저자 주: GPT Image 2.6에 새로 추가된 Complexity 파라미터는 모델이 렌더링 전에 얼마나 많은 장면 계획을 수행할지 제어해요. OpenAI 공식 종이 오리기 축구팀 비교 사례를 통해 세 단계의 차이, Quality와의 역할 분담, API에서 단계를 선택하고 테스트하는 방법을 살펴볼게요.
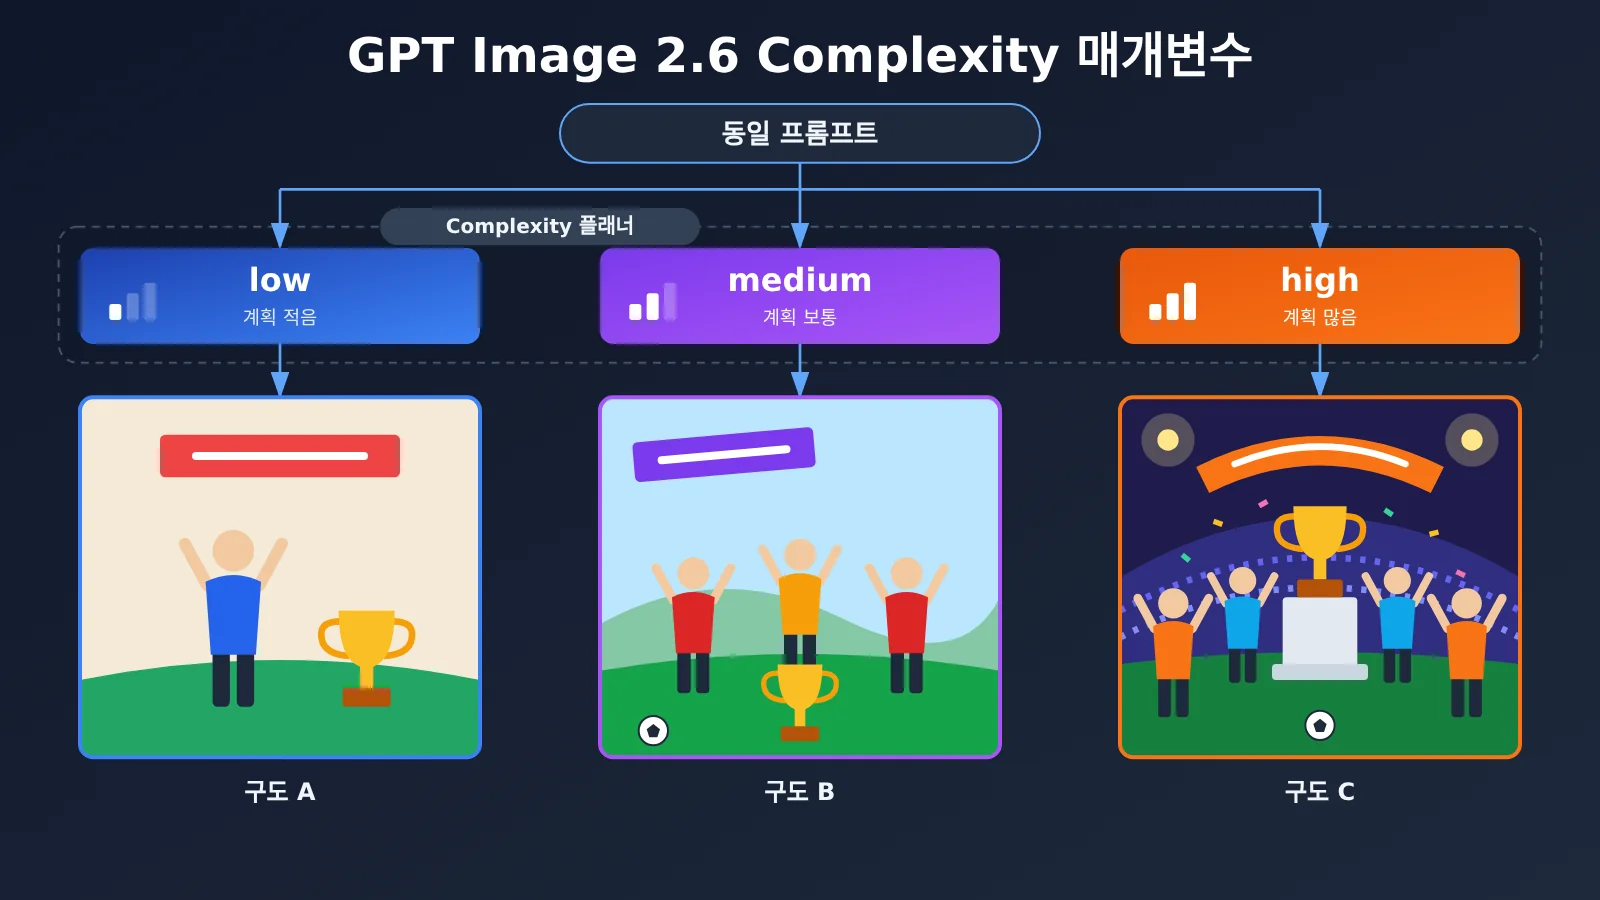
같은 프롬프트에 크기와 화질도 똑같이 설정하고, Complexity만 low에서 high로 바꿨는데도 선수들의 유니폼 색상, 트로피 장식, “CHAMPIONS” 표지판의 위치가 달라질 수 있어요. OpenAI가 GPT Image 2.6 프롬프트 가이드에서 공개한 비교 결과예요.
2026년 11월 4일, OpenAI는 Images 2.6을 출시하면서 개발자용 모델 gpt-image-2.6-flare와 gpt-image-2.6-sunburst를 선보이고 complexity 파라미터를 추가했어요. 이 파라미터로 모델의 사고 과정을 볼 수는 없고, “높을수록 좋은” 화질 설정도 아니에요. 모델이 그림을 그리기 전에 장면을 얼마나 계획할지 제어하는 파라미터예요.
핵심 내용: 이 글을 읽으면 OpenAI가 GPT Image 2.6의 Complexity 파라미터를 어떻게 정의하는지, 실제 사례에서 세 단계에 따라 무엇이 달라지는지, API에서 어느 단계부터 테스트하면 좋을지 알 수 있어요.
GPT Image 2.6 Complexity 핵심 정보 한눈에 보기
먼저 공식적으로 확인된 내용을 표로 정리했어요. 이후의 분석과 추론은 모두 이 정보를 바탕으로 해요.
| 정보 항목 | 내용 |
|---|---|
| 출시일 | 2026년 11월 4일, Images 2.6과 함께 출시 |
| 지원 모델 | gpt-image-2.6-flare, gpt-image-2.6-sunburst |
| 선택 가능한 단계 | low / medium / high |
| 기본값 | 두 모델 모두 high |
| 공식 정의 | 창작 요구사항을 이해하고 충족하기 위해 렌더링 전에 수행하는 계획의 양을 제어 |
| 과금 안내 | 파라미터에 대한 별도 추가 요금은 없으며, 실제 토큰 사용량과 소요 시간은 직접 테스트해야 함 |
| 관련 제한 | GPT Image 2.6은 reasoning.summary를 지원하지 않아 계획 과정을 확인할 수 없음 |
여기서 오해하기 쉬운 점이 두 가지 있어요. 첫째, 공식적으로 언급한 것은 ‘계획에 들이는 양’이에요. 각 단계의 내부 계산 배분 방식이나 고정된 추론 토큰 수에 대응하는지는 공개하지 않았어요. 둘째, ‘추가 요금 없음’이 ‘세 단계의 비용이 동일함’을 뜻하지는 않아요. 최종 비용은 여전히 실제 과금되는 토큰 수를 기준으로 계산돼요.
GPT Image 2.6 Complexity와 Quality의 차이
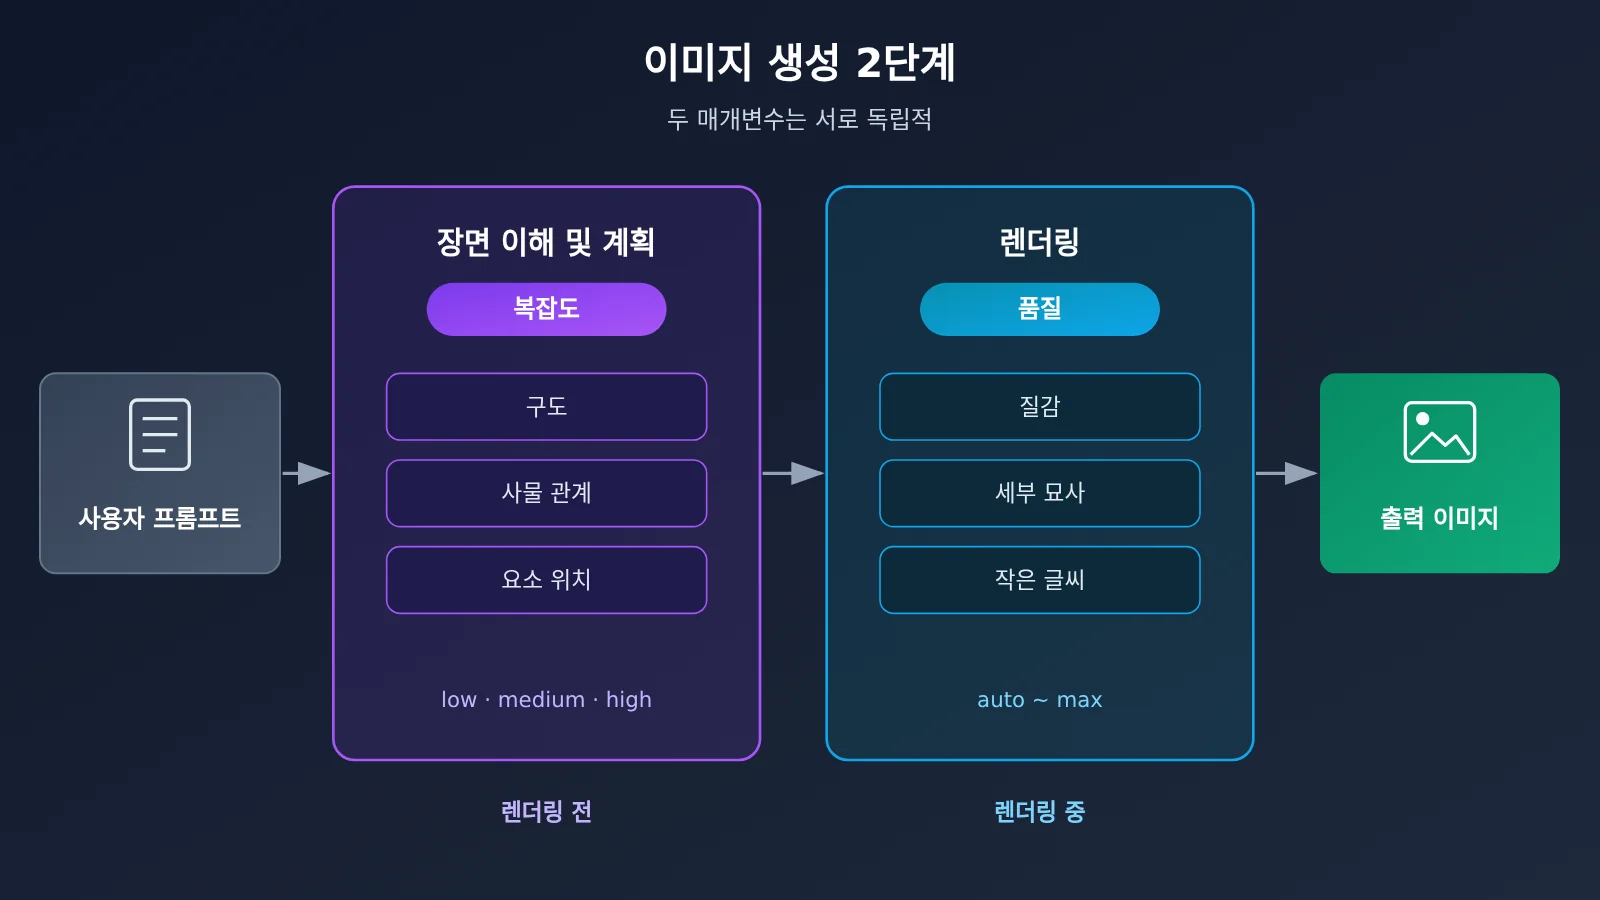
Complexity를 처음 보면 Quality의 다른 표현이라고 생각하기 쉬워요. 하지만 두 파라미터는 이미지 생성 과정에서 서로 다른 역할을 해요. Complexity는 화면을 어떻게 구성할지 결정하고, Quality는 화면을 얼마나 정교하게 표현할지 결정해요.
| 비교 항목 | Complexity | Quality |
|---|---|---|
| 적용 단계 | 렌더링 전 계획 및 장면 이해 | 렌더링 시 시각적 표현 |
| 주요 영향 | 전체 구도, 객체 간 관계, 요소 위치, 여러 조건의 조율 | 질감, 디테일, 작은 글자, 전반적인 정교함 |
| 선택 가능한 값 | low / medium / high | auto / low / medium / high / xhigh / max |
| 기본값 | high | 인터페이스 설정에 따름 |
| 대표적인 문제 | 요소 배치가 잘못되거나 관계를 잘못 이해함 | 구조는 맞지만 작은 글자가 흐리거나 질감이 거침 |
두 파라미터는 서로 독립적이므로 문제를 해결할 때는 먼저 어떤 유형인지 판단해야 해요. 인포그래픽의 구조와 화살표 관계는 맞는데 작은 라벨 글자만 잘 보이지 않는다면 Quality를 먼저 높여보세요. Complexity를 계속 높여도 큰 도움이 되지 않아요. 반면 화면에서 여러 주체의 상대적인 위치가 계속 잘못 배치된다면 Complexity를 살펴봐야 해요.
비유하자면 Complexity는 디자이너가 작업에 들어가기 전 밑그림을 그리는 시간이고, Quality는 최종 채색과 선을 얼마나 정교하게 다듬는지에 해당해요. 밑그림에 시간을 오래 들인다고 선이 더 정교해지는 것은 아니에요. 마찬가지로 선을 정교하게 그려도 밑그림의 구조적 오류를 보완할 수는 없어요.
GPT Image 2.6 Complexity 공식 비교 사례: 종이 오리기 축구팀
추상적인 정의만으로는 의미를 다르게 받아들이기 쉬워요. 공식 프롬프트 가이드에는 직접 비교해 볼 수 있는 사례가 나와 있어요.
실험 조건(공식 발표):
- 모델:
gpt-image-2.6-sunburst - 크기:
1024x1536, Quality:medium, 형식:png - 프롬프트: “A premium handcrafted layered paper-cut illustration of a football team celebrating a championship victory inside a packed stadium.”(관중으로 가득 찬 경기장에서 축구팀이 우승을 축하하는 모습을 고급스러운 수제 종이 오리기 레이어 기법으로 표현한 일러스트)
- 유일한 변수: Complexity를 각각 low, medium, high로 설정
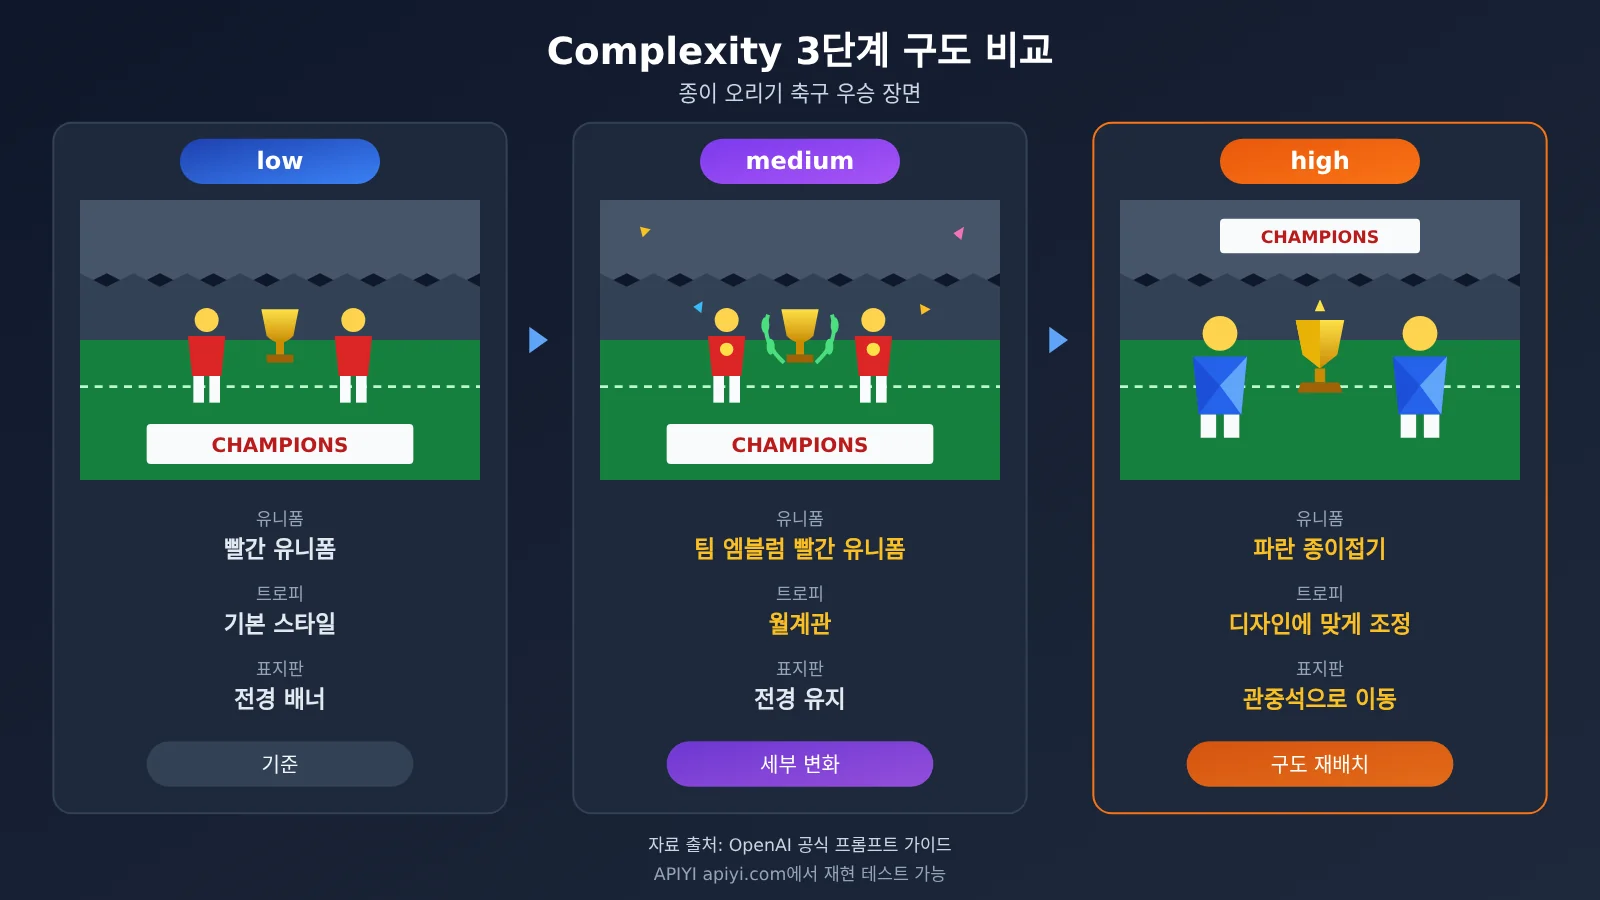
| 단계 | 유니폼 | 트로피 | CHAMPIONS 표지판 | 구도 변화 |
|---|---|---|---|---|
| low | 빨간색 옷 | 상단에 왕관 장식 | 전경의 현수막에 표시 | 기본 배치 |
| medium | 팀 엠블럼이 있는 빨간색 유니폼 | 월계관 장식 | 여전히 전경의 현수막에 표시 | 세부 요소가 더 풍부해짐 |
| high | 파란색 종이접기 질감의 유니폼 | 전체 디자인에 맞춰 조정 | 관중석으로 이동 | 전경을 선수들에게 더 많이 할애하고 전체 배치를 재구성 |
종이 오리기 사례로 살펴보는 Complexity의 변화
공식 설명을 보면 low에서 medium으로의 변화는 주로 요소의 세부 디자인에 나타나요. 유니폼에 팀 엠블럼이 추가되고 트로피 장식이 바뀌었지만, 표지판의 위치는 그대로예요. high에서는 변화가 전체 배치로 확장돼요. 문구가 전경에서 관중석으로 이동하고 전경 공간은 선수들에게 할애됐어요. 유니폼 소재도 ‘종이 오리기’ 주제에 더 가까운 종이접기 질감으로 바뀌었어요.
이는 Complexity를 높이면 질감만 추가되는 게 아니라, 모델이 구도의 층위와 요소 구성에서도 다른 선택을 한다는 뜻이에요. high 단계의 결과는 모델이 ‘종이 오리기 + 우승 + 경기장’이라는 세 가지 조건을 더 종합적으로 재배치한 것으로 볼 수 있어요.
다만 이 비교 사례가 보여주는 근거에는 한계가 있어요.
- 공식 자료에는 각 단계별로 한 개의 예시만 제시돼 있어, high의 평균 품질이 더 좋다고 볼 수는 없어요.
- 공식 자료에는 세 단계의 실제 소요 시간과 토큰 사용량이 공개되지 않았어요.
- “high가 종이 오리기 주제에 더 잘 맞는다”는 말은 이미지 한 장에 대한 해석이지, 통계적 결론이 아니에요.
GPT Image 2.6 Complexity 단계는 어떻게 선택할까요?
공식 안내에서는 작업별로 어떤 단계부터 시작할지 명확히 제시하면서, High가 항상 더 좋은 것은 아니다라고 강조해요.
공식 권장 사항: 편집 작업은 low부터 시작하기
OpenAI는 출시 발표에서 대부분의 이미지 편집 작업에 low complexity를 먼저 적용해 편집 속도를 높이고, 작업 흐름에 필요한 Quality를 함께 설정하도록 권장해요. 배경 교체, 표지판 내용 변경, 부분 색상 변경, 특정 객체 삭제처럼 나머지 화면을 유지해야 하는 정밀 편집은 low부터 시도하기 좋아요.
왜 부분 편집에는 많은 계획이 필요하지 않을까요? 다음은 합리적인 기술적 추론이지만, 공식적으로 확인된 내용은 아니에요. 사용자가 “화병 색상만 바꾸고 나머지는 그대로 둬”라고 요청했다면, 화면을 최소한으로 수정하는 것이 의도에 가장 잘 맞아요. 모델이 전체 장면을 대폭 재계획하면 오히려 수정하지 말아야 할 부분까지 바뀔 수 있어요. 공식 안내에서도 “높은 복잡도는 원하지 않는 추가 변경을 일으킬 수 있다”고 언급해 이 추론과 같은 방향을 가리키지만, high가 반드시 더 큰 수정 범위 이탈을 초래한다는 데이터는 아직 없어요.
공식 권장 사항: 제약 조건이 많은 작업은 중간·높은 단계 비교하기
화면 요소가 많거나 레이아웃이 복잡하고 제약 조건이 많은 작업에는 medium 또는 high를 시도하도록 권장해요.
| 작업 유형 | 권장 시작 단계 | 근거 | 추가 확인 사항 |
|---|---|---|---|
| 배경 교체, 부분 색상 변경, 표지판 문구 변경 | low | 공식 권장 사항 | 편집하지 않은 영역이 바뀌었는지 |
| 단일 객체 삭제 | low | 공식 권장 사항 | 채워진 영역이 자연스러운지 |
| 여러 주체가 등장하는 장면, 인물 간 관계 | medium / high 비교 | 공식 권장 사항 | 주체의 위치와 관계가 올바른지 |
| 복잡한 인포그래픽, 촘촘한 레이블 | medium / high 비교 | 공식 권장 사항 | 구조를 확인한 뒤 텍스트 선명도 점검 |
| 레이아웃이 완전히 지정된 디자인 시안 | 최고 단계를 기본으로 선택할 필요 없음 | 공식 안내에 따르면 개선 효과가 크지 않을 수 있음 | 불필요한 변경이 생겼는지 |
마지막 행에 주목할 만해요. 프롬프트에 각 요소의 위치를 이미 구체적으로 지정했다면, 모델이 자유롭게 계획할 여지가 적어요. 공식 안내에 따르면 이런 작업에서 Complexity를 높여도 눈에 띄는 개선 없이 지연 시간만 늘어날 수 있어요.
high가 기본값이라는 것은 무엇을 의미할까요?
두 모델 모두 기본값이 high예요. 기존 작업 흐름에서 전환할 때 이 파라미터를 전달하지 않으면 가장 높은 계획 단계로 실행돼요. 부분 편집 요청이 많은 경우에는 이 기본값이 반드시 가장 적합한 설정은 아닐 수 있어요.
🎯 기술 팁: Complexity는 전체에 일괄 적용하는 스위치가 아니라 작업 유형에 따라 조정하는 파라미터로 다루는 것이 좋아요. APIYI apiyi.com에서 OpenAI 호환 인터페이스로 비교 테스트할 수 있어요. 2.6 모델 제공 여부와
complexity파라미터 전달 지원 여부는 플랫폼의 모델 목록과 문서를 확인하세요.
API에서 GPT Image 2.6 Complexity 설정하기
간단한 예제
complexity는 /v1/images/generations 요청 본문에서 quality, size와 같은 수준에 설정해요. SDK 버전에 이 필드가 없다면 extra_body로 전달할 수 있어요.
import base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.images.generate(
    model="gpt-image-2.6-sunburst",
    prompt="A detailed educational infographic explaining how a coffee machine works, with clearly labeled components and arrows.",
    size="1024x1536",
    quality="medium",
    extra_body={"complexity": "high", "output_format": "png"},
)
open("coffee_high.png", "wb").write(base64.b64decode(resp.data[0].b64_json))
이 코드는 공식 파라미터 사양을 바탕으로 작성한 예시이며, 실제 테스트를 완료한 요청은 아니에요.
세 단계 비교 테스트 전체 스크립트 보기
import base64
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # APIYI OpenAI 호환 인터페이스
)

PROMPT = (
    "A premium handcrafted layered paper-cut illustration of a football team "
    "celebrating a championship victory inside a packed stadium."
)
LEVELS = ["low", "medium", "high"]
REPEATS = 3  # 한 장의 결과만 보지 않도록 각 단계를 여러 번 반복

def run_once(level: str, idx: int) -> dict:
    start = time.time()
    resp = client.images.generate(
        model="gpt-image-2.6-sunburst",  # 모델 고정
        prompt=PROMPT,                   # 프롬프트 고정
        size="1024x1536",                # 크기 고정
        quality="medium",                # 화질 고정
        extra_body={"complexity": level, "output_format": "png"},
    )
    elapsed = time.time() - start
    path = f"paper_cut_{level}_{idx}.png"
    with open(path, "wb") as f:
        f.write(base64.b64decode(resp.data[0].b64_json))
    usage = getattr(resp, "usage", None)  # 토큰 사용량 기록(반환된 경우)
    return {"level": level, "idx": idx, "seconds": round(elapsed, 2),
            "usage": usage, "file": path}

results = []
for level in LEVELS:
    for i in range(REPEATS):
        try:
            results.append(run_once(level, i))
        except Exception as e:
            results.append({"level": level, "idx": i, "error": str(e)})

for r in results:
    print(r)
이 스크립트는 complexity만 변경하고 나머지 파라미터는 모두 고정해요. 공식 마이그레이션 가이드도 처음에는 기본값을 사용하고, 이후 한 번에 하나의 파라미터만 조정할 것을 권장해요.
🚀 빠른 시작: 신규 사용자는 APIYI apiyi.com에서 무료 테스트 크레딧을 받아 위 스크립트로 소규모 비교 테스트를 진행한 뒤, 프로덕션 환경에서 사용할 단계를 결정할 수 있어요.
GPT Image 2.6 Complexity 공정 테스트 방법
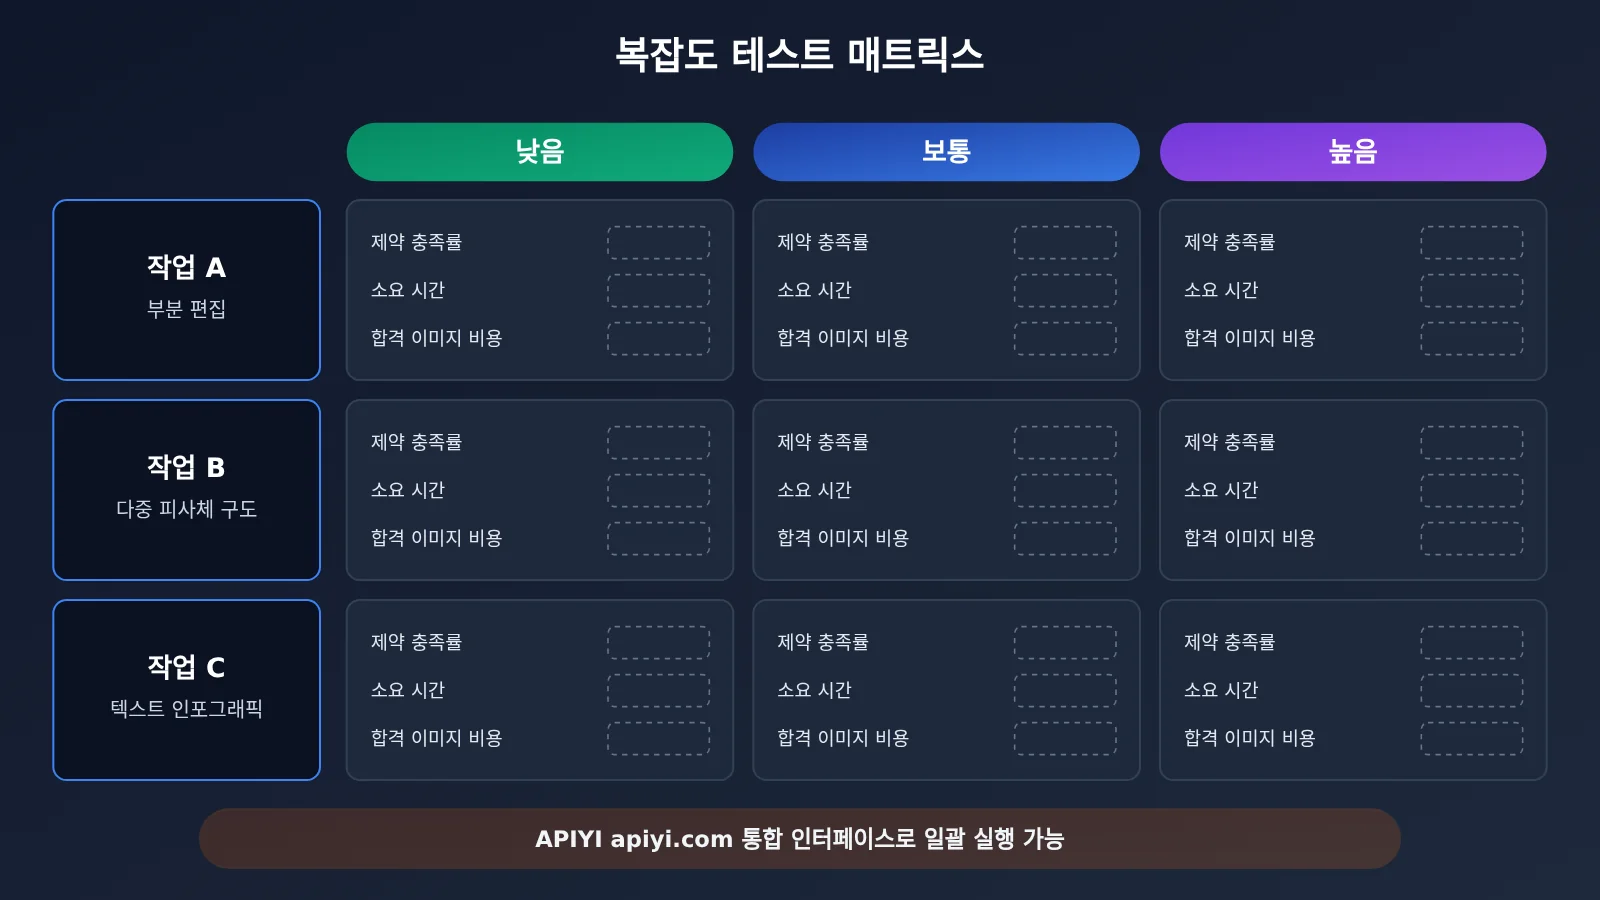
이미지 한 장만 비교하면 우연의 영향을 받기 쉬워요. 아래 테스트 설계는 공식 마이그레이션 권장 사항을 참고한 것으로, 팀 내부 평가 프레임워크로 활용할 수 있어요. 방법에 대한 제안이며, 실제 테스트 데이터는 포함하지 않습니다.
세 가지 대표 작업:
- 작업 A: 단순 부분 편집, 객체 하나만 수정하고 나머지는 그대로 유지해요.
- 작업 B: 여러 대상이 포함된 복잡한 구도, 여러 객체가 지정된 관계를 유지해야 해요.
- 작업 C: 텍스트가 많은 인포그래픽, 지정된 논리에 따라 레이블, 흐름, 계층을 표현해요.
변수 통제: 모델, 프롬프트, 참조 이미지, 크기, 출력 형식, Quality는 고정하고 Complexity만 변경해 각 단계에서 여러 번 반복 생성해요.
| 평가 지표 | 측정 내용 | 기록 방법 |
|---|---|---|
| 제약 조건 충족률 | 프롬프트의 필수 요구사항을 몇 개 충족했는지 | 항목별 체크 |
| 레이아웃 정확성 | 객체의 위치와 관계가 설명에 부합하는지 | 사람이 판단 |
| 의도하지 않은 변경 | 편집 작업에서 바뀌면 안 되는 영역이 변경됐는지 | 원본 이미지와 비교 |
| 텍스트 정확도 | 레이블과 제목의 철자가 정확하고 읽기 쉬운지 | 글자별 대조 |
| 생성 소요 시간 | 단일 요청의 엔드투엔드 시간 | 스크립트로 측정 |
| 합격 이미지 평균 비용 | 총비용 ÷ 합격 이미지 수 | usage 집계 |
마지막 지표를 가장 주의 깊게 살펴봐야 해요. 어떤 단계는 한 번 생성할 때 비용이 적게 들더라도, 합격 이미지 한 장을 얻기 위해 여러 번 재시도해야 한다면 결과적으로 더 저렴하지 않을 수 있어요. 단일 요청 비용보다 “합격 이미지 한 장당 평균 비용”으로 비교하는 편이 실제 업무에 더 가까워요.
GPT Image 2.6 Complexity의 영향 분석
개발자에게 미치는 영향
- 조정할 파라미터가 하나 더 생겼어요: 기존에는 이미지 생성 시 주로 크기와 화질을 조정했지만, 이제는 ‘계획에 들이는 노력’도 고려해야 해요. 기본값인 high가 부분 편집 요청에 항상 적합한 것은 아니므로, 기존 워크플로를 이전할 때 다시 평가해야 해요.
- 문제 원인을 단계별로 파악해야 해요: 이미지가 기대에 못 미친다면 먼저 ‘구도 문제’인지 ‘렌더링 문제’인지 구분한 뒤 Complexity와 Quality 중 무엇을 조정할지 결정하세요. 두 파라미터를 무작정 최대로 올리는 일은 피할 수 있어요.
- 비용은 직접 측정해야 해요: Complexity에는 추가 요금이 없지만, 공식적으로 각 단계의 토큰 사용량 차이는 공개되지 않았어요. 서드파티 Kingy AI의 단일 테스트에서는 기본값 high를 사용한 2.6이 2.5보다 시간과 비용이 더 들었어요. 다만 두 모델의 측정 조건이 달라 일반적인 결론으로 확대할 수는 없으며, 직접 테스트해 볼 만하다는 정도로만 참고해야 해요.
이미지 생성 제품에 미치는 영향
- 계획과 렌더링을 별도로 제어할 수 있어요: 텍스트 모델에는 이미 ‘추론 강도’ 같은 개념이 있었는데, 이미지 모델에서도 이제 계획 단계를 따로 조절할 수 있게 됐어요. 제품 설계 시 ‘빠른 초안’과 ‘복잡한 레이아웃’에 같은 설정을 쓸 필요 없이 서로 다른 단계를 적용할 수 있어요.
- High 자체를 장점으로 내세우기는 어려워요: 공식 문서에서도 높은 단계는 지연과 불필요한 수정을 늘릴 수 있다고 명시해요. 사용자 대상 제품이라면 무조건 최고 단계를 쓰기보다 작업 유형에 따라 단계를 자동으로 선택하는 편이 좋아요.
자주 묻는 질문 FAQ
Q1: GPT Image 2.6의 Complexity 파라미터란 무엇인가요?
모델이 이미지 렌더링 전에 요구사항을 이해하고 반영하기 위해 얼마나 계획할지 조절하는 파라미터예요. `low`, `medium`, `high` 중 선택할 수 있으며, 두 2.6 모델 모두 기본값은 `high`예요. 주로 구도, 객체 간 관계, 요소의 위치에 영향을 주며, 모델의 내부 추론 과정을 확인하는 데는 사용할 수 없어요.
Q2: Complexity와 Quality의 차이는 무엇인가요?
Complexity는 “화면을 어떻게 배치할지”, Quality는 “얼마나 정교하게 그릴지”를 담당하는 독립적인 파라미터예요. 구조는 맞지만 작은 글씨가 흐리다면 Quality부터 조정하고, 요소 배치가 계속 잘못된다면 Complexity 조정을 고려해 보세요.
Q3: Complexity를 high로 설정하면 항상 결과가 더 좋아지나요?
꼭 그렇지는 않아요. 공식 설명에 따르면 높은 단계는 지연 시간을 늘리거나 원치 않는 추가 변화를 일으킬 수 있어요. 레이아웃을 이미 완전히 지정한 작업에서는 개선 효과가 크지 않을 수도 있어요. 정밀한 부분 편집에는 `low`부터 시도하는 것을 권장해요.
Q4: Complexity에 추가 요금이 있나요? 단계별 비용 차이는 얼마나 되나요?
공식 설명에 따르면 Complexity 조정에 별도 추가 요금은 없지만, 실제 비용은 과금 대상 토큰을 기준으로 계산돼요. 세 단계의 평균 토큰 소비량과 처리 시간 차이는 공개되지 않았으므로, 직접 작업 샘플을 테스트해 “기준을 충족하는 이미지 한 장당 평균 비용”을 확인하는 것이 좋아요.
Q5: API로 Complexity의 효과를 빠르게 테스트하려면 어떻게 하나요?
1. APIYI apiyi.com에 가입하고 API 키와 무료 테스트 크레딧을 받으세요.
2. 모델 목록에서 2.6 시리즈 모델의 사용 가능 여부와 `complexity` 파라미터 지원 여부를 확인하세요.
3. 이 글의 스크립트에서 base_url을 `https://api.apiyi.com/v1`로 설정한 뒤, 다른 파라미터는 고정하고 Complexity만 바꿔 비교 테스트를 실행하세요.
Q6: Complexity의 알려진 한계는 무엇인가요?
공식 자료에는 단일 샘플의 시각적 비교만 공개되어 있어요. 현재 세 단계의 대규모 샘플 성공률, 평균 지연 시간, 독립적인 제3자의 체계적인 비교 자료는 없어요. 계획이 정확해도 글자가 반드시 선명한 것은 아니며, 복잡한 요청은 처리 시간이 길어질 수 있어요. 생성된 이미지는 상업적으로 사용하기 전에 사람이 검수해야 해요.
GPT Image 2.6 Complexity 핵심 요약 Key Takeaways
- 정의: Complexity는 렌더링 전 장면 계획에 들이는 자원을 제어하는 파라미터예요. 사고 연쇄 스위치가 아니에요.
- 역할 분담: Complexity는 구도와 배치를, Quality는 렌더링의 정교함을 담당하며 서로 독립적으로 조절할 수 있어요.
- 공식 사례: 종이 오리기 축구팀 이미지에서 high 설정 시 표지판이 관중석으로 옮겨지고 유니폼이 종이접기 재질로 바뀌었어요.
- 시작 가이드: 부분 편집은 low부터, 조건이 많은 복잡한 이미지는 medium과 high를 비교해 보세요.
- 기본값 주의: 두 모델 모두 기본값이 high이므로 기존 워크플로를 이전할 때 다시 평가해야 해요.
- 비용 기준: 추가 요금이 없다고 비용이 같은 건 아니에요. ‘기준을 충족한 이미지당 평균 비용’으로 비교하는 편이 더 신뢰할 만해요.
- 시작 방법: APIYI apiyi.com에서 OpenAI 호환 인터페이스로 세 단계 비교 테스트를 진행할 수 있어요.
정리
GPT Image 2.6 Complexity 파라미터의 핵심은 다음과 같아요.
- 화면을 구성하는 방식이 달라져요: 공식 종이 오리기 사례에서 설정 단계에 따라 유니폼, 트로피, 표지판의 디자인 선택이 달라졌어요.
- Quality와 역할이 명확히 구분돼요: 하나는 계획을, 다른 하나는 렌더링을 담당해요. 문제가 생기면 먼저 어느 쪽에 해당하는지 판단하세요.
- 높을수록 좋은 건 아니에요: high는 더 느릴 수 있고, 바꾸면 안 되는 부분까지 수정할 수도 있어요. 작업 유형에 맞춰 단계를 선택하세요.
이미지를 생성할 때는 최종 화면의 정교함과 모델의 화면 구성 방식을 함께 제어해야 해요. 실제 업무 샘플로 소규모 비교 테스트를 진행하고, 조건 충족률과 의도하지 않은 변경, 기준을 충족한 이미지의 비용을 기준으로 단계를 선택하는 것이 좋아요.
먼저 APIYI apiyi.com의 무료 할당량으로 세 단계를 비교해 보세요. 플랫폼이 2.6 모델과 관련 파라미터를 지원하는지 확인한 뒤 프로덕션 환경에 적용하는 것을 추천해요.
📚 참고 자료
- OpenAI 공식 발표 – Introducing Images 2.6: Images 2.6 출시 발표와 Complexity 사용 권장 사항
- 링크:
openai.com/index/introducing-images-2-6 -
설명: 편집 작업에 low complexity를 우선 사용하라는 공식 권장 사항이 담겨 있어요.
-
OpenAI API 문서 – GPT Image 2.6 prompting guide: Complexity 파라미터 설명과 종이 오리기 스타일의 축구팀 비교 사례
- 링크:
developers.openai.com/api/docs/guides/image-prompting -
설명: Set image complexity, Compare complexity, Migrate an existing workflow 섹션을 중점적으로 살펴보세요.
-
OpenAI API 문서 – Image generation: 이미지 생성 API 파라미터 개요
- 링크:
developers.openai.com/api/docs/guides/image-generation -
설명: quality, size, output_format 등 파라미터의 전체 사양을 확인할 수 있어요.
-
OpenAI 모델 페이지: Flare와 Sunburst 모델 상세 정보
- 링크:
developers.openai.com/api/docs/models/gpt-image-2.6-sunburst - 설명: 모델 ID와 지원 기능을 확인할 수 있어요.
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 홈에서 문의하실 수 있어요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인하세요.