작성자 주: 星尘智能의 라이제가 말한 “나사 하나 조일 때마다 토큰 요금을 내고 싶지는 않다”는 비유를 바탕으로, AI 워크플로에서 어떤 작업은 고정 프로그램에 맡기고 어떤 작업에 대규모 언어 모델의 판단이 필요한지 살펴봐요.
2026년 11월 5일, 아이판얼의 「다양성 회사」 코너에서 星尘智能 창업자 겸 CEO 라이제의 인터뷰를 공개했어요. 그중 한 문장은 AI 애플리케이션을 만드는 사람들 사이에서 자주 회자됐어요. “나사를 조이는 일은 고정 프로그램이 24시간 내내 돌아가며 처리했으면 해요. 나사 하나 조일 때마다 토큰 요금을 내고 싶지는 않거든요.”
이건 단순한 농담이 아니에요. 라이제는 인터뷰에서 로봇의 역할 분담을 이야기했어요. 물리적 동작은 체화 모델이 담당하고, 문제가 생기면 자연어로 기반 대규모 언어 모델에 묻는 방식이에요. 이 아이디어를 소프트웨어 워크플로에 적용하면 한 가지 실질적인 질문으로 이어져요. AI 애플리케이션에서 대규모 언어 모델을 호출하지 말아야 할 단계는 어디일까요?
핵심 내용: 이 글에서는 인터뷰의 로봇 관련 관점을 소프트웨어 워크플로의 호출 경계 설계에 적용해요. 대규모 언어 모델을 호출하지 않아야 할 작업 5가지, 계층별 판단 기준, 바로 수정해 쓸 수 있는 라우팅 코드 예시를 소개해요. 다만 로봇과 소프트웨어는 서로 다른 시스템이므로, 아래 내용은 비유를 통한 추론이며 효과는 실제 사용량을 바탕으로 직접 검증해야 해요.
「나사 하나 조일 때마다 토큰 요금을 내고 싶지 않다」 핵심 요약
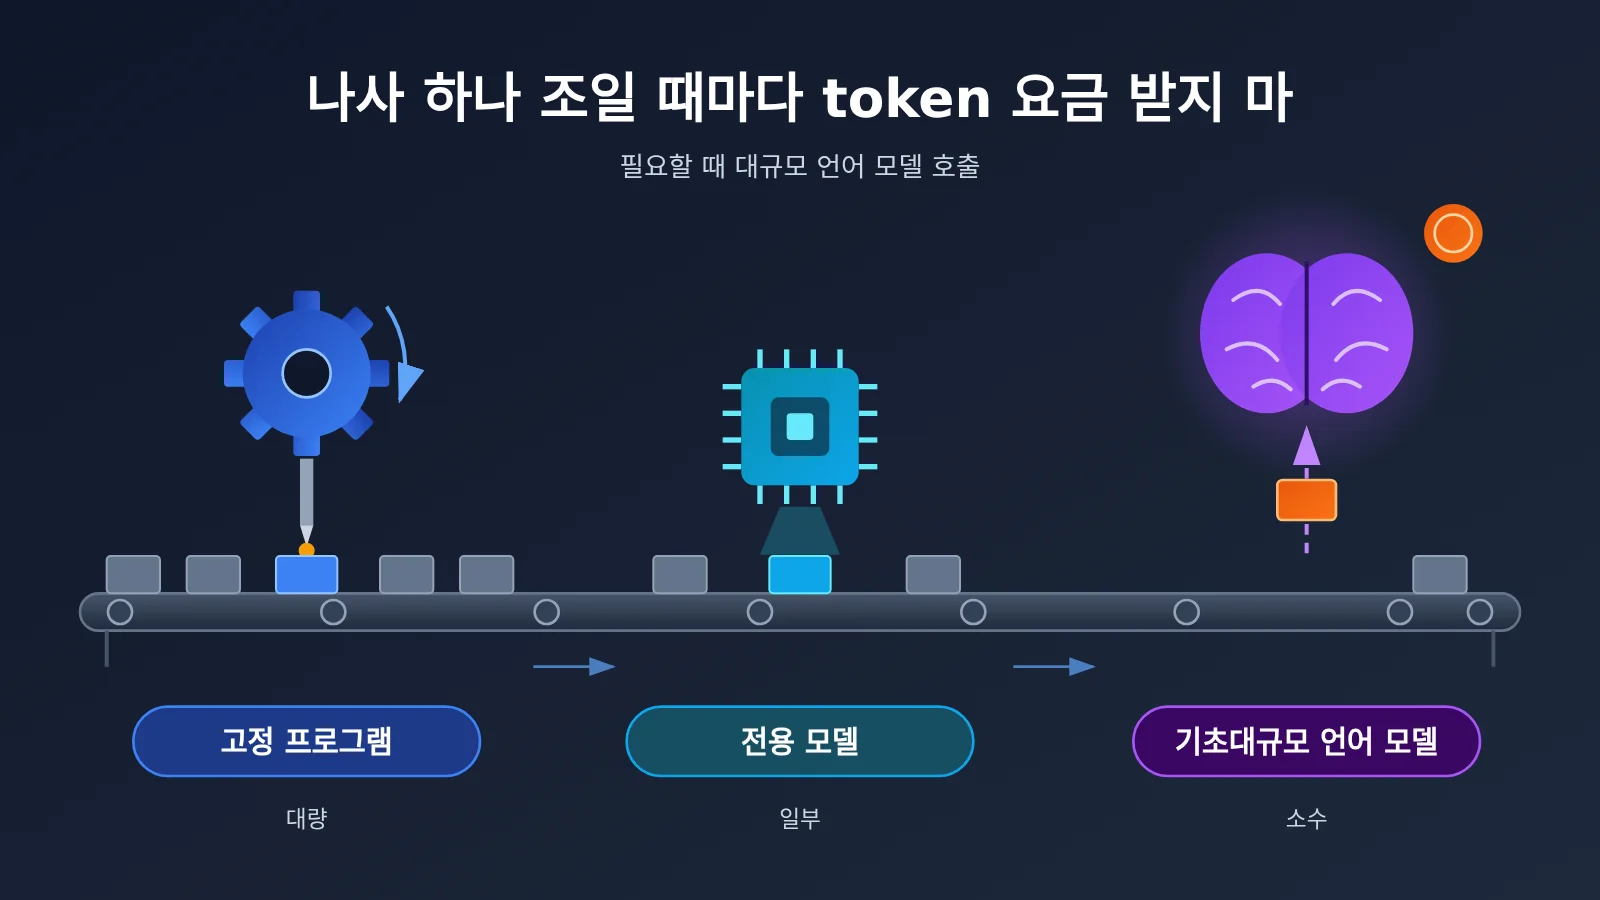
이 말은 인터뷰의 마지막 질문에서 나왔어요. 로봇이 인간을 어떤 일에서 벗어나게 해주길 바라느냐는 질문에 라이제는 로봇이 “공장에 들어가 나사를 조이는 일”은 하지 않았으면 좋겠다고 답했어요. 로봇의 가치는 폭넓은 능력에 있으며, 비용 측면에서도 반복 작업의 매 동작마다 토큰 요금을 내는 건 합리적이지 않다는 생각이에요.
| 정보 항목 | 내용 |
|---|---|
| 정보 출처 | 아이판얼 「다양성 회사」 코너의 15번째 인터뷰 |
| 공개일 | 2026년 11월 5일 |
| 인터뷰 대상 | 싱천즈넝 창업자 겸 CEO 라이제. 텐센트 Robotics X 로봇 연구소의 첫 번째 직원 출신 |
| 핵심 관점 | 반복 동작은 고정된 프로그램에 맡기고, 매번 토큰 요금을 내지 않아야 함 |
| 역할 분담 | 체화 모델이 물리적 동작을 수행하고, 문제가 생기면 자연어로 기반 대규모 언어 모델에 질문 |
| 소프트웨어에 주는 시사점 | AI 워크플로에서 고정 프로그램, 전용 모델, 기반 대규모 언어 모델의 호출 경계를 나눠야 함 |
다만 인터뷰 내용은 창업자의 의견이며, 비용 실측이나 제3자 검증 데이터는 제시되지 않았어요. 여기서는 특정 결론이 아니라 역할 분담의 논리를 참고해요.
라이제의 ‘엄마에게 영상통화하기’ 비유: 대규모 언어 모델은 맥락만 보완해요
인터뷰에는 ‘나사 조이기’보다 역할 분담을 더 잘 보여주는 비유가 나와요. 라이제는 요리를 할 줄 모르지만 해보고 싶다면 엄마에게 영상통화를 건다고 말해요. 엄마는 “먼저 달군 팬에 기름을 조금 넣어”라고 알려주지만, 어느 병이 기름인지까지 설명할 필요는 없어요. 궁금한 점이 생기면 다시 물어보면 되죠. 핵심은 엄마가 맥락에 필요한 지식을 보충해주지만, 기름을 넣는 동작은 직접 할 줄 알아야 한다는 거예요. 엄마는 전화기 너머에서 대신 기름을 넣어줄 수 없으니까요.
이를 로봇에 적용하면, 체화 모델은 무게와 쥐는 힘, 물체를 안정적으로 잡았는지 같은 물리적 매개변수를 스스로 감지해야 해요. 그리고 “제대로 쥐지 못해서 좀 불안정한데 어떻게 해야 할까?” 같은 문제만 기반 대규모 언어 모델에 물어보는 거죠. 라이제는 촉각 정보까지 기반 대규모 언어 모델에 학습시키는 것이 “불가능한 건 아니지만 비용이 적절하지 않고, 통신 대역폭에도 문제가 생긴다”고 설명해요. 또 이것은 단순한 계층화가 아니라 개미처럼 에이전트들이 협력하는 방식에 가깝다고 덧붙여요. 각 에이전트의 능력은 강하지 않을 수 있지만, 함께 작동하면 강력해진다는 거죠.
| 로봇 시스템의 역할 | 인터뷰에서 설명한 역할 | 소프트웨어 워크플로의 대응 역할 |
|---|---|---|
| 고정 프로그램 | 24시간 나사 조이기 반복 | 규칙 엔진, 정규식, 스크립트, 데이터베이스 쿼리 |
| 체화 모델 | 물리적 실행, 매개변수 감지, 상태를 자연어로 변환 | 분류, 추출, 벡터 검색 등을 위한 전용 소형 모델 |
| 기반 대규모 언어 모델 | 맥락 지식 보충, 난제 해결 방안 제시 | 복잡한 추론, 개방형 생성, 예외 상황 판단 |
| AOS 운영체제 | 기능을 스킬 모듈로 묶어 대규모 언어 모델 및 Agent와 연동 | 워크플로 오케스트레이션 계층, 도구 호출 계층, 라우터 |
이 대응표는 인터뷰 내용을 바탕으로 이 글에서 추론한 것으로, 인터뷰의 직접적인 발언은 아니에요. 로봇은 물리 세계의 실시간 제어와 통신 대역폭에 제약을 받지만, 소프트웨어 워크플로는 주로 토큰 비용, 지연 시간, 안정성에 영향을 받아요. 따라서 두 분야의 병목은 완전히 같지 않아요.
AI 애플리케이션의 어느 단계에서 대규모 언어 모델을 호출하지 말아야 할까? 5가지 판단 기준
많은 팀이 Agent의 첫 버전을 만들 때 모든 단계를 대규모 언어 모델에 맡기곤 해요. 형식 검증과 날짜 변환은 물론, “필드가 비어 있는지 확인”하는 작업까지 프롬프트로 작성하죠. 프로토타입 단계에서는 빠르지만, 출시 후에는 요청할 때마다 결정적인 작업에 비용을 쓰는 데다 불필요한 무작위성까지 생겨요.
“나사 조이기”에 비유해, 각 단계에서 대규모 언어 모델을 호출할 가치가 있는지 다음 5가지 기준으로 판단해 볼 수 있어요.
| 판단 기준 | 고정 프로그램이 적합 | 전용 모델이 적합 | 범용 대규모 언어 모델이 적합 |
|---|---|---|---|
| 입력이 구조화되어 있는가 | 필드가 고정되어 있고 형식이 명확함 | 반구조화된 텍스트 | 자유로운 자연어 |
| 정답이 하나인가 | 유일한 정답이 있음 | 제한된 범주의 답이 있음 | 타당한 답이 여럿 있음 |
| 규칙을 모두 열거할 수 있는가 | if/else로 작성할 수 있음 | 규칙은 많지만 패턴이 일정함 | 규칙을 모두 열거할 수 없음 |
| 오류 발생 비용 | 오류가 없어야 함 | 소량의 오류를 허용하고 검토할 수 있음 | 종합적인 판단이 필요함 |
| 호출 빈도 | 매우 높고 매번 실행됨 | 높음 | 낮고 필요할 때 실행됨 |
고정 프로그램에 맡기기 좋은 “나사 조이기”형 단계
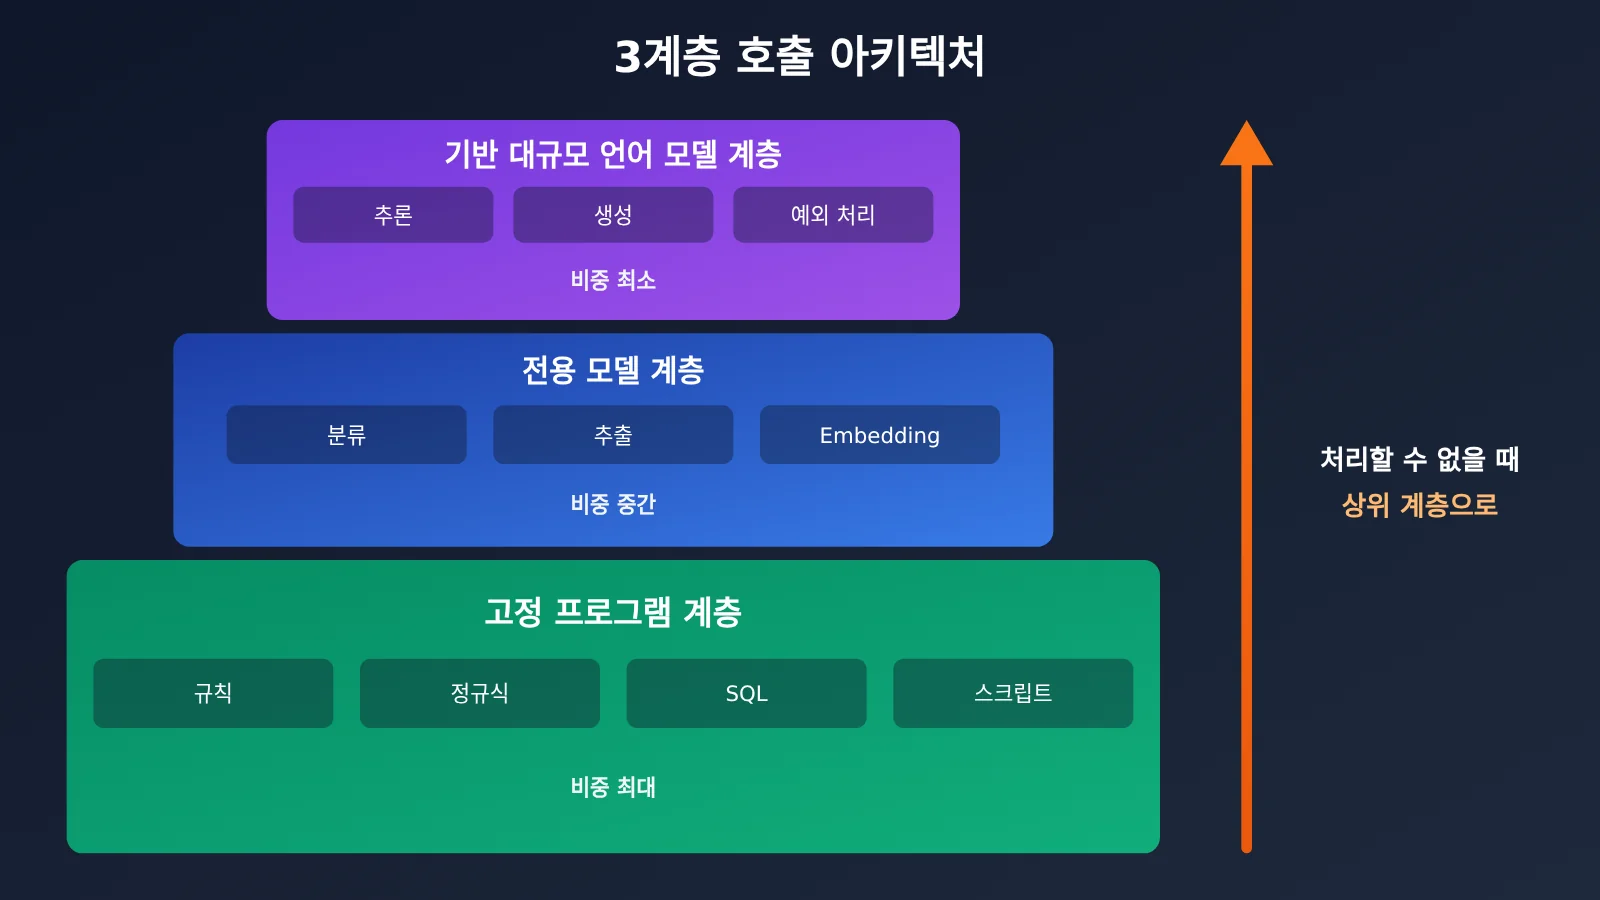
다음 단계는 대체로 “나사 조이기”에 해당해요. 결과가 정해져 있고 반복되는 작업이라, 대규모 언어 모델을 쓰면 오히려 안정성이 떨어질 수 있어요.
- 형식 검증과 정제: 이메일, 휴대전화 번호, JSON 구조, 필수 필드 검사는 정규식과 Schema 검증으로 충분해요.
- 데이터 조회와 계산: 주문 상태, 재고 수량, 금액 합계는 데이터베이스를 직접 조회하거나 업무 인터페이스를 호출하세요. 대규모 언어 모델이 “추산”하게 해서는 안 돼요.
- 고정 템플릿 출력: 알림 문자, 표준 확인서, 보고서 표 머리글은 템플릿 엔진으로 변수를 채우면 돼요.
- 흐름 제어와 재시도: 분기 처리, 타임아웃 재시도, 요청 제한과 대기열 처리는 오케스트레이션 계층의 로직이므로 모델이 필요하지 않아요.
- 자주 반복되는 요청의 캐시 조회: 같은 질문이 반복되면 먼저 캐시나 FAQ 데이터베이스를 조회하고, 일치하는 답이 있으면 바로 반환하세요.
대규모 언어 모델의 판단이 필요한 단계
반대로 범용 대규모 언어 모델을 호출할 가치가 있는 경우는 “전화기 너머의 엄마만 답할 수 있는 질문”과 같아요. 사용자 의도가 모호해 추가 확인이 필요하거나, 여러 자료를 종합해 결론을 작성해야 할 때, 규칙이 다루지 못하는 예외 상황을 만났을 때, 창의적인 콘텐츠를 생성해야 할 때가 여기에 해당하죠. 이런 단계는 정답이 하나가 아니고, 규칙을 모두 열거할 수 없으며, 발생 빈도가 상대적으로 낮다는 공통점이 있어요.
전용 모델은 그 중간에 있어요. 의도 분류, 개체 추출, 감정 판단, 텍스트 벡터화 같은 작업은 작은 모델로도 충분히 처리할 수 있는 경우가 많아요. 소프트웨어 버전의 “체화 모델”이라고 생각하면 돼요. 스스로 할 수 있는 일은 처리하고, 처리하지 못하는 상황은 명확한 질문으로 정리해 상위 계층에 전달하는 거죠.
AI 워크플로 계층별 설계 예시: 대규모 언어 모델이 필요 없는 단계는 먼저 걸러내기
흔히 볼 수 있는 ‘고객 지원 티켓 자동 처리’ 흐름을 예로 들어, 모델 호출 범위를 각 단계에서 어떻게 정할 수 있는지 살펴볼게요. 실제 프로젝트의 측정 데이터가 아닌 설계 예시예요.
| 워크플로 단계 | 담당 계층 | 처리 방식 | 토큰 사용 여부 |
|---|---|---|---|
| 티켓 필드 검증 | 고정 프로그램 | 스키마 검증 후 누락된 필드가 있으면 즉시 반려 | 아니요 |
| 주문 및 배송 상태 조회 | 고정 프로그램 | 비즈니스 데이터베이스 인터페이스 호출 | 아니요 |
| 자주 묻는 질문 매칭 | 고정 프로그램 / 전용 모델 | 키워드 규칙을 우선 적용하고, 매칭되지 않으면 벡터 검색 사용 | 소량 |
| 의도 분류 | 전용 모델 | 소형 모델이 정해진 분류 중 하나를 출력 | 소량 |
| 복잡한 불만 및 예외 처리 | 기반 대규모 언어 모델 | 주문 맥락을 바탕으로 처리 방안 생성 | 예 |
| 답변 템플릿 채우기 | 고정 프로그램 | 템플릿 엔진으로 최종 텍스트 출력 | 아니요 |
6단계 중 기반 대규모 언어 모델을 반드시 호출해야 하는 단계는 하나뿐이에요. 실제 토큰 절감량, 성공률 하락 여부, 지연 시간 변화는 트래픽 구성과 규칙 적용 범위에 따라 달라지므로 실제 로그로 평가해야 해요.
최소 예제: 규칙을 우선 적용하고, 모델로 나머지 처리하기
다음 코드는 최소한의 계층별 라우팅 방식을 보여줘요. 먼저 규칙으로 단순한 ‘나사형’ 요청을 처리하고, 나머지는 소형 모델로 분류해요. 복잡한 경우에만 대규모 언어 모델을 호출합니다. 모델 이름은 예시이므로 플랫폼에서 실제로 사용 가능한 모델 목록을 확인하세요.
import re
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

def handle(query: str) -> str:
    # 첫 번째 계층: 고정 프로그램으로, 규칙으로 해결할 수 있으면 모델을 호출하지 않음
    if re.search(r"(订单号|单号)\s*[::]?\s*\d{8,}", query):
        return "已为您查询订单状态(走业务接口,不消耗 token)"
    # 두 번째 계층: 소형 모델로 의도 분류
    intent = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": f"只输出类别(咨询/投诉/其他):{query}"}],
        max_tokens=5,
    ).choices[0].message.content.strip()
    if intent != "投诉":
        return f"已归类为:{intent},转入标准流程"
    # 세 번째 계층: 복잡한 불만 사항에만 기반 대규모 언어 모델 호출
    return client.chat.completions.create(
        model="claude-sonnet-4",
        messages=[{"role": "user", "content": f"请给出投诉处理建议:{query}"}],
    ).choices[0].message.content
사용량 기록이 포함된 전체 구현 코드 보기
import re
import time
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SMALL_MODEL = "gpt-4o-mini"       # 예시: 분류 및 추출용 소형 모델
LARGE_MODEL = "claude-sonnet-4"   # 예시: 복잡한 추론용 대규모 언어 모델

@dataclass
class UsageLog:
    records: list = field(default_factory=list)

    def add(self, layer: str, tokens: int, latency: float):
        self.records.append({"layer": layer, "tokens": tokens, "latency": latency})

    def summary(self):
        result = {}
        for r in self.records:
            s = result.setdefault(r["layer"], {"count": 0, "tokens": 0, "latency": 0.0})
            s["count"] += 1
            s["tokens"] += r["tokens"]
            s["latency"] += r["latency"]
        return result

log = UsageLog()

RULES = [
    (re.compile(r"(订单号|单号)\s*[::]?\s*\d{8,}"), "order_lookup"),
    (re.compile(r"(营业时间|几点开门)"), "faq_hours"),
]

def rule_layer(query: str):
    for pattern, action in RULES:
        if pattern.search(query):
            return action
    return None

def call_model(model: str, prompt: str, layer: str, max_tokens: int = 512) -> str:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    tokens = resp.usage.total_tokens if resp.usage else 0
    log.add(layer, tokens, time.time() - start)
    return resp.choices[0].message.content.strip()

def handle(query: str) -> str:
    start = time.time()
    action = rule_layer(query)
    if action:
        log.add("rule", 0, time.time() - start)
        return f"[规则层] 执行动作:{action}"

    intent = call_model(
        SMALL_MODEL,
        f"只输出一个类别(咨询/投诉/其他),不要解释:{query}",
        layer="small",
        max_tokens=5,
    )
    if "投诉" not in intent:
        return f"[专用模型层] 归类为:{intent}"

    return call_model(
        LARGE_MODEL,
        f"你是资深客服主管,请针对以下投诉给出处理建议:{query}",
        layer="large",
    )

if __name__ == "__main__":
    for q in ["订单号:2026110612345 到哪了", "你们营业时间是?", "收到的商品破损,客服一直不回复"]:
        print(handle(q))
    print(log.summary())
🚀 빠른 시작 팁: 분层 라우팅의 신뢰할 만한 결과를 얻으려면 같은 인터페이스에서 계층별로 모델을 바꿔 호출하고 사용량을 기록하는 것이 중요해요. APIYI apiyi.com에서 하나의 API 키로 소형 모델과 대규모 언어 모델을 함께 호출하고, 플랫폼 사용량 통계로 각 계층의 토큰 소비량을 비교해 보세요. 신규 사용자는 무료 테스트 크레딧으로 프로토타입을 검증할 수 있어요.
「나사 하나 조일 때마다 토큰 요금을 받지 마세요」의 영향 분석
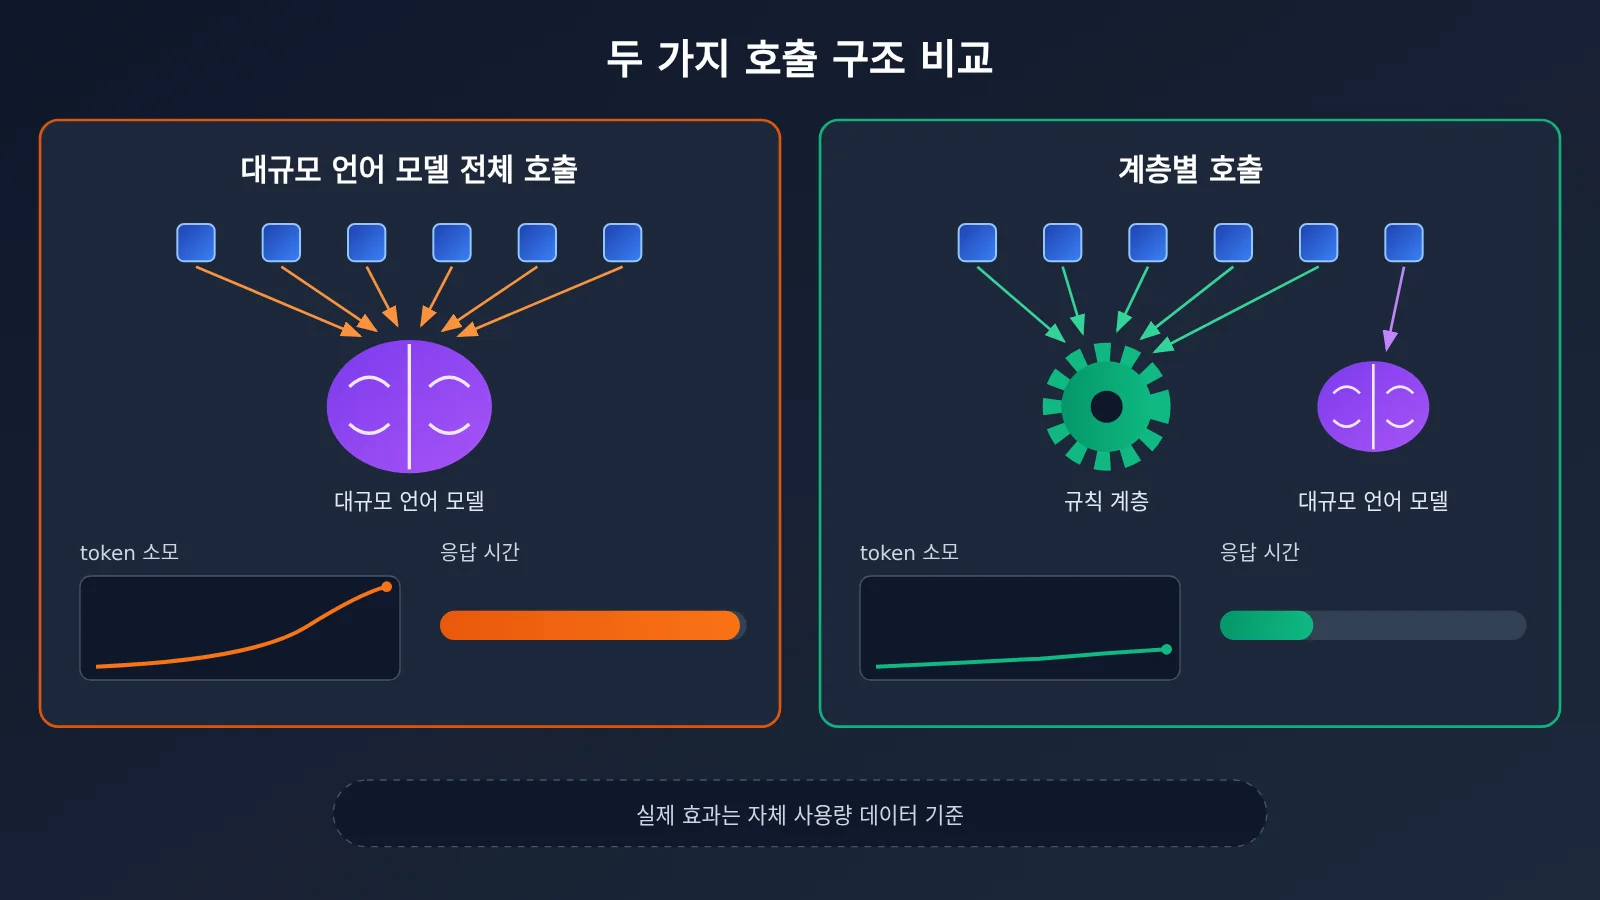
위 그림은 실측값이 아니라 두 설계의 구조적 차이를 보여줘요. 구체적인 비교를 위해서는 APIYI apiyi.com에서 동일한 요청 세트로 두 방식을 각각 실행한 뒤 사용량 기록을 바탕으로 결론을 내리는 것이 좋아요.
| 비교 항목 | 모든 작업에 대규모 언어 모델 호출 | 계층별 호출 | 이용 가능한 플랫폼 |
|---|---|---|---|
| 개발 속도 | 프롬프트만 작성하면 되므로 프로토타입 제작이 가장 빠름 | 규칙과 라우팅을 추가로 정리해야 함 | APIYI apiyi.com, 각 공식 API |
| 토큰 소비 | 모든 단계에서 요금 발생 | 주로 어려운 단계에서만 요금 발생 | 위와 같음 |
| 결과의 결정성 | 결정적인 작업에서도 무작위 편차가 생길 수 있음 | 규칙 계층의 결과는 예측 가능 | 위와 같음 |
| 응답 지연 | 단계마다 모델이 생성할 때까지 기다려야 함 | 규칙 계층은 거의 즉시 응답 | 위와 같음 |
| 유지보수 비용 | 프롬프트가 계속 길어짐 | 비즈니스 변화에 맞춰 규칙을 업데이트해야 함 | 위와 같음 |
워크플로 빌더와 개발자에게 미치는 영향
- 설계 순서가 바뀌어요: 더 이상 “대규모 언어 모델부터 연결한 뒤 비용을 줄일 방법을 찾는” 게 아니에요. 먼저 모든 단계를 나열하고 어떤 단계가 “나사”에 해당하는지 표시한 다음, 모델을 어디에 배치할지 결정해요.
- 전용 모델의 배치가 더 중요해져요: 체화 모델이 물리적 상태를 자연어로 바꾸듯, 중간 계층은 모호한 입력을 구조화된 문제로 정리해 대규모 언어 모델이 매번 더 명확한 작업에 집중하도록 도와줘요.
- 관측 가능성이 필수가 돼요: 계층을 나눈 뒤에는 호출 횟수, 토큰, 지연 시간을 계층별로 기록해야 해요. 그래야 특정 계층의 작업을 상위 또는 하위 계층으로 옮길지 판단할 수 있어요.
제품 책임자에게 미치는 영향
- 비용 모델을 더 예측하기 쉬워져요: 결정적인 단계에서는 토큰 비용이 들지 않고, 비용은 주로 예상 가능한 어려운 요청에 집중돼요.
- “더 똑똑하다고 항상 좋은 것은 아니다”라는 점을 받아들여야 해요: 주문 조회를 대규모 언어 모델에 맡기면 더 똑똑해 보이지만, 사용자가 진정 원하는 것은 정확성과 속도예요.
- 검증 지표를 미리 정해야 해요: 계층 분리 전후의 토큰 소비량, 작업 성공률, 엔드투엔드 지연 시간을 출시 전 비교 기준으로 삼아야 해요.
업계에 미치는 영향
라이제의 관점은 하나의 방향을 보여줘요. 기반 대규모 언어 모델이 점점 강력해진다고 해서 모든 기능을 하나의 모델에 넣어야 하는 것은 아니에요. 오히려 서로 다른 능력을 가진 “에이전트”가 각자의 역할을 맡는 거죠. 소프트웨어 분야에서도 이는 도구 호출과 에이전트 오케스트레이션의 발전 방향과 일치해요. 다만 인터뷰에서 다룬 것은 로봇 시나리오예요. 이 방식이 소프트웨어 워크플로에서 얼마나 효과적인지는 공개된 사례 데이터가 아직 부족하므로 더 많은 팀의 실험을 통해 검증해야 해요.
자주 묻는 질문 FAQ
Q1: “나사 하나 조일 때마다 토큰 비용을 받지 마세요”라는 말은 무슨 뜻인가요?
스타더스트 인텔리전스 창업자 라이제가 2026년 11월 아이판얼 인터뷰에서 한 말이에요. 공장에서 로봇이 나사를 조이는 반복 작업은 정해진 프로그램으로 24시간 수행해야지, 동작할 때마다 모델을 호출하고 토큰 비용을 지불해서는 안 된다는 뜻이에요. AI 애플리케이션에 적용하면 결과가 정해져 있고 빈도가 높은 단계에는 대규모 언어 모델을 호출하지 말아야 한다는 의미예요.
Q2: 로봇의 계층화 방식을 소프트웨어 워크플로에 그대로 적용할 수 있나요?
그대로 동일하게 적용할 수는 없어요. 로봇은 실시간 제어, 촉각 인지, 통신 대역폭을 고려해야 하지만, 소프트웨어 워크플로는 주로 토큰 비용, 지연 시간, 안정성의 영향을 받아요. 다만 “실행 계층에서 자체 처리하고, 어려운 문제만 상위 계층으로 넘긴다”는 분업 방식은 참고할 수 있어요. 구체적인 효과는 실제 사례로 검증해야 해요.
Q3: 어떤 단계에 소형 모델과 대규모 언어 모델 중 무엇을 써야 할지 어떻게 판단하나요?
출력의 종류가 제한적인지, 규칙이 안정적인지 살펴보세요. 의도 분류나 필드 추출처럼 출력 범주가 제한되어 있고 패턴이 안정적인 작업에는 소형 모델을 먼저 시도해 보세요. 종합적인 추론, 자유로운 생성, 예외 처리가 필요한 작업은 대규모 언어 모델에 맡기면 돼요. APIYI apiyi.com에서 같은 샘플로 여러 모델을 테스트하고, 정확도와 사용량을 비교한 뒤 결정하는 것을 권장해요.
Q4: 계층화하면 반드시 비용을 줄일 수 있나요?
꼭 그렇지는 않아요. 요청 대부분이 복잡한 문제라 규칙 계층에서 처리할 수 있는 양이 적다면 계층화의 효과도 제한적이에요. 규칙을 지나치게 넓게 설정해 요청을 잘못 처리하면 성공률이 떨어질 수도 있어요. 먼저 현재 상태를 기록한 다음 계층화 전후의 토큰 사용량, 성공률, 지연 시간을 비교하세요.
Q5: 계층별 모델 호출 프로토타입을 빠르게 구축하려면 어떻게 해야 하나요?
다음 순서로 진행해 보세요.
1. 워크플로의 모든 단계를 나열하고 “나사 조이기형” 단계를 표시해 규칙으로 구현해요.
2. APIYI apiyi.com에 가입해 API 키를 발급받고, OpenAI 호환 인터페이스로 소형 모델과 대규모 언어 모델을 함께 연동해요.
3. 이 글의 코드를 참고해 라우팅을 구현하고, 계층별로 토큰 사용량과 지연 시간을 기록해요.
통합 인터페이스를 사용하면 `model` 파라미터만 바꿔 모델을 전환할 수 있어 반복 비교가 편리해요.
Q6: 계층 설계에서 흔히 겪는 문제는 무엇인가요?
– **규칙의 무분별한 증가**: 규칙이 계속 늘어나면 프롬프트보다 유지보수하기 어려워져요. 주기적으로 정리해야 해요.
– **계층 간 정보 손실**: 소형 모델이 분류한 뒤 컨텍스트를 대규모 언어 모델에 전달하지 않으면 같은 내용을 다시 파악해야 해요.
– **대체 경로 부재**: 규칙과 소형 모델 모두 판단에 실패할 때 대규모 언어 모델이나 사람에게 넘기는 경로가 있어야 해요.
「나사 하나 조일 때마다 토큰 비용을 청구하지 마세요」 핵심 요점 Key Takeaways
- 의견 출처: 2026년 11월 아이판얼이 진행한 스타더스트 인텔리전스 라이제의 단독 인터뷰에 나온 창업자의 의견이에요.
- 역할 분담: 실행 계층이 직접 동작을 수행하고, 어려운 문제에서만 기반 대규모 언어 모델에 질문해 맥락을 보충해요.
- 5가지 나사 조이기 단계: 형식 검증, 데이터 조회, 템플릿 출력, 프로세스 제어, 캐시 적중에는 대규모 언어 모델을 호출하지 않아야 해요.
- 3계층 구조: 고정 프로그램을 기반으로 하고, 전용 모델을 중간에 배치하며, 기반 대규모 언어 모델은 개방형 문제와 예외 상황만 처리해요.
- 비유의 한계: 로봇 분야의 결론을 소프트웨어에 그대로 적용할 수 없으며, 효과는 자체 데이터로 검증해야 해요.
- 3가지 검증 지표: 계층화 전후의 토큰 사용량, 작업 성공률, 엔드투엔드 지연 시간을 비교해요.
- 시작하는 방법: APIYI apiyi.com의 통합 인터페이스로 각 계층의 모델을 전환하고 사용량을 확인할 수 있어요.
정리
「나사 하나 조일 때마다 토큰 비용을 청구하지 마세요」라는 말은 결국 AI 워크플로에서 어디까지 모델을 호출할지 다시 살펴보자는 뜻이에요.
- 먼저 나사를 찾아요: 결과가 확정적이고, 빈도가 높으며, 정답이 하나인 단계는 고정 프로그램에 맡겨요.
- 그다음 전용 모델을 배치해요: 분류 범주가 한정적이고 패턴이 안정적인 작업은 소형 모델로 처리하고, 질문도 정리해요.
- 마지막이 대규모 언어 모델이에요: 개방형 추론, 예외 상황 판단, 창의적인 생성에만 토큰 비용을 지불할 가치가 있어요.
이 방법은 특정 모델이나 특정 시점의 출시에 의존하지 않으므로, Agent 설계 체크리스트로 오래 활용할 수 있어요. 실제로 적용할 때는 비용이 무조건 줄어든다고 가정하지 말고, 자체 비즈니스 로그로 계층화 전후의 차이를 꼭 검증하세요.
계층형 워크플로를 설계하고 있다면 APIYI apiyi.com에서 API 키 하나로 다양한 규모의 모델을 사용할 수 있어요. 각 계층에서 모델을 유연하게 전환하고 사용량 통계를 비교해, 각각의 “나사”를 누가 조일지 데이터로 결정해 보세요.
📚 참고 자료
- 爱范儿 – Stardust Intelligence의 Lai Jie 인터뷰: 「다양성 기업」 코너의 15번째 인터뷰
- 링크:
ifanr.com/1687805 -
설명: 이 글의 ‘나사 조이기와 토큰 비용’ 비유와 체화 모델 및 기반 대규모 언어 모델의 역할 분담에 관한 원출처
-
OpenAI Chat Completions API 문서: OpenAI 호환 API의 매개변수 설명
- 링크:
platform.openai.com/docs/api-reference/chat - 설명:
model,max_tokens,usage등의 필드를 이해하고 계층별 사용량 기록을 구현하는 데 도움이 돼요.
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 홈에서 문의해 주세요. 모델 연동과 사용량 통계에 관한 자세한 내용은 APIYI 문서 센터에서 확인할 수 있어요.