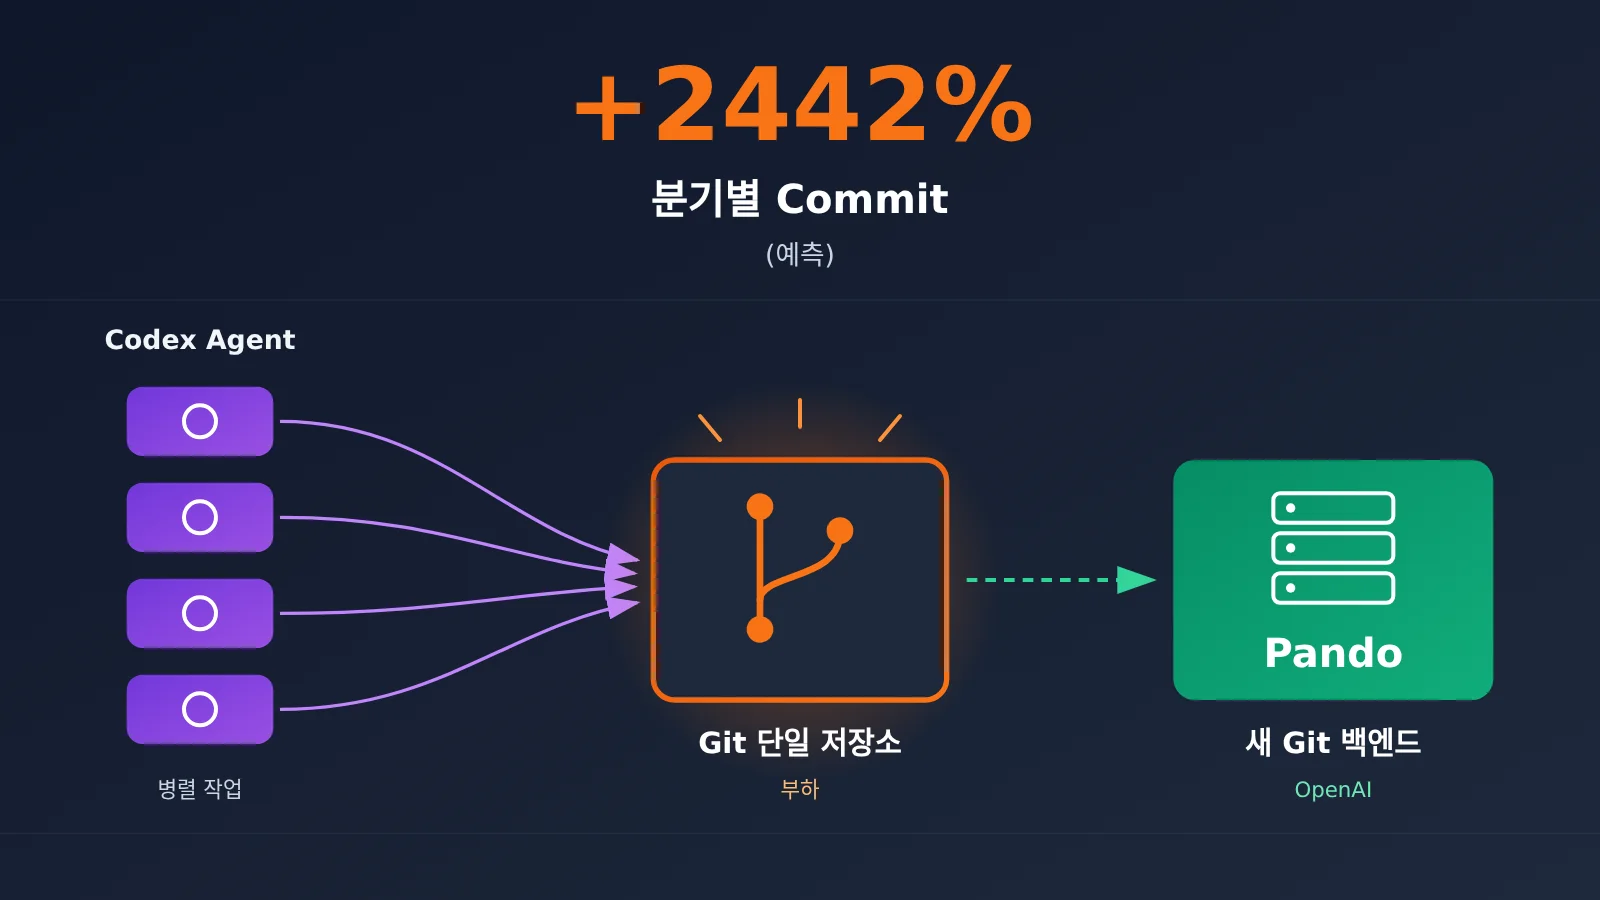
저자 주: OpenAI가 새로운 Git 백엔드 Pando를 공개했어요. Codex의 영향으로 단일 저장소의 분기별 커밋 수는 2024년 1분기 대비 2442% 증가할 것으로 예상돼요. 이 글에서는 AI 코딩의 영향이 코드 생성에서 Git, CI, 코드 리뷰로 어떻게 이어지는지 살펴봅니다.
2026년 11월 2일, OpenAI는 기술 블로그에 《Scaling Git at OpenAI》를 발표했어요. 글에 실린 그래프에 따르면 OpenAI 단일 저장소의 2026년 4분기 커밋 수는 2024년 1분기 대비 2442% 증가할 것으로 예상돼요. OpenAI는 Codex가 불러온 동시 개발 부담을 감당하기 위해 Pando라는 새로운 Git 백엔드를 구축했어요.
이건 풍문도, “AI가 코드량을 24배 폭증시켰다”는 마케팅 구호도 아니에요. 이 수치는 Aaron Friel, Taylor Blau, Ted Nyman 세 기술자가 작성한 OpenAI 공식 엔지니어링 블로그에서 나온 거예요. 먼저 두 가지를 짚고 넘어갈게요. 2442%는 4분기가 끝나기 전의 예측치예요. 또 집계 대상은 master 브랜치에 병합된 커밋 수이지, 코드 줄 수나 생산성이 아니에요.
핵심 내용: 이 글을 읽고 나면 Codex의 ‘병렬 작업’이 OpenAI의 소프트웨어 개발 규모를 어떻게 바꿨는지, Git 인프라에 왜 부담이 생겼는지, 소프트웨어 개발의 병목이 어디로 이동하고 있는지 알 수 있어요.
Codex와 OpenAI Git 인프라: 핵심 정보 한눈에 보기
먼저 표로 핵심 사실을 정리해 볼게요. 아래 내용은 모두 OpenAI의 공식 발표를 바탕으로 했으며, 공개되지 않은 정보는 명확히 표시했어요.
| 항목 | 내용 |
|---|---|
| 발표일 | 2026년 11월 2일, 《Scaling Git at OpenAI》 |
| 발표 주체 | OpenAI 엔지니어링 팀(Aaron Friel, Taylor Blau, Ted Nyman) |
| 핵심 내용 | 표준 Git 프로토콜과 클라이언트에 호환되는 새 Git 서버 백엔드 Pando |
| 직접적인 배경 | Codex로 개발 병렬성이 높아지면서 기존 Git 시스템에 성능과 안정성 문제 발생 |
| 프로덕션 적용 시점 | 2026년 4월부터 프로덕션 트래픽 처리, 프로젝트 시작부터 출시까지 약 10주 |
| 주요 효과 | Push 지연 시간 중앙값이 약 80% 감소, 하루에 약 1 PB의 Git 데이터 전송 |
| 공개 현황 | OpenAI 내부에서만 사용하며, 서버 공개 여부와 가격, 공개 일정은 미정 |
Codex가 이끈 분기별 Commit 증가 추이
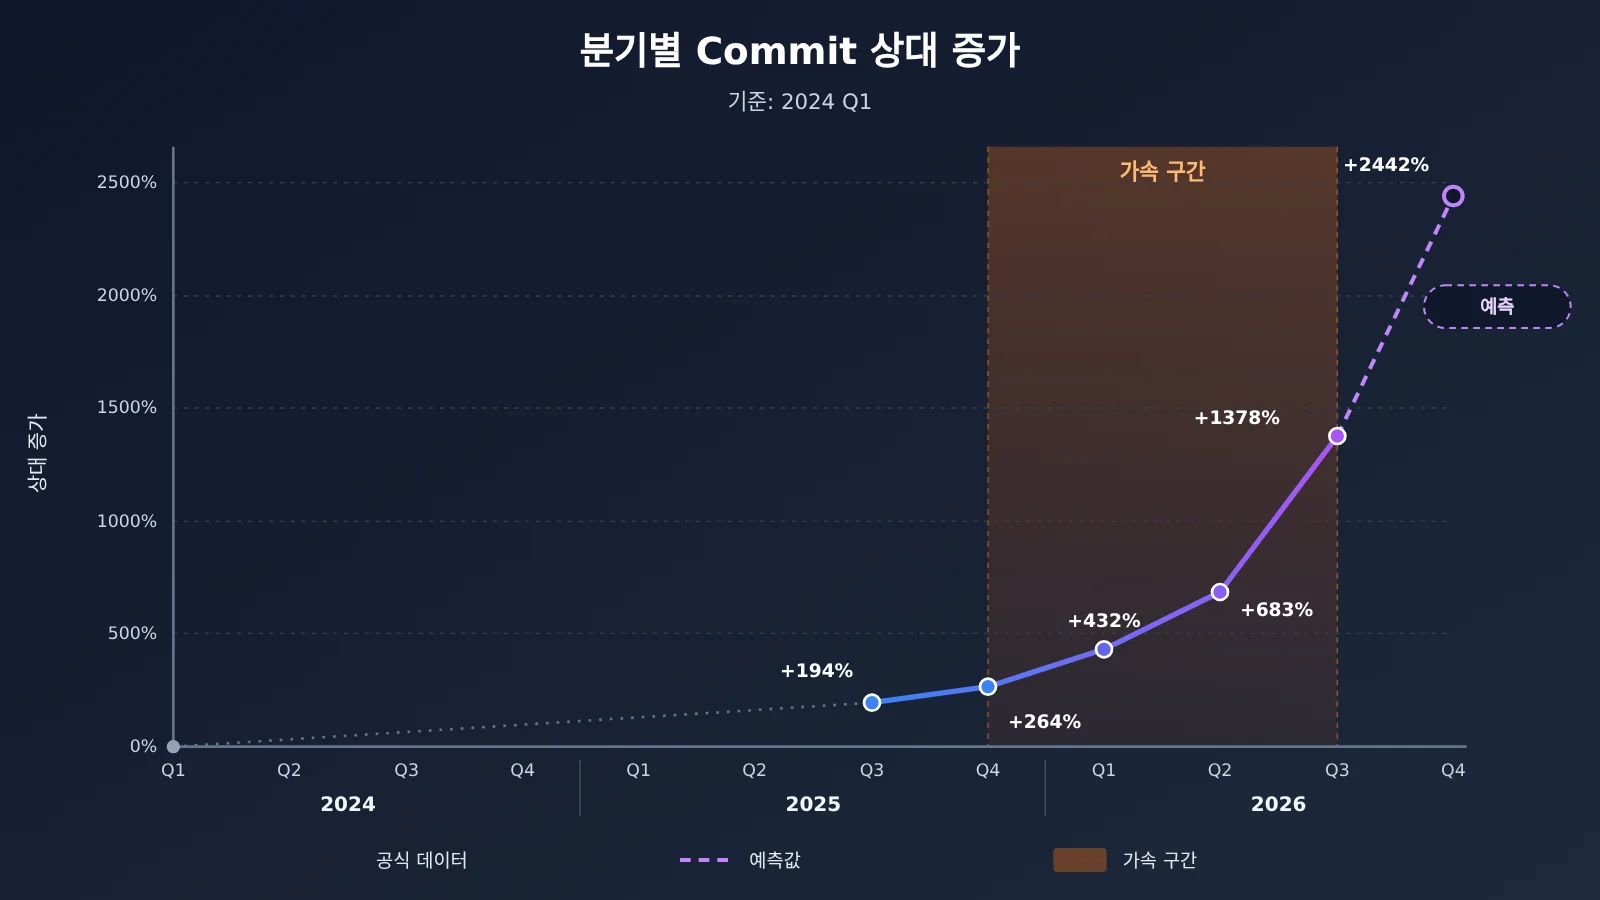
많은 보도가 2,442%라는 수치만 인용해요. 하지만 분기별 추이를 살펴보면 상황을 더 잘 이해할 수 있어요. 아래 표는 2024 Q1을 기준으로 OpenAI 모노레포의 master 브랜치에 병합된 분기별 Commit 수를 비교한 것이에요.
| 분기 | 2024 Q1 대비 증가율 | 기준 분기 대비 약 몇 배 |
|---|---|---|
| 2024 Q2 | +35% | 1.35 |
| 2024 Q4 | +98% | 1.98 |
| 2025 Q2 | +194% | 2.94 |
| 2025 Q4 | +264% | 3.64 |
| 2026 Q1 | +432% | 5.32 |
| 2026 Q2 | +683% | 7.83 |
| 2026 Q3 | +1,378% | 14.78 |
| 2026 Q4 | +2,442%(예측) | 25.42 |
이 데이터에서 세 가지를 알 수 있어요. 첫째, 2024년부터 2025년까지도 증가세가 있었으므로 모든 증가를 Codex 덕분이라고 볼 수는 없어요. 둘째, 2025 Q4의 +264%에서 2026 Q3의 +1,378%로 곡선이 가팔라졌어요. 이 가속 구간은 OpenAI가 설명한 에이전트 병렬 개발 추세와 맞아떨어져요. 셋째, OpenAI는 상대 증가율만 발표했으며 분기별 절대 Commit 수는 공개하지 않았어요.
집계 기준이 다른 또 다른 데이터도 같은 방향을 가리켜요. 2026년 7월 20일 OpenAI 개발자 블로그는 Codex Code Review를 소개하면서 내부 주간 Pull Request 수가 직전 4분기보다 두 배 이상 늘었다고 밝혔어요. 이 수치는 분기별 Commit 증가율과 집계 기준과 기간이 달라 더하거나 서로 환산할 수는 없어요. 다만 두 수치 모두 코드 변경 활동이 빠르게 늘고 있음을 보여줘요.
Codex는 Git 인프라에 어떻게 부담을 줄까요?
직관적으로 생각하면 ‘AI가 코드를 더 빨리 작성한다’는 것은 개발자 개인에게만 영향을 줄 것 같아요. 하지만 OpenAI의 설명은 다른 측면을 가리켜요. Codex는 엔지니어링 시스템 전체에서 동시에 처리하는 작업의 수를 늘립니다. 한 엔지니어가 여러 Agent에게 서로 관련 없는 기능을 동시에 맡길 수 있고, 각 Agent는 브랜치, Commit, Push를 만들어냅니다. 이후 이 작업들은 연쇄적인 자동 읽기를 촉발해요.
아래 표는 OpenAI의 공식 설명을 바탕으로 이 인과관계를 정리한 것입니다.
| 단계 | 어떤 일이 일어나나요? | Git 인프라에 미치는 영향 |
|---|---|---|
| A. 실행 비용 감소 | 엔지니어가 여러 Agent에게 독립적인 기능을 동시에 수정하게 함 | 개발 작업 수 증가 |
| B. 병렬 처리 증가 | 브랜치, Commit, Git Push 증가 | 쓰기 요청과 브랜치 업데이트 증가 |
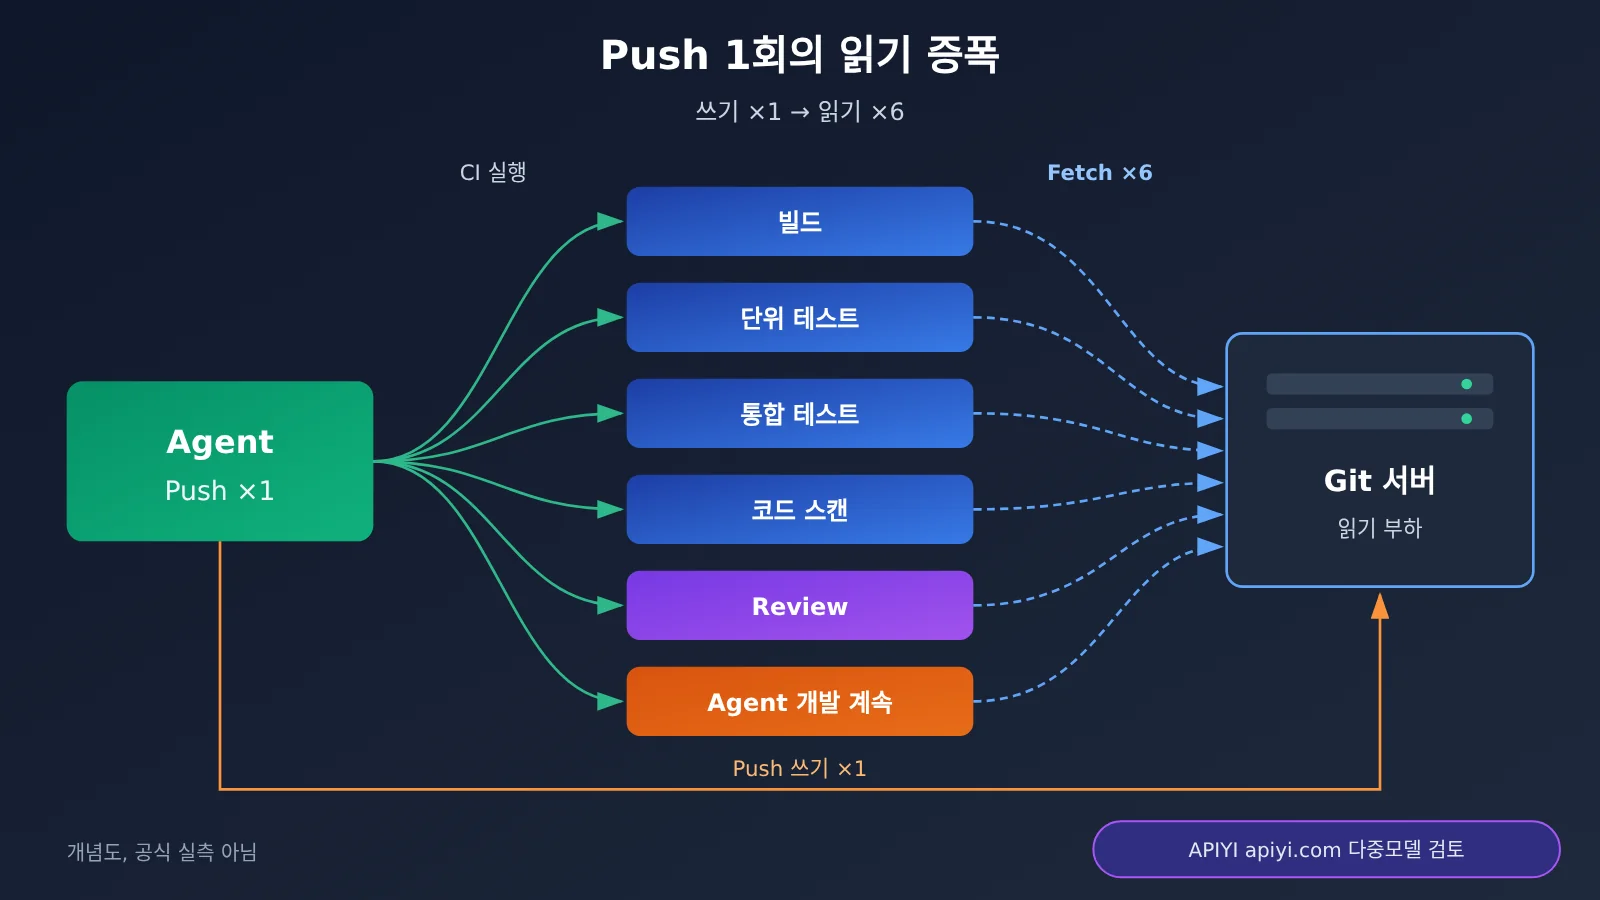
| C. 파이프라인 증폭 | 한 번의 Push가 여러 CI 빌드, 테스트, 스캔을 촉발 | 같은 커밋을 반복해서 Fetch |
| D. 공유 인프라 부담 | 병합, 상태 동기화, 버전 데이터 전달이 동시에 증가 | Push / Fetch 속도 저하, Merge 실패 |
| E. 병목 이동 | 모델의 코드 작성 속도는 빨라졌지만 Git, CI, Review의 처리 용량은 그대로 | 후속 단계에서 배포 속도 저하 |
부하 증폭을 보여주는 예시
아래는 이해를 돕기 위한 예시일 뿐, 수치는 OpenAI의 실제 측정값이 아닙니다. 한 번의 Push가 6개의 CI 작업을 촉발하고, 각 작업이 코드를 한 번씩 Fetch한다고 가정해 볼게요. 그러면 Push 100회로 약 600회의 코드 읽기가 발생할 수 있어요. Agent로 인해 Push 횟수가 몇 배로 늘어나면 읽기량도 그만큼 증가합니다.
실제 요청량은 CI 캐시, 작업 재사용, 빌드 아키텍처의 영향을 받지만, 증가하는 방향은 분명해요. 쓰기 증가는 읽기 측에서 증폭됩니다. Git 서버가 가장 먼저 부담을 느끼는 지점이 바로 여기예요. OpenAI 원문에서도 같은 커밋을 여러 CI 작업, 연구 작업, 개발 환경에서 반복해서 가져올 수 있다고 언급합니다.
OpenAI의 기존 Git 시스템에는 어떤 문제가 있었을까요?
OpenAI에 따르면 2025년 말부터 모노레포를 뒷받침하는 시스템이 늘어나는 부하를 감당하기 어려워졌어요. Git Fetch와 Push가 느려지고 Merge가 실패하는 일이 발생했으며, 인프라 안정성이 때때로 90% 아래로 떨어졌어요.
여기서 “90% 미만”의 의미를 정확히 짚어야 해요. 이는 일부 기간의 시스템 안정성을 나타내며, 구체적인 통계 기준과 전체 기간의 추이는 공개되지 않았어요. 따라서 “코드의 10%에 결함이 있었다”거나 “OpenAI 커밋의 10% 이상이 실패했다”고 해석해서는 안 돼요.
기술적으로 보면 기존 아키텍처에는 두 가지 구조적 병목이 있었어요.
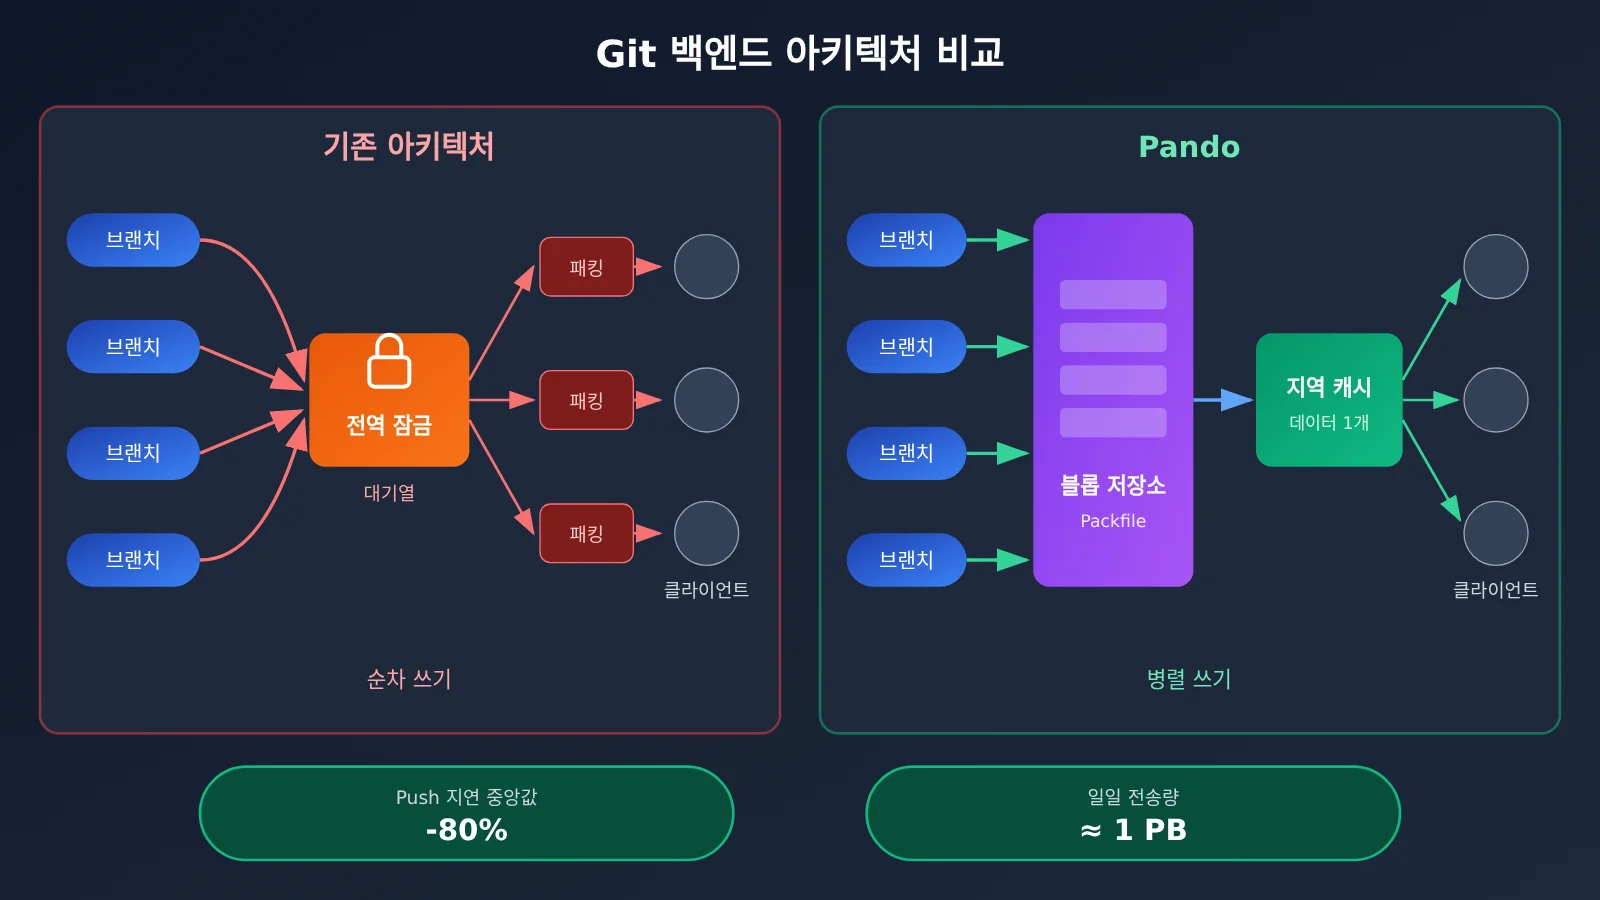
- 브랜치 업데이트에 전역 조율이 필요했어요: 많은 기존 분산 Git 서비스는 저장소 전체 참조의 상태를 일관되게 유지해야 해요. 두 Agent가 서로 전혀 관계없는 브랜치를 수정하더라도 같은 조율 경로에 몰릴 수 있어요.
- 다운로드 패키지를 반복해서 계산했어요: 클라이언트마다 보유한 Git 이력이 다르기 때문에 서버는 각 클라이언트를 위해 객체를 따로 순회하고 패키징하고 압축해야 하는 경우가 많아요. 여러 Agent가 같은 버전을 읽을 때도 비용이 큰 이 작업이 반복됐어요.
사람 엔지니어가 주도하던 시절에는 두 문제를 감내할 수 있었어요. 하지만 수많은 Agent와 CI 작업이 동시에 몰리면서 시스템의 병목이 됐어요.
Pando는 Codex가 가져온 Git 부담에 어떻게 대응했을까요?
OpenAI는 Git을 버리지 않았어요. Pando는 여전히 표준 Git 프로토콜과 클라이언트를 사용하므로 엔지니어의 기존 명령어와 워크플로도 거의 그대로 유지돼요. 새롭게 설계한 부분은 서버 측 스토리지, 참조 업데이트, 데이터 전달 방식이에요. 아래 표에서 기존 방식과 Pando의 주요 차이를 비교해 볼게요.
| 구분 | 기존 Git 서버 | Pando |
|---|---|---|
| 브랜치 쓰기 | 저장소 전체에 걸친 강력한 조정이 필요해 관련 없는 브랜치끼리도 서로 기다릴 수 있음 | 각 브랜치를 독립적으로 업데이트하며, 같은 Ref에서만 조정이 필요함 |
| 일관성 모델 | 저장소 전체의 일관된 스냅샷 | 인과적 일관성, 같은 브랜치에서 순서와 자신이 쓴 내용 읽기 보장 |
| 읽기 데이터 전달 | 클라이언트 상태에 따라 매번 다시 패키징하고 압축 | Push 시 저장한 Packfile을 재사용하고 캐시를 통해 배포 |
| 캐시 | 구현 방식에 따라 다름 | 리전별 캐시 서비스 사용, Packfile 캐시 적중률 99% 이상 |
| 클라이언트 호환성 | 표준 Git | 표준 Git, packfile-uri 메커니즘을 이용해 데이터 전달 |
Pando의 두 가지 핵심 아이디어
첫째는 쓰기 병렬 처리예요. Pando는 전체 저장소에 대해 단일 시점의 일관된 스냅샷을 유지하는 대신, 각 브랜치가 독립적으로 버전을 관리하도록 했어요. 서로 다른 브랜치에 대한 Push는 병렬로 처리할 수 있고, 같은 Ref를 수정하는 요청만 충돌을 처리하면 돼요. 그 대신 여러 브랜치를 한 번에 읽을 때 각 브랜치가 서로 다른 시점의 상태로 보일 수 있어요. OpenAI는 자사의 사용 환경에서는 이런 절충이 적절하다고 판단했어요.
둘째는 읽기 데이터의 재사용이에요. Pando는 Push할 때마다 받은 Packfile을 변경할 수 없는 데이터로 Blob Store에 저장해요. 다른 클라이언트가 Fetch하면 서버는 클라이언트가 이미 가진 Commit과 원하는 Commit을 바탕으로 기존 Packfile을 골라 전달해요. 매번 다시 패키징하지 않는 거죠. 백그라운드에서는 작은 Packfile을 계층적으로 병합해 더 큰 묶음으로 만들어요. 덕분에 오랫동안 업데이트하지 않은 클라이언트도 지나치게 많은 파일을 다운로드하지 않아도 돼요.
공식 운영 데이터에 따르면 Push 지연 시간의 중앙값은 약 80% 감소했고, 하루에 전달하는 Git 데이터는 1 PB에 가까워요. 시간당 Packfile 전달량은 최대 57 TB를 넘었어요. 다만 1 PB는 전달량으로, 같은 데이터를 반복해서 읽은 경우도 포함돼요. 매일 1 PB의 새 코드가 만들어진다는 뜻은 아니에요.
Pando 자체도 에이전트가 개발에 참여한 결과물이라는 점이 흥미로워요. OpenAI에 따르면 핵심 아키텍처는 엔지니어 한 명이 설계했고, 여러 에이전트 팀이 구현에 참여했어요. 검증에는 Git 호환성 테스트 모음과 결정적 시뮬레이션 테스트를 활용했어요. 다만 OpenAI가 모든 코드를 AI가 작성했다고 주장한 것은 아니에요.
AI 프로그래밍의 영향 분석: 병목은 코드 작성에서 다른 단계로 이동하고 있어요
개발자와 팀에 미치는 영향
Pando 사례에서 주목할 점은 OpenAI가 자체 Git 백엔드를 구축했다는 사실보다 그 이면의 원리예요. AI 프로그래밍으로 코드 생성 비용이 낮아지면서 엔지니어링 과정의 후속 단계에 부담이 옮겨가고 있어요. Git은 그 부담이 처음 드러난 곳일 뿐, 코드 리뷰와 테스트, 통합도 같은 압박을 받고 있어요.
OpenAI는 Codex Code Review 관련 글에서 리뷰를 기다리는 PR이 늘고 있다고 직접 인정했어요. 리뷰어가 기존의 제약 조건을 제때 파악하고 API 호환성 위험을 판단하기가 어렵기 때문이에요. 이를 위해 Codex Code Review는 저장소의 AGENTS.md에 정의된 리뷰 규칙을 읽어 기존 API 계약을 보호하고, 고객 데이터가 유출될 수 있는 로그를 식별하며, 기존 서비스 통합이 깨지는 일을 방지할 수 있어요.
일반적인 AI 개발팀이라면 다음과 같은 조정이 필요해요.
- 리뷰 규칙을 문서화하세요: 팀의 암묵적인 제약 조건을 AGENTS.md와 같은 규칙 파일에 정리해 AI 리뷰의 근거로 활용하세요.
- CI에 여유 용량을 확보하세요: 에이전트를 병렬로 실행하면 인력 비용이 늘기 전에 CI 작업 수가 먼저 증가할 수 있어요. 캐시와 동시 실행 할당량을 미리 점검하세요.
- 측정 지표를 다시 선택하세요: Commit이나 PR 수만 보지 말고 전달 주기와 변경 실패율도 함께 살펴보세요.
- 검증 역량을 우선하세요: 테스트 커버리지, 시뮬레이션 테스트, 호환성 테스트가 에이전트의 결과물을 안심하고 병합할 수 있는지 결정해요.
여러 모델을 활용한 AI 코드 리뷰 최소 예제
저장소에서 ‘규칙에 따라 Diff를 리뷰하는’ 과정을 시험해 보고 싶다면 OpenAI 호환 인터페이스로 빠르게 프로토타입을 만들 수 있어요. 다음 예제는 로컬 Diff를 읽고 모델이 규칙에 따라 리뷰 의견을 제시하도록 합니다.
import openai, subprocess

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
diff = subprocess.run(["git", "diff", "HEAD~1"], capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="YOUR_MODEL",  # 플랫폼에서 사용할 수 있는 프로그래밍 모델로 교체하세요
    messages=[{"role": "user", "content": f"请审查以下改动,重点关注 API 兼容性和日志泄露风险:\n{diff}"}],
)
print(resp.choices[0].message.content)
전체 구현 코드 보기(AGENTS.md 규칙 읽기 + 여러 모델 비교)
import subprocess
from pathlib import Path
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # 하나의 키로 여러 제공업체의 모델 호출
)

def load_rules(path: str = "AGENTS.md") -> str:
    """저장소의 리뷰 규칙을 읽고, 없으면 기본 규칙을 반환합니다."""
    p = Path(path)
    if p.exists():
        return p.read_text(encoding="utf-8")
    return "1. 不得破坏已有 API 契约\n2. 日志中不得输出客户数据\n3. 不得破坏已有服务集成"

def get_diff(base: str = "HEAD~1") -> str:
    """리뷰할 Diff를 가져옵니다."""
    return subprocess.run(
        ["git", "diff", base], capture_output=True, text=True
    ).stdout

def review(diff: str, rules: str, model: str) -> str:
    """규칙에 따라 모델을 호출해 코드 변경 사항을 리뷰합니다."""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": f"你是严格的代码审查者,请依据以下仓库规则审查:\n{rules}"},
            {"role": "user", "content": f"待审查 Diff:\n{diff}\n请逐条列出风险点和修改建议。"},
        ],
        max_tokens=1500,
    )
    return resp.choices[0].message.content

if __name__ == "__main__":
    rules, diff = load_rules(), get_diff()
    # 비교할 모델 이름으로 교체하고 모델별 리뷰 차이를 확인하세요
    for model in ["MODEL_A", "MODEL_B"]:
        print(f"===== {model} =====")
        print(review(diff, rules, model))
🚀 빠른 시작 팁: AI 코드 리뷰 프로토타입을 만들 때 APIYI apiyi.com에서 무료 테스트 크레딧을 받을 수 있어요. 하나의 API 키로 OpenAI, Claude, Gemini 등의 모델을 호출할 수 있어 저장소 규칙에 따른 모델별 리뷰 품질을 비교하기 편리합니다.
업계에 미치는 영향
The New Stack은 OpenAI가 Agent Coding을 초기에 적극적으로 사용한 기업이며, 그 과정에서 겪은 인프라 압박이 다른 대기업과 코드 호스팅 플랫폼이 앞으로 마주할 문제를 예고할 수 있다고 봤어요. 이는 매체의 추세 분석이지, GitHub나 GitLab에서 이미 같은 장애가 발생했다는 증거는 아니에요.
개발자 커뮤니티의 의견도 엇갈려요. 낙관론자들은 코딩 비용이 낮아지면 이전에는 투자할 가치가 없던 소규모 프로젝트도 실현할 수 있다고 봐요. 반면 회의론자들은 Commit이 늘어도 소프트웨어의 가치가 높아지는 것은 아니며, 리뷰와 테스트가 따라가지 못하면 전체 배포 속도도 빨라지지 않을 수 있다고 지적해요. 대형 Monorepo의 규모 문제는 AI 시대 이전부터 있었다는 의견도 있어요.
Codex 데이터 이해하기: 혼동하면 안 되는 다섯 가지 지표
AI 프로그래밍의 효과를 논할 때 가장 흔한 실수는 서로 다른 지표를 혼동하는 거예요. 아래 표를 보면 각 데이터로 무엇을 알 수 있고, 무엇은 알 수 없는지 판단할 수 있어요.
| 지표 | 무엇을 측정하나요? | 이번 뉴스에서의 상황 |
|---|---|---|
| Commit 수 | 버전 커밋 빈도 | 분기 증가율 +2,442% 예상, 상대값만 공개 |
| PR 수 | 변경 제안 및 병합 활동 | 주간 PR이 이전 Q4보다 두 배 이상 증가 |
| 코드 줄 수 | 코드 규모 | 비공개, Commit 증가율로 추산 불가 |
| Lead Time | 변경 시작부터 배포까지 걸리는 시간 | 비공개 |
| 변경 실패율 | 배포 후 장애를 일으킨 변경의 비율 | 비공개 |
Pando 사례가 보여주는 것은 OpenAI의 코드 개발 부하가 크게 늘면서 기존 Git 인프라에 병목이 발생했다는 사실이에요. 소프트웨어 품질이나 개발자 생산성이 같은 배율로 증가했다는 뜻은 아니며, Codex가 엔지니어 몇 명을 대체했는지 추산할 수도 없어요.
또한 OpenAI가 2026년 2월에 발표한 Harness Engineering은 별개의 실험이에요. 빈 저장소에서 시작해 약 5개월 만에 100만 줄 규모의 프로젝트를 완성했으며, 누적 PR은 약 1,500개였어요. Pando와 무관한 다른 프로젝트의 데이터지만, 엔지니어의 업무 중심이 아키텍처, 도구 체인, 피드백 루프, 코드 검수로 이동하고 있다는 추세를 보여줘요.
💡 선택 팁: 팀에 Coding Agent를 도입한다면 먼저 소규모로 모델별 코드 생성 및 리뷰 성능을 비교해 보세요. APIYI apiyi.com의 통합 인터페이스로 모델을 빠르게 전환하고 같은 테스트 케이스로 평가한 뒤, 주력 모델을 결정할 수 있어요.
자주 묻는 질문 FAQ
Q1: Codex 덕분에 OpenAI의 코드량이 정말 24배 늘었나요?
그렇게 해석하면 안 돼요. 공식 수치는 “master에 병합되는 분기별 Commit 수가 2024년 1분기 대비 2442% 증가할 것으로 예상된다”는 뜻이에요. 이는 코드 줄 수가 아닌 Commit 수에 대한 예측치예요. Commit마다 변경 규모가 다르므로 코드량이나 생산성과 같다고 볼 수 없어요.
Q2: Pando는 GitHub의 대안인가요?
아니요. Pando는 표준 Git 프로토콜과 호환되는 서버 백엔드로, OpenAI 내부에서만 사용해요. 2026년 11월 3일 기준으로 서버, 가격, 공개 일정은 발표되지 않았어요. OpenAI가 공개한 것은 개선된 Git 클라이언트 저장소이며, 일부 변경 사항은 업스트림 Git에 기여했어요. Pando 서버가 오픈소스로 공개된 것은 아니에요.
Q3: 일반 팀도 OpenAI처럼 Git 인프라를 새로 구축해야 하나요?
대부분은 그럴 필요가 없어요. OpenAI는 초대형 모노레포와 높은 수준의 Agent 동시 실행을 처리해야 해요. 중소 규모 팀에서는 CI 할당량, 테스트 커버리지, 코드 리뷰 인력이 더 현실적인 병목인 경우가 많으므로, 이 부분부터 보완하는 게 좋아요.
Q4: AI 코드 리뷰나 Coding Agent 워크플로를 저렴하게 시험해 보려면 어떻게 해야 하나요?
먼저 OpenAI 호환 인터페이스로 최소한의 프로토타입을 만들 수 있어요. 이 글의 코드 예제처럼 Diff와 규칙 파일을 읽어 모델에 리뷰를 맡기면 돼요. APIYI apiyi.com에 가입하면 무료 테스트 크레딧을 받을 수 있어요. base_url을 `https://api.apiyi.com/v1`로 바꾸면 하나의 Key로 여러 모델의 리뷰 결과를 비교할 수 있어요.
Q5: AI 코딩이 품질 낮은 코드만 더 많이 만들어내는 건 아닐까요?
이 부분은 커뮤니티에서도 논쟁 중이며, 아직 결론이 나지 않았어요. OpenAI는 결함률, 롤백률, 순 개발 비용의 변화를 공개하지 않았어요. 따라서 품질이 전반적으로 떨어졌다고도, 높아졌다고도 말할 수 없어요. 팀에서 배포 주기와 변경 실패율을 함께 추적하는 것이 더 안전한 방법이에요. APIYI apiyi.com으로 여러 모델을 연결해 교차 리뷰하면 단일 모델이 문제를 놓칠 위험도 줄일 수 있어요.
Codex와 Git 인프라의 변화: 핵심 요약
- 수치를 정확히 해석해야 해요: 2442%는 코드 줄 수가 아니라 2026년 4분기 Commit 수의 예상 증가율이에요.
- 증가세가 뚜렷하게 가속됐어요: 2025년 4분기 이후 그래프가 가팔라졌지만, 증가세는 2024년부터 이어졌어요.
- 부하의 원인은 동시성이에요: Codex가 작업 병렬도를 높이면서 쓰기 증가의 영향이 CI의 읽기 작업에서 증폭됐어요.
- 기존 시스템은 한계에 부딪혔어요: 2025년 말부터 Push와 Fetch가 느려졌고, 안정성이 때로는 90% 아래로 떨어졌어요.
- Pando의 해결 방식: 브랜치별 독립 쓰기, Packfile 재사용과 캐싱을 통해 Push 지연 시간의 중앙값을 약 80% 줄였어요.
- 병목이 후속 단계로 이동했어요: 코드 리뷰, 테스트, 통합, 배포가 새로운 제약 요인이 됐어요.
- 시작하기: APIYI apiyi.com의 통합 인터페이스로 여러 모델을 활용한 리뷰 프로토타입을 빠르게 구축해 보세요.
정리
Codex가 OpenAI에 가져온 변화는 크게 세 가지로 정리할 수 있어요.
- 규모: 단일 저장소의 분기별 Commit 수가 2024년 1분기 대비 2442% 증가할 것으로 예상돼요. PR 수도 두 배로 늘어나는 등 코드 변경 활동이 크게 늘었어요.
- 인프라: 병렬 Agent로 인해 브랜치, Push, CI 읽기 작업이 늘면서 기존 Git 백엔드에 성능과 안정성 문제가 발생했어요. OpenAI는 이에 대응하기 위해 약 10주 만에 Pando를 구축했어요.
- 엔지니어링 프로세스: 코드 작성은 더 이상 가장 느린 단계가 아니에요. 리뷰, 테스트, 배포 역량이 AI 코딩을 실제 가치로 전환할 수 있는지를 결정해요.
대부분의 팀은 Commit 수를 늘리는 데 집중하기보다 결과물 검증과 리뷰 역량부터 갖추고, Agent의 병렬 규모를 단계적으로 확대하는 편이 좋아요. AI 리뷰나 Coding Agent 워크플로를 빠르게 검증하고 싶다면 APIYI apiyi.com의 무료 사용량을 통해 여러 모델의 실제 성능을 비교해 보세요.
📚 참고 자료
- Scaling Git at OpenAI: OpenAI의 Pando 기술 관련 공식 글(2026-11-02)
- 링크:
openai.com/index/scaling-git-at-openai -
설명: 이 글의 주요 사실과 분기별 커밋 증가 데이터의 출처
-
Custom Code Review rules for Codex: OpenAI 개발자 블로그(2026-07-20)
- 링크:
developers.openai.com/blog/custom-code-review-rules-for-codex -
설명: 주간 PR 수가 두 배로 늘었다는 내용과 AGENTS.md 검토 규칙의 출처
-
Harness engineering: OpenAI의 독립적인 에이전트 개발 실험(2026-02-11)
- 링크:
openai.com/index/harness-engineering -
설명: 엔지니어 역할의 변화를 이해하기 위한 별도 사례로, Pando 프로젝트와는 무관
-
OpenAI Git Fork: OpenAI가 유지 관리하는 Git 클라이언트 공개 저장소
- 링크:
github.com/openai/git -
설명: packfile-uri 등 클라이언트 개선 사항 확인
-
The New Stack 보도: 외부 매체의 Pando 관련 분석(2026-11-02)
- 링크:
thenewstack.io - 설명: 업계 동향을 파악하기 위한 참고 자료
작성자: APIYI 기술팀
기술 문의: APIYI 공식 홈페이지에서 문의해 주세요. 더 많은 모델 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다.