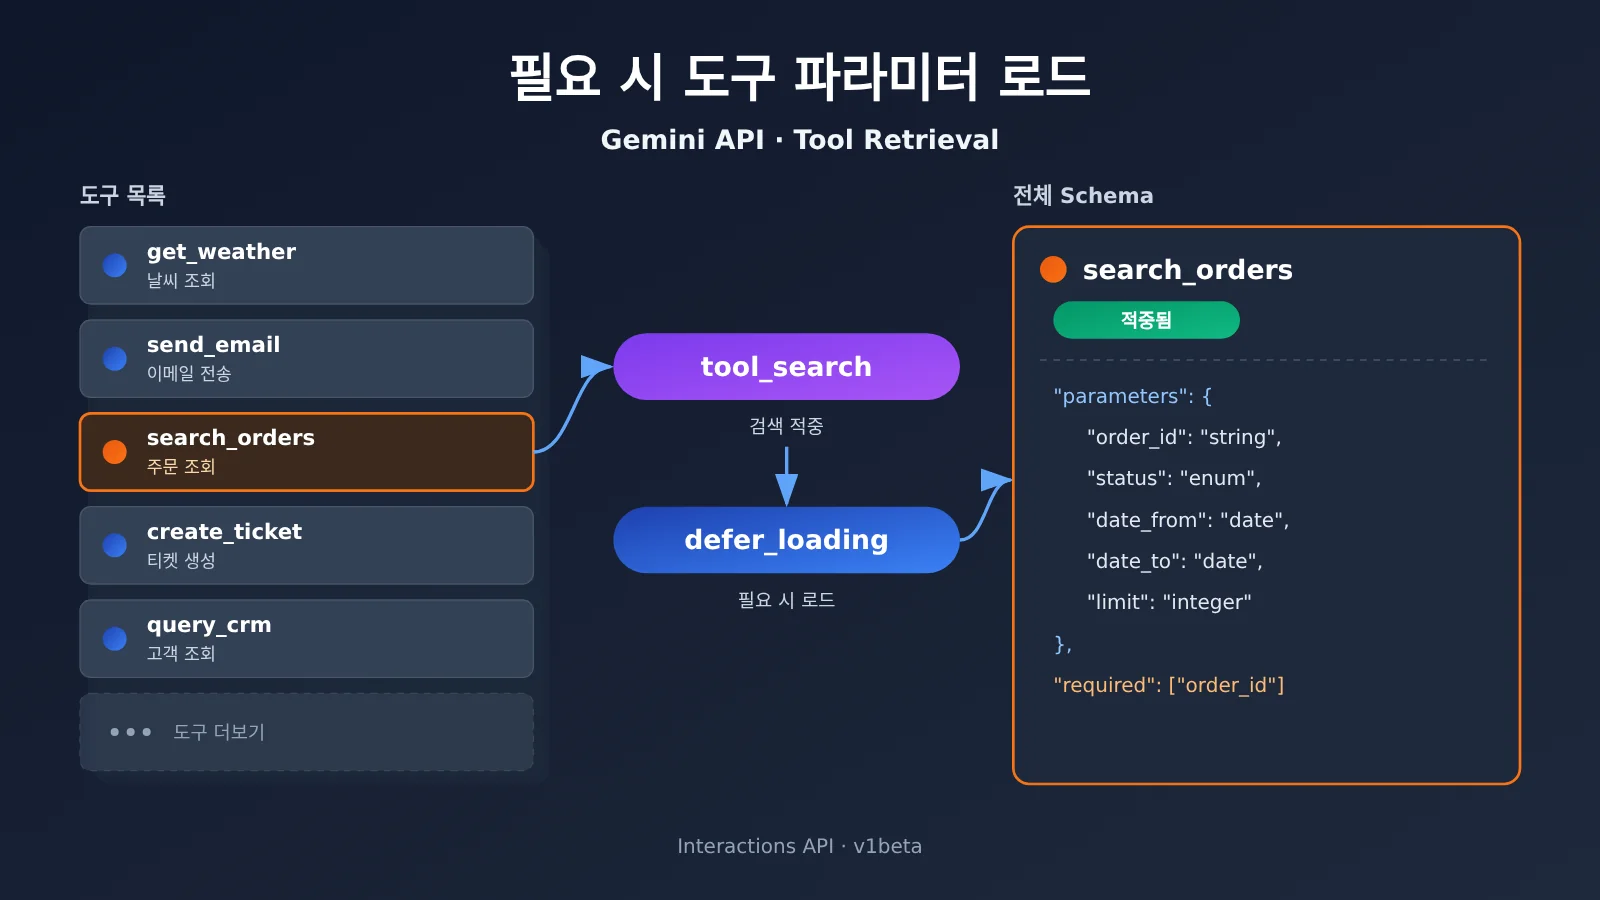
2026년 11월 19일, Google이 Gemini Interactions API에서 Tool Retrieval(도구 검색)을 Preview 형태로 선보였어요. 에이전트가 처음에는 도구의 이름과 짧은 설명만 보다가, 실제로 호출이 필요해질 때 전체 파라미터 Schema를 컨텍스트에 불러오는 방식이에요. 주로 해결하는 문제는 “도구를 계속 붙이다 보니 컨텍스트가 놀고 있는 도구 정의로 가득 차는” 상황이에요. 도구 수가 많고 호출이 소수의 고빈도 도구에 집중되면서 롱테일 도구가 잔뜩 있는 에이전트에 가장 잘 맞고, 모든 애플리케이션에서 기본으로 켠다고 해서 무조건 비용이 절감되는 건 아니에요.
이 글을 읽고 나면 알 수 있는 것
- Tool Retrieval이 실제로 바꾸는 게 무엇인지, 그리고 “개발자는 여전히 전체 도구 선언을 제출해야 한다”와 “모델이 미리 전체 Schema를 읽을 필요는 없다”가 어떻게 동시에 성립하는지
- 도구 등록부터
function_call까지의 전체 실행 체인, 그리고 서버 측 검색과 클라이언트 측 검색의 역할 분담 - 현재 명시적으로 지원되는 4개 모델 ID, 표준 가격, 그리고 “별도 기능 요금은 없지만 토큰은 평소대로 과금된다”의 의미
- 공식 자료의 방향이 서로 반대인 두 가지 예시 계산: 언제 절감되고, 언제 오히려 더 비싸지는지
- 연동 전에 주의해야 할 제한 사항, 그리고 내 에이전트가 도입할 만한지 판단하는 방법
색인: 뒷부분에서는 먼저 개념 표와 영향 요약으로 배경을 빠르게 정리해 드릴게요. “객관적 사실” 부분에서는 출시 정보, 작동 원리, 하이브리드 로딩과 원격 MCP, 지원 모델과 비용, 사용 제한을 차례로 설명하고, 모두 Google 공식 공지와 개발 문서를 기준으로 삼아요. “분석 및 판단” 부분에서는 적용 시나리오 판단, 마이그레이션 전의 기준 측정 방법, 그리고 몇 가지 흔한 의문을 다루며, 판단이나 예측 성격을 띠는 내용은 따로 표시할게요.
Gemini API Tool Retrieval: 먼저 알아야 할 개념 (To Know)
| 개념 | 간단한 설명 |
|---|---|
| Tool Retrieval | 필요한 도구를 먼저 검색한 뒤, 매칭된 도구의 전체 파라미터 정의를 모델 컨텍스트에 추가하는 방식 |
| Interactions API | Gemini가 에이전트를 위해 제공하는 인터페이스로, 상호작용 기록·도구 실행 단계·모델 출력을 관리하며 2026년 6월부터 정식 사용 가능해요 |
| 파라미터 Schema | 함수가 어떤 파라미터를 받고, 타입이 무엇이며, 무엇이 필수인지를 설명하는 구조로, 보통 JSON Schema로 표현해요 |
| Function Calling | 모델이 함수명과 파라미터를 생성하면 애플리케이션이 함수를 실행하고, 그 결과를 다시 모델에 전달하는 방식 |
tool_search |
도구 검색 메커니즘을 선언하는 도구 타입으로, 모델이 이를 통해 도구 정의를 찾아 로드해요 |
defer_loading |
서버 측 모드의 설정으로, 도구의 전체 파라미터 정의를 검색 매칭 시점까지 지연 로딩해요 |
short_description |
지연 도구의 짧은 설명으로, 모델이 초기 카탈로그에서 도구를 식별할 수 있게 해줘요 |
| 원격 MCP | Model Context Protocol을 통해 외부 애플리케이션과 연결되는, 제3자 서비스 제공 도구 |
| 암시적 캐시 | 플랫폼이 동일한 컨텍스트 프리픽스를 자동으로 재사용하며, 매칭된 부분은 캐시 입력 요금으로 과금되는 방식 |
Gemini API Tool Retrieval 영향 한눈에 보기
- 에이전트에 대량의 업무 도구를 연결 중인 개발자: 이제 자체 도구 검색기를 직접 만들지 않고도, 모델이 수십에서 수백 개에 달하는 도구의 스키마를 필요에 따라 읽도록 할 수 있어요. 다만 여전히 매 요청마다 전체 도구 배열을 제출해야 하고, 캐시와 과금을 다시 평가해야 해요. 마이그레이션 전에는 기존 Function Calling(함수 호출) 흐름으로 도구 정의가 실제로 차지하는 비중을 먼저 측정해 보는 걸 권장해요. APIYI apiyi.com 같은 다중 모델 통합 인터페이스를 활용하면 비교 기준선을 빠르게 뽑아낼 수 있어요.
- 제품 및 비용 담당자: 별도의 기능 요금은 없지만, 서버 측 검색이 일어날 때마다 추가 모델 추론이 발생해요. 비용이 절감되는지는 도구 규모, 컨텍스트 길이, 검색 빈도에 따라 달라지며, 청구서 필드로 검증해야 하고 홍보 문구의 방향만 보고 판단하면 안 돼요.
- 도구가 적고 호출이 안정적인 애플리케이션: 공식 산출 예시에 따르면, 작은 도구 집합에 긴 컨텍스트를 더하면 오히려 토큰 총량이 늘어나요. 계속 직접 로드하는 편이 더 안정적인 선택이에요.
- 에이전트 프레임워크를 사용하는 팀: 이는 모델 API 계층의 새로운 기능이라, 프레임워크가 즉시 대응하지 않을 수 있어요. 프레임워크 계층의 점진적 로딩 문제가 이미 해결됐다고 기본 가정해서는 안 돼요.
객관적 사실: Gemini API Tool Retrieval은 무엇을 발표했나
Gemini API Tool Retrieval의 발표 정보와 배경
Google 공식 블로그는 2026년 11월 19일 《Introducing Tool Retrieval in the Gemini API》를 게시했어요. 작성자는 Gemini API 제품 관리자 Lucia Loher와 Google DeepMind 연구 과학자 Nora Kassner입니다. 이 기능은 현재 Preview 단계로, Interactions API에서만 사용할 수 있으며 v1beta 버전이 필요합니다. 기존 generateContent 메서드는 지원하지 않아요.
엔지니어링 측 준비는 공지보다 먼저 진행됐습니다. 11월 18일 Google 공식 Python SDK가 v3.6.0을 배포했고, 업데이트 노트에는 Tool Retrieval 및 함수 결과와 관련된 공개 스키마가 추가되었다고 명시했어요. 같은 날 Go SDK v1.79.0에도 해당 업데이트가 포함됐습니다. 타임라인으로 보면 이번 발표는 이미 GA된 Interactions API 위에서 도구 발견과 필요 시 로딩 기능을 보완한 것이지, 새로운 API 제품을 출시한 것은 아닙니다.
개발자 수요도 기록으로 확인할 수 있어요. 2026년 3월 18일 한 개발자가 Python SDK 저장소에 Issue #2185를 제출하며 defer_loading과 tool_search 지원을 요청했습니다. 이유는 에이전트가 30개 이상의 도구를 연결하면 전체 스키마가 컨텍스트 팽창을 일으킨다는 것이었어요. Google 유지보수 담당자는 3월 20일 응답하며 이를 기능 요청으로 등록했습니다. 이는 성능 테스트가 아니라 요구 사항 피드백입니다.
한 문장으로 Tool Retrieval을 요약하면: 도구는 먼저 발견될 수 있고, 구체적인 매개변수는 호출이 필요할 때 읽습니다.
Tool Retrieval은 도구 Schema 로딩 방식을 어떻게 바꾸나요
전통적인 정적 로딩 방식에서는 사용자가 환불 한 건만 처리하려 해도 주문, 물류, 재고, CRM 등 수십 개 도구의 파라미터 선언이 매 추론마다 함께 컨텍스트에 들어갑니다. Google 문서에 따르면 수십 개의 함수 선언만으로도 수만 개의 토큰을 차지할 수 있습니다. 이는 대화 기록이 들어갈 공간을 잡아먹고, 비슷한 도구가 많으면 모델이 올바른 도구를 고르는 데 방해가 될 수도 있습니다.
Tool Retrieval의 핵심은 세 가지 층위를 구분하는 것입니다:
- API 요청 계층: 개발자는 평소처럼 파라미터 Schema를 포함한 전체 도구 정의를 제출합니다.
- 모델 초기 컨텍스트:
defer_loading: true로 표시된 도구는 이름과short_description형태로만 등장합니다. 간단 설명이 설정되어 있지 않으면 전체description의 첫 문장을 사용합니다. - 도구 호출 단계: 도구가 검색에 걸린 뒤에야 전체 Schema가 컨텍스트에 들어가고, 모델은 이를 바탕으로 파라미터가 채워진 호출을 생성합니다.
따라서 제목의 “더 이상 매번 모든 도구 파라미터를 로드하지 않는다”는 정확히는 모델이 매 라운드마다 모든 전체 파라미터를 미리 읽지 않는다는 뜻이지, 개발자가 더 이상 전체 선언을 보내지 않아도 된다는 뜻이 아닙니다. 서버 측 모드에서는 공식적으로 매 요청마다 전체 tools 배열을 다시 제출해야 하며, previous_interaction_id를 사용한 경우에도 예외가 아닙니다.
Tool Retrieval 실행 체인: 공식 환불 사례로 살펴보기
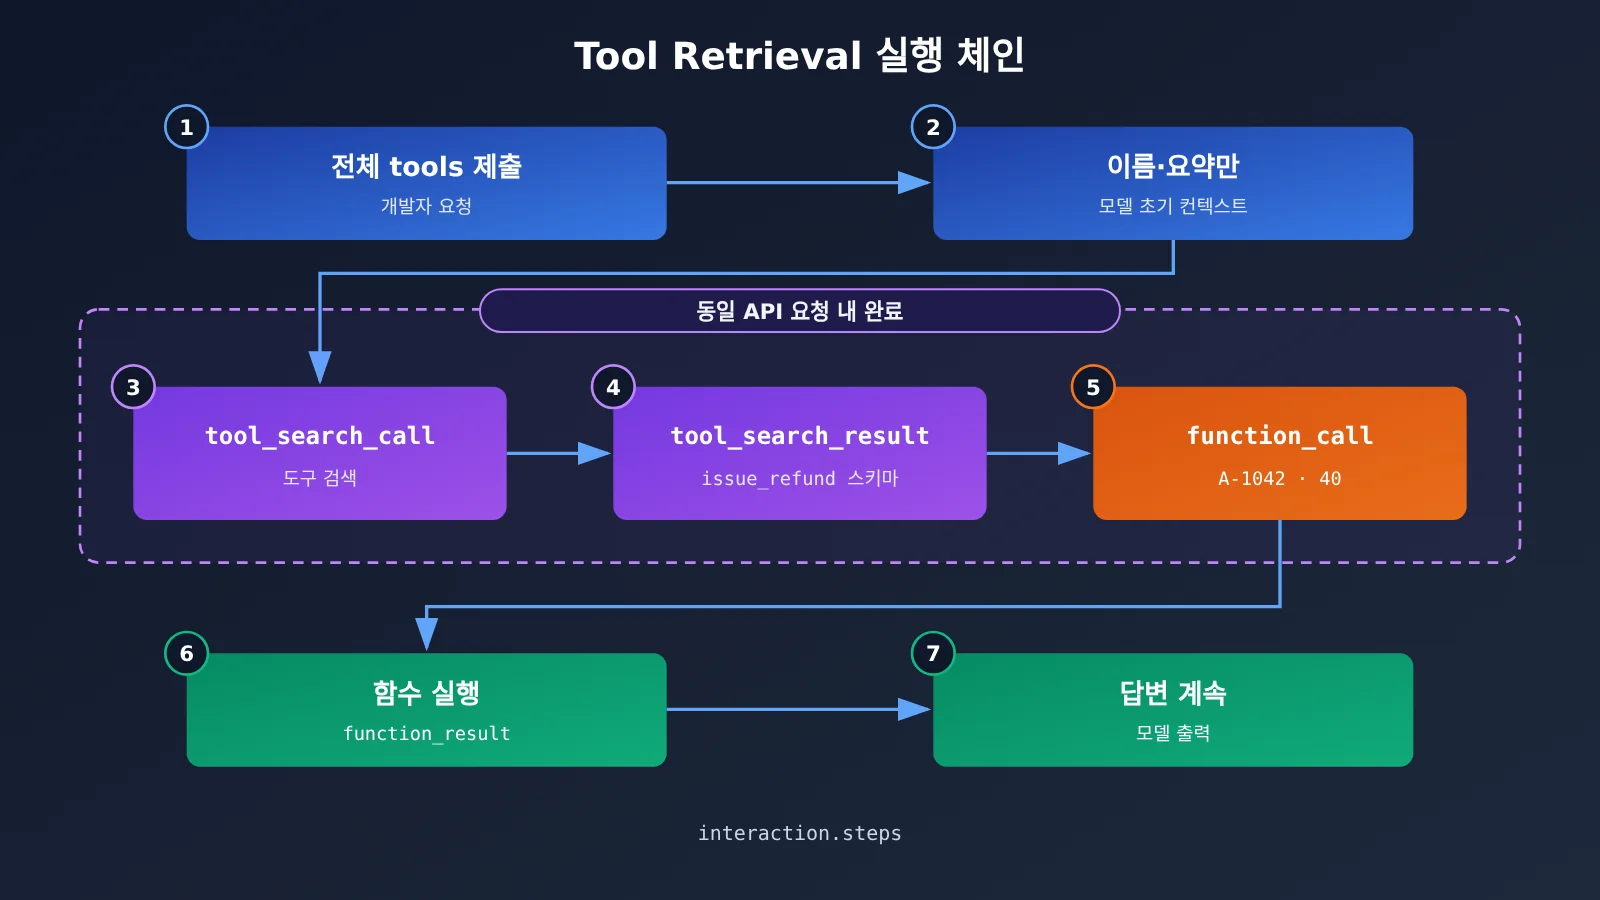
Google 공지에서는 주문 환불 시나리오를 하나 예로 들었어요. 주문 A-1042의 상품이 배송 도착 시점에 이미 손상되어 사용자가 40달러 환불을 요청하는 상황이고, 여기에 필요한 도구는 issue_refund예요. 서버 측 검색의 전체 과정은 다음과 같아요:
- 요청에
{"type": "tool_search"}를 선언하고,issue_refund같은 저빈도 도구에는defer_loading: true를 설정해요. - 모델이 작업을 보고 환불 기능이 필요하다고 판단하면
tool_search_call을 발행해요. - API가
tool_search_result를 반환하고, 여기에는issue_refund의 전체 파라미터 스키마가 담겨 있어요. - 모델이 파라미터 정의를 읽고
function_call을 생성하는데, 파라미터는order_id: "A-1042"와amount: 40이에요. - 애플리케이션이 함수를 실행해
function_result를 돌려주면, 모델은 이를 바탕으로 작업을 계속 이어나가요.
검색, 로딩, 함수 호출 생성은 같은 외부 API 요청 안에서 완료될 수 있고, 모든 단계는 interaction.steps에서 확인할 수 있어요. 다만 주의할 점이 있어요. 같은 요청이라고 해서 내부에서 추론이 한 번만 일어난다는 뜻은 아니에요. 서버 측 검색이 일어날 때마다 추가 모델 호출이 발생하고, 이는 과금 대상이에요. 그리고 이건 데모 사례이지, 어떤 환불 성공률 통계도 아니에요.
아래는 공식 문서를 바탕으로 정리한 예시 코드예요. Google 엔드포인트에 직접 연결하며, 요청 구조를 보여주는 용도일 뿐이에요:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "issue_refund",
        "description": "Refund an order.",
        "short_description": "Refund a customer order.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "amount": {"type": "number"}
            },
            "required": ["order_id", "amount"]
        }
    }
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Refund 40 USD for order A-1042.",
    tools=tools
)
for step in interaction.steps:
    print(step.type)  # tool_search_call / tool_search_result / function_call
Function Calling의 기존 역할 분담은 달라지지 않았어요. 사용자 정의 함수의 경우 API는 function_call만 반환하고, 환불 실행, 데이터베이스 접근, 권한 처리는 여전히 애플리케이션의 몫이에요. 원격 MCP 서버에 연결할 때만 API가 대신 원격 호출을 발행하면서 mcp_server_tool_call과 mcp_server_tool_result를 반환해요.
Tool Retrieval의 하이브리드 로딩, 원격 MCP, 그리고 두 가지 검색 모드
Google은 하이브리드 사용을 권장해요. 자주 쓰는 도구는 바로 로드하고, 빈도가 낮고 전문적인 롱테일 도구는 지연 로드하는 방식이죠. 이렇게 하면 간단한 작업에서 굳이 먼저 검색을 한 번 돌릴 필요가 없고, 롱테일 기능이 컨텍스트를 오래 차지하지도 않아요. 원격 MCP 서버도 전체적으로 지연 로드를 설정할 수 있는데, 예를 들어 type: "mcp_server" 설정에 defer_loading: true를 붙이면 그 서버가 노출하는 도구들이 필요에 따라 로드되고, 하나하나 선언할 필요가 없어요.
Gemini가 검색을 수행하는 서버 측 모드 외에, 공식에서는 클라이언트 모드도 제공해요. 개발자가 execution: "client"인 tool_search를 선언하면, 자신의 애플리케이션이 도구 레지스트리를 조회한 뒤 매칭된 전체 도구 선언을 function_result.result에 담아 모델에 반환하는 방식이에요. 두 방식의 차이는 다음과 같아요:
| 비교 항목 | 서버 측 검색 | 클라이언트 측 검색 |
|---|---|---|
| 실행 위치 | Gemini API 서버 측 (기본값 server) |
개발자 애플리케이션 (client) |
| 검색기 직접 구축 필요 여부 | 불필요 | 필요 |
| 도구 라이브러리 사전 선언 필요 여부 | 필요 | 불필요, 세션 중 새 도구 도입 가능 |
defer_loading |
적용 가능 | 적용 불가 |
| 추가 네트워크 왕복 | 추가 클라이언트 왕복 없음 | 검색할 때마다 왕복 한 번 추가 |
| 권한 제어 | 요청에서 선언한 도구 집합에 의해 결정 | 자체 구축한 사용자 수준 권한 필터와 결합 가능 |
| 대표적인 시나리오 | 크고 비교적 고정된 도구 집합 | 동적 도구 라이브러리, 멀티테넌시, 기업 프라이빗 레지스트리 |
클라이언트 모드에서 반환하는 함수 선언은 구조화된 객체여야 하고, JSON 문자열로 변환하면 안 돼요. 같은 요청 안에서 두 모드를 혼용할 수 없고, tool_search는 최대 하나만 선언할 수 있어요.
Gemini API Tool Retrieval은 어떤 모델을 지원하고 가격은 얼마인가요
Google 공지의 표현은 다소 포괄적이어서 Gemini 3.6 및 그 이후 모델, 즉 모든 Gemini 4 모델이 지원된다고 밝히고 있어요. 하지만 개발 문서에서 11월 20일 기준으로 명확히 나열한 것은 4개의 모델 ID뿐입니다. 실제 적용 시에는 개발 문서를 기준으로 삼아야 하며, 지원하지 않는 모델에 defer_loading을 설정하면 HTTP 400이 반환돼요.
| 모델 ID | 표준 입력 가격(달러/백만 Tokens) | 표준 출력 가격(Thinking 포함) | 비고 |
|---|---|---|---|
gemini-4-hydrogen |
$1.50 | $7.50 | Free Tier 표시 있음 |
gemini-4-argon |
$2.00 (12월 1일부터 $4.00) | $10.00 (12월 1일부터 $20.00) | Free Tier 없음 |
gemini-3.8-flash |
$0.75 (2027년 1월 1일부터 $1.50) | $3.75 (2027년 1월 1일부터 $7.50) | Free Tier 표시 있음 |
gemini-3.6-flash |
$0.75 (2027년 1월 1일부터 $1.50) | $3.75 (2027년 1월 1일부터 $7.50) | Free Tier 표시 있음 |
가격은 Google Gemini Developer API 가격 페이지의 Standard 등급 기준입니다. Free Tier의 실제 할당량과 속도 제한은 프로젝트별로 확인해야 해요.
과금 측면에서 Google은 Tool Retrieval에 별도의 기능 요금이 없다고 명확히 밝혔지만, 그것이 검색이 무료라는 뜻은 아닙니다. 지연 도구의 간략 설명 목록, tool_search를 켠 뒤 추가되는 고정 검색 지시, 서버 측 검색마다 발생하는 추가 추론, 로드된 전체 Schema와 그것이 이후 턴에서 유지되는 부분까지 모두 선택한 모델의 요율로 Token이 계산돼요. 비용을 관찰할 때는 total_tool_use_tokens 필드에 특히 주목해야 합니다. 이 필드는 서버 측 검색으로 발생한 추가 모델 호출 입력을 기록하거든요. 첫 입력 Token이 줄어든 것만 보면 절감 효과를 과대평가하기 쉽습니다.
Tool Retrieval의 공식 Token 예시 산출
공식 초기 테스트에 따르면, 각 지연 도구는 초기 카탈로그에서 평균 약 26 Tokens를 차지해요. 이는 근사치일 뿐 고정 오버헤드는 아니에요. 문서에서는 결론 방향이 서로 반대인 두 가지 가정성 산출 예시도 함께 제시합니다.
| 시나리오(공식 가정) | 모든 도구 정적 로딩 | Tool Retrieval | 변화 |
|---|---|---|---|
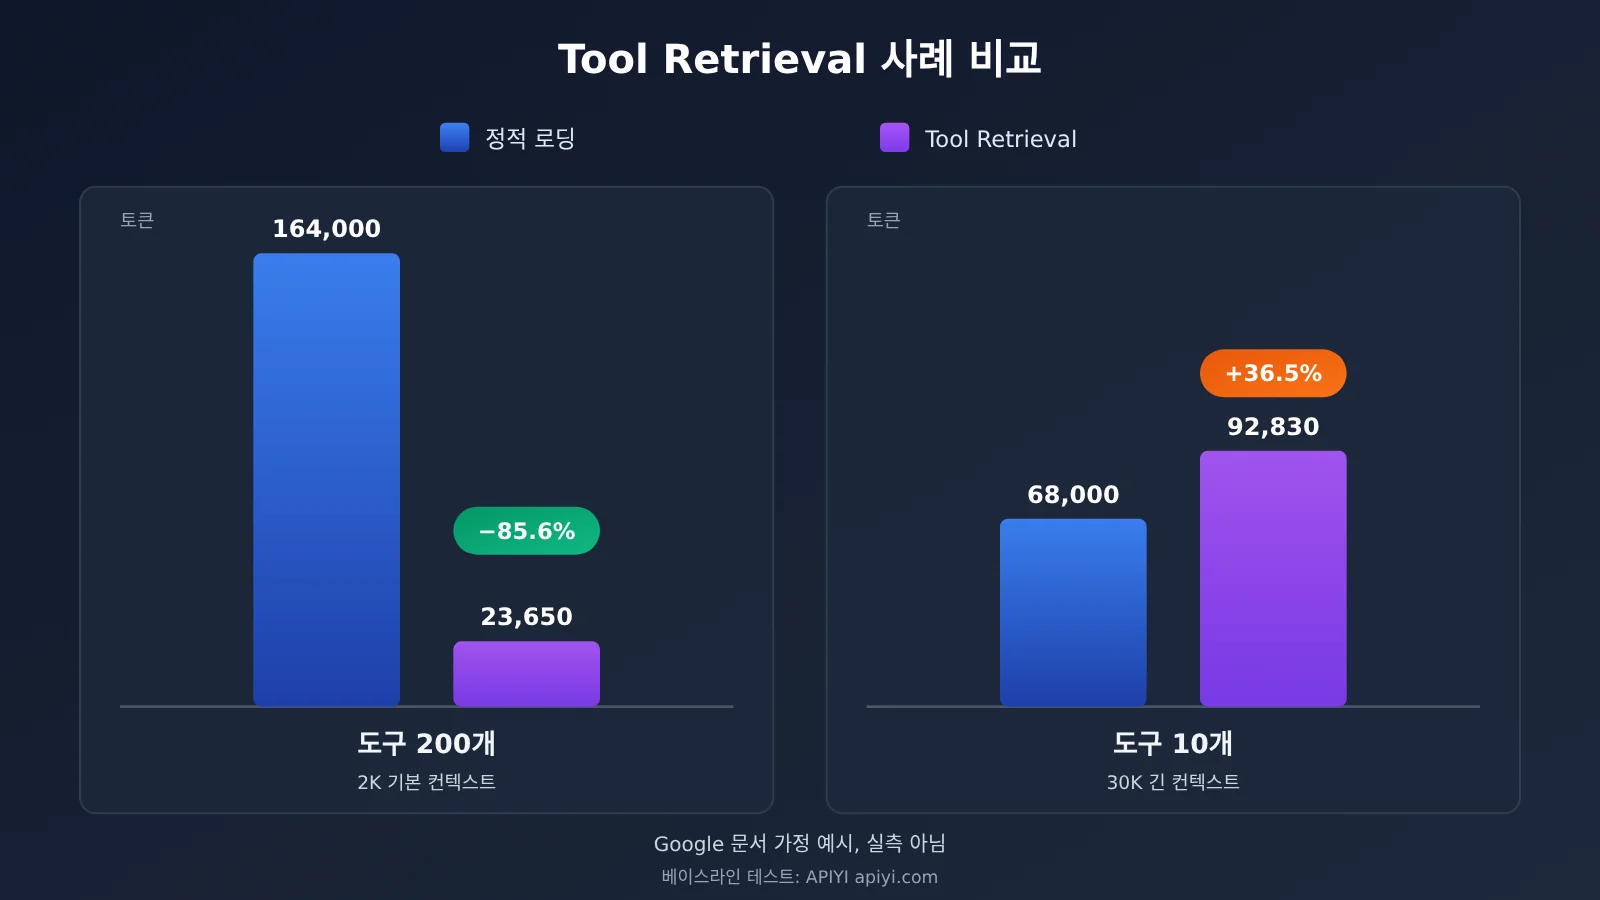
| 200개 도구, 각 400 Tokens, 기본 컨텍스트 2,000, 2개 도구 사용, 총 2회 요청 | 164,000 | 약 23,650 | 약 85.6% 감소(예시 기준 산출) |
| 10개 도구, 각 400 Tokens, 기본 컨텍스트 30,000, 2개 도구 사용, 총 2회 요청 | 68,000 | 92,830 | 약 36.5% 증가(예시 기준 산출) |
두 번째 산출 예시가 더 비싼 이유는 서버 측 검색이 추가로 한 번 추론해야 하고, 이미 긴 컨텍스트를 다시 처리해야 하기 때문이에요. 반면 10개의 도구 자체는 차지하는 비중이 크지 않아서, 절약한 Schema가 검색 오버헤드를 상쇄하지 못하죠. 두 숫자 모두 Google이 명시한 가정성 예시로, 출력 Token과 캐시 이익은 포함되지 않았으며 프로덕션 환경 Benchmark가 아니에요. 자료 검토일 기준으로, Google은 이 기능의 실측 Token 절감 비율, 지연 개선 또는 도구 선택 정확도 향상을 공개하지 않았습니다.
캐시 측면에서 Google은 Tool Retrieval이 암시적 캐싱을 지원한다고 밝혔어요. 전체 Schema가 초기 프리픽스에 나타나지 않아, 시스템 지시문과 도구 카탈로그 같은 프리픽스가 더 쉽게 안정적으로 유지되죠. 하지만 문서는 지연 로딩 때문에 초기 프롬프트가 짧아지면서, 원래 대량의 Schema에 의존해야 캐시 최소 임계값에 도달할 수 있었던 요청이 임계값 아래로 떨어질 수 있다고도 경고합니다.
Tool Retrieval의 현재 사용 제한
다음 내용은 공식 문서에서 나온 것으로, 개발 중에 가장 자주 발을 들이는 부분이에요:
- 이미 로드된 도구는 제거할 수 없음: Schema가 한 번 검색되면 현재 세션에서 계속 유지돼요. 아주 긴 세션에서 계속 새 도구를 검색하면 컨텍스트는 여전히 계속 커져요.
- 매 요청마다 전체 도구 배열을 다시 제출:
tool_search, 모든 지연 및 비지연 도구, 관련 MCP 설정이 포함돼요.name과short_description만 제출하고parameters를 생략할 수는 없어요. - 시스템 지시에서 직접 지명한 도구는 지연하지 말 것: 모델이 검색을 우회해 곧바로 호출할 수 있고, 그러면 로딩 컨텍스트가 없어 오류가 발생해요.
- 무상태 세션에서는 검색 단계를 온전히 보존:
store=false로 히스토리를 직접 관리할 때tool_search_call,tool_search_result및 그signature는 삭제하거나 수정하면 안 돼요. 그렇지 않으면 HTTP 400이 반환될 수 있어요. - 디버깅은 steps를 봐야 함:
interaction.status가requires_action이 아니더라도 결과 안에 실행 대기 중인function_call이 포함될 수 있어요. - 매칭 실패 시 텍스트가 반환될 수 있음: 서버 측 검색이 일치하는 도구를 찾지 못할 때 반드시 구조화된 오류를 반환하는 건 아니에요.
분석과 판단: Gemini API Tool Retrieval이 Agent 개발에 의미하는 것
Tool Retrieval의 적용 시나리오 판단
이번 업데이트의 실질적 가치는 “완전한 도구 목록을 유지하는 것”과 “매 추론 라운드마다 그 목록을 전부 읽는 것”을 두 개의 별개 문제로 분리했다는 데 있어요. 도구 라이브러리는 계속 확장할 수 있지만, 모델 컨텍스트에 상시 유지되는 것은 아주 얇은 목차 하나뿐이죠. 새로운 비즈니스 시스템을 지속적으로 연동하는 팀이라면, 사전에 도구 세트를 잘라내는 부담을 줄일 수 있고, Token을 제어하려고 애플리케이션 측에서 매 라운드 동적으로 도구를 필터링하면서 캐시 프리픽스를 깨뜨리는 상황도 줄일 수 있어요.
다만 공식 산출 예시는 이미 수익이 조건부임을 보여줘요. 공식 엔지니어링 권장 사항과 결합하면, 아래 표로 1차 판단을 할 수 있어요(이건 엔지니어링 선택 권장 사항이지, 강제되는 수량 기준은 아니에요):
| Agent 유형 | 도구 특성 | 권장 |
|---|---|---|
| 고객 서비스, 비즈니스 프로세스 어시스턴트 | 수십 개의 도구, 소수의 조회류가 고빈도, 환불·승인·계약 등은 저빈도 | 고빈도는 직접 로드, 롱테일은 서버 측 검색 |
| 다중 MCP 서버의 개발/운영 Agent | 서버마다 도구가 많고, 단일 작업에서는 일부만 사용 | MCP 서버 전체에 defer_loading 설정 |
| 다중 테넌트, 권한별 도구 개방 플랫폼 | 도구 집합이 사용자와 워크스페이스에 따라 달라짐 | 클라이언트 검색, 자체 레지스트리와 권한 필터링 결합 |
| 소형 어시스턴트 | 약 20개 미만의 안정적인 도구, 대부분이 매 라운드 사용됨 | 계속 정적 로드 |
| 긴 컨텍스트 + 빈번한 검색 | 대화가 매우 길고, 매 라운드 여러 번 검색이 필요한 경우가 많음 | 먼저 테스트 후 결정, 순비용 상승 위험 존재 |
우리의 판단은 이래요: 도구 호출 분포가 “롱테일”일수록 Tool Retrieval을 쓸 가치가 커요. 반대로 대부분의 도구를 매 라운드 사용한다면, 지연 로드는 검색 추론 한 번을 더할 뿐이에요.
Tool Retrieval로 마이그레이션하기 전에, 도구 Schema의 실제 점유량부터 측정하세요
마이그레이션 여부를 판단할 때 가장 신뢰할 수 있는 근거는 자사 업무 데이터예요. 마이그레이션 전에 기존 OpenAI 호환 Function Calling 흐름을 그대로 활용해 “전체 도구”와 “실제로 쓰는 도구만 포함”한 두 요청의 입력 Token 차이를 측정하면, 도구 Schema가 실제로 차지하는 양을 확인할 수 있어요. 아래 스크립트는 이런 베이스라인 측정을 수행하는 것이며, Tool Retrieval 자체는 아니에요:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스, 정적 로딩 베이스라인 측정용
)

def make_tool(name, desc):
    return {"type": "function", "function": {
        "name": name, "description": desc,
        "parameters": {"type": "object",
                       "properties": {"order_id": {"type": "string"}},
                       "required": ["order_id"]}}}

all_tools = [make_tool(f"crm_tool_{i}", f"CRM operation {i}") for i in range(50)]
messages = [{"role": "user", "content": "查询订单 A-1042 的状态"}]

for label, tools in [("全量 50 个工具", all_tools), ("仅 1 个工具", all_tools[:1])]:
    resp = client.chat.completions.create(
        model="your-model-id", messages=messages, tools=tools)
    print(label, "prompt_tokens =", resp.usage.prompt_tokens)
전체 베이스라인 측정 스크립트 보기(도구 수에 따른 배치 비교)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스를 통해 여러 모델의 도구 Schema 오버헤드 측정
)

def load_tools(path: str) -> list:
    """업무 도구 레지스트리(JSON 파일)에서 OpenAI 형식의 도구 정의를 읽어옵니다"""
    with open(path, "r", encoding="utf-8") as f:
        return json.load(f)

def measure(model: str, tools: list, prompt: str) -> int:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools if tools else None,
        max_tokens=16,
    )
    return resp.usage.prompt_tokens

def baseline_report(model: str, tools: list, prompt: str, steps=(0, 10, 20, 50, 100)):
    base = measure(model, [], prompt)
    print(f"无工具基础输入: {base} tokens")
    for n in steps:
        if n == 0 or n > len(tools):
            continue
        used = measure(model, tools[:n], prompt)
        print(f"{n:>4} 个工具: {used} tokens, Schema 约占 {used - base} tokens")

if __name__ == "__main__":
    tools = load_tools("tool_registry.json")
    baseline_report("your-model-id", tools, "查询订单 A-1042 的状态")
🎯 기술 제안: Tool Retrieval을 평가하기에 앞서, APIYI apiyi.com에서 하나의 API 키로 여러 주요 모델에 정적 로딩 베이스라인을 돌려 보세요. 그러면 도구 Schema가 내 요청에서 정확히 몇 Token을 차지하는지 한눈에 볼 수 있어요. 베이스라인을 확보한 뒤에는 Gemini Interactions API에서
tool_search를 켜고 대조 테스트를 하면서total_input_tokens와total_tool_use_tokens의 합계를 비교해 보세요.
한 가지 짚고 넘어갈 점은, Tool Retrieval은 Interactions API의 v1beta 인터페이스와 전용 필드에 의존하기 때문에 위의 OpenAI 호환 호출은 오직 정적 로딩 오버헤드를 측정하는 용도로만 쓴다는 거예요. 대조 테스트를 할 때는 모델, 도구 라이브러리, 작업 집합, 컨텍스트 길이, 캐시 조건을 동일하게 유지한 상태에서 총 과금 비용, 엔드투엔드 소요 시간, 올바른 도구 선택률, 평균 검색 횟수를 비교해야 해요. 그래야 차이를 검색 전략 탓으로 돌릴 수 있거든요. 만약 같은 스크립트 안에서 여러 모델의 베이스라인 차이를 한눈에 비교하고 싶다면, APIYI apiyi.com의 통합 인터페이스가 모델마다 따로 붙일 필요 없이 수고를 덜어 줍니다.
주목할 만한 후속 발전 (예측적 판단)
다음은 판단이며, 확인된 사실이 아닙니다.
첫째, 공지와 개발 문서가 지원 모델 범위에서 차이가 존재하며, Gemini 4 Carbon, Gemini 4 Neon 등 모델이 호환 목록에 포함될지 여부는 문서 업데이트를 주목할 필요가 있습니다. 둘째, “이미 로드된 Schema는 언로드할 수 없다”는 장기 세션 Agent의 뚜렷한 단점으로, 정식 버전이 언로드 또는 퇴출 메커니즘을 제공할지가 장기 작업에서의 성능에 직접 영향을 미칠 것입니다. 셋째, Google ADK 사용자들은 이전에 Issue #7241에서 점진적 로딩과 캐시 무효화 문제를 피드백한 바 있으며, 모델 API가 새로운 능력을 지원한다고 해서 프레임워크가 자동으로 채택하는 것은 아니므로, 프레임워크 계층의 적응 속도는 지켜볼 만합니다.
온디맨드 도구 정의 로딩 아이디어는 업계에 이미 선례가 있었고, Google 이번 것은 이를 Gemini의 Agent 인터페이스에 보완해 넣은 것입니다. Preview 단계 인터페이스는 변경될 수 있으므로, 프로덕션 시스템 연동 시 정적 로딩으로 폴백하는 스위치를 유지할 것을 권장합니다.
Gemini API Tool Retrieval 관련 몇 가지 자주 묻는 질문
Q1: Tool Retrieval을 켜면 요청 본문이 작아지나요?
아니요. 서버 모드에서는 매 요청마다 여전히 전체 도구 배열을 제출해야 하며, 작아지는 것은 모델 초기 컨텍스트에서의 도구 점유량입니다. 기존 요청에서 도구 정의의 용량을 먼저 계산하고 싶다면, 위 스크립트로 APIYI apiyi.com을 통해 베이스라인을 측정할 수 있습니다.
Q2: Google 공식이 85%를 절약할 수 있다고 하나요?
그런 실측 결론은 없습니다. 85.6%는 200개 도구의 가정적 계산 예시로 추산된 것이며, 같은 문서에서 소규모 도구 집합에서는 토큰이 약 36.5% 증가한다는 반례도 제시했습니다.
Q3: Tool Retrieval은 유료인가요?
별도의 기능 요금은 없지만, 검색 명령, 추가 추론, 로드된 Schema 모두 모델 요율로 토큰이 계산됩니다. 예산에 민감한 팀은 먼저 APIYI apiyi.com을 통해 종량제로 다양한 모델의 Function Calling 오버헤드를 소규모로 테스트한 후, Agent의 모델 선정을 결정할 수 있습니다.
Q4: Tool Retrieval을 쓰면 함수를 직접 실행할 필요가 없나요?
아니요. 커스텀 함수는 여전히 애플리케이션이 실행하고 결과를 반환하며, Tool Retrieval은 도구 정의를 찾아 로드하는 역할만 합니다. 원격 MCP 도구만 API가 대신 호출합니다.
도구 라이브러리는 점점 커지겠지만, 매 라운드 실제로 필요한 것은 대개 그중 몇 개에 불과합니다. Tool Retrieval은 “도구를 모두 갖추는 것”과 “필요할 때 바로 꺼내 쓰는 것”을 분리해서 처리하며, 잘 쓰면 대형 Agent를 더 가볍게 만들 수 있지만, 잘못 쓰면 한 라운드의 추론 비용을 더 지불할 수도 있습니다. 《논어·위령공(論語·衛靈公)》에서 말했듯이 “일을 잘하려면 먼저 도구를 잘 갈고닦아야 한다”라고 했습니다. 먼저 손에 있는 각 ‘도구’의 무게를 명확히 측정한 후, 어떻게 배치할지 결정해야 합니다.
📚 참고 자료
-
Google 공식 발표: Introducing Tool Retrieval in the Gemini API (2026-11-19)
- 링크:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - 설명: 발표 정보, 설계 목표, 두 가지 검색 모드와 가격 책정 원칙
- 링크:
-
Google Tool Retrieval 개발 문서: 구성, 제한, 과금 및 예시 계산
- 링크:
aistudio.google.com/docs/tool-retrieval - 설명: 지원 모델 목록, Usage 필드, 모범 사례와 자주 발생하는 오류
- 링크:
-
Gemini Developer API 가격: 모델 표준 가격과 캐시 요율
- 링크:
aistudio.google.com/docs/pricing - 설명: 각 모델의 입력·출력 단가 및 시행일
- 링크:
-
Interactions API 문서: 인터페이스 정의와 실행 단계
- 링크:
aistudio.google.com/docs/interactions-overview - 설명: 상태 유지 대화, steps 구조, 그리고 generateContent와의 차이
- 링크:
-
Google Python SDK v3.6.0 및 Issue #2185: 엔지니어링 근거와 개발자 요구 기록
- 링크:
github.com/googleapis/python-genai/releases/tag/v3.6.0 - 링크:
github.com/googleapis/python-genai/issues/2185 - 설명: SDK 공개 스키마 업데이트와 초기 커뮤니티 요구
- 링크:
작성자: APIYI 기술 팀
기술 문의: APIYI apiyi.com 홈페이지에서 언제든 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.