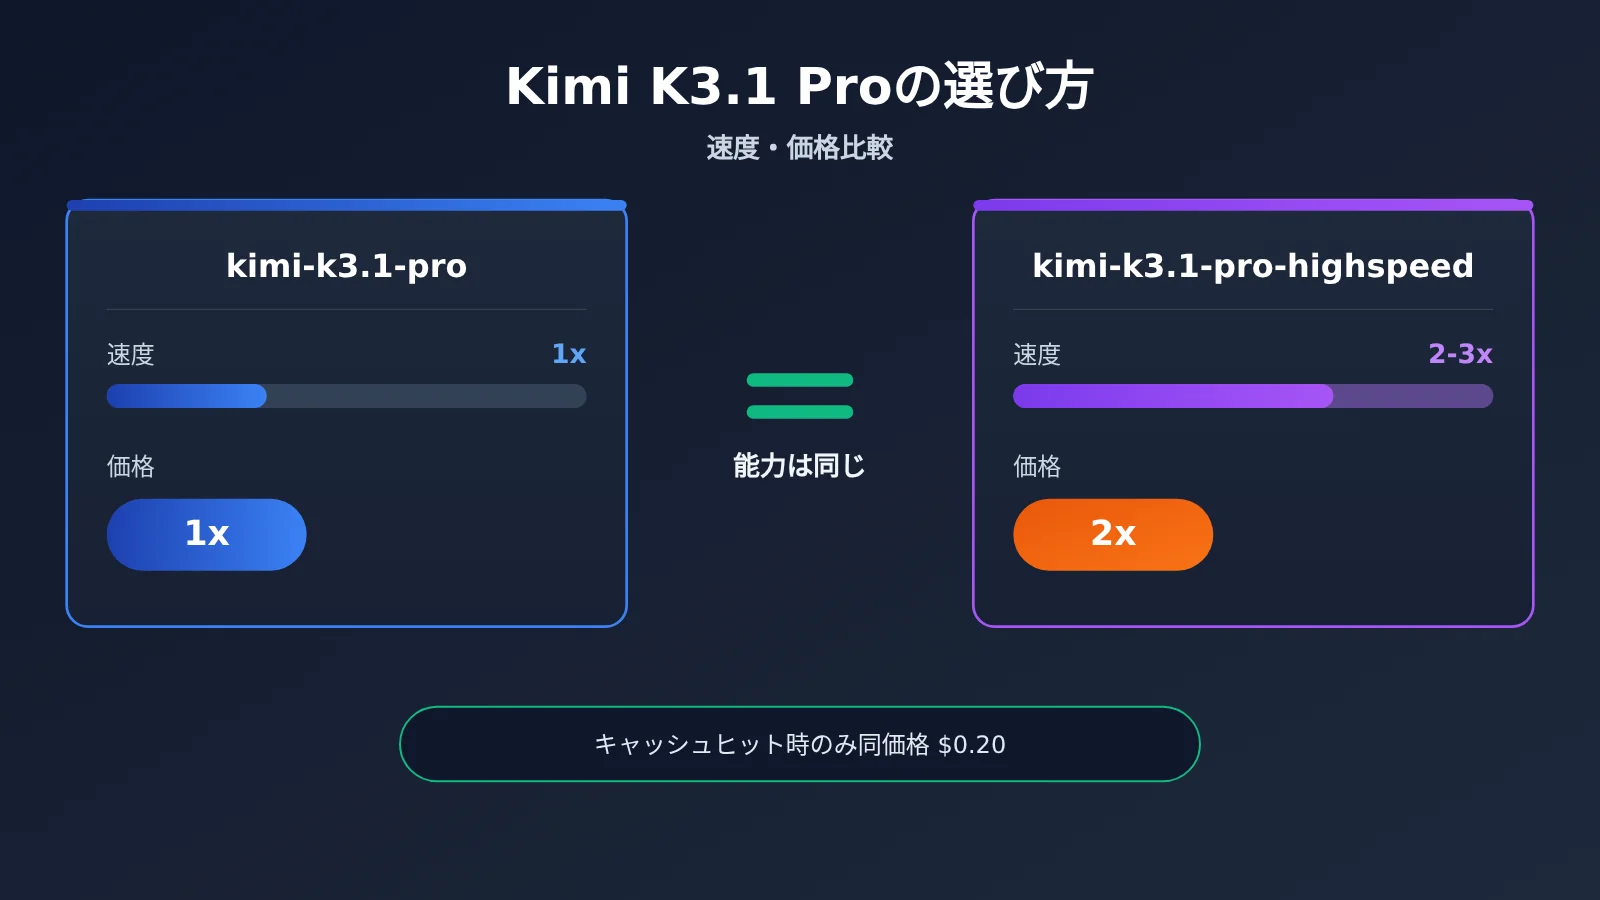
Kimi K3.1 ProとHighspeed版のモデル性能は同じで、Highspeed版の違いは速度だけです。公式によると、処理速度は2〜3倍です。その分、料金はほぼすべての項目で約2倍になります。キャッシュヒット時の料金だけは変わらず、どちらも$0.20です。そのため、画面の前で結果を待つような用途にはHighspeed版、バックグラウンドでまとめて処理する用途には標準版を選ぶのがおすすめです。
この結論の根拠は3つあります。Moonshotの公式ブログには、2つのモデルの「same capabilities(同じ性能)」と明記されています。公式料金ページには5段階の単価が掲載されており、Kimi Codeの公式ドキュメントには、Highspeed版は約2倍のクォータを消費すると記載されています。以下では、それぞれの事実の出典を「公式発表」「第三者情報」「未確認」の3段階で示します。データがない箇所は、推定値を実測値のように見せることなく、データなしと明記します。
この記事では、どちらが賢いかを比べるわけではありません。 2つのモデルの性能は同じです。ここで考えるのは、同じ品質の結果をより速く得るために、料金を倍払う価値があるかということです。
この記事でわかること:5段階の料金表、待ち時間を金額に換算して判断する方法、自分で検算できる2つの試算、そして6種類の用途ごとに結論を示した選択表です。
1. Kimi K3.1 ProとHighspeedの主な違い:性能は同じで、速度と価格だけが異なる
まず全体像を見てみましょう。下の表では、2つのモデルを比較できる項目をまとめ、最後の列に情報源の区分を記載しています。コンテキスト長とは、モデルが一度に「読み取れる」テキストの総量で、tokensで数えます。tokenはモデルの料金計算や処理に使われる基本単位で、ざっくり言うと「単語や文字のかけら」のようなものです。
| 比較項目 | kimi-k3.1-pro(標準版) | kimi-k3.1-pro-highspeed | 情報源の区分 |
|---|---|---|---|
| モデルの能力 | 基準 | 標準版と同じ | 公式発表 |
| コンテキスト長 | 1,048,576 tokens | 1,048,576 tokens | 公式発表 |
| 生成速度 | 基準 | 公式発表では2~3倍 | 公式発表、詳細なデータなし |
| 価格 | 基準 | キャッシュヒット時を除き2倍 | 公式価格 |
| Kimi Codeの利用条件 | Plus以上の会員(1MコンテキストはPro以上) | Pro以上の会員 | 公式ドキュメント |
| Kimi Codeのクォータ消費量 | 基準 | 約2倍 | 公式ドキュメント |
| 公式の利用先 | kimi.ai、Kimi Work、Kimi Code、Kimi API | 左記と同じ | 公式ブログ |
この表から分かることはシンプルです。速度、価格、会員の利用条件を除けば、2つのモデルに違いはありません。選択を間違えても「生成結果の品質」が損なわれるわけではなく、失うのはお金か時間だけです。
1.1 Kimi K3.1 ProとHighspeedの料金比較(5項目すべてを掲載)
以下の料金は、2026-10-24時点で取得した、税抜きの米ドル/百万tokensで、公式価格に基づいています。まず、各料金項目について説明します。「入力」はモデルに送る内容、「出力」はモデルが返す内容です。「キャッシュ」とは、同じプレフィックスの内容(たとえば、何度もリクエストに含めるプロジェクトのコード)をプラットフォームに一時保存する仕組みです。次のリクエストに同じプレフィックスが含まれていれば、それを再利用できます。これを「キャッシュヒット」といい、低い料金が適用されます。初めて内容をキャッシュに保存するときは「書き込み」料金がかかり、保存期間は5分と1時間の2種類です。
| 料金項目 | kimi-k3.1-pro | kimi-k3.1-pro-highspeed | 倍率 |
|---|---|---|---|
| 入力(キャッシュミス) | $2.00 | $4.00 | 2倍 |
| 出力 | $10.00 | $20.00 | 2倍 |
| キャッシュヒット時の入力 | $0.20 | $0.20 | 同額。値上がりした唯一の項目ではない |
| キャッシュ書き込み(5分) | $2.00 | $4.00 | 2倍 |
| キャッシュ書き込み(1時間) | $4.00 | $8.00 | 2倍 |
サードパーティーの開発者Simon Willisonが公開した記録でも、この点が確認されています。Highspeedの料金は2倍ですが、キャッシュヒット時の入力料金は標準版と同じです。この違いは、後の料金計算に影響します。リクエストの入力の大部分がキャッシュヒットする場合、入力の大きな割合に値上げが適用されないため、Highspeedの実質的な合計料金は「ちょうど2倍」よりも低くなります。
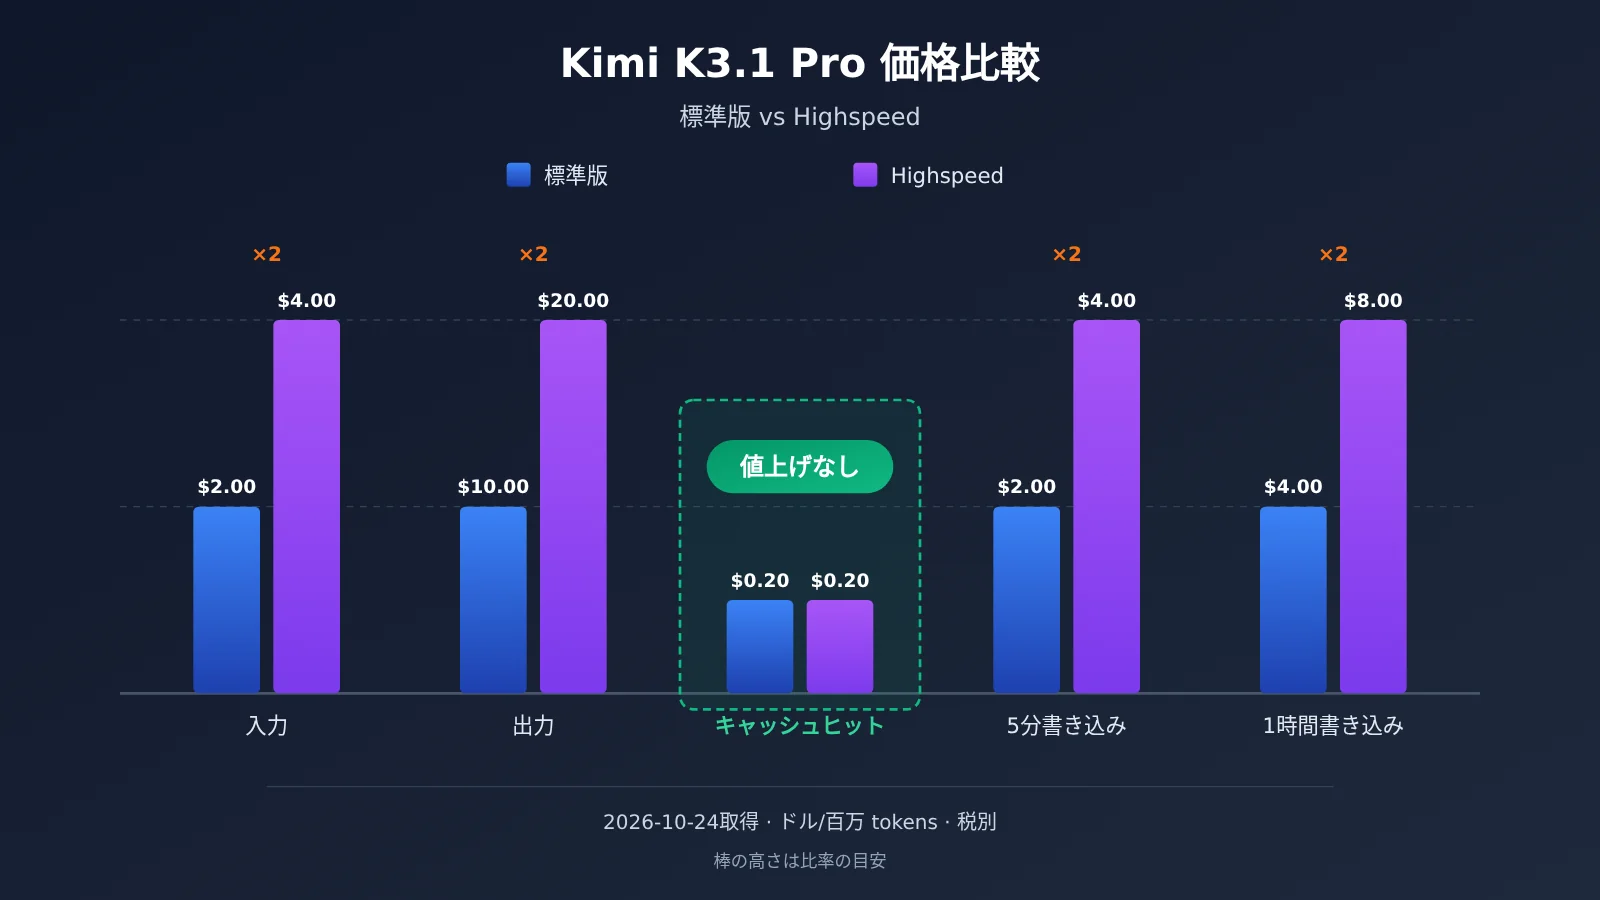
料金について:上のグラフと表は、いずれも公式価格に基づいています。APIYI apiyi.com経由でAPIを利用する場合、プラットフォーム上のモデル名と料金は、プラットフォームのモデル一覧をご確認ください。これら2つのモデルは現在導入準備中です。できるだけ早く提供を開始する予定です。
2. Kimi K3.1 Pro Highspeedの速度差はどれくらい?
ここでは、正直にお伝えします。現時点で確認できる速度データは非常に限られています。公式が公表しているのは倍率の範囲だけで、第三者が測定したのも標準版のみです。Highspeedの具体的なtokens/秒を測定した公開ベンチマークはありません。tokens/秒とは、モデルが1秒あたりに出力できるトークン数のことです。数値が大きいほど、回答が表示されるまでの時間は短くなります。
| データ項目 | 数値 | 情報源の区分 | 説明 |
|---|---|---|---|
| Highspeedの標準版に対する速度 | 標準版の2〜3倍 | 公式発表 | テスト条件や詳細データは未公開 |
| 標準版の出力速度 | 80.7 tokens/秒 | 第三者(Artificial Analysis) | 4段階評価のうち2段階 |
| Highspeedの出力速度 | なし | 未検証 | 第三者による個別測定はまだ行われていない |
| 標準版の1タスクあたりの平均出力量 | 約55K tokens | 第三者(Artificial Analysis) | Intelligence Indexのテストタスクでの数値 |
| 標準版の1タスクあたりのコスト | 約$1.98(モデルページでは$2.11) | 第三者(Artificial Analysis) | 同上 |
そのため、「Highspeedは1秒あたり何tokens出力できるのか」という質問に、現時点で信頼できる答えはありません。具体的な数値を示す記事があれば、独自に測定したもの(テスト条件の確認が必要)か、80.7に2または3を掛けて推算したものです。ここではそのような数値は提示せず、ベンチマークデータに頼らない判断方法を紹介します。
2.1 Kimi K3.1 Proの選び方:待ち時間をコストに換算する
速度そのものに価値があるわけではありません。価値があるのは、「誰かが待つ時間をどれだけ短縮できるか」です。誰も待っていないなら、どれだけ速くても意味はありません。判断は次の4ステップで行います。
- 1回あたりの待ち時間を見積もる:出力tokens ÷ 速度。標準版の速度を80.7 tokens/秒、出力を1,500 tokensとすると、表示される内容の生成には約19秒かかります。なお、どちらのモデルも思考機能は常に有効で、思考にも時間がかかります。実際の待ち時間はさらに長くなり、タスクによって異なります。
- Highspeedで短縮できる時間を見積もる:公式発表の2〜3倍を基にすると、同じ出力なら待ち時間は約6〜10秒となり、1回あたり約10秒短縮できる計算です。ただし、これは推算であり、実測値ではありません。実際のリクエストで確認してください。
- 回数と時間単価を掛け合わせる:1日に100回やり取りし、1回あたり10秒短縮できれば、合計で約17分です。この17分に、あなたやチームの時間コストを掛けます。
- 追加料金と比較する:第3節の方法で、Highspeedによって1日に増える費用を計算します。短縮できる時間の価値が追加料金を上回るなら、Highspeedを選ぶ価値があります。
よくある誤解として、「速度が3倍なら、作業効率も3倍になる」という考えがあります。モデルの出力は作業プロセスの一部にすぎません。コードを読んだり、考えたり、修正したり、テストを実行したりする時間は短くなりません。短縮されるのは「モデルの応答を待つ数秒」だけです。したがって、ステップ3では倍率で成果を単純に拡大するのではなく、実際の待ち時間を使って計算してください。
3. Kimi K3.1 ProとHighspeed、2つの料金を計算してみる
以下の2つのケースは、どちらも公式の単価をもとに計算しています。計算式もすべて記載しているので、自分のトークン数に置き換えて計算してみてください。
3.1 ケースA:コードを対話形式で20回修正
前提:1回のリクエストで入力するのは30,000トークン。そのうち25,000トークンは毎回引き継ぐリポジトリのコンテキストで、5,000トークンは新しい内容です。出力は毎回1,500トークン。5分未満の間隔で連続して20回リクエストするため、キャッシュは有効なままです。
標準版:
- 初回リクエスト:入力は
30000 × $2 / 100万 = $0.06。このうち25,000トークンがキャッシュに書き込まれ、書き込み分の料金は25000 × $2 / 100万 = $0.05 - 2回目以降のキャッシュヒット:
25000 × $0.2 / 100万 = $0.005 - 新しい内容の入力:
5000 × $2 / 100万 = $0.01 - 出力:
1500 × $10 / 100万 = $0.015 - 1回あたりの合計:
$0.005 + $0.01 + $0.015 = $0.03
Highspeed:
- キャッシュヒットの料金は変わらず、
$0.005 - 新しい内容の入力は2倍:
5000 × $4 / 100万 = $0.02 - 出力も2倍:
1500 × $20 / 100万 = $0.03 - 1回あたりの合計:
$0.005 + $0.02 + $0.03 = $0.055、約 $0.06
初回のキャッシュ書き込みにかかる一度きりの費用も含めると、20回の合計は標準版が約 $0.66、Highspeedが約 $1.26です。1回あたりの料金を厳密に比較すると、Highspeedは標準版の約1.8倍で、きっかり2倍にはなりません。キャッシュヒット分の料金が上がらないためです。結論は、料金はおよそ2倍になる一方、公式の倍率どおりなら待ち時間を半分以上短縮できます。 約 $0.6の追加料金で、20回の待ち時間を数分短縮できるため、多くの開発者にとっては割に合うでしょう。
3.2 ケースB:オフラインで1,000件を一括処理
前提:1回あたりの入力は8,000トークン、出力は600トークン。これを1,000回実行し、各リクエストで再利用できる共通のプレフィックスはないため、キャッシュは使えません。
- 標準版の1回あたりの料金:
(8000 × $2 + 600 × $10) / 100万 = $0.016 + $0.006 = $0.022、1,000回で$22 - Highspeedの1回あたりの料金:
(8000 × $4 + 600 × $20) / 100万 = $0.032 + $0.012 = $0.044、1,000回で$44
結論:追加料金を払うだけで、得るものはありません。 各結果を待つ必要はなく、タスク全体の所要時間は通常、並列実行数やキューによって決まります。追加で払う $22に、実感できるメリットはありません。
| 比較項目 | ケースA:対話形式のコード修正 | ケースB:オフラインでの一括処理 |
|---|---|---|
| リクエスト数 | 20回 | 1,000回 |
| キャッシュヒットの有無 | あり、25,000トークンを再利用 | なし |
| 標準版の合計料金 | 約 $0.66 | $22 |
| Highspeedの合計料金 | 約 $1.26 | $44 |
| 実際の料金倍率 | 約1.8~1.9倍 | 2倍 |
| 待つ人がいるか | いる | いない |
| 結論 | 料金はおよそ2倍。待ち時間を半分以上短縮できるのでおすすめ | 追加料金に見合うメリットなし。標準版がおすすめ |
4. シーンに応じて Kimi K3.1 Pro と Highspeed を選ぶ
ここまでの判断方法をよくあるシーンに当てはめると、次の表のようになります。判断基準は、「誰かが結果を待っているか」「キャッシュを活用できるか」の2点だけです。
| シーン | おすすめ | 理由 |
|---|---|---|
| 対話型プログラミング | Highspeed | ユーザーが画面を見ながら変更を待っており、リポジトリのコンテキストをキャッシュにヒットさせられます。実質的な追加料金は2倍未満です |
| 対話型エージェント | Highspeed | 短いリクエストを複数回送り、ツール呼び出しを重ねるため、各ターンの待ち時間が積み重なって体感差が大きくなります |
| デモ・ライブ配信 | Highspeed | 観客が見ているため、回答が遅いとその場の印象に直接影響します。数十回の呼び出しで生じるコスト差は無視できます |
| 大量データのクリーニング | 標準版 | 個々の結果を待つ人がいないため、速度に付加価値はありません。料金が倍になる分はすべてコストです |
| オフライン評価 | 標準版 | 評価で重視するのは結果の品質です。両モデルの性能は同じなので、速度によってスコアは変わりません |
| 定期実行タスク | 標準版 | 夜間やバックグラウンドで実行するため、数分早く終わっても違いはありません。コストを重視する場合に適しています |
1つの製品で両方のシーンを扱う場合は、使い分けることもできます。ユーザーが直接操作するフロントエンドのリクエストには kimi-k3.1-pro-highspeed を使い、バックグラウンドでの要約、アーカイブ、バッチ処理には kimi-k3.1-pro を使います。両モデルの性能は同じなので、モデル名を切り替えてもプロンプトを変更する必要はありません。
5. Kimi K3.1 Proを高速化する3つ目の変数:reasoning_effortとKimi Codeの利用枠
追加料金を払う前に、無料で試せる高速化の方法があります。どちらのモデルも「常に思考する」タイプで、回答の前に内部で推論を行います。推論にかける時間は reasoning_effort パラメーターで調整でき、「モデルにどれだけ深く考えさせるか」を指定します。設定を低くするほど推論が短くなり、結果が速く返ってきます。以下はすべて公式ドキュメントに記載されている内容です。
reasoning_effortはlow/high/maxの3段階に対応しており、デフォルトはmaxです。- 速度を上げたい場合は、まず標準版を
lowに設定して試してみましょう。速度と品質のどちらにも問題がなければ、Highspeedに倍額を払う必要はありません。 - 設定を下げると、複雑なタスクでの推論が浅くなります。つまり、品質と引き換えに速度を得る方法です。一方、Highspeedは品質を維持したまま、料金と引き換えに速度を上げます。両者では代償が異なります。
- 2つを組み合わせることもできます。Highspeedと
lowの組み合わせは、遅延をできるだけ抑えたい一方で、タスクがそれほど複雑ではない場合に適しています。
もうひとつ、見落としやすい点がKimi Codeにあります。Kimi CodeはMoonshotのプログラミングツールで、利用量は会員プランごとの利用枠で管理されます。公式のKimi Codeドキュメントによると、以下のとおりです。
k3.1-proの利用にはPlus以上の会員プランが必要です。1Mのコンテキストウィンドウを利用するには、Pro以上の会員プランが必要です。k3.1-pro-highspeedの利用にはPro以上の会員プランが必要です。- Highspeed版は利用枠を約2倍消費します。同じ会員プランの利用枠で使える量は、Highspeedではおよそ半分になります。
APIを呼び出す際には、固定値が設定されている以下のパラメーターにも注意してください。公式の要件により、リクエストには含めず、省略する必要があります。
temperatureは1.0固定top_pは0.95固定nは1固定presence_penaltyとfrequency_penaltyは0固定max_completion_tokensはデフォルトが131072、最大値は1048576
6. 公式以外で Kimi K3.1 Pro を手軽に使う方法:APIYI 経由で接続
公式 API は OpenAI と Anthropic の両方の形式に対応しており、Chat Completions、Responses、Messages の各インターフェースを利用できます。「OpenAI 互換」とは、既存の OpenAI SDK のコードをほぼ変更せず、接続先と API キーを差し替え、モデル名を変更するだけで呼び出せるという意味です。
国内の開発者は、APIYI(apiyi.com)を利用すれば、1つの API キーで複数のモデルをまとめて呼び出せます。料金は従量制で、新規ユーザーには無料のテスト枠があります。接続方法は次のとおりです。
- OpenAI 形式:
base_urlにhttps://api.apiyi.com/v1を設定 - Anthropic 形式:ベース URL に
https://api.apiyi.comを設定 modelには、プラットフォームのモデル一覧に記載されたモデル名を指定
なお、2026年10月24日時点で確認したところ、APIYI のモデル一覧には kimi-k2.5、kimi-k2.6、kimi-k2.7-code、kimi-k3 などの Kimi モデルが掲載されていますが、kimi-k3.1-pro と kimi-k3.1-pro-highspeed はまだ提供されていません。これらのモデル名や料金は、プラットフォームのモデル一覧をご確認ください。このモデルはできるだけ早く提供を開始する予定です。それまでは、既存の Kimi モデルで呼び出しの流れやキャッシュ戦略を検証しておけば、提供開始後はモデル名を変更するだけで利用できます。
7. Kimi K3.1 Pro と Highspeed の選び方
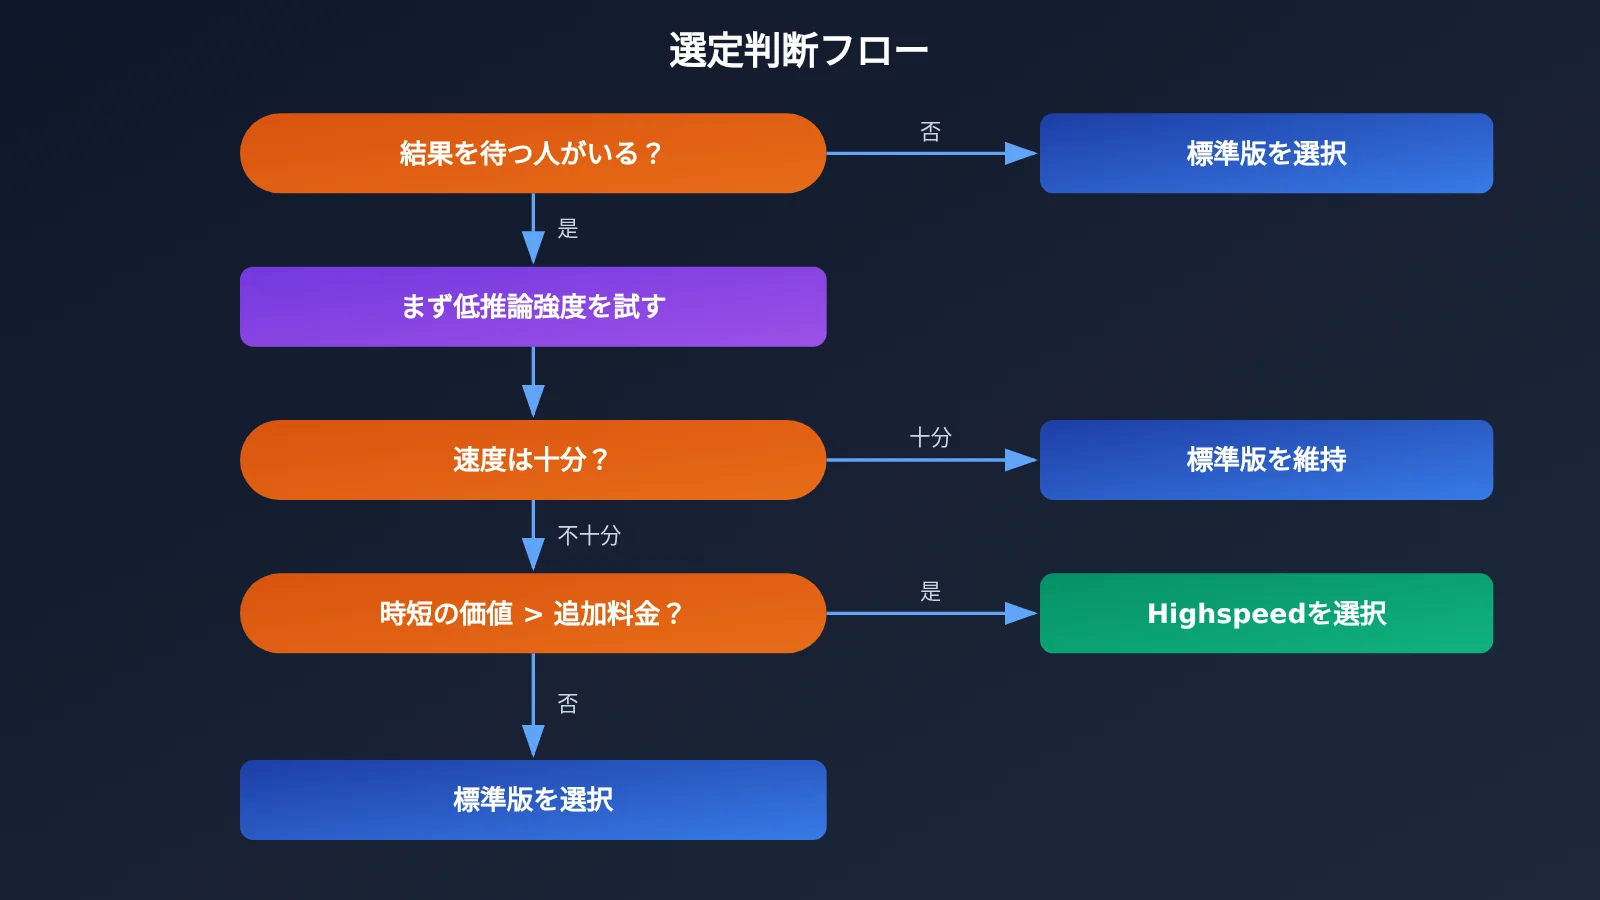
選び方のポイント:「誰かが待っているか」をまず考えてみましょう。待っている人がいなければ標準版、いる場合はまず
reasoning_effortをlowに下げて試します。それでも遅いと感じたら、Highspeed に切り替えましょう。切り替える価値があるかどうかは、第2節の方法で短縮できる待ち時間を金額に換算し、第3節で算出した価格差と比べて判断してください。実際のリクエストを使った小規模な比較を、APIYI(apiyi.com)で行うのがおすすめです。K3.1 Pro シリーズの提供開始後のモデル名と価格は、プラットフォームのモデル一覧をご確認ください。このモデルは近日中に提供開始予定です。
すぐに実践できるポイントをまとめます。
- 基本は標準版を使う。Highspeed はデフォルト設定ではなく、必要に応じて有効にする選択肢として扱いましょう
- 再利用するプレフィックスが多いほど、Highspeed のコストメリットが大きくなります。キャッシュヒット時の価格は2倍にならないためです
- チーム内で使い分ける場合は、利用経路ごとに振り分けましょう。ユーザー向けの対話には Highspeed、バックグラウンド処理には標準版を使います
- Kimi Code で Highspeed を使うときは、利用枠を考慮しましょう。消費量は約2倍です
よくある質問(FAQ)
Q1:Kimi K3.1 Pro Highspeed とは何ですか?
Moonshot が Kimi K3.1 Pro と同時に発表した高速版で、モデル名は `kimi-k3.1-pro-highspeed` です。公式発表によると、速度は K3.1 Pro の2~3倍で、モデルの能力は同じです。コンテキストウィンドウも同じく 1,048,576 tokens です。
Q2:Highspeed 版は標準版より性能が落ちたり、逆に良くなったりしますか?
公式発表では、両者の能力は同じとされています。そのため、「速くなった分、賢さが落ちる」「価格が高い分、より賢い」ということはありません。回答の品質に実際に影響するのは、どちらのバージョンを選ぶかではなく、`reasoning_effort` の設定です。
Q3:Highspeed 版はどれくらい速いですか?tokens/秒の具体的な数値はありますか?
公式発表では「2~3倍」という範囲のみが示されており、詳しい数値は公表されていません。第三者機関の Artificial Analysis は標準版の出力速度を 80.7 tokens/秒と測定していますが、Highspeed は個別に測定していません。Highspeed の具体的な数値は現時点で未検証のため、ご自身のリクエストで実測することをおすすめします。
Q4:Highspeed 版の料金が必ずしも標準版の2倍にならないのはなぜですか?
キャッシュヒット時の入力料金は、どちらも $0.20/百万 tokens だからです。リクエスト内に再利用されるプレフィックスが多く、キャッシュがヒットすれば、その部分には追加料金がかかりません。そのため、合計料金の倍率は2倍を下回ります。本記事のシナリオAでは、1回あたりの料金は標準版の約1.8倍です。
Q5:中国国内から Kimi K3.1 Pro と Highspeed を利用するにはどうすればよいですか?
公式 Kimi API のほか、APIYI(apiyi.com)の OpenAI 互換インターフェースからも利用できます。`base_url` を `https://api.apiyi.com/v1` に変更してください。APIYI でのモデル名と価格は、プラットフォームのモデル一覧をご確認ください。現在、接続作業を進めており、このモデルは近日中に提供開始予定です。
Q6:Kimi K3.1 Pro シリーズには、どのような制限がありますか?
– どちらのモデルも思考モードが常に有効で、推論を完全にオフにはできません。調整できるのは `reasoning_effort` の設定のみです
– `temperature` や `top_p` などのパラメーターは固定されているため、リクエストでは省略する必要があります。サンプリングパラメーターを調整して文体を制御することはできません
– Kimi Code で Highspeed を使うには Pro 以上の会員資格が必要です。また、利用枠の消費量は約2倍です
– 公式発表では、完全な重みを 2026-11-04 までに公開する予定ですが、現時点ではまだ公開されていません
Kimi K3.1 Pro と Highspeed の選び方:重要ポイント
- 性能は同じ:Highspeedで得られるのは速度だけで、回答の質が上がるわけではありません
- 料金は倍増:入力、出力、2段階のキャッシュ書き込み料金はすべて2倍です。キャッシュヒット料金だけは同じ$0.20です
- 速度データは少ない:公式発表では2〜3倍高速とのことですが、第三者による測定は標準版の80.7 tokens/秒のみです
- 待ち時間で判断する:人が待つ時間を金額に換算し、追加料金と比べましょう。速度の倍率を、そのまま効率の倍率と考えてはいけません
- 対話型なら高速版:対話型コーディング、対話型エージェント、ライブデモにはHighspeedが向いています
- 一括処理なら標準版:一括データクリーニング、オフライン評価、定期実行タスクでHighspeedを使うと、余計なコストがかかります
- まず設定を下げてから追加料金を検討:
reasoning_effortをlowにするのは、無料で速度を上げる方法です
まとめ
Kimi K3.1 ProとHighspeedの選び方で、押さえておきたいポイントは3つです。
- どちらも性能は同じ:どちらを選んでも回答の質は変わりません。違いは速度、料金、会員資格の条件です
- 値上げには例外がある:5段階の料金のうち4段階は2倍ですが、キャッシュヒット料金は変わりません。再利用するプレフィックスが多いほど、Highspeedの実質的な追加料金は小さくなります
- 人が待つ場面でこそ価値がある:対話型の用途では、約2倍の料金で待ち時間を半分以上短縮できます。一括処理では、追加料金を払うだけです
実際に使う際は、まず標準版でreasoning_effort=lowを設定して試し、それでも速度が足りなければHighspeedに切り替えるのがおすすめです。第3節の計算式に自分のトークン数を当てはめて、コストも確認しましょう。APIYI(apiyi.com)経由で接続する場合、K3.1 Proシリーズのモデル名と料金は、プラットフォームのモデル一覧をご確認ください。このモデルは近日中に提供開始予定です。
参考資料
- Kimi公式サイトとブログ:K3.1 ProとHighspeedのリリース情報、性能、提供チャネルに関する説明
- リンク:
kimi.ai -
説明:「速度は2~3倍、性能は同じ」という公式発表の出典
-
Artificial Analysis:第三者によるモデルの速度とコストの測定
- リンク:
artificialanalysis.ai -
説明:標準版の80.7 tokens/秒、タスクごとの出力量、コストデータの出典
-
Simon Willisonのブログ:開発者による公開記録
- リンク:
simonwillison.net -
説明:Highspeedの価格は2倍で、キャッシュヒット時の価格は標準版と同じであることを確認
-
APIYIのモデル一覧:プラットフォームで利用できるモデルと価格
- リンク:
docs.apiyi.com/models - 説明:2026-10-24時点で、Kimiシリーズのプラットフォームへの掲載状況を確認
著者:APIYI技術チーム
技術に関するお問い合わせ:接続に関する詳しい情報は、docs.apiyi.comのドキュメントセンターをご覧ください。Kimi K3.1 Proシリーズの掲載モデルと価格は、プラットフォームのモデル一覧をご確認ください。このモデルは近日中に提供開始予定です。