著者注:MiniMax M3.1 Flashの料金体系や節約方法、従量課金APIとM Planのどちらを選ぶべきかを解説する実用ガイドです。
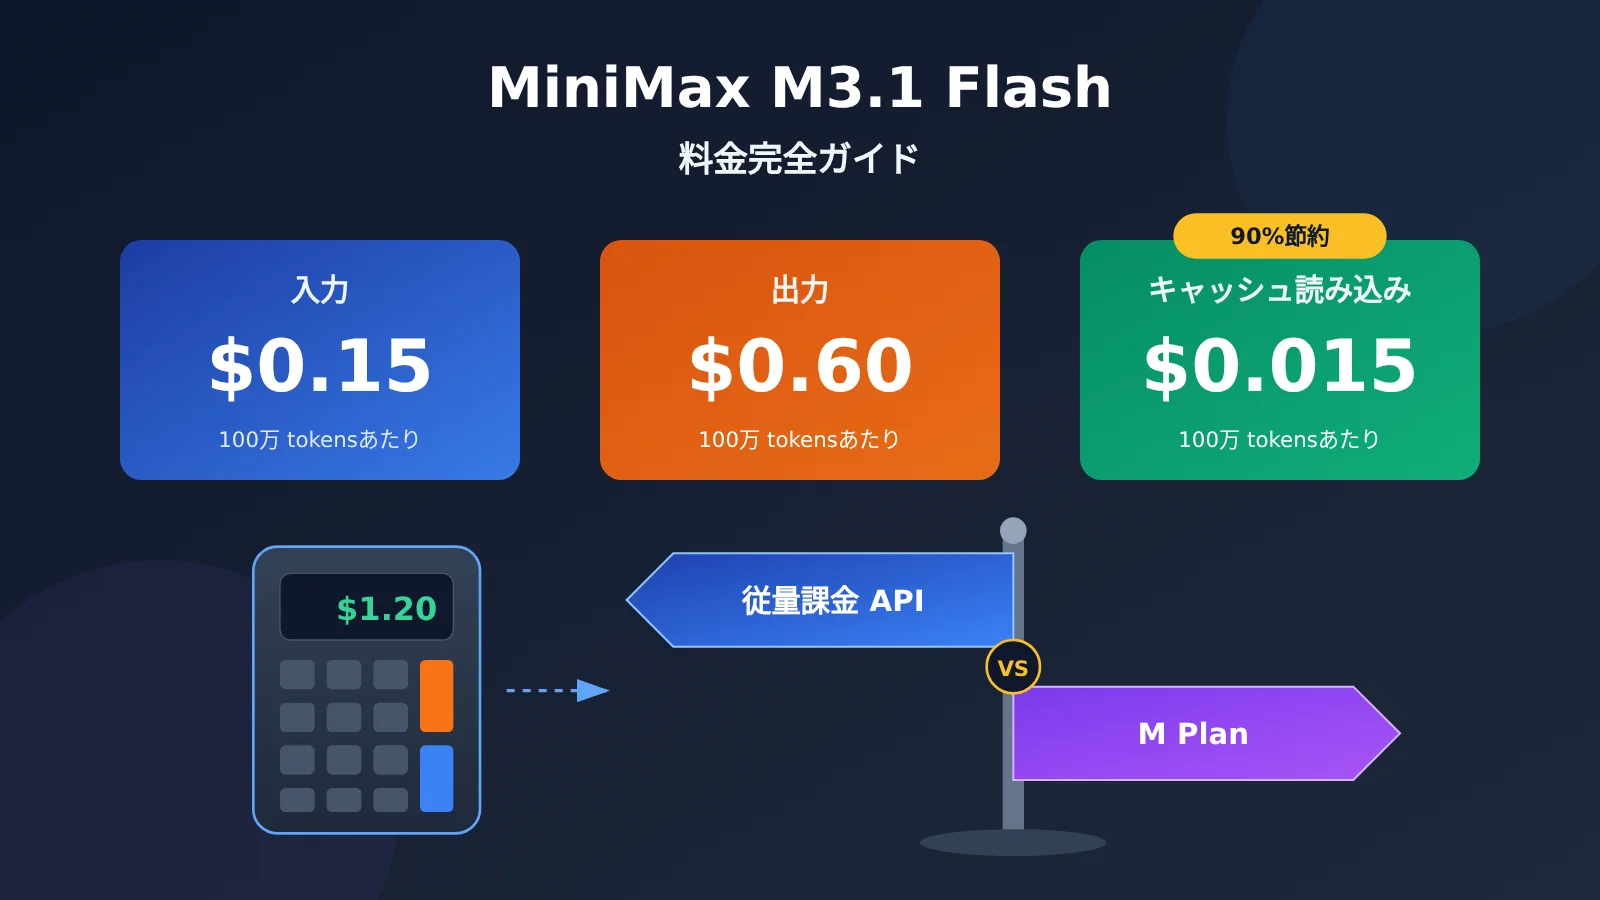
まず、結論をひと言で:MiniMax M3.1 Flashの料金は、入力が100万トークンあたり$0.15、出力が$0.60、キャッシュ読み取りが$0.015です。請求額の大半を占めるのは、通常出力(モデルの思考過程を含む)です。節約するには、effortの設定を下げる方法と、固定の内容をリクエストの先頭に置いてキャッシュを利用する方法があります。
この記事は、新たなリリースニュースではありません。リリース情報はすでに当サイトでお伝えしています。ここでは料金に絞り、3項目それぞれの単価、1回の対話や1つのAgentタスクにかかるおおよその費用、M3と比べてどこが安いのか、そして従量課金と月額サブスクリプションの選び方を解説します。
この記事でわかること:MiniMax M3.1 Flashの月額費用を自分で見積もれるようになり、よくある2つの課金上の落とし穴を避けながら、自分に合った支払い方法を選べます。
MiniMax M3.1 Flashの料金:押さえておきたいポイント
まずは「token」について説明します。tokenはモデルの料金計算に使われる最小単位で、「文字のかけら」のようなものです。公式の換算目安では、英語約750語が約1,000 tokensに相当します。中国語の換算比率は公式の料金ページに記載されていないため、実際の使用量はコンソールの請求明細で確認してください。
以下は、MiniMax M3.1 Flashの料金一覧です。MiniMax公式の料金ページに掲載されている固定料金です。
| 課金項目 | 単価(100万 tokensあたり) | わかりやすく言うと | 主な内容 |
|---|---|---|---|
| 入力 | $0.15 | モデルに送るすべての内容 | システムプロンプト、チャット履歴、アップロードした文書・画像・動画 |
| 出力 | $0.60 | モデルが返すすべての内容。思考過程も含む | 最終回答、思考内容(reasoning) |
| キャッシュ読み取り | $0.015 | 入力のうち、過去のリクエストと重複し、キャッシュが利用された部分 | 毎回同じシステムプロンプト、繰り返し参照する長文書 |
| 追加:web_search | $0.01/回 | サーバー側のウェブ検索ツール。呼び出しごとに課金 | Agentによる検索 |
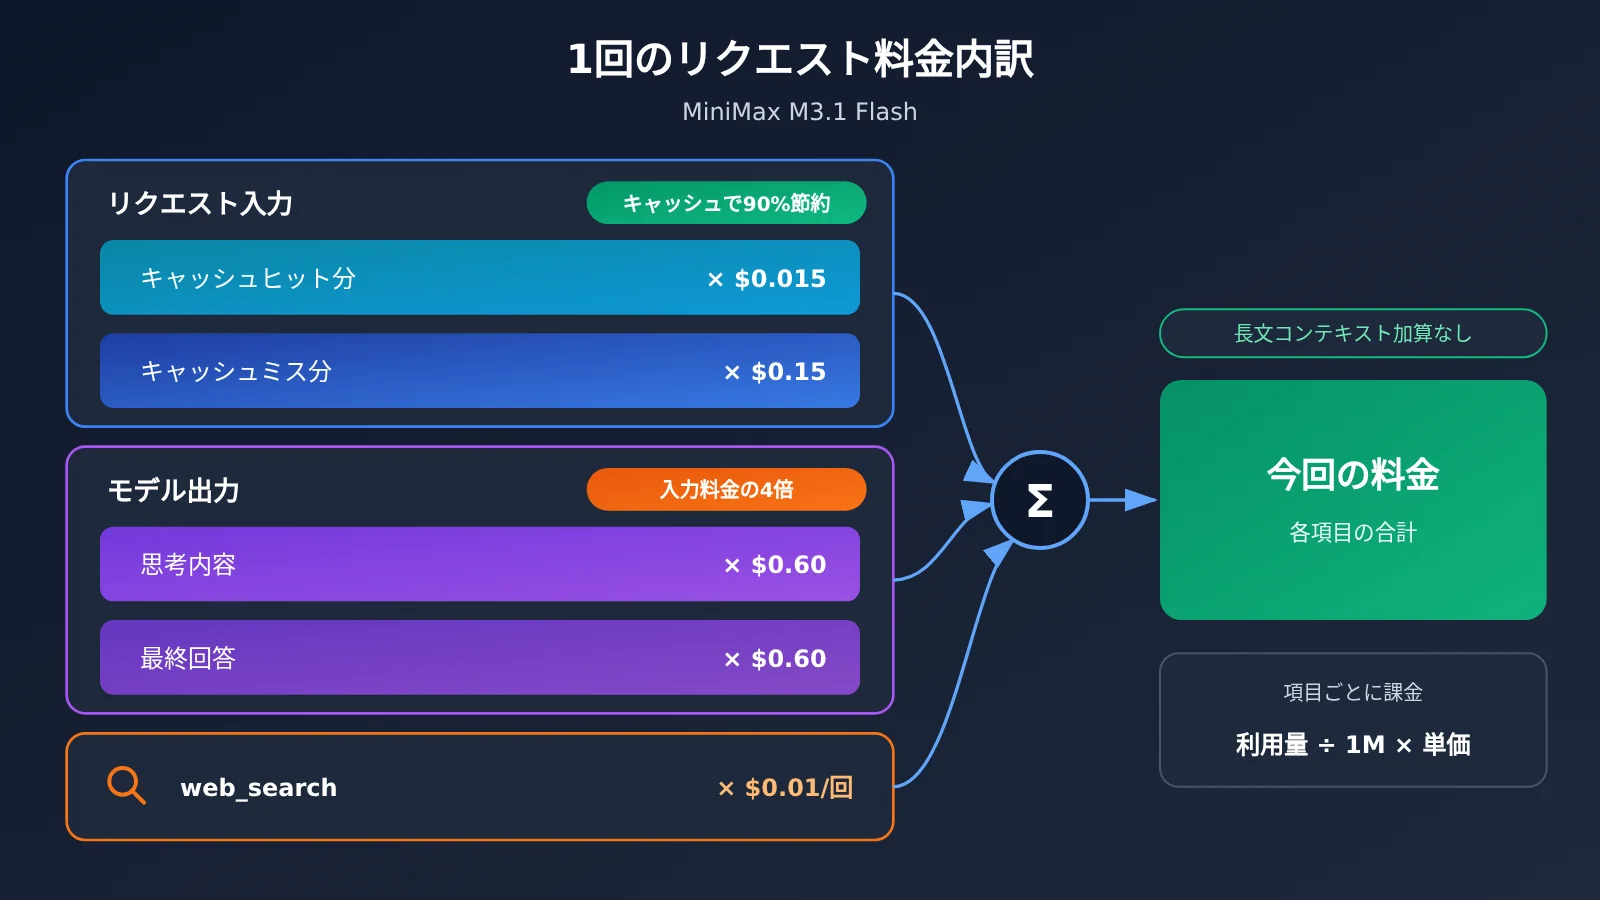
覚えておきたい点は2つあります。1つ目は、出力の単価が入力の4倍であることです。そのため、「どれだけ送ったか」よりも「モデルがどれだけ返したか」のほうが、請求額に大きく影響します。2つ目は、キャッシュ読み取りの単価が入力の10分の1であることです。キャッシュが利用された入力部分は、料金を90%節約できます。
MiniMax M3.1 Flashの料金計算式
公式の計算方法はシンプルです。料金 = 使用量 ÷ 1,000,000 × 単価。課金項目ごとに計算し、その合計がアカウント残高から差し引かれます。
1回のリクエストの料金は、次の3つに分けて考えられます。キャッシュが利用された入力 × $0.015、キャッシュが利用されなかった入力 × $0.15、出力(回答 + 思考)× $0.60。これらに検索回数 × $0.01を加えます。
また、MiniMax M3.1 Flashのコンテキストウィンドウは1,000,000 tokensです(コンテキストウィンドウとは、モデルが一度に「読み取れる」内容の最大量です)。公式の料金ページには、長いコンテキストによる追加料金はないと明記されています。10万 tokensでも80万 tokensでも、単価は変わりません。
MiniMax M3.1 Flashの料金を計算:3つの例
以下の3つの例に出てくるトークン数は、計算方法を説明するための仮定値であり、実測データではありません。ご自身の数値に置き換えて計算できます。
例1:通常の会話を1回行う場合
前提:入力2,000 tokens(キャッシュ未ヒット)、出力1,500 tokens(思考分を含む)。
- 入力:2,000 ÷ 1,000,000 × $0.15 = $0.0003
- 出力:1,500 ÷ 1,000,000 × $0.60 = $0.0009
- 合計:$0.0003 + $0.0009 = $0.0012
検算:この会話を1,000回行うと、入力は200万、出力は150万 tokensです。2 × $0.15 + 1.5 × $0.60 = $0.30 + $0.90 = $1.20となり、$0.0012 × 1,000と一致します。
例2:Agentのタスクを1つ実行する場合(複数ターン)
Agentとは、モデルが自ら手順を分解し、ツールを呼び出し、複数ターンにわたって処理を進める仕組みです。各ターンで、それまでのコンテキストを再び送信する必要があるため、入力が多くなります。その分、キャッシュの効果も特に大きくなります。
前提:合計20ターン。各ターンの入力は30,000 tokensで、そのうち25,000 tokensがキャッシュにヒットし、5,000 tokensが新しい内容。出力は各ターン2,000 tokensです。
- キャッシュ読み取り:25,000 × 20 = 500,000 tokens、0.5 × $0.015 = $0.0075
- 新規入力:5,000 × 20 = 100,000 tokens、0.1 × $0.15 = $0.015
- 出力:2,000 × 20 = 40,000 tokens、0.04 × $0.60 = $0.024
- 合計:$0.0075 + $0.015 + $0.024 = $0.0465
比較してみましょう。キャッシュにまったくヒットしない場合、入力60万 tokensの料金は0.6 × $0.15 = $0.09です。これに出力料金の$0.024を加えると、合計は$0.114になります。キャッシュによる節約額は、$0.114 − $0.0465 = $0.0675で、約59%です。
例3:1日に1,000回まとめて呼び出す場合
前提:呼び出し1回につき、固定のシステムプロンプト1,000 tokens(キャッシュにヒット)、新しい内容500 tokens、出力1,000 tokens。
- キャッシュ読み取り:1,000 × 1,000 = 100万 tokens、1 × $0.015 = $0.015
- 新規入力:500 × 1,000 = 50万 tokens、0.5 × $0.15 = $0.075
- 出力:1,000 × 1,000 = 100万 tokens、1 × $0.60 = $0.60
- 1日の合計:$0.015 + $0.075 + $0.60 = $0.69。30日換算で約$20.70/月
effortを高く設定して、1回あたりの出力が3,000 tokensになった場合(これも仮定値です)、出力料金は3 × $0.60 = $1.80に増え、1日の合計は$1.89になります。入力とキャッシュの料金は変わらないのに、請求額は元の約2.7倍($1.89 ÷ $0.69 ≈ 2.74)です。つまり、まとめて処理するタスクでは出力が料金の大部分を占めます。
🚀 まず試してみるためのヒント:少量の実データで試し、平均入力トークン数、キャッシュヒット量、出力トークン数を記録してから、上の計算式に当てはめて月額料金を見積もりましょう。感覚で予測するより、ずっと正確です。MiniMax-M3やClaudeなど、複数モデルのコストも比較したい場合は、APIYI(apiyi.com)で同じAPIキーを使ってモデルを切り替えながらテストできます。
MiniMax M3.1 Flashで特に注意したい2つの料金の落とし穴
落とし穴1:思考はオフにできない。effortの設定が料金を左右する
effortは「思考の深さ」を指定するパラメーターです。設定を高くするほど、モデルはより多くの思考を行います。MiniMax M3.1 Flashには、多くのモデルとは異なる特徴があります。思考をオフにできません。公式ドキュメントによると、thinking disabledまたはeffort noneを指定すると、model “MiniMax-M3.1-Flash” requires adaptive thinkingというエラーとともに、400エラーが返されます。
思考内容は出力として課金されます。また、effortを指定しない場合、デフォルトはmaxで、最も高額な設定です。料金を抑えるには、設定を明示的に下げるしかありません。プロトコルによってフィールド名が異なり、Anthropicプロトコルではoutput_config.effort、OpenAIプロトコルではreasoning_effort、Responsesプロトコルではreasoning.effortを使います。
| effortの設定 | 思考量 | 料金への影響 | おすすめの用途 |
|---|---|---|---|
| low | 最小 | 出力が最も少なく、最も低コストで遅延も短い | 分類、抽出、書き換え、形式変換 |
| medium | 少なめ | 比較的低コスト | 日常的な質問応答、簡単な要約 |
| high | やや多め | やや高コスト | 一般的なプログラミング、複数ステップの推論 |
| xhigh | 多め | 高コスト | 複雑な分析、難しい問題のデバッグ |
| max(デフォルト) | 最大 | 最も高コストで、遅延も最長 | 本当に難しいタスク、長い処理経路を持つAgent |
公式は、各設定で平均して何トークン多く使うかを公開していません。上の表は相対的な違いを示しています。また、公式ベンチマークとValsの第三者評価では、どちらも高い設定が使われています(Valsはeffort maxと明記)。設定を下げると性能がどの程度変わるかについては、現時点で公開データがありません。まずはlowかmediumでサンプルを試し、結果が不十分なら設定を上げるのがおすすめです。
もう1つの変更点として、思考内容が独立して返されるようになりました。OpenAI互換プロトコルでは、思考はreasoning_contentフィールドに入り、contentには最終回答だけが入ります。以前、M3の出力に含まれる思考タグから内容を取り出していた場合は、解析ロジックの変更が必要です。
落とし穴2:キャッシュ読み込みは入力料金の10分の1。内容の順序が重要
キャッシュとは、リクエスト内の内容が過去のリクエストと完全に一致した場合、システムがそれを認識し、キャッシュ読み込みの料金で処理する仕組みです。料金は$0.015で、$0.15と比べて90%安くなります。
キャッシュのヒット率を上げるには、リクエストの冒頭部分を変えないことが重要です。
- 固定のシステムプロンプトは先頭に置き、タイムスタンプや乱数、ユーザー名などを挿入しないようにします。
- 長文ドキュメント、ナレッジベース、ツールの説明など、繰り返し使う内容はシステムプロンプトの直後に置きます。
- 毎回変わる内容(ユーザーの質問や今回のデータ)は最後に置きます。
- 複数ターンの会話では、前の履歴をむやみに削除・変更しないようにします。途中の一部を変えると、それ以降の内容はキャッシュにヒットしにくくなります。
資料で公式に公開されているのはキャッシュ読み込みの料金のみです。キャッシュの具体的なルールや、その他の関連料金については、MiniMax公式の料金ページをご確認ください。
MiniMax M3.1 Flash と M3 の価格比較
MiniMax M3.1 Flash と旧世代の M3 では、価格にどれくらい差があるのか気になる方も多いでしょう。以下の表は公式価格ページをもとにしたもので、M3は恒久的な50%割引適用後の標準プランの価格です(100万トークンあたり)。
| モデル | 入力 | 出力 | キャッシュ読み込み | 長いコンテキストの追加料金 |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 | $0.60 | $0.015 | なし |
| MiniMax-M3(入力 ≤512K) | $0.30 | $1.20 | $0.06 | — |
| MiniMax-M3(入力 >512K) | $0.60 | $2.40 | $0.12 | 単価が2倍 |
| MiniMax-M3 Priority プラン | 標準プラン × 1.5 | 標準プラン × 1.5 | — | — |
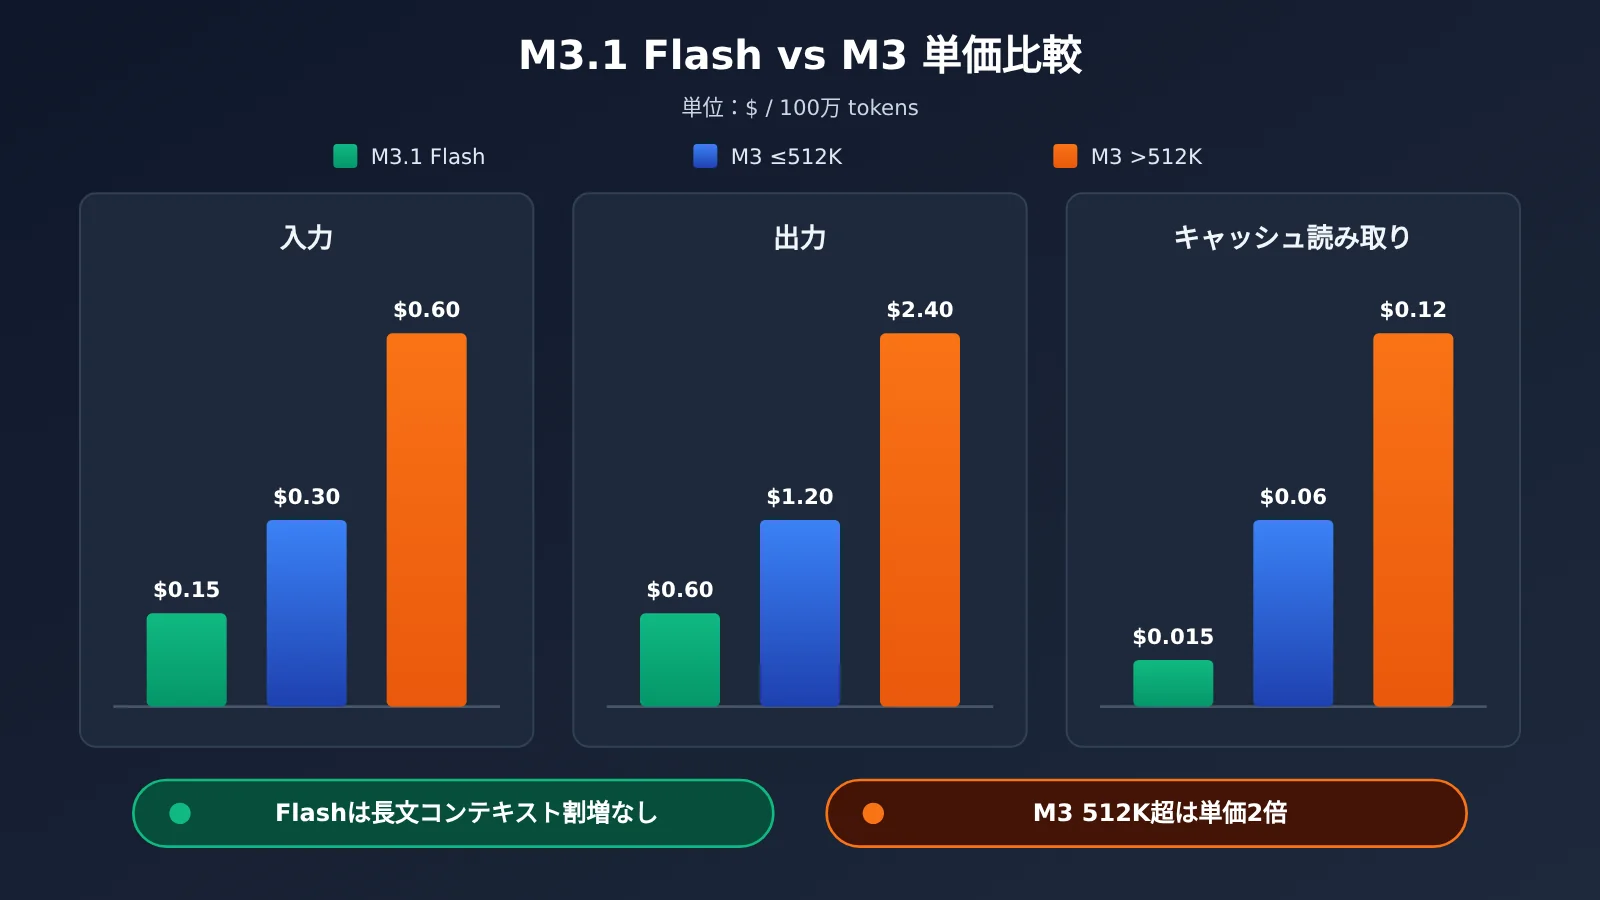
図注:価格データはMiniMaxの公式価格ページに基づいています。実際の料金は各サードパーティプラットフォームの価格ページをご確認ください。たとえば、APIYI(apiyi.com)経由でMiniMaxシリーズを利用する場合は、同サイトの価格ページに記載された料金が適用されます。
表からは、次の3点がわかります。
- 通常の長さのコンテキスト:Flashの入力・出力単価はどちらもM3の半額で、キャッシュ読み込みはM3の4分の1です($0.015対$0.06)。ユースケース3で確認してみましょう。同じ使用量をM3で処理すると、1 × $0.06 + 0.5 × $0.30 + 1 × $1.20 = 1日あたり$1.41、Flashでは1日あたり$0.69となり、約49%に抑えられます。
- 非常に長いコンテキスト:入力が512Kを超えると、M3の単価は2倍になりますが、Flashには追加料金がありません。入力・出力ともにM3の4分の1です。
- キャッシュを使うほどお得:Flashのキャッシュ読み込み単価は入力単価の10分の1、M3は5分の1です。そのため、キャッシュを多く利用するほどFlashの優位性が大きくなります。
公式の「コストが3分の1」とは? 単価は半額なのに?
この2つの説明は矛盾していません。単価が半額というのはトークンあたりの価格を指します。一方、公式X投稿の「コストが3分の1」や公式ブログの「Agentタスクの総コストを70%削減」は、いずれもタスクを1件完了するまでにかかる総費用についての説明で、公式発表によるものです。
タスク完了までの総費用 = 単価 × 使用したトークン数です。新モデルで同じタスクを完了するのに必要なラウンド数やトークン数が少なければ、タスクあたりのコストは単価以上に下がります。ただし、公式はこの「3分の1」の具体的な算出方法を公開していません。また、公式のコスト図にあるAutomation-Benchの数値(62.8)と、表に記載された数値(62.2)も一致していません。予算を立てる際は単価をもとに自分で計算し、「3分の1」という数字はあくまで参考として扱うのがおすすめです。
MiniMax M3.1 Flashの従量課金APIとM Planサブスクリプション、どう選ぶ?
MiniMax M3.1 Flashには、2つの支払い方法があります。従量課金APIは使った分だけアカウント残高から差し引かれ、M Planは月額制のサブスクリプションです。Go、Explore、Buildの3つのプランがあり、いずれもテキストモデルはM3.1 Flashです。公式ドキュメントによると、利用枠はExploreがGoの3倍、BuildがGoの7.5倍です。また、ExploreとBuildにはH3動画モデルも含まれます。各プランの月額料金は公式サイトでご確認ください。月額プランの初月割引に関する告知もありますが、キャンペーンの詳細は同じく公式サイトでご確認ください。
| 判断基準 | 従量課金APIを選ぶ | M Planサブスクリプションを選ぶ |
|---|---|---|
| 利用量 | 利用量が安定しない、または全体的に少ない | 毎日頻繁に使い、月々の支出を固定したい |
| 利用先 | 自社製品のバックエンド、バッチスクリプト、データ処理 | 自分でコードを書く、日常的なAIコーディング支援 |
| 利用するツール | 自作プログラムからAPIエンドポイントへ直接アクセス | MiniMax Code、Claude Code、Codex、Cursor、OpenCode |
| 動画が必要か | 必要に応じて別途利用 | Explore / BuildにはH3動画モデルが含まれる |
| コスト管理 | リクエストごとに細かく把握でき、effortやキャッシュを使って最適化できる | トークン数を計算する必要はありません。プランの利用枠を超えた場合の扱いは公式サイトでご確認ください |
簡単に言うと、プログラムから使うなら従量課金、人が使うならサブスクリプションです。Claude CodeやCursorなどのツールで主にコードを書く場合は、M PlanのサブスクリプションKeyをそのまま接続できます。製品開発やバッチ処理が目的なら、従量課金APIのほうが、この記事で紹介する方法でコストを把握しやすくなります。
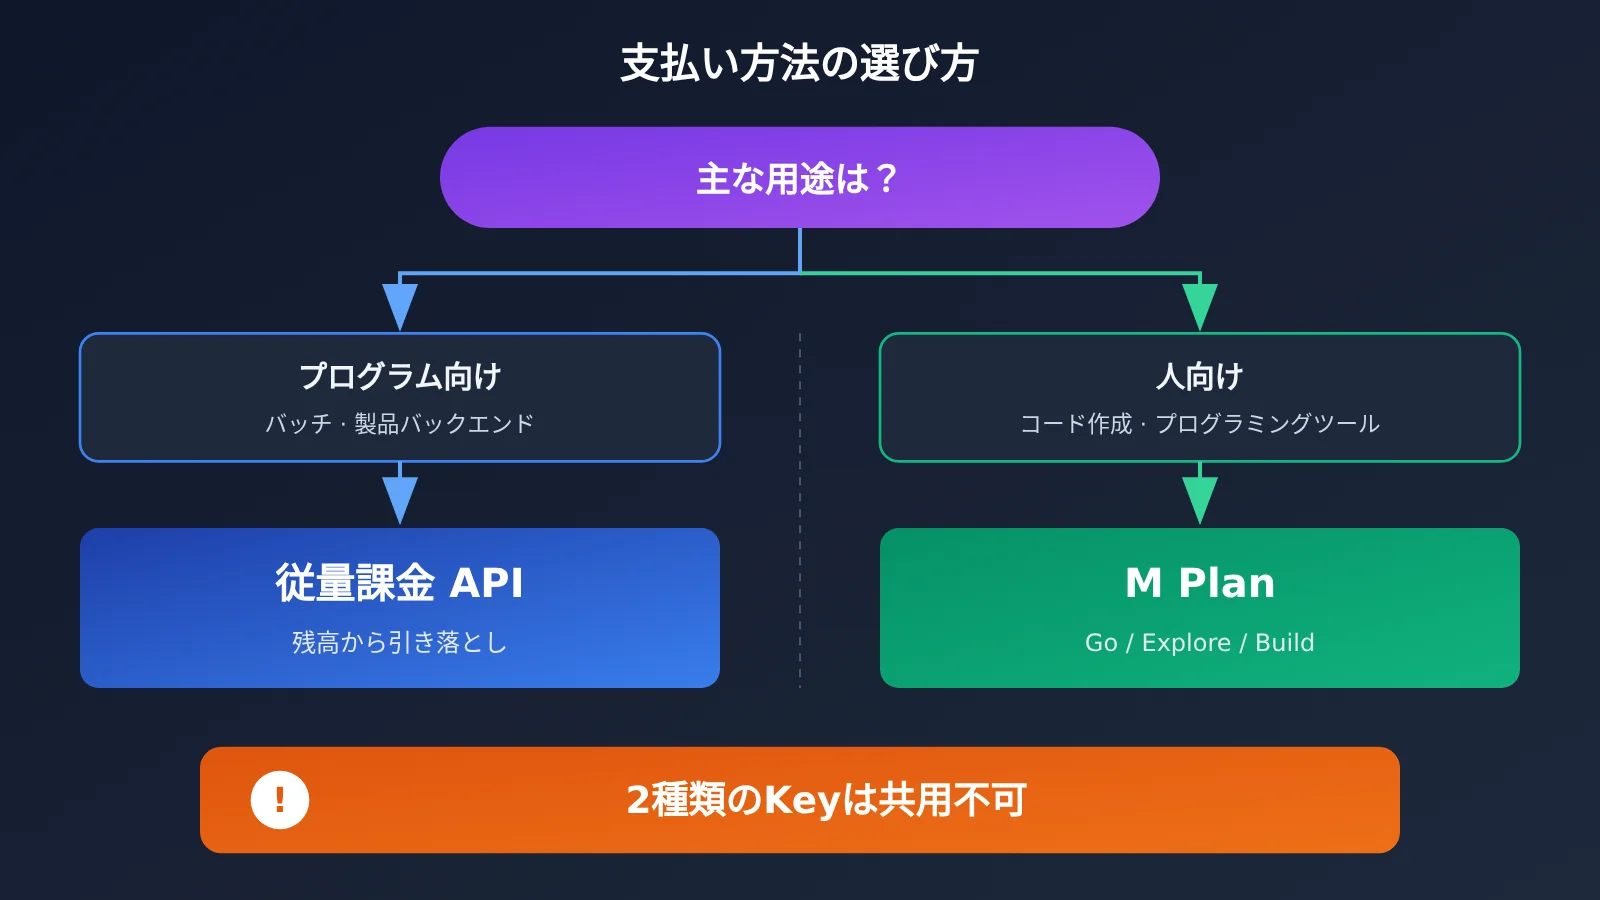
⚠️ 重要:2種類のKeyは共用できません。公式FAQによると、従量課金APIのAPI KeyとM PlanのサブスクリプションKeyは別物で、管理画面内の異なる場所から取得します。サブスクリプションKeyで従量課金APIを呼び出したり、その逆を行ったりすると問題が発生します。設定前に、正しいKeyをコピーしたか確認してください。また、旧モデル名のMiniMax-M3.1-Flash-Previewはすでに廃止されており、現在は旧名で送信されたリクエストもMiniMax-M3.1-Flashで処理されます。
MiniMax M3.1 Flashを使わないほうがよいケース
価格が安いからといって、どんな作業にも向いているわけではありません。次のようなケースでは、すぐに切り替えず、まずは一部の作業だけで試すのがおすすめです。
1. 長い処理フローを伴うエージェントや、ターミナル操作を含むタスク。 第三者評価機関のVals AIによると、M3.1 FlashのTerminal-Bench 4.0のスコアは25.25%で、51モデル中22位です。HLAB-Vals-1.1では7.50%で、23モデル中17位でした。公式発表のTerminal Bench 4.0のスコアも38.1で、Claude Opus 5の51.8を13.7ポイント下回っています。
2. 大規模なコードのリファクタリング。 公式発表のSWE Refactor Benchのスコアは23.0で、Claude Opus 5の31.0を下回っています。
3. 思考機能をオフにして、極めて低いレイテンシを求める場合。 思考機能はオフにできず、最低でもlowに設定する必要があります。
4. 既存の連携で、思考タグの解析に依存している場合。 M3から移行する際は、思考内容を取得できなくならないよう、事前に解析ロジックを変更してください。
5. 今すぐAPIYIで使いたい場合。 この記事の公開時点では、APIYIの料金ページにMiniMax-M3.1-Flashは掲載されていません。利用できるかどうかは料金ページで確認してください。
Claudeとの比較についても触れておきます。公式の比較表で比較対象になっているのはClaude Opus 5であり、Opus 5.5ではありません。Claude Opus 5.5は現在もAnthropicの最上位フラッグシップモデルですが、MiniMaxは公式にOpus 5.5との項目別比較を行っていません。そのため、FlashがOpus 5.5に追いついた、あるいは上回ったとは言えません。総合ランキングでは、Vals IndexにおいてM3.1 Flashは22モデル中15位(53.78%)、オープンウェイトモデルでは5位です。
| モデル | 入力 / 出力(100万トークンあたり) | ベンチマークの比較状況 | 得意な作業 | 利用チャネル |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 / $0.60 | 公式発表 + Valsの評価 | 大量処理、日常的なプログラミング、ツール呼び出し | MiniMax公式、APIYIは料金ページを確認 |
| claude-opus-5 | $5 / $25(公式価格) | 公式比較表の比較対象 | 複雑なタスク | APIYI apiyi.comなど |
| claude-opus-5-5 | $4 / $20(公式価格) | 公式では比較対象外 | 難易度の高い計画立案、アーキテクチャ設計、大規模なリファクタリング | APIYI apiyi.comなど |
単価で比べると、Opus 5.5の出力料金はFlashの約33倍($20 ÷ $0.60 ≈ 33.3)、入力料金は約27倍($4 ÷ $0.15 ≈ 26.7)です。これだけ価格差があるなら、どちらか一方を選ぶより、用途に応じて使い分けるのが合理的です。
APIYIでMiniMaxとClaude Opus 5.5をどう使い分けるか
2026年10月22日時点で、APIYIの料金ページから直接利用できるMiniMaxモデルは、MiniMax-M3(OpenAI形式とAnthropic形式の両方のAPIに対応し、ClaudeCodeグループでも利用可能)、MiniMax-M2.7、MiniMax-M2.7-highspeed、MiniMax-M2.5、MiniMax-M2.5-lightning、そして動画モデルのMiniMax-H3です。MiniMax-M3.1-Flashは、現時点では料金ページに掲載されていません。利用できるかどうかは、APIYIの料金ページでご確認ください。
Claudeでは、claude-opus-5-5とclaude-opus-5をどちらも直接呼び出せます。APIYIなら、1つのAPIキーでMiniMaxシリーズとClaude Opus 5.5の両方を利用できるため、別々に登録したり、チャージしたりする必要がありません。おすすめの使い分けは次のとおりです。
- コストを抑えやすい大量処理はMiniMaxに任せる:データのクリーニング、コンテンツの分類、大量の文章のリライト、簡単なコード生成などには、MiniMax-M3のようなコストパフォーマンスの高いモデルを使い、キャッシュや低めの思考レベルを組み合わせます。
- 難しい計画や大規模なリファクタリングはOpus 5.5に任せる:システムアーキテクチャの設計、複数モジュールにまたがる大規模なリファクタリング、複雑なタスク全体の計画には、claude-opus-5-5を使います。
- まず計画を立ててから実行する:Opus 5.5に方針の作成とタスクの分解を任せ、細分化したタスクをMiniMaxにまとめて実行させることで、品質とコストのバランスを取れます。
💡 選び方のヒント:どの作業を低コストなモデルに任せられるか迷ったら、APIYIのapiyi.comで同じサンプルをMiniMax-M3とclaude-opus-5-5にそれぞれ処理させ、結果とコストを比較してから使い分けの割合を決めましょう。
よくある質問(FAQ)
Q1:MiniMax M3.1 Flash の料金はいくらですか?
公式の料金ページによると、入力は 100 万トークンあたり $0.15、出力は $0.60、キャッシュ読み取りは $0.015 です。固定料金で、長いコンテキストによる追加料金はありません。サーバー側のウェブ検索機能 web_search は、別途 1 回あたり $0.01 かかります。
Q2:一言しか質問していないのに、出力トークンが多いのはなぜですか?
思考プロセスも出力としてカウントされるうえ、effort を指定しない場合はデフォルトで max に設定されるためです。思考をオフにはできません。出力を減らしたい場合は、effort を low または medium に設定してください。
Q3:MiniMax M3.1 Flash は M3 よりどれくらい安いですか?
単価は、入力・出力ともに M3 の標準料金の半額、キャッシュ読み取りは 4 分の 1 です。入力が 512K を超えると M3 の単価は 2 倍になりますが、Flash は追加料金がかかりません。公式が発表している「コストが 3 分の 1」という数値は、タスク単位の公式発表値で、計算方法は公開されていません。
Q4:従量課金の APIキーを Claude Code に入力して、M Plan を利用できますか?
できません。従量課金の APIキーと M Plan のサブスクリプションキーは別のもので、取得場所も異なり、相互に使うことはできません。サブスクリプションでツールを利用する場合は、サブスクリプションキーをコピーしてください。
Q5:現在、APIYI で MiniMax M3.1 Flash を利用できますか?
記事執筆時点では、APIYI の料金ページに MiniMax-M3.1-Flash は掲載されていません。利用できるかどうかは料金ページをご確認ください。できるだけ早く提供を開始する予定です。現在は APIYI(apiyi.com)で MiniMax M3 や claude-opus-5-5 などのモデルを利用でき、1 つの APIキーで切り替えられます。
Q6:無料で試す方法はありますか?
サードパーティープラットフォームの OpenRouter では、利用制限付きの無料エンドポイント minimax/minimax-m3.1-flash:free が提供されています。まずは性能を試したい場合に便利です。本格的に利用する際は、この記事の方法で少量のデータを使ってコストを見積もることをおすすめします。
Q7:MiniMax M3.1 Flash の弱点は何ですか?
サードパーティーの評価では、長い処理を伴う Agent タスクやターミナル操作の性能がやや低めです(Vals Terminal-Bench 4.0 では、51 モデル中 22 位)。また、公式発表のリファクタリング系ベンチマークのスコアも Claude Opus 5 を下回っています。さらに、MiniMax は Flash で何を変更したのかを説明する技術レポートをまだ公開していません。
Q8:できるだけ費用を抑えるには、まず何をすればよいですか?
まず、デフォルトの max から effort を下げましょう。次に、固定のシステムプロンプトや長いドキュメントをリクエストの先頭に置き、キャッシュを活用します。この 2 つは、モデルを切り替えるよりもすぐに効果が出ることが多いです。複数のモデルの費用をまとめて比較したい場合は、APIYI(apiyi.com)で一括テストできます。
MiniMax M3.1 Flashの価格:重要ポイント
- 3種類の単価:入力は$0.15、出力は$0.60、キャッシュ読み取りは$0.015(いずれも100万トークンあたり)。長文コンテキストによる追加料金はありません。
- 請求額の大半は出力分:思考トークンも出力として計算されます。デフォルトのmax設定では最も高くなるため、節約するならまずeffortを下げましょう。
- 思考はオフにできない:
disabledやnoneを指定すると400エラーになります。最低でもlowに設定する必要があります。 - キャッシュで90%節約:固定の内容を前方に置き、変化する内容は後方に配置しましょう。
- 単価はM3の半分:「コスト1/3」はタスク単位での公式発表です。両者に矛盾はありません。
- プログラムには従量課金、人にはサブスクリプション:2種類のキーは互換性がありません。M Planの月額料金は公式サイトで確認してください。
- 組み合わせて使うとお得:APIYIで1つのキーを使い、MiniMaxにバッチ処理を、Opus 5.5に計画立案を任せられます。
まとめ
MiniMax M3.1 Flashの価格について、押さえておきたいポイントは次のとおりです。
- 料金を計算する:料金 = 使用量 ÷ 100万 × 単価。入力、キャッシュ読み取り、出力をそれぞれ計算して合計します。
- 費用を抑える:effortを下げて思考出力を調整し、固定の内容を前方に置いてキャッシュを活用しましょう。
- 用途に合わせて選ぶ:プログラムには従量課金API、人が使う場合はM Planがおすすめです。長い処理フローを扱うAgentや大規模なリファクタリングには、より高性能なモデルの利用をおすすめします。
まずは少量の実データで試し、1回あたりのコストを計算してから、支払い方法やモデルの使い分けを決めましょう。複数のモデルの性能と費用を比較する場合は、APIYI(apiyi.com)で1つのキーを使ってまとめてテストするのがおすすめです。MiniMax-M3.1-Flashを利用できるかどうかは、料金ページでご確認ください。
📚 参考資料
- MiniMax公式発表ブログ:M3.1 Flashの速度、コスト、公式発表のベンチマークスコア
- リンク:
minimax.io/blog/minimax-m31f -
説明:公式価格と「エージェントタスクのコストを70%削減」の出典
-
MiniMax公式料金ページ:FlashとM3の完全な料金一覧
- リンク:
platform.minimax.io/docs/guides/pricing -
説明:料金計算式、長いコンテキストの料金区分、web_searchの料金
-
MiniMax公式ドキュメント:モデル呼び出し:effortの段階と推論のルール
- リンク:
platform.minimax.io/docs/guides/text-generation -
説明:推論は無効化できないこと、各プロトコルにおけるeffortフィールド名
-
MiniMax M Planのサブスクリプション案内:Go / Explore / Buildの3プラン
- リンク:
platform.minimax.io/docs/m-plan/intro -
説明:利用量の倍率、対応ツール、モデルの説明
-
MiniMax公式FAQ:APIキーとサブスクリプションキーの違い
- リンク:
platform.minimax.io/docs/faq/about-apis -
説明:2種類のキーは互換性がないという公式説明
-
Vals AIの評価ページ:第三者による評価結果
- リンク:
vals.ai/models/minimax_MiniMax-M3.1-flash - 説明:Vals Indexの順位、得意分野と不得意分野
著者:APIYI技術チーム
技術に関するお問い合わせ:APIYI(apiyi.com)のトップページからお気軽にご連絡ください。導入に関する資料はdocs.apiyi.comのドキュメントセンターをご覧いただけます。