Anmerkung des Autors: Für unabhängige Entwickler gedacht – ein Plan für die Multi-Modell-Anbindung von AI Agents und Workflows in Ein-Personen-Projekten, gegliedert in 5 Etappen: Aufgabenebenen, einheitliche Schnittstelle, Routing mit Fallback, Kostenkontrolle sowie Monitoring und Evaluierung.
Wenn man allein an einem KI-Produkt arbeitet, ist der größte Stolperstein oft nicht der Prompt, sondern die Anbindung mehrerer Modelle. Bei der Planung von Agents und Workflows tauchen schnell einige Fragen auf: Welches Modell wählt man? Sollte man mehrere Anbieter gleichzeitig anbinden? Wie verwaltet man die Keys? Wie behält man die Rechnungen im Griff? Und was tut man, wenn ein Dienst einmal schwächelt? Dieser Artikel stellt eine Planungsmethode für die Multi-Modell-Anbindung nach dem Prinzip „Aufgabenebenen + einheitliche Schnittstelle + Routing mit Fallback“ vor, mit der du das in einem Ein-Personen-Projekt sowohl entspannt als auch erweiterbar umsetzen kannst.
Das hier ist keine verkleinerte Version einer Unternehmensarchitektur. In Teams kümmert sich jemand dediziert um Gateway, Monitoring und Finanzabstimmung – in einem Ein-Personen-Projekt gibt es diese Ressourcen nicht. Die folgenden Empfehlungen drehen sich alle um ein Prinzip: mit minimalem Wartungsaufwand ausreichend Flexibilität gewinnen.
Der Kern des Ganzen: Nach dem Lesen dieses Artikels weißt du, wie du für deine AI Agents und Workflows Modellebenen einteilst, die Anbindungsweise vereinheitlichst, Fallback-Ketten entwirfst und genau siehst, wie viel jeder einzelne Aufruf gekostet hat.
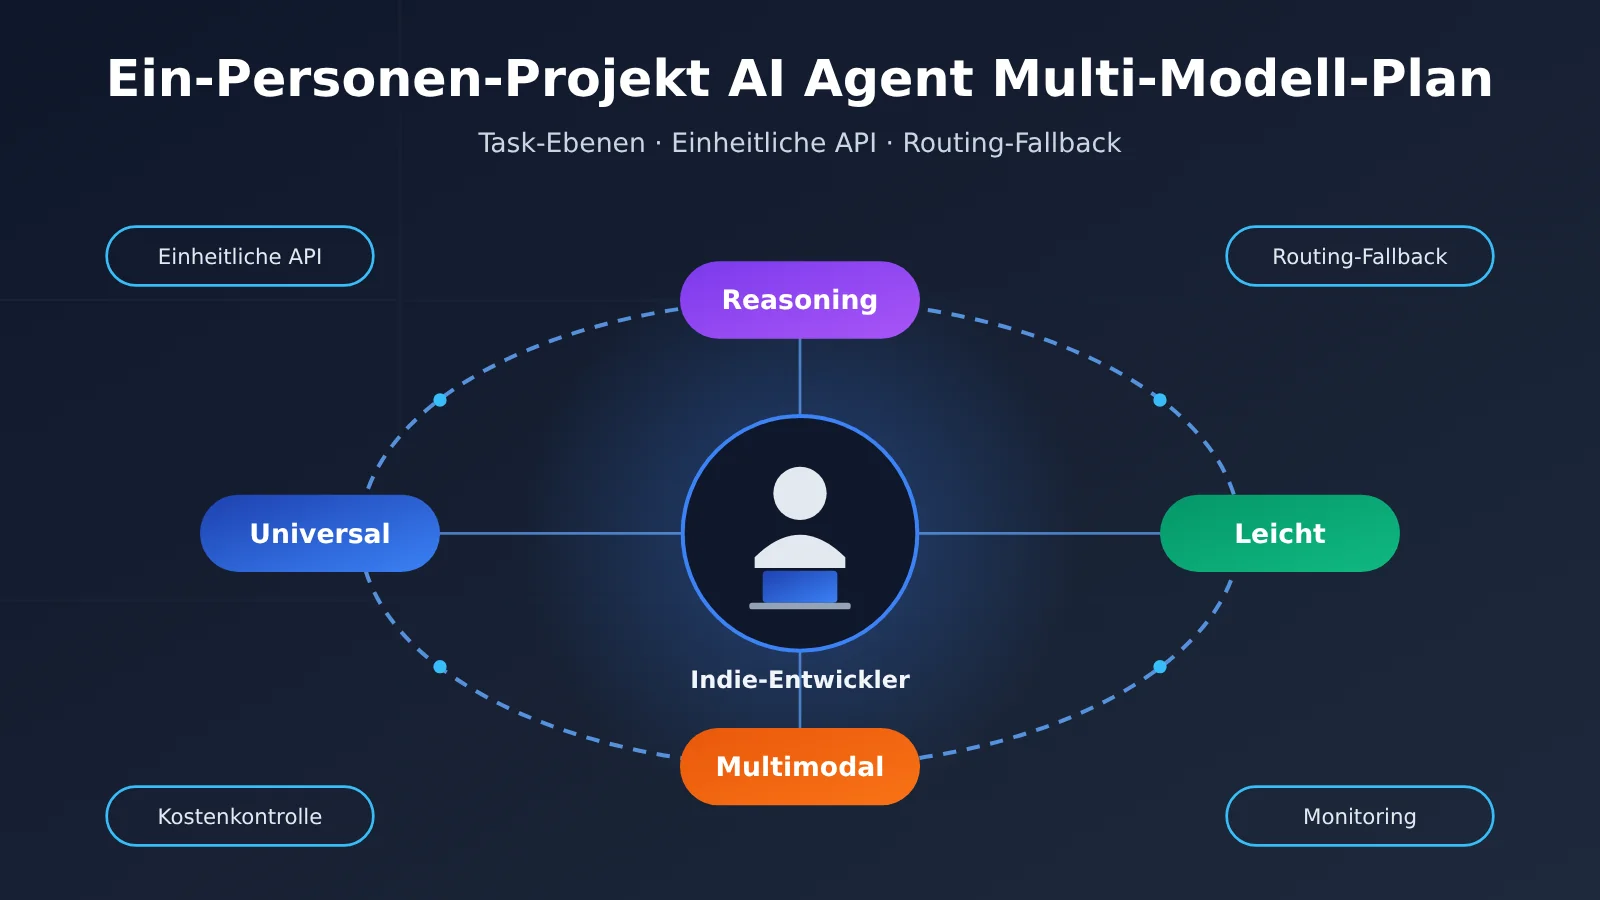
Kernpunkte der Multi-Modell-Anbindung für ein Solo-Projekt mit KI-Agenten
Bevor du mit dem Programmieren beginnst, solltest du die folgenden fünf Punkte klären. Sie entscheiden darüber, ob du in den nächsten drei Monaten am Produkt iterierst oder die Anbindungsschicht reparierst.
| Punkt | Erläuterung | Nutzen für ein Solo-Projekt |
|---|---|---|
| Aufgabenschichtung | Aufrufe in Agenten und Workflows nach Schwierigkeit und Häufigkeit in 3–4 Ebenen aufteilen | Teure Modelle nur an kritischen Stellen einsetzen; die Gesamtkosten bleiben beherrschbar |
| Einheitliche Schnittstelle | Alle Modelle nutzen ein einziges Anfrageformat, z. B. das OpenAI-kompatible Format | Ein Modellwechsel erfordert nur eine Parameteränderung, kein Umschreiben des Geschäftscodes |
| Routing und Fallback | Für jede Ebene ein Primärmodell und ein Ausweichmodell konfigurieren | Bei einer Störung eines einzelnen Dienstes bleibt das Produkt nicht komplett unbrauchbar |
| Kostenbetrachtung | Eingabe, Ausgabe, Cache und weitere Abrechnungsposten getrennt betrachten; maßgeblich sind die Preisseiten der Plattform | Vermeidet außer Kontrolle geratene Monatsabrechnungen |
| Monitoring und Evaluierung | Bei jedem Aufruf Modell, Laufzeit, Token und Ergebnisqualität erfassen | Modellwechsel anhand von Daten entscheiden, nicht aus dem Bauch heraus |
Die Planung der Multi-Modell-Anbindung im Detail
Die Aufgabenschichtung ist der Ausgangspunkt der gesamten Planung. Ein typischer KI-Agent erledigt viele unterschiedliche Dinge: Nutzerabsicht verstehen, Schritte planen, Tools aufrufen, Ergebnisse zusammenfassen, Ausgabe formatieren. Diese Schritte stellen sehr unterschiedliche Anforderungen an die Modellfähigkeiten. Für Aufgaben wie Intent-Klassifikation oder Feldextraktion reicht meist ein leichtgewichtiges Modell; mehrstufige Planung, komplexe Codegenerierung und Reasoning über lange Dokumente brauchen dagegen ein Flaggschiffmodell. Wenn der gesamte Ablauf mit dem stärksten Modell läuft, steigen Kosten und Latenz um ein Vielfaches; umgekehrt führt der durchgängige Einsatz leichter Modelle an kritischen Stellen leicht zu Fehlern. Erst schichten, dann Modelle auswählen – das ist für ein Solo-Projekt der wirtschaftlichste Ansatz.
Die einheitliche Schnittstelle entscheidet über deinen Wartungsaufwand. Die offiziellen SDKs der einzelnen Modellanbieter unterscheiden sich bei Parameternamen, Streaming-Rückgabeformaten und der Struktur von Tool-Aufrufen. Wer gleichzeitig drei oder vier offizielle APIs direkt anbindet, muss drei oder vier Sätze Anpassungscode, drei oder vier Konten und drei oder vier Rechnungen pflegen. Für eine Einzelperson sollte diese Energie eigentlich ins Produkt fließen. Realistischer ist eine aggregierende Zugriffsschicht, die sowohl das OpenAI- als auch das Anthropic-Format unterstützt. Die Geschäftsseite kennt dann nur noch ein Protokoll, und Modelle werden zu austauschbaren Konfigurationsparametern.
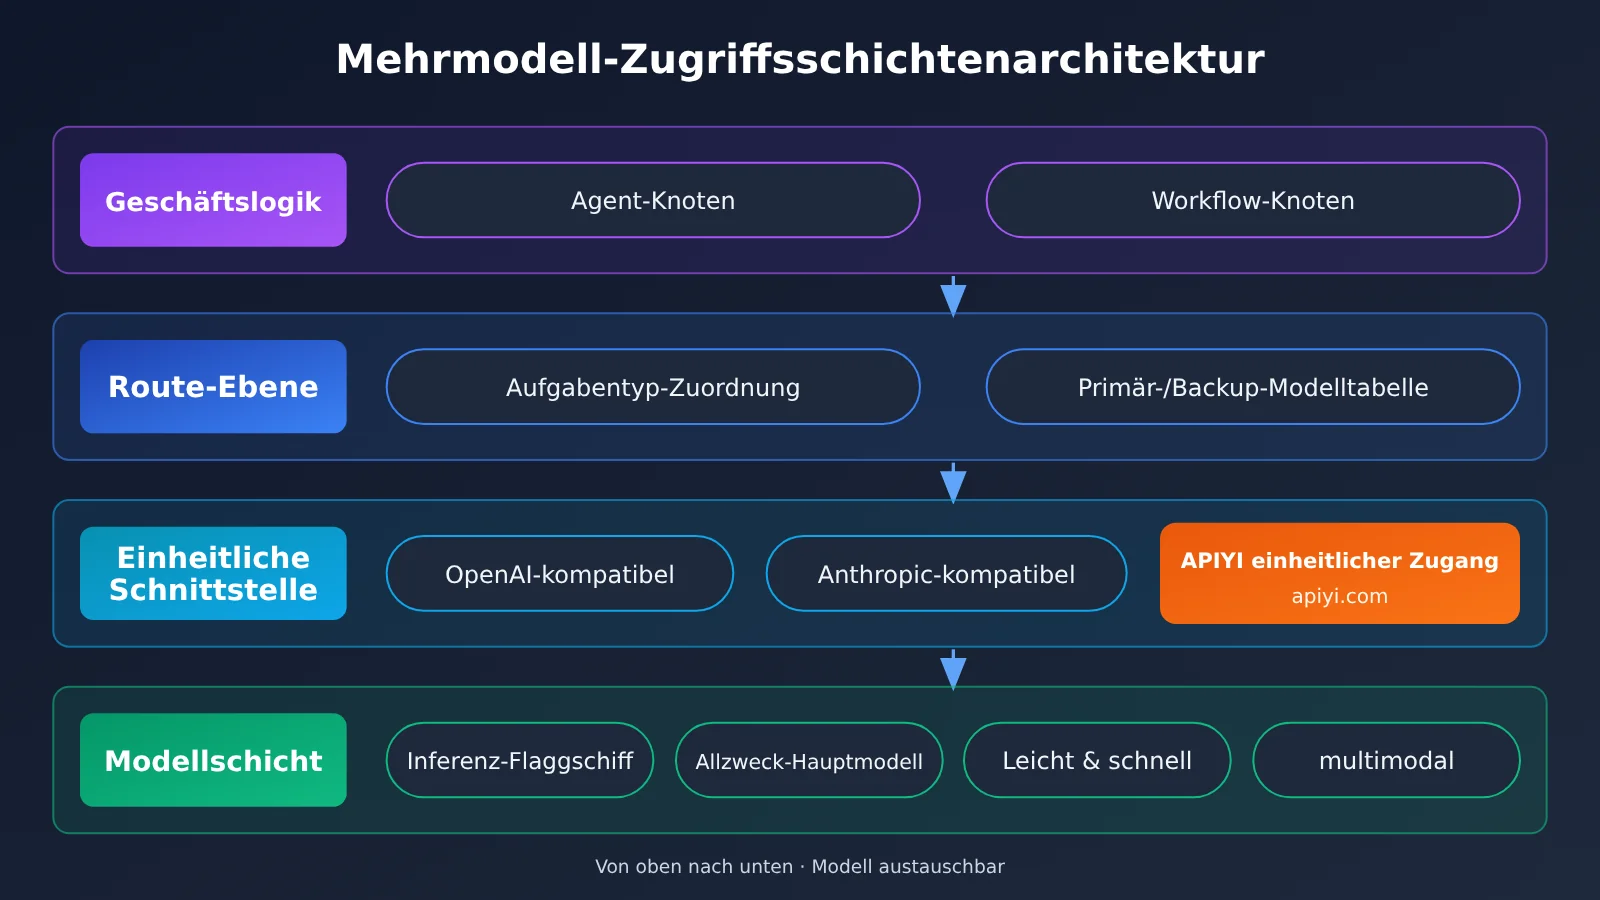
Wie man bei AI-Agenten in Ein-Personen-Projekten Modelle nach Aufgaben schichtet
Der entscheidende Punkt bei der Schichtung ist, nach Aufgabenmerkmalen zu unterscheiden – nicht nach Modellnamen. Die folgende Vierteilung eignet sich für die meisten AI-Agenten und Workflows als Ausgangspunkt und lässt sich anschließend an das eigene Geschäft anpassen.
| Ebene | Typische Aufgaben | Anforderungen an die Modellfähigkeiten | Auswahlansatz |
|---|---|---|---|
| L1 Reasoning-Ebene | Mehrstufige Planung, komplexer Code, Analyse langer Dokumente | Tiefes Reasoning, starke Befolgung von Anweisungen, langes Kontextfenster | Flaggschiff- oder Reasoning-Modelle der Anbieter, geringe Aufrufhäufigkeit |
| L2 Hauptebene | Normale Dialoge, Inhaltserzeugung, Tool-Aufrufe | Ausgewogene allgemeine Fähigkeiten, stabile Tool-Aufrufe | Gängige Allzweckmodelle, die den Großteil des Anfragevolumens bewältigen |
| L3 Leichtgewichtsebene | Intent-Klassifikation, Feldextraktion, Zusammenfassung, Umformulierung | Schnell, günstig, formatstabil | Leichtgewicht- oder Mini-Modelle, hohe Aufrufhäufigkeit |
| L4 Spezialebene | Bildverständnis, Bilderzeugung, Sprachverarbeitung, Vektorisierung | Fähigkeiten für bestimmte Modalitäten | Separate Auswahl nach Funktion, entkoppelt von der Textkette |
Drei Prinzipien für die Umsetzung der Workflow-Schichtung in Ein-Personen-Projekten
Eine Schichtungstabelle aufzustellen ist nicht schwer. Die Herausforderung besteht darin, sie im Workflow wirklich durchzuhalten. Die folgenden drei Grundsätze helfen Ihnen, Umwege zu vermeiden:
- Im Zweifel nach unten einordnen, erst nach Validierung nach oben verschieben. Wenn Sie einen neuen Knoten hinzufügen, testen Sie ihn zuerst mit einem leichten L3-Modell. Erst wenn die Ergebnisse nicht ausreichen, wechseln Sie zu L2 oder L1. So vermeiden Sie die Angewohnheit, für alles das teuerste Modell zu verwenden.
- Planung und Ausführung trennen. Überlassen Sie dem L1-Modell das „gründliche Durchdenken, was zu tun ist“, und L2 oder L3 die „konkrete Ausführung“. Viele Agent-Frameworks unterstützen unterschiedliche Modelle für Planer und Executor – das ist die Optimierung mit dem besten Preis-Leistungs-Verhältnis.
- Für strukturierte Ausgaben bevorzugt Modelle mit stabilen Formaten wählen. Nachgelagerte Workflow-Schritte müssen häufig JSON parsen. Wenn das Modell gelegentlich zusätzlichen Text ausgibt, scheitert die gesamte Kette. Bei solchen Knoten sollte die Formatstabilität ausschlaggebend sein – nicht nur die „Intelligenz“.
Zu beachten ist, dass Modellversionen schnell weiterentwickelt werden. Die obige Tabelle nennt daher bewusst keine konkreten Modellbezeichnungen. Ein solides Vorgehen: Wählen Sie aus der Modellliste der Plattform, über die Sie die Modelle anbinden, zwei bis drei Kandidaten pro Ebene aus, testen Sie sie mit Ihren eigenen realen Beispielen und entscheiden Sie dann. Die Modellliste von APIYI deckt Text-, Reasoning- und multimodale Modelle der wichtigsten Anbieter ab. Der Quervergleich lässt sich innerhalb eines Kontos durchführen – ideal für Auswahltests in Ein-Personen-Projekten.
Workflow für Solo-Projekte: Multi-Modell-Anbindung schnell umgesetzt
Dieser Abschnitt beschreibt die Umsetzungsschritte der Reihe nach. Damit es sich gut lesen lässt, werden alle Konfigurationspunkte in Tabellen und kurzen Texten erklärt, ohne Code auszubreiten.
Schritt 1: Einheitliches Anbindungsprotokoll festlegen
Auf der Anwendungsseite sollte einheitlich das OpenAI-kompatible Chat-Completions-Format verwendet werden. Gängige Agent-Frameworks, Workflow-Orchestrierungstools und die meisten Open-Source-Projekte unterstützen dieses Format standardmäßig – die Ökosystem-Kompatibilität ist hier am besten. Wenn Sie intensiv Funktionen der Claude-Reihe nutzen, etwa die native Struktur für Tool-Aufrufe oder Prompt-Caching, können Sie an den betreffenden Knoten auch das Anthropic-Messages-Format verwenden. APIYI unterstützt sowohl das OpenAI- als auch das Anthropic-Schnittstellenformat – beide Protokolle können sich ein Konto und einen Key teilen.
Schritt 2: Modellparameter in die Konfiguration auslagern
Schreiben Sie Modellnamen nicht fest in die Geschäftslogik. Alle modellbezogenen Parameter gehören in eine Konfigurationsdatei oder in Umgebungsvariablen. Die folgende Tabelle listet die Einträge auf, die Sie herausziehen sollten:
| Konfigurationseintrag | Zweck | Empfohlenes Vorgehen |
|---|---|---|
base_url |
Schnittstellenadresse | Tragen Sie die Anbindungsadresse ein, die in der APIYI-Dokumentation docs.apiyi.com angegeben ist – im gesamten Projekt nur an dieser einen Stelle |
api_key |
Authentifizierungsschlüssel | In eine Umgebungsvariable legen, für Entwicklung und Produktion jeweils unterschiedliche Keys verwenden |
model |
Modellname | Nach Ebene benennen, z. B. MODEL_L1, MODEL_L2, MODEL_L3 |
fallback_model |
Ausweichmodell | Pro Ebene mindestens eines konfigurieren, am besten von einem anderen Anbieter |
timeout |
Timeout | Bei L3 kurz, bei L1 lang – so werden Reasoning-Modelle nicht fälschlich als Timeout gewertet |
max_tokens |
Obergrenze für die Ausgabe | Pro Knoten festlegen, damit ungewöhnlich lange Ausgaben die Kosten nicht hochtreiben |
Danach müssen Sie zum Modellwechsel nur die Konfiguration ändern – Agent-Logik und Workflow-Orchestrierung bleiben unangetastet.
Schritt 3: Ebenen an den Workflow-Knoten kennzeichnen
Öffnen Sie Ihr Workflow-Diagramm und kennzeichnen Sie jeden Knoten, der ein Modell aufruft, mit L1 bis L4. Egal ob Sie ein visuelles Orchestrierungstool oder selbst geschriebenen Ablaufcode verwenden – Sie können die Ebene in der Knotenbeschreibung oder in den Parametern vermerken und das passende Modell dann aus der Konfiguration lesen. Das ist schnell erledigt, zeigt Ihnen aber auf einen Blick, an welchen Knoten die Kosten hauptsächlich entstehen.
Schritt 4: Fallback und Retry konfigurieren
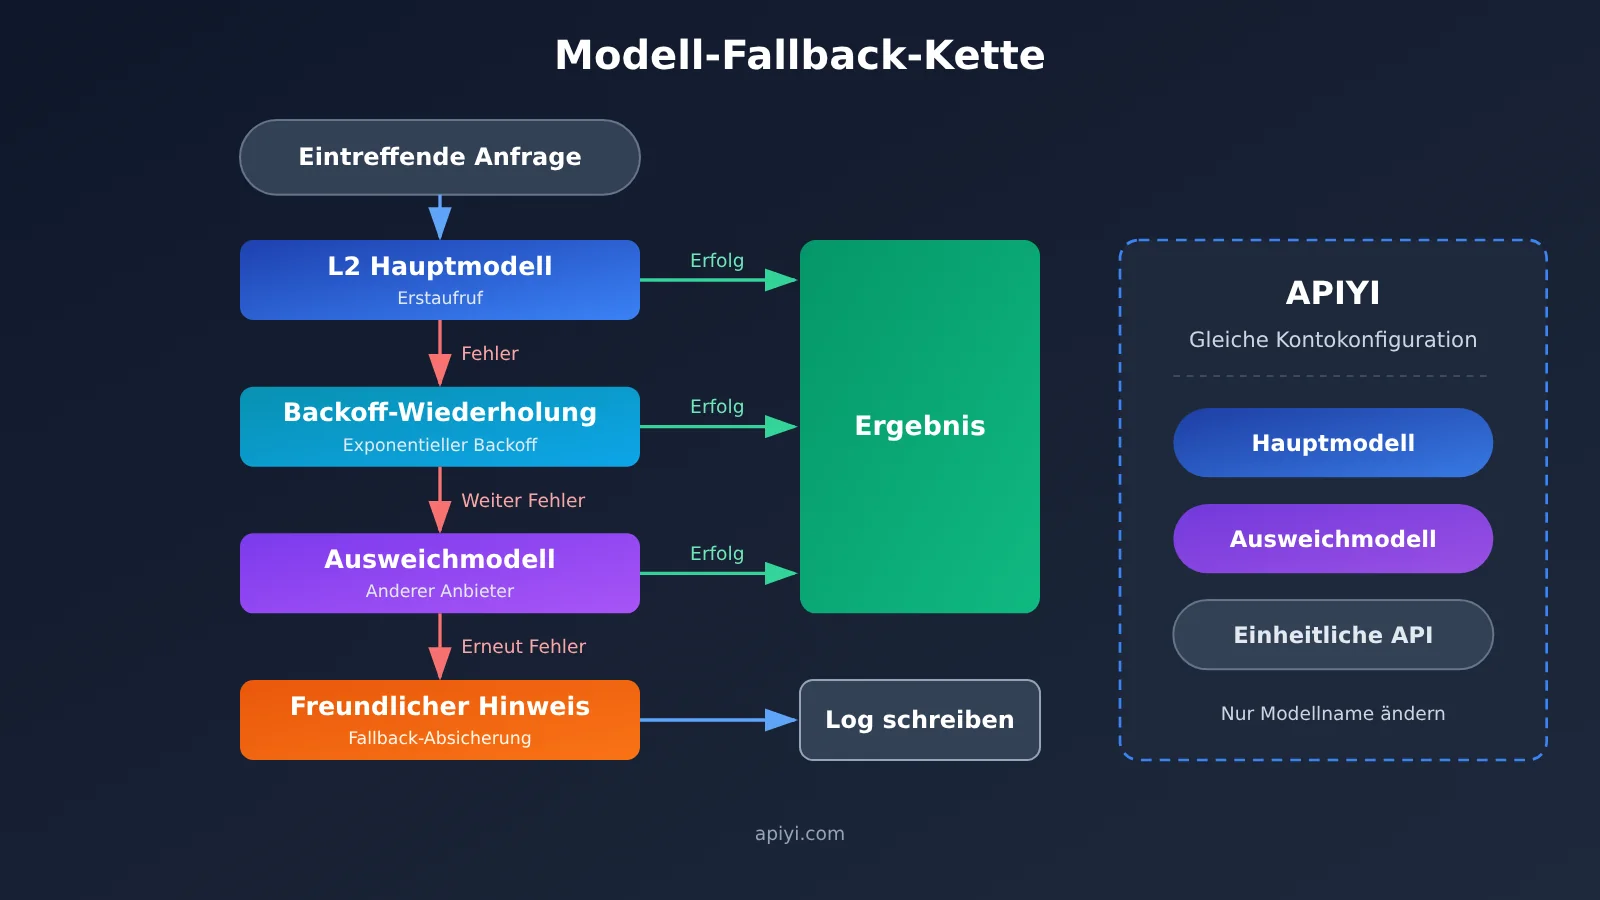
Konfigurieren Sie für jede Ebene die Reihenfolge „Primärmodell → Ausweichmodell“. Meldet das Primärmodell Rate-Limiting, einen Timeout oder einen Serverfehler, folgen zunächst ein bis zwei Retries mit Backoff; schlägt das weiterhin fehl, wird auf das Ausweichmodell gewechselt. Wählen Sie für das Ausweichmodell möglichst ein Produkt derselben Klasse von einem anderen Anbieter – so entgehen Sie einem Ausfall, der sich auf einen einzelnen Dienst konzentriert.
Schritt 5: Jeden Aufruf protokollieren
Erfassen Sie mindestens diese Punkte: Zeitpunkt, Knotenname, Ebene, Modellname, Input-Token, Output-Token, Dauer, ob ein Fallback ausgelöst wurde und ob der Aufruf letztlich erfolgreich war. Eine einfache Log-Tabelle oder ein leichtgewichtiges Observability-Tool reicht aus – wichtig ist, dass Sie konsequent protokollieren.
🚀 Tipp für den Schnellstart: Für Solo-Projekte empfiehlt es sich, sich zuerst bei APIYI apiyi.com zu registrieren und Testguthaben zu holen. Lassen Sie dann mit demselben Key alle Kandidatenmodelle von L1 bis L3 jeweils an echten Beispielen laufen. Erst danach die Auswahl in die Konfiguration schreiben – das spart deutlich mehr Aufwand, als zuerst anzubinden und dann immer wieder Code zu ändern.
Ein-Personen-Projekt: Vergleich der Multi-Modell-Anbindung für KI-Agenten
Für die Anbindung mehrerer Modelle gibt es grob vier Wege – und der Wartungsaufwand unterscheidet sich dabei erheblich.
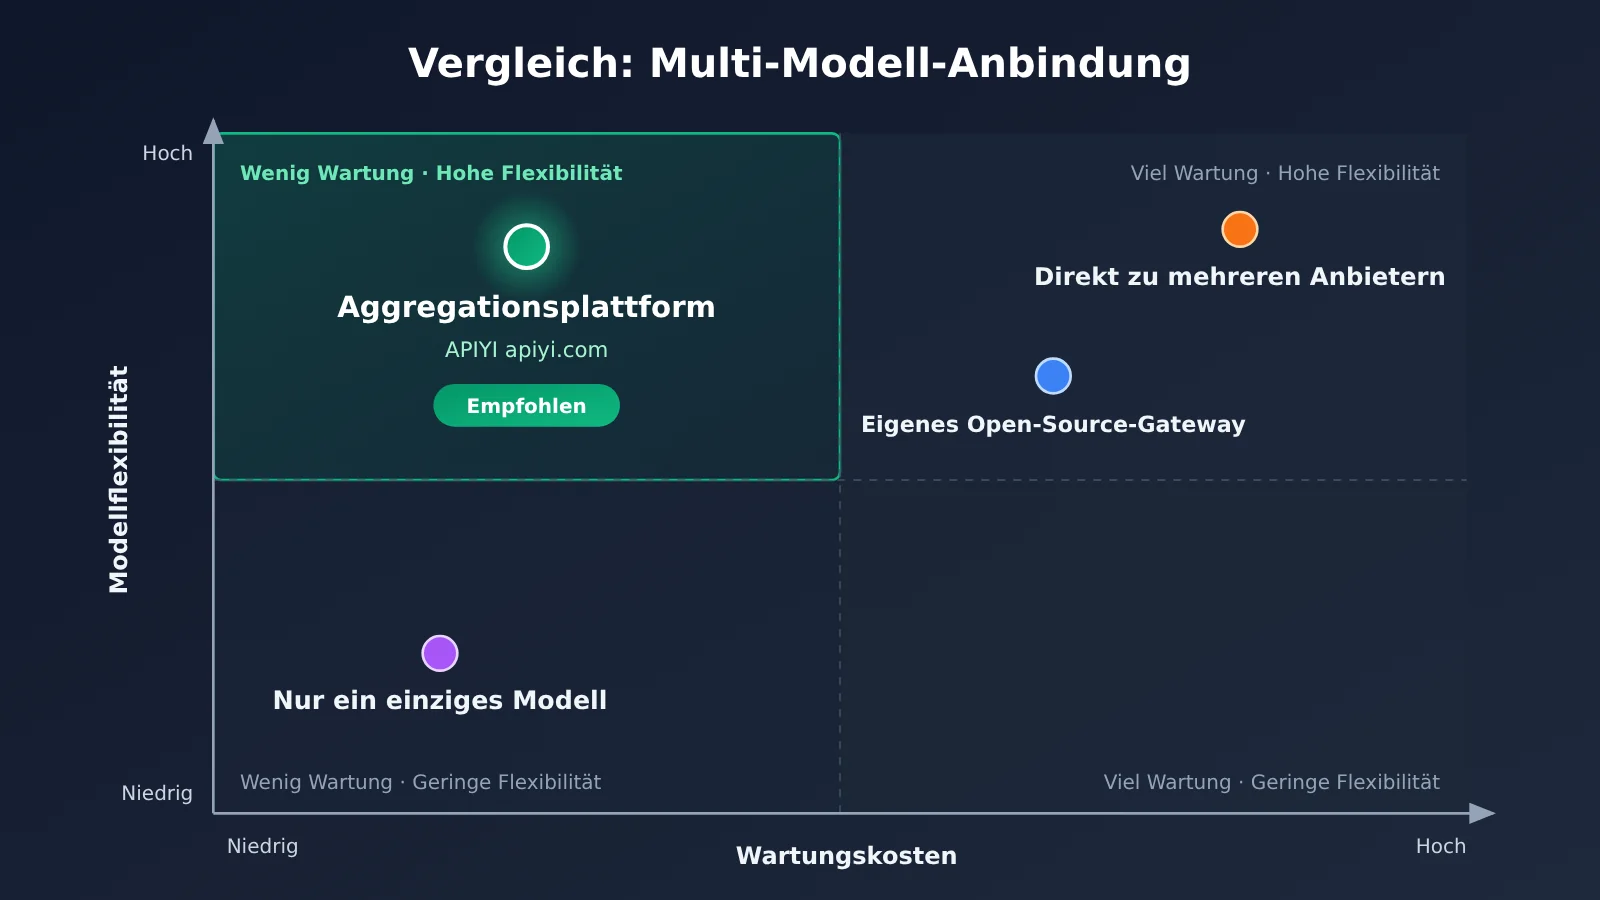
| Lösung | Kernmerkmale | Geeignete Szenarien | Wartungsaufwand für ein Ein-Personen-Projekt |
|---|---|---|---|
| Nur ein einziges Modell | Ein Anbieter, ein Modell – am einfachsten | Prototypenvalidierung, kleine Tools mit einer einzigen Funktion | Niedrig, aber ohne Fallback-Möglichkeit |
| Direkte Anbindung mehrerer Anbieter | Jeden Anbieter einzeln über dessen offizielle API anbinden | Wenn man tief von den Besonderheiten eines Anbieters abhängt | Hoch, es braucht mehrere SDKs, Konten und Abrechnungen |
| Selbst betriebenes Open-Source-Gateway | Eigene einheitliche Proxy-Schicht selbst deployen | Mit Betriebserfahrung, wenn Private-Hosting nötig ist | Mittel bis hoch, Deployment, Updates und Fehlersuche in Eigenregie |
| Aggregationsplattform | Eine Schnittstelle für mehrere Modelle | Wenn man mehrere Modelle braucht, die Anbindungsschicht aber nicht pflegen will | Niedrig, Plattformen wie APIYI apiyi.com bieten eine einheitliche Schnittstelle |
Vergleichsanalyse der Anbindungsvarianten
Vergleich: Nur ein einziges Modell. Mit nur einem Modell ist man in der Startphase am effizientesten unterwegs – Routing-Design ist überhaupt nicht nötig. Dafür hängen Verfügbarkeit und Kosten komplett an einem einzigen Anbieter: Sobald dieser das Rate-Limit senkt oder die Preise anpasst, bleibt kaum Spielraum. Legt man dagegen von Anfang an eine einheitliche Schnittstelle und konfigurierbare Modellparameter an, kostet das fast keinen zusätzlichen Entwicklungsaufwand – lässt aber für spätere Erweiterungen reichlich Luft.
Vergleich: Direkte Anbindung mehrerer Anbieter. Direkte Anbindungen an die offiziellen APIs punkten bei neuen Features: Was ein Anbieter gerade veröffentlicht, lässt sich sofort nutzen. Gleichzeitig bedeutet es, mehrere Adaptionsschichten, mehrere Guthabenkonten und mehrere Abrechnungen parallel zu pflegen – das zehrt dauerhaft an der Energie einer einzelnen Person. Für die meisten Ein-Personen-Projekte ist es realistischer, nur an den Stellen direkt zu verbinden, an denen man wirklich auf ein exklusives Anbieter-Feature angewiesen ist, und den Rest über eine einheitliche Schnittstelle laufen zu lassen.
Vergleich: Selbst betriebenes Gateway. Ein selbst betriebenes Open-Source-Gateway bietet die größte Kontrolle und eignet sich für Szenarien mit Private-Hosting-Bedarf. Allerdings liegen Deployment, Updates, Monitoring und Fehlersuche komplett bei dir – unterm Strich pflegst du damit einen zusätzlichen Dienst. Wenn das Kernziel lautet, das Produkt schnell auszuliefern, ist eine Aggregationsplattform meist der sicherere Startpunkt; ob ein eigenes Gateway sinnvoll ist, lässt sich prüfen, wenn das Geschäft gewachsen ist.
💡 Empfehlung: Wenn du noch unentschieden bist, bringe alle Nodes zunächst mit APIYI zum Laufen und halte die Business-Seite ausschließlich auf das OpenAI-kompatible Format ausgerichtet. So bleiben bei einer späteren Migration auf ein eigenes Gateway oder auf die direkte Anbieter-Anbindung die Änderungen auf die Konfigurationsebene beschränkt.
Kosten- und Stabilitätskontrolle bei der Anbindung mehrerer Modelle in einem Solo-Projekt
In einem Solo-Projekt gibt es keine Finanzkollegen, die die Rechnungen im Blick behalten – Kostenkontrolle muss deshalb fest in der Architektur verankert sein. Die folgende Tabelle fasst die wichtigsten Kostenhebel zusammen:
| Kostenhebel | Vorgehen | Hinweis zur Abrechnung |
|---|---|---|
| Gestaffeltes Downgrade | Häufig aufgerufene Knoten mit L3-Leichtmodellen betreiben | Die Token-Preise unterscheiden sich je nach Modell deutlich; maßgeblich ist die Preisseite von APIYI |
| Ausgabelänge begrenzen | Für jeden Knoten max_tokens festlegen |
Bei den meisten Modellen ist der Ausgabepreis pro Token höher als der Eingabepreis; Details siehe Preisseite |
| Caching nutzen | Feste System-Eingabeaufforderungen und Tool-Definitionen an den Anfang der Anfrage stellen | Ob Caching unterstützt wird und wie es abgerechnet wird, hängt vom Modell ab; maßgeblich ist die Preisseite |
| Kontext komprimieren | Mehrrunden-Dialoge des Agenten regelmäßig zusammenfassen, den Verlauf nicht unbegrenzt anwachsen lassen | Eingabe-Token wachsen linear mit der Anzahl der Runden und sind ein großer versteckter Kostenfaktor |
| Budgetwarnungen einrichten | Token-Verbrauch täglich erfassen und bei Überschreitung des Schwellenwerts benachrichtigen | Mit Aufrufprotokollen und Plattformabrechnung abgleichen |
Zu den Preisen: In diesem Artikel werden bewusst keine konkreten Zahlen genannt. Die Eingabe- und Ausgabepreise pro Token, die Preise für Cache-Lesen und -Schreiben sowie die Abrechnungslogik ändern sich mit der Anbieterstrategie. Schätzungen aus dem Gedächtnis oder aus alten Unterlagen führen leicht zu Fehlern. Verwenden Sie für die Kostenplanung die tatsächlichen Daten auf der APIYI-Preisseite docs.apiyi.com/models, schätzen Sie die monatlichen Kosten nach dem Schema „durchschnittliche tägliche Aufrufe pro Ebene × durchschnittliche Eingabe-Token × Eingabepreis + durchschnittliche Ausgabe-Token × Ausgabepreis“ und halten Sie eine separate Spalte für Cache-Treffer vor.
Für die Stabilität sollten drei Dinge vor dem Produktivstart erledigt sein:
- Degradationskette testen: Ändern Sie den Namen des Hauptmodells manuell in einen ungültigen Wert und prüfen Sie, ob der Workflow automatisch auf das Ersatzmodell umschaltet und die Aufgabe normal abschließt.
- Timeouts staffeln: Reasoning-Modelle denken länger; der Timeout-Schwellenwert muss deutlich höher liegen als bei Leichtmodellen. Sonst gilt: Je schlauer, desto anfälliger für Timeouts.
- Idempotenz by Design: Tool-Aufrufe mit Nebenwirkungen – etwa E-Mail-Versand oder Datenbank-Schreibvorgänge – müssen davor geschützt werden, bei Wiederholungen mehrfach ausgeführt zu werden.
Häufige Fragen (FAQ)
Q1: Was ist die Multi-Modell-Planung für ein Solo-Projekt?
Damit ist gemeint, dass Sie in einem unabhängigen Entwicklungsprojekt vorab festlegen, welche Art von Modell an welcher Stelle von KI-Agent und Workflow zum Einsatz kommt, über welche Schnittstelle es angebunden wird, wie bei Fehlern ein Fallback aussieht und wie die Kosten erfasst werden. Das Ziel: Kosten- und Verfügbarkeitsvorteile gewinnen, ohne den Wartungsaufwand groß aufzublähen.
Q2: Worin unterscheiden sich KI-Agent und Workflow bei der Modellanbindung?
Beim Workflow sind die Schritte vorab festgelegt, das Modell lässt sich pro Knoten statisch zuweisen, und die Schichtung ist relativ anschaulich. Ein Agent entscheidet selbst über Reihenfolge und Anzahl der Aufrufe – das Aufrufvolumen ist schwer zu schätzen. Deshalb brauchen Sie hier eine Trennung zwischen Planungs- und Ausführungsmodell sowie eine Obergrenze für Runden und ein Token-Budget pro Aufgabe.
Q3: Muss ich schon am Anfang mehrere Modelle anbinden?
Sie müssen nicht sofort viele Anbieter einbinden, aber die Schnittstelle sollte von Beginn an einheitlich gestaltet sein. Empfehlung: Machen Sie den Modellnamen schon in der ersten Version zur Konfiguration, nutzen Sie das OpenAI-kompatible Format und halten Sie für die Kernknoten ein Ausweichmodell bereit. Der Zusatzaufwand ist minimal, die spätere Erweiterung läuft dafür umso reibungsloser.
Q4: Für welche Solo-Projekt-Szenarien eignet sich die Multi-Modell-Anbindung am besten?
– **KI-Schreib- oder Content-Tools**: Gliederung mit L1, Fließtext mit L2, Titel-Umformulierung mit L3.
– **Intelligenter Kundenservice-Agent**: Intent-Erkennung mit L3, komplexe Fragen eskalieren auf L2 oder L1.
– **Datenverarbeitungs-Workflow**: Batch-Extraktion und Klassifizierung mit L3, Ausreißerfälle zur Nachprüfung an L2.
– **Programmier-Assistenten**: Code-Planung mit L1, Vervollständigung und Kommentare mit L2 oder L3.
Q5: Wie rufe ich mehrere Modelle über eine einheitliche Schnittstelle schnell auf?
Nutzen Sie APIYI, das sowohl OpenAI- als auch Anthropic-Schnittstellenformate unterstützt:
1. Besuchen Sie APIYI unter apiyi.com, registrieren Sie ein Konto und holen Sie sich den API-Schlüssel.
2. Konfigurieren Sie `base_url` und Key gemäß der APIYI-Dokumentation unter docs.apiyi.com.
3. Ändern Sie einfach den Parameter `model`, um zwischen Modellen verschiedener Anbieter zu wechseln – am Geschäftscode ändert sich nichts.
Alle in diesem Artikel erwähnten Reasoning-Modelle, Allround-Modelle, Leichtgewicht-Modelle und multimodalen Modelle lassen sich über die einheitliche Schnittstelle von APIYI aufrufen und vergleichen.
Q6: Wie schätze ich die monatlichen Kosten eines Multi-Modell-Setups?
Ermitteln Sie zunächst aus den Aufrufprotokollen die durchschnittliche Anzahl Aufrufe pro Tag und die durchschnittliche Token-Zahl je Ebene. Rechnen Sie dann mit den Ein-, Ausgabe- und Cache-Preisen der jeweiligen Modelle auf der Preisseite von APIYI unter docs.apiyi.com/models. Verlassen Sie sich nicht auf Preise aus alten Artikeln oder aus dem Gedächtnis – maßgeblich sind die tatsächlichen Daten auf der Preisseite. Prüfen Sie das einmal im Monat.
Q7: Welche bekannten Einschränkungen hat ein Multi-Modell-Setup?
Auf dieselbe Eingabeaufforderung reagieren verschiedene Modelle unterschiedlich. Nach dem Wechsel auf ein Ausweichmodell kann das Ausgabeformat leicht abweichen, die nachgelagerte Verarbeitung muss also fehlertolerant sein. Manche herstellerspezifischen Features lassen sich im kompatiblen Format womöglich nicht vollständig nutzen. Außerdem gilt: je mehr Modelle, desto größer der Evaluierungsaufwand – halten Sie die Kandidaten pro Ebene bei zwei bis drei.
Die wichtigsten Erkenntnisse zur Multi-Modell-Anbindung eines AI Agents im Solo-Projekt
- Erst schichten, dann auswählen: Nach Aufgabenkomplexität und -häufigkeit in L1 bis L4 einteilen, nicht nach Modellnamen.
- Schnittstellen vereinheitlichen: Die Anwendungsseite hängt nur von einem Protokoll ab; der Modellname ist eine austauschbare Konfigurationsoption.
- Planung und Ausführung trennen: Die Planung des Agenten übernimmt ein leistungsstarkes Modell, die Ausführung ein Hauptmodell oder ein leichtgewichtiges Modell.
- Fallback-Szenarien müssen geprobt werden: Primär- und Ersatzmodelle stammen von unterschiedlichen Anbietern; vor dem Go-live einen Ausfall manuell simulieren und verifizieren.
- Preise laut Preisseite: Alle Einzelpreise und die Cache-Abrechnung gegen docs.apiyi.com/models prüfen.
- Logs sind die Entscheidungsgrundlage: Modell, Token, Laufzeit und Fallback-Situationen protokollieren; einen Modellwechsel anhand von Daten entscheiden.
- Für den Einstieg eignet sich eine Aggregationsplattform: APIYI ist mit dem OpenAI- und Anthropic-Format kompatibel; mit einem einzigen API-Schlüssel lassen sich mehrere Modelle testen.
Zusammenfassung
Beim Aufbau von AI Agents und Workflows in einem Solo-Projekt lassen sich die Überlegungen zur Multi-Modell-Anbindung auf drei Punkte reduzieren:
- Aufgabenebenen: Jeder Schritt nutzt ein gerade ausreichendes Modell, sodass Kosten und Qualität gleichzeitig kontrollierbar bleiben.
- Einheitliche Schnittstelle plus Konfiguration: Modelle werden zu austauschbaren Parametern; der Wartungsaufwand bleibt in einem Bereich, den eine Person bewältigen kann.
- Fallback und Beobachtbarkeit: Die Verfügbarkeit hat eine Absicherung, Entscheidungen haben eine Datengrundlage – nur so kann das Projekt langfristig stabil weiterentwickelt werden.
Empfehlung: Zuerst alle Knoten über eine einheitliche Schnittstelle zum Laufen bringen und dann die Modellauswahl anhand der Logdaten Ebene für Ebene optimieren. Wer die Integrationsschicht nicht selbst betreiben möchte, kann über APIYI apiyi.com die gängigen Modelle einheitlich aufrufen; die Schnittstelle ist mit dem OpenAI- und Anthropic-Format kompatibel. Hinweise zur Anbindung finden sich in der APIYI-Dokumentation unter docs.apiyi.com. Modellpreise und Abrechnungslogik orientieren sich an der Preisseite docs.apiyi.com/models.
📚 Referenzen
- APIYI-Dokumentationszentrum: Informationen zu Endpunktadresse, Authentifizierung und API-Format
- Link:
docs.apiyi.com -
Hinweis: Zum Nachschlagen beim Einrichten von
base_urlund API-Schlüssel sowie beim Wechsel zwischen OpenAI- und Anthropic-Format. -
APIYI – Modell- und Preisseite: Modellliste, Preise für Ein- und Ausgabe sowie Cache-Abrechnung
- Link:
docs.apiyi.com/models -
Hinweis: Für alle kostenbezogenen Angaben in diesem Artikel sind die tatsächlichen Daten auf dieser Seite maßgeblich.
-
OpenAI-API-Dokumentation: Referenz zum Format der Chat-Completions-API
- Link:
platform.openai.com/docs -
Hinweis: Zum Verständnis der Parameter und der Tool-Call-Struktur im OpenAI-kompatiblen Format.
-
Offizielle Anthropic-Dokumentation: Messages-API und Prompt-Caching
- Link:
docs.anthropic.com - Hinweis: Zur Referenz, wenn Sie im Claude-Knoten das Anthropic-Format verwenden.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website. Weitere Materialien zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.