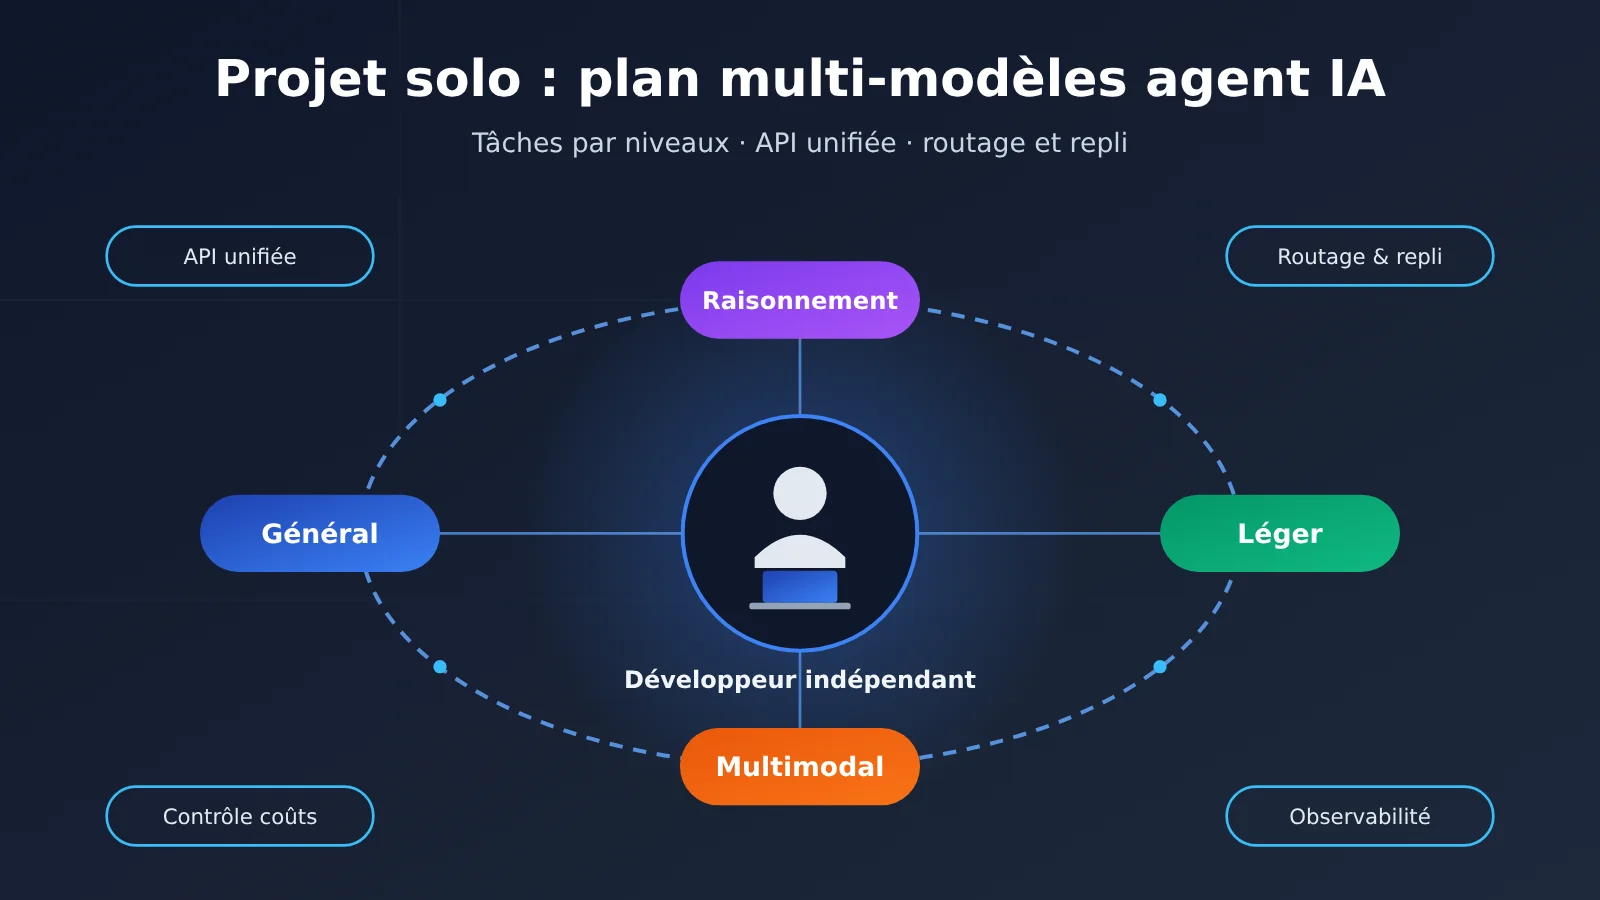
Note de l’auteur : destiné aux développeurs indépendants, cet article présente, en 5 étapes — stratification des tâches, interface unifiée, routage avec dégradation, maîtrise des coûts, observation et évaluation — un plan d’accès multi-modèles pour un Agent IA et des Workflows dans un projet solo.
Quand on développe seul un produit IA, le plus gros blocage n’est souvent pas la conception de l’invite (prompt), mais l’accès à plusieurs modèles. Dès qu’on planifie un Agent et des Workflows, plusieurs questions surgissent vite : quel modèle choisir, faut-il passer par plusieurs fournisseurs en même temps, comment gérer les clés, comment maîtriser la facture, que faire quand un service devient instable. Cet article propose une méthode de planification d’accès multi-modèles « stratification des tâches + interface unifiée + routage avec dégradation », pour vous aider, dans un projet solo, à rendre cela à la fois simple à maintenir et extensible.
Il ne s’agit pas d’une version réduite de l’architecture d’une grande entreprise. Dans une équipe, des personnes dédiées s’occupent de la passerelle, de la supervision et du rapprochement financier ; un projet solo n’a pas ces moyens. Les conseils ci-dessous tournent tous autour d’un principe : un minimum de coûts de maintenance pour un maximum de flexibilité.
L’essentiel : après avoir lu cet article, vous saurez comment attribuer des niveaux de modèles à votre Agent IA et à vos Workflows, unifier leur mode d’accès, concevoir une chaîne de dégradation, et voir clairement combien chaque appel vous a coûté.
Les points essentiels de l’intégration multi-modèles d’un AI Agent pour un projet en solo
Avant d’écrire la moindre ligne de code, prenez le temps de clarifier les 5 points ci-dessous. Ce sont eux qui détermineront si, dans trois mois, vous itérez sur votre produit ou si vous êtes encore en train de réparer la couche d’intégration.
| Point clé | Description | Valeur pour un projet en solo |
|---|---|---|
| Découpage des tâches | Répartir les appels de l’Agent et des Workflows en 3 à 4 niveaux selon leur difficulté et leur fréquence | Les modèles coûteux ne servent que sur les étapes critiques, ce qui garde les coûts globaux sous contrôle |
| Interface unifiée | Tous les modèles passent par un même format de requête, par exemple le format compatible OpenAI | Changer de modèle ne demande qu’un paramètre à modifier, sans réécrire le code métier |
| Routage et repli | Prévoir un modèle principal et un modèle de secours pour chaque niveau | En cas d’anomalie d’un service, le produit ne devient pas totalement indisponible |
| Base de coûts | Distinguer les postes de facturation comme l’entrée, la sortie ou le cache, en se basant sur la page tarifaire de la plateforme | Éviter une facture incontrôlable en fin de mois |
| Observabilité et évaluation | Consigner pour chaque appel le modèle, la latence, les tokens et la qualité du résultat | Décider avec des données s’il faut changer de modèle, plutôt qu’au ressenti |
Les points clés de la planification de l’intégration multi-modèles en détail
Le découpage des tâches est le point de départ de toute la planification. Un AI Agent typique accomplit des choses très différentes : comprendre l’intention de l’utilisateur, planifier des étapes, appeler des outils, résumer un résultat, formater une sortie. Ces étapes n’ont pas du tout les mêmes exigences en matière de capacité du modèle. Pour la classification d’intention ou l’extraction de champs, un modèle léger suffit généralement ; la planification en plusieurs étapes, la génération de code complexe ou le raisonnement sur de longs documents nécessitent en revanche des modèles haut de gamme. Si tout le flux utilise le modèle le plus puissant, les coûts et la latence augmentent de façon disproportionnée ; à l’inverse, si tout repose sur des modèles légers, les étapes critiques deviennent vite fragiles. Découper d’abord, choisir ensuite : c’est l’approche la plus rentable pour un projet en solo.
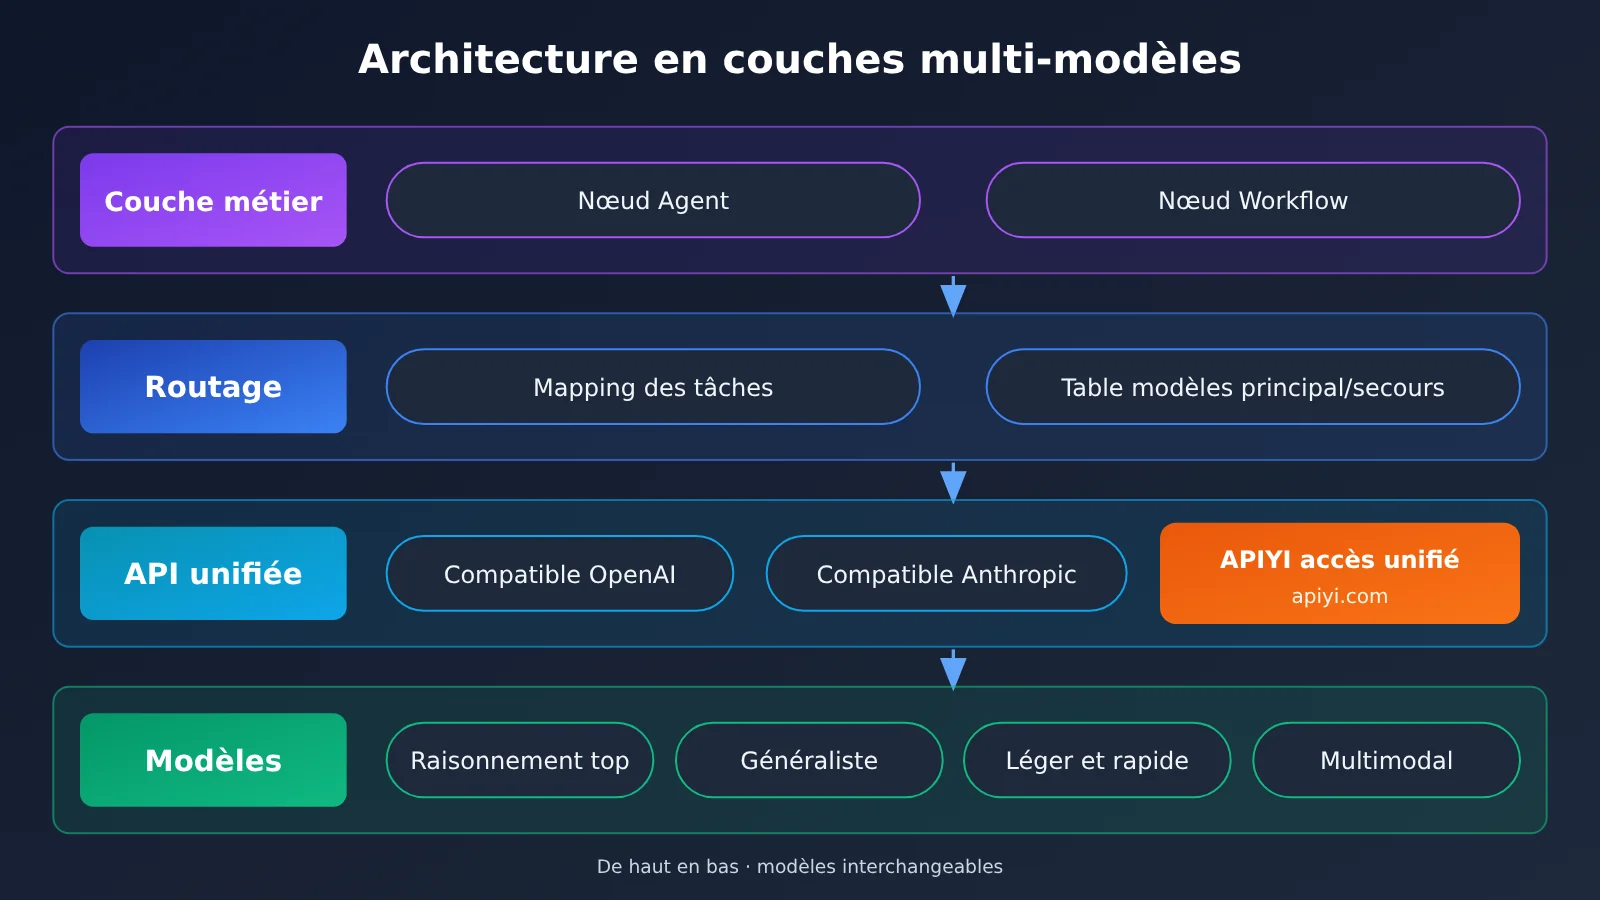
L’interface unifiée détermine votre coût de maintenance. Les SDK officiels de chaque modèle n’utilisent pas exactement les mêmes noms de paramètres, le même format de retour en streaming ni la même structure d’appel d’outils. Se connecter directement à trois ou quatre API officielles en même temps, c’est devoir maintenir trois ou quatre bases de code d’adaptation, autant de comptes et de factures. Pour une seule personne, cette énergie devrait plutôt aller au produit. L’approche plus réaliste consiste à choisir une couche d’agrégation compatible avec les formats OpenAI et Anthropic : côté métier, on ne connaît qu’un seul protocole, et le modèle devient un simple élément de configuration remplaçable.
Projet solo et AI Agent : comment choisir les modèles par couches selon les tâches
L’essentiel du découpage par couches, c’est de le faire selon les caractéristiques des tâches, pas selon le nom des modèles. Voici une répartition en quatre couches qui convient à la plupart des AI Agents et des Workflows. Vous pouvez la prendre comme point de départ, puis l’ajuster à votre activité.
| Couche | Tâches typiques | Compétences requises du modèle | Piste de sélection |
|---|---|---|---|
| L1 Couche de raisonnement | Planification multi-étapes, code complexe, analyse de longs documents | Raisonnement approfondi, fort suivi des instructions, longue fenêtre de contexte | Modèles phares ou de type raisonnement de chaque fournisseur, faible fréquence d’appel |
| L2 Couche principale | Conversation courante, génération de contenu, appel d’outils | Capacités globales équilibrées, appel d’outils stable | Modèles généralistes courants, qui absorbent la majorité du trafic |
| L3 Couche légère | Classification d’intentions, extraction de champs, résumé, réécriture | Rapide, bon marché, format stable | Modèles légers ou de niveau mini, appels à haute fréquence |
| L4 Couche spécialisée | Compréhension d’images, génération d’images, voix, vectorisation | Capacités spécifiques à une modalité | Sélection séparée par fonction, découplée de la chaîne texte |
Trois principes pour appliquer les couches dans le Workflow d’un projet solo
Dessiner le tableau des couches n’est pas difficile ; le plus dur, c’est de vraiment l’appliquer dans le Workflow. Les trois principes ci-dessous vous éviteront quelques détours :
- Placer par défaut vers le bas, puis remonter après vérification. Quand vous ajoutez un nœud, commencez par le tester avec un modèle léger de la couche L3, et ne passez en L2 ou L1 que si le résultat n’est pas à la hauteur. Cela évite de prendre systématiquement le modèle le plus cher par habitude.
- Séparer la planification de l’exécution. Le « bien réfléchir à ce qu’il faut faire » de l’Agent revient à L1, le « passer à l’action concrète » revient à L2 ou L3. Beaucoup de frameworks d’Agent permettent de configurer des modèles différents pour le planificateur et l’exécuteur : c’est l’optimisation la plus rentable.
- Pour la sortie structurée, privilégier les modèles au format stable. En aval du Workflow, il faut souvent parser du JSON ; si le modèle ajoute occasionnellement du texte superflu, toute la chaîne échoue. Pour ce type de nœud, la sélection doit se baser sur la stabilité du format, pas seulement sur « l’intelligence ».
Un rappel : les versions de modèles évoluent vite, c’est pourquoi le tableau ci-dessus ne fige volontairement aucun nom précis. L’approche la plus sûre consiste à choisir 2 ou 3 candidats par couche dans la liste de modèles de la plateforme d’accès, puis à les tester avec vos propres échantillons réels avant de trancher. La liste de modèles d’APIYI couvre les modèles texte, de raisonnement et multimodaux des principaux fournisseurs ; la comparaison côte à côte se fait au sein d’un même compte, ce qui convient bien aux tests de sélection d’un projet solo.
Projet solo : prise en main rapide de l’accès multi-modèles dans un workflow
Cette section présente les étapes concrètes, dans l’ordre. Pour faciliter la lecture, tous les paramètres de configuration sont décrits sous forme de tableaux et d’explications textuelles, sans détailler le code.
Première étape : choisir un protocole d’accès unifié
Je vous conseille d’adopter côté métier un format Chat Completions compatible avec OpenAI. Les principaux frameworks d’agents, les outils d’orchestration de workflows et la plupart des projets open source prennent en charge ce format par défaut : c’est le choix le plus compatible avec l’écosystème. Si vous exploitez intensivement les spécificités de la série Claude, comme la structure native d’appel d’outils ou la mise en cache des invites, vous pouvez aussi utiliser le format Anthropic Messages sur les nœuds concernés. APIYI est compatible à la fois avec les formats d’interface OpenAI et Anthropic ; les deux protocoles peuvent partager un même compte et une même clé.
Deuxième étape : transformer les paramètres du modèle en configuration
Ne codez pas en dur le nom du modèle dans la logique métier. Tous les paramètres liés au modèle doivent être extraits dans un fichier de configuration ou des variables d’environnement. Le tableau ci-dessous liste les paramètres qu’il est conseillé d’isoler :
| Paramètre | Rôle | Recommandation |
|---|---|---|
base_url |
Adresse de l’interface | Indiquez l’adresse d’accès fournie dans la documentation APIYI, docs.apiyi.com, à un seul endroit dans tout le projet |
api_key |
Clé d’authentification | Placez-la dans une variable d’environnement ; utilisez des clés différentes en développement et en production |
model |
Nom du modèle | Nommez par niveau, par exemple MODEL_L1, MODEL_L2, MODEL_L3 |
fallback_model |
Modèle de secours | Prévoyez-en au moins un par niveau, si possible chez un fournisseur différent |
timeout |
Délai d’expiration | Court pour L3, long pour L1, afin d’éviter de considérer à tort un modèle de raisonnement comme expiré |
max_tokens |
Limite de sortie | Réglez-la par nœud pour éviter qu’une sortie anormalement longue ne fasse grimper les coûts |
Ainsi, changer de modèle ne demande que de modifier la configuration : la logique de l’agent et l’orchestration du workflow restent intactes.
Troisième étape : étiqueter les niveaux sur les nœuds du workflow
Ouvrez votre schéma d’orchestration de workflow et étiquetez de L1 à L4 chaque nœud qui appelle un modèle. Que vous utilisiez un outil d’orchestration visuel ou votre propre code de flux, vous pouvez indiquer le niveau dans la description ou les paramètres du nœud, puis lire le modèle correspondant depuis la configuration. Cette étape est rapide, mais elle vous permet de voir d’un coup d’œil sur quels nœuds les coûts se concentrent.
Quatrième étape : configurer le repli et les nouvelles tentatives
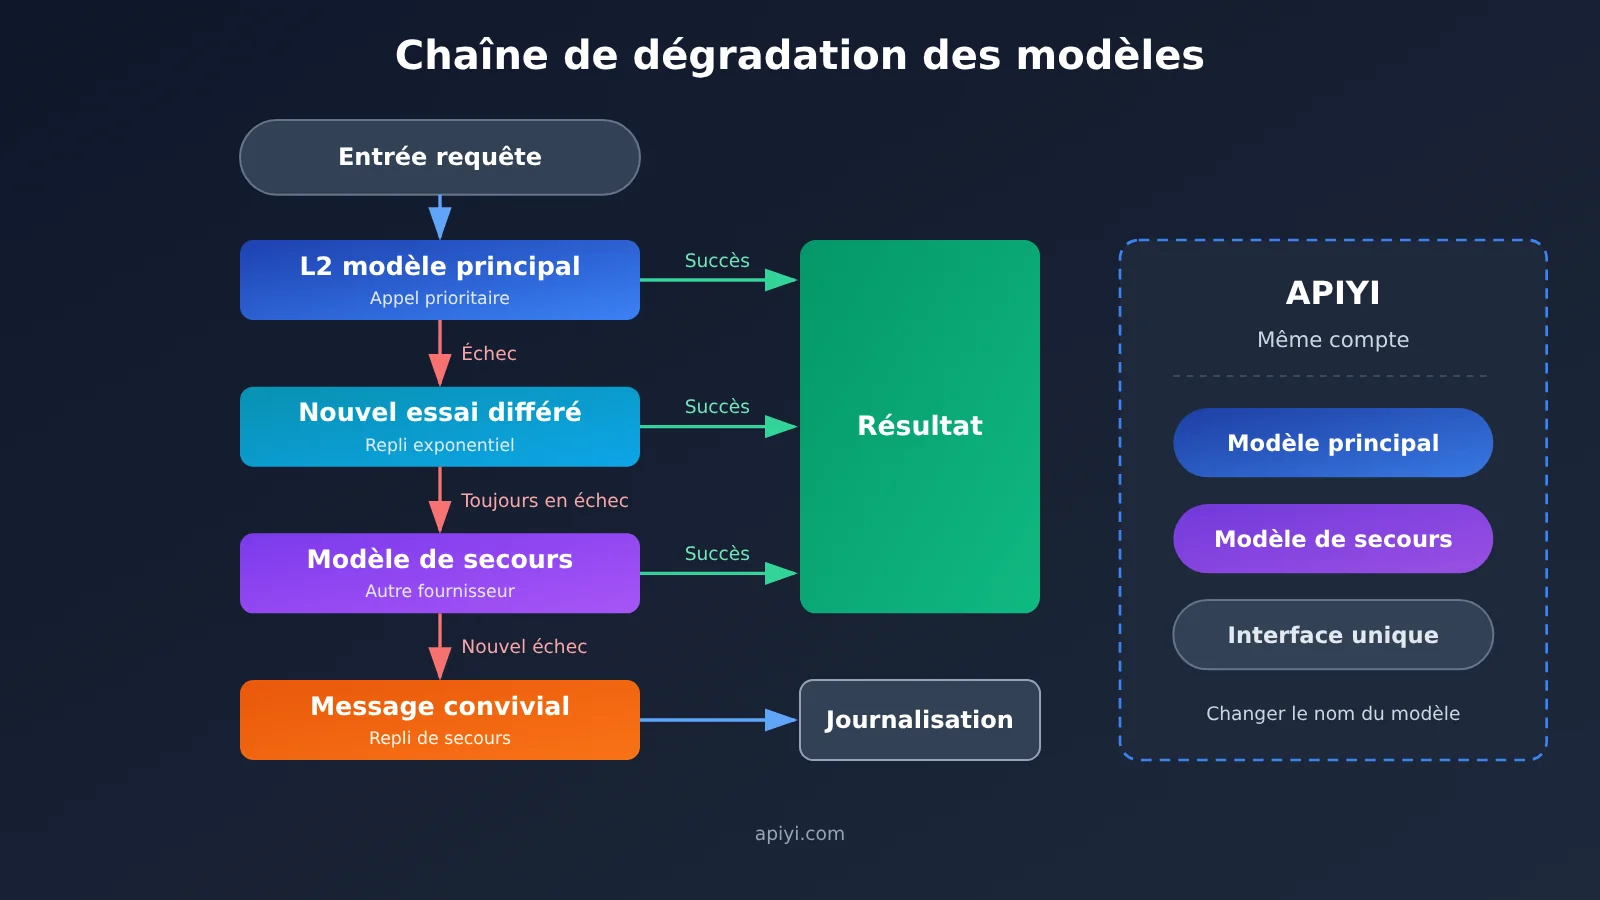
Pour chaque niveau, configurez l’ordre « modèle principal → modèle de secours ». Si le modèle principal renvoie une erreur de limitation de débit, un délai d’expiration ou une erreur côté serveur, effectuez d’abord une ou deux nouvelles tentatives avec temporisation, puis basculez vers le modèle de secours si l’échec persiste. Choisissez si possible le modèle de secours parmi des produits équivalents d’un autre fournisseur, afin d’éviter une panne concentrée sur un même service.
Cinquième étape : journaliser chaque appel
Enregistrez au minimum : l’horodatage, le nom du nœud, le niveau, le nom du modèle, les tokens d’entrée, les tokens de sortie, la durée, le déclenchement éventuel d’un repli et le succès final. Un simple tableau de logs ou un outil d’observabilité léger suffit ; l’essentiel est de journaliser systématiquement.
🚀 Conseil pour démarrer rapidement : pour un projet solo, je vous conseille de commencer par créer un compte sur APIYI apiyi.com et d’obtenir des crédits de test. Avec la même clé, testez chaque modèle candidat de L1 à L3 sur de vrais échantillons. Une fois le choix arrêté, reportez-le dans la configuration : c’est beaucoup moins pénible que d’intégrer d’abord puis de retoucher le code sans arrêt.
Comparatif des solutions d’intégration multi-modèles pour un projet AI Agent en solo
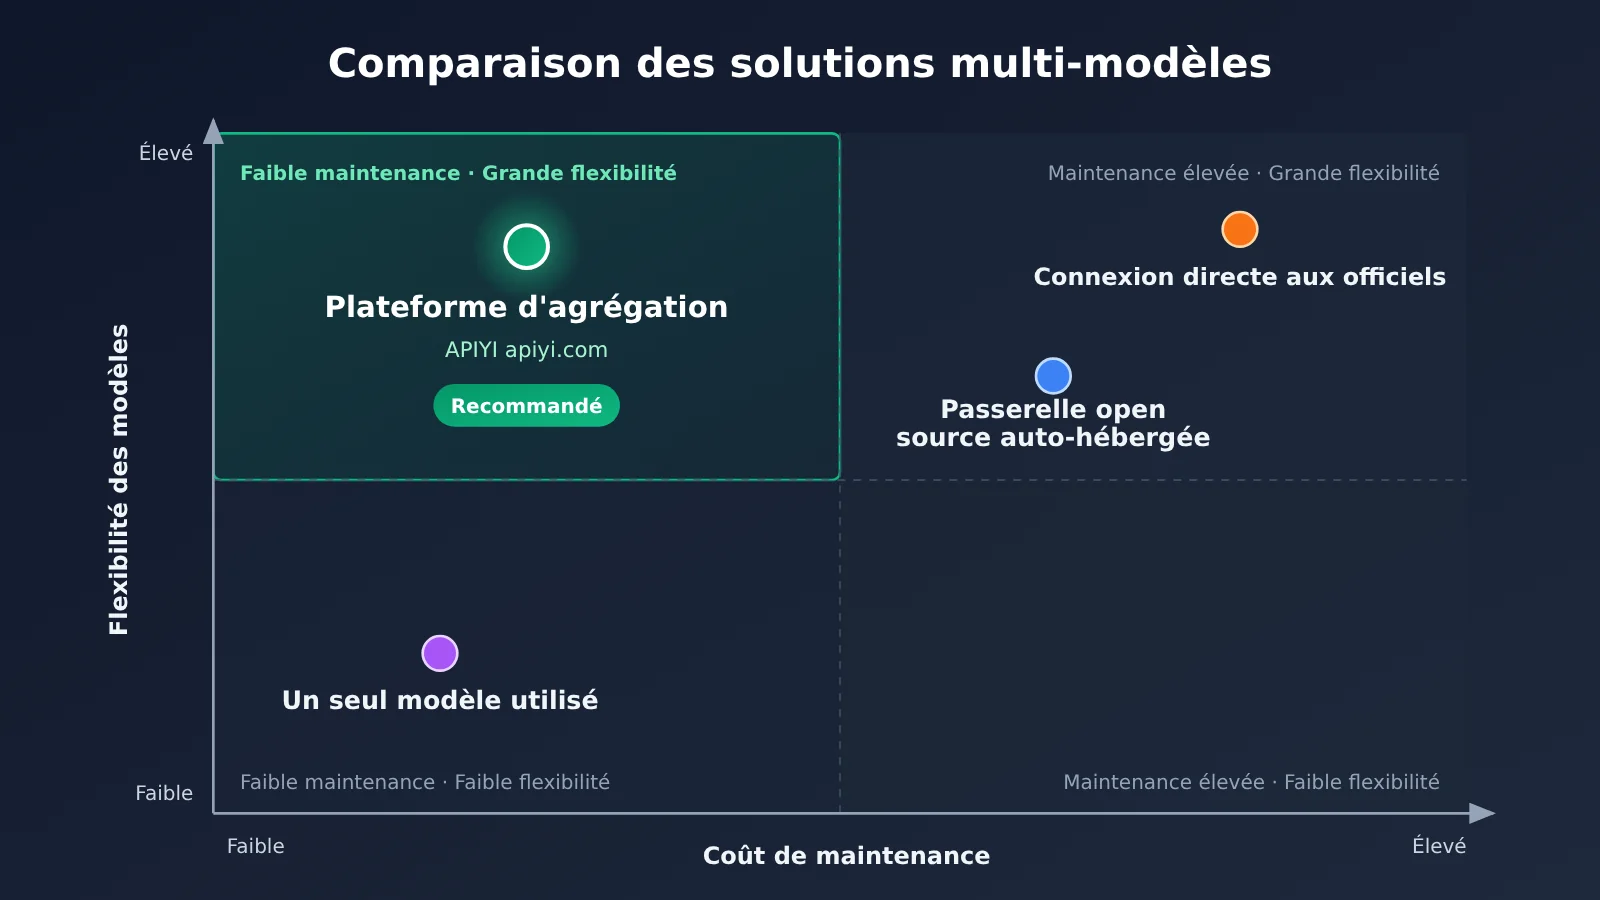
Pour brancher plusieurs modèles, on distingue globalement quatre approches, avec des coûts de maintenance très différents.
| Solution | Caractéristique principale | Cas d’usage | Charge de maintenance pour un projet solo |
|---|---|---|---|
| Un seul modèle | Un fournisseur, un modèle, au plus simple | Prototypage, petit outil à fonction unique | Faible, mais aucune solution de repli |
| Connexion directe à plusieurs fournisseurs | Intégration séparée des API officielles de chaque éditeur | Forte dépendance à une fonctionnalité propre à un fournisseur | Élevée : plusieurs SDK, comptes et facturations à gérer |
| Passerelle open source auto-hébergée | Déploiement de sa propre couche proxy unifiée | Besoin d’auto-hébergement, avec de l’expérience en ops | Moyenne à élevée : déploiement, mises à jour et dépannage à sa charge |
| Plateforme d’accès agrégée | Une seule interface pour plusieurs modèles | Besoin de plusieurs modèles sans maintenir la couche d’accès | Faible : des plateformes comme APIYI apiyi.com fournissent une interface unifiée |
Analyse comparative des solutions d’intégration multi-modèles
Comparatif de la solution mono-modèle : démarrer avec un seul modèle est ce qu’il y a de plus efficace au début, sans aucun routage à concevoir. En revanche, vous misez toute la disponibilité et tout le coût sur un seul fournisseur : en cas de limitation de débit ou de changement de tarif, vous n’avez presque aucune marge de manœuvre. À l’inverse, prévoir dès le départ une interface unifiée et des paramètres de modèle configurables n’ajoute quasiment pas de travail de développement, tout en laissant de la place pour la suite.
Comparatif de la connexion directe aux fournisseurs : passer par les API officielles permet de suivre les nouveautés très vite, et d’utiliser immédiatement une capacité fraîchement publiée. Mais maintenir plusieurs bases de code d’adaptation, plusieurs comptes de recharge et plusieurs rapprochements de factures consomme en continu l’énergie d’une seule personne. Pour la plupart des projets solo, il est plus réaliste de se connecter en direct uniquement aux quelques points où vous dépendez réellement d’une fonctionnalité officielle exclusive, et de faire passer le reste par une interface unifiée.
Comparatif de la passerelle auto-hébergée : une passerelle open source que vous hébergez vous-même offre le plus grand contrôle et convient aux besoins d’auto-hébergement. Mais le déploiement, les mises à jour, la supervision et le diagnostic des pannes sont à votre charge : c’est un service de plus à maintenir. Si votre objectif principal est de livrer le produit rapidement, une plateforme d’accès agrégée constitue généralement un point de départ plus sûr ; vous verrez ensuite, une fois le volume d’activité installé, s’il faut envisager l’auto-hébergement.
💡 Conseil de choix : si vous hésitez encore, commencez par faire tourner tous les nœuds avec APIYI, tout en veillant à ce que le côté métier ne dépende que du format compatible OpenAI. Ainsi, même en migrant plus tard vers une passerelle auto-hébergée ou vers les API officielles, les modifications resteront limitées à la couche de configuration.
Contrôle des coûts et de la stabilité pour un projet solo multi-modèles
Dans un projet mené en solo, personne ne surveille la facture à votre place : le contrôle des coûts doit être intégré à l’architecture elle-même. Le tableau ci-dessous récapitule les leviers de coût les plus courants :
| Levier de coût | Mise en œuvre | Précisions sur la facturation |
|---|---|---|
| Réduction par paliers | Les nœuds à forte fréquence utilisent le modèle léger L3 | Les prix unitaires diffèrent nettement d’un modèle à l’autre ; référez-vous à la page tarifaire d’APIYI |
| Limiter la longueur de sortie | Définir max_tokens pour chaque nœud |
Pour la plupart des modèles, le prix de sortie dépasse celui de l’entrée ; voir la page tarifaire |
| Exploiter le cache | Placer les invites système fixes et les définitions d’outils en tête de requête | La prise en charge du cache et son mode de facturation varient selon les modèles ; voir la page tarifaire |
| Compresser le contexte | Résumer régulièrement les conversations multi-tours de l’Agent, sans accumuler indéfiniment l’historique | Les tokens d’entrée augmentent linéairement avec le nombre de tours : c’est le principal coût caché |
| Configurer des alertes budgétaires | Compter l’usage de tokens par jour et notifier au-delà du seuil | Recouper avec les journaux d’appels et la facturation de la plateforme |
Concernant les prix, cet article n’a volontairement cité aucun chiffre précis. Le prix unitaire d’entrée, celui de sortie, les tarifs de lecture/écriture du cache et les règles de facturation évoluent au gré des stratégies des fournisseurs : une estimation de mémoire ou à partir de documents anciens est vite fausse. Pour votre planification budgétaire, fiez-vous aux données réelles de la page tarifaire d’APIYI, sur docs.apiyi.com/models, et estimez le coût mensuel selon la logique « nombre d’appels quotidiens par couche × tokens d’entrée moyens × prix unitaire d’entrée + tokens de sortie moyens × prix unitaire de sortie », en réservant une colonne à part pour les cas de cache hit.
Côté stabilité, trois choses méritent d’être faites avant la mise en production :
- Répétition du chemin de repli : remplacez manuellement le nom du modèle principal par une valeur invalide et vérifiez que le Workflow bascule tout seul sur le modèle de secours et va jusqu’au bout.
- Paliers de timeout : les modèles de raisonnement réfléchissent plus longtemps, leur seuil de timeout doit donc être nettement plus élevé que celui d’un modèle léger, sinon vous tomberez dans le cas « plus c’est intelligent, plus ça expire ».
- Conception idempotente : les appels d’outils à effet de bord, comme l’envoi d’e-mails ou l’écriture en base de données, doivent être protégés contre une exécution en double lors d’un retry.
FAQ — Questions fréquentes
Q1 : Qu’est-ce que la planification d’intégration multi-modèles pour un projet solo ?
Il s’agit, dans un contexte de développement indépendant, de décider à l’avance quels types de modèles utiliser à chaque étape d’un Agent IA et d’un Workflow, via quelle interface les connecter, comment basculer en cas d’erreur et comment comptabiliser les coûts. L’objectif : obtenir à la fois un avantage de coût et une garantie de disponibilité, sans alourdir excessivement la maintenance.
Q2 : Quelle est la différence entre Agent IA et Workflow en matière d’intégration de modèles ?
Les étapes d’un Workflow sont orchestrées à l’avance : le modèle de chaque nœud peut être spécifié statiquement, et la répartition par niveaux reste assez intuitive. Un Agent, lui, décide lui-même de l’ordre et du nombre d’appels, ce qui rend le volume difficile à prévoir. Il faut donc d’autant plus séparer les modèles de planification et d’exécution, et fixer un nombre maximal de tours ainsi qu’un budget de Token par tâche.
Q3 : Faut-il vraiment intégrer plusieurs modèles dès le début ?
Pas besoin de connecter plusieurs fournisseurs dès le départ, mais la conception de l’interface doit être unifiée dès le début. Je conseille, dès la première version, de rendre le nom du modèle configurable, d’adopter le format compatible OpenAI et de prévoir un modèle de secours pour les nœuds critiques. Le surcoût de développement est minime, et les extensions futures se passeront bien mieux.
Q4 : Quels scénarios de projet solo se prêtent le mieux à l’intégration multi-modèles ?
– **Outils d’écriture ou de contenu IA** : plan détaillé avec L1, corps du texte avec L2, réécriture des titres avec L3.
– **Agent de service client intelligent** : détection d’intention avec L3, escalade des cas complexes vers L2 ou L1.
– **Workflow de traitement de données** : extraction et classification par lots avec L3, échantillons anormaux revus par L2.
– **Outils d’assistance au code** : planification du code avec L1, complétion et commentaires avec L2 ou L3.
Q5 : Comment appeler rapidement plusieurs modèles via une interface unifiée ?
On peut utiliser APIYI, compatible avec les formats d’interface OpenAI et Anthropic :
1. Rendez-vous sur APIYI apiyi.com pour créer un compte et récupérer une clé API.
2. Configurez `base_url` et la clé selon la documentation APIYI sur docs.apiyi.com.
3. Il suffit de modifier le paramètre `model` pour changer de modèle, sans toucher au code métier.
Les modèles de raisonnement, généralistes, légers et multimodaux évoqués dans cet article peuvent tous être appelés et comparés via l’interface unifiée d’APIYI.
Q6 : Comment estimer le coût mensuel d’une solution multi-modèles ?
Commencez par extraire des journaux d’appels le nombre moyen d’appels quotidiens et le nombre moyen de Tokens par niveau, puis reportez-vous aux prix d’entrée, de sortie et de cache de chaque modèle sur la page tarifaire d’APIYI : docs.apiyi.com/models. Ne vous fiez pas aux prix d’anciens articles ou à votre mémoire : utilisez les données réelles de la page tarifaire et revérifiez chaque mois.
Q7 : Quelles sont les limites connues d’une solution multi-modèles ?
Face à une même invite, les modèles n’ont pas le même style de réponse. Après bascule vers un modèle de secours, de légères différences de format peuvent apparaître : l’analyse en aval doit être tolérante aux erreurs. Certaines fonctionnalités propres à un fournisseur peuvent ne pas être pleinement exploitables au format compatible. Enfin, plus il y a de modèles, plus l’évaluation pèse lourd : je recommande de limiter chaque niveau à deux ou trois modèles candidats.
Points clés : l’intégration multi-modèles d’un AI Agent dans un projet solo (Key Takeaways)
- D’abord la stratification, ensuite le choix du modèle : on classe les tâches de L1 à L4 selon leur difficulté et leur fréquence, pas selon le nom du modèle.
- Une interface unifiée : le métier ne dépend que d’un seul protocole, le nom du modèle n’étant qu’un paramètre de configuration interchangeable.
- Séparer planification et exécution : on confie la planification de l’Agent à un modèle puissant, et l’exécution à un modèle principal ou léger.
- Le repli doit être testé : les modèles principal et de secours viennent de fournisseurs différents ; on simule une panne manuellement avant la mise en production.
- Les prix de la page tarifs font foi : tous les prix unitaires et la facturation du cache sont vérifiés sur docs.apiyi.com/models.
- Les logs sont la base des décisions : on enregistre le modèle, les tokens, la latence et les cas de repli ; ce sont les données qui guident le changement de modèle.
- Une plateforme d’agrégation pour démarrer : APIYI est compatible avec les formats OpenAI et Anthropic, une seule clé suffit pour tester plusieurs modèles.
En résumé
Quand on construit un AI Agent et des Workflows en solo, la planification de l’accès multi-modèles se résume en trois points :
- Stratifier les tâches : chaque étape utilise le modèle juste assez puissant, ce qui garde coûts et résultats sous contrôle.
- Interface unifiée + configuration : le modèle devient un paramètre interchangeable, et la charge de maintenance reste dans les limites d’une seule personne.
- Repli et observabilité : la disponibilité a un filet de sécurité, les décisions s’appuient sur des données, et le projet peut itérer durablement.
Le conseil : commencez par faire tourner tous les nœuds via une interface unifiée, puis affinez progressivement le choix des modèles à partir des données de logs. Si vous ne voulez pas maintenir vous-même la couche d’accès, vous pouvez appeler les principaux modèles de façon unifiée via APIYI apiyi.com, dont l’interface est compatible avec les formats OpenAI et Anthropic. Les instructions d’intégration se trouvent dans la documentation APIYI sur docs.apiyi.com, et les prix des modèles ainsi que les modalités de facturation font foi sur la page tarifs docs.apiyi.com/models.
📚 Ressources
- Centre de documentation APIYI : adresse d’accès, méthode d’authentification et format d’interface
- Lien :
docs.apiyi.com -
Description : à consulter pour configurer
base_url, la clé API, et pour basculer entre le format OpenAI et le format Anthropic -
Page modèles et tarifs APIYI : liste des modèles, prix d’entrée/sortie et facturation du cache
- Lien :
docs.apiyi.com/models -
Description : toutes les données de coût de cet article se basent sur les données réelles de cette page
-
Documentation de l’API OpenAI : référence du format de l’interface Chat Completions
- Lien :
platform.openai.com/docs -
Description : pour comprendre les paramètres du format compatible OpenAI et la structure d’appel des outils
-
Documentation officielle Anthropic : interface Messages et mise en cache des invites
- Lien :
docs.anthropic.com - Description : à consulter lorsqu’on utilise le format Anthropic dans un nœud Claude
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site officiel APIYI ; pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com