著者注:本記事では、タスクの難易度・エラーのコスト・コンテキスト規模という3つの軸から、タスク別に大規模言語モデルを階層ルーティングする方法を解説します。フラッグシップモデルは、本当に必要とするリクエストにこそ割り当てましょう。
多くのチームが大規模言語モデルを導入する際、最初の一歩としてすべてのリクエストを現時点で最強のフラッグシップモデルに送りがちです。プロトタイプ段階ではそれで問題ありませんが、リクエスト量が増えると請求額は急速に膨らみます。しかも、その大半は中小規模モデルでも十分に処理できるものです。本記事では、タスク別に大規模言語モデルを階層ルーティングする実践的な方法を紹介し、どのリクエストが本当にフラッグシップモデルを使う価値があるのかを見極める手助けをします。
これは「安価なモデルでも十分使える」と煽る記事ではありません。フラッグシップモデルは、複雑な推論、長いチェーンでのコード修正、リスクの高い出力において今なお明確な優位性を持っています。階層ルーティングが解決すべきは「適切なリクエストを適切なモデルに届けること」であり、コストをただひたすら下げることではありません。
コアバリュー:本記事を読み終えると、3層のタスク分類基準、ルーティングルールの設定チェックリスト、そしてリリース後にデータを使ってルーティング戦略を調整する方法を身につけられます。
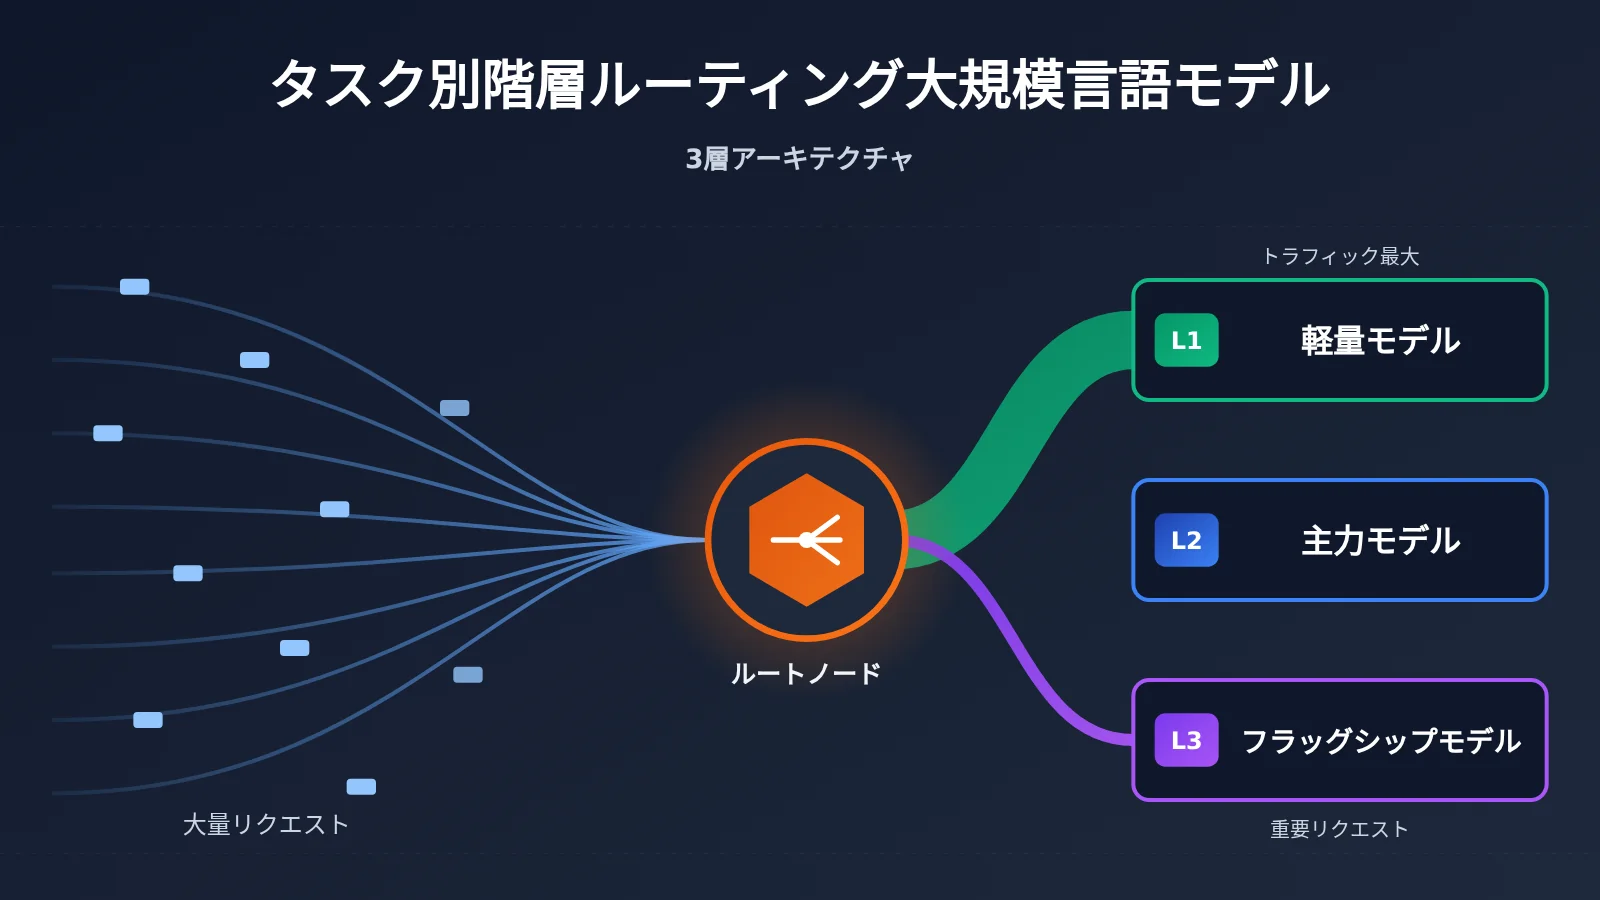
タスク別に大規模言語モデルを階層ルーティングする際の核心ポイント
具体的な設定を議論する前に、階層ルーティングの核心となる判断基準をいくつか挙げておきます。これらは、あるリクエストがどのレイヤーに振り分けられるべきか、またルーティング戦略を継続的に保守できるかどうかを左右します。
| ポイント | 説明 | 価値 |
|---|---|---|
| ユーザー単位ではなくタスク単位でレイヤー分けする | 同じユーザーでもリクエストごとに難易度は大きく異なるため、単一タスクの特徴をルーティングの根拠にします | 「VIPユーザーはすべてフラッグシップモデル」による無駄を避けられる |
| タスク難易度よりもエラーのコストを優先する | 簡単でもエラー時の影響が大きいタスクでは、フラッグシップモデルや二次検証が必要になる場合があります | 本番障害のリスクを抑える |
| デフォルトは中間レイヤーとし、シグナルに応じて昇格・降格する | 主力モデルで大部分のトラフィックを受け止め、特定条件を満たした場合に昇格または降格します | ルールが少なく、保守しやすく、ロールバックしやすい |
| 失敗時は昇格できるようにする | 下位レイヤーの出力が検証を通らない場合、自動的に上位レイヤーへリトライします | 少数のリトライコストで全体品質を確保する |
| データでキャリブレーションする | 各レイヤーの成功率、リトライ率、タスクあたりのコストを記録し、定期的にしきい値を調整します | モデルの進化に合わせてルーティング戦略を継続的に有効に保てる |
階層ルーティングの重点解説:なぜすべてをフラッグシップモデルで処理できないのか
2026年のモデル勢力図は、階層ルーティングの必要性をさらに高めています。参考資料で公開されている情報を例にすると、OpenAI は2026年4月24日に GPT-5.5 を発表し、100万トークン級のコンテキストを提供しました。同じ日に DeepSeek は V4 シリーズを発表し、Pro と Flash の2つの仕様を用意しています。こちらも1Mコンテキストに対応し、Apache 2.0 ライセンスで重みを公開しています。同時期に、Claude Opus シリーズ、Gemini 3.1 Pro、Kimi K2.6 などのモデルも、コーディングや推論タスクで差を着実に縮めています。
トップモデルが一般的なベンチマークで近いスコアを出すようになると、「タスクあたりのコスト」がモデルを選び分ける重要な指標になります。ある第三者の評価記事では、複数のモデルがコーディングベンチマークで非常に近いスコアを出しており、実際に差がつくのは各タスクを完了するためにかかるコストだと述べられています。また別の記事では、Claude Code のようなコーディングエージェントの場面では、トークン消費の大部分を最高峰のモデルで処理する必要はないと分析しています。これらはいずれも第三者の見解であり、具体的な比率は業務によって異なります。ただ、方向性は明確です。フラッグシップモデルをここぞという場面に絞って使うほうが、すべてをそれで処理するよりコスト効率がよいのです。
もう一つ見落とされがちなのがレイテンシーです。フラッグシップモデルは一般により深く考え、出力も長くなるため、分類、抽出、書き換えのような即時性が求められるタスクでは、かえってユーザーの待ち時間が長くなります。参考資料では、GPT-5.5 Instant が ChatGPT のデフォルトモデルになってから、回答の長さが明確に短くなり、ハルシネーション率が低下したと述べられています。これは、「すぐに質問してすぐに答える」用途に向けた軽量版そのものが、ベンダーが認める製品方向であることを示しています。
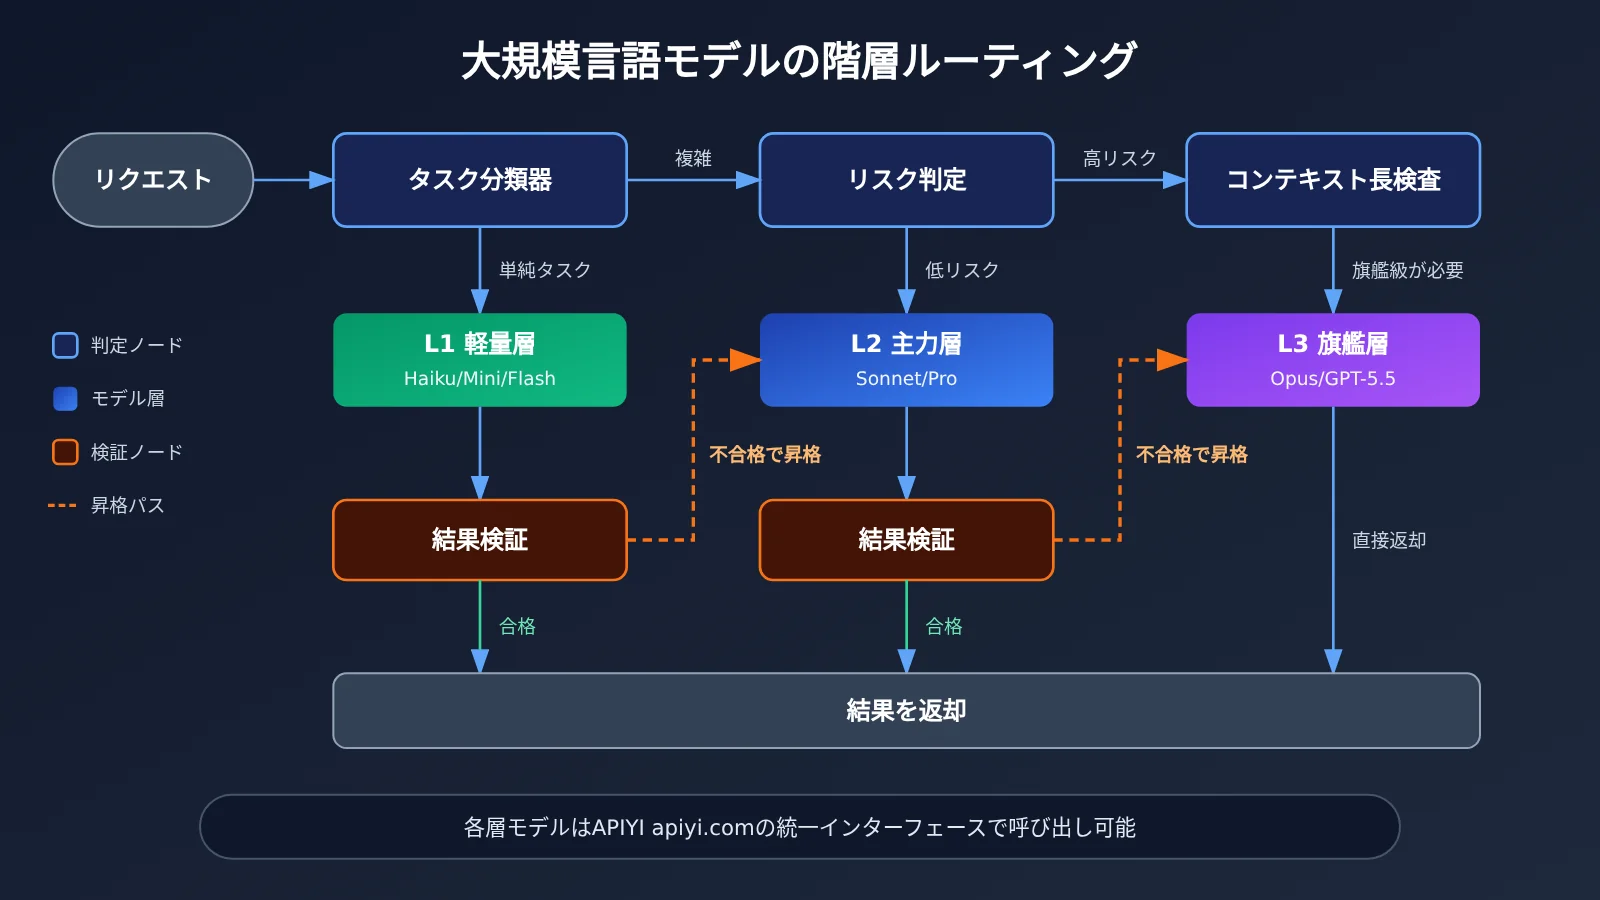
大規模言語モデルの階層ルーティングを3つのタスク階層に分ける方法
階層化のポイントは、タスクの種類ごとに「ちょうど十分」なモデルを見つけることです。以下の表は、複数のプロジェクトでまとめた一般的な分け方で、自社の業務に合わせて項目を追加・削除してかまいません。
| 階層 | 代表的なタスク | 判定の手がかり | 推奨モデルタイプ |
|---|---|---|---|
| L1 軽量層 | 意図分類、キーワード抽出、フォーマット変換、短いテキストの書き換え、簡単な質問応答 | 入力が短い、出力構造が固定、明確な検証ルールがある | Haiku クラス、Mini クラス、Flash クラスのモデル |
| L2 主力層 | 通常の対話、文書要約、中程度の複雑さのコード生成、RAG 質問応答 | 一定の理解力と構成力が必要だが、誤りを発見・修正できる | Sonnet クラス、オープンソースの大パラメータモデル、Pro クラスの汎用モデル |
| L3 フラッグシップ層 | 多段階推論、ファイルをまたぐコードリファクタリング、アーキテクチャ設計、法務や財務などの高リスク出力 | 多段階の依存関係、誤りが潜みやすくコストが高い、超長いコンテキストでの総合分析 | Opus クラス、GPT-5.5 クラスなどのフラッグシップモデル |
L1 軽量層タスクの判断方法
L1 層の重要な特徴は「出力をプログラムで検証できる」ことです。たとえば意図分類は固定ラベルから1つだけ選ぶ、JSON 抽出はスキーマで検証する、フォーマット変換はフィールドの完全性を照合する、といった形です。検証ルールを十分に厳しく書いておけば、軽量モデルが間違えた部分を自動的にせき止め、上位の処理にエスカレーションできます。
参考資料の比較記事では、Claude Haiku 4.5 と GPT-5.4 Mini のような小規模モデルにはそれぞれ得意分野があり、前者はコード品質、後者は速度で優れていると指摘されています。こうしたモデルは高頻度・低複雑度のトラフィックを担うのに適しており、階層ルーティングでコストを抑える主な源になります。
L2 主力層タスクの判断方法
L2 層は「考える必要はあるが、それほど難しくない」リクエストの大部分を担い、デフォルトのルーティング先としても推奨されます。デフォルト値を中間層に設定するには、2つの利点があります。1つは、分類器の誤判定によって多くの複雑なリクエストが軽量層に降格されるのを防げること。もう1つは、昇格・降格のルールをシンプルに保てることです。
オープンソースモデルのこの層での性能は注目に値します。参考資料のサードパーティ評価では、DeepSeek V4 Flash は境界が明確なコーディングタスクにおいて V4 Pro との差が小さく、Kimi K2.6 も主要なコーディングベンチマークで Claude Opus 4.6 との差はわずか数ポイントだとされています。つまり、これまでデフォルトでフラッグシップモデルに任せていたコーディングタスクの多くは、まず主力層で試せるということです。
L3 フラッグシップ層タスクの判断方法
フラッグシップモデルを使う価値が本当にあるリクエストは、通常、次の条件のうち少なくとも2つを同時に満たします。
- 推論チェーンが長い:多段階の計画や中間結論の繰り返し検証が必要です。たとえば、複雑なバグの特定、数学的証明、多数の制約があるスケジューリングなどが該当します。
- エラーが潜みやすく、コストが高い:出力はもっともらしく見えても、細部の誤りに気づきにくいケースです。たとえば、契約条項の分析、財務基準の計算、セキュリティ関連コードなどが挙げられます。
- コンテキストの総合的な難度が高い:数十万 token の資料の中で、単にある断片を検索するのではなく、段落をまたいで情報を関連付ける必要があります。
- 低層で失敗済み:L2 層の出力が検証を通らなかった、またはユーザーから結果が使えないと明確にフィードバックされた場合です。
🎯 技術的なアドバイス:階層ルーティングでは複数のモデルを同時に接続する必要があります。各社と個別に契約し、SDK も個別に適合させると、運用コストがルーティングによるメリットを打ち消してしまいます。APIYI apiyi.com は、本記事で扱う GPT、Claude、Gemini、DeepSeek などのシリーズモデルの API 呼び出しを提供しており、OpenAI と Anthropic の2種類のインターフェース形式に対応しています。モデルを切り替える際は、通常モデル名のパラメータを変更するだけで済みます。
大規模言語モデルの階層ルーティングを素早く始める
ここでは、設定チェックリスト形式で、最小構成で使える階層ルーティングの一案を説明します。本記事ではコードスニペットは掲載せず、主要な設定項目はすべて表で説明します。お使いのフレームワークに合わせて実装してみてください。
ステップ1:接続レイヤーを統一する
階層ルーティングの前提となるのは「モデルを替えてもコードは替えない」という考え方です。すべてのモデルリクエストは共通の呼び出し関数を経由させることをおすすめします。この関数はタスク種別、メッセージ内容、任意の階層上書きパラメータだけを受け取り、内部でルーティングルールに従って実際に呼び出すモデルを決めます。
接続方法について、プロジェクトですでに OpenAI SDK を使っている場合は、chat completions 形式のインターフェースをそのまま利用できます。Anthropic SDK を使っている場合も、messages 形式のインターフェースをそのまま使えます。APIYI はこの2つの形式の両方に対応しています。具体的な接続先 URL、認証方式、モデル名の一覧については、APIYI ドキュメントセンター docs.apiyi.com の説明を参照してください。
ステップ2:ルーティングルールの設定を定義する
次の表は、ルーティングルールでよく使う設定項目をまとめたものです。サービスを再起動せずに調整できるよう、独立した設定ファイルとして書くことをおすすめします。
| 設定項目 | 意味 | 推奨される値の考え方 |
|---|---|---|
task_type |
タスク種別のラベル(例:classify、extract、summarize、code、reason) | ビジネスの入口で直接タグ付けするほうが、モデルによる分類より安定する |
default_tier |
どのルールにも該当しない場合に使う階層 | L2 主力層に設定することを推奨 |
risk_level |
ビジネスリスクのラベル。low、medium、high の3段階 | high は L3 へ直接ルーティングするか、検証ステップを追加する |
context_threshold |
昇格をトリガーする入力 token 数のしきい値 | 各モデルのコンテキストウィンドウと長文での性能を踏まえて設定する |
validator |
出力の検証方法(例:JSON schema、正規表現、ユニットテスト、二次モデルによるレビュー) | L1 層では必須、L2 層では設定を推奨 |
max_escalation |
検証失敗後に昇格できる最大回数 | 通常は 1〜2 回。無限リトライを防ぐ |
tier_model_map |
各階層に対応するモデル名と予備モデル名 | モデル名は APIYI ドキュメントのモデル一覧に準拠 |
ステップ3:昇格と降格のロジックを設定する
ルーティングルールは次の順序で判定することをおすすめします。上にあるほど優先度が高くなります。
- 呼び出し側が階層の上書きパラメータを明示的に指定した場合は、その階層をそのまま使います。デバッグや人手による介入がしやすくなります。
risk_levelが high の場合は、L3 フラッグシップ層にルーティングします。- 入力長が
context_thresholdを超える場合は、少なくとも L2 にルーティングし、タスク種別に応じて L3 へ昇格するかどうかを決めます。 task_typeをキーに表を引き、分類・抽出・フォーマット変換系のタスクは L1 にルーティングします。- 上記のいずれにも該当しない場合は
default_tierを使います。 - 出力が
validatorの検証を通らなかった場合は、1 段階昇格してリトライし、max_escalationの上限に達するまで繰り返します。
ステップ4:各層の主要指標を記録する
ルーティングを本番稼働させた後は、少なくともリクエストごとに、階層、モデル名、入力・出力 token 数、キャッシュヒットの有無、昇格リトライの有無、検証の合否を記録しましょう。これらのデータは、後でしきい値を調整するための唯一の根拠になります。ログのないルーティング戦略は、勘で調整するしかありません。
🚀 クイックスタート:まずテスト環境で、同じ実リクエスト群を L1・L2・L3 の3階層でそれぞれ実行し、通過率と1タスクあたりのコストを比較することをおすすめします。APIYI apiyi.com を使えば、同一のインターフェースで複数モデルを切り替えられるため、こうした比較実験をすばやく行えます。
階層ルーティングにおけるフラッグシップモデルとメインモデルの比較
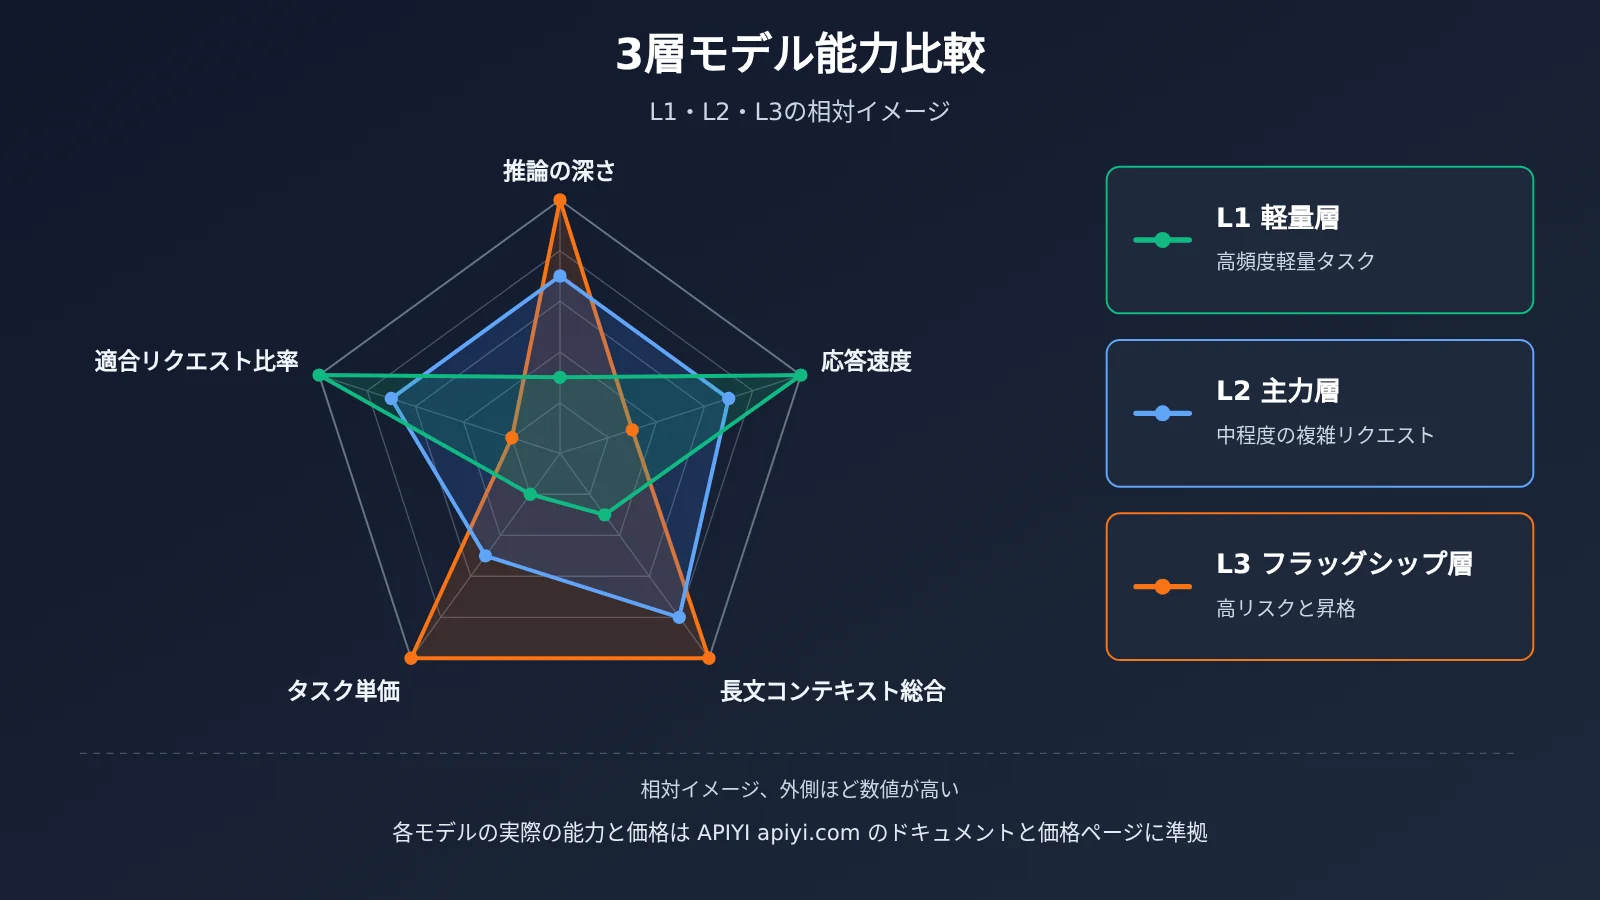
以下の表は、参考資料で挙げられている主要モデルを層ごとに分類したもので、各層の候補モデルを選ぶ際に役立ちます。表の位置づけは公開情報と第三者評価に基づくもので、実際の性能はバージョンアップによって変わるため、自社の業務データで再テストすることをおすすめします。
| モデル | 一般的な位置づけ | 適した層 | 利用可能なプラットフォーム |
|---|---|---|---|
| Claude Opus 4.7 / 4.6 | 複雑なコーディングと多段階推論 | L3 フラッグシップ層 | APIYI apiyi.com、公式 API |
| GPT-5.5 | 汎用フラッグシップ、1M コンテキスト | L3 フラッグシップ層 | APIYI apiyi.com、公式 API |
| Gemini 3.1 Pro | 推論と長文コンテキスト、コストパフォーマンスに優れる | L2 ~ L3 | APIYI apiyi.com、公式 API |
| DeepSeek V4 Pro | オープンソースの大規模パラメータ、1M コンテキスト | L2 メイン層 | APIYI apiyi.com、公式 API |
| Kimi K2.6 | コーディング能力がフラッグシップに迫る | L2 メイン層 | APIYI apiyi.com、公式 API |
| DeepSeek V4 Flash | 低コスト、境界が明確なタスクに適する | L1 ~ L2 | APIYI apiyi.com、公式 API |
| Claude Haiku 4.5 / GPT-5.4 Mini | 高頻度の軽量タスク | L1 軽量層 | APIYI apiyi.com、公式 API |
フラッグシップモデルとメインモデルの比較分析
フラッグシップモデルの比較分析:Claude Opus や GPT-5.5 といったフラッグシップモデルは、多段階推論、複数ファイルにまたがるコード修正、潜在的なエラーの検出でリードを保っています。ただし、単価も応答遅延も明らかに高く、分類やリライトのような単純なタスクに使うのは明らかなリソースの無駄遣いです。そう考えると、フラッグシップモデルは L3 層に置き、高リスクなリクエストと下位層で失敗した後のエスカレーションだけを処理するのが最適です。
オープンソースメインモデルの比較分析:DeepSeek V4 や Kimi K2.6 は通常のコーディングや文書処理で優れた性能を発揮し、第三者の評価ではフラッグシップモデルとの差が多くのタスクですでに小さくなっていることが示されています。ただ、長い推論チェーンが必要なタスクや暗黙の制約が多いタスクでは、依然として差が残ります。中程度の複雑さのリクエストの大半では、メイン層のモデルがより堅実で経済的なデフォルトの選択肢であり続けます。
💡 選択のヒント:各層でどのモデルを選ぶかは、主にタスクの分布と品質要件によって決まります。APIYI apiyi.com で同じサンプル群を使って候補モデルを横断的にテストし、そのうえで各層のメインモデルとバックアップモデルを決めることをおすすめします。
階層型ルーティングのコスト計算方法
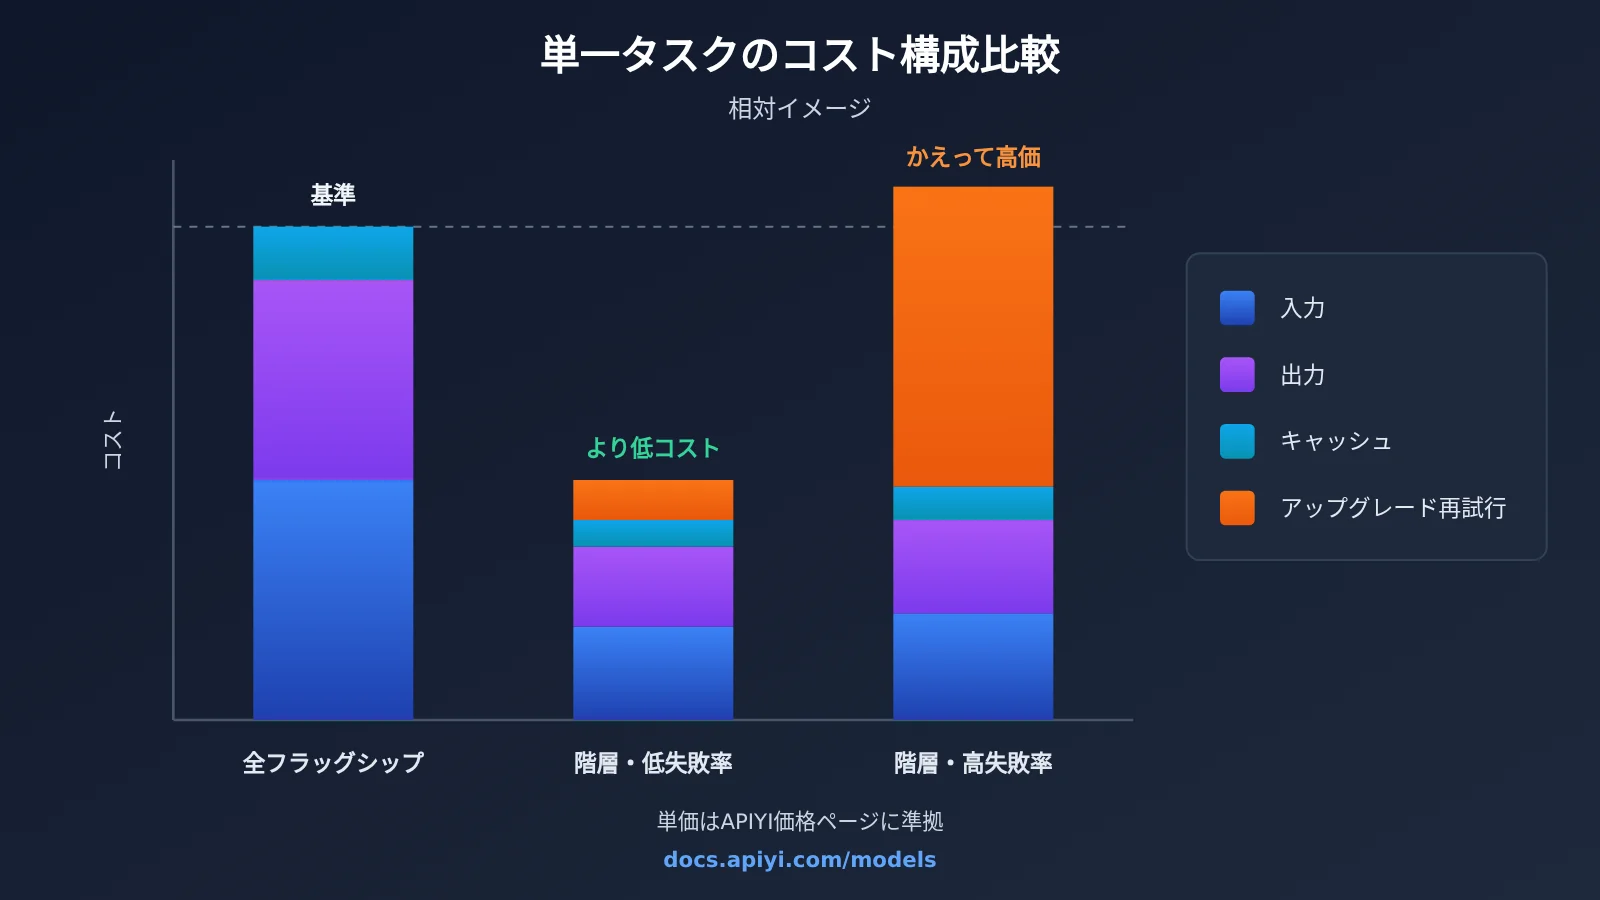
階層型ルーティングがコストを抑えられるかどうかは、単価だけで判断するのではなく、「1タスクあたりの総コスト」で見る必要があります。1つのタスクの総コストは通常、複数の課金項目から構成されており、どれか1つでも計算を誤ると結論が歪んでしまいます。
| 課金項目 | 説明 | 価格の根拠 |
|---|---|---|
| 入力トークン | プロンプト、コンテキスト、履歴メッセージの総量 | APIYIの価格ページ docs.apiyi.com/models の実データに準拠 |
| 出力トークン | モデルが生成した内容。推論型モデルでは思考トークンを含む場合がある | APIYIの価格ページ docs.apiyi.com/models の実データに準拠 |
| キャッシュ読み取り | プロンプトキャッシュにヒットした入力部分 | APIYIの価格ページ docs.apiyi.com/models の実データに準拠 |
| キャッシュ書き込み | 初回にキャッシュへ書き込む入力部分。一部のモデルでは別途課金される | APIYIの価格ページ docs.apiyi.com/models の実データに準拠 |
| 昇格リトライ | 下位層で失敗した後、上位層で再実行することで発生するすべての費用 | 実際の呼び出し階層に応じて累積計算 |
階層型ルーティングの1タスクコストを計算する際のよくある誤解
1つ目の誤解は、キャッシュトークンを二重に計算してしまうことです。参考資料の中には、キャッシュコストを計算する際には読み取り・書き込み・通常入力・出力・リトライを分けて集計すべきだとわざわざ注意している記事もあります。そうしないと、同じトークンの束を2回数えてしまいがちです。2つ目の誤解は、昇格リトライのコストを無視することです。L1層の検証失敗率が高い場合、「まず安いモデルを試す」方が、主力モデルを直接使うよりも高くつくことがあります。
そのため、ある種のタスクを下位層に置くのが適切かどうかを評価するには、シンプルな式を使うことをおすすめします。下位層の1回あたりのコストに「失敗率 × 上位層の1回あたりコスト」を加えた値が、上位層を直接使うコストより明らかに低く、かつ最終的な品質が許容できるなら、その種のタスクは下位層への移行に適していると言えます。各モデルの具体的な単価、キャッシュ価格、課金の基準については、APIYIの価格ページ docs.apiyi.com/models のリアルタイムデータに統一して準拠してください。本記事では具体的な価格の数字は示しません。
💰 コスト最適化:コスト試算を行う際は、APIYIの価格ページから各モデルの入力・出力・キャッシュの単価を直接読み取り、自分のログデータと組み合わせて1タスクあたりのコストを計算することをおすすめします。同じプラットフォーム内であれば課金基準が統一されているため、モデル間の比較でも間違えにくくなります。
よくある質問(FAQ)
Q1:タスク別の階層ルーティング型大規模言語モデルとは何ですか?
各リクエストのタスク種別、リスクレベル、コンテキストの規模に応じて、能力とコストの異なる階層のモデルにリクエストを振り分ける仕組みです。単純なタスクは軽量モデルに、通常のタスクは主力モデルに、そして複雑または高リスクなタスクだけをフラッグシップモデルに割り当てます。
Q2:階層ルーティングと、単純な「安価なモデルへのダウングレード」はどう違うのですか?
単純なダウングレードは多くの場合グローバルな置き換えになり、品質が全体的に低下します。階層ルーティングはタスクごとに扱いを変え、検証と自動アップグレードの仕組みを備えています。下位層で失敗したリクエストは、より強力なモデルに引き継いでやり直すため、コストを抑えながら品質の下限を守ることができます。
Q3:2026 年に新しいモデルが公開されたら、ルーティング戦略を調整し直す必要がありますか?
必要です。2026 年前半には GPT-5.5、DeepSeek V4、Claude Opus の新バージョンなどが相次いで公開され、各階層の能力の境界は急速に変化します。主要なモデルが更新されるたびに、固定のテストセットで各層の通過率を再計測し、そのうえで階層マッピングを調整するかどうかを判断することをおすすめします。
Q4:どのリクエストにフラッグシップモデルを使う価値が最も高いですか?
主に次のような種類があります:
– **ファイルをまたぐコードのリファクタリングと複雑なバグの特定**:大量のコンテキスト間の依存関係を理解する必要があります。
– **高リスク領域の出力**:契約書レビュー、財務基準の照合、セキュリティポリシーの生成など。
– **多制約の推論タスク**:複雑なスケジューリング、案のトレードオフ、数学的導出など。
– **下位層のモデルですでに失敗したリクエスト**:アップグレード時の受け皿として。
Q5:API を使って階層ルーティングのテスト環境を素早く構築するには?
複数モデルに対応した API アグリゲーションプラットフォームの利用をおすすめします:
1. APIYI apiyi.com にアクセスしてアカウントを登録し、APIキーを取得します。
2. APIYI のドキュメントセンター docs.apiyi.com で接続先アドレスと利用可能なモデル名を確認します。
3. 本記事の設定リストに沿って L1、L2、L3 それぞれにモデルを 1 つ選び、同じサンプル群で通過率を比較します。
APIYI は OpenAI と Anthropic のインターフェース形式に対応しているため、既存のプロジェクトは通常、大きな改修なしで接続できます。
Q6:タスク分類そのものをモデルで行うと、コストが増えませんか?
多少の追加コストは発生します。そのため、まずは業務の入口で直接タグ付けすることをおすすめします。たとえば「カスタマーサポート問い合わせ窓口」は既定である種のタスクになります。入口だけでは区別できない場合にのみ、L1 の軽量モデルで分類します。この部分のコストは通常、フラッグシップモデルの誤用による無駄よりもはるかに小さくなります。
Q7:階層ルーティングにはどのような既知の制約がありますか?
主に 3 点あります。1 つ目は、ルールを継続的に保守する必要があり、モデル更新後にしきい値が機能しなくなる可能性があること。2 つ目は、アップグレード時の再試行によって一部のリクエストの遅延が増えるため、リアルタイム性が非常に重要な場面ではトレードオフが必要になること。3 つ目は、モデルごとに出力のスタイルが異なるため、ユーザー向けのプロダクトでは統一の後処理が必要になる場合があることです。こうした問題が現れたときは、デフォルトの階層を上げるか、階層の数を減らすとよいでしょう。
Q8:階層ルーティングの価格はどこを参照すればよいですか?
すべてのモデルの入力・出力・キャッシュの単価、および課金の基準については、APIYI の価格ページ docs.apiyi.com/models の実際のデータを参照してください。第三者の記事に掲載されている価格は、実際に利用しているチャネルと異なる場合があるため、そのまま予算の算出に使うことはおすすめしません。
タスク別階層ルーティング大規模言語モデルの核心ポイント Key Takeaways
- 階層分けの基準はユーザーではなくタスク:同じユーザーのリクエストでも難易度は大きく異なるため、1件ずつ判断すべきです。
- エラーのコストは難易度より重要:シンプルでもリスクの高いタスクには、フラッグシップモデルを使う価値があります。
- デフォルトは主力層が最も安定:中間層でフォールバックし、シグナルに応じて昇格・降格する。ルールがシンプルで保守しやすい構成です。
- 下位層には必ず検証を組み合わせる:プログラムで検証できる出力だけが軽量モデルに任せられます。
- コストはタスク単位の総額で見る:入力・出力・キャッシュ・リトライを分けて計算します。
- モデル更新時は再テストが必要:2026年はモデルの進化が速く、階層マッピングは定期的にキャリブレーションしましょう。
- 統一インターフェースで切り替えコストを削減:APIYI apiyi.com なら、同じインターフェースで複数社のモデルを呼び出せます。
まとめ
タスク別に大規模言語モデルを階層ルーティングする核心ポイントは次のとおりです。
- 3層の区分:L1 は検証可能な軽量タスクを処理し、L2 はデフォルトのトラフィックを担い、L3 は複雑・高リスク・昇格リクエストのみを受け付けます。
- ルールの優先順位:人手による上書き、リスクタグ、コンテキスト長、タスク種別、デフォルト階層の順に判断し、失敗時は自動で昇格します。
- データドリブン:層ごとの通過率、リトライ率、タスク単価を記録し、感覚ではなく実際のデータでしきい値を調整します。
階層ルーティングが目指すのは「すべてを最も安いモデルで処理する」ことではなく、フラッグシップモデルの能力を本当に必要な場面に使うことです。まずは頻度の高いタスクを1〜2個選び、「分類・呼び出し・検証・昇格・記録」という一連の流れを動かしてみて、そこから徐々に対象業務を広げていくのがおすすめです。
階層化の検証は APIYI apiyi.com で手早く始められます。複数モデルを統一インターフェースで扱えるプラットフォームで、導入方法は docs.apiyi.com、料金は docs.apiyi.com/models を参照してください。
📚 参考資料
- Ofox.ai ブログ記事一覧(2026年4〜5月):GPT-5.5、DeepSeek V4、Claude Opus などのモデル公開と比較を網羅
- リンク:
ofox.ai/blog/page/35 -
説明: 混合モデルルーティングやキャッシュコスト計算などの第三者分析を含む。本記事では事実情報のみを引用
-
Ofox.ai ブログ記事一覧(モデル公開と評価):GPT-5.5 Instant、主要モデルのベンチマーク、単一タスクのコスト比較を網羅
- リンク:
ofox.ai/blog/page/36 -
説明: 2026年の主要モデルの公開ポジショニングを理解するのに適している
-
Ofox.ai ブログ記事一覧(小規模モデルとオープンソースモデル):Claude Haiku、GPT-5.4 Mini、Llama 4 などの軽量モデル・オープンソースモデルを網羅
- リンク:
ofox.ai/blog/page/37 -
説明: L1・L2レイヤーの候補モデルを選定する際の参考に適している
-
APIYI ドキュメントセンター:接続先アドレス、インターフェース形式、モデル名の説明
- リンク:
docs.apiyi.com -
説明: OpenAI または Anthropic 互換インターフェースに接続する前にご確認ください
-
APIYI モデル価格ページ:各モデルの入力・出力・キャッシュの課金データ
- リンク:
docs.apiyi.com/models - 説明: 本記事のコスト計算はすべてこのページの実際のデータに基づく
作者: APIYI 技術チーム
技術交流: APIYI apiyi.com サイトのトップページからお気軽にお問い合わせください。その他の接続資料は docs.apiyi.com ドキュメントセンターでご覧いただけます