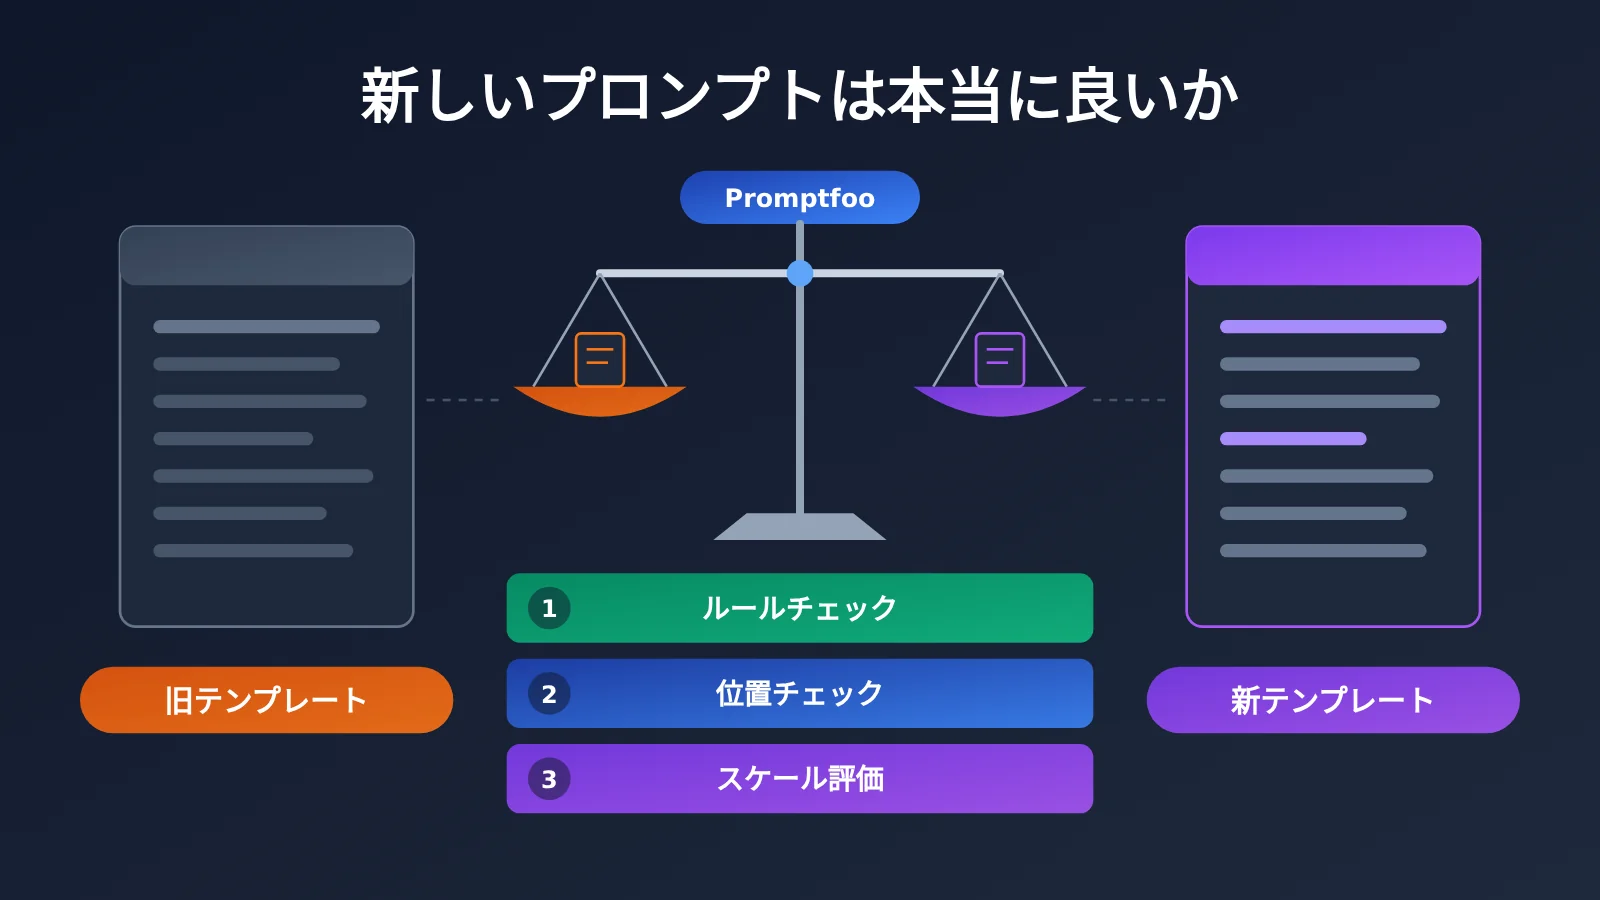
結論から言うと:新しいプロンプトが必ずしも優れているとは限らず、「より良く見える」ことも証拠にはなりません。 新旧の記事テンプレートのどちらが優れているかを判断するには、素材、モデル、生成設定を固定し、テンプレートだけを変更したうえで、Promptfoo のアサーションを使って構造、順序、内容の品質を層ごとにチェックするべきです。さらに、結果は観点ごとに示し、文章の巧さのスコアで事実誤認を相殺してはいけません。本記事は実験計画を提案するものであり、実際の A/B 実験は行っていないため、勝率、スコア、コスト削減額は一切示しません。
この記事を読むと、次のことがわかります:
- Promptfoo の
contains、JavaScript、llm-rubricアサーションがそれぞれ何をチェックでき、何を証明できないか。 - 既存のモデル出力に対してアサーションファイルだけを実行し、評価ルールだけを変更するときに再生成を避ける方法。
- 新旧の記事テンプレートを比較する実験設計。変数の制御、3層のチェック、観点別の提示を含みます。
- モデルジャッジとルールアサーションの限界、および有料の評価モデルがもたらすコスト問題。
この記事の構成: まず概念表で Promptfoo 評価におけるいくつかの重要用語を説明し、次にこのことがコンテンツチーム、開発者、評価責任者に与える影響を述べます。本文の「客観的事実」部分では、ドキュメントに記載されたアサーション機能と検証状況だけを整理します。「分析・判断」部分では、実験設計の提案、設定例、限界についての議論を示し、項目ごとに、どれが提案であり実測結果ではないかを明記します。
Promptfooでプロンプトテンプレートを比較する前に知っておきたい概念
以下の用語は、この後の説明で繰り返し登場します。多くはPromptfooの設定ドキュメントに由来しますが、評価実験で一般的に使われる表現も少し含まれています。
| 概念 | 簡単な説明 |
|---|---|
| Promptfoo | 大規模言語モデルのプロンプトと出力を評価するためのオープンソースツール。設定ファイルでテストケースやアサーションを定義できます |
| アサーション(Assertion) | モデルの出力を自動チェックするルール。出力が特定の条件を満たすかどうかを判定します |
| contains | 指定したテキストが出力に含まれるかを確認する、決定的な文字列マッチングです |
| JavaScriptアサーション | JavaScriptの式や関数を使って、より複雑な判定条件を実装します |
| llm-rubric | モデルが独自のルーブリックに従って出力を採点する、「モデル採点」タイプのアサーションです |
| 採点プロバイダー(Grading Provider) | llm-rubricの採点を実行するモデル。個別に設定できます |
| ルーブリック(Rubric) | 採点モデルに与える評価基準。どのような場合に合格とみなすか、どこで減点するかを示します |
| モデルによる判定(LLM-as-a-Judge) | 人間のレビューに代えて大規模言語モデルで出力品質を評価する手法です |
| 変数制御 | 実験で1つの要因(ここではテンプレート)だけを変え、ほかの要因は一定に保つことです |
新旧プロンプトテンプレート評価の影響をひと目で
この種の評価手法の価値は、ツール自体がどれだけ新しいかではなく、「新しいテンプレートのほうが良いと思う」という主観を、再確認可能なチェック記録に変えられる点にあります。得られるものは役割によって異なります。
| 対象者 | 実質的な影響 |
|---|---|
| コンテンツチームと編集者 | テンプレート改版に再確認可能な検収基準ができ、「構造は正しいが、事実の段落に推測が混入している」といった問題を発見できる |
| プロンプトエンジニアと開発者 | テンプレート要件をルールベースのアサーションと評価尺度ベースのアサーションに分解でき、評価ルールを変更するときに全出力を再生成する必要がない |
| 評価責任者 | 次元ごとに結果を報告し、モデルによる採点、ルールのヒット、人手レビューそれぞれの証明力を明確に区別する必要がある |
| 予算責任者 | ルールベースのアサーションは追加の呼び出しコストがほとんどなく、llm-rubric で有料モデルを使う場合は評価費用が発生する |
Promptfoo のアサーション機能に関する客観的事実
本節では、Promptfoo のドキュメントに記載されている機能だけを述べます。2026-11-17 に関連ドキュメントページを確認しましたが、これらの機能の初回リリース日は未検証のため、本記事では具体的な提供開始時期は示しません。
Promptfoo の contains アサーション:テキストの出現をチェック
contains は最も基本的なアサーションタイプで、モデル出力に指定したテキストが現れるかをチェックします。決定的な文字列マッチングであり、同じ出力であれば実行するたびに同じ結果になります。
強調したいのは、contains が通過するのは「その文字列にヒットした」ということだけを示す点です。その文字列が含まれる段落の出来が良いかどうかも、内容が正しいかどうかも示せません。
Promptfoo の JavaScript アサーション:複雑な条件を実装
「含まれるかどうか」を超える判定条件では、JavaScript アサーションでカスタムロジックを書けます。たとえば、2つの見出しの出現順序を比較する、ある章の個数を数える、あるテキストが特定の章の内部にあるかをチェックする、といったことです。この種のアサーションも決定的で、結果は再現可能です。
独立したアサーションファイルで Promptfoo の既存出力を評価
Promptfoo は、すでに生成済みのモデル出力に対して独立したアサーションファイルを実行できます。すべての出力を再生成する必要はありません。これは評価のイテレーションにとって重要です。評価ルールはしばしば繰り返し調整が必要で、生成そのものは時間も呼び出しコストもかかるためです。
Promptfoo の llm-rubric:モデルによる評価尺度スコアリング
llm-rubric はモデル採点タイプのアサーションです。出力とカスタムの評価尺度を採点モデルに渡し、採点モデルが通過かどうかを判断して理由を提示します。ドキュメントによれば、採点を実行するプロバイダーは個別に設定でき、採点時に使うプロンプトもカスタマイズできます。
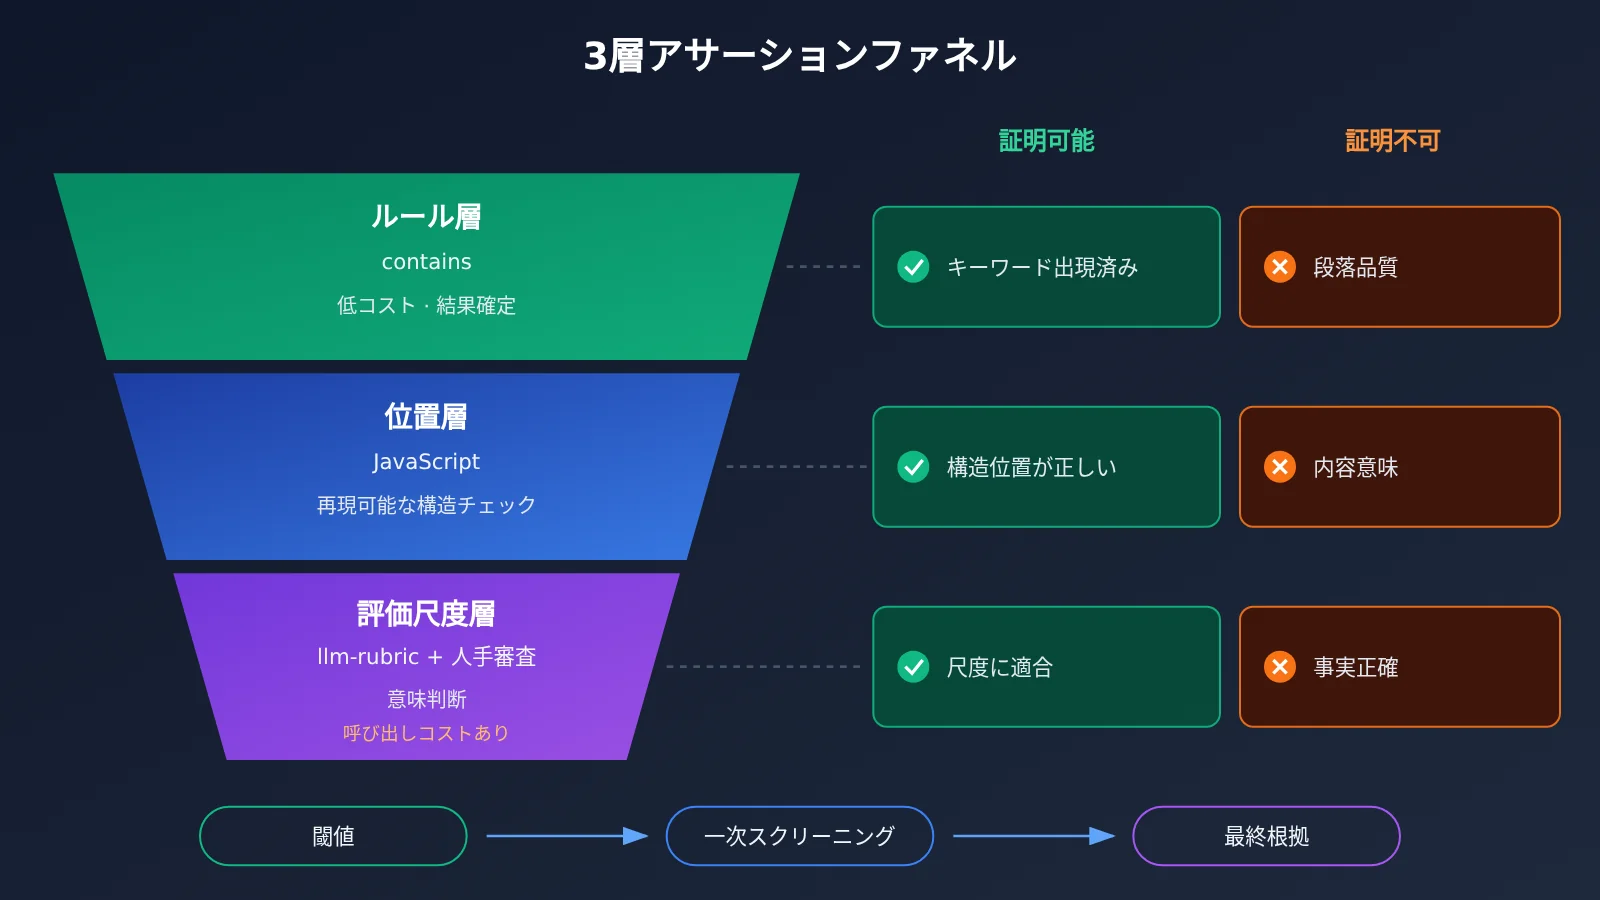
| アサーションタイプ | 判定方法 | 結果は決定的か | 証明できること | 証明できないこと |
|---|---|---|---|---|
| contains | 文字列マッチング | 決定的 | 指定文字が出現した | 段落の品質、内容の正しさ |
| JavaScript | カスタムコードロジック | 決定的 | 構造・順序・カウントなどコード化可能な条件 | 意味論的な良し悪し |
| llm-rubric | モデルによる評価尺度採点 | 採点モデルの影響を受ける | 出力が採点モデルから見て評価尺度に合致する | 事実の正しさ。また人手による確認の代替にもならない |
出典と検証状況
本記事の事実部分は以下の Promptfoo ドキュメントページに基づいており、確認日は 2026-11-17 です。
- Promptfoo のアサーションと指標のドキュメント: promptfoo.dev/docs/configuration/expected-outputs/
- Promptfoo のモデル採点アサーションのドキュメント: promptfoo.dev/docs/configuration/expected-outputs/model-graded/
- Promptfoo の llm-rubric ドキュメント: promptfoo.dev/docs/configuration/expected-outputs/model-graded/llm-rubric/
本記事では実際の新旧テンプレート A/B 実験は行っていません。後述の設定やフローはすべて設計上の提案であり、いかなる実測結果も示すものではありません。
Promptfoo で新旧の記事テンプレートの分析判断を比較する
以下は、上記の事実に基づいて私たちが行った解釈と提案です。「ニュース記事テンプレート」を例に、新しいテンプレートが記事に「客観的事実」と「分析判断」という2つのセクションを求め、事実が前・分析が後で、事実の段落に推測を混ぜてはならないと仮定します。
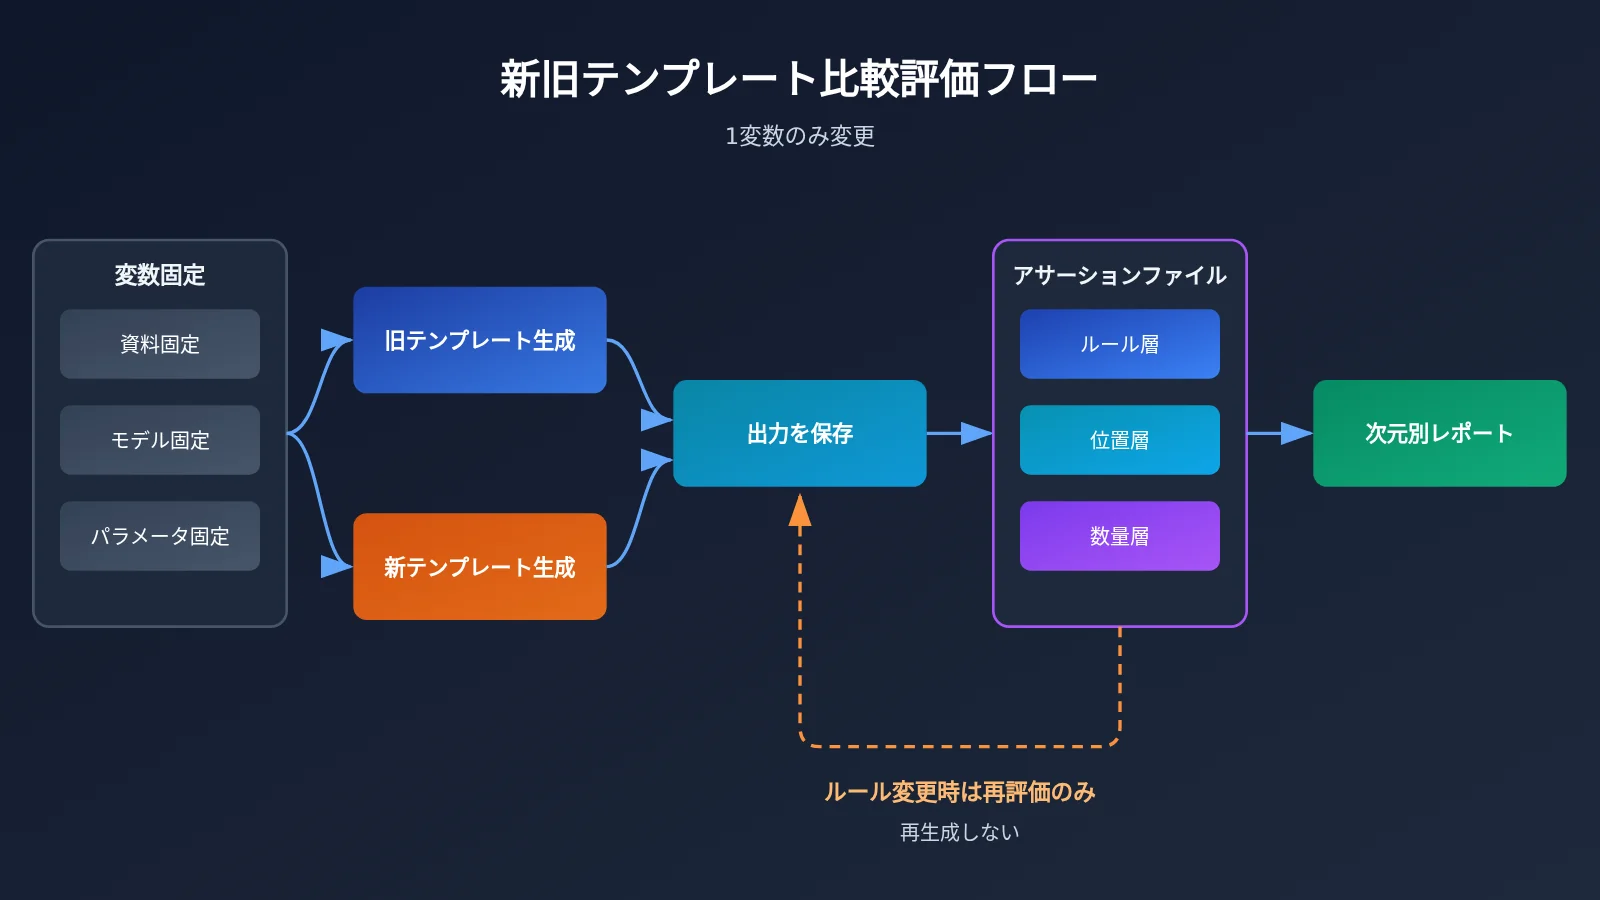
実験設計:Promptfoo でテンプレートを比較する際は1つの変数だけを変える
テンプレートを比較する際の最もよくある誤りは、テンプレートを変えると同時に資料やモデル、温度パラメータまで変えてしまうことです。これでは結果が良くなっても、テンプレートの功績なのか他の要因の影響なのかを説明できません。そこで最初のステップは、テンプレート以外のすべての変数を固定することです。
| 変数 | 処理方法 | 理由 |
|---|---|---|
| 入力資料 | 同一バッチに固定し、新旧テンプレートで共用 | 資料が異なると事実の内容が直接変わってしまう |
| 生成モデル | 同一モデル・バージョンに固定 | モデルが異なると執筆スタイルの差がテンプレートの差より大きくなる可能性がある |
| 生成パラメータ | 温度、最大長などの設定を固定 | パラメータは出力の安定性と分量に影響する |
| プロンプトテンプレート | 唯一変更される変数 | これが検証の対象 |
| 評価ルール | 新旧2グループで同一のアサーションセットを使用 | 両グループが同じチェックを受けることを保証する |
Promptfoo のルール層と位置層:まず構造を確認し、次に順序を確認
第一層はルールチェックで、contains を使ってテンプレートが求める見出しが出力に含まれているかを確認します。第二層は位置の比較で、JavaScript アサーションを使って「## 客观事实」という見出しが「## 分析判断」という見出しより前に現れることを確認します。この二層はいずれも決定的なチェックであり、コストが低く結果も安定しているため、明らかに不合格な出力を最初にふるい落とすのに適しています。
以下は考え方を示すためのアサーションの書き方です。具体的なフィールド名は Promptfoo の公式ドキュメントを参照してください:
# サンプル設定:考え方を説明するためのもの。フィールドの詳細は公式ドキュメントで確認してください
assert:
  # ルール層:見出しが出現するか
  - type: contains
    value: "## 客观事实"
  - type: contains
    value: "## 分析判断"

  # 位置層:事実セクションが分析セクションより前にあること
  - type: javascript
    value: |
      const a = output.indexOf('## 客观事实');
      const b = output.indexOf('## 分析判断');
      return a >= 0 && b >= 0 && a < b;
位置層の書き方では、まず二つの見出しが両方とも存在するかを判定している点に注目してください。もし a < b だけを書いた場合、「## 客观事实」の見出しが欠けていると indexOf は -1 を返し、それでも「より小さい」という条件を満たしてしまい、誤判定につながります。まさにこうした理由から、決定的なアサーションであっても丁寧に書く必要があるのです。
Promptfoo の評価軸レイヤー:明確なルーブリックで事実セクションに推測が混入していないか確認する
タイトルが揃い、順序も正しいからといって、事実セクションがきれいに書けているとは限りません。「事実セクションに推測が混入していないか」は意味的な判断であり、ルールベースのアサーションではなかなかカバーできません。こうした場面では llm-rubric が適しています。ルーブリックは具体的に書き、何が違反に当たるかを評価モデルに伝えるべきで、「よく書けているか」を漠然と尋ねるだけではいけません。
# サンプル設定:評価プロバイダーとルーブリックの内容はあくまで例
assert:
  - type: llm-rubric
    value: |
      「客観的事実」のセクションのみを評価する。
      このセクションに予測・主観的評価・出典が明記されていない推論が含まれている場合は不合格とし、問題のある原文を引用する。
      文章の美しさは評価しない。他のセクションも評価しない。
    provider: your-grading-model   # 評価プロバイダーは個別に設定可能
ルーブリックレイヤーの結論には、依然として人手によるスポットチェックが必要です。評価モデルは判定を漏らすこともあり、妥当な事実記述を推測と誤判定することもあります。より確実な方法は、不合格サンプルを1件ずつ再確認し、さらに合格サンプルからランダムに一部を抽出して人手で審査することです。
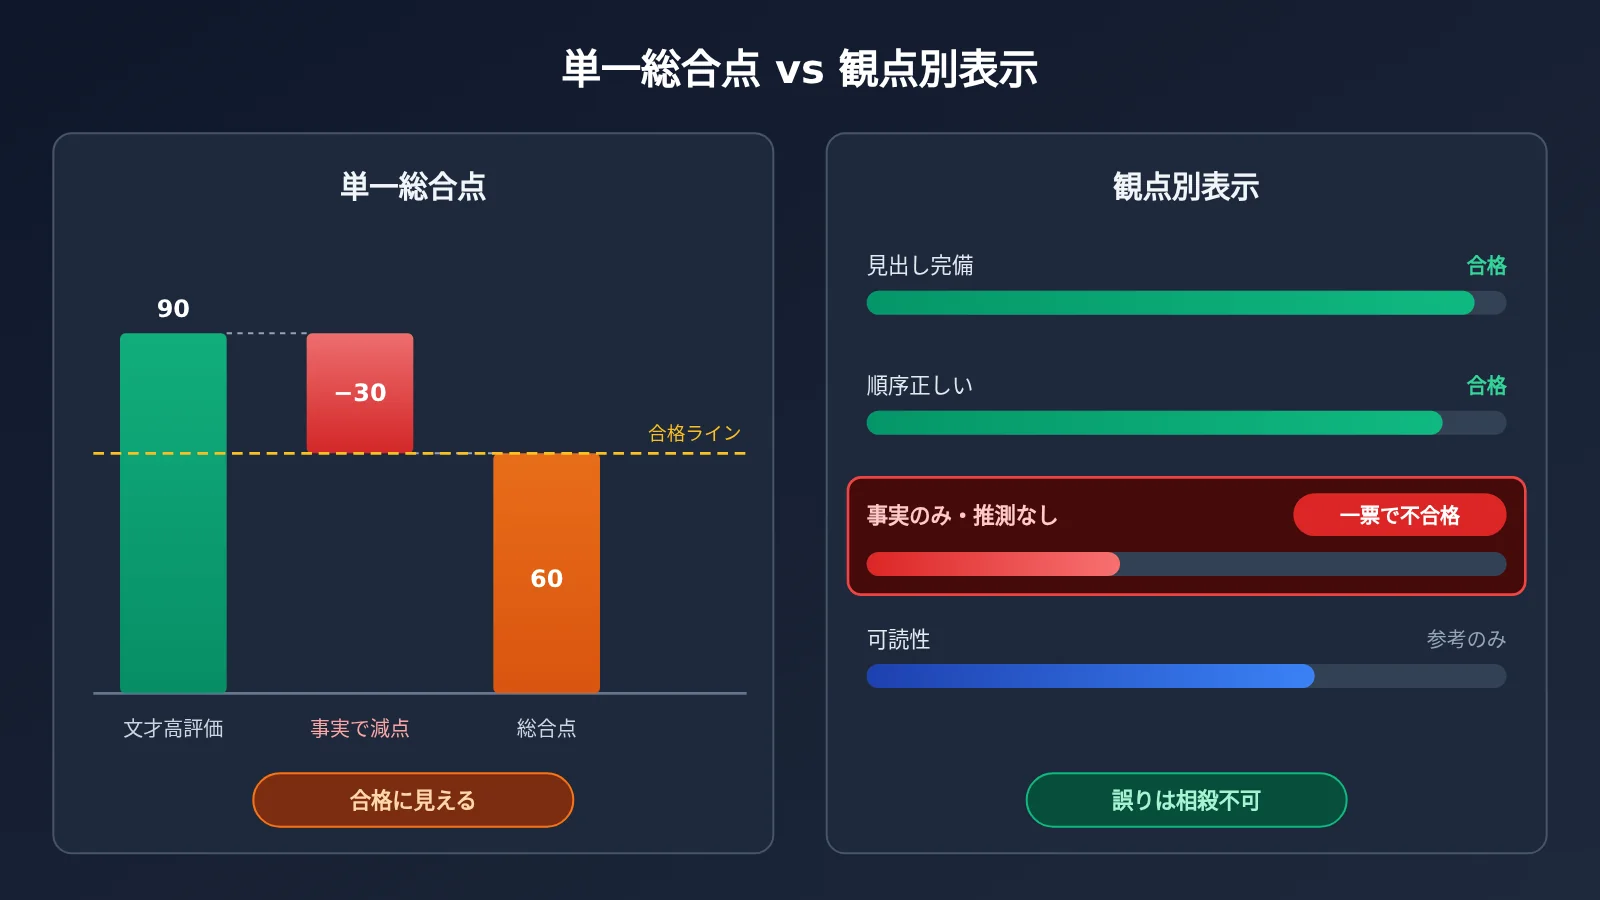
次元別の提示:Promptfoo の文章力スコアが事実エラーを打ち消さないようにする
すべてのアサーションを1つの総合スコアにまとめると、文章は流暢だが事実セクションに推測が混入した記事と、構成は厳密だがやや平板な記事が近いスコアになる可能性があります。ニュース系コンテンツでは、このような「相互打ち消し」は危険です。そのため、次元ごとに個別に報告し、事実系の次元は一票否決に設定することを推奨します。
| 評価次元 | チェック方法 | 提示方法 | 他の次元で打ち消せるか |
|---|---|---|---|
| 必須タイトルが揃っている | contains | 合格率 | いいえ、ハード要件 |
| セクション順序が正しい | JavaScript | 合格率 | いいえ、ハード要件 |
| 事実セクションに推測の混入なし | llm-rubric + 人手審査 | 合格率 + 問題原文リスト | いいえ、一票否決 |
| 表現と可読性 | llm-rubric | 個別に列挙 | 参考のみ、打ち消しには不参加 |
Promptfoo の評価ルールだけを変えたときは、過去の出力をそのまま再評価する
評価を繰り返すなかで、もっとも頻繁に変更されるのはテンプレートそのものではなく、評価ルールであることが多いものです。たとえば、ルーブリック(評価尺度)の説明が十分に明確でないと気づいたり、位置に関するアサーションで境界ケースを書き漏らしたりしたケースです。このときテンプレートも出力も変わっていないので、再生成する必要はありません。
Promptfoo には、既存の出力に対して独立したアサーションファイルを実行する機能があります。これを使えば、生成と評価を完全に切り分けられます。生成は一度だけ行って出力を保存しておき、以降はルールを調整するたびにアサーションだけを再実行すればよいのです。時間を節約できるうえ、前後の評価ラウンドがまったく同じテキストを対象にしていることが保証されるので、比較にも意味が生まれます。
Promptfoo のモデルジャッジにおける限界とコスト
評価結果を過度に解釈してしまわないよう、はっきりさせておきたい点が3つあります。
- モデルジャッジのスコアは、事実の正しさを証明しません。 llm-rubric が示すのは、出力が評価モデルの目にルーブリックに適合して映ったというだけであり、ファクトチェックは元の資料に立ち返って行う必要があります。
- contains が通るのは、あくまで文字列が一致しただけです。 見出しが出現したことは示しますが、その見出しの下にある段落の品質が合格であることは示しません。
- 有料モデルによる評価にはコストがかかります。 ルールベースのアサーションは基本的に追加のモデル呼び出しを発生させませんが、llm-rubric は出力1件を評価するたびに評価モデルを1回呼び出します。そのため、評価全体を「すべて無料」と呼ぶことはできません。
こうした限界を踏まえたうえでの私たちの判断は次のとおりです。決定的なアサーションは「門番(ゲート)」として、モデルによる評価は「一次選別(スクリーニング)」として活用し、事実に関する結論の最終的な根拠とするのは人手によるレビューです。3つの役割はそれぞれ異なり、互いに代替することはできません。
今後注目すべき方向性
以下はまだ検証されていない観察の方向性で、今後の実験提案としてのみ挙げるものです。
- 評価モデルの一貫性。 同じ出力を何度評価しても結論が安定するのか、別の評価モデルに変えると結論が覆るのか。もし不安定なら、評価尺度をもっと具体的に書く必要があります。
- 人手による抜き取り確認とモデル評価の一致度。 これによって、llm-rubric を一次スクリーニングとしてどこまで信頼できるかが決まります。
- サンプル数は十分か。 少数の記事だけを比較すると、偶然の要因がテンプレートの違いを覆い隠す可能性があります。意味のある結論を導くには、十分な量の入力資料が必要です。
これらの問題について実測データが得られるまでは、「新しいテンプレートの勝率はどれだけか」「評価がどれだけ向上したか」といった主張は慎重に扱うべきです。本記事があえてこうした数値を示さないのも、まさにそのためです。
紙の上で得た知識はどこか浅く、このことを本当に理解するには自ら実践するしかない。——陸游「冬夜読書、子聿に示す」