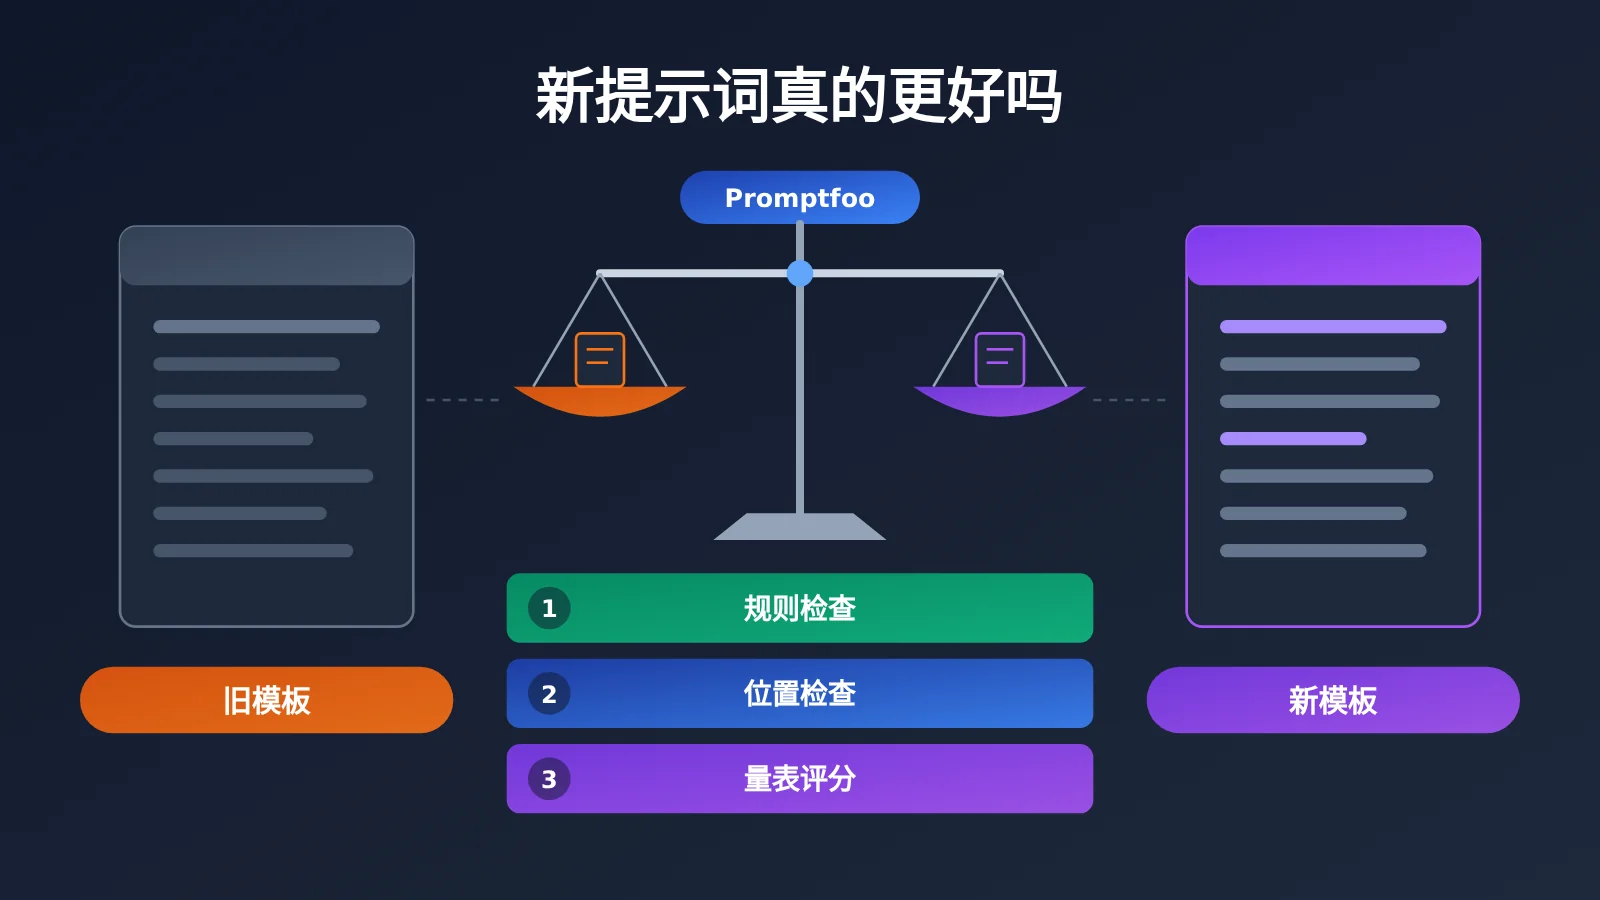
直接回答:新提示词不一定更好,“看起来更好”也不能算证据。 要判断新旧文章模板谁更好,应该固定资料、模型和生成设置,只改模板,再用 Promptfoo 的断言分层检查结构、顺序和内容质量。还要分维度呈现结果,不能让文采分抵消事实错误。本文提出的是一套实验方案,没有运行真实的 A/B 实验,因此不给出任何胜率、评分或节省额度。
读完本文,你能了解到:
- Promptfoo 的
contains、JavaScript 和llm-rubric断言分别能检查什么,不能证明什么。 - 如何对已有模型输出单独运行断言文件,在只改评分规则时避免重新生成。
- 一套比较新旧文章模板的实验设计,包括变量控制、三层检查和分维度呈现。
- 模型裁判和规则断言的边界,以及付费评审模型带来的成本问题。
索引: 先用概念表解释 Promptfoo 评测中的几个关键术语,再说明这件事对内容团队、开发者和评测负责人的影响。正文的“客观事实”部分只整理文档所述的断言能力和核查状态。“分析判断”部分则给出实验设计建议、配置示例和局限讨论,并逐项标明哪些是建议而非实测结论。
Promptfoo 比较提示词模板前需要知道的概念
下面这些术语会在后文反复出现。它们大多来自 Promptfoo 的配置文档,也有少量是评测实验中的通用说法。
| 概念 | 简要解释 |
|---|---|
| Promptfoo | 一个用于评测大模型提示词与输出的开源工具,可以用配置文件定义测试用例和断言 |
| 断言(Assertion) | 对模型输出的自动检查规则,判定输出是否满足某个条件 |
| contains | 检查输出中是否出现指定文本,属于确定性的字符串匹配 |
| JavaScript 断言 | 用一段 JavaScript 表达式或函数实现更复杂的判断条件 |
| llm-rubric | 让一个模型按自定义量表给输出打分,属于“模型评分”类断言 |
| 评分提供方(Grading Provider) | 执行 llm-rubric 打分的那个模型,可以单独配置 |
| 量表(Rubric) | 写给评分模型的评判标准,说明什么情况算通过、什么情况扣分 |
| 模型裁判(LLM-as-a-Judge) | 用大模型代替人工评审输出质量的做法 |
| 变量控制 | 实验中只改变一个因素(这里是模板),其他因素保持不变 |
新旧提示词模板评测的影响速览
这类评测方法的价值不在于工具本身多新,而在于把“我觉得新模板更好”变成可复查的检查记录。不同角色从中得到的东西并不一样。
| 人群 | 实质影响 |
|---|---|
| 内容团队与编辑 | 模板改版有了可复查的验收依据,能发现“结构对了但事实段混入推测”这类问题 |
| 提示词工程师与开发者 | 可以把模板要求拆成规则断言和量表断言,修改评分规则时不必重新生成全部输出 |
| 评测负责人 | 需要分维度汇报结果,并明确区分模型打分、规则命中和人工审查各自的证明力 |
| 预算负责人 | 规则断言几乎没有额外调用开销,llm-rubric 若使用付费模型则会产生评审费用 |
Promptfoo 断言能力的客观事实
这一部分只陈述 Promptfoo 文档中描述的能力。我们于 2026-11-17 核查了相关文档页面,但这些能力的首次发布日期未经核实,因此本文不给出具体上线时间。
Promptfoo 的 contains 断言:检查文本是否出现
contains 是最基础的断言类型,用来检查模型输出中是否出现某段指定文本。它是确定性的字符串匹配,同样的输出每次运行都会得到同样的结果。
需要强调的是,contains 通过只说明“命中了这段文字”。它不能说明这段文字所在的段落写得好不好,也不能说明内容是否正确。
Promptfoo 的 JavaScript 断言:实现复杂条件
当判断条件超出“是否包含”时,可以用 JavaScript 断言编写自定义逻辑。比如比较两个标题出现的先后位置,统计某个章节的数量,或者检查某段文字是否落在特定章节内部。这类断言依然是确定性的,结果可复现。
用独立断言文件评估 Promptfoo 已有输出
Promptfoo 支持对已经生成好的模型输出运行独立的断言文件,不需要把所有输出重新生成一遍。这对评测迭代很重要:评分规则往往需要反复调整,而生成本身既耗时又有调用成本。
Promptfoo 的 llm-rubric:用模型按量表评分
llm-rubric 属于模型评分类断言。它把输出和一段自定义量表交给评分模型,由评分模型判断是否通过并给出理由。文档说明,执行打分的评分提供方可以单独配置,评分时使用的提示也可以自定义。
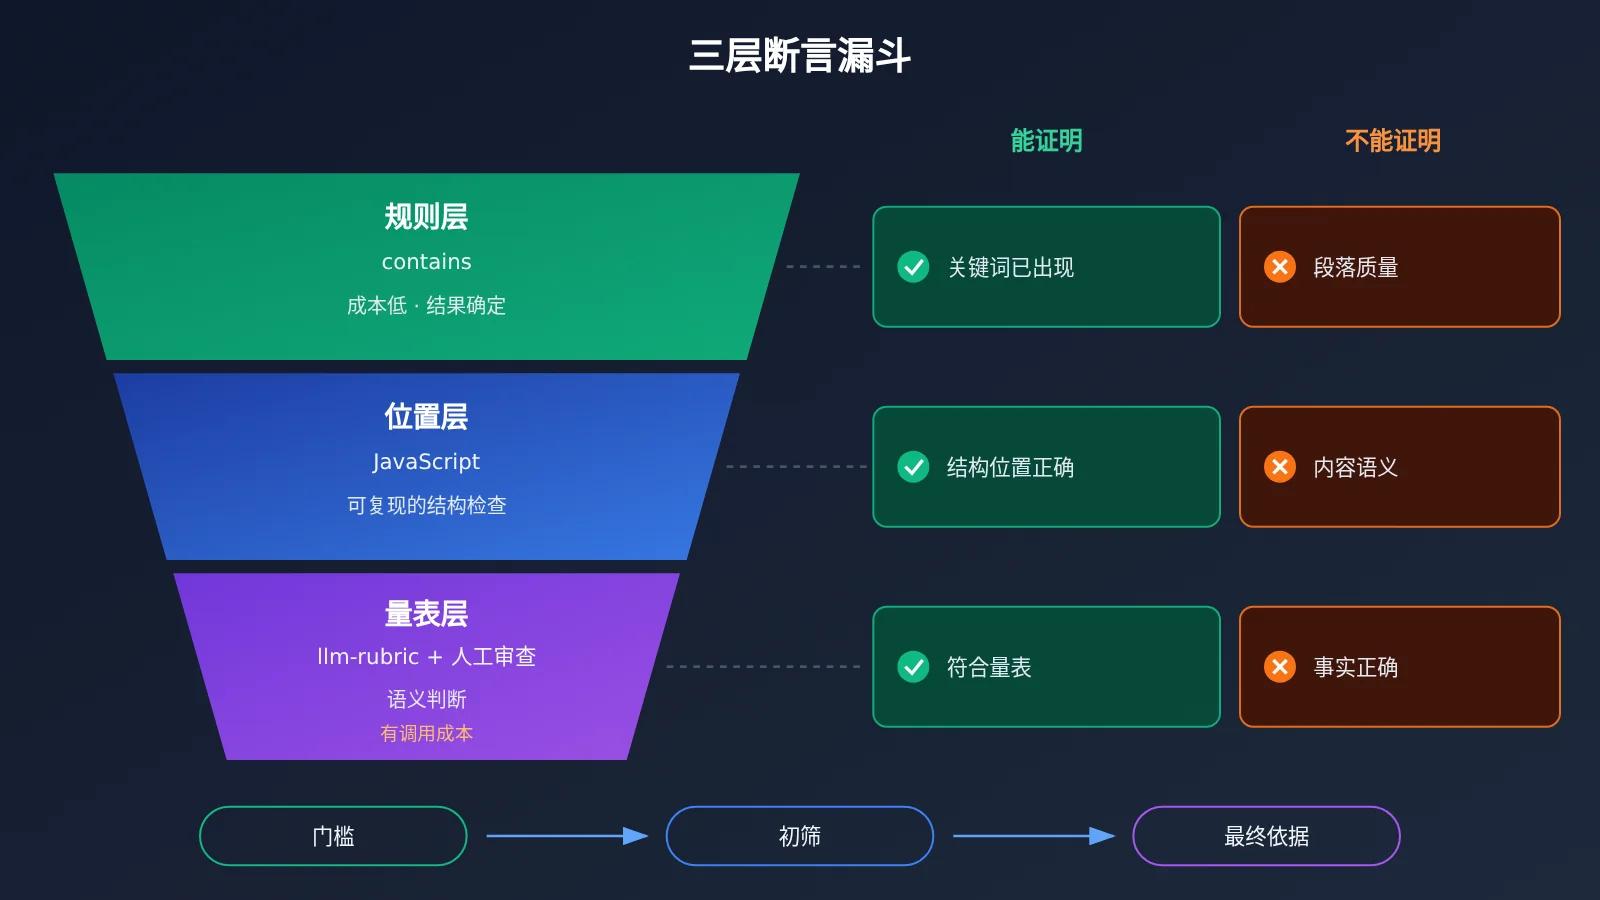
| 断言类型 | 判断方式 | 结果是否确定 | 能证明什么 | 不能证明什么 |
|---|---|---|---|---|
| contains | 字符串匹配 | 确定 | 指定文字出现了 | 段落质量、内容正确性 |
| JavaScript | 自定义代码逻辑 | 确定 | 结构、顺序、计数等可编码条件 | 语义层面的好坏 |
| llm-rubric | 模型按量表评分 | 受评分模型影响 | 输出在评分模型看来符合量表 | 事实正确,也不能替代人工核查 |
资料来源与核查状态
本文事实部分依据以下 Promptfoo 文档页面,核查日期为 2026-11-17:
- Promptfoo 断言与指标文档: promptfoo.dev/docs/configuration/expected-outputs/
- Promptfoo 模型评分断言文档: promptfoo.dev/docs/configuration/expected-outputs/model-graded/
- Promptfoo llm-rubric 文档: promptfoo.dev/docs/configuration/expected-outputs/model-graded/llm-rubric/
本文没有运行真实的新旧模板 A/B 实验。后文出现的配置和流程都是设计建议,不代表任何实测结果。
用 Promptfoo 比较新旧文章模板的分析判断
以下内容是我们基于上述事实做出的解读和建议。以“新闻文章模板”为例,假设新模板要求文章包含“客观事实”和“分析判断”两个章节,且事实在前、分析在后,事实段中不得混入推测。
实验设计:Promptfoo 比较模板时只改一个变量
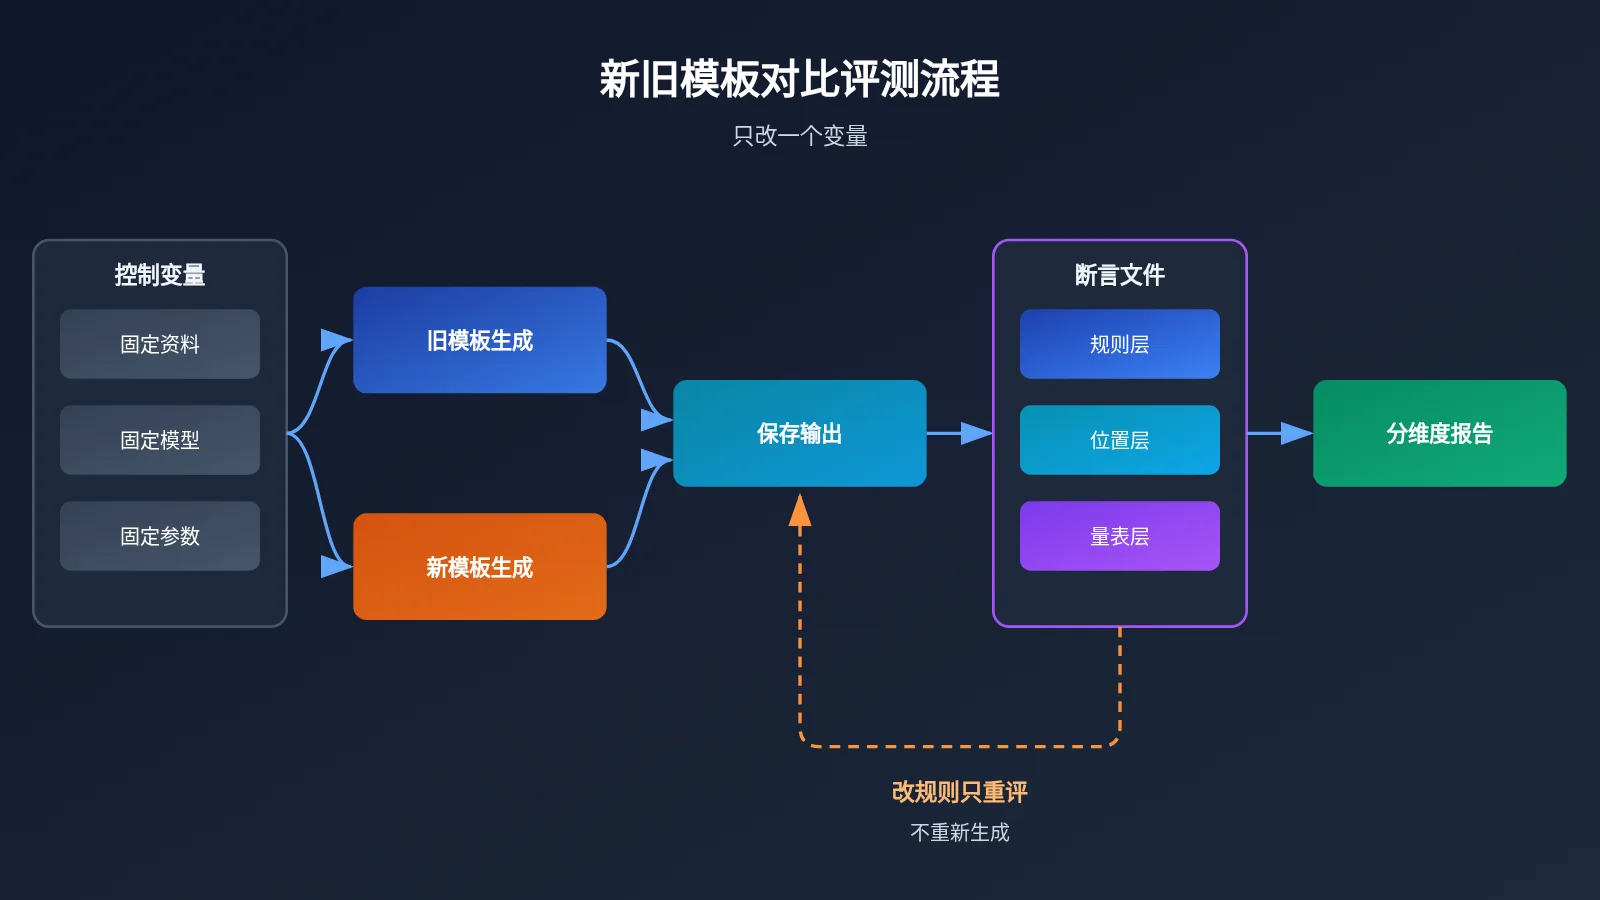
比较模板最常见的错误,是在换模板的同时也换了资料、模型或温度参数。这样即使结果变好,也说不清是模板的功劳还是其他因素的影响。因此第一步是锁死除模板以外的所有变量。
| 变量 | 处理方式 | 原因 |
|---|---|---|
| 输入资料 | 固定同一批,新旧模板共用 | 资料不同会直接改变事实内容 |
| 生成模型 | 固定同一模型与版本 | 不同模型写作风格差异可能大于模板差异 |
| 生成参数 | 固定温度、最大长度等设置 | 参数会影响输出的稳定性和篇幅 |
| 提示词模板 | 唯一被改变的变量 | 这是要验证的对象 |
| 评分规则 | 新旧两组使用同一套断言 | 保证两组接受同样的检查 |
Promptfoo 规则层与位置层:先查结构再查顺序
第一层是规则检查,用 contains 确认模板要求的标题是否出现。第二层是位置比较,用 JavaScript 断言确认“客观事实”标题出现在“分析判断”标题之前。这两层都是确定性检查,成本低、结果稳定,适合放在最前面过滤明显不合格的输出。
下面是一份示意性的断言写法,具体字段名请以 Promptfoo 官方文档为准:
# 示意配置:用于说明思路,字段细节请对照官方文档核实
assert:
  # 规则层:标题是否出现
  - type: contains
    value: "## 客观事实"
  - type: contains
    value: "## 分析判断"

  # 位置层:事实章节必须在分析章节之前
  - type: javascript
    value: |
      const a = output.indexOf('## 客观事实');
      const b = output.indexOf('## 分析判断');
      return a >= 0 && b >= 0 && a < b;
注意位置层的写法里先判断了两个标题都存在。如果只写 a < b,当“客观事实”标题缺失时 indexOf 返回 -1,同样会满足“小于”的条件,造成误判。这正是确定性断言也需要认真编写的原因。
Promptfoo 量表层:用明确量表检查事实段是否混入推测
标题齐全、顺序正确,并不等于事实段写得干净。“事实段是否混入推测”属于语义判断,规则断言很难覆盖,这时适合用 llm-rubric。量表要写得具体,告诉评分模型什么算违规,而不是笼统地问“写得好不好”。
# 示意配置:评分提供方与量表内容均为举例
assert:
  - type: llm-rubric
    value: |
      只评估“客观事实”章节。
      若该章节出现预测、主观评价或未标注来源的推断,判为不通过,并引用出问题的原句。
      不评价文采,不评估其他章节。
    provider: your-grading-model   # 评分提供方可单独配置
量表层的结论仍需要人工抽查。评分模型可能漏判,也可能把合理的事实陈述误判为推测。比较稳妥的做法是对不通过的样本逐条复核,再从通过的样本中随机抽取一部分人工审查。
分维度呈现:不让 Promptfoo 的文采分抵消事实错误
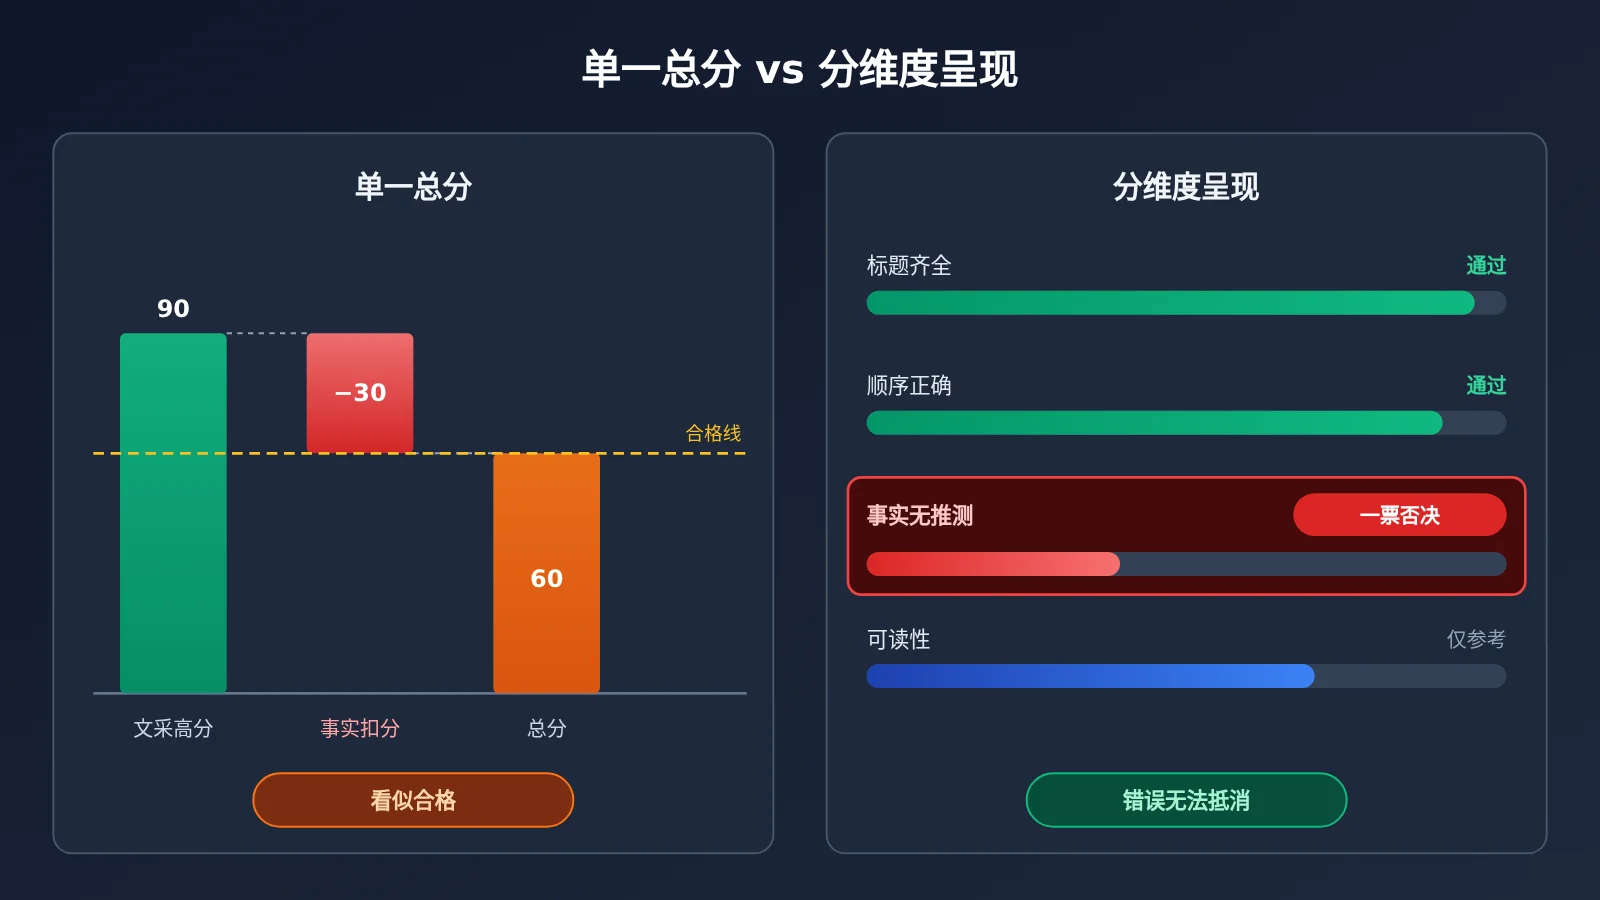
如果把所有断言合成一个总分,一篇文笔流畅但事实段混入推测的文章,可能和一篇结构严谨但略显平淡的文章得分相近。对新闻类内容来说,这种“相互抵消”是危险的。因此建议按维度分别汇报,并把事实类维度设为一票否决。
| 评测维度 | 检查方式 | 呈现方式 | 能否被其他维度抵消 |
|---|---|---|---|
| 必需标题齐全 | contains | 通过率 | 否,属于硬性要求 |
| 章节顺序正确 | JavaScript | 通过率 | 否,属于硬性要求 |
| 事实段无推测混入 | llm-rubric + 人工审查 | 通过率 + 问题原句清单 | 否,一票否决 |
| 表达与可读性 | llm-rubric | 单独列出 | 仅作参考,不参与抵消 |
只改 Promptfoo 评分规则时,直接重评旧输出
评测迭代中,最常改动的往往是评分规则,而不是模板本身。比如发现量表描述不够清楚,或者位置断言写漏了边界情况。此时模板和输出都没变,没有必要重新生成。
利用 Promptfoo 对已有输出运行独立断言文件的能力,可以把生成和评分彻底分开:生成一次,保存输出,之后每次调整规则都只重跑断言。这样既节省时间,也能保证前后两轮评分面对的是完全相同的文本,比较才有意义。
Promptfoo 模型裁判的边界与成本
有三点需要明确说清楚,避免对评测结果过度解读:
- 模型裁判分数不能证明事实正确。 llm-rubric 只说明输出在评分模型看来符合量表,事实核查仍要回到原始资料。
- contains 通过只是命中了文字。 它说明标题出现了,不说明标题下面的段落质量合格。
- 付费模型评审有成本。 规则类断言基本不产生额外模型调用,但 llm-rubric 每评一条输出都要调用一次评分模型,因此不能把整套评测称为“全部免费”。
基于这些边界,我们的判断是:确定性断言适合当作“门槛”,模型评分适合当作“初筛”,人工审查才是事实类结论的最终依据。三者职责不同,不能互相替代。
后续值得关注的方向
以下是尚未验证的观察方向,仅作为后续实验建议:
- 评分模型的一致性。 同一份输出多次评分是否结论稳定,换一个评分模型是否结论翻转。若不稳定,量表需要写得更具体。
- 人工抽查与模型评分的吻合程度。 这决定了在多大程度上可以依赖 llm-rubric 做初筛。
- 样本量是否足够。 只比较少量文章时,偶然因素可能掩盖模板差异,需要足够多的输入资料才能得出有意义的结论。
在这些问题有了实测数据之前,任何“新模板胜率多少”“评分提升多少”的说法都应该谨慎对待。本文刻意不给出这类数字,原因也在于此。
纸上得来终觉浅,绝知此事要躬行。——陆游《冬夜读书示子聿》