直接回答:新提示詞不一定更好,“看起來更好”也不能算證據。 要判斷新舊文章模板誰更好,應該固定資料、模型和生成設置,只改模板,再用 Promptfoo 的斷言分層檢查結構、順序和內容質量。還要分維度呈現結果,不能讓文采分抵消事實錯誤。本文提出的是一套實驗方案,沒有運行真實的 A/B 實驗,因此不給出任何勝率、評分或節省額度。
讀完本文,你能瞭解到:
- Promptfoo 的
contains、JavaScript 和llm-rubric斷言分別能檢查什麼,不能證明什麼。 - 如何對已有模型輸出單獨運行斷言文件,在只改評分規則時避免重新生成。
- 一套比較新舊文章模板的實驗設計,包括變量控制、三層檢查和分維度呈現。
- 模型裁判和規則斷言的邊界,以及付費評審模型帶來的成本問題。
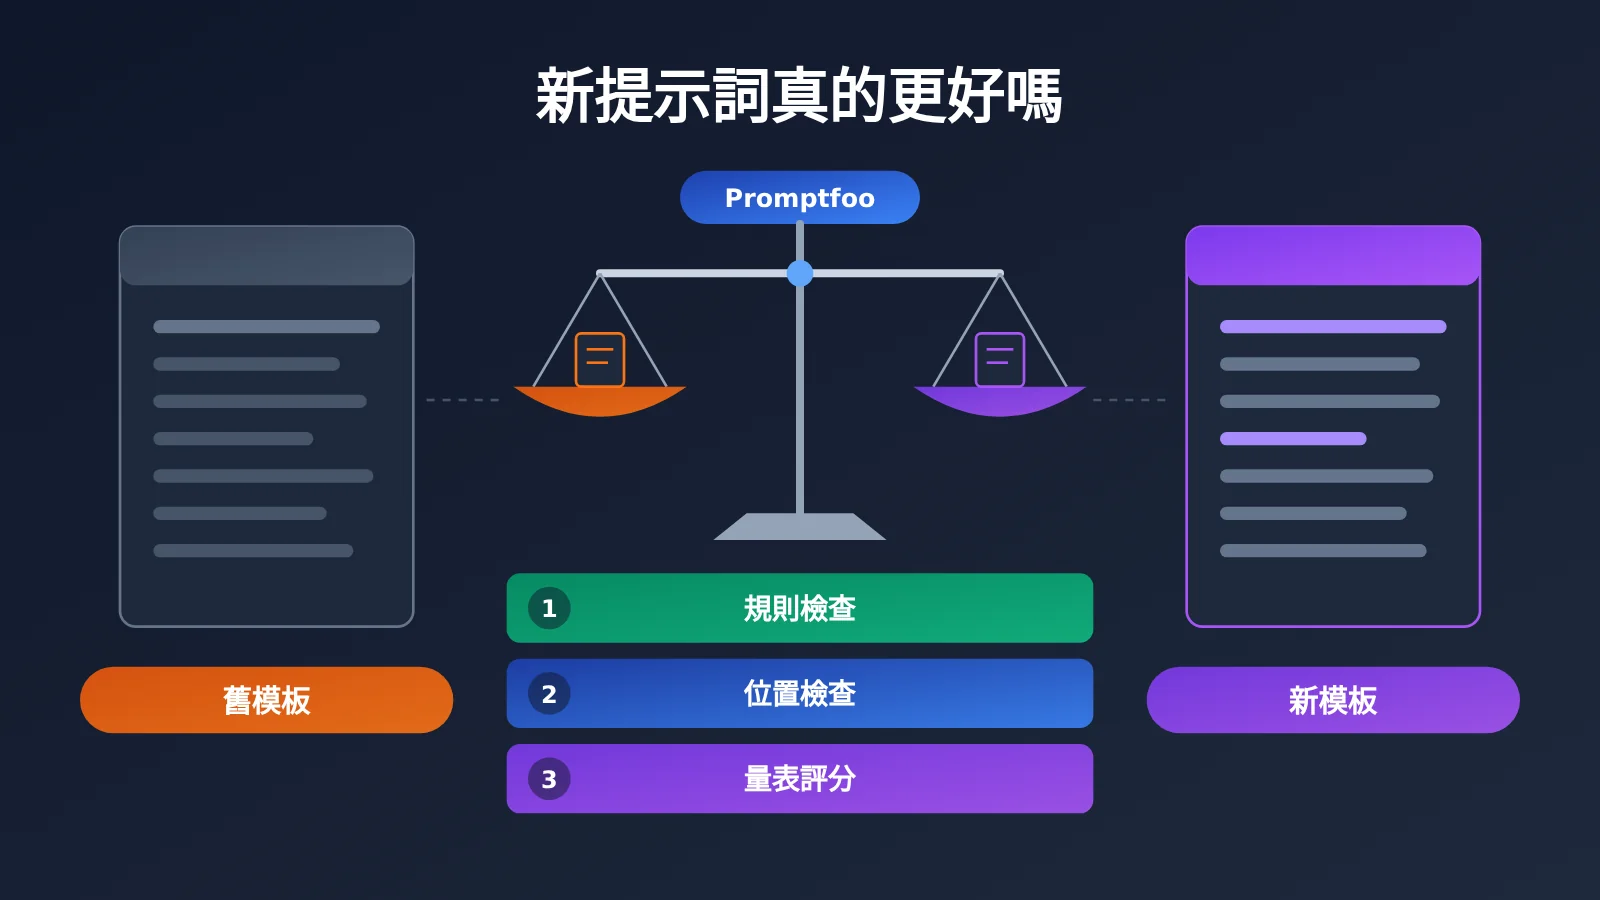
索引: 先用概念表解釋 Promptfoo 評測中的幾個關鍵術語,再說明這件事對內容團隊、開發者和評測負責人的影響。正文的“客觀事實”部分只整理文檔所述的斷言能力和核查狀態。“分析判斷”部分則給出實驗設計建議、配置示例和侷限討論,並逐項標明哪些是建議而非實測結論。
Promptfoo 比較提示詞模板前需要知道的概念
下面這些術語會在後文反覆出現。它們大多來自 Promptfoo 的配置文檔,也有少量是評測實驗中的通用說法。
| 概念 | 簡要解釋 |
|---|---|
| Promptfoo | 一個用於評測大模型提示詞與輸出的開源工具,可以用配置文件定義測試用例和斷言 |
| 斷言(Assertion) | 對模型輸出的自動檢查規則,判定輸出是否滿足某個條件 |
| contains | 檢查輸出中是否出現指定文本,屬於確定性的字符串匹配 |
| JavaScript 斷言 | 用一段 JavaScript 表達式或函數實現更復雜的判斷條件 |
| llm-rubric | 讓一個模型按自定義量表給輸出打分,屬於“模型評分”類斷言 |
| 評分提供方(Grading Provider) | 執行 llm-rubric 打分的那個模型,可以單獨配置 |
| 量表(Rubric) | 寫給評分模型的評判標準,說明什麼情況算通過、什麼情況扣分 |
| 模型裁判(LLM-as-a-Judge) | 用大模型代替人工評審輸出質量的做法 |
| 變量控制 | 實驗中只改變一個因素(這裏是模板),其他因素保持不變 |
新舊提示詞模板評測的影響速覽
這類評測方法的價值不在於工具本身多新,而在於把“我覺得新模板更好”變成可複查的檢查記錄。不同角色從中得到的東西並不一樣。
| 人羣 | 實質影響 |
|---|---|
| 內容團隊與編輯 | 模板改版有了可複查的驗收依據,能發現“結構對了但事實段混入推測”這類問題 |
| 提示詞工程師與開發者 | 可以把模板要求拆成規則斷言和量表斷言,修改評分規則時不必重新生成全部輸出 |
| 評測負責人 | 需要分維度彙報結果,並明確區分模型打分、規則命中和人工審查各自的證明力 |
| 預算負責人 | 規則斷言幾乎沒有額外調用開銷,llm-rubric 若使用付費模型則會產生評審費用 |
Promptfoo 斷言能力的客觀事實
這一部分只陳述 Promptfoo 文檔中描述的能力。我們於 2026-11-17 覈查了相關文檔頁面,但這些能力的首次發佈日期未經覈實,因此本文不給出具體上線時間。
Promptfoo 的 contains 斷言:檢查文本是否出現
contains 是最基礎的斷言類型,用來檢查模型輸出中是否出現某段指定文本。它是確定性的字符串匹配,同樣的輸出每次運行都會得到同樣的結果。
需要強調的是,contains 通過只說明“命中了這段文字”。它不能說明這段文字所在的段落寫得好不好,也不能說明內容是否正確。
Promptfoo 的 JavaScript 斷言:實現複雜條件
當判斷條件超出“是否包含”時,可以用 JavaScript 斷言編寫自定義邏輯。比如比較兩個標題出現的先後位置,統計某個章節的數量,或者檢查某段文字是否落在特定章節內部。這類斷言依然是確定性的,結果可復現。
用獨立斷言文件評估 Promptfoo 已有輸出
Promptfoo 支持對已經生成好的模型輸出運行獨立的斷言文件,不需要把所有輸出重新生成一遍。這對評測迭代很重要:評分規則往往需要反覆調整,而生成本身既耗時又有調用成本。
Promptfoo 的 llm-rubric:用模型按量表評分
llm-rubric 屬於模型評分類斷言。它把輸出和一段自定義量表交給評分模型,由評分模型判斷是否通過並給出理由。文檔說明,執行打分的評分提供方可以單獨配置,評分時使用的提示也可以自定義。
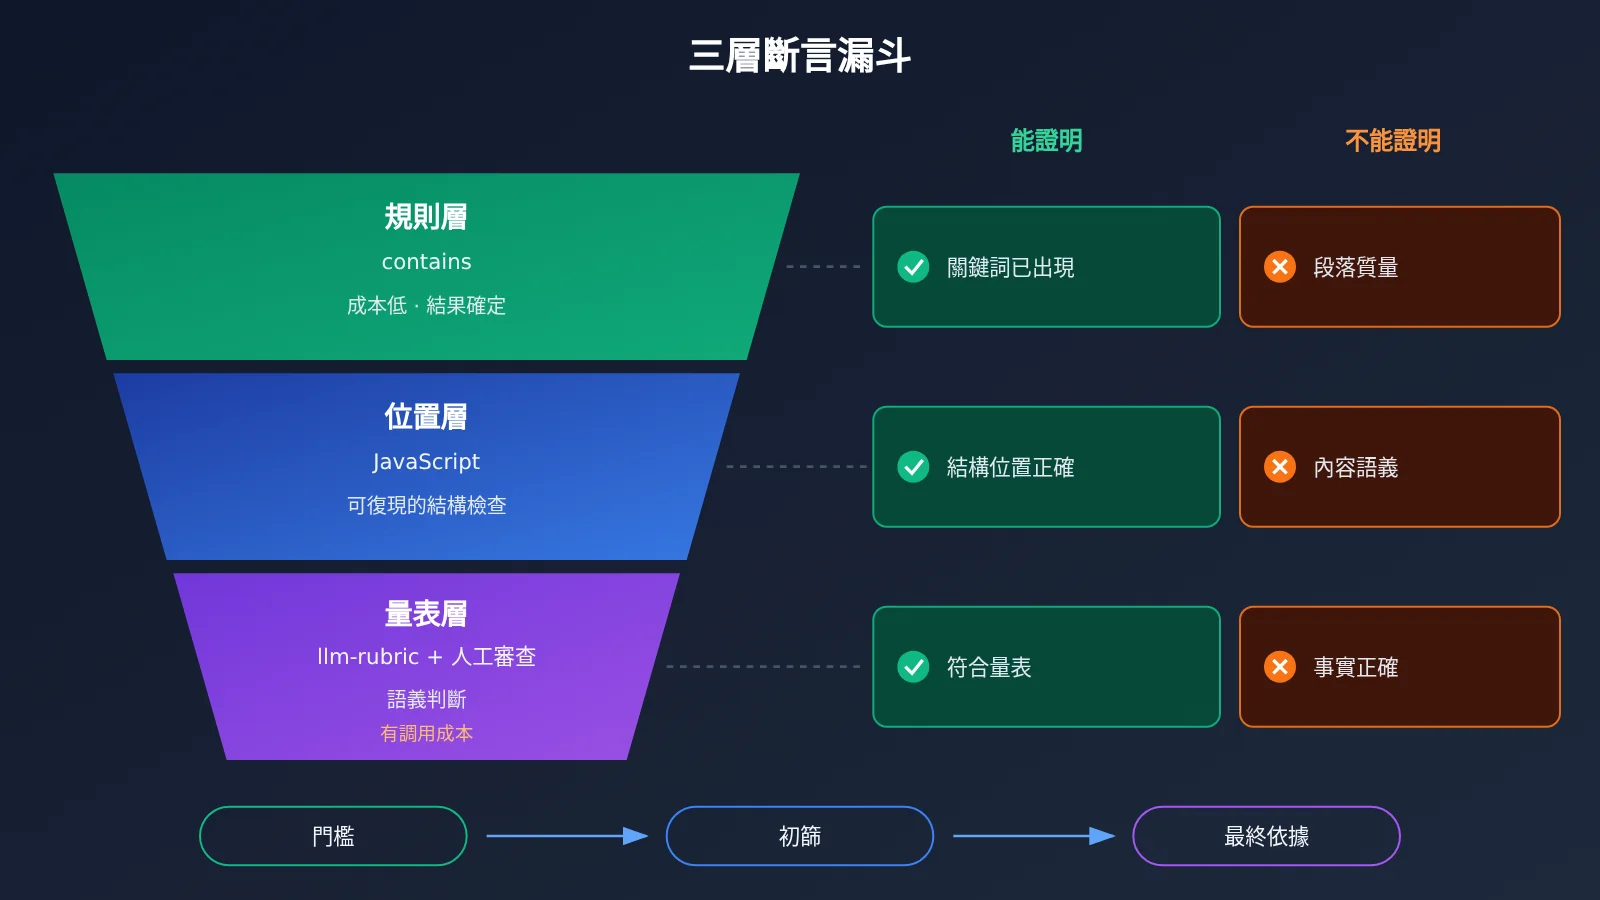
| 斷言類型 | 判斷方式 | 結果是否確定 | 能證明什麼 | 不能證明什麼 |
|---|---|---|---|---|
| contains | 字符串匹配 | 確定 | 指定文字出現了 | 段落質量、內容正確性 |
| JavaScript | 自定義代碼邏輯 | 確定 | 結構、順序、計數等可編碼條件 | 語義層面的好壞 |
| llm-rubric | 模型按量表評分 | 受評分模型影響 | 輸出在評分模型看來符合量表 | 事實正確,也不能替代人工覈查 |
資料來源與覈查狀態
本文事實部分依據以下 Promptfoo 文檔頁面,覈查日期爲 2026-11-17:
- Promptfoo 斷言與指標文檔: promptfoo.dev/docs/configuration/expected-outputs/
- Promptfoo 模型評分斷言文檔: promptfoo.dev/docs/configuration/expected-outputs/model-graded/
- Promptfoo llm-rubric 文檔: promptfoo.dev/docs/configuration/expected-outputs/model-graded/llm-rubric/
本文沒有運行真實的新舊模板 A/B 實驗。後文出現的配置和流程都是設計建議,不代表任何實測結果。
用 Promptfoo 比較新舊文章模板的分析判斷
以下內容是我們基於上述事實做出的解讀和建議。以“新聞文章模板”爲例,假設新模板要求文章包含“客觀事實”和“分析判斷”兩個章節,且事實在前、分析在後,事實段中不得混入推測。
實驗設計:Promptfoo 比較模板時只改一個變量
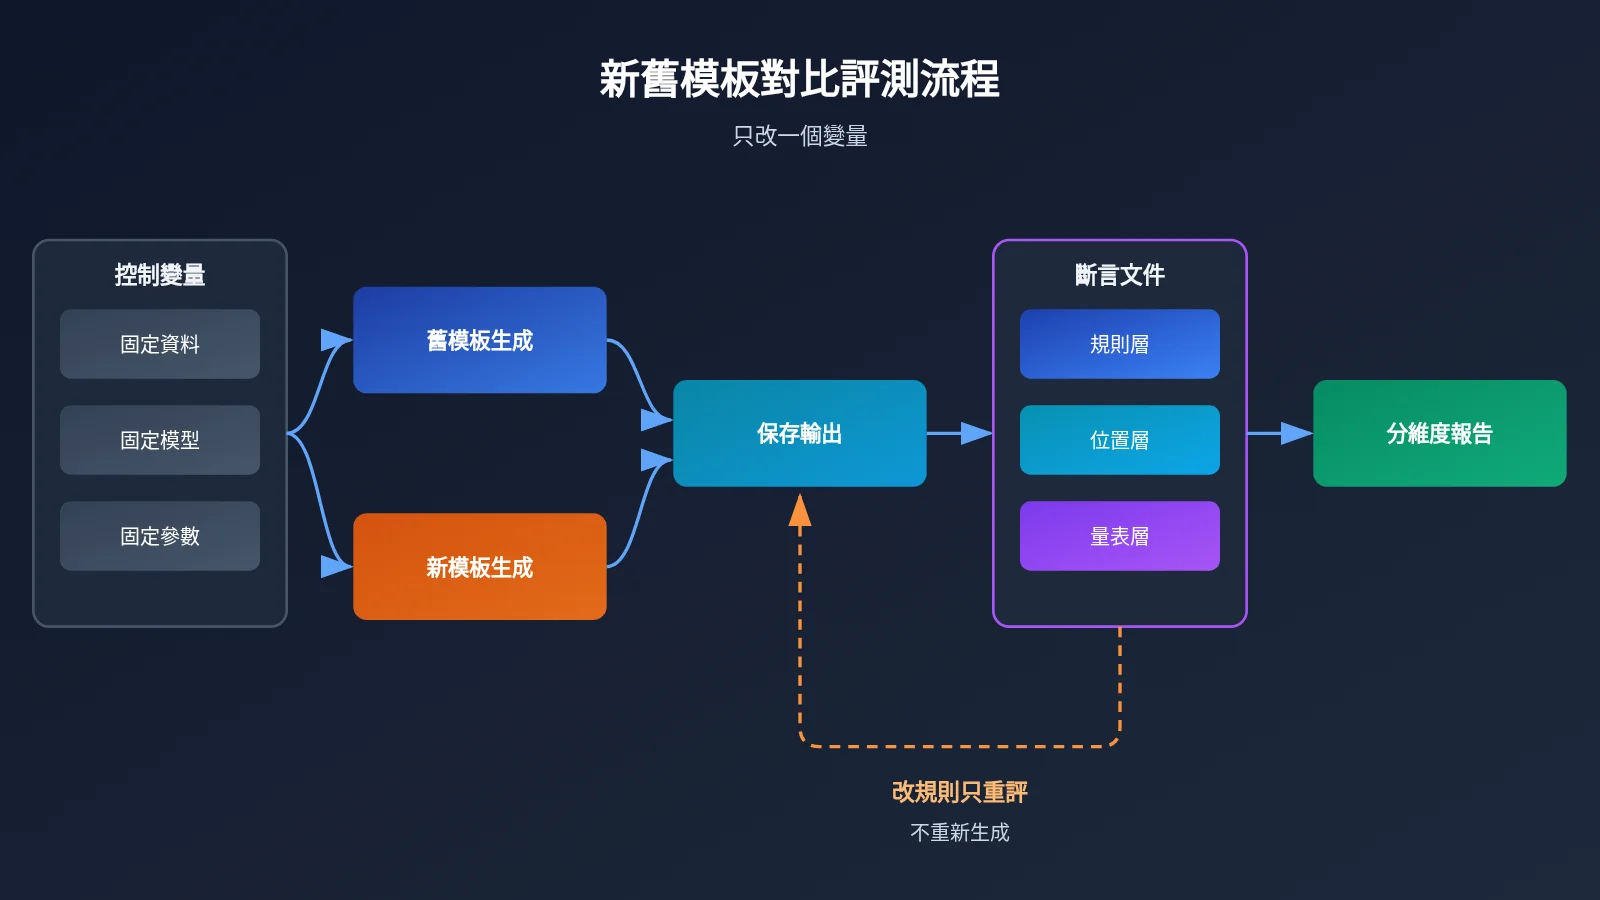
比較模板最常見的錯誤,是在換模板的同時也換了資料、模型或溫度參數。這樣即使結果變好,也說不清是模板的功勞還是其他因素的影響。因此第一步是鎖死除模板以外的所有變量。
| 變量 | 處理方式 | 原因 |
|---|---|---|
| 輸入資料 | 固定同一批,新舊模板共用 | 資料不同會直接改變事實內容 |
| 生成模型 | 固定同一模型與版本 | 不同模型寫作風格差異可能大於模板差異 |
| 生成參數 | 固定溫度、最大長度等設置 | 參數會影響輸出的穩定性和篇幅 |
| 提示詞模板 | 唯一被改變的變量 | 這是要驗證的對象 |
| 評分規則 | 新舊兩組使用同一套斷言 | 保證兩組接受同樣的檢查 |
Promptfoo 規則層與位置層:先查結構再查順序
第一層是規則檢查,用 contains 確認模板要求的標題是否出現。第二層是位置比較,用 JavaScript 斷言確認“客觀事實”標題出現在“分析判斷”標題之前。這兩層都是確定性檢查,成本低、結果穩定,適合放在最前面過濾明顯不合格的輸出。
下面是一份示意性的斷言寫法,具體字段名請以 Promptfoo 官方文檔爲準:
# 示意配置:用於說明思路,字段細節請對照官方文檔覈實
assert:
  # 規則層:標題是否出現
  - type: contains
    value: "## 客觀事實"
  - type: contains
    value: "## 分析判斷"

  # 位置層:事實章節必須在分析章節之前
  - type: javascript
    value: |
      const a = output.indexOf('## 客觀事實');
      const b = output.indexOf('## 分析判斷');
      return a >= 0 && b >= 0 && a < b;
注意位置層的寫法裏先判斷了兩個標題都存在。如果只寫 a < b,當“客觀事實”標題缺失時 indexOf 返回 -1,同樣會滿足“小於”的條件,造成誤判。這正是確定性斷言也需要認真編寫的原因。
Promptfoo 量表層:用明確量表檢查事實段是否混入推測
標題齊全、順序正確,並不等於事實段寫得乾淨。“事實段是否混入推測”屬於語義判斷,規則斷言很難覆蓋,這時適合用 llm-rubric。量表要寫得具體,告訴評分模型什麼算違規,而不是籠統地問“寫得好不好”。
# 示意配置:評分提供方與量表內容均爲舉例
assert:
  - type: llm-rubric
    value: |
      只評估“客觀事實”章節。
      若該章節出現預測、主觀評價或未標註來源的推斷,判爲不通過,並引用出問題的原句。
      不評價文采,不評估其他章節。
    provider: your-grading-model   # 評分提供方可單獨配置
量表層的結論仍需要人工抽查。評分模型可能漏判,也可能把合理的事實陳述誤判爲推測。比較穩妥的做法是對不通過的樣本逐條複覈,再從通過的樣本中隨機抽取一部分人工審查。
分維度呈現:不讓 Promptfoo 的文采分抵消事實錯誤
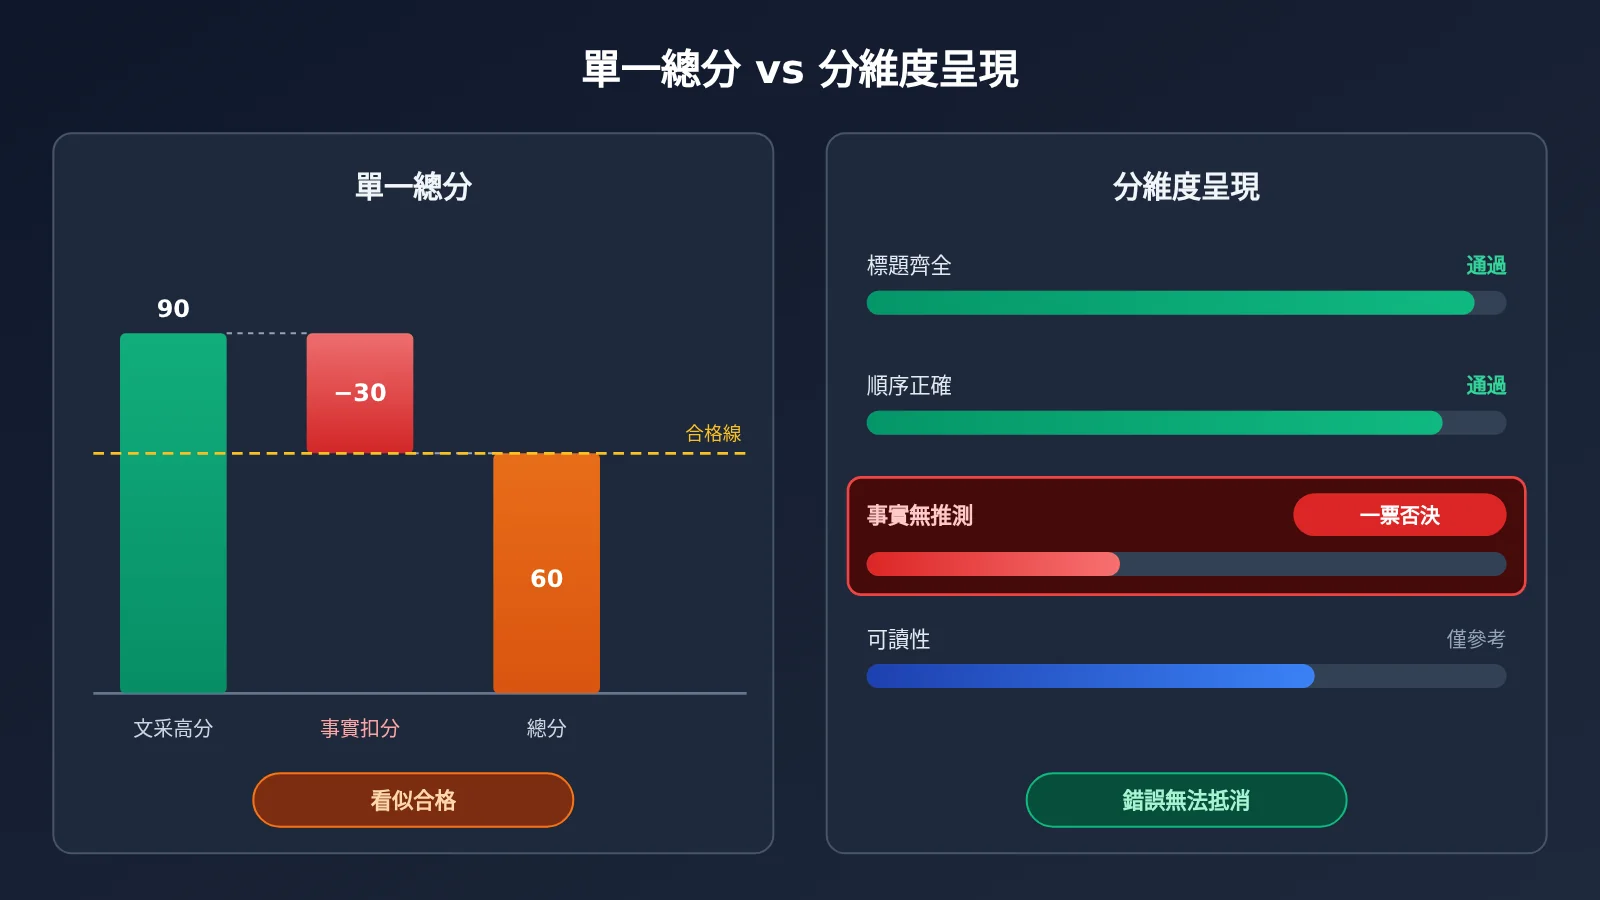
如果把所有斷言合成一個總分,一篇文筆流暢但事實段混入推測的文章,可能和一篇結構嚴謹但略顯平淡的文章得分相近。對新聞類內容來說,這種“相互抵消”是危險的。因此建議按維度分別彙報,並把事實類維度設爲一票否決。
| 評測維度 | 檢查方式 | 呈現方式 | 能否被其他維度抵消 |
|---|---|---|---|
| 必需標題齊全 | contains | 通過率 | 否,屬於硬性要求 |
| 章節順序正確 | JavaScript | 通過率 | 否,屬於硬性要求 |
| 事實段無推測混入 | llm-rubric + 人工審查 | 通過率 + 問題原句清單 | 否,一票否決 |
| 表達與可讀性 | llm-rubric | 單獨列出 | 僅作參考,不參與抵消 |
只改 Promptfoo 評分規則時,直接重評舊輸出
評測迭代中,最常改動的往往是評分規則,而不是模板本身。比如發現量表描述不夠清楚,或者位置斷言寫漏了邊界情況。此時模板和輸出都沒變,沒有必要重新生成。
利用 Promptfoo 對已有輸出運行獨立斷言文件的能力,可以把生成和評分徹底分開:生成一次,保存輸出,之後每次調整規則都只重跑斷言。這樣既節省時間,也能保證前後兩輪評分面對的是完全相同的文本,比較纔有意義。
Promptfoo 模型裁判的邊界與成本
有三點需要明確說清楚,避免對評測結果過度解讀:
- 模型裁判分數不能證明事實正確。 llm-rubric 只說明輸出在評分模型看來符合量表,事實覈查仍要回到原始資料。
- contains 通過只是命中了文字。 它說明標題出現了,不說明標題下面的段落質量合格。
- 付費模型評審有成本。 規則類斷言基本不產生額外模型調用,但 llm-rubric 每評一條輸出都要調用一次評分模型,因此不能把整套評測稱爲“全部免費”。
基於這些邊界,我們的判斷是:確定性斷言適合當作“門檻”,模型評分適合當作“初篩”,人工審查纔是事實類結論的最終依據。三者職責不同,不能互相替代。
後續值得關注的方向
以下是尚未驗證的觀察方向,僅作爲後續實驗建議:
- 評分模型的一致性。 同一份輸出多次評分是否結論穩定,換一個評分模型是否結論翻轉。若不穩定,量表需要寫得更具體。
- 人工抽查與模型評分的吻合程度。 這決定了在多大程度上可以依賴 llm-rubric 做初篩。
- 樣本量是否足夠。 只比較少量文章時,偶然因素可能掩蓋模板差異,需要足夠多的輸入資料才能得出有意義的結論。
在這些問題有了實測數據之前,任何“新模板勝率多少”“評分提升多少”的說法都應該謹慎對待。本文刻意不給出這類數字,原因也在於此。
紙上得來終覺淺,絕知此事要躬行。——陸游《冬夜讀書示子聿》