Примечание автора: на примере проекта Heimstaden по оценке экологических рисков разберём, как человек и Codex распределяют работу при поиске и очистке данных и построении процессов, если пользователь не занимается разработкой. Также объясним, почему ответственность за методологию и проверку результатов должна оставаться у отраслевого эксперта.
Многие бизнес-аналитики хорошо знают свою отрасль, но не умеют писать код. Когда данные разбросаны по десяткам открытых источников и представлены в разных форматах, раньше им приходилось ждать помощи технической команды или обращаться к внешним консультантам. На основе реального публичного кейса мы разберём, как распределить работу между человеком и Codex при построении процесса обработки данных без навыков разработки. Особое внимание уделим двум принципиальным вопросам: ответственности за методологию и проверке результатов человеком.
Это не рекламная статья о том, как «ИИ сделает за вас всё». В кейсе есть впечатляющие цифры, но многие детали не раскрыты. Мы чётко разделим известные факты и предположения.
Главная польза: из статьи вы узнаете, какие этапы проекта по работе с данными стоит поручить агенту для программирования, а за какие решения нужно отвечать самостоятельно. Вы также поймёте, как превратить разовый анализ в процесс, который команда сможет развивать и улучшать.
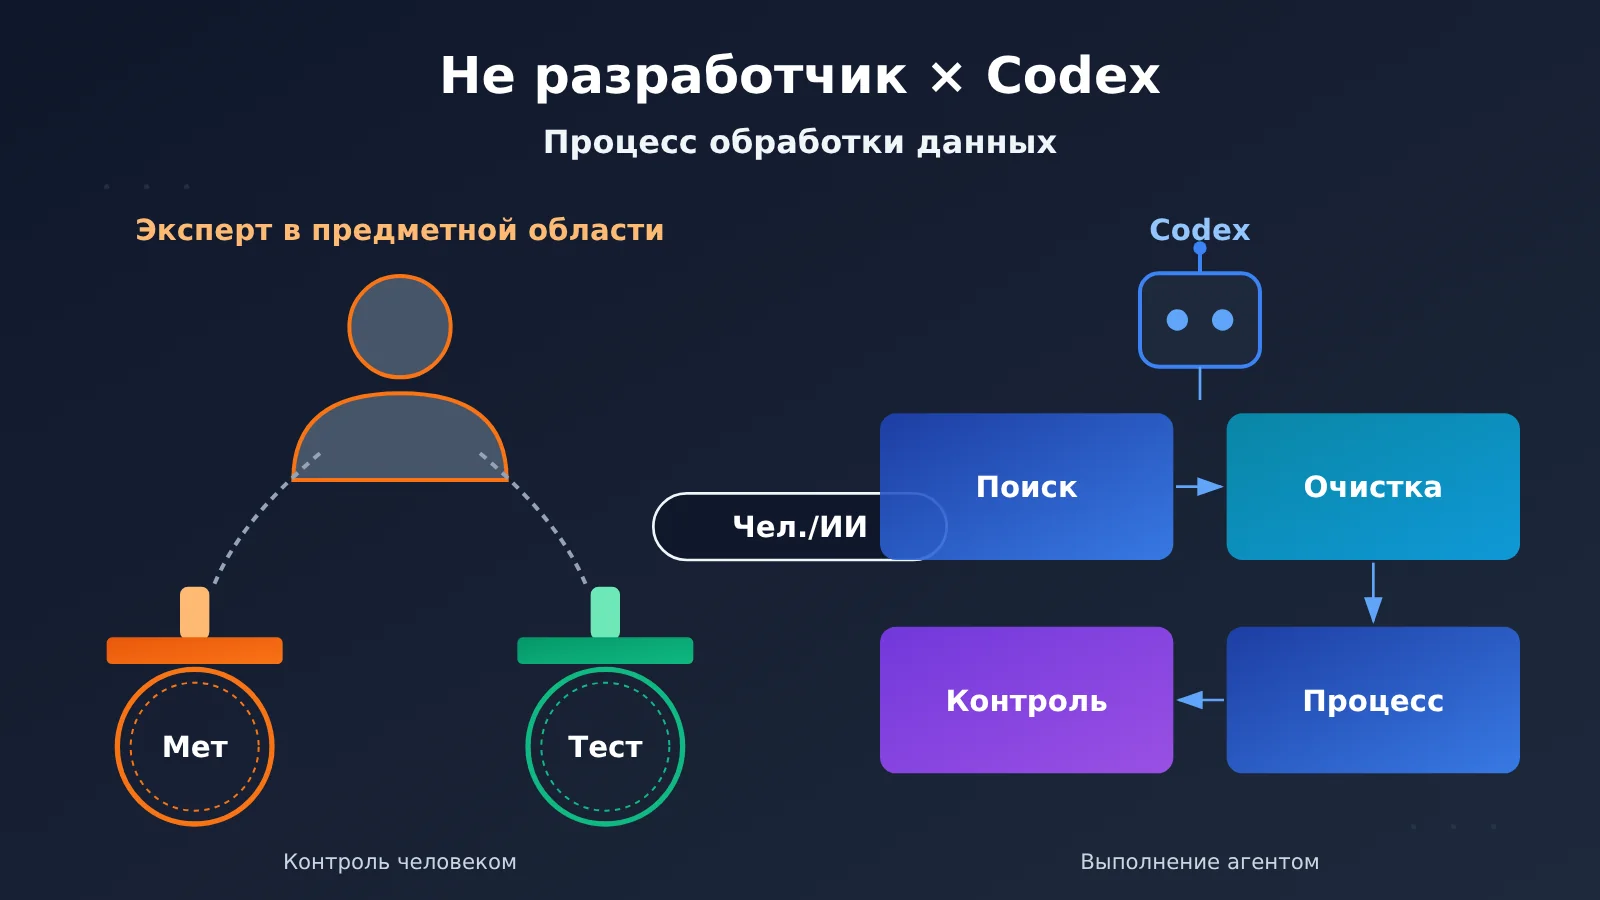
Главное о создании процессов обработки данных с Codex для неспециалистов по разработке
3 ноября 2026 года OpenAI опубликовала историю клиента — европейского оператора жилой недвижимости Heimstaden. В ней рассказывается об аналитике по экологической устойчивости Julia Erlandsen. Не имея опыта разработки, она с помощью Codex провела оценку экологических рисков для всего портфеля активов. В таблице собраны главные выводы из этого примера.
| Аспект | Как было в примере | Чем полезно читателю |
|---|---|---|
| Характер задачи | Информация существует, но разбросана по разным открытым источникам, форматам и наборам данных | Помогает распознать проекты с разрозненными данными, для которых особенно полезны агенты |
| Задачи агента | Поиск, очистка и стандартизация данных, проверка качества, разработка воспроизводимого процесса обработки | Показывает, какие этапы можно доверить агенту |
| Роль эксперта | Аналитик сохраняет контроль над методологией и проверкой результатов | Помогает обеспечить достоверность выводов |
| Масштаб результата | Оценено 20,112 объектов, получено более 600 миллионов строк пригодных к использованию данных | Показывает, что и без навыков разработки можно работать с большими объёмами данных |
| Долгосрочная польза | Разовый проект превратился в воспроизводимый процесс, не требующий внешних консультантов | Методология остаётся внутри компании, и её можно развивать самостоятельно |
Как распределить работу с Codex при обработке данных
Самая важная мысль в этом примере проста: Codex помогал искать, очищать и стандартизировать данные, проверять их качество и разрабатывать воспроизводимый процесс обработки, а Julia сохранила контроль над методологией и проверкой результатов. Это чёткая граница. Всё, что связано с очисткой данных и построением рабочего процесса, можно поручить агенту. А решения о том, по каким критериям оценивать риски и верны ли результаты, должны оставаться за человеком.
Эта граница важна, потому что результаты экологической оценки используются для анализа климатических рисков, подготовки отчётности в соответствии с требованиями и принятия инвестиционных решений. Если методология строится на предположениях агента по умолчанию, аналитик не сможет объяснить инвесторам или аудиторам, откуда взялись выводы. Слова самой Julia подтверждают это: «Теперь эта методология принадлежит нам, и мы можем продолжать развивать её самостоятельно». Под «владением» здесь понимается именно понимание и контроль логики оценки, а не просто наличие таблицы с результатами.
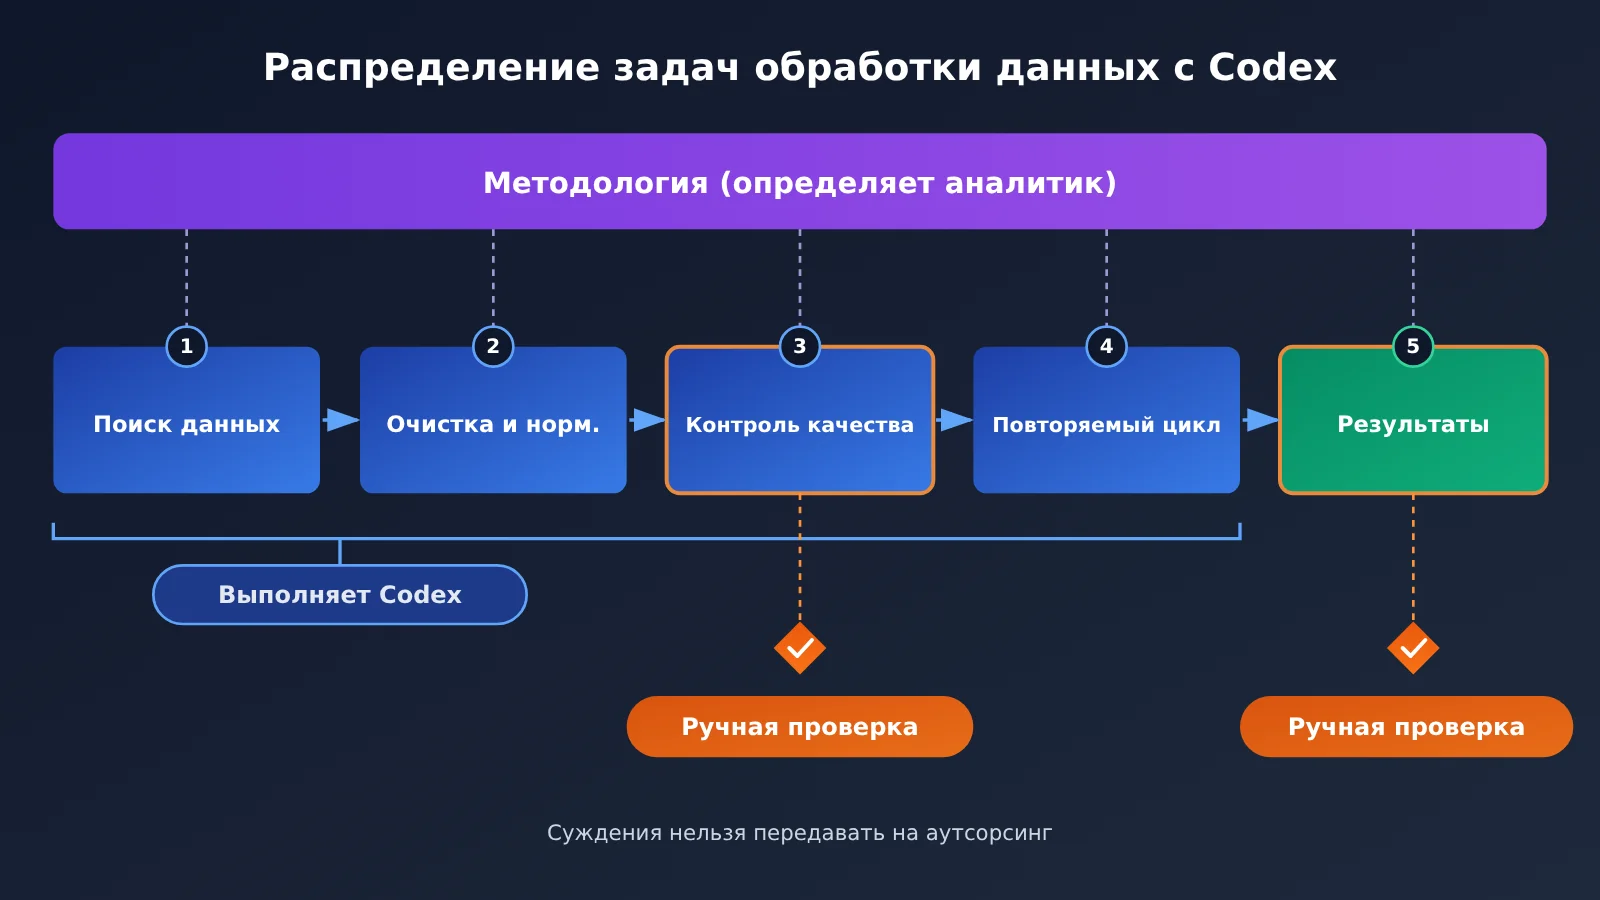
Принципы распределения задач при обработке данных с Codex для неспециалистов в программировании
На основе распределения обязанностей в этом кейсе можно составить более общую таблицу. В колонке «Раскрыты ли детали в кейсе» указано, есть ли соответствующие подробности в оригинальном материале. Рекомендации в таблице основаны на типичном опыте работы с данными и не обязательно отражают то, как действовала Heimstaden.
| Этап | Задачи программного агента | Задачи эксперта предметной области | Раскрыты ли детали в кейсе |
|---|---|---|---|
| Поиск данных | Найти и перечислить возможные источники данных, объяснить значение полей | Определить, насколько источники авторитетны и подходят ли они для оценки | Конкретные источники не раскрыты |
| Очистка и стандартизация | Унифицировать форматы, единицы измерения и кодировки, сопоставить координаты и адреса | Решить, как обрабатывать пропущенные и противоречивые значения | Правила не раскрыты |
| Проверка качества | Написать автоматические проверки, составить список аномалий | Определить, что считать аномалией, провести выборочную проверку | Методы и доля ошибок не раскрыты |
| Построение процесса | Объединить шаги в процесс обработки, который можно запускать повторно | Убедиться, что логика процесса соответствует методологии | Упоминается только возможность повторного запуска |
| Методология и выводы | Выполнить расчёты по инструкции | Определить систему оценки, веса и пороговые значения, отвечать за результаты | Прямо указано, что эти задачи остаются за аналитиком |
Из этой таблицы можно вывести 5 принципов распределения задач:
- Исполнение можно делегировать, суждения — нет. Агент хорошо превращает расплывчатое «приведи данные в порядок» в конкретные действия, но на вопрос «разумно ли это пороговое значение» ответит только специалист, который знает отрасль.
- Сначала зафиксируйте методологию, потом передавайте её агенту. Система оценки должна быть документом, который вы можете объяснить самостоятельно, а не набором разрозненных инструкций в переписке.
- Проверяйте результат независимо. Если поручить агенту, который создал процесс, проверить собственную работу, он обнаружит лишь часть проблем. Без ручной выборочной проверки и сравнения с внешними эталонами не обойтись.
- Процесс должен быть воспроизводимым. Разовый результат, полученный вручную, трудно дорабатывать. А вот процесс, который можно запустить заново, — это ценный актив.
- За выводы всегда отвечает человек. Общая стратегия Heimstaden в области ИИ также подчёркивает: сотрудники отвечают за проверку и утверждение решений, а материалы, созданные ИИ, перед публикацией должен проверить человек.
🎯 Технический совет: если на одном из этапов обработки данных нужно вызвать большую языковую модель — например, чтобы распределить неструктурированные текстовые описания по уровням риска, — через APIYI apiyi.com можно обращаться к нескольким популярным моделям с помощью одного интерфейса. Если разные модели оценивают одну и ту же выборку, систематические отклонения отдельной модели заметить проще. Это само по себе недорогой способ проверки.
Быстрый старт: обработка данных с Codex для тех, кто не программирует
В описании кейса не уточняется, какой вариант Codex использовала Джулия, как именно она с ним взаимодействовала и как был устроен её рабочий процесс. Поэтому шаги ниже не воспроизводят кейс: это отправная точка для аналитиков без опыта разработки, основанная на описанном распределении задач. Как и требуется, здесь нет кода — только списки с пояснениями, что передать агенту и что проверить самостоятельно на каждом этапе.
Шаг 1. Опишите методологию на естественном языке
Прежде чем приступать к работе, опишите логику оценки в документе, например methodology.md. Укажите как минимум цель оценки, необходимые показатели, способ расчёта каждого показателя, пороговые значения для уровней риска и правила работы с отсутствующими данными. Этот документ закрепляет ваше право определять методологию: каждый раз, когда вы просите агента изменить процесс, он должен ориентироваться на него.
Шаг 2: поручите агенту поиск данных, но решение оставьте за собой
Расскажите агенту о целях оценки и попросите перечислить возможные источники данных, поля в каждом из них, частоту обновления и известные ограничения. Проверьте каждый источник: достаточно ли он авторитетен и соответствует ли его охват распределению ваших активов. Попросите агента сохранять исходные загруженные данные в отдельную директорию raw и никогда их не изменять. Всю дальнейшую обработку следует проводить на копиях.
Шаг 3: очистка и стандартизация с журналом всех изменений
Объясните агенту правила стандартизации: например, единый формат адресов и дат, систему координат и единицы измерения. Затем попросите его составить процесс обработки. Главное требование — фиксировать результаты каждого преобразования: сколько строк удалено, сколько записей объединено и какие записи не удалось сопоставить. Так вы сможете оценить обоснованность обработки по журналу, даже не разбираясь в коде.
Шаг четвёртый: проверьте качество в два этапа
Первый этап поручите агенту: пусть он напишет автоматические проверки на дубликаты, пропущенные значения, выход за допустимые пределы, ошибки сопоставления активов и другие проблемы, а затем составит список аномалий. Второй этап — за вами: выберите случайную часть активов из результатов и проверьте их вручную привычным вам способом. Долю выборки и допустимый уровень ошибок заранее укажите в документе с методологией и отдельно зафиксируйте в таблице вроде validation_log.
Шаг пятый: сделайте процесс повторяемым
Когда убедитесь, что результатам можно доверять, попросите агента собрать весь процесс так, чтобы его можно было повторно запустить в один клик, и написать инструкцию. Она должна быть достаточно понятной, чтобы коллега, который тоже не умеет программировать, смог всё выполнить самостоятельно. Только после этого проект из «разового анализа» превратится в «воспроизводимый инструмент».
| Этап | Что вы передаёте агенту | Что обязательно проверить | Типичный риск |
|---|---|---|---|
| Методология | Цель оценки и отраслевые знания | Документ с методологией, написанный вами | Неясные определения показателей и постоянные переделки |
| Поиск данных | Цель и охват | Список источников и описание ограничений | Использование ненадёжных или устаревших данных |
| Очистка и стандартизация | Правила стандартизации | Журнал изменений на каждом шаге | Данные удаляются без уведомления, и результат лишь выглядит чистым |
| Проверка качества | Определения аномалий и доля выборки | Список аномалий и результаты ручной проверки выборки | Доверие только автоматическим проверкам и пропуск систематических ошибок |
| Закрепление процесса | Требования к запуску и обновлению | Повторно запускаемый процесс и инструкция | Только агент «помнит», как запустить процесс |
🚀 Быстрый старт: если на третьем или четвёртом шаге вам понадобится большая языковая модель для понимания текстовых полей — например, для разбора описаний рисков в открытых отчётах разных стран, — сначала сравните результаты нескольких моделей на небольшой выборке через APIYI apiyi.com. Выберите самую стабильную и подключите её к основному процессу. Так вы не будете с самого начала полагаться на одну модель для всей партии данных.
Сравнение процесса обработки данных с Codex и других подходов
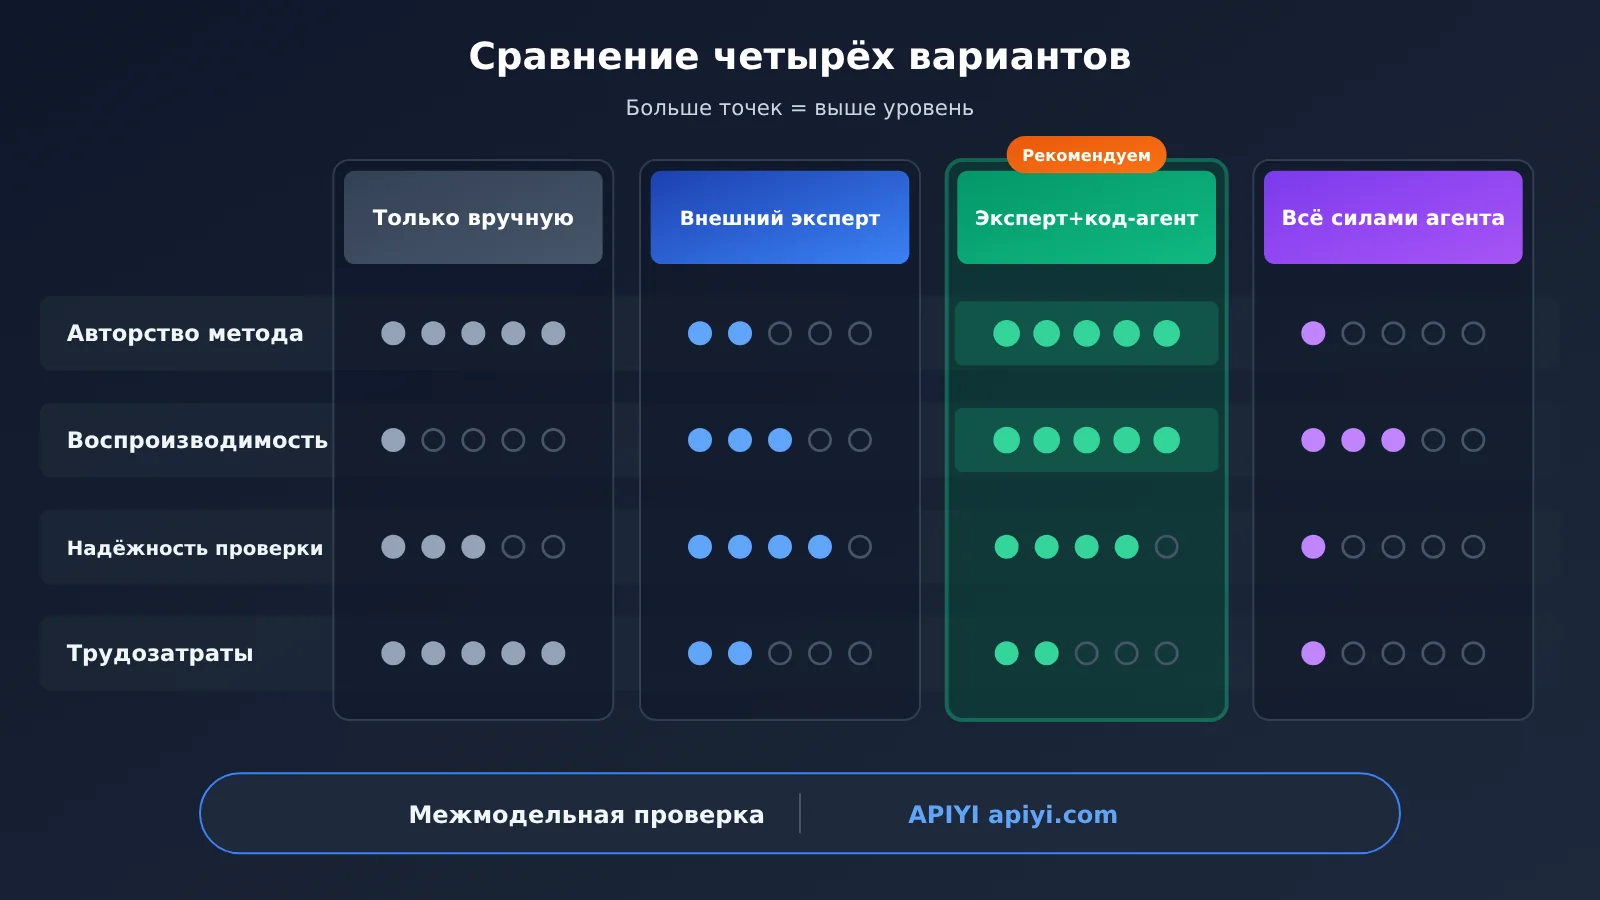
| Подход | Кому принадлежит методология | Воспроизводимость | Надёжность проверки | Главная проблема |
|---|---|---|---|---|
| Полностью вручную | Эксперту | Низкая, процесс часто сложно повторить | Зависит от внимательности специалиста | Высокие трудозатраты: в рассматриваемом случае потребовалось бы 5 человек на 1 год |
| Внешние консультанты | Обычно консультантам | Средняя, зависит от результатов работы консультантов | Довольно высокая, но процесс непрозрачен | Для последующих обновлений приходится снова обращаться к консультантам |
| Эксперт + программирующий агент | Эксперту | Высокая, процесс можно повторить | Высокая при условии тщательной проверки человеком | От эксперта требуется умение чётко сформулировать методологию |
| Полностью силами агента | Неясно: методология скрыта в предположениях по умолчанию | Средняя | Низкая, сложно объяснить, откуда взялись выводы | За выводы сложно отвечать перед внешними сторонами |
Разбор сравнения
Сравнение с внешними консультантами: у консультантов есть преимущества в профессиональном опыте и скорости работы. Но методология обычно остаётся у них: чтобы обновить оценку в следующем году, придётся снова обсуждать задачу и оплачивать услуги. В модели «эксперт + программирующий агент» методология остаётся внутри организации. Heimstaden также прямо отметила, что благодаря проекту ей не пришлось нанимать внешних консультантов.
Сравнение с полностью автономной работой агента: передать агенту весь проект кажется самым простым решением, к тому же результат можно получить быстро. Но агент самостоятельно делает множество предположений: например, как заполнять пропущенные значения и исключать выбросы. Эти предположения могут не соответствовать отраслевой практике. Если оценка нужна для подготовки отчётности в соответствии с требованиями или принятия инвестиционных решений, такие выводы будет сложно защитить при проверке.
К цифрам экономии трудозатрат стоит относиться объективно. В оригинале речь идёт об «оценочной потребности в ресурсах»: она снизилась с 5 человек на 1 год до 2 человек на 2 месяца. При грубом пересчёте получается около 60 человеко-месяцев против 4. Но это собственная оценка компании, которую никто независимо не проверял. Кроме того, не указано, как распределялись роли между двумя участниками.
💡 Совет по выбору: если у вашей команды уже есть методология, но не хватает технических ресурсов для её реализации, стоит попробовать подход «эксперт + программирующий агент». Для вызова моделей в процессе можно использовать единый интерфейс APIYI apiyi.com: он позволяет переключаться между моделями и сравнивать их, а при последующей замене модели не придётся переписывать весь процесс.
Что известно и неизвестно о кейсе Codex по обработке данных
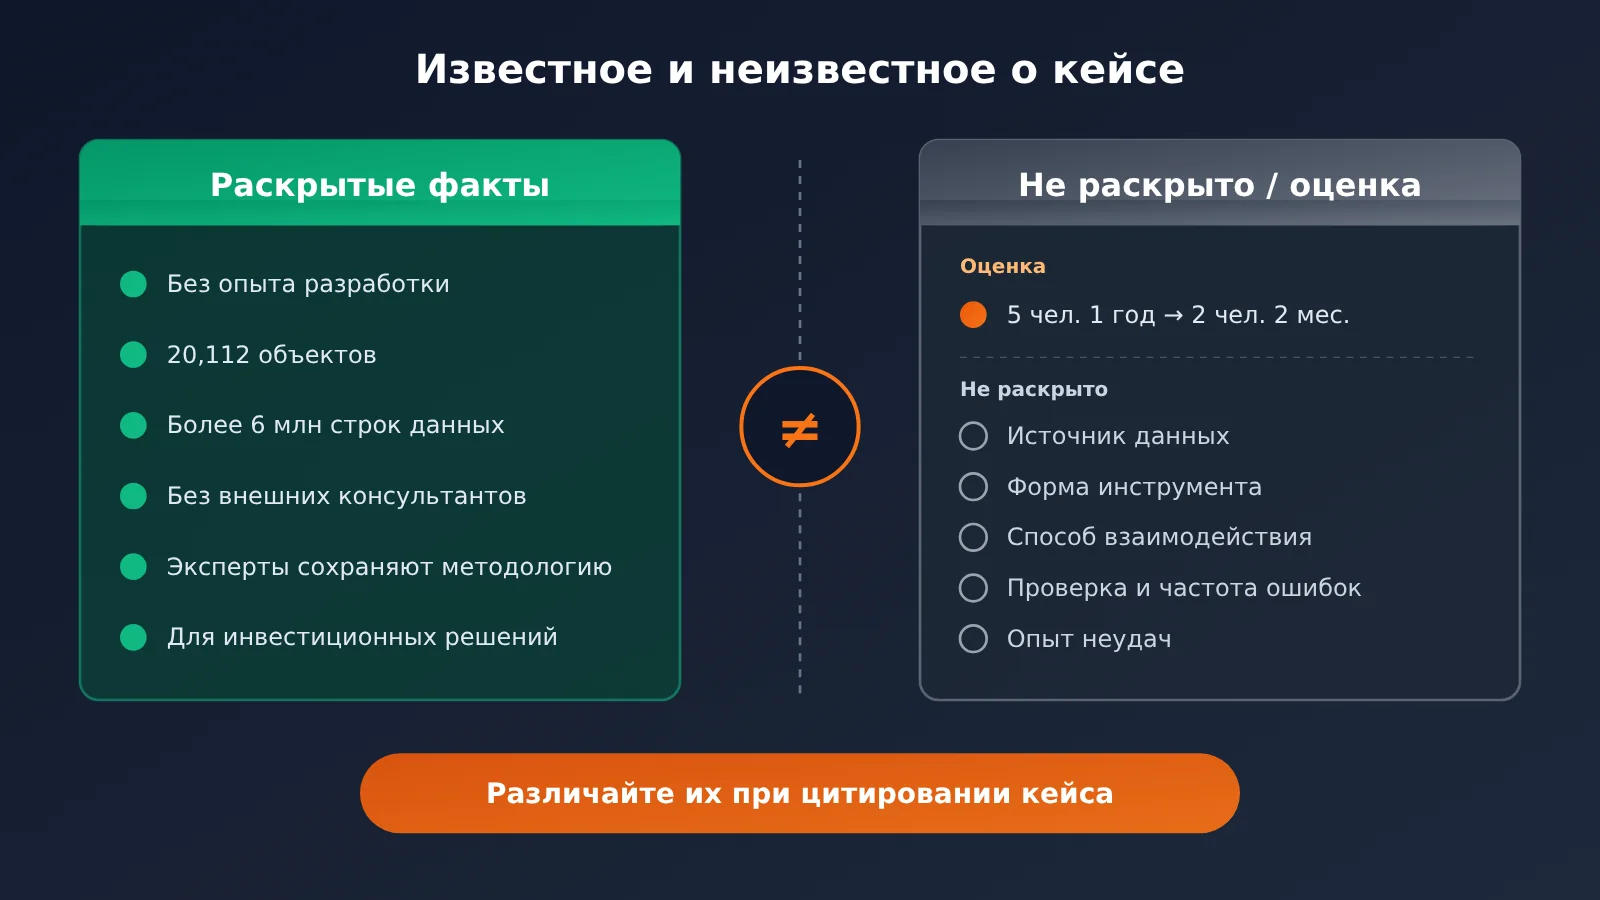
Чтобы не делать выводов сверх того, что сказано в оригинале, разделим раскрытую информацию и то, что осталось за кадром.
| Категория | Содержание |
|---|---|
| Раскрыто | У аналитиков не было опыта разработки ПО; Codex помогал с поиском данных, очисткой и стандартизацией, контролем качества и разработкой процессов; методология и проверка оставались за аналитиками; оценено 20,112 объектов недвижимости, получено более 6 миллионов строк данных; внешние консультанты не потребовались; результаты используются для оценки климатических рисков, подготовки отчётов и принятия инвестиционных решений |
| Оценка | По оценке компании, вместо 5 человек и 1 года для выполнения задачи потребовались 2 человека и 2 месяца |
| Не раскрыто | Конкретные источники данных; способ использования Codex (настольное приложение, CLI или другой); формат взаимодействия и рабочий процесс; конкретные методы проверки и частота ошибок; трудности и неудачи в ходе работы |
Эти пробелы не мешают взять на заметку принцип разделения задач, но означают, что цифры эффективности из кейса нельзя просто перенести на другой проект. На практике на проработку методологии и ручную проверку вполне может уйти больше времени, чем на то, чтобы «поручить агенту написать процесс». Стоит запомнить вывод руководства Heimstaden: ИИ не исправит плохой процесс, но может значительно усилить хороший.
Часто задаваемые вопросы FAQ
В1: Что значит создавать процессы обработки данных с помощью Codex без навыков разработки?
Это значит, что эксперт в своей области без опыта программирования описывает требования программирующему агенту на естественном языке. Агент выполняет техническую работу: получает, очищает и проверяет данные, а также создаёт процесс их обработки. Эксперт отвечает за методологию и проверяет результаты. Проект Heimstaden по оценке экологических рисков — один из публичных примеров такого подхода.
В2: Чем это отличается от обычных вопросов о данных в ChatGPT?
Формат вопросов и ответов обычно подходит для разовых задач, а полученные результаты сложно воспроизвести. Ценность программирующего агента в том, что он создаёт процесс обработки, который можно запускать повторно. После обновления данных его можно запустить заново, а после изменения методологии — скорректировать. Именно это и означает переход «от сложного аналитического проекта к воспроизводимому процессу».
В3: Когда был опубликован этот кейс?
OpenAI опубликовала кейс 3 ноября 2026 года. Он отражает недавнюю практику использования программирующих агентов в компаниях. Конкретные цифры и инструменты со временем могут измениться, но принцип разделения обязанностей — «выполнение поручаем агенту, решения оставляем за экспертом» — останется полезным ориентиром надолго.
В4: Для каких проектов с данными лучше всего подходит такое разделение обязанностей?
— **Объединение открытых данных из разных источников**: например, наборов данных об окружающей среде, климате или населении, собранных разными организациями
— **Периодическая отчётность**: отчёты о соблюдении требований и раскрытии информации, которые нужно готовить каждый квартал или год
— **Массовая оценка на уровне портфеля активов**: задачи, в которых тысячи записей нужно оценить по единым критериям
В5: Как быстро начать, если в процессе обработки нужно вызывать большие языковые модели?
Можно зарегистрироваться в APIYI на apiyi.com и через единый интерфейс вызвать несколько популярных моделей, чтобы сравнить результаты классификации или извлечения данных на небольшой репрезентативной выборке. Убедившись в стабильности результатов и согласованности критериев, можно подключать модели к рабочему процессу. Сравнение нескольких моделей также помогает при ручной проверке.
В6: Насколько тщательно нужно проводить ручную проверку?
В кейсе не раскрываются метод проверки и частота ошибок. Обычно заранее определяют размер выборки и допустимый уровень ошибок, затем по отдельности проверяют все аномалии, отмеченные автоматической проверкой, и выборочно сверяют результаты, признанные нормальными. Кроме того, их сравнивают с известными внешними эталонами. Все записи о проверках следует сохранять для последующего аудита.
В7: Какие ограничения есть у этого подхода?
Во-первых, показатели эффективности основаны на оценках компании и не подтверждены независимой проверкой. Во-вторых, специалистам без опыта разработки всё равно нужно уметь чётко описывать методологию, иначе агент лишь усилит путаницу. В-третьих, в кейсе не рассказывается о трудностях и неудачах. На практике процесс может работать с ошибками, причину которых сложно понять, поэтому при необходимости всё равно придётся обращаться за помощью к техническим специалистам.
В8: Почему так важно самому разбираться в методологии?
Методология остаётся в руках команды. Когда данные обновятся, требования регулятора изменятся или инвесторы зададут дополнительные вопросы, специалисты смогут сами внести изменения и объяснить их — без повторного обращения к консультантам. Именно об этой долгосрочной самостоятельности говорит Julia: «Теперь эта методология принадлежит нам, и мы можем продолжать развивать её самостоятельно».
Ключевые выводы: обработка данных с Codex для неразработчиков
- Разделение обязанностей: поиск и очистку данных, контроль качества и выполнение процессов поручайте агентам, а методологию и проверку оставляйте экспертам
- Сначала методология: сначала подробно опишите систему оценки, затем поручите агенту действовать по этому документу
- Независимая проверка: автоматические проверки, ручная выборочная проверка и сравнение с внешними бенчмарками — обязательны все три
- Воспроизводимость — ключевой фактор: активом становится процесс, который можно запустить повторно; разовый результат не позволяет двигаться дальше
- Осторожнее с цифрами: сокращение работы с года для 5 человек до 2 месяцев для 2 человек — приблизительная оценка, которую не стоит напрямую применять к другим проектам
- Сравнение моделей помогает проверке: на этапах, где требуется вызов большой языковой модели, можно использовать единый интерфейс APIYI для перекрёстной проверки с помощью нескольких моделей
Итоги
Когда специалисты без опыта разработки создают процессы обработки данных с помощью Codex, главное, чему стоит у них поучиться, — не показатели эффективности, а чёткое распределение обязанностей:
- Агент отвечает за выполнение: ему можно доверить поиск данных, очистку и стандартизацию, проверку качества и создание воспроизводимых процессов
- Эксперт отвечает за решения: разработка методологии и проверка результатов — основа достоверных и объяснимых выводов
- Развитие компетенций: собственная методология и возможность повторно запускать процесс превращают разовый проект в инструмент, который организация может постоянно совершенствовать
Если у вас есть проект, в котором «данные разбросаны, а технических ресурсов не дождаться», попробуйте сначала описать методологию и запустить небольшой пилот. На этапах, где нужен вызов большой языковой модели, можно через APIYI apiyi.com сравнить результаты нескольких моделей с помощью единого интерфейса — это даст дополнительную опору для проверки человеком.
📚 Источники
- Клиентская история OpenAI — Heimstaden: как Heimstaden использует ChatGPT и Codex для преобразования управления жилой недвижимостью
- Ссылка:
openai.com/index/heimstaden/ - Описание: единственный источник фактов для этого кейса, включая распределение обязанностей и оценочные данные проекта по оценке экологических рисков
Автор: техническая команда APIYI
Обсуждение технических вопросов: свяжитесь с нами на главной странице сайта APIYI. Дополнительные материалы по подключению моделей доступны в центре документации docs.apiyi.com