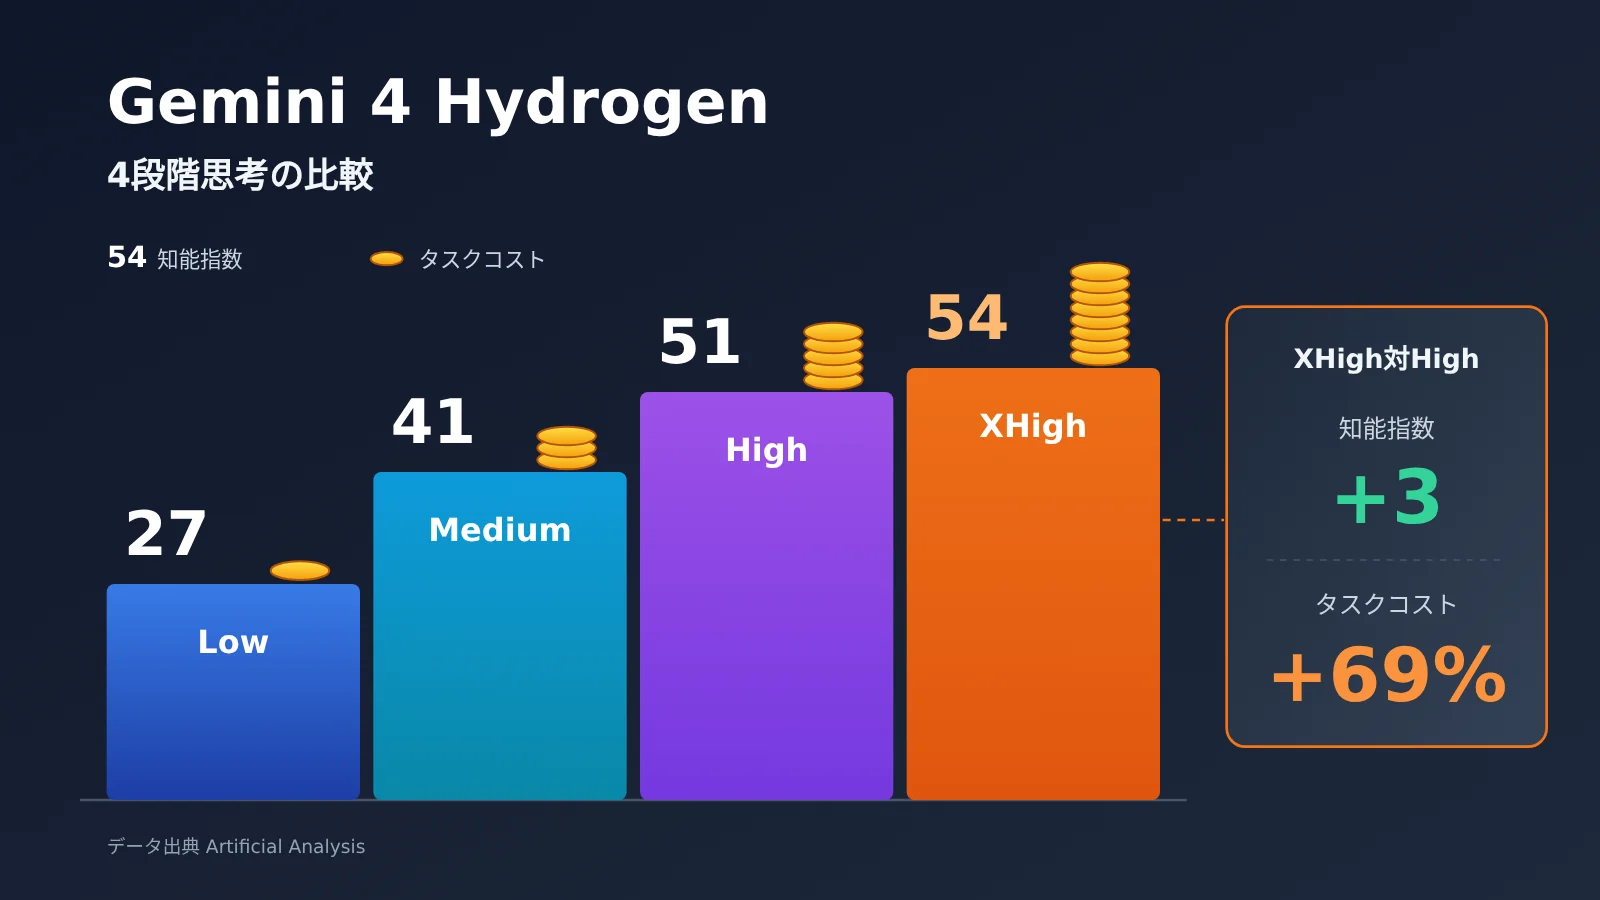
一言まとめ:Artificial Analysis の4段階評価によると、Gemini 4 Hydrogen は High から XHigh に上げても知能指数はわずか3ポイントしか増えず、評価タスクのコストは約69%増加します。そのため、タスクの難易度に応じて思考レベルを設定する方が適しています。
Google は2026年11月12日に Gemini 4 Hydrogen を正式リリースし、同時に Low、Medium、High、XHigh の4段階の思考レベルを提供しました。4つのレベルは同じモデル ID と同じトークン単価を使用しますが、第三者評価におけるスコア、コスト、待ち時間には大きな差があります。
これは「レベルが高いほどよい」という推奨ではありません。本記事では Artificial Analysis の標準化された評価データを用いて各レベルの限界便益(追加の効果)を計算し、タスク種別ごとに明確なレベル推奨を示します。
本記事の価値:本記事を読み終えると、自社の業務でどのレベルを使うべきか、また thinking_level パラメータで思考コストをどう制御するかを判断できるようになります。
Gemini 4 Hydrogen の4段階思考を比較する前に知っておきたい用語
- thinking_level:モデルの推論深度を制御する思考レベルパラメータです。Hydrogen は Low、Medium、High、XHigh の4つの値をサポートしています。
- 思考トークン:モデルが最終回答を出す前に推論に使うトークンです。Google 公式の料金ページによると、この部分は出力料金として計算されます。
- トークン:モデルがテキストや画像などの情報を処理する際の計量単位で、API では100万トークン単位で課金されます。
- Harness:モデルへの入力を構成し、ツール呼び出しを実行し、タスクを採点するテストフレームワークです。異なる Harness で測定されたスコアは直接比較できません。
- API:プログラムからサービスを呼び出すためのインターフェースです。本文のコード例では OpenAI 互換形式を使用しています。
同じ Gemini 4 Hydrogen なのに、なぜ4段階でここまで差が出るのか?
Gemini 4 Hydrogen は Google DeepMind が発表した高効率モデルで、主に日常的なプログラミングや AI エージェントのタスク実行に使われます。API モデル ID は gemini-4-hydrogen です。4段階の思考は4つのモデルではなく、同じモデルの4つの推論深度です。Google Cloud のドキュメントでは、各段階に推奨タスクが記載されています:
| 思考レベル | 公式の推奨用途 | 推論深度 | デフォルトか |
|---|---|---|---|
| Low | 分類などの単純なタスク | 浅い | いいえ |
| Medium | 一般的なプログラミング | 中程度 | いいえ(3.8 Flash のデフォルト) |
| High | 多段階エージェント | 深い | ✅ Hydrogen のデフォルト |
| XHigh | 複雑で深い推論 | 最も深い | いいえ |
Hydrogen の4段階思考は単価が同じなのに、請求額が変わる理由
2026年11月13日時点で、Google 公式の Standard 呼び出し価格は入力 $1.50 / 100万トークン、出力 $7.50 / 100万トークンで、4段階の間に違いはありません。差はトークン使用量から生まれます。段階が高いほど、モデルが回答前に生成する思考トークンが増え、これらのトークンは出力価格で課金されます。
ですから「単価が同じ」は「1タスクあたりのコストが同じ」という意味ではありません。同じ質問でも XHigh では High の数倍の思考内容が生成される可能性があり、請求額もそれに伴って増えます。コストを見積もるときは、最終回答の長さだけではなく、目に見えない思考部分も計算に入れる必要があります。
Gemini 4 Hydrogen 4段階の実測データ:スコア、コスト、速度の比較
以下のデータは第三者機関 Artificial Analysis によるもので、公開当日に評価を完了しています。インテリジェンス指数、評価タスクのコスト、平均所要時間は同機関の Intelligence Index v5.0.1 に基づきます。最初の回答トークンまでの遅延と出力トークン総数は、2026年11月13日時点のページスナップショットによるものです。以下はすべて第三者機関による標準化評価の結果であり、当サイトでの実測ではありません。
| 思考レベル | インテリジェンス指数 | タスクあたり平均コスト | タスクあたり平均所要時間 | 最初の回答トークンまでの遅延 | 評価全体の出力トークン数 |
|---|---|---|---|---|---|
| Low | 27 | $0.29 | 1.3分 | 約5.7秒 | 2,030万 |
| Medium | 41 | $0.80 | 3.7分 | 約11.8秒 | 5,440万 |
| High(デフォルト) | 51 | $1.87 | 8.3分 | 約18.9秒 | 1.10億 |
| XHigh | 54 | $3.16 | 13.5分 | 約37.8秒 | 3.04億 |
3つの指標は混同しないでください
この表には意味の異なる3種類の指標があります。
- インテリジェンス指数:複数のベンチマークを総合した能力スコアで、この評価セット内での相対的な水準を示すだけです。
- タスクあたり平均所要時間:タスクの出力トークン数とエンドツーエンドの出力速度から計算される加重指標で、標準化された評価ワークロードを表します。ユーザーが簡単な質問をする場合、必ずしも8.3分待つわけではありません。
- 最初の回答トークンまでの遅延:リクエスト送信から最初の回答トークンが表示されるまでの待ち時間で、推論モデルの思考フェーズを含みます。対話シナリオでユーザーが最も体感しやすい指標です。
表からわかるように、Medium から High へのスコア差(10ポイント)は、High から XHigh への差よりもはるかに大きくなっています。同じモデル名でも、レベルが異なると実際の能力差は20ポイントを超えることがあります。Hydrogen と他のモデルを比較する際は、比較相手がどのレベルを使用しているかを必ず確認してください。
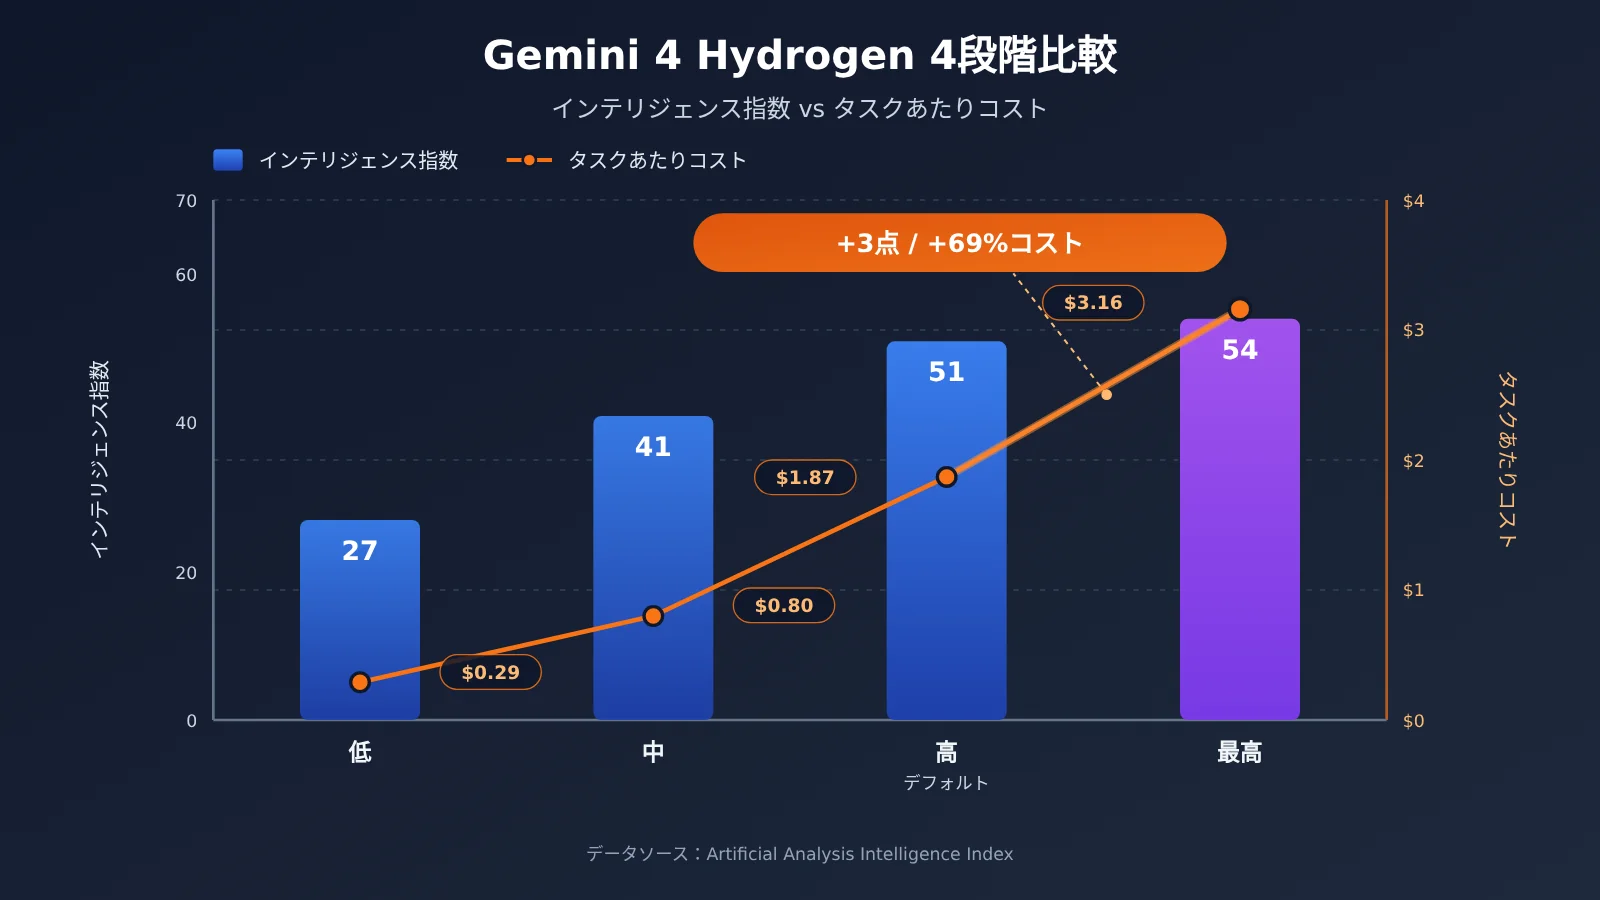
Gemini 4 Hydrogen XHigh は High より69%高コスト、いったい何を買っているのか?
4段階のデータを2つずつ比較すれば、各段階アップグレードの利益とコストが得られます。以下の表の増分比率は、編集部がArtificial Analysisの公表データに基づいて計算したものです。
| アップグレード経路 | 知能指数の変化 | タスクコストの変化 | 平均所要時間の変化 | 1ポイント追加あたりの追加コスト |
|---|---|---|---|---|
| Low → Medium | +14点 | +176% | +185% | 約 $0.036 |
| Medium → High | +10点 | +134% | +124% | 約 $0.107 |
| High → XHigh | +3点 | +69% | +63% | 約 $0.43 |
収益逓減:Hydrogen 4段階思考の限界コスト
HighからXHighに上げると、知能指数は51から54に向上し、約5.9%の改善です。タスクあたりのコストは$1.87から$3.16に上昇し、所要時間は8.3分から13.5分に増加し、最初の回答までの遅延は約18.9秒から約37.8秒へ倍増しました。「1ポイント追加あたり」で計算すると、XHighの限界コストはLow → Mediumの約12倍です。
主な原因はトークン使用量です。Highのフル評価セットの出力は約1.10億トークン、XHighは約3.04億トークンで、前者の約2.76倍です。ただし請求額は2.76倍にはなっていません。総費用には入力トークン、キャッシュヒットの状況、評価タスクの重み付け方法も含まれるため、出力トークンの倍数から直接費用を推算することはできません。
平均スコアが低いからといって、複雑なタスクでの収益も低いとは限らない
知能指数は複数のタスクの平均結果であり、3点の差は2つの状況から生じる可能性があります。ほとんどのタスクで2段階のパフォーマンスが同じで、少数の高難度タスクでXHighが明らかに優れているというケースです。科学推論、数学的証明、ファイルをまたぐ大規模リファクタリングのような「一歩間違えれば全滅」のタスクでは、XHighの余分な思考がタスク成否を左右するかもしれません。
したがって、より正確な言い方はこうです:XHighは通常タスクではコストパフォーマンスが非常に低く、少数の高難度タスクでは必要になる可能性がある。 69%余分に支払う価値があるかどうかは、自分のタスクサンプルで検証すべきであり、平均スコアだけで判断してはいけません。
🎯 技術的な提案:まず20〜50個の実際のタスクサンプルを選び、HighとXHighのそれぞれで実行して、成功率とタスクあたりのコストを比較することをお勧めします。APIYI apiyi.com経由で同じAPIキーを使ってパラメータを切り替えれば、ビジネスコードの構造を変更せずにA/Bテストを完了できます。
Gemini 4 Hydrogen の4段階思考レベルは、それぞれどのタスクに適しているか?
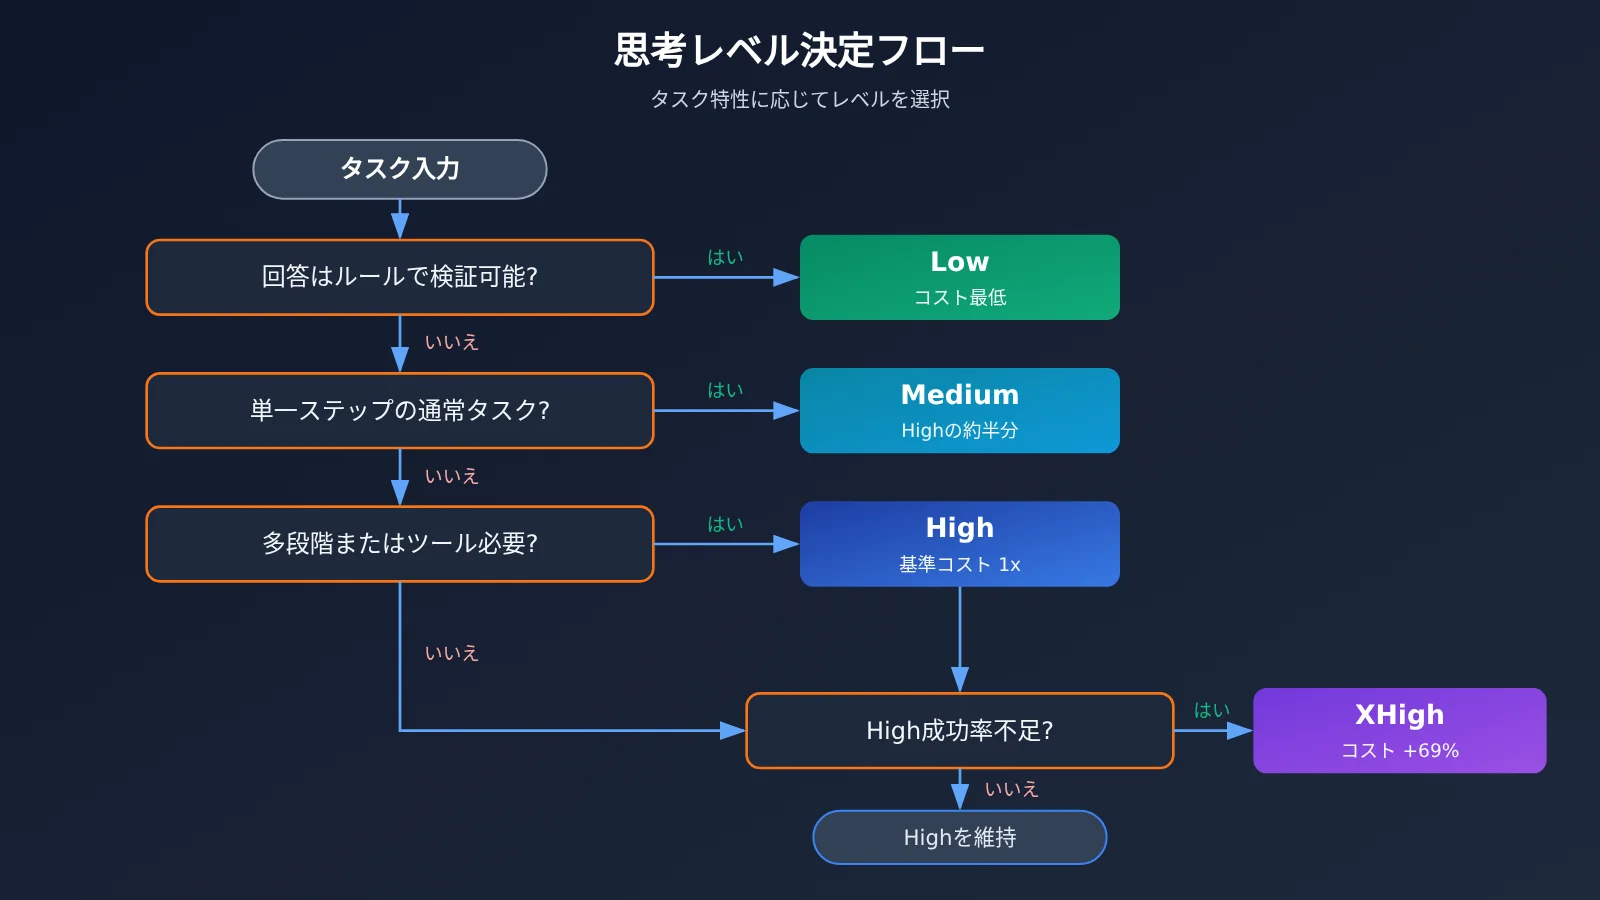
Google の公式推奨と上記のコストデータを組み合わせると、タスクの難易度に応じて次のような提案ができます。
| タスクの種類 | 推奨レベル | 代表例 | 選ぶ理由 |
|---|---|---|---|
| 分類・抽出・書式整理 | Low | チケット分類、フィールド抽出、JSON フォーマット、簡単なQ&A | コストが最も低く、最初のトークンまでの遅延は約5.7秒で、高並列処理に向いています |
| 通常のコード・コンテンツ処理 | Medium | 単一ファイルでの関数作成、文章のリライト、ドキュメント要約、一般的な業務自動化 | Low より14ポイント高く、コストは依然として High の半分未満です |
| 多段階エージェントとツール呼び出し | High | 複数ファイルにまたがるバグ修正、連続したツール呼び出し、検索後の総合分析 | 公式のデフォルトレベルで、能力とコストのバランスが取れています |
| 高い複雑度の推論 | XHigh | 科学推論、数学的証明、大規模ソフトウェアエンジニアリングのリファクタリング | High の成功率が明らかに不足する場合にのみ使用します |
Hydrogen の低いレベル帯が適する場面
Low と Medium は、タスクの目的が明確で、答えを検証しやすい場面に向いています。たとえば契約書から金額や日付を抽出する、ユーザーフィードバックを10個のカテゴリに分類する、といったタスクでは、考える時間を増やしても精度はほとんど上がらず、遅延とコストだけが増えます。リアルタイムチャットや検索サジェストのように、最初のトークンまでの遅延に敏感な場面では、Low の約5.7秒は XHigh の約37.8秒よりも明らかに優れています。
Hydrogen の高いレベル帯が適する場面
High は Google が設定したデフォルトレベルで、ほとんどのエージェントワークフローに適しています。「High で繰り返し失敗し、リトライコストがレベルを上げるコストを上回る」ような場合にのみ、XHigh へのアップグレードが必要です。注意すべき点として、Google の公式モデルカードでも、高い思考レベルでは所要時間とコストが大幅に増える可能性があり、まれに遅延やタイムアウトが発生すると述べられています。長い処理チェーンを持つタスクでは、タイムアウトとリトライ戦略を適切に設定してください。
開発者が Gemini 4 Hydrogen の思考コストを制御する方法
thinking_level パラメータとデフォルト値
Hydrogen では thinking_level パラメータで思考レベルを選択します。指定しない場合のデフォルトは High です。Gemini 3.8 Flash から移行する際には、次の点に注意してください。
- 3.8 Flash のデフォルトは Medium でした。移行後にパラメータを指定しないと自動的に High になり、請求額が増える可能性があります。
thinking_budgetとMINIMALはサポートされなくなりました。使用すると HTTP 400 が返されます。- 独自に設定した temperature、top_p、top_k は無視されます。
- マルチターンのツール呼び出しでは、thought signatures を正しく保存して返送する必要があります。
最小限の例:ティア別に Hydrogen を呼び出す
以下では OpenAI 互換形式で呼び出し、extra_body 経由で思考ティアを渡します。プラットフォームによってこのパラメータの透過フィールドは異なる場合があるため、具体的なフィールド名は各プラットフォームのドキュメントを参照してください。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "把这条反馈分类:退款太慢"}],
    extra_body={"thinking_level": "low"}  # 単純な分類には Low を使う
)
print(resp.choices[0].message.content)
完全な実装コードを見る:タスク難易度でティアを分け、自動で昇格させる
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# タスク種別とデフォルトティアのマッピング
LEVEL_MAP = {
    "classify": "low",
    "extract": "low",
    "content": "medium",
    "code": "medium",
    "agent": "high",
    "reasoning": "xhigh",
}
ESCALATE = {"low": "medium", "medium": "high", "high": "xhigh"}


def call_hydrogen(prompt: str, level: str) -> tuple[str, dict]:
    resp = client.chat.completions.create(
        model="gemini-4-hydrogen",
        messages=[{"role": "user", "content": prompt}],
        extra_body={"thinking_level": level},
    )
    usage = resp.usage.model_dump() if resp.usage else {}
    return resp.choices[0].message.content, usage


def run_task(prompt: str, task_type: str, validator=None,
             max_level: Optional[str] = "high") -> str:
    """まず低いティアで実行し、検証に失敗したら段階的にティアを上げます。max_level は上限ティアを指定します"""
    level = LEVEL_MAP.get(task_type, "medium")
    while True:
        answer, usage = call_hydrogen(prompt, level)
        print(f"[{level}] usage={usage}")  # Token を記録し、成功したタスクのコスト計算に使う
        if validator is None or validator(answer):
            return answer
        if level == max_level or level not in ESCALATE:
            return answer
        level = ESCALATE[level]


result = run_task(
    prompt="提取订单号,只返回数字:订单 A-20261113-889 已发货",
    task_type="extract",
    validator=lambda s: s.strip().replace("-", "").isalnum(),
)
print(result)
🚀 クイックスタート: APIYI apiyi.com は OpenAI 互換インターフェースを提供しており、1 つの API キーで Gemini、Claude、OpenAI などの主要モデルを呼び出せます。新規ユーザーには無料のテスト枠が用意されており、まず上記のティア戦略を動作確認してから本番導入するのに適しています。
段階的戦略:まず低档位、失敗したら昇格
推奨される方法は「デフォルトは低档位、必要に応じて昇格」です。シンプルなタスクは Low または Medium を固定で使い、複雑なタスクは High からスタートし、検証に失敗したときだけ XHigh に上げます。さらにタスク種別ごとに最高档位の上限を設定して、予期しないコストの急増を防ぎます。これは Google が Antigravity Orchestrator で異なるモデルに役割を分担させる考え方と同じですが、ここでは同じモデルの思考深度を調整している点が異なります。
4つの指標で Hydrogen の档位最適化効果を測る
| 最適化指標 | 計算方法 | 注目する理由 |
|---|---|---|
| 精度 / 成功率 | 検証に合格したタスク数 ÷ 総タスク数 | 档位を下げても品質が大きく低下しないこと |
| エンドツーエンド時間 | リクエストから使える結果を得るまでの総時間(リトライを含む) | 最初のトークン遅延はその一部に過ぎない |
| Token 使用量 | 入力 + 出力(思考を含む)Token | 思考 Token は出力料金で課金される |
| 成功タスクのコスト | 総費用 ÷ 成功タスク数 | 低档位で頻繁に失敗・リトライすると、高档位より高くつく可能性がある |
「成功タスクのコスト」が実際の支出を最もよく反映します。Medium で 30% のタスクが再実行を必要とし、High なら一度で成功する場合、High の成功タスクあたりのコストの方がかえって低くなる可能性があります。
よくある質問 FAQ
Q1:Gemini 4 Hydrogen の4段階の思考レベルは、4つのモデルですか?
いいえ。4段階は同じモデル `gemini-4-hydrogen` における推論の深さの違いで、thinking_level パラメータで切り替えます。Token の単価は同じで、違いは生成される思考 Token の数にあります。
Q2:XHigh は High よりわずか3点高いだけなら、使う必要はまったくないのでしょうか?
そう単純には考えられません。3点は複数タスクにおける平均の差であり、科学的推論、数学的証明、大規模なエンジニアリングタスクでは、XHigh がタスクの成否を左右することもあります。一般的なタスクでは XHigh のコストパフォーマンスは低めですが、少数の高難度タスクでは必要不可欠な場合があります。
Q3:High の平均所要時間が 8.3 分ということは、毎回の質問でそれだけ待つ必要があるのですか?
いいえ。8.3 分は Artificial Analysis の標準化された評価タスクにおける加重平均の所要時間です。通常の会話では、むしろ最初の回答 Token までの遅延を参考にすべきで、High は約 18.9 秒、Low は約 5.7 秒です。実際の時間はタスクの長さにも依存します。
Q4:thinking_level を渡さないとどうなりますか?
デフォルトでは High が使用されます。Gemini 3.8 Flash(デフォルトは Medium)から移行したプロジェクトで、旧コードのままパラメータを渡さない場合、思考レベルが自動的に上がり、コストも増加する可能性があります。明示的にレベルを設定することをおすすめします。
Q5:各レベルを自社の業務で素早く比較するにはどうすればよいですか?
実際のタスクのサンプルを一批用意し、それぞれ異なるレベルで実行して成功率と Token 使用量を集計するのがおすすめです:
1. APIYI apiyi.com に登録し、APIキーと無料テスト枠を取得する
2. 本記事のコードを使い、`thinking_level` の値を変更する
3. 「成功タスクあたりのコスト」で最適なレベルを選ぶ
Q6:Hydrogen の高い思考レベルには、どのような既知の問題がありますか?
Google のモデルカードでは、思考レベルが高いと所要時間とコストが明らかに増加し、まれに遅延やタイムアウトが発生すると言及されています。また、Hacker News では一部の Agent タスクで過剰な実行が起きるとのユーザー報告もあります。長時間のタスクには、タイムアウト、最大レベル、停止条件を設定することをおすすめします。
Q7:Token からコストを估算する際、最もよくある誤解は何ですか?
最終回答の文字数だけで估算することです。思考 Token は出力価格に含まれ、XHigh の一式の評価における出力 Token は High の約 2.76 倍になります。APIYI apiyi.com のコンソールで実際の使用量の内訳を確認する方が、手動の估算より信頼できます。
Gemini 4 Hydrogen 4段階思考の主なポイント
- 同一モデル・異なる段階:4段階の単価は同じで、実際のタスクコストは思考トークンの使用量によって決まります。
- 改善幅の逓減が顕著:High → XHigh は3ポイントの追加に対して、評価タスクのコストが約69%増加します。
- レイテンシが倍増:XHigh では最初の回答までのレイテンシが約37.8秒で、High の2倍です。
- デフォルトは High:3.8 Flash から移行する際は、段階を明示的に設定する必要があります。
- 難易度に応じて段階を選ぶ:分類には Low、通常は Medium、Agent には High、難しい問題にだけ XHigh を使います。
- 成功タスクのコストを見る:リトライも含めて計上することで、異なる段階の真のコストを比較できます。
- サンプルで検証する:APIYI apiyi.com の1つのキーで、4段階の効果を比較できます。
まとめ
Gemini 4 Hydrogen の4段階思考を比較した核心的な結論は次のとおりです。
- 能力差が大きい:Low の27ポイントから XHigh の54ポイントまで、同じモデル名でも能力が2倍異なります。
- 限界コストが逓増する:1ポイント追加あたりのコストは、Low → Medium の約 $0.036 から High → XHigh の約 $0.43 へと上昇します。
- XHigh は必要に応じて使う:平均スコアの差は小さいものの、少数の高難度タスクでは依然として鍵を握る可能性があります。
日常業務でのアドバイスは、thinking_level を明示的に設定し、簡単なタスクには低い段階を、複雑なステップにはより高い段階を使い、最終的な評価基準として成功タスクのコストを用いることです。
実際のタスクサンプルを使って APIYI apiyi.com で各段階の効果をすばやく検証することをお勧めします。プラットフォームは OpenAI 互換インターフェースと無料のテストクレジットを提供しています。
📚 参考資料
- Artificial Analysis – Gemini 4 Hydrogen 4段階評価ページ:インテリジェンス指数、タスクコスト、所要時間とレイテンシのデータ
- リンク:
artificialanalysis.ai/models/gemini-4-hydrogen-low - リンク:
artificialanalysis.ai/models/gemini-4-hydrogen-medium - リンク:
artificialanalysis.ai/models/gemini-4-hydrogen-high - リンク:
artificialanalysis.ai/models/gemini-4-hydrogen -
説明:本記事における4段階比較データすべての出典。レイテンシは動的指標です
-
Google 公式ブログ – Introducing Gemini 4 Hydrogen:公開のお知らせ
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
説明:モデルの位置づけ、能力範囲、パートナー企業の事例
-
Google Cloud 開発者ガイド – Gemini 4 Hydrogen:thinking_level と移行時の注意事項
- リンク:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
説明:4段階それぞれの推奨用途、デフォルト段階、互換性のないパラメータ
-
Google AI Studio 料金ページ:Hydrogen 公式 API の価格
- リンク:
aistudio.google.com/docs/pricing -
説明:Standard、Batch、Flex、Priority 各モードの価格、思考 Token の課金ルール
-
Google DeepMind モデルカード:限界と安全性評価
- リンク:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - 説明:高思考レベルにおける所要時間リスク、拒否応答やハルシネーションなどの既知の問題
著者:APIYI 技術チーム
技術交流:APIYI 公式サイトのトップページからお気軽にお問い合わせください。Gemini シリーズモデルの接続資料をさらに入手できます