要約:Google Decisions API は固定の選択肢に対して直接スコアを付け、テキストを生成しません。本記事では公開価格を用いて、分類・モデレーション・ルーティング業務におけるコストを試算し、公式データと第三者データを組み合わせて適用範囲を説明します。
結論から先に:Google は 2026年11月11日に Gemini Decisions API(モデル ID gemini-decision-1)を発表しました。1回のリクエストで、同じ入力に対して1~1,000個の独立した判定を実行できます。入力価格は100万Tokenあたり0.10ドルで、生成出力Tokenの課金はありません。公開価格に基づく試算では、同じ10K Tokenの文書で1,000件のルールをチェックする場合、費用はGemini 3.5 Flash-Liteの約1/20となり、理論上94.9%の節約になります。1,000件のメッセージをそれぞれ1回分類する場合、理論上の節約率は73.1%です。Googleの公式テストで示されたコスト優位性は約4.7倍です。第三者が単一タスクで実測したところ、この優位性は約1.5倍でした。分類、モデレーション、ルーティングのみを行い、答えをあらかじめ固定の選択肢に限定できるタスクは、コスト削減に最も適しています。
以降の本文では、まずこのAPIの動作原理と3種類の判定タイプを説明し、次に再計算できる計算式で3つの代表的な業務の費用を試算します。さらに、公式の「約5倍」と第三者実測の差を説明します。その後、Googleが公開した速度データとArtificial Analysisの独立評価を照らし合わせ、精度が本番環境の要件を満たすかどうかを検討します。最後に、最小限の呼び出し例、選定表、本番導入前のコストチェックリストを示します。
To Know:用語の予備知識
| 用語 | 説明 |
|---|---|
| Decisions API | Google が提供する判定インターフェース。固定された選択肢に対して、結果と確率を直接返します |
| Gemini Decision 1 | このインターフェースを支える専用モデル。モデル ID は gemini-decision-1 |
| Token | モデルの処理と課金の基本単位。テキストや画像などもすべて Token に換算されます |
| Shared Input | 1 回のリクエスト内で、すべての判定が共有する入力内容 |
| Closed-set Decision | 答えの範囲があらかじめ限定された判定。たとえば「はい/いいえ」や「A/B/C から 1 つ」 |
| noul | 二値判定。返すのは「Yes」の確率 |
| choice | あらかじめ用意された 2〜255 個の選択肢から 1 つを選ぶ |
| score | 定義済みの順序尺度で評価し、結果は重み付き期待値 |
| Confidence | 選んだ結果が正しいとモデルが見積もった確率 |
| Single Forward Pass | モデルが 1 回の計算で各選択肢のスコアを出し、1 トークンずつ生成する必要がない方式 |
| Context Window | 1 回のリクエストに収められる内容の総量。本モデルでは 262,144 Token |
| TPM / RPM | 1 分あたりに処理できる Token 数/リクエスト数。スループットの上限 |
1 Google が発表したもの:判定問題に特化した Gemini Decisions API
1.1 Gemini Decision 1 と従来の生成モデルの違い
Gemini Decisions API は 2026 年 11 月 11 日に Gemini Developer API v1beta を通じて公開されました。REST エンドポイントは POST https://generativelanguage.googleapis.com/v1beta/decisions です。中核となる機能は、あらかじめ定義した選択肢に対する確率判定で、判定結果、各選択肢の確率、信頼度、Token 使用量を返します。入力はテキスト、画像、音声、動画、PDF に対応しています。
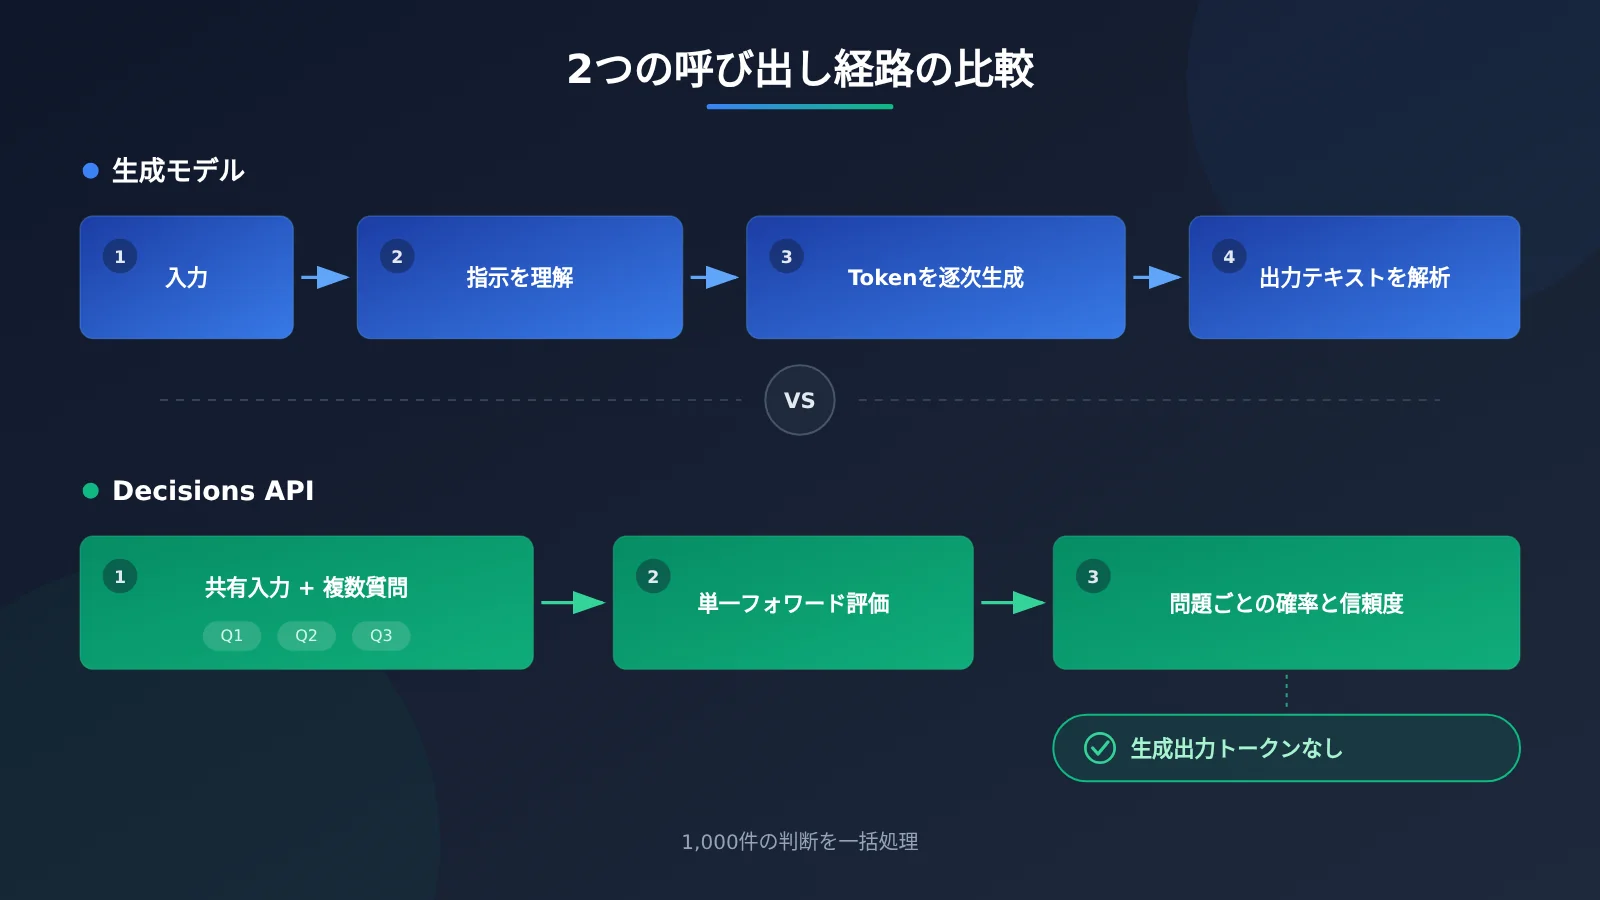
従来の生成モデルで分類タスクを処理する流れは、内容を読み込み、指示を理解し、1 トークンずつ回答を生成して、開発者がその回答を解析する、というものでした。Decisions API はこの流れを、共有コンテンツを読み込んだうえで、各質問の所定の選択肢を直接スコアリングする形に変えます。分類やモデレーション、ルーティングといったタスクに必要なのはラベル 1 つ、あるいは「はい/いいえ」だけです。長い回答を生成すると出力課金が発生し、レスポンスも遅くなります。このステップを省くことが、コストとレイテンシの削減につながる理由です。
1.2 Decisions API の 3 つの判定方式がカバーするタスク
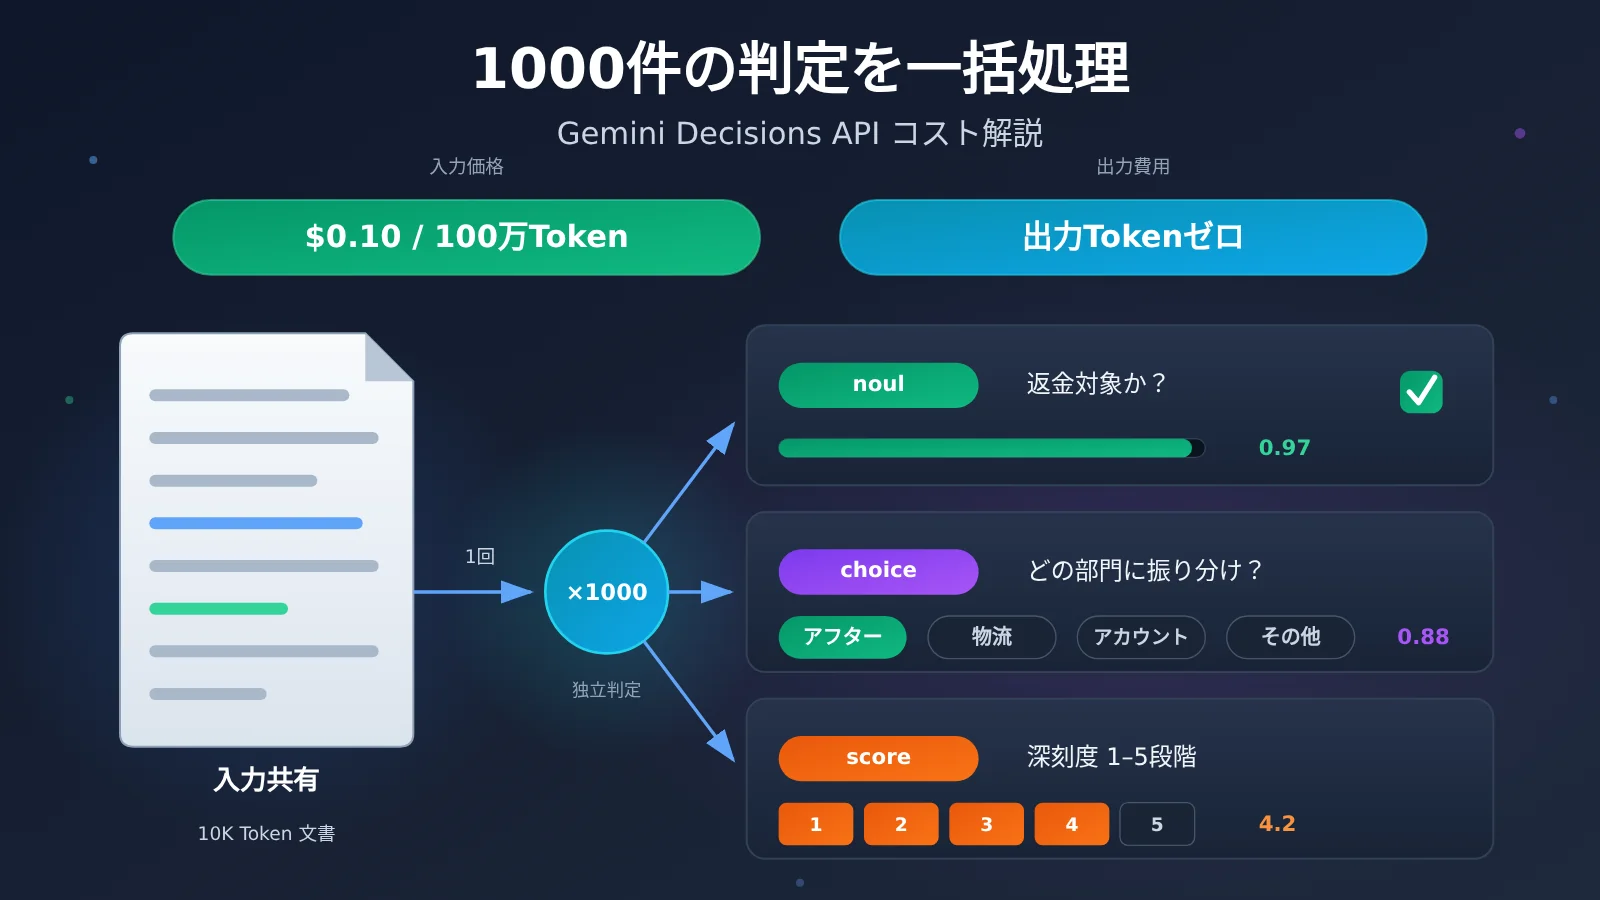
あるカスタマーサポートのメッセージを例に考えてみましょう。「先週買ったイヤホンの左側から音が出ない。返金を申請してから 3 日経つのに誰も対応してくれない。これ以上放置されたらプラットフォームに苦情を出す」。この 1 件のメッセージに対して、同じリクエストの中で互いに独立した 3 つの質問を同時に投げられます。
| 判定タイプ | 質問の例 | 返却内容 | 典型的なタスク |
|---|---|---|---|
| noul | このメッセージは返金に関わるか? | 「Yes」の確率、たとえば 0.97 | 違反かどうか、価格に言及しているか、上位審査に回すべきか |
| choice | どの部門に回すべきか:アフターサービス/物流/アカウント/その他? | 「アフターサービス」を選択し、各選択肢の確率も返す | チケットの振り分け、記事の分類、Agent のツール選択 |
| score | 苦情の深刻度は 1〜5 段階で何点か? | 各レベルの確率から計算した重み付き期待値、たとえば 4.2 | 関連性、深刻度、リードの優先度スコアリング |
choice は 2〜255 個の選択肢、score は 2〜255 個のレベルに対応します。score が返すのは各レベルの確率から計算された期待値なので、評価文からスコアを抽出する手間なく、そのままランキングや閾値の設定に使えます。
2 Google Decisions API のコストはどれだけ削減できるか:3つの業務シナリオで試算
2.1 共有入力を活用するとトークン消費を抑えられる理由
Decisions API の課金体系には、次の3つの特徴があります。共有入力は1回のリクエストで1度だけ課金されること、各質問自体の指示は入力トークンとして課金されること、そして判定結果は生成出力の費用を発生させないことです。比較対象となる Gemini 3.5 Flash-Lite の公式標準価格は、入力100万トークンあたり0.30ドル、出力100万トークンあたり2.50ドルです(2026年11月13日時点の公式価格)。
ここで、S を1つの共有入力のトークン数、Q をその入力に対する独立した質問の数、Tq を各質問の平均トークン数、To を生成モデルの各質問あたりの平均出力トークン数、N を入力の本数とします。「2つのインターフェースで課金対象となる入力トークンが同じ」という単純化した仮定の下では、コストは次のように計算できます。
Decisions API コスト  C_D = N × (S + Q×Tq) × 0.10 / 1,000,000
Flash-Lite コスト     C_F = N × [ (S + Q×Tq) × 0.30 + Q×To × 2.50 ] / 1,000,000
節約率                = (1 − C_D / C_F) × 100%
これは仕組みを理解するための計算モデルであり、Google が固定の節約率を示しているわけではありません。2つのインターフェースにはそれぞれ独自の指示エンコードやフォーマットのオーバーヘッドがあるため、実際の費用はそれぞれが返す課金トークンに基づいて決まります。
2.2 1 回の判断から 1,000 回の判断へ、費用はどう変わるか
下の表は公開価格に基づいて試算した理論上の例で、実際の負荷テストは行っていません。シナリオ①の 1,000 回の判断はすべて同一の文書を対象にしており、1 つの入力に対して 1,000 個の独立した質問を投げる形です。これは「1,000 件の文書をそれぞれ 1 回分析する」とはまったく異なる負荷です。
| 業務シナリオ | 主な前提 | Decisions API | Flash-Lite | 理論上の削減率 |
|---|---|---|---|---|
| ① 1 つの文書で 1,000 条のルールをチェック | 文書 10K Token、各ルール 20 Token、Flash-Lite は 1 件あたり出力 20 Token、両方とも 1 回のリクエストに統合 | $0.003 | $0.059 | 94.9% |
| ② 1,000 件のメッセージをそれぞれ 1 回分類 | 各 300 Token、判断指示 50 Token、Flash-Lite の出力 10 Token | $0.035 | $0.130 | 73.1% |
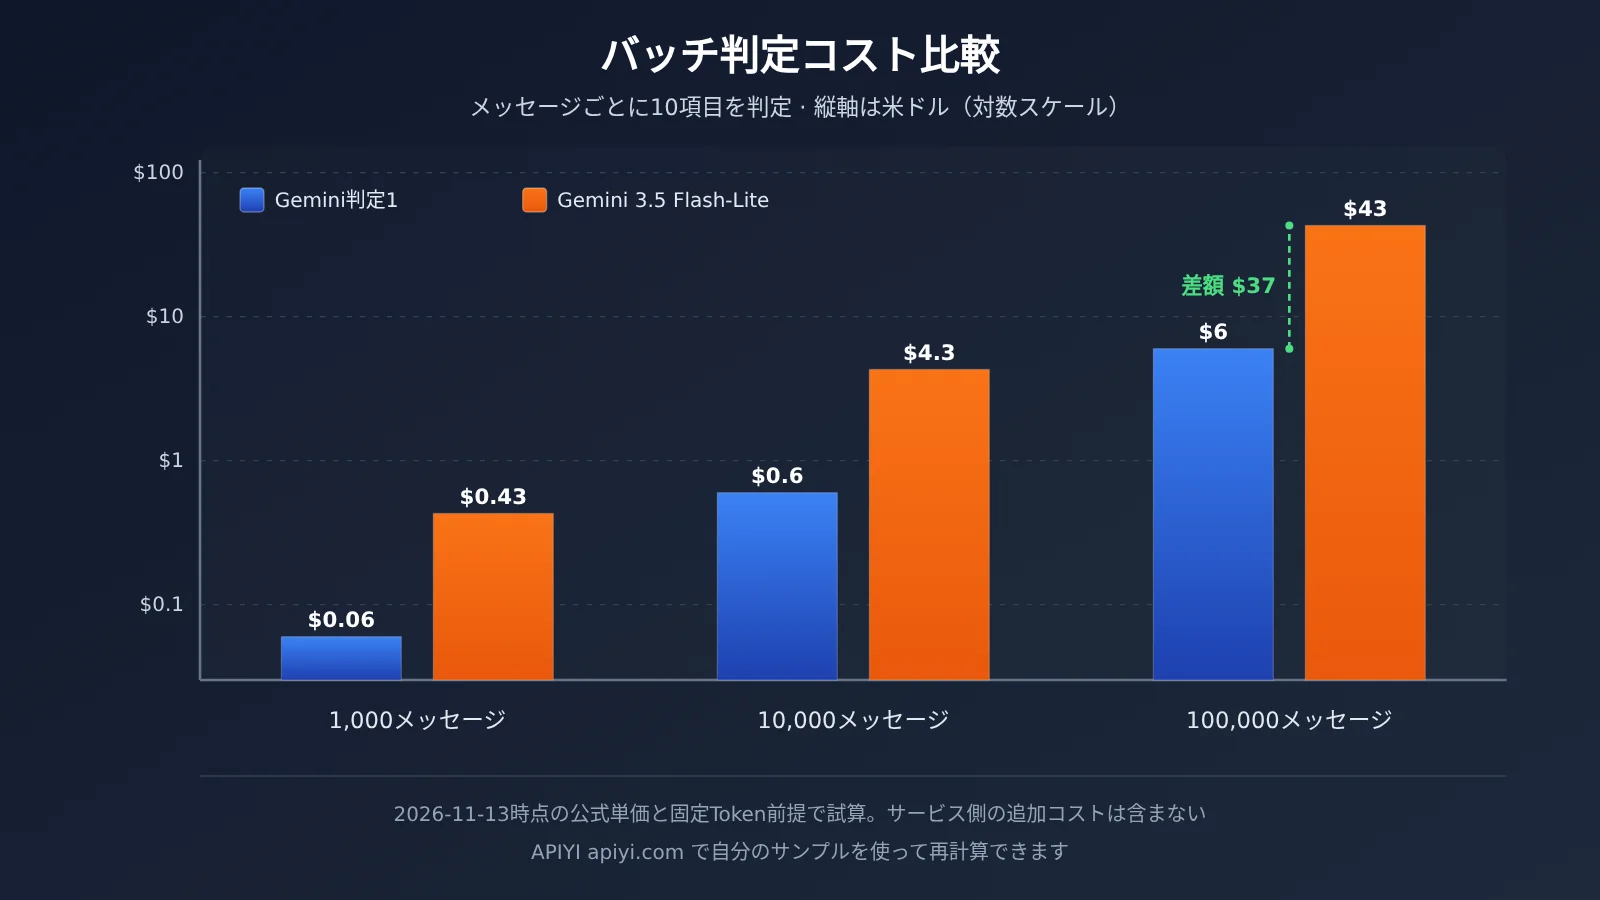
| ③ 1,000 件のメッセージでそれぞれ 10 項目の判断 | 各 300 Token、各判断項目 30 Token、Flash-Lite は各項目の出力 10 Token、各メッセージで 1 回のリクエスト | $0.060 | $0.430 | 86.0% |
3 つのシナリオから 2 つのことが分かります。シナリオ②では各リクエストに質問が 1 つだけですが、それでも 73.1% の理論上の削減率があります。これは入力単価が 3 分の 1 に下がり、出力費用がゼロになるためです。シナリオ①と③の削減率がより高いのは、共有入力のコストが複数の質問に分散され、さらに Flash-Lite では各質問に対して出力を生成する必要があるためです。
シナリオ③のパラメータで規模を拡大します。10 万件のメッセージ、合計 100 万回の判断を処理する場合、Decisions API のモデル呼び出しコストは 6 ドル、Flash-Lite は 43 ドルで、差は 37 ドルになります。この金額にはモデル呼び出し費用のみが含まれ、リトライ、誤判定後の人手レビュー、より強力なモデルへのエスカレーション、転送・保存、エンジニアリングの改造成本は含まれていません。
自分の業務サンプルで再計算したい場合は、まず同じデータを生成モデルに流して実行し、実際の入力・出力 Token を記録してから、上の式に当てはめるとよいでしょう。APIYI apiyi.com なら 1 つの APIキーで Gemini、GPT、Claude などの生成モデルを呼び出せるため、このコスト基準をすばやく確立できます。
2.3 Google の「約5倍」が万能の答えではない理由
Google は発表時に、公式テストにおいて Decision 1 のコストが Gemini 3.5 Flash-Lite の約 1/4.7 であると公表しました。独立系テスターの RanThis は 2026年11月12日に実際の API 呼び出しで別の数値を示しました。100件の英語メッセージと20件のベトナム語メッセージを使い、各リクエストでは二値判断を1つだけ行うという条件です。
- 精度:英語の100件の判断で、Decision 1 は99件正解し、Flash-Lite は98件正解しました。
- コスト:英語判断1000回あたりの推算コストはそれぞれ $0.0113 と $0.0166 で、Decision 1 は約32%低く、約1.5倍の差でした。
- レイテンシ:単一リクエストのレイテンシ中央値はそれぞれ 0.18 秒と 0.58 秒でした。
- トークン消費:Decision 1 は1リクエストあたり平均で約113個の入力トークンが課金され、Flash-Lite は約47個の入力トークンに1個の出力トークンでした。
差が生じる原因は明らかです。Decisions インターフェース自体の指示とフォーマットのオーバーヘッドによって、課金される入力トークンが2倍以上になり、単価の優位性の一部が打ち消されます。入力が非常に短く、毎回1問だけを問い、生成モデルが1個のトークンだけを出力する場合には、節約幅は最も小さくなります。RanThis が同じメールの10個の質問を1つの Decision 1 リクエストにまとめ、10回の個別の Flash-Lite リクエストと比較したところ、差は約5.4倍に広がりました。ただしこの比較では Flash-Lite 側が同じ統合を行っておらず、異なるリクエスト方式同士の比較になります。
したがって、実際の節約量に影響する変数は、共有入力の長さ、1つの入力あたりの質問数、生成モデルの出力長、双方がリクエスト統合を行っているかどうか、そしてインターフェース自体の固定オーバーヘッドです。公式の導出、公式ベンチマーク、サードパーティの実測はそれぞれ異なる条件に基づいているため、選定時には個別に捉えるべきです。
3 1回で1,000件の判定を完了——Decisions API は実際どんな業務に向くのか?
3.1 文書審査:1つの資料を複数のルールに照合する
共有入力の利点を最も活かせるのは、「長い資料+多数のルール」です。契約書、入札文書、製品仕様書などでは、コンプライアンスチェックリストに沿って項目ごとに確認する必要があります。違約条項が含まれているか、データの国外移転が定められているか、支払いサイトが60日を超えていないか、署名日が欠けていないか、といった具合です。資料が長く、ルールが多ければ多いほど、共有入力のコストをより十分に薄められます。シナリオ①の94.9%という理論上の削減効果は、こうした構造から生まれるものです。
この種のタスクには、結果をそのまま表に落とし込めるという利点もあります。各ルールが1つの noul 判定に対応し、確率と信頼度が返されるため、プログラムはしきい値に応じて「合格 / 不合格 / 再確認待ち」とマークできます。審査担当者は、再確認が必要な項目だけを見れば済みます。
3.2 Agentルーティングとコンテンツ分類
Agent は各ステップで、次に取るべき動作を決める必要があります。ネット検索が必要か、コードを実行すべきか、他のツールに引き渡すべきか、といった判断です。こうした判定は選択肢が固定され、呼び出し頻度が高く、遅延にも敏感なため、choice で一度に完了するのに適しています。Google が公開した社内での利用例も、ここに集中しています。Gemini Notebook では、質問の性質に応じてモデルと思考レベルを選択するために使われ、通常のクエリでは遅延を最大40%削減しています。Google Search では、MCP ツールの安全性チェックに使われ、敵対的コンテンツを識別します。CC は200以上の候補Emojiからリアクションを素早く選択します。これらはGoogle自身のデータであり、外部開発者にとっての実際の効果は、それぞれの負荷状況に左右されます。
コンテンツ制作ワークフローも、もう1つの応用領域です。AIニュースを1件収集した後、システムはそれが新規イベントか、開発者に関係するか、API価格に関わるか、公式ソースがあるか、チュートリアル向きかどうかを判定し、コンテンツ価値を採点する必要があります。これら6つの条件は互いに独立しており、1つの Decisions リクエストにまとめてスクリーニングを完了できます。スクリーニングを通過したテーマは、生成モデルに渡して調査、執筆、推敲を行います。これは、インターフェースの機能に基づいて設計した一例です。後半の生成ステップでは、APIYI apiyi.com を通じて必要に応じて異なるモデルを切り替え、執筆品質とコストを比較できます。
3.3 1,000件の質問における3つの制約
- 質問は互いに独立している必要があります。同じリクエスト内の判定は、互いの結果を読み取れません。「まずクレームかどうかを判定し、次にクレームの種類ごとに分類する」のような順序依存のフローでは、プログラム側で結果を組み合わせ、必要に応じて次のリクエストを発行する必要があります。
- 1,000件の質問が262,144 Tokenのコンテキストを共有します。共有入力とすべての質問が、このウィンドウを共同で占有します。各質問の指示が長くなるほど、収められる資料は短くなります。
- 公式の低遅延データは、小規模なリクエストのみを対象としています。Googleのテストで遅延がほぼ安定していた範囲は、1回あたり1〜100件の質問、コンテキスト16K Token以内です。1,000件の質問を上限に近いコンテキストと組み合わせる場合、遅延は自分で実測する必要があります。
4 安さだけではない、Gemini Decisions API の精度と速度は本番要件を満たせるのか?
4.1 Google が公表した速度と内部アプリケーションデータ
Google が公表したモデル計算時間の中央値は 50~100 ms、エンドツーエンドのレイテンシは 150~250 ms で、テスト条件は 1 回あたり 1~100 問、コンテキストは 16K Token 以下でした。このデータから、Agent の各ステップにおけるルーティングやユーザーメッセージの即時振り分けといったリアルタイムの処理チェーンに組み込むのに適していることがわかります。RanThis の単一問題における実測中央値レイテンシ 0.18 秒も、この範囲に近い値になっています。
4.2 サードパーティの評価からわかること
Artificial Analysis の Decision Index v2.1 の初期公開結果は、元のスコアと実際のタスクを混合して計算されています。以下の表に示す費用はこのベンチマークタスクの混合コストであり、「100 万 Token あたりの単価」とは別の尺度です。
| 意思決定モデル | 総合スコア | タスクあたりの所要時間 | 100 万タスクあたりの推定費用 | AA-Paperclip 15 項目全問正解率 |
|---|---|---|---|---|
| Drex Max v1.1 | 72.62 | 283 ms | $103 | 63% |
| TypeSafe Jev 1.14 | 66.23 | 92 ms | $156 | 35.5% |
| Gemini Decision 1 | 65.98 | 211 ms | $345 | 33% |
| GPT-6 Luna (Decisions) | 60.25 | 206 ms | $339 | — |
2 つのポイントが注目に値します。第一に、Gemini Decision 1 は Token 単価が低いものの、このタスク分布では 100 万タスクあたりの推定費用が Drex Max や Jev よりも高くなっており、リクエストの方式やタスク構造が最終的な経済性を変えることを示しています。第二に、AA-Paperclip のドキュメントテストでは、Decision 1 が 15 項目の判断すべてを一度に完了し、かつ全問正解だったドキュメントの割合が 33% でした。複数の判断を一度に完了することで費用は節約できますが、各項目の精度は個別に検証する必要があります。
4.3 信頼度で誤りの自動実行を防ぐ
信頼度とはモデル自身の結果に対する確率の推定値で、どの結果を自動実行し、どれを人手に引き渡すかを決めるのに使えます。本番投入時には、次の 3 つのやり方を組み合わせることをおすすめします:
- 信頼度のしきい値を設定する:たとえば返金判断の信頼度が 0.85 未満なら人手に回し、しきい値以上の場合のみ自動でタグ付けやチケット割り当てを行う、といった具合です。
- choice に other オプションを追加する:どの選択肢も当てはまらない場合でも、モデルはそのうちの 1 つを選んでしまいます。「その他 / 判断できない」を加えることで、範囲外の入力の一部を食い止められます。また、noul を別途追加して範囲チェックを行うこともできます。
- 高リスク操作にはコードによる制約を残す:返金額、アカウント凍結、コンプライアンス上のブロックなどのアクションには、モデルの判断に加えて、ハードコードされたルールと人手によるレビューも必要です。
5 開発者は Gemini Decisions API をどのように利用し、選定すべきか?
5.1 最初のリクエストを送信する方法
公式では Python の google-genai SDK 3.2 以降が必要で、JavaScript SDK と REST にも対応しています。利用には Google AI Studio の APIキーが必要です。以下のサンプルは公式 SDK の構造に基づいて整理したもので、同じニュースに対して二値判定と分類判定を同時に行います。本記事では実際の呼び出しによる検証は行っていません。フィールド名は公式の開発者ガイドを参照してください。
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    # input: すべての質問で共有する入力。課金は一度だけ
    input="Google released a new AI API with official pricing and developer documentation.",
    # questions: 相互に独立した判定。キー名が質問 ID
    questions={
        "has_api_pricing": {
            "type": "noul",
            "instructions": "Does this news mention API pricing?",
        },
        "category": {
            "type": "choice",
            "instructions": "Which news category fits best?",
            "criteria": {
                "model": "An AI model launch",
                "api": "An API or developer tool",
                "business": "Business or finance news",
            },
        },
    },
)

print(result.answers)  # 各質問の判定結果、各選択肢の確率、信頼度
print(result.usage)    # 課金対象の Token 使用量。コスト計算はこれを基準にする
4つの主要フィールドの役割は次のとおりです。input には共有内容を、questions には独立した質問を入れます(score タイプの等級定義の書き方は公式ガイドを参照してください)。answers から判定結果と確率を、usage から課金対象の Token を取得します。コスト算出では必ず usage の実際値を使ってください。2.3 節で説明したとおり、API の固定オーバーヘッドは 1 問あたりのコストに大きく影響します。
コスト比較を行うには、生成モデルのベースラインも必要です。以下では OpenAI 互換インターフェースから APIYI 経由で Flash-Lite を呼び出し、同じ分類を実行して Token 使用量を記録します。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",  # プラットフォームのモデル一覧にある実際の名称に従う
    messages=[{
        "role": "user",
        "content": "News: Google released a new AI API with official pricing.\n"
                   "Q1 mentions API pricing? Answer yes/no.\n"
                   "Q2 category: model/api/business. Answer one word each line."
    }],
    max_tokens=10,
)
print(resp.choices[0].message.content)
print(resp.usage)  # 入力・出力 Token。2.1 節の式に代入する
バッチ比較スクリプトを見る:同じサンプル群で 2 つのインターフェースのコストをそれぞれ集計
import openai

PRICE_IN, PRICE_OUT = 0.30, 2.50   # Flash-Lite の公式標準価格、米ドル/100万 Token
DECISION_IN = 0.10                 # Decision 1 の入力価格。出力は課金なし

gen_client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def flash_lite_cost(samples, questions, model="gemini-3.5-flash-lite"):
    """各サンプルのすべての質問を 1 回の生成リクエストにまとめ、実際の課金コストを累計する"""
    total = 0.0
    for text in samples:
        prompt = text + "\n" + "\n".join(
            f"Q{i+1}: {q} Answer briefly." for i, q in enumerate(questions)
        )
        r = gen_client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
            max_tokens=10 * len(questions),
        )
        total += (r.usage.prompt_tokens * PRICE_IN
                  + r.usage.completion_tokens * PRICE_OUT) / 1_000_000
    return total

def decision_cost(usage_input_tokens_list):
    """Decisions API が毎回返す usage の入力 Token を受け取り、総コストを計算する"""
    return sum(t * DECISION_IN for t in usage_input_tokens_list) / 1_000_000
🚀 クイックスタートのヒント:まず実際の業務サンプルを200〜500件選び、生成モデルでベースラインの精度とToken使用量を測定してから、Decisions API の
usageと比較しましょう。APIYI(apiyi.com)はOpenAI互換インターフェースと新規ユーザー向けの無料テスト枠を提供しており、このベースライン検証を素早く終えるのに適しています。
5.2 Decisions API を選ぶ場面、生成モデルを使い続ける場面
| タスクの種類 | 推奨案 | 理由 |
|---|---|---|
| 同じ長文ドキュメントを複数のルールに照らして審査 | Decisions API | 入力を共有してコストを分散でき、判断は互いに独立している |
| Agentのツールルーティング、モデル選択 | Decisions API | 選択肢が固定で、低遅延 |
| コンテンツの安全性と違反チェック | Decisions API | 複数の独立した noul 条件があり、信頼度で振り分け可能 |
| カスタマーサポートのチケット分類、ECのアフターサービスラベル | Decisions API | 固定のラベル集合 |
| テーマ選定の絞り込み、リードの優先度スコアリング | Decisions API | あらかじめ定義したスケールによる score に適している |
| 要約、リライト、執筆 | 生成モデル | 自然言語の出力が必要 |
| 複雑な調査、論証、新しい観点の提示 | 生成モデル | オープンエンドな推論が必要 |
| 判断の間に順序依存があるフロー | プログラムによるオーケストレーション+複数リクエスト、または生成モデル | 同一リクエスト内では質問同士が互いを参照できない |
生成モデルの構造化出力(JSON Schema)を使っても、回答を固定フォーマットに制約することはできます。ただし依然としてToken単位で内容を生成し、出力に応じて課金されるため、確率を得るには追加の処理が必要です。Decisions API は各選択肢の確率と信頼度を直接返し、出力は課金対象外です。その代わり、あらかじめ選択肢を限定した質問にしか答えられません。
5.3 リリース前に計算すべきコストは他に何があるか
単価以外に、次の項目が「正しい意思決定1回あたりの総コスト」に直接影響します。
- 実際のToken使用量:
usageを基準に判断します。短い入力の単一問題シナリオでは、固定オーバーヘッドの割合が最も高くなります。 - リクエスト制限:無料枠は200 RPM、50,000 TPM、10,000 RPD、有料のTier 1は1,500 RPM、100万TPM、50,000 RPDです。長いコンテキストのリクエストは、しばしばTPM上限に先に達します。
- キャッシュとバッチ処理の欠如:Context Caching、Batch API、Flex/Priority推論をサポートしていないため、同じ長い文書を繰り返し使う場合にキャッシュ割引を受けられません。
- 機能上の制約:問題の指示にメディア内容を含めることはできず、完全な会話履歴や思考・ツール呼び出しブロックを直接渡すこともできません。マルチターンの会話は、まずテキスト入力として整理する必要があります。
- 誤判定と人手によるレビュー:低信頼度で人に引き継ぐ割合や、誤判定後のやり直し費用は、単位コストに計上する必要があります。
- データ処理の条件:無料枠では使用データがGoogle製品の改善に使われる可能性がありますが、公式価格表によると有料枠ではこの目的には使用されません。顧客の文書を処理する前に、使用する階層を確認すべきです。
- エンジニアリング上の改修:生成的なプロンプトを noul / choice / score の問題に書き換え、しきい値とフォールバックロジックを構築するには、開発への投資が必要です。
サードパーティのAPIプラットフォーム経由で接続する予定の場合は、そのプラットフォームが /v1beta/decisions という専用エンドポイントをサポートしているか確認する必要があります。Chat Completions しかサポートしていないプラットフォームでは、Decisions API を直接呼び出すことはできません。APIYI apiyi.com で使用する前に、ドキュメントセンターのモデルとエンドポイントの一覧を確認するか、プラットフォームに問い合わせてサポート状況を確認してください。
6 結論:分類・審査・ルーティングタスクは Gemini Decisions API に任せられる
冒頭の問いに戻ると、結論は次の3点です。
- 固定選択肢のタスクでは、Decisions API を優先的に検討する価値がある。公開価格から試算すると、1問あたりの分類では理論上約73%のコスト削減、同一の長文ドキュメントに対する1,000件のルール審査では理論上約95%のコスト削減になります。サードパーティによる1問あたりの実測では、優位性は約32%でした。
- 「1つの入力、複数の独立した問題」はコスト面で最も大きな可能性を秘めた構造です。共有入力は1回だけ課金され、問題数が増えるほど、入力が長くなるほど、生成モデルの出力が長くなるほど、その差は広がります。
- 最終的な評価基準は、本番環境における「正しい判断1件あたりの総コスト」です。トークンの単価や1,000問の上限はあくまで出発点であり、実際の收益は、精度、信頼度による振り分け後の人手対応比率、レート制限、エンジニアリングコストが組み合わさって決まります。
より堅実な進め方は、まず実際のサンプルで生成モデルのベースラインを測定し、そのうえで Decisions API の usage と精度を比較し、判断レイヤーと生成レイヤーを分離して設計することです。生成レイヤーのモデル選定とコスト比較は、APIYI apiyi.com の統一インターフェースを通じて行えます。
📚 参考資料
- Google Gemini Decisions API 開発者ガイドと料金表:インターフェース機能、制限、レート制限、公式価格
- リンク:
ai.google.dev -
説明: モデル ID、問題タイプ、コンテキストウィンドウ、レート制限、SDK の使い方
-
Google 公式ブログの発表記事:公開日、レイテンシデータ、社内導入事例
- リンク:
blog.google -
説明: 50〜100 ms の計算時間、約4.7倍のコスト優位性、Gemini Notebook などの事例
-
Gemini Decisions API の REST エンドポイント
- リンク:
generativelanguage.googleapis.com/v1beta/decisions -
説明: REST 方式で呼び出す公式エンドポイント
-
Artificial Analysis Decision Index v2.1:サードパーティによる意思決定モデルの評価
- リンク:
artificialanalysis.ai -
説明: 総合スコア、タスク所要時間、100万タスクあたりのコスト、AA-Paperclip の全問正解率
-
RanThis による独立実測(2026-11-12):実際の呼び出しに基づく小規模テスト
- 説明: 1問あたりのコスト、レイテンシ、トークン消費の比較、および複数問題をまとめたリクエストの結果
作者: APIYI 技術チーム
技術的なお問い合わせ: APIYI apiyi.com のトップページからお気軽にご連絡ください。その他の導入資料は docs.apiyi.com のドキュメントセンターでご覧いただけます