2026年11月9日、Google Cloudは第8世代TPUの新たな2つのシステム構成、TPU 8txとTPU 8i Maxを発表しました。TPU 8i Maxは2基のTPU 8iを1つのパッケージに統合し、演算能力、オンチップSRAM、HBM帯域幅を同時に2倍にしています。長いコンテキスト、高い同時実行性、複数のAgentが連携する推論を想定した設計です。
これは単に演算能力を積み増すだけの発表ではありません。Googleの公式発表、AMDの同時発表された協業に関する告知、複数のメディアによる速報で、関連情報が確認されています。この記事ではチップの仕様を列挙するのではなく、KV Cacheの具体的な計算を通じて、Agentの推論におけるボトルネックが「どれだけ速く計算できるか」から「データを計算ユニットへ適時に届けられるか」へ移りつつあることを解説します。
この記事のポイント:読み終えるころには、長いコンテキストを含むリクエストがどれだけのメモリを必要とするかを自分で見積もり、メモリウォールが生じる原因を理解し、TPU 8i Maxのようなシステム設計が自分のAgentサービスにどう影響するかを判断できるようになります。
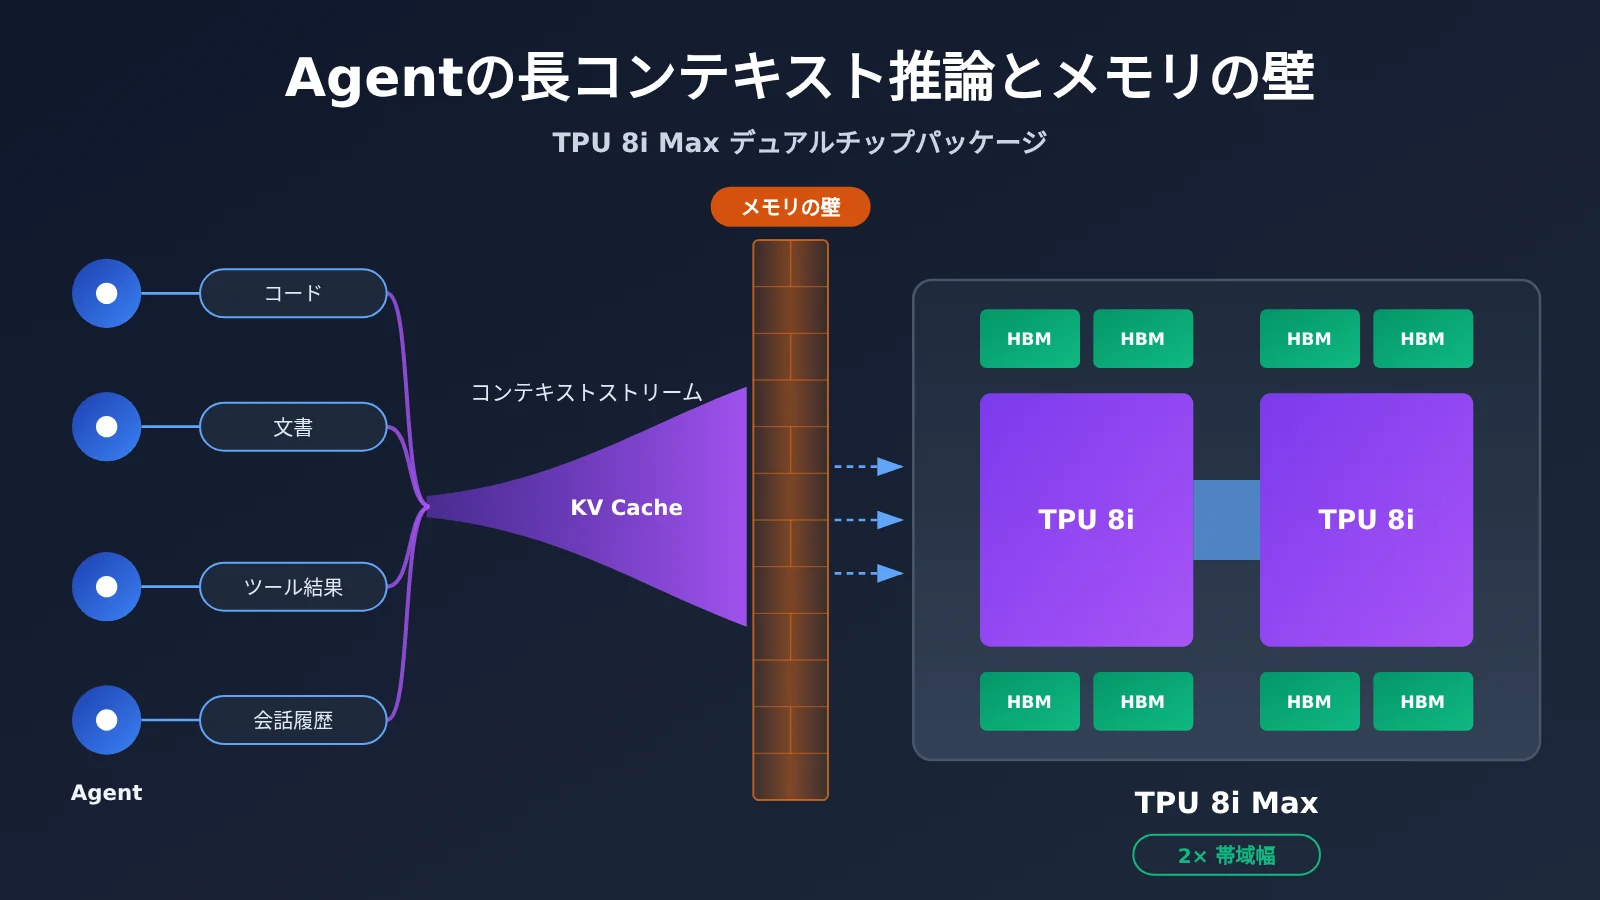
TPU 8i MaxとAgentの長文コンテキストに関する概要
| 項目 | 詳細 |
|---|---|
| 発表日 | 2026年11月9日 |
| 発表元 | Google Cloud |
| 製品の位置づけ | 第8世代TPUのシステム構成であり、新設計の独立したチップではない |
| パッケージ方式 | 2個のTPU 8iを同じパッケージに統合 |
| 公式に確認された性能向上 | 計算能力、SRAM、HBM帯域幅はいずれもTPU 8iの2倍 |
| メディア向け説明会で明らかになった仕様 | 384 GB HBM、17.2 TB/sのHBM帯域幅、768 MB SRAM |
| 主な用途 | 長文コンテキスト、高並列推論、複数Agentの協調、長時間動画の分析など |
| 提供状況 | 公式製品ページには「Coming soon」と記載。価格とGAの日程は未発表 |
重要なのは、Googleが発表の中で「チップ」と「システム」を明確に区別している点です。チップの設計には何年もかかりますが、システム構成ならパッケージ、メモリ、ネットワーク、セキュリティコンポーネントを調整することで、新たなワークロードにより迅速に対応できます。TPU 8i Maxは、まさにこの考え方から生まれた製品です。シリコンにはTPU 8iを採用し、変更はパッケージとシステムのレイヤーで行われています。
Agentの長文コンテキストが通常のチャットより多くのメモリを消費する理由
通常のチャットは「質問と回答」の繰り返しが中心です。コンテキストが増えるペースは緩やかで、会話が終われば状態を破棄できます。一方、Agentは1つの目標を複数のサブタスクに分解し、外部資料を継続的に読み込み、ツールを呼び出し、フィードバックを受けてさらに推論します。また、結果を待つ間も状態を保持します。各ステップの出力がコンテキストに追加されていくため、コンテキストは増え続けます。
たとえば、ソフトウェア開発Agentは1つのタスクの中で、次のような情報を同時に扱うことがあります。
- コードベース:数百のソースコードファイルとその依存関係
- プロジェクトドキュメント:アーキテクチャの説明、インターフェース仕様、コーディング規約
- 過去の会話:ユーザーの要望に関する複数回の確認や修正意見
- ツールの実行結果:コンパイルログ、テスト出力、エラーのスタックトレース
- サブAgentの出力:テスト、レビュー、リファクタリングを担当する各サブAgentからの結果
さらに重要なのが並列実行です。メインAgentから4つのサブAgentが派生すると、システム内には独立したコンテキストが5つ同時に存在します。推論中は、それぞれのコンテキストをメモリ上に常駐させる必要があります。Googleが「複数Agentによる大規模ソフトウェアプロジェクトの共同開発」をTPU 8i Maxの代表的な用途に挙げているのは、このためです。
なお、Googleが言及した「100万トークン規模のコンテキスト」は、想定される用途を示したものであり、固定の最大コンテキスト長として発表された仕様ではありません。
Agentの長いコンテキストに伴って線形に増加するKV Cache
KV Cacheの役割
Transformerは新しいトークンを生成するたびに、現在のトークンのQueryと過去のすべてのトークンのKeyを使って注意スコアを計算し、その重みを過去のトークンのValueに適用して加重和を求めます。トークンを生成するたびに過去のKeyとValueをすべて再計算すると、コンテキストが長くなるにつれて計算量が急増します。KV Cacheでは、過去のトークンについて計算済みのKeyとValueを保存して再利用し、メモリを使って計算量を抑えます。
その代わり、キャッシュの容量はコンテキストの長さと同時実行数に応じて増え続けます。以下の推定式は、vLLMのKV Cacheのメモリレイアウトに対応しています。
M_KV = 2 × L × H_KV × D × B × T × N
| パラメーター | 意味 | Llama 3.1 70Bでの値 |
|---|---|---|
| 2 | KeyとValueの2種類のキャッシュ | 2 |
| L | Transformerの層数 | 80 |
| H_KV | Key/Valueの注意ヘッド数 | 8(GQA) |
| D | KV Headあたりの次元数 | 128 |
| B | 各要素のバイト数 | 2(BF16) |
| T | リクエストあたりのトークン数 | シナリオによって異なる |
| N | 同時実行リクエスト数 | シナリオによって異なる |
Llama 3.1 70BのKV Cache計算例
まず、トークン1個あたりのサイズを計算します。2 × 80 × 8 × 128 × 2 = 327,680バイト、つまり1トークンあたり約320 KiBです。この数字は小さく見えますが、コンテキスト長を掛けると急速に大きくなります。
| シナリオ | コンテキスト長 | 同時実行数 | 理論上のKV Cache |
|---|---|---|---|
| 短いタスク | 8K | 1 | 2.5 GiB |
| 中程度のコードタスク | 32K | 1 | 10 GiB |
| 長いコンテキストを使うAgent | 128K | 1 | 40 GiB |
| 複数Agentの並列実行 | 128K | 8 | 320 GiB |
上記の計算にはKV Cacheのみが含まれており、モデルの重み、実行時のワークスペース、メモリの断片化によるオーバーヘッドは含まれていません。比較すると、70BパラメーターのモデルをBF16で保存する場合、重みだけで約140 GB必要です。つまり、128Kの同時実行セッションが8つあると、必要なKV Cacheはモデルの重みの2倍を超えます。
GQAがKV Cacheのメモリ使用量に与える影響
Llama 3.1 70BはAttention Headを64個備えていますが、KV Headは8個です。これがGQA(Grouped-Query Attention)で、Query Head 8個で1組のKey/Valueを共有します。計算では64ではなく8を使う必要があります。そうしないと、結果が8倍に過大評価されます。
GQAの効果は、反実仮想で考えると分かりやすくなります。このモデルが標準的なマルチヘッドアテンションを採用し、64個すべてのHeadに個別のKVを保持する場合、128Kリクエスト1件あたりのKV Cacheは40 GiBから320 GiBに増えます。これは、GQAを使った8並列のシナリオ全体で必要な量に相当します。MQAではKV Headをさらに1個まで減らせるため、メモリ使用量を抑えられますが、モデルの品質への影響も考慮する必要があります。さらに、KV Cacheの量子化(たとえばBF16から8ビットにする方法)で、使用量を半分にできます。ただし、精度の低下を評価する必要があります。
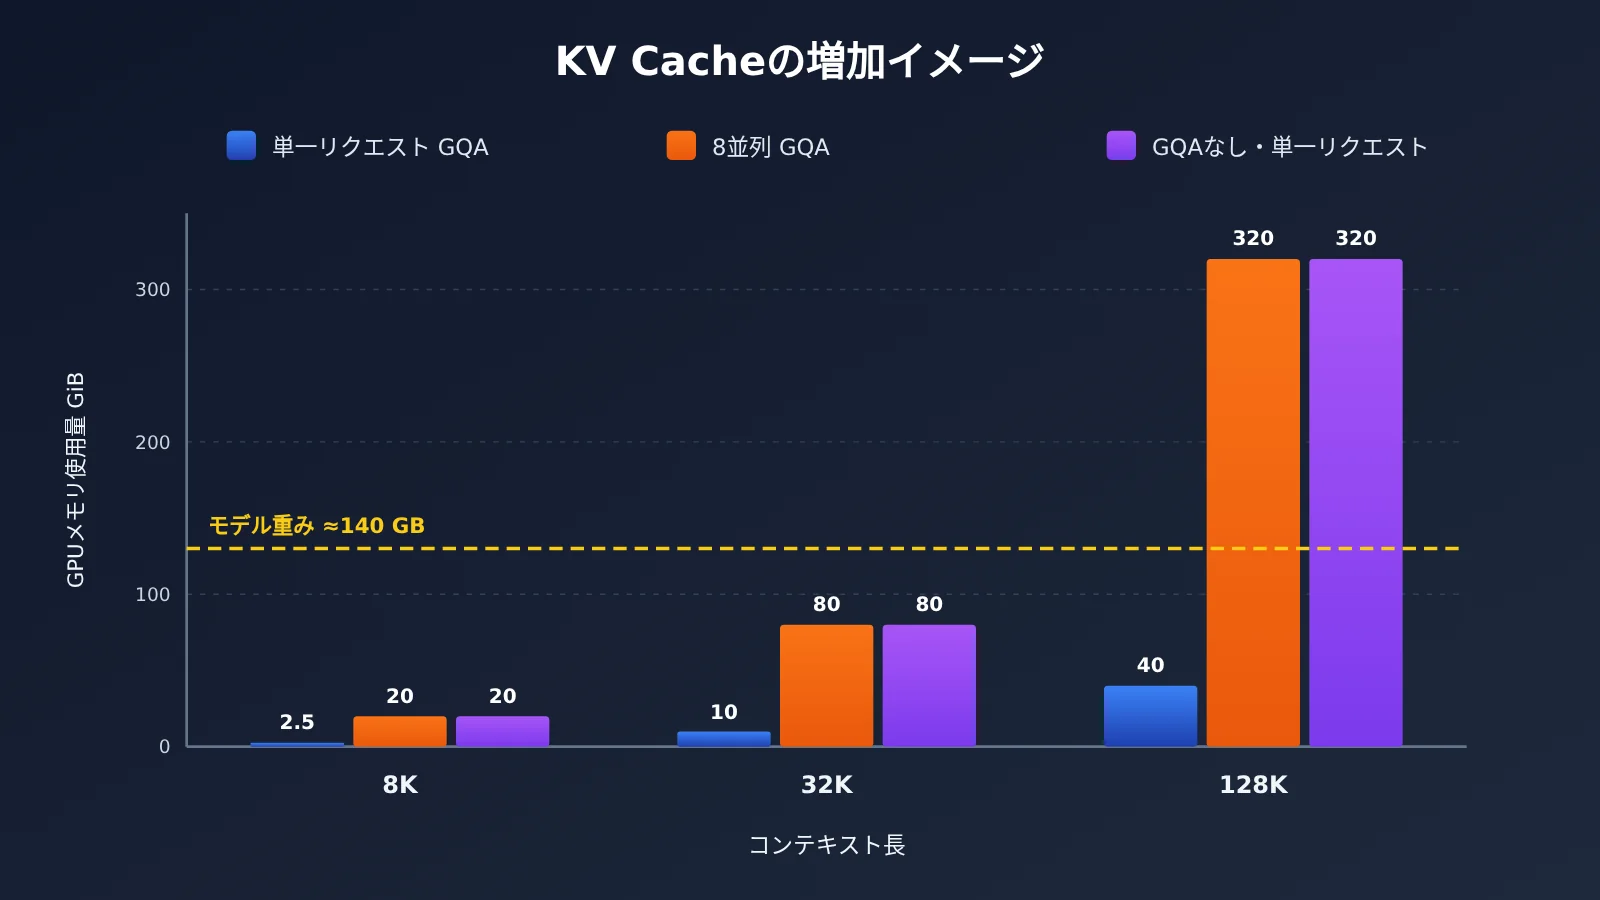
以下のスクリプトでは、上記の計算式を使って、さまざまなコンテキスト長と同時実行数におけるモデルのKV Cache容量をすばやく見積もれます。
def kv_cache_gib(layers, kv_heads, head_dim, bytes_per_elem, tokens, concurrency=1):
    """M_KV = 2 × L × H_KV × D × B × T × N でKV Cacheを推定し、単位をGiBで返す"""
    total = 2 * layers * kv_heads * head_dim * bytes_per_elem * tokens * concurrency
    return total / (1024 ** 3)

# Llama 3.1 70B:80層、KV Headは8個、次元数は128、BF16
for ctx in (8_192, 32_768, 131_072):
    print(f"{ctx:>7} tokens -> {kv_cache_gib(80, 8, 128, 2, ctx):.1f} GiB")

print("8 并发 x 128K ->", kv_cache_gib(80, 8, 128, 2, 131_072, 8), "GiB")
print("FP8 KV 量化 128K ->", kv_cache_gib(80, 8, 128, 1, 131_072), "GiB")
Agentの長文脈推論におけるメモリーウォールとは
容量、帯域幅、SRAMはそれぞれ独立した指標
メモリーウォールについて語るとき、よくある誤解は「メモリーが大きいこと」と「メモリーが速いこと」を同じものとして捉えることです。実際、AIアクセラレーターのメモリーシステムには、少なくとも互いに独立した3つの指標があります。
| 指標 | 何を決めるか | Agentにとっての意味 |
|---|---|---|
| HBM容量 | どれだけのデータを格納できるか | モデルの重みとKV Cacheをどれだけ同時に保持できるか、つまり同時に処理できるコンテキスト数 |
| HBM帯域幅 | 単位時間あたりにどれだけのデータを転送できるか | Tokenを1つ生成するたびに、重みとKV Cacheを計算コアへすばやく転送できるか |
| オンチップSRAM | 計算コアに最も近い高速メモリー | 頻繁に使うデータをチップ上に保持し、HBMへのアクセス待ちを減らせるか |
HBMは、多層積層と先進的なパッケージングによって高並列アクセスを実現するDRAMです。一方、SRAMはより高速で計算ユニットに近いものの、容量あたりのコストが高く、物理的な面積にも限りがあります。そのため、現代のアクセラレーターでは、特定のメモリー容量だけを追求するのではなく、一般に多階層のメモリー構成が採用されています。
PrefillとDecodeではデータの要求が大きく異なる
LLMの推論は2つの段階に分かれます。Prefill段階では、入力コンテキスト全体を一括処理してKV Cacheを構築します。大量のTokenを並列に計算できるため、典型的な計算集約型タスクです。Decode段階では、出力Tokenを1つずつ生成します。各ステップで処理する新しいTokenは1つだけですが、すべての重みとコンテキスト全体のKV Cacheを読み込む必要があります。計算量は少なく、データ転送量が多いため、帯域幅がボトルネックになりやすいタスクです。
Decodeにかかる負荷を、単純化した推定で見てみましょう。128Kのリクエスト1件分のKV Cacheは約40 GiB(約43 GB)で、Tokenを1つ生成するたびに全量を読み込む必要があります。TPU 8iの単一チップあたりのHBM帯域幅を約8.6 TB/sとすると、KV Cacheの読み込みだけで約5ミリ秒かかります。TPU 8i Maxの17.2 TB/sであれば、理論上の下限は約2.5ミリ秒です。これは重みの読み込み、計算とのオーバーラップ、並列分割を考慮しない理論値にすぎません。それでも、コンテキストが長くなるほど、Decodeの時間は計算よりもデータ転送に左右されることがわかります。
計算ユニットが「データ待ち」になる理由
計算コアが1秒あたりに実行できる演算量に対して、メモリーが1秒あたりに供給できるデータ量が少ないと、計算ユニットはデータを待つ間、稼働できずに遊休状態になります。これがメモリーウォールです。Agentでは、長いコンテキストによってDecodeの各ステップで読み込むデータ量が増え、高い並列度によって常時保持すべきKV Cacheが増え、さらに複数回の推論によってキャッシュの読み込みと更新が繰り返されます。こうした要因が重なると、ピーク演算性能を高めても、その効果は次第に小さくなります。
🎯 技術的なアドバイス:Agentアプリケーションを評価する前に、コンテキスト長を変えながら、最初のTokenが出力されるまでの遅延(TTFT)と出力速度を実測し、コンテキストの増加に伴う遅延の変化を確認することをおすすめします。APIYI apiyi.comでは、同じAPIキーでClaude、Gemini、GPTなどのモデルを切り替えてテストできるため、各モデルの長文脈処理性能を比較しやすくなります。
TPU 8i Maxのデュアルチップパッケージがメモリ帯域幅を拡張する仕組み
2基のTPU 8iをどう組み合わせるのか
TPU 8i Maxは、第8世代TPUにおける4つ目のシステム構成です。Googleは、複数のエージェントが大規模なコードベースや長時間の動画、複雑なドキュメントを同時に処理する際、ボトルネックになるのは演算能力ではなく、チップがデータを読み込み、やり取りする速度であることに気づきました。そこで、低レイテンシーのTPU 8iを2基、1つのパッケージに統合し、同じラック設置面積でシリコンの量を2倍にしました。
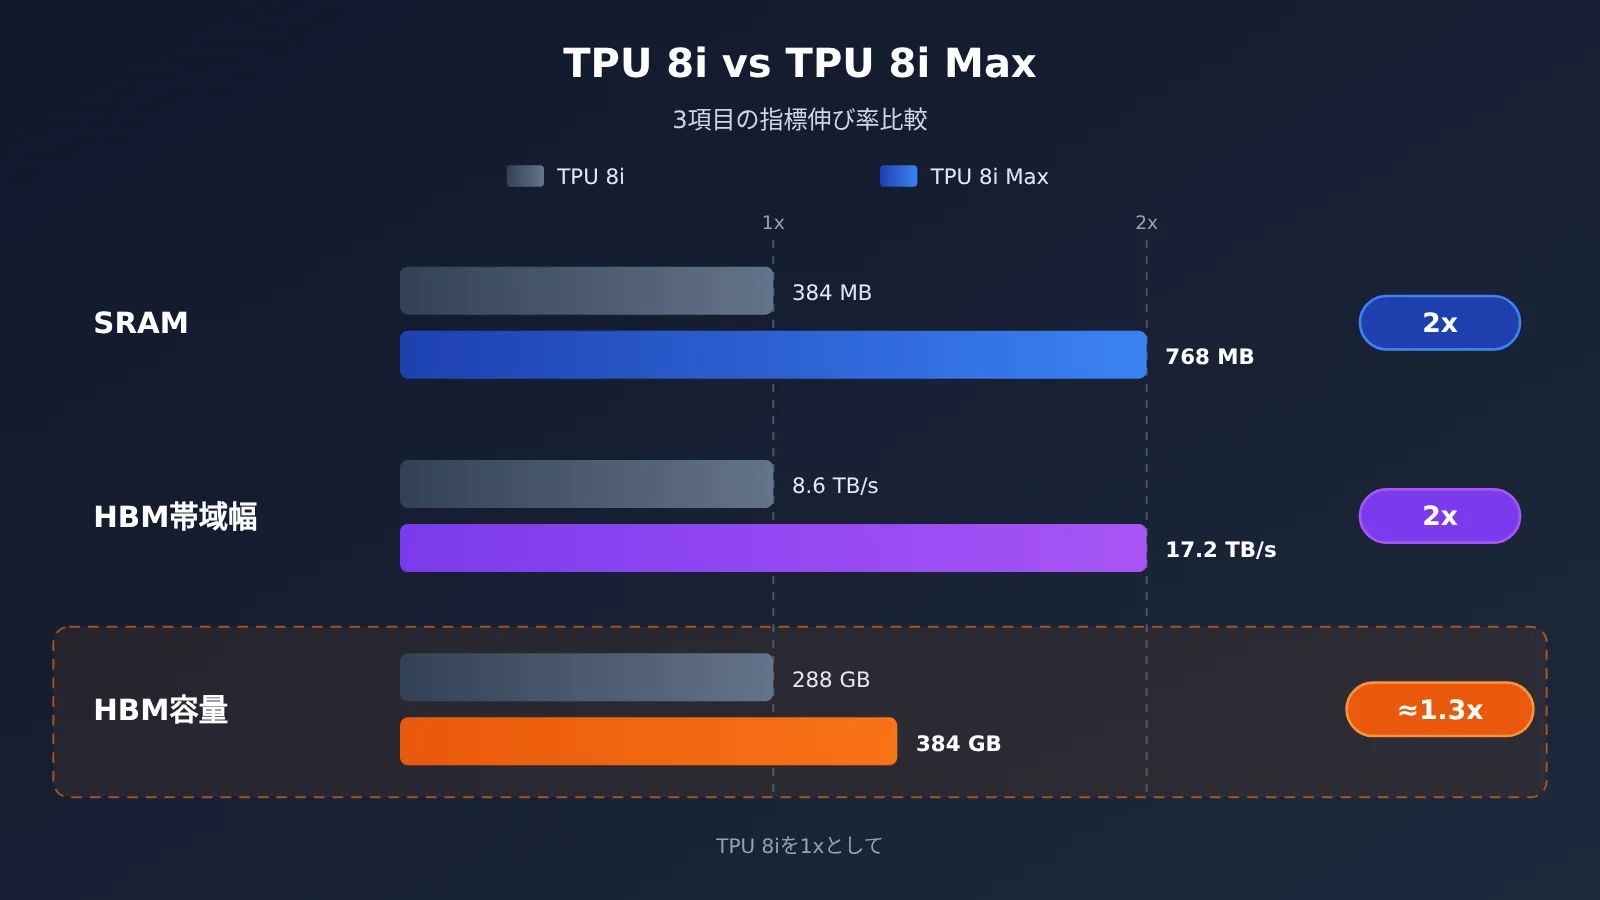
| 指標 | TPU 8i | TPU 8i Max | 変化 |
|---|---|---|---|
| チップパッケージ | 単一チップ | 2チップ | — |
| 演算能力 | 基準 | 2倍 | 2倍 |
| オンチップSRAM | 384 MB | 768 MB | 2倍 |
| HBM帯域幅 | 8,601 GB/s | 17,200 GB/s | 約2倍 |
| HBM容量 | 288 GB | 384 GB | 約33%増 |
注:TPU 8iのデータはGoogleが2026年4月に公開したアーキテクチャ技術記事に基づいています。TPU 8i Maxの具体的な数値は11月9日のメディア向け説明会の報道によるものです。公式発表記事の本文で明確に確認されているのは、演算能力、SRAM、HBM帯域幅が2倍になる点です。
個別に演算能力を高めるより、同期して拡張する方が効果的な理由
演算能力だけを高めると、デコード段階では帯域幅がより深刻なボトルネックになります。一方、帯域幅だけを高めても、演算ユニットを十分に活用できない可能性があります。TPU 8i Maxでは、演算能力、SRAM、HBM帯域幅をほぼ同じ比率で拡張することで、「データ供給速度/演算速度」の比率を、従来の設計バランスに近い水準に保っています。また、SRAMが2倍になったことで、頻繁に使うデータをより多くチップ上に保持でき、HBMとのデータのやり取りもさらに減らせます。
HBM容量の増加は約33%。2倍ではない
ここは特に間違えやすいポイントです。HBM帯域幅は約8.6 TB/sから17.2 TB/sへと2倍になりましたが、HBM容量は288 GBから384 GBへと約33%増にとどまります。前述の数値と合わせて考えると、その意味がわかります。TPU 8i Maxはメモリ1 GBあたりの帯域幅が高く、同じサイズのKVキャッシュをより速く読み込めます。しかし、同時に「格納できる」コンテキストの総量は、帯域幅ほど大きく増えていません。
つまり、TPU 8i Maxの主な価値は、単一モデルのコンテキスト上限を2倍にすることではなく、大量のコンテキストを同時に、より効率よく処理できるようにすることです。容量が足りない場合は、引き続きKVキャッシュのオフロードや量子化、複数チップへの分割といったソフトウェア上の手法が必要です。
GPUとTPU 8i Maxのメモリーアーキテクチャ比較
TPU 8i Maxの位置づけを理解するために、NVIDIAの最新アーキテクチャであるRubinをGPUの比較対象として見てみましょう。
| 項目 | NVIDIA Rubin GPU | Google TPU 8i Max |
|---|---|---|
| 計測単位 | GPU 1基 | TPUチップ2基のパッケージ |
| HBM容量 | 288 GB HBM4 | 384 GB HBM(メディア報道) |
| HBM帯域幅 | 22 TB/s | 17.2 TB/s(メディア報道) |
| オンチップストレージ | アーキテクチャにより異なる | 768 MB SRAM(メディア報道) |
| チップ間インターコネクト | NVLink 6 | Boardfly低遅延ネットワーク(TPU 8iシステム) |
| ソフトウェアエコシステム | CUDAおよび主要な推論エンジン | JAX、TorchTPU、vLLM / SGLangのTPUバックエンド |
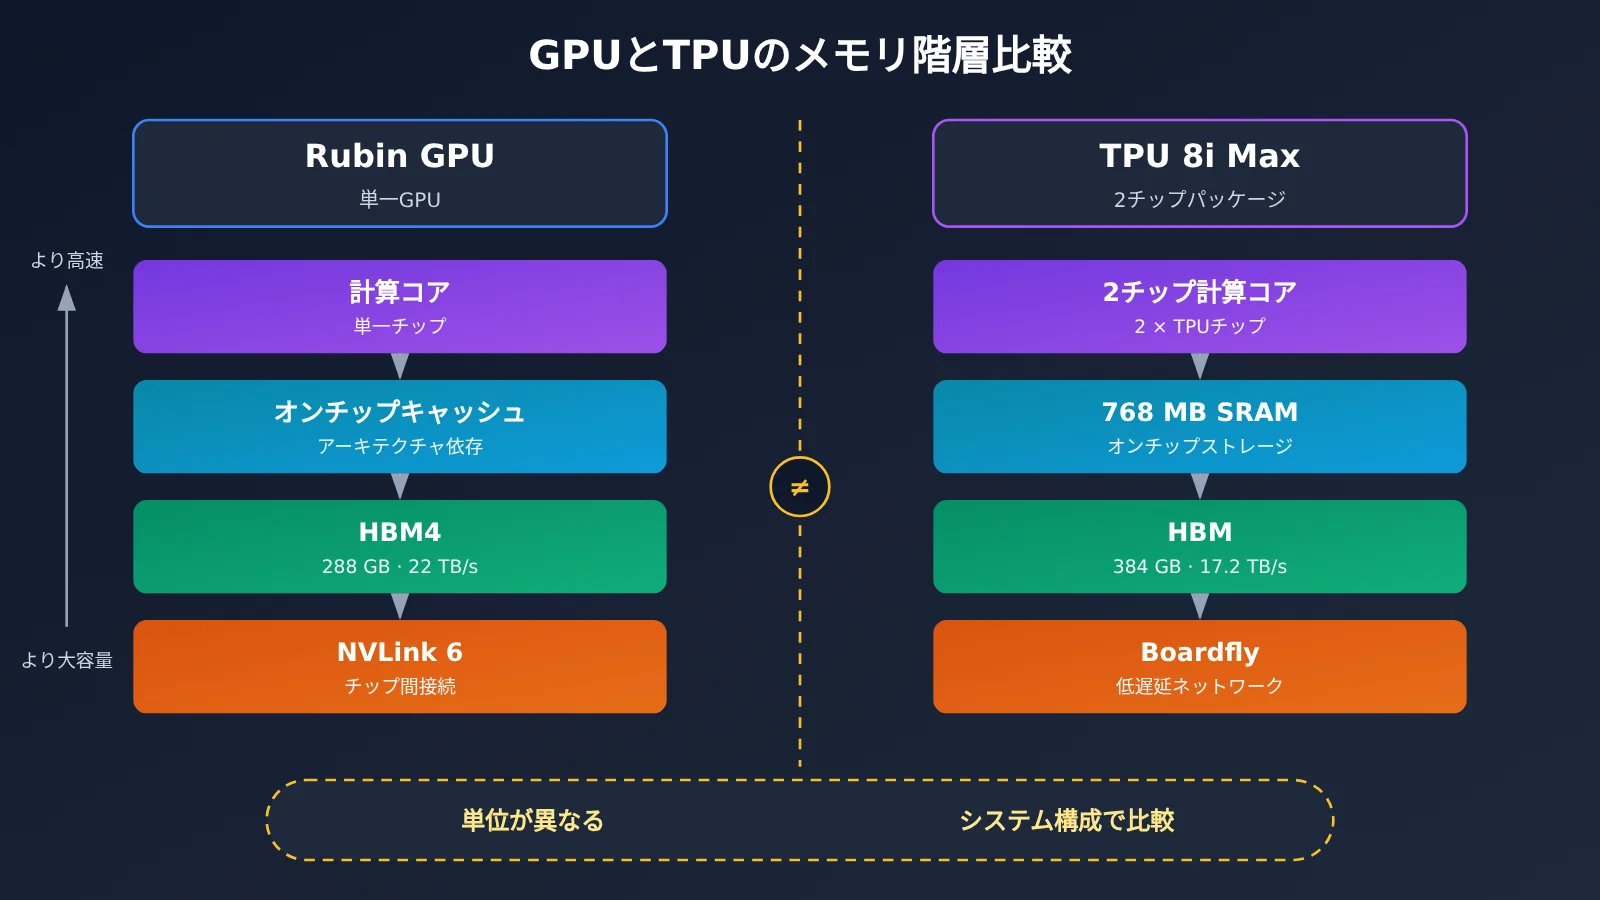
この表だけで単純に順位をつけることはできません。384 GBと288 GBの比較では、一方が2チップのパッケージ、もう一方がGPU 1基です。HBMの世代、インターコネクト方式、計算アーキテクチャ、システム全体の構成も異なります。帯域幅だけを見るとRubinが上回り、容量だけを見るとTPU 8i Maxが上回りますが、いずれもシステム規模と切り離して論じることはできません。
本当に比較すべきなのは、同じ消費電力、ラックの設置スペース、コストの条件で、システム全体としてどれだけの有効な同時実行コンテキストを安定して処理できるか、また、それらのコンテキストを維持した際のスループット、レイテンシ、電力効率がどの程度かという点です。2026年11月10日時点で、TPU 8i Maxについて第三者が再検証できる公開実測値はありません。こうしたシステムレベルの比較には、正式な商用提供後のデータを待つ必要があります。
💡 選び方のヒント:API経由でAgentを構築する多くのチームにとって、基盤がGPUとTPUのどちらで動くかを自分たちで選ぶ必要はありません。より現実的なのは、長いコンテキストを扱う場合のレイテンシや単価を、各モデル間で比較することです。APIYI apiyi.comの統一インターフェースを利用すれば、複数のモデルを並行してテストし、実際の業務で使うプロンプトで比較できます。
TPU 8i Maxがエージェント開発者に与える影響
コンテキストウィンドウ、実際の同時処理数、推論レイテンシを区別する
モデルが公称するコンテキストウィンドウは、「理論上どれだけの情報を格納できるか」を示すものです。この長さでサーバーがどれだけの同時処理を支えられるかを示すものでも、レイテンシが許容範囲に収まることを保証するものでもありません。前述の計算からもわかるように、同じ128Kのコンテキストでも、1つのセッションと8つのセッションではKV Cacheの容量に8倍の差が生じます。開発者は、次の3つの指標を分けて考える必要があります。
- コンテキストウィンドウ:モデルが処理できる最大範囲であり、1回の処理にどれだけの情報を含められるかを決めます
- 実際の同時処理能力:所定のハードウェアで、長いセッションを同時にいくつ維持できるかを示します。HBM容量の制約を受けます
- 推論レイテンシ:TTFTはPrefillの計算量に左右され、トークンごとの生成速度はメモリ帯域幅とKV Cacheのサイズに左右されます
普及が進む3つのメモリウォール緩和技術
ハードウェアはメモリウォールを解消するための手段の半分にすぎません。もう半分はソフトウェア層にあります。Googleが同時にオープンソース化したTPU Syncや、TPU版のvLLM、SGLangは、次のような技術を中心に開発されています。
| 技術 | 解決する問題 | コストや注意点 |
|---|---|---|
| KV Cache Offloading | 一時的に使用しないキャッシュをHBMからホストのDRAM、SSD、共有ストレージに移し、容量の上限を超えて利用できるようにする | キャッシュを戻す際に転送時間がかかります。効率的なDMAと非同期転送が必要です |
| KV Cacheの量子化 | 要素あたりのバイト数を減らし、容量と帯域幅の使用量を直接削減する | 精度への影響を評価する必要があります |
| Prefill / Decodeの分離 | 計算負荷の高いPrefillと、帯域幅を多く消費するDecodeを別々のノードに配置する | ノード間でKV Cacheを高速に転送する必要があります |
| Prefix Caching | 同じシステムプロンプトや会話履歴のプレフィックスを再利用し、Prefillの重複を避ける | リクエスト間でプレフィックスがどれだけ重複しているかに左右されます |
Googleが公開したTPU Syncのデータによると、KV Cacheの転送遅延を90%以上削減でき、64Kのコンテキストでプレフィックスキャッシュを使用する場合、TTFTを最大90%短縮できます。ただし、このテストは第7世代Ironwood TPUを使って実施されたものです。また、GitHubのREADMEに現在記載されている検証済みハードウェアはv7xとv6eです。そのため、この結果をTPU 8i Maxの性能としてそのまま扱うことはできません。
実際の性能とリソースコストに反映する
APIの呼び出し側にとって、こうした基盤レベルの最適化は、最終的に次の2点に表れます。長いコンテキストを使ったリクエストの遅延が安定するか、そしてToken単位の課金コストが下がるかです。アプリケーション側でも、「メモリ使用量を抑える」という考え方を取り入れられます。システムプロンプトを簡潔にし、キャッシュがヒットするようにプレフィックスを安定させる、ツールの出力を要約してからコンテキストに戻す、子Agentには履歴全体ではなく必要な部分だけを渡す、といった方法です。
以下の例では、ストリーミング出力を使ってコンテキスト長ごとの初回Token生成までの遅延を測定し、コンテキストの増加がPrefillに与える影響を確認できます。
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIのOpenAI互換インターフェース
)

def measure_ttft(context: str, model: str = "gpt-4o-mini") -> float:
    start = time.perf_counter()
    stream = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": context + "\n请用一句话总结上文。"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            return time.perf_counter() - start
    return -1.0

print(f"TTFT: {measure_ttft('示例代码片段 ' * 2000):.2f}s")
複数モデル・複数コンテキスト長の一括テストコードを見る
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 1つのAPIキーで複数のモデルを切り替え
)

MODELS = ["gpt-4o-mini", "claude-sonnet-4", "gemini-2.5-flash"]
LENGTHS = [1_000, 5_000, 20_000]  # コンテキストをおおよそ拡大するための、コード片の繰り返し回数

def run_once(model: str, repeat: int) -> dict:
    context = "def handler(event):\n    return process(event)\n" * repeat
    start = time.perf_counter()
    first, tokens = None, 0
    try:
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": context + "\n指出上面代码的潜在问题。"}],
            stream=True,
            max_tokens=200,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                tokens += 1
                if first is None:
                    first = time.perf_counter() - start
        total = time.perf_counter() - start
        return {"model": model, "repeat": repeat, "ttft": first, "total": total, "chunks": tokens}
    except Exception as e:
        return {"model": model, "repeat": repeat, "error": str(e)}

for m in MODELS:
    for n in LENGTHS:
        print(run_once(m, n))
🚀 すぐに始める:APIYI(apiyi.com)に登録すると、無料のテスト枠を利用できます。上記スクリプトのbase_urlを
https://api.apiyi.com/v1に設定すれば、数分で複数モデルのコンテキスト長ごとのTTFT曲線を取得できます。
業界への影響
- システムレベルのカスタマイズが加速:Googleが「同じシリコン、異なるシステム」というアプローチで、特定のワークロードに向けた構成を迅速に投入したことは、アクセラレーターの競争軸が単一チップのスペックからシステム設計へ移りつつあることを示しています。
- ハードウェアとソフトウェアの連携が標準に:TPU 8i Maxは、TPU Sync、Agent Compute Engine、TPU向け推論エンジンとともに発表されました。メモリウォールの解消には、ハードウェアの帯域幅とソフトウェアのスケジューリングの両方が必要です。
- 商用化はまだ初期段階:TPU 8i Maxは、8t、8i、8txと同様に「Coming soon」と記載されており、公開価格や正式な提供開始日は明らかになっていません。実際のコストパフォーマンスは、今後の検証を待つ必要があります。
よくある質問(FAQ)
Q1:TPU 8i Maxとは何ですか?
TPU 8i Maxは、Googleが2026年11月9日に発表した第8世代TPUのシステム構成です。2基のTPU 8iを同一パッケージに統合しており、計算能力、オンチップSRAM、HBM帯域幅はいずれもTPU 8iの2倍です。長いコンテキスト、高い同時実行性、複数エージェントによる協調推論を主な用途としています。まったく新しい設計のチップではありません。
Q2:TPU 8i MaxではHBM容量も2倍になりましたか?
いいえ。メディア向けブリーフィングによると、HBM容量は288 GBから384 GBへ増加しており、増加率は約33%です。2倍になったのはHBM帯域幅(約8.6 TB/sから17.2 TB/s)とSRAM(384 MBから768 MB)です。容量と帯域幅は別々の指標であり、混同しないようにしましょう。
Q3:TPU 8i Maxは現在利用できますか?価格はいくらですか?
2026年11月10日時点で、Google Cloudの公式製品ページではTPU 8i Maxは「Coming soon」と記載されています。公開価格や正式な一般提供(GA)開始日は発表されておらず、第三者が公開情報から検証できる独立した性能テストもありません。現時点で参考にできるのは、Googleの公式発表とメディア向けブリーフィングの仕様のみです。
Q4:TPU 8i Maxなら、単一モデルで100万トークンのコンテキストに対応できますか?
Googleは、100万トークン規模のコンテキストを想定される用途として挙げていますが、これは確定した最大コンテキスト長の仕様ではありません。モデルがどれほど長いコンテキストを処理できるかは、まずモデル自体によって決まります。ハードウェアが左右するのは、その長さでどれだけの同時実行性を維持できるか、また許容できる遅延に収まるかです。
Q5:アプリケーション開発者は、長いコンテキストが遅延に与える影響をどう検証できますか?
最も直接的な方法は、実際の業務で使うコンテキストを長さ別に用意し、TTFTと出力速度を測定することです。
1. APIYI(apiyi.com)にアクセスしてアカウントを登録し、APIキーと無料テスト枠を取得します。
2. この記事のテストスクリプトを使い、`base_url`を`https://api.apiyi.com/v1`に設定します。
3. 同じコンテキストで複数のモデルを切り替え、長さに応じた遅延の増加傾向を比較します。
Q6:KV Cacheの量子化やオフロードには、どのような制約がありますか?
量子化はメモリと帯域幅の使用量を直接削減できますが、精度が低下する可能性があるため、対象タスクでの評価が必要です。オフロードはHBMの容量制限を超えてデータを扱えるようにしますが、データを戻す際に転送時間がかかります。データ階層間の転送が十分に速くなければ、かえって遅延が増えることもあります。どちらの方法も、同時実行数や遅延の目標に合わせてパラメーターを調整する必要があります。
エージェントの長文コンテキストとTPU 8i Maxの要点
- ボトルネックの移行:エージェントの推論では、単純な計算性能の競争から、計算能力とメモリへのデータ供給のバランスが重視されるようになっています。
- KV Cacheは線形に増加:Llama 3.1 70Bでは1トークンあたり約320 KiBを使用し、128Kの単一リクエストでは約40 GiBに達します。
- GQAが重要:KVヘッドが8個の場合、キャッシュの使用量は標準的なマルチヘッドアテンションの8分の1になります。
- Decodeは帯域幅を消費:トークンを1つ生成するたびにKV Cache全体を読み込む必要があるため、長いコンテキストでは帯域幅がレイテンシを左右します。
- ハードウェアを同時に拡張:TPU 8i Maxは計算性能、SRAM、HBM帯域幅がそれぞれ2倍になっていますが、HBM容量の増加は約33%にとどまります。
- ソフトウェアも重要:オフロード、量子化、Prefill/Decodeの分離、プレフィックスキャッシュが、メモリウォールを緩和する主な手段です。
- 実際に試して検証:APIYI apiyi.comの統一インターフェースを利用して、複数モデルの長文コンテキストにおけるレイテンシを実測できます。
まとめ
エージェントの長文コンテキスト推論におけるメモリウォールの要点は、次のとおりです。
- 負荷の要因:コードベース、ツールの実行結果、サブエージェントの出力が蓄積し、さらに複数エージェントの並列実行が加わることで、KV Cacheの使用量は大きく膨らみます。
- ハードウェアの考え方:TPU 8i Maxは単に計算性能を高めるのではなく、計算性能、SRAM、HBM帯域幅を同時に拡張し、データ供給と計算のバランスを保つ設計です。
- 適用上の限界:HBM容量の増加は限られており、製品もまだ商用化されていません。実際の価値は、システム全体での実測データを待って判断する必要があります。
多くの開発者にとって、現時点で現実的なのは、KV Cacheのコスト構造を理解し、アプリケーション層でコンテキストの肥大化を抑えながら、モデルサービスの長文コンテキストにおけるレイテンシや料金の変化を継続的に確認することです。APIYI apiyi.comを使って実際の業務データで複数モデルの長文コンテキスト性能を比較するのもおすすめです。このプラットフォームはOpenAI互換インターフェースと、新規ユーザー向けの無料利用枠を提供しています。
📚 参考資料
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max:今回の発表に関する公式技術アナウンス
- リンク:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
説明:デュアルチップパッケージの採用と、演算性能、SRAM、HBM帯域幅が2倍になったことを確認できます。
-
Google Cloud – Inside the eighth-generation TPU:第8世代TPUアーキテクチャの詳細解説
- リンク:
cloud.google.com/blog/products/compute/tpu-8t-and-tpu-8i-technical-deep-dive -
説明:TPU 8iの従来仕様と、Boardflyネットワークアーキテクチャについて解説しています。
-
Google Cloud – Introducing TPU Sync:KV Cacheと重みの転送ライブラリ
- リンク:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
説明:多階層メモリシステムと、KV Cacheのオフロードに関するテストデータを確認できます(Ironwoodを使用)。
-
Network World – Google targets AI’s next infrastructure bottlenecks:メディア向けブリーフィングの記事
- リンク:
networkworld.com/article/4245897 -
説明:TPU 8i MaxのHBM容量、帯域幅、SRAMの具体的な数値が掲載されています。
-
Google TPU Sync GitHub:オープンソースリポジトリ
- リンク:
github.com/google/tpu-sync - 説明:対応ハードウェアと開発状況について確認できます。
著者:APIYI技術チーム
技術に関するお問い合わせ:APIYI公式サイトのトップページからお気軽にお問い合わせください。導入に関する資料は、docs.apiyi.com のドキュメントセンターでもご覧いただけます。