El 9 de noviembre de 2026, Google Cloud presentó dos nuevas configuraciones de sistema para la octava generación de TPU: TPU 8tx y TPU 8i Max. TPU 8i Max integra dos TPU 8i en el mismo encapsulado y duplica a la vez la capacidad de cómputo, la SRAM en el chip y el ancho de banda de HBM. Está pensado para tareas de inferencia con contextos largos, alta concurrencia y colaboración entre varios agentes.
No se trata de un lanzamiento centrado únicamente en aumentar la capacidad de cómputo. La información ya está confirmada en el anuncio oficial de Google, en un anuncio de colaboración publicado al mismo tiempo por AMD y en resúmenes de varios medios. En lugar de enumerar las especificaciones del chip, este artículo usa cálculos reales de la caché KV para explicar algo importante: el cuello de botella de la inferencia con agentes está pasando de «qué tan rápido se calcula» a «si los datos llegan a tiempo a las unidades de cómputo».
Valor principal: al terminar de leer, podrás calcular cuánta memoria de GPU requiere una solicitud con un contexto largo, entender por qué se produce el muro de memoria y evaluar qué implican para tu servicio de agentes diseños de sistema como TPU 8i Max.
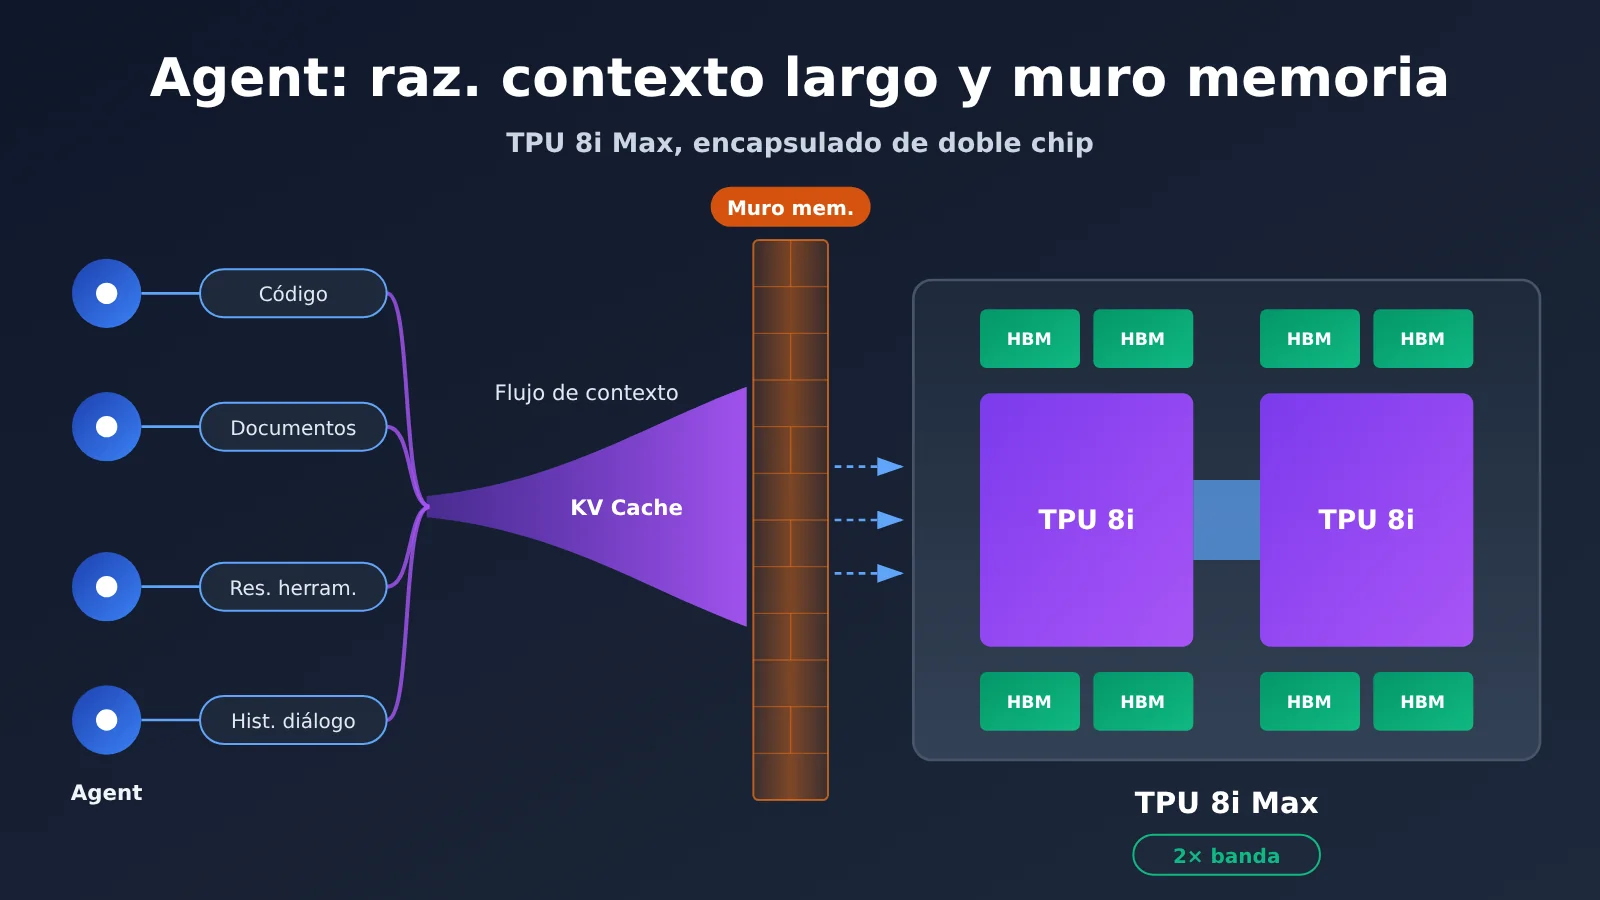
Resumen de la información clave sobre TPU 8i Max y los contextos largos de los agentes
| Información | Detalles |
|---|---|
| Fecha de lanzamiento | 9 de noviembre de 2026 |
| Anunciado por | Google Cloud |
| Naturaleza del producto | Una configuración de sistema de la octava generación de TPU, no un chip independiente con un diseño completamente nuevo |
| Tipo de encapsulado | Dos TPU 8i integradas en el mismo encapsulado |
| Mejoras confirmadas oficialmente | El doble de capacidad de cómputo, SRAM y ancho de banda HBM que TPU 8i |
| Parámetros revelados en una sesión informativa para medios | 384 GB de HBM, 17,2 TB/s de ancho de banda HBM y 768 MB de SRAM |
| Escenarios objetivo | Contextos largos, inferencia con alta concurrencia, colaboración entre varios agentes y análisis de videos largos, entre otros |
| Disponibilidad | La página oficial del producto indica «Coming soon»; todavía no se han anunciado el precio ni la fecha de disponibilidad general (GA) |
Conviene destacar que, en su anuncio, Google diferencia deliberadamente entre chip y system. El diseño de un chip puede tardar años, mientras que una configuración de sistema puede adaptarse más rápido a nuevas cargas de trabajo mediante cambios en el encapsulado, la memoria, la red y los componentes de seguridad. TPU 8i Max es precisamente el resultado de este enfoque: conserva el silicio de TPU 8i y los cambios se aplican en las capas del encapsulado y del sistema.
Por qué los contextos largos de los agentes consumen más memoria que los chats normales
En un chat normal suele haber un intercambio de pregunta y respuesta. El contexto crece poco a poco y, cuando termina la conversación, se puede descartar el estado. Los agentes funcionan de otra manera: dividen un objetivo en varias tareas, consultan continuamente fuentes externas, usan herramientas, siguen razonando a partir de los resultados y guardan el estado mientras esperan respuestas. El resultado de cada paso se añade al contexto, que no deja de crecer.
Por ejemplo, durante una tarea, un agente de desarrollo de software puede tener que manejar al mismo tiempo:
- Repositorio de código: cientos de archivos de código fuente y sus dependencias
- Documentación del proyecto: descripciones de la arquitectura, especificaciones de las interfaces y normas de codificación
- Historial de conversación: varias rondas de aclaraciones sobre los requisitos del usuario y sus comentarios sobre los cambios
- Resultados de herramientas: registros de compilación, resultados de pruebas y trazas de errores
- Resultados de subagentes: las respuestas de los subagentes encargados de las pruebas, la revisión y la refactorización
La concurrencia hace que el consumo sea aún mayor. Si un agente principal crea 4 subagentes, el sistema tendrá 5 contextos independientes al mismo tiempo. Cada contexto debe permanecer en memoria durante la inferencia. Por eso Google incluye la «colaboración entre varios agentes para desarrollar grandes proyectos de software» entre los escenarios típicos de TPU 8i Max. Cabe aclarar que la referencia de Google a contextos de «millones de tokens» describe los escenarios de uso previstos; no corresponde a un tamaño máximo de contexto fijo ya anunciado.
Cómo crece linealmente la KV Cache con los contextos largos de los agentes
Función de la KV Cache
Al generar cada token nuevo, el Transformer necesita usar el Query del token actual para calcular las puntuaciones de atención con las Key de todos los tokens anteriores. Después, utiliza los pesos obtenidos para calcular una suma ponderada de los Value históricos. Si volviera a calcular todas las Key y los Value anteriores cada vez que genera un token, la carga de cómputo crecería rápidamente con la longitud de la secuencia. La KV Cache guarda las Key y los Value ya calculados para reutilizarlos, a cambio de ocupar memoria.
El coste es que esta caché crece continuamente con la longitud del contexto y el número de solicitudes simultáneas. La siguiente fórmula de estimación se corresponde con la distribución de memoria de la KV Cache de vLLM:
M_KV = 2 × L × H_KV × D × B × T × N
| Parámetro | Significado | Valor para Llama 3.1 70B |
|---|---|---|
| 2 | Dos cachés: una para Key y otra para Value | 2 |
| L | Número de capas del Transformer | 80 |
| H_KV | Número de cabezas de atención Key/Value | 8 (GQA) |
| D | Dimensión de cada cabeza KV | 128 |
| B | Bytes por elemento | 2 (BF16) |
| T | Número de tokens por solicitud | Varía según el escenario |
| N | Número de solicitudes simultáneas | Varía según el escenario |
Caso de cálculo de la KV Cache de Llama 3.1 70B
Primero, calculemos el consumo de un solo token: 2 × 80 × 8 × 128 × 2 = 327,680 bytes, es decir, unos 320 KiB por token. Puede parecer poco, pero esta cifra crece rápidamente al multiplicarla por la longitud del contexto.
| Escenario | Longitud del contexto | Concurrencia | KV Cache teórica |
|---|---|---|---|
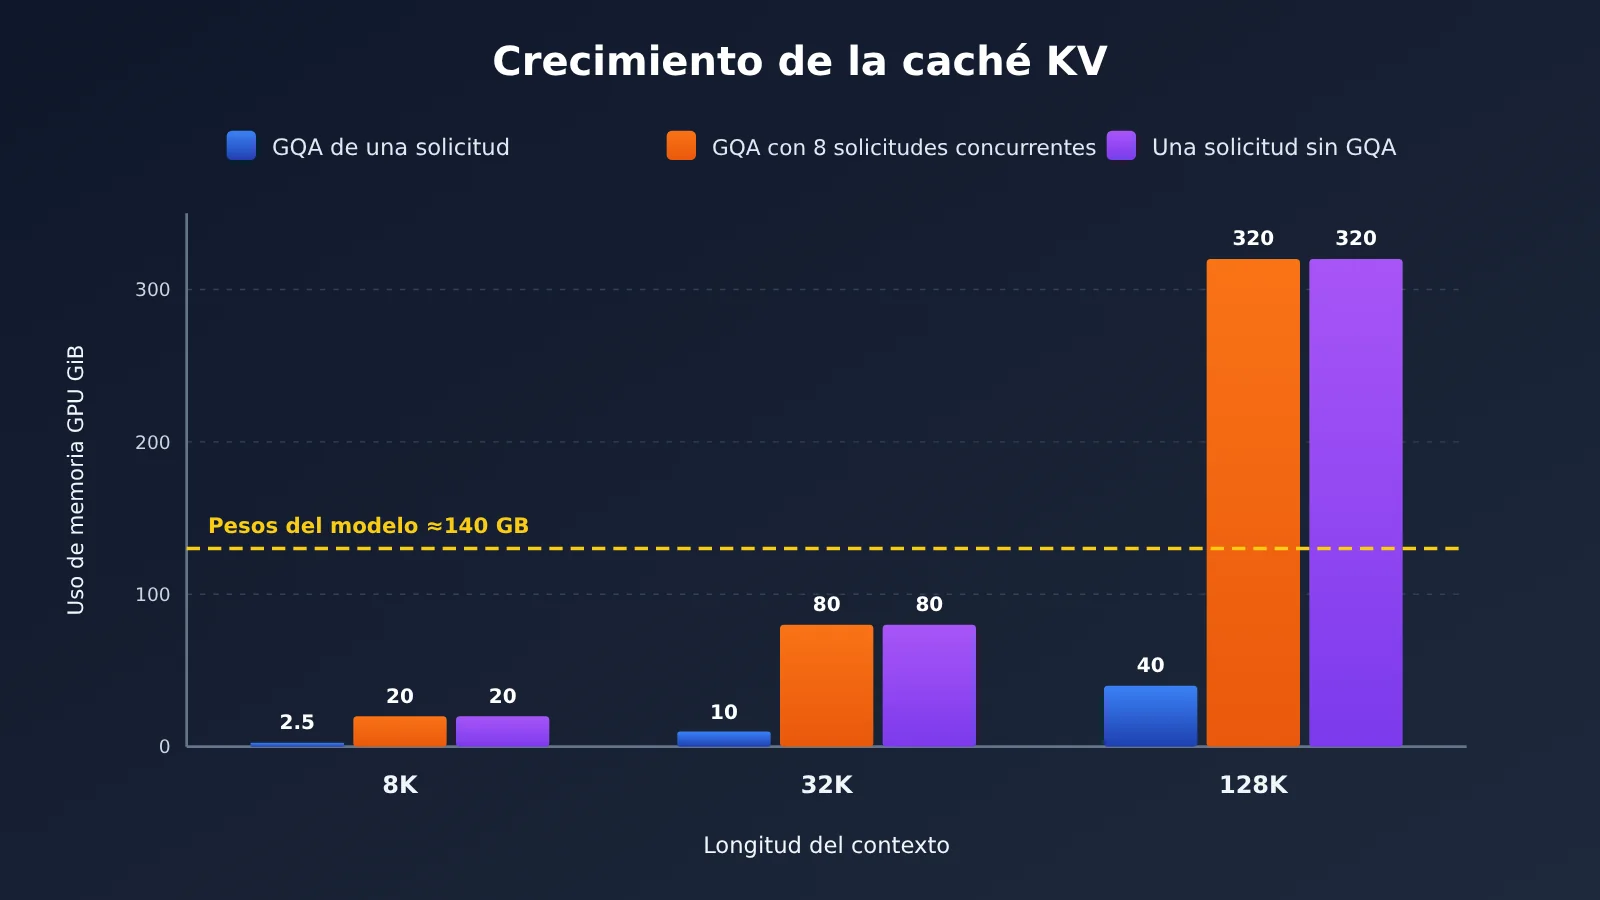
| Tarea corta | 8K | 1 | 2.5 GiB |
| Tarea de código de tamaño medio | 32K | 1 | 10 GiB |
| Agente con contexto largo | 128K | 1 | 40 GiB |
| Varios agentes en paralelo | 128K | 8 | 320 GiB |
Estas cifras solo incluyen la KV Cache; no contemplan los pesos del modelo, el espacio de trabajo en tiempo de ejecución ni la sobrecarga por fragmentación. Como referencia, almacenar los pesos de un modelo de 70B parámetros en BF16 requiere unos 140 GB. Es decir, la KV Cache necesaria para 8 sesiones concurrentes de 128K ya supera en más del doble el tamaño de los pesos del modelo.
Efecto de GQA en el consumo de memoria de la KV Cache
Llama 3.1 70B tiene 64 cabezas de atención, pero solo 8 cabezas KV. Eso es GQA (Grouped-Query Attention): cada grupo de 8 cabezas Query comparte un conjunto de Key/Value. En los cálculos hay que usar 8, no 64; de lo contrario, el resultado será 8 veces mayor.
Un escenario hipotético permite ver el valor de GQA. Si el modelo usara atención multicabezal estándar y las 64 cabezas conservaran sus propios KV, la KV Cache de una solicitud de 128K pasaría de 40 GiB a 320 GiB: una sola solicitud consumiría tanto como 8 solicitudes concurrentes con GQA. MQA reduce aún más la cantidad de cabezas KV, hasta dejarla en 1, lo que ahorra memoria, aunque también hay que valorar su impacto en la calidad del modelo. Además, cuantizar la KV Cache —por ejemplo, pasar de BF16 a 8 bits— puede reducir el consumo a la mitad, a cambio de tener que evaluar la pérdida de precisión.
El siguiente script reutiliza la fórmula anterior para ayudarte a estimar rápidamente el tamaño de la KV Cache de tu modelo con distintas longitudes de contexto y niveles de concurrencia:
def kv_cache_gib(layers, kv_heads, head_dim, bytes_per_elem, tokens, concurrency=1):
    """Estima la KV Cache con M_KV = 2 × L × H_KV × D × B × T × N; el resultado se expresa en GiB."""
    total = 2 * layers * kv_heads * head_dim * bytes_per_elem * tokens * concurrency
    return total / (1024 ** 3)

# Llama 3.1 70B: 80 capas, 8 cabezas KV, dimensión 128, BF16
for ctx in (8_192, 32_768, 131_072):
    print(f"{ctx:>7} tokens -> {kv_cache_gib(80, 8, 128, 2, ctx):.1f} GiB")

print("8 并发 x 128K ->", kv_cache_gib(80, 8, 128, 2, 131_072, 8), "GiB")
print("FP8 KV 量化 128K ->", kv_cache_gib(80, 8, 128, 1, 131_072), "GiB")
Qué es exactamente el muro de memoria en el razonamiento de contexto largo de los agentes
La capacidad, el ancho de banda y la SRAM son tres dimensiones independientes
El error más común al hablar del muro de memoria es confundir «mucha memoria» con «memoria rápida». En realidad, el sistema de memoria de un acelerador de IA abarca al menos tres métricas independientes:
| Métrica | Qué determina | Qué significa para un agente |
|---|---|---|
| Capacidad de HBM | Cuántos datos caben | Cuántos pesos del modelo y cuántas cachés KV se pueden mantener a la vez; es decir, cuántos contextos simultáneos se pueden admitir |
| Ancho de banda de HBM | Cuántos datos se pueden transferir por unidad de tiempo | Si los pesos y la caché KV pueden llegar rápidamente a los núcleos de cálculo al generar cada token |
| SRAM en el chip | Almacenamiento de alta velocidad más cercano a los núcleos de cálculo | Si los datos de acceso frecuente pueden mantenerse en el chip para reducir las esperas por los accesos repetidos a la HBM |
La HBM es, en esencia, DRAM que consigue un acceso muy paralelo mediante el apilamiento de varias capas y el uso de empaquetado avanzado. La SRAM es más rápida y está más cerca de las unidades de cálculo, pero su coste por unidad de capacidad es alto y su superficie física, limitada. Por eso los aceleradores modernos suelen emplear una jerarquía de memoria de varios niveles, en lugar de centrarse únicamente en aumentar la capacidad de un tipo de memoria.
Las necesidades de datos de Prefill y Decode son muy distintas
La inferencia de los LLM se divide en dos etapas. En Prefill, se procesa de una vez todo el contexto de entrada y se crea la caché KV. Se pueden calcular muchos tokens en paralelo, así que es una tarea típicamente limitada por el cálculo. En Decode, los tokens de salida se generan uno a uno: cada paso procesa un único token nuevo, pero debe leer todos los pesos y toda la caché KV. El cálculo es escaso y el volumen de transferencia de datos, elevado, por lo que es una tarea limitada por el ancho de banda.
Podemos hacernos una idea de la carga de Decode con una estimación idealizada. La caché KV de una solicitud de 128K es de unos 40 GiB (aproximadamente 43 GB) y hay que leerla completa para generar cada token. Con un ancho de banda de HBM de unos 8,6 TB/s por chip TPU 8i, leer solo la caché KV requiere unos 5 milisegundos; con los 17,2 TB/s de TPU 8i Max, el límite inferior es de unos 2,5 milisegundos. Esto es solo un límite teórico que no tiene en cuenta la lectura de pesos, el solapamiento con el cálculo ni la división del procesamiento en paralelo. Aun así, basta para mostrar que, cuanto más largo es el contexto, más depende el tiempo de Decode del movimiento de datos y menos del cálculo.
Por qué las unidades de cálculo se quedan «esperando datos»
Cuando un núcleo de cálculo puede realizar muchas más operaciones por segundo de las que la memoria puede alimentar, la unidad de cálculo queda ociosa mientras espera. Eso es el muro de memoria. En los agentes, los contextos largos aumentan la cantidad de datos que hay que leer en cada paso de Decode; un nivel alto de concurrencia incrementa la cantidad de caché KV que debe mantenerse disponible; y las rondas sucesivas de inferencia exigen volver a leer y actualizar la caché. Al combinarse estos tres factores, cada vez se obtiene menos beneficio marginal de aumentar únicamente el rendimiento máximo de cálculo.
🎯 Recomendación técnica: Antes de evaluar tu aplicación de agente, mide el tiempo hasta el primer token (TTFT) y la velocidad de generación con distintas longitudes de contexto, y observa cómo cambia la latencia a medida que este crece. Con APIYI, en apiyi.com, puedes alternar entre modelos como Claude, Gemini y GPT con la misma clave API, lo que facilita comparar su rendimiento con contextos largos.
Cómo amplía el encapsulado de doble chip del TPU 8i Max el ancho de banda de memoria
Cómo se combinan dos TPU 8i
TPU 8i Max es la cuarta configuración de sistema de la octava generación de TPU. Google observó que, cuando varios agentes procesan al mismo tiempo grandes bases de código, videos largos o documentos complejos, el cuello de botella suele estar no en la capacidad de cálculo, sino en la velocidad a la que los chips leen e intercambian datos. La solución consiste en integrar dos TPU 8i de baja latencia en un mismo encapsulado y colocar el doble de silicio en el mismo espacio de rack.
| Indicador | TPU 8i | TPU 8i Max | Variación |
|---|---|---|---|
| Encapsulado del chip | Un chip | Dos chips | — |
| Capacidad de cálculo | Base | 2 veces | Se duplica |
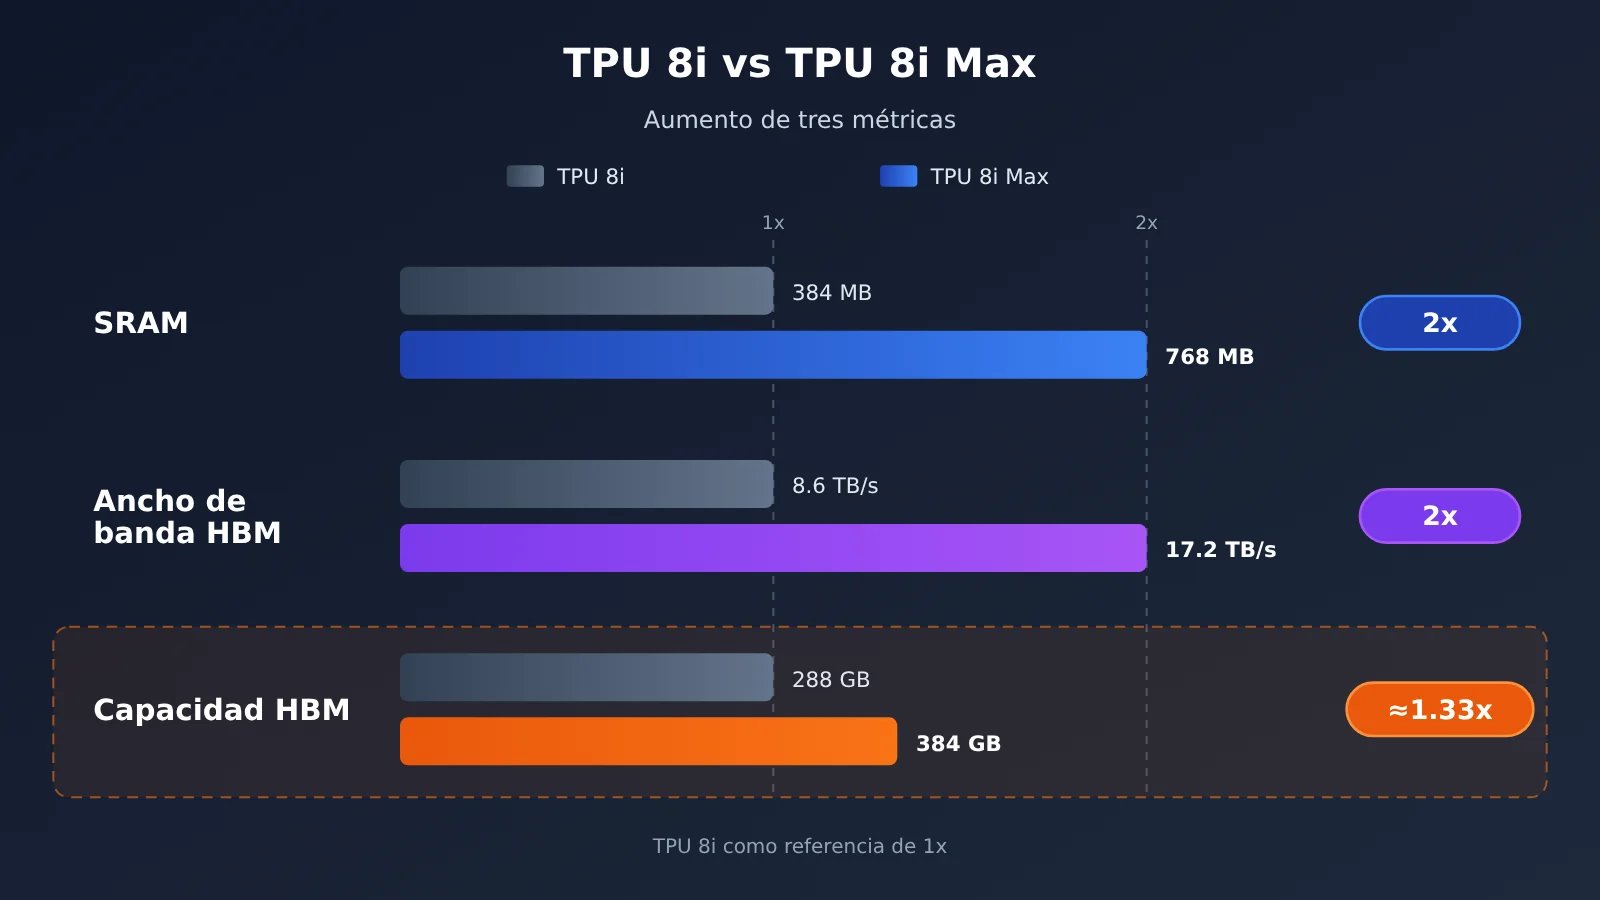
| SRAM en el chip | 384 MB | 768 MB | Se duplica |
| Ancho de banda de HBM | 8,601 GB/s | 17,200 GB/s | Aproximadamente se duplica |
| Capacidad de HBM | 288 GB | 384 GB | Aumenta aproximadamente un 33 % |
Nota: los datos del TPU 8i proceden de un artículo técnico sobre arquitectura de Google publicado en abril de 2026. Los valores absolutos del TPU 8i Max proceden de una nota informativa para medios del 9 de noviembre. En el cuerpo del artículo oficial se confirma explícitamente que la capacidad de cálculo, la SRAM y el ancho de banda de HBM se duplican.
Por qué tiene más sentido ampliar todo a la vez que aumentar solo la capacidad de cálculo
Si solo aumenta la capacidad de cálculo, la fase de decodificación quedará aún más limitada por el ancho de banda. Si solo aumenta el ancho de banda, es posible que las unidades de cálculo no se aprovechen por completo. El TPU 8i Max amplía la capacidad de cálculo, la SRAM y el ancho de banda de HBM en proporciones similares, de modo que la relación entre la velocidad de suministro de datos y la velocidad de cálculo se mantiene, en líneas generales, en el equilibrio del diseño original. Al duplicar la SRAM, también se mantienen más datos de uso frecuente en el chip, lo que reduce aún más los accesos de ida y vuelta a la HBM.
La capacidad de HBM solo aumenta aproximadamente un 33 %, no se duplica
Este es el detalle más fácil de indicar incorrectamente. El ancho de banda de HBM pasa de unos 8,6 TB/s a 17,2 TB/s, es decir, se duplica. Sin embargo, la capacidad de HBM solo pasa de 288 GB a 384 GB, un aumento de aproximadamente el 33 %. Los cálculos anteriores ayudan a entender lo que esto significa: el TPU 8i Max ofrece más ancho de banda por GB de memoria y lee más rápido una caché KV del mismo tamaño, pero el aumento de la cantidad total de contexto que puede almacenar a la vez es mucho menor que el del ancho de banda.
En otras palabras, el valor principal del TPU 8i Max no consiste en duplicar el límite de contexto de un único modelo, sino en permitir que el sistema gestione y procese de forma más eficiente muchos contextos simultáneos. Si la capacidad no es suficiente, siguen haciendo falta técnicas de software como la descarga de la caché KV, la cuantización y la distribución entre varios chips.
Comparación de la arquitectura de memoria de GPU y TPU 8i Max
Para entender el posicionamiento de TPU 8i Max, podemos tomar la arquitectura Rubin más reciente de NVIDIA como referencia de GPU.
| Dimensión | GPU NVIDIA Rubin | Google TPU 8i Max |
|---|---|---|
| Unidad de medida | Una GPU | Paquete de dos chips TPU |
| Capacidad HBM | 288 GB HBM4 | 384 GB HBM (según información publicada en medios) |
| Ancho de banda HBM | 22 TB/s | 17,2 TB/s (según información publicada en medios) |
| Memoria integrada en el chip | Depende de la configuración de la arquitectura | 768 MB SRAM (según información publicada en medios) |
| Interconexión entre chips | NVLink 6 | Red de baja latencia Boardfly (arquitectura TPU 8i) |
| Ecosistema de software | CUDA y los principales motores de inferencia | JAX, TorchTPU y backends de TPU para vLLM / SGLang |
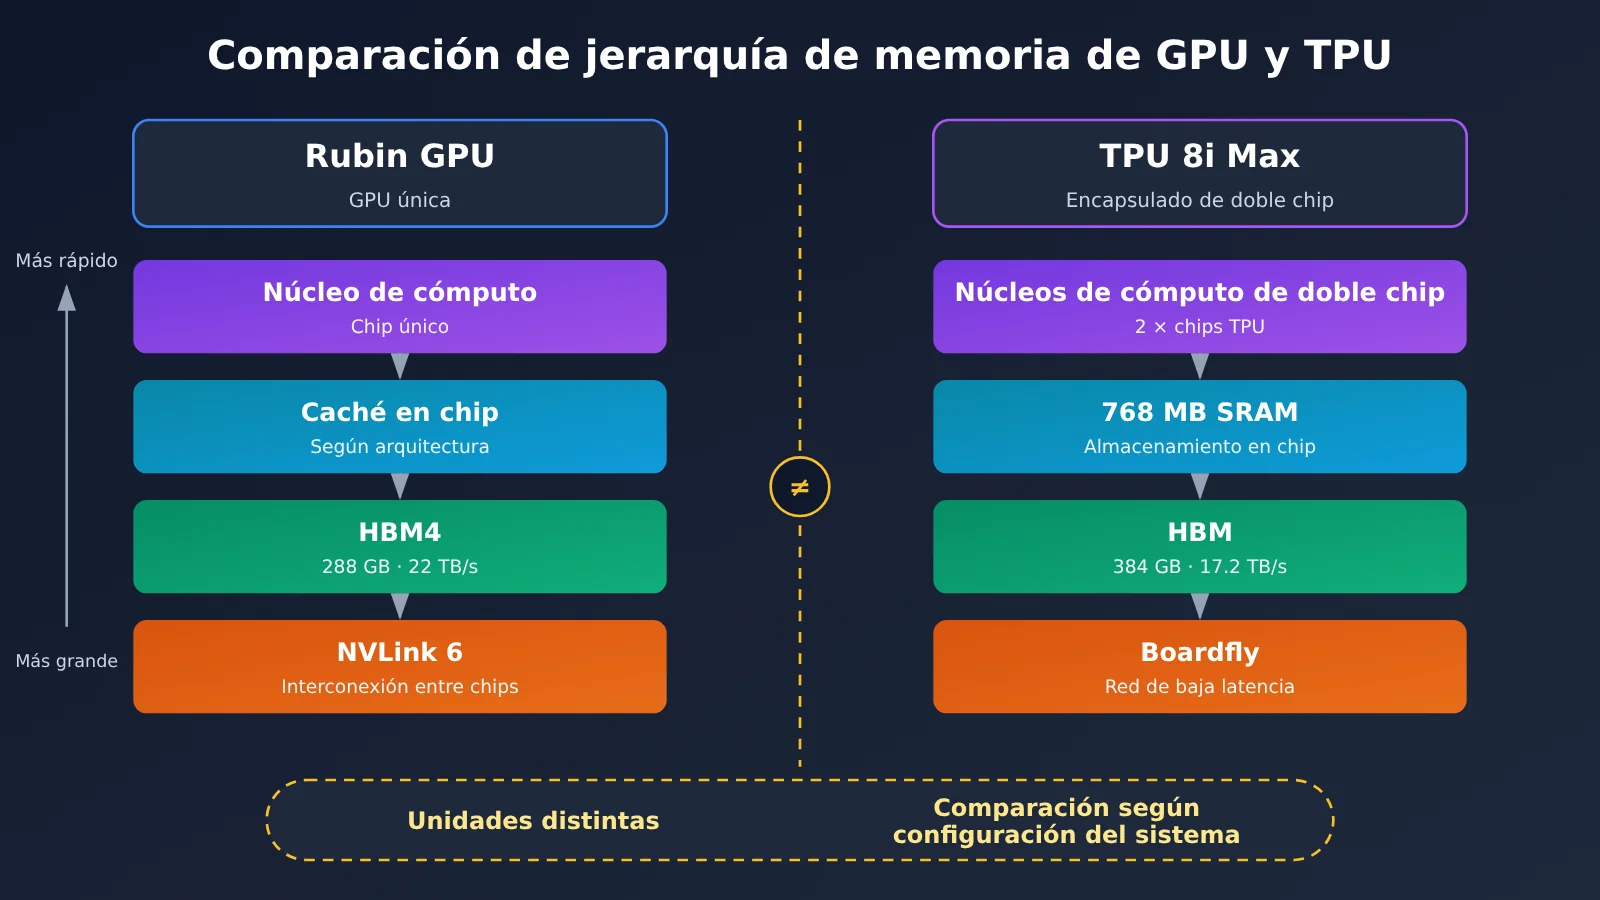
Esta tabla no permite establecer una clasificación sencilla. Los 384 GB y los 288 GB comparan un paquete de dos chips con una GPU individual. También son diferentes la generación de HBM, la interconexión, la arquitectura de cálculo y la configuración del sistema completo. Si nos fijamos solo en el ancho de banda, Rubin ofrece más por GPU; si miramos solo la capacidad, TPU 8i Max tiene más. Pero ninguno de estos datos debe analizarse por separado del tamaño del sistema.
Lo realmente importante es comparar cuántos contextos concurrentes efectivos puede mantener de forma estable todo el sistema, así como el rendimiento, la latencia y la eficiencia energética al hacerlo, con el mismo consumo, espacio en rack y costo. Al 10 de noviembre de 2026, todavía no hay pruebas independientes y verificables públicamente de TPU 8i Max. Para hacer este tipo de comparación a nivel de sistema, habrá que esperar a que se publiquen datos tras su comercialización.
💡 Recomendación: Para la mayoría de los equipos que crean agentes mediante API, no hace falta decidir si el modelo se ejecuta en GPU o TPU. Lo más práctico es comparar la latencia y el precio de cada modelo con contextos largos. Puedes probar varios modelos en paralelo mediante la interfaz unificada de APIYI (apiyi.com) y compararlos con indicaciones basadas en casos de uso reales.
Análisis del impacto de TPU 8i Max en el desarrollo de agentes
Diferencias entre la ventana de contexto, la concurrencia real y la latencia de inferencia
La ventana de contexto que anuncia un modelo solo indica cuánto contenido puede procesar en teoría. No significa que el servidor pueda admitir muchas solicitudes simultáneas con esa longitud ni que la latencia vaya a ser aceptable. Los cálculos anteriores ya muestran que, con la misma ventana de contexto de 128K, la caché KV de 8 sesiones es 8 veces mayor que la de una sola sesión. Para los desarrolladores, conviene distinguir entre estos tres indicadores:
- Ventana de contexto: el rango máximo que puede procesar el modelo; determina cuánto material se puede incluir en una sola solicitud.
- Capacidad de concurrencia real: cuántas sesiones largas pueden mantenerse simultáneamente con un hardware determinado; está limitada por la capacidad de HBM.
- Latencia de inferencia: el TTFT depende de la carga de cálculo del prefill, mientras que la velocidad de generación de tokens depende del ancho de banda y del tamaño de la caché KV.
Tres técnicas de mitigación que están ganando popularidad
El hardware es solo la mitad de la solución al muro de memoria; la otra mitad está en el software. TPU Sync, que Google publicó como código abierto al mismo tiempo, así como las versiones de vLLM y SGLang para TPU, giran en torno a estas técnicas:
| Técnica | Problema que resuelve | Coste o aspectos que tener en cuenta |
|---|---|---|
| Descarga de KV Cache | Traslada la caché que no se usa temporalmente de la HBM a la DRAM del host, a un SSD o al almacenamiento compartido, y así supera el límite de capacidad | Recuperarla requiere tiempo de transferencia y depende de un DMA eficiente y de transferencias asíncronas |
| Cuantización de KV Cache | Reduce los bytes por elemento y, con ello, el consumo de capacidad y ancho de banda | Hay que evaluar el impacto en la precisión |
| Separación de Prefill / Decode | Despliega Prefill, que requiere mucha computación, y Decode, que consume mucho ancho de banda, en nodos distintos | Se necesita transferir KV Cache rápidamente entre los nodos |
| Caché de prefijos | Reutiliza las mismas indicaciones del sistema y los prefijos del historial para evitar repetir Prefill | Depende de cuánto se repitan los prefijos de las solicitudes |
Los datos publicados por Google para TPU Sync muestran que la latencia de transferencia de KV Cache puede reducirse en más de un 90 %, y que, en escenarios con caché de prefijos de contexto de 64K, el TTFT puede disminuir hasta un 90 %. Sin embargo, estas pruebas se realizaron con la TPU Ironwood de séptima generación. Además, el README de GitHub indica que el hardware validado actualmente es v7x y v6e, así que estos resultados no se pueden considerar directamente como datos de rendimiento de la TPU 8i Max.
Impacto en el rendimiento real y el costo de los recursos
Para quienes llaman a la API, estas optimizaciones internas se traducen, en última instancia, en dos aspectos: si la latencia de las solicitudes con contextos largos es estable y si disminuye el costo de la facturación por Token. En tu aplicación también puedes aplicar la idea de «ocupar menos memoria»: simplifica la indicación del sistema y mantén estable el prefijo para aprovechar la caché; resume las salidas de las herramientas antes de volver a incluirlas en el contexto; y pasa a los subagentes solo los fragmentos que necesitan, en lugar de todo el historial.
El siguiente ejemplo mide la latencia hasta el primer Token con salida en streaming para distintas longitudes de contexto. Así podrás observar cómo afecta el crecimiento del contexto al Prefill:
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

def measure_ttft(context: str, model: str = "gpt-4o-mini") -> float:
    start = time.perf_counter()
    stream = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": context + "\n请用一句话总结上文。"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            return time.perf_counter() - start
    return -1.0

print(f"TTFT: {measure_ttft('示例代码片段 ' * 2000):.2f}s")
Ver el código de prueba por lotes con varios modelos y longitudes
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Una sola clave para cambiar entre varios modelos
)

MODELS = ["gpt-4o-mini", "claude-sonnet-4", "gemini-2.5-flash"]
LENGTHS = [1_000, 5_000, 20_000]  # Número de repeticiones del fragmento, como aproximación para ampliar el contexto

def run_once(model: str, repeat: int) -> dict:
    context = "def handler(event):\n    return process(event)\n" * repeat
    start = time.perf_counter()
    first, tokens = None, 0
    try:
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": context + "\n指出上面代码的潜在问题。"}],
            stream=True,
            max_tokens=200,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                tokens += 1
                if first is None:
                    first = time.perf_counter() - start
        total = time.perf_counter() - start
        return {"model": model, "repeat": repeat, "ttft": first, "total": total, "chunks": tokens}
    except Exception as e:
        return {"model": model, "repeat": repeat, "error": str(e)}

for m in MODELS:
    for n in LENGTHS:
        print(run_once(m, n))
🚀 Empieza rápido: regístrate en APIYI, en apiyi.com, para obtener crédito de prueba gratuito. Deja
base_urlcomohttps://api.apiyi.com/v1en el script anterior y, en unos minutos, tendrás las curvas de TTFT de varios modelos para distintas longitudes de contexto.
Impacto en el sector
- Aceleración de la personalización a nivel de sistema: Google está lanzando rápidamente configuraciones para cargas de trabajo específicas con el enfoque «mismo silicio, distintos sistemas». Esto demuestra que la competencia entre aceleradores está pasando de centrarse en las especificaciones de un solo chip a hacerlo en el diseño del sistema.
- La colaboración entre hardware y software se vuelve estándar: TPU 8i Max se presentó junto con TPU Sync, Agent Compute Engine y un motor de inferencia para TPU. Resolver el problema del muro de memoria depende tanto del ancho de banda del hardware como de la planificación del software.
- La comercialización aún está en sus primeras etapas: TPU 8i Max, al igual que 8t, 8i y 8tx, aparece como Coming soon. Todavía no se han anunciado precios públicos ni una fecha oficial de disponibilidad, por lo que queda por comprobar su relación rendimiento-precio en la práctica.
Preguntas frecuentes
Q1: ¿Qué es TPU 8i Max?
TPU 8i Max es una configuración de sistema TPU de octava generación que Google presentó el 9 de noviembre de 2026. Integra dos TPU 8i en el mismo encapsulado y duplica la capacidad de cálculo, la SRAM en chip y el ancho de banda de HBM con respecto a TPU 8i. Está pensado principalmente para inferencias con contextos largos, alta concurrencia y colaboración entre varios agentes. No se trata de un chip de diseño completamente nuevo.
Q2: ¿Se ha duplicado la capacidad de HBM de TPU 8i Max?
No. Según la información divulgada en el informe para medios, la capacidad de HBM aumenta de 288 GB a 384 GB, aproximadamente un 33 %. Lo que se duplica es el ancho de banda de HBM (de unos 8,6 TB/s a 17,2 TB/s) y la SRAM (de 384 MB a 768 MB). La capacidad y el ancho de banda son dos métricas independientes y no deben confundirse.
Q3: ¿Ya se puede usar TPU 8i Max? ¿Cuánto cuesta?
A 10 de noviembre de 2026, la página oficial del producto en Google Cloud indica que TPU 8i Max estará Coming soon. Todavía no se han anunciado precios públicos ni una fecha oficial de disponibilidad general (GA), y tampoco hay pruebas de rendimiento independientes que puedan verificarse públicamente. Por ahora, solo se pueden consultar las declaraciones oficiales de Google y los parámetros del informe para medios.
Q4: ¿TPU 8i Max permite que un solo modelo admita un contexto de un millón de tokens?
Google señala que los contextos de hasta un millón de tokens son uno de los escenarios previstos, pero no ha anunciado esta cifra como el límite máximo fijo de contexto. La longitud de contexto que puede procesar un modelo depende, ante todo, del propio modelo. El hardware determina cuánta concurrencia puede mantenerse con esa longitud y si la latencia resulta aceptable.
Q5: ¿Cómo pueden los desarrolladores de aplicaciones comprobar el efecto del contexto largo en la latencia?
La forma más directa es medir el TTFT y la velocidad de generación con contextos reales de distintas longitudes:
1. Visita APIYI en apiyi.com, regístrate y obtén una clave API y un cupo gratuito de prueba.
2. Usa el script de prueba de este artículo y establece `base_url` en `https://api.apiyi.com/v1`.
3. Cambia entre varios modelos con el mismo conjunto de contextos y compara cómo aumenta la latencia a medida que crece la longitud.
Q6: ¿Qué limitaciones tienen la cuantización y la descarga de la KV Cache?
La cuantización puede reducir directamente el uso de memoria y de ancho de banda, pero también puede afectar a la precisión, por lo que debe evaluarse con la tarea prevista. La descarga permite superar el límite de capacidad de HBM, pero recuperar los datos requiere tiempo de transferencia. Si la transferencia entre niveles de almacenamiento no es lo bastante rápida, puede aumentar la latencia. En ambos casos, es necesario ajustar la configuración teniendo en cuenta el nivel de concurrencia y los objetivos de latencia.
Puntos clave sobre contextos largos de los agentes y TPU 8i Max
- El cuello de botella está cambiando: la inferencia de agentes está pasando de priorizar la potencia de cálculo a buscar un equilibrio entre el cálculo y el suministro de datos a la memoria.
- La caché KV crece de forma lineal: Llama 3.1 70B requiere unos 320 KiB por token; una solicitud de 128K tokens ocupa alrededor de 40 GiB.
- GQA es clave: sus 8 cabezales KV reducen la caché a una octava parte de la que requiere la atención multi-cabeza estándar.
- La decodificación consume ancho de banda: cada token generado requiere leer toda la caché KV; con contextos largos, el ancho de banda determina la latencia.
- Escalado sincronizado: TPU 8i Max duplica a la vez la potencia de cálculo, la SRAM y el ancho de banda de HBM, mientras que la capacidad de HBM solo aumenta alrededor de un 33 %.
- El software también importa: la descarga a memoria, la cuantización, la separación entre Prefill y Decode, y la caché de prefijos son las principales herramientas para mitigar el muro de memoria.
- Pruebas prácticas: puedes usar la interfaz unificada de APIYI (apiyi.com) para medir la latencia de contexto largo de varios modelos.
Resumen
Estos son los aspectos clave del muro de memoria en la inferencia de agentes con contextos largos:
- Origen de la presión: el código, los resultados de las herramientas y las respuestas de los subagentes se acumulan de forma continua. Al sumarse la concurrencia de varios agentes, la caché KV puede crecer rápidamente.
- Enfoque de hardware: TPU 8i Max no se limita a añadir potencia de cálculo; amplía a la vez la capacidad de cálculo, la SRAM y el ancho de banda de HBM para mantener el equilibrio entre el suministro de datos y el cálculo.
- Límites de aplicación: el aumento de la capacidad de HBM es limitado y el producto aún no está disponible comercialmente. Su valor real tendrá que comprobarse con mediciones del sistema completo.
Para la mayoría de los desarrolladores, lo más práctico por ahora es entender la estructura de costos de la caché KV, controlar el crecimiento del contexto desde la aplicación y seguir de cerca los cambios en la latencia y el precio de los servicios de modelos con contextos largos. Recomendamos usar datos reales de negocio en APIYI (apiyi.com) para comparar el rendimiento de varios modelos con contextos largos. La plataforma ofrece una interfaz compatible con OpenAI y crédito gratuito para nuevos usuarios.
📚 Referencias
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max: anuncio técnico oficial del lanzamiento
- Enlace:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
Descripción: confirma el empaquetado de dos chips y la duplicación de la capacidad de cálculo, la SRAM y el ancho de banda de HBM
-
Google Cloud – Inside the eighth-generation TPU: análisis detallado de la arquitectura TPU de octava generación
- Enlace:
cloud.google.com/blog/products/compute/tpu-8t-and-tpu-8i-technical-deep-dive -
Descripción: especificaciones originales de TPU 8i y arquitectura de red Boardfly
-
Google Cloud – Introducing TPU Sync: biblioteca para transferir KV Cache y pesos
- Enlace:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
Descripción: jerarquía de memoria y datos de pruebas de descarga de KV Cache (basados en Ironwood)
-
Network World – Google targets AI’s next infrastructure bottlenecks: cobertura de prensa
- Enlace:
networkworld.com/article/4245897 -
Descripción: cifras absolutas de capacidad y ancho de banda de HBM, y de SRAM, de TPU 8i Max
-
Google TPU Sync GitHub: repositorio de código abierto
- Enlace:
github.com/google/tpu-sync - Descripción: información sobre el hardware compatible y el estado del desarrollo
Autor: Equipo técnico de APIYI
Consultas técnicas: Contáctanos desde la página de inicio del sitio web de APIYI. Puedes encontrar más información de integración en el centro de documentación docs.apiyi.com.