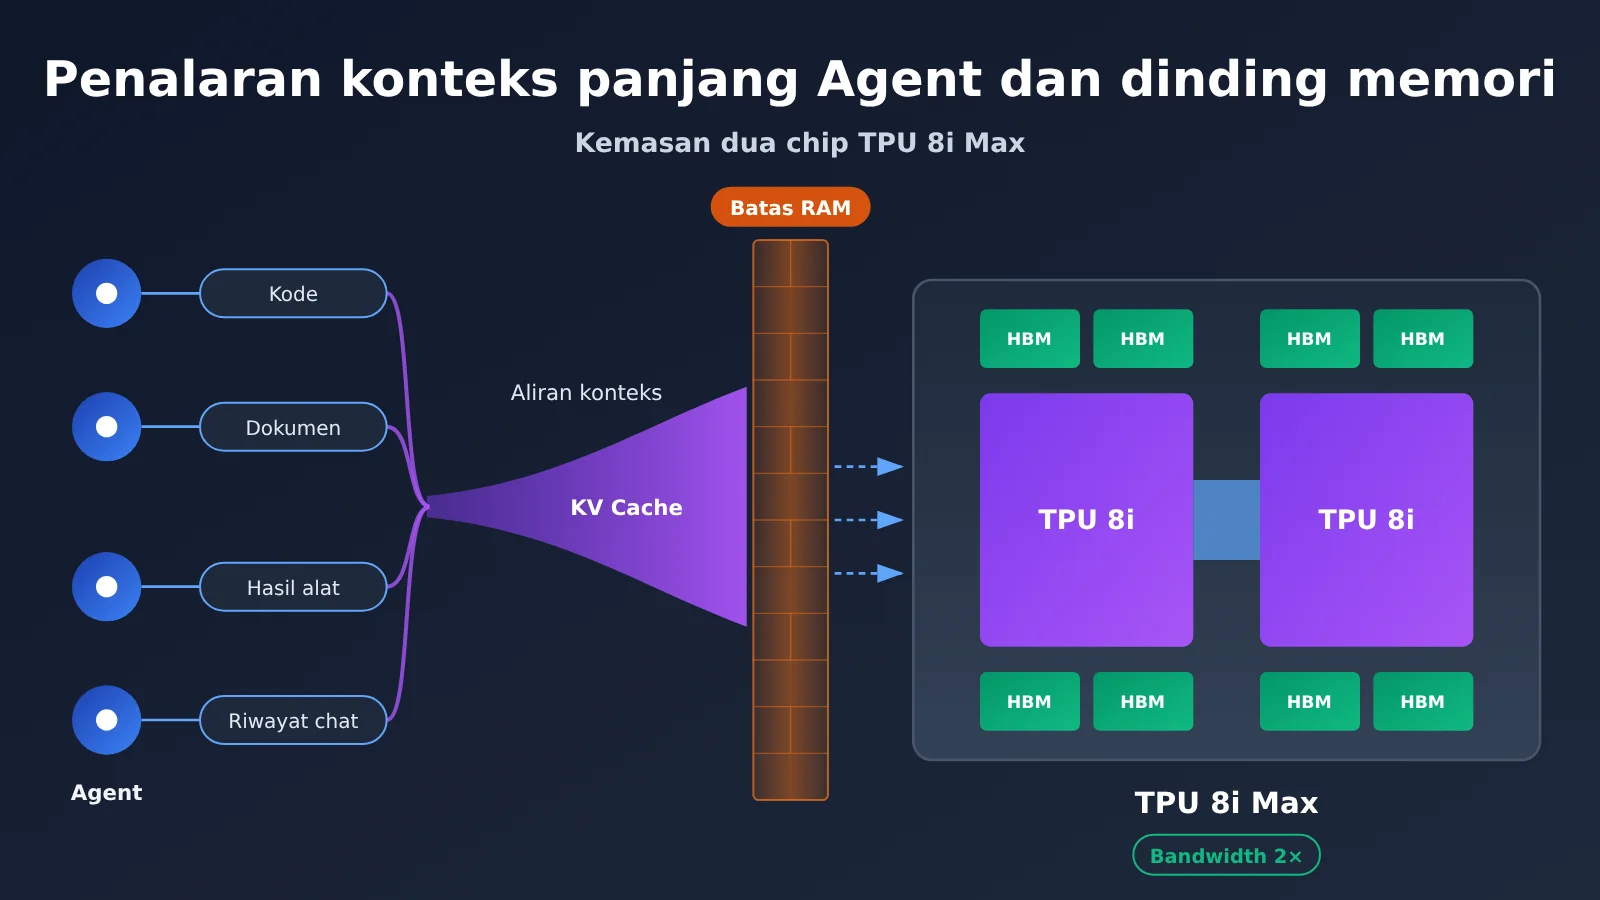
9 November 2026, Google Cloud merilis dua konfigurasi sistem baru untuk TPU generasi kedelapan: TPU 8tx dan TPU 8i Max. TPU 8i Max mengintegrasikan dua TPU 8i dalam satu kemasan. Kapasitas komputasi, SRAM on-chip, dan bandwidth HBM meningkat dua kali lipat. Sistem ini ditujukan untuk skenario dengan konteks panjang, konkurensi tinggi, dan penalaran kolaboratif oleh banyak Agent.
Ini bukan sekadar peluncuran yang menumpuk kapasitas komputasi. Informasi terkait telah dikonfirmasi melalui pengumuman resmi Google, pengumuman kerja sama AMD yang dirilis pada waktu yang sama, serta laporan singkat dari berbagai media. Artikel ini tidak merinci spesifikasi chip, melainkan menggunakan perhitungan nyata KV Cache untuk menjelaskan satu hal: hambatan dalam penalaran Agent mulai bergeser dari “seberapa cepat komputasi dilakukan” menjadi “apakah data dapat dikirim ke unit komputasi tepat waktu”.
Manfaat utama: Setelah membaca artikel ini, kamu bisa memperkirakan sendiri berapa banyak memori GPU yang dibutuhkan oleh permintaan dengan konteks panjang, memahami penyebab terjadinya hambatan memori, dan menilai dampak desain sistem seperti TPU 8i Max terhadap layanan Agent-mu.
Ringkasan Informasi Utama TPU 8i Max dan Konteks Panjang untuk Agent
| Informasi | Detail |
|---|---|
| Tanggal rilis | 9 November 2026 |
| Pihak yang merilis | Google Cloud |
| Jenis produk | Konfigurasi sistem TPU generasi kedelapan, bukan chip mandiri dengan desain baru |
| Kemasan | Dua TPU 8i diintegrasikan dalam satu kemasan |
| Peningkatan yang dikonfirmasi secara resmi | Kemampuan komputasi, SRAM, dan bandwidth HBM masing-masing 2 kali lipat dibandingkan TPU 8i |
| Spesifikasi yang diungkapkan dalam pengarahan media | HBM 384 GB, bandwidth HBM 17,2 TB/s, SRAM 768 MB |
| Skenario penggunaan yang dituju | Konteks panjang, inferensi serentak dalam skala besar, kolaborasi multi-Agent, analisis video panjang, dan lainnya |
| Status ketersediaan | Halaman produk resmi mencantumkan Coming soon; harga dan tanggal GA belum diumumkan |
Perlu ditekankan bahwa dalam pengumumannya, Google sengaja membedakan antara chip dan sistem. Siklus desain chip dihitung dalam hitungan tahun, sedangkan konfigurasi sistem dapat lebih cepat disesuaikan dengan beban kerja baru melalui perubahan pada kemasan, memori, jaringan, dan komponen keamanan. TPU 8i Max merupakan hasil dari pendekatan ini: silikon yang digunakan tetap TPU 8i, sementara perubahan terjadi pada tingkat kemasan dan sistem.
Mengapa Konteks Panjang untuk Agent Lebih Boros Memori daripada Obrolan Biasa
Obrolan biasa umumnya berlangsung dalam pola “tanya jawab”, sehingga konteks bertambah perlahan dan statusnya bisa dibuang setelah sesi berakhir. Agent berbeda: Agent memecah satu tujuan menjadi beberapa subtugas, terus membaca materi eksternal, menggunakan alat, lalu melanjutkan penalaran berdasarkan umpan balik. Status juga perlu disimpan sambil menunggu hasil. Setiap keluaran dari langkah-langkah ini ditambahkan kembali ke konteks, sehingga konteks terus bertambah.
Sebagai contoh, dalam satu tugas, Agent pengembang perangkat lunak mungkin harus menangani semua hal berikut sekaligus:
- Repositori kode: ratusan file kode sumber beserta dependensinya
- Dokumentasi proyek: penjelasan arsitektur, kesepakatan antarmuka, dan standar pengodean
- Riwayat percakapan: beberapa putaran klarifikasi kebutuhan pengguna dan masukan revisi
- Hasil alat: log kompilasi, keluaran pengujian, dan tumpukan galat
- Keluaran sub-Agent: hasil yang dikembalikan masing-masing sub-Agent untuk pengujian, peninjauan, dan refaktor
Yang lebih penting adalah konkurensi. Ketika satu Agent utama membuat 4 sub-Agent, ada 5 konteks independen yang aktif secara bersamaan di dalam sistem. Setiap konteks harus tetap berada di memori selama proses inferensi. Inilah alasan Google menyebut “kolaborasi multi-Agent untuk mengembangkan proyek perangkat lunak berskala besar” sebagai salah satu skenario utama TPU 8i Max. Perlu diperjelas bahwa “konteks berskala jutaan Token” yang disebut Google menggambarkan skenario penggunaan yang dituju, bukan spesifikasi batas maksimum konteks tetap yang sudah diumumkan.
Bagaimana KV Cache Tumbuh Linear Seiring Panjang Konteks Agent
Fungsi KV Cache
Saat menghasilkan setiap Token baru, Transformer perlu menggunakan Query dari Token saat ini untuk menghitung skor perhatian terhadap Key dari semua Token sebelumnya, lalu menjumlahkan Value dari Token sebelumnya secara berbobot menggunakan bobot yang diperoleh. Jika semua Key dan Value dari riwayat dihitung ulang setiap kali menghasilkan Token, beban komputasi akan meningkat tajam seiring bertambahnya panjang konteks. KV Cache menyimpan Key dan Value yang sudah dihitung untuk Token sebelumnya agar bisa digunakan kembali, sehingga memori ditukar dengan penghematan komputasi.
Konsekuensinya, cache ini terus membesar seiring bertambahnya panjang konteks dan jumlah permintaan yang berjalan bersamaan. Rumus estimasi berikut sesuai dengan tata letak memori KV Cache di vLLM:
M_KV = 2 × L × H_KV × D × B × T × N
| Parameter | Makna | Nilai untuk Llama 3.1 70B |
|---|---|---|
| 2 | Dua cache untuk Key dan Value | 2 |
| L | Jumlah layer Transformer | 80 |
| H_KV | Jumlah head perhatian Key/Value | 8 (GQA) |
| D | Dimensi setiap KV Head | 128 |
| B | Jumlah byte per elemen | 2 (BF16) |
| T | Jumlah Token per permintaan | Bergantung pada skenario |
| N | Jumlah permintaan yang berjalan bersamaan | Bergantung pada skenario |
Contoh Perhitungan KV Cache Llama 3.1 70B
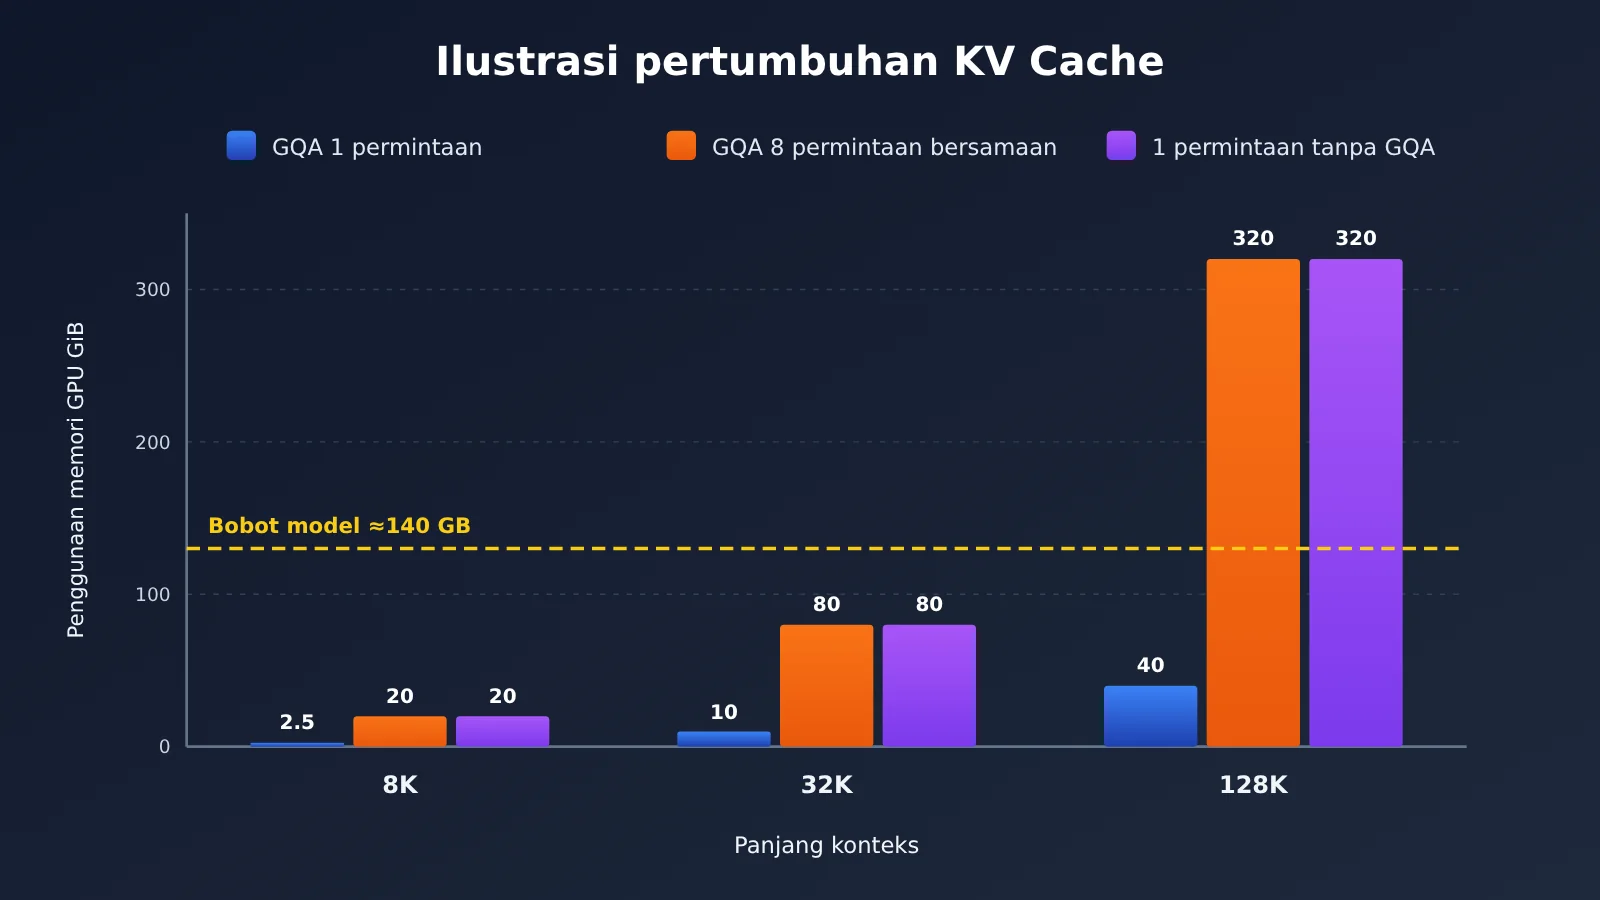
Pertama, hitung untuk satu Token: 2 × 80 × 8 × 128 × 2 = 327,680 byte, atau sekitar 320 KiB per Token. Angka ini tampak kecil, tetapi akan cepat membesar seiring bertambahnya panjang konteks.
| Skenario | Panjang konteks | Jumlah konkurensi | KV Cache teoretis |
|---|---|---|---|
| Tugas singkat | 8K | 1 | 2.5 GiB |
| Tugas kode menengah | 32K | 1 | 10 GiB |
| Agent dengan konteks panjang | 128K | 1 | 40 GiB |
| Beberapa Agent berjalan paralel | 128K | 8 | 320 GiB |
Perhitungan di atas hanya mencakup KV Cache, belum termasuk bobot model, ruang kerja runtime, dan overhead fragmentasi. Sebagai perbandingan, model dengan 70B parameter membutuhkan sekitar 140 GB hanya untuk menyimpan bobotnya dalam BF16. Artinya, KV Cache yang dibutuhkan untuk 8 sesi serentak dengan konteks 128K sudah lebih dari dua kali ukuran bobot model.
Dampak GQA terhadap Penggunaan Memori KV Cache
Llama 3.1 70B memiliki 64 Attention Head, tetapi hanya 8 KV Head. Inilah yang disebut GQA (Grouped-Query Attention): setiap 8 Query Head berbagi satu kelompok Key/Value. Dalam perhitungan, gunakan 8, bukan 64. Jika menggunakan 64, hasilnya akan 8 kali lebih besar.
Simulasi dengan asumsi sebaliknya bisa menunjukkan manfaat GQA. Jika model ini menggunakan multi-head attention standar dan masing-masing dari 64 head memiliki KV sendiri, KV Cache untuk satu permintaan 128K akan meningkat dari 40 GiB menjadi 320 GiB—setara dengan seluruh penggunaan untuk 8 permintaan serentak dalam skenario GQA. MQA mengurangi jumlah KV Head menjadi 1 sehingga lebih hemat memori, tetapi dampaknya terhadap kualitas model juga perlu dipertimbangkan. Selain itu, kuantisasi KV Cache—misalnya menurunkan presisi dari BF16 ke 8 bit—dapat memangkas penggunaan memori hingga setengahnya, dengan konsekuensi perlu mengevaluasi penurunan akurasi.
Skrip berikut bisa langsung digunakan dengan rumus di atas untuk memperkirakan ukuran KV Cache model Anda berdasarkan panjang konteks dan jumlah konkurensi:
def kv_cache_gib(layers, kv_heads, head_dim, bytes_per_elem, tokens, concurrency=1):
    """Perkirakan KV Cache dengan rumus M_KV = 2 × L × H_KV × D × B × T × N, dalam satuan GiB"""
    total = 2 * layers * kv_heads * head_dim * bytes_per_elem * tokens * concurrency
    return total / (1024 ** 3)

# Llama 3.1 70B: 80 lapisan, 8 KV Head, dimensi 128, BF16
for ctx in (8_192, 32_768, 131_072):
    print(f"{ctx:>7} tokens -> {kv_cache_gib(80, 8, 128, 2, ctx):.1f} GiB")

print("8 并发 x 128K ->", kv_cache_gib(80, 8, 128, 2, 131_072, 8), "GiB")
print("FP8 KV 量化 128K ->", kv_cache_gib(80, 8, 128, 1, 131_072), "GiB")
Apa sebenarnya dinding memori dalam penalaran Agent dengan konteks panjang?
Kapasitas, bandwidth, dan SRAM adalah tiga aspek yang berbeda
Kesalahpahaman paling umum saat membahas dinding memori adalah menganggap “memori besar” sama dengan “memori cepat”. Padahal, sistem memori akselerator AI setidaknya memiliki tiga metrik yang saling independen:
| Metrik | Menentukan | Artinya bagi Agent |
|---|---|---|
| Kapasitas HBM | Banyaknya data yang dapat ditampung | Berapa banyak bobot model dan KV Cache yang bisa disimpan sekaligus, yang menentukan jumlah konteks bersamaan |
| Bandwidth HBM | Banyaknya data yang dapat dipindahkan dalam satuan waktu | Seberapa cepat bobot dan KV Cache dapat dikirim ke inti komputasi setiap kali Token dihasilkan |
| SRAM on-chip | Penyimpanan berkecepatan tinggi yang paling dekat dengan inti komputasi | Apakah data yang sering digunakan dapat disimpan di chip sehingga waktu tunggu akibat akses HBM berulang bisa dikurangi |
Pada dasarnya, HBM adalah DRAM yang memanfaatkan tumpukan berlapis dan pengemasan canggih untuk mendukung akses paralel tingkat tinggi. SRAM lebih cepat dan lebih dekat ke unit komputasi, tetapi biaya per satuan kapasitasnya tinggi dan luas fisiknya terbatas. Inilah alasan akselerator modern umumnya menggunakan hierarki memori bertingkat, alih-alih hanya mengejar kapasitas satu jenis memori.
Kebutuhan data Prefill dan Decode sangat berbeda
Inferensi LLM terbagi menjadi dua tahap. Pada tahap Prefill, seluruh konteks masukan diproses sekaligus dan KV Cache dibuat. Banyak Token dapat dihitung secara paralel, sehingga tugas ini umumnya intensif komputasi. Pada tahap Decode, Token keluaran dihasilkan satu per satu. Setiap langkah hanya memproses satu Token baru, tetapi harus membaca semua bobot dan seluruh KV Cache. Jumlah komputasinya kecil, sedangkan data yang perlu dipindahkan sangat banyak, sehingga tahap ini umumnya intensif bandwidth.
Kita bisa memperkirakan tekanan pada Decode dengan perhitungan sederhana. KV Cache untuk satu permintaan 128K berukuran sekitar 40 GiB (sekitar 43 GB), dan harus dibaca seluruhnya setiap kali sebuah Token dihasilkan. Dengan bandwidth HBM sekitar 8,6 TB/s pada satu chip TPU 8i, membaca KV Cache saja membutuhkan sekitar 5 milidetik. Pada TPU 8i Max dengan bandwidth 17,2 TB/s, batas bawahnya sekitar 2,5 milidetik. Angka ini hanya batas bawah teoretis karena mengabaikan pembacaan bobot, tumpang tindih komputasi, dan pembagian beban secara paralel. Namun, angka tersebut cukup menunjukkan bahwa semakin panjang konteks, semakin besar peran pemindahan data—bukan komputasi—dalam menentukan waktu Decode.
Mengapa unit komputasi bisa “menunggu data”?
Ketika jumlah operasi yang dapat diselesaikan inti komputasi per detik jauh lebih tinggi daripada jumlah data yang dapat disediakan memori per detik, unit komputasi akan menganggur sambil menunggu. Inilah yang disebut dinding memori. Bagi Agent, konteks yang panjang memperbesar jumlah data yang harus dibaca pada setiap langkah Decode, konkurensi tinggi menambah jumlah KV Cache yang perlu disimpan, dan penalaran multi-putaran mengharuskan cache dibaca serta diperbarui berulang kali. Ketiganya saling memperkuat, sehingga manfaat tambahan dari peningkatan daya komputasi puncak semakin kecil.
🎯 Saran teknis: Sebelum mengevaluasi aplikasi Agent Anda, sebaiknya ukur waktu hingga Token pertama (TTFT) dan kecepatan keluaran pada beberapa panjang konteks. Amati bagaimana latensi berubah seiring bertambahnya konteks. Melalui APIYI apiyi.com, Anda bisa beralih antara model Claude, Gemini, GPT, dan lainnya menggunakan kunci API yang sama untuk membandingkan performa konteks panjang setiap model.
Bagaimana Kemasan Dua Chip TPU 8i Max Memperluas Bandwidth Memori
Cara Dua TPU 8i Digabungkan
TPU 8i Max adalah konfigurasi sistem keempat untuk TPU generasi kedelapan. Google menemukan bahwa saat beberapa Agent bekerja secara bersamaan dengan basis kode besar, video berdurasi panjang, atau dokumen kompleks, hambatannya sering kali bukan kemampuan komputasi, melainkan kecepatan chip membaca dan bertukar data. Solusinya adalah mengintegrasikan dua TPU 8i berlatensi rendah ke dalam satu kemasan, sehingga jumlah silikon menjadi 2 kali lipat dalam luas rak yang sama.
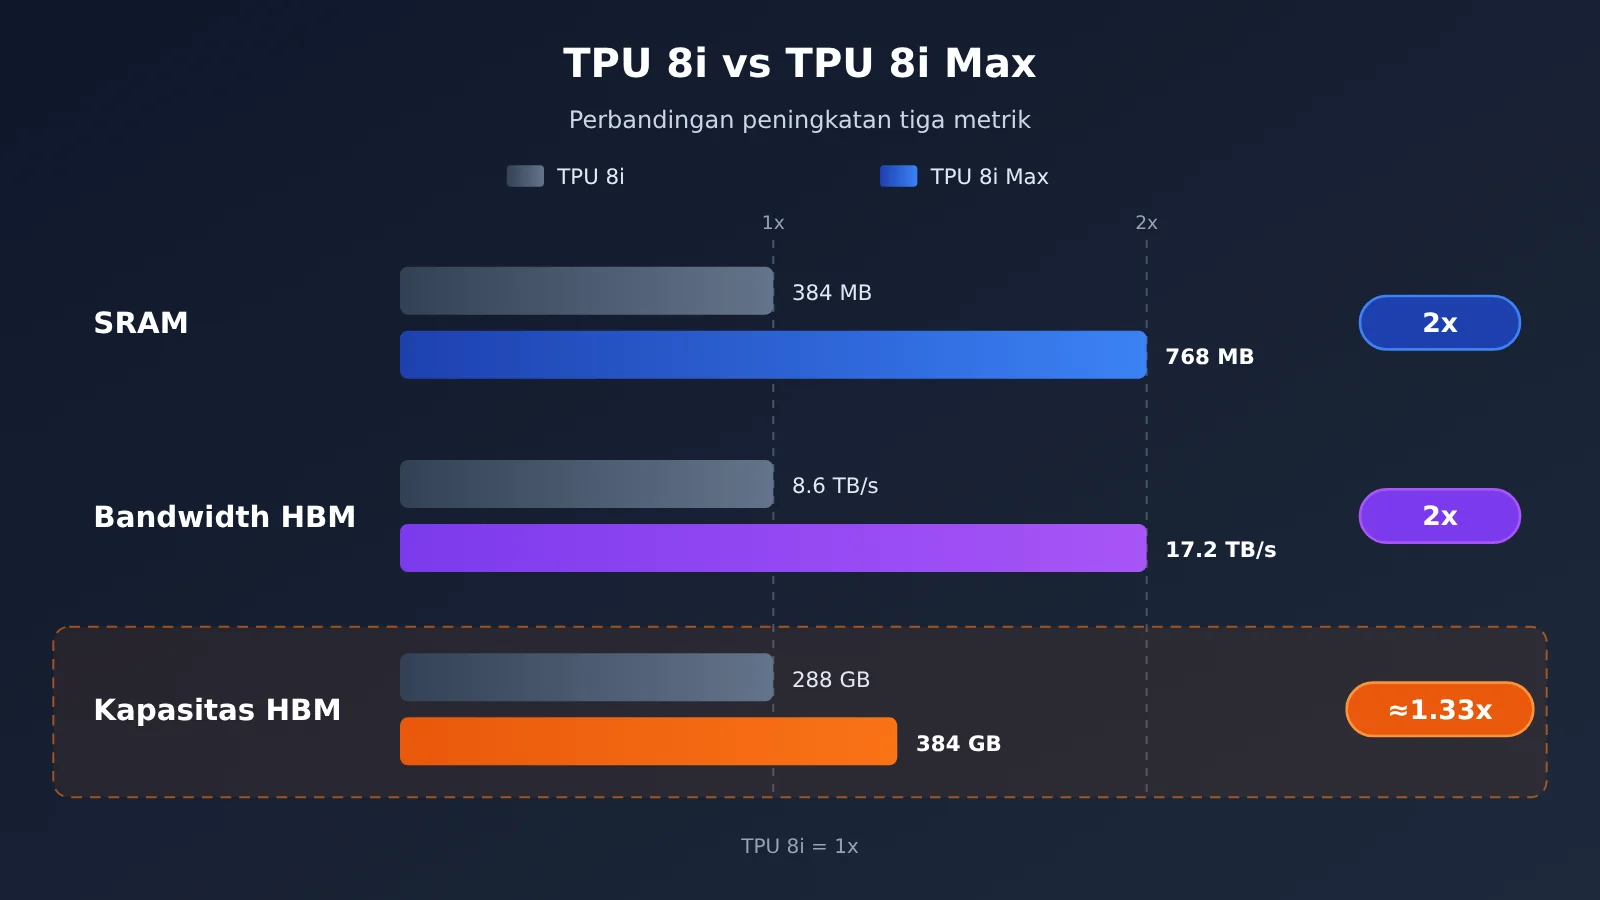
| Metrik | TPU 8i | TPU 8i Max | Perubahan |
|---|---|---|---|
| Kemasan chip | Satu chip | Dua chip | — |
| Kemampuan komputasi | Acuan | 2 kali | 2 kali lipat |
| SRAM on-chip | 384 MB | 768 MB | 2 kali lipat |
| Bandwidth HBM | 8,601 GB/s | 17,200 GB/s | Sekitar 2 kali |
| Kapasitas HBM | 288 GB | 384 GB | Bertambah sekitar 33% |
Catatan: Data TPU 8i berasal dari artikel teknis arsitektur Google pada April 2026. Angka absolut TPU 8i Max berasal dari laporan pengarahan media pada 9 November. Dalam isi artikel pengumuman resminya, Google secara eksplisit mengonfirmasi bahwa kemampuan komputasi, SRAM, dan bandwidth HBM meningkat 2 kali lipat.
Mengapa Peningkatan yang Seimbang Lebih Bermakna daripada Sekadar Menambah Komputasi
Jika hanya kemampuan komputasi yang ditingkatkan, tahap Decode akan semakin terhambat oleh bandwidth. Sebaliknya, jika hanya bandwidth yang ditingkatkan, unit komputasi bisa kekurangan data. TPU 8i Max meningkatkan komputasi, SRAM, dan bandwidth HBM dalam proporsi yang kurang lebih sama, sehingga rasio “kecepatan pasokan data / kecepatan komputasi” tetap mendekati titik keseimbangan desain sebelumnya. SRAM yang berlipat ganda juga memungkinkan lebih banyak data yang sering diakses tetap berada di chip, sehingga mengurangi akses bolak-balik ke HBM.
Kapasitas HBM Hanya Bertambah Sekitar 33%, Bukan 2 Kali Lipat
Ini detail yang paling mudah keliru. Bandwidth HBM meningkat 2 kali lipat, dari sekitar 8.6 TB/s menjadi 17.2 TB/s. Namun, kapasitas HBM hanya bertambah sekitar 33%, dari 288 GB menjadi 384 GB. Jika dikaitkan dengan perhitungan sebelumnya, artinya bandwidth per GB memori di TPU 8i Max lebih tinggi, sehingga KV Cache dengan ukuran yang sama bisa dibaca lebih cepat. Namun, peningkatan kapasitas konteks yang dapat ditampung secara bersamaan jauh lebih kecil daripada peningkatan bandwidth.
Dengan kata lain, keunggulan utama TPU 8i Max bukanlah menggandakan batas konteks satu model, melainkan membuat sistem lebih efisien dalam menampung dan memproses banyak konteks secara bersamaan. Jika kapasitasnya tidak mencukupi, kita tetap perlu menggunakan teknik perangkat lunak seperti pemindahan KV Cache, kuantisasi, dan pembagian ke beberapa chip.
Perbandingan Arsitektur Memori GPU dan TPU 8i Max
Untuk memahami posisi TPU 8i Max, kita bisa menggunakan arsitektur terbaru NVIDIA, Rubin, sebagai pembanding GPU.
| Aspek | GPU NVIDIA Rubin | Google TPU 8i Max |
|---|---|---|
| Unit pengukuran | Satu GPU | Paket dua chip TPU |
| Kapasitas HBM | 288 GB HBM4 | 384 GB HBM (dilaporkan media) |
| Bandwidth HBM | 22 TB/s | 17,2 TB/s (dilaporkan media) |
| Memori on-chip | Bergantung pada konfigurasi arsitektur | 768 MB SRAM (dilaporkan media) |
| Interkoneksi antarchip | NVLink 6 | Jaringan latensi rendah Boardfly (arsitektur TPU 8i) |
| Ekosistem perangkat lunak | CUDA dan mesin inferensi populer | JAX, TorchTPU, backend TPU untuk vLLM / SGLang |
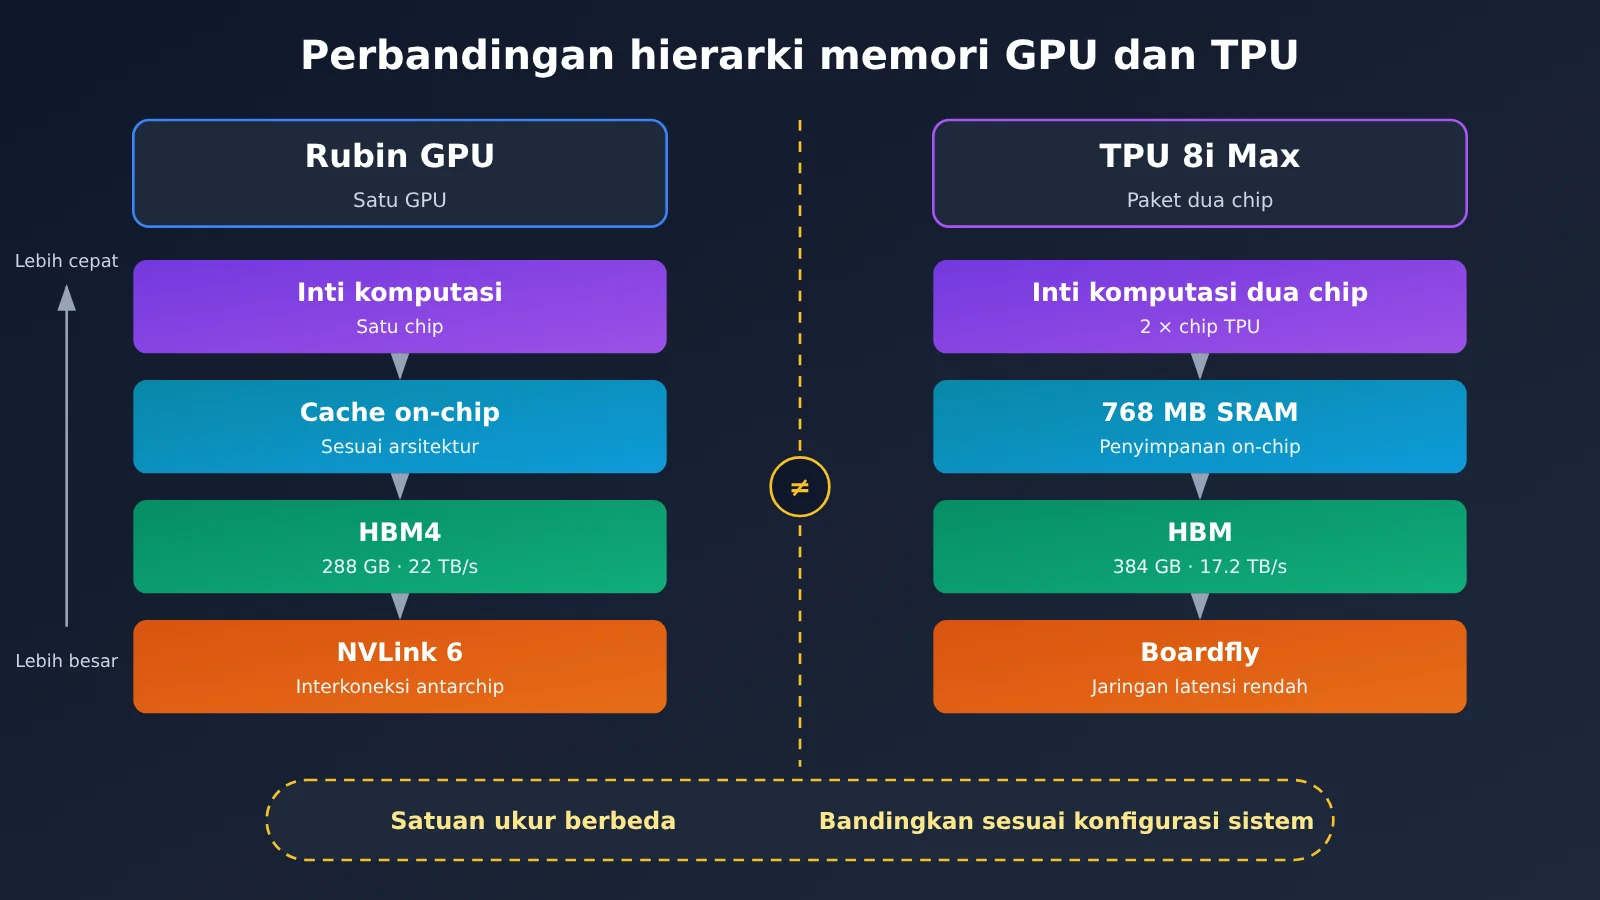
Tabel ini tidak bisa digunakan untuk membuat peringkat secara sederhana. Kapasitas 384 GB dan 288 GB membandingkan paket dua chip dengan satu GPU. Generasi HBM, metode interkoneksi, arsitektur komputasi, dan konfigurasi sistemnya juga berbeda. Jika hanya melihat bandwidth, Rubin lebih unggul; jika hanya melihat kapasitas, TPU 8i Max lebih besar. Namun, keduanya tidak bisa dibahas secara terpisah dari skala sistem.
Perbandingan yang benar-benar penting adalah: dengan daya, ruang rak, dan biaya yang sama, berapa banyak konteks paralel efektif yang bisa didukung sistem secara stabil, serta bagaimana throughput, latensi, dan efisiensi energinya saat mempertahankan konteks tersebut. Hingga 10 November 2026, belum tersedia hasil pengujian independen TPU 8i Max yang bisa diverifikasi publik. Perbandingan di tingkat sistem seperti ini masih harus menunggu data setelah produk resmi tersedia secara komersial.
💡 Saran pemilihan: Bagi sebagian besar tim yang membangun Agent melalui API, keputusan apakah sistem dasarnya berjalan di GPU atau TPU tidak perlu dibuat sendiri. Yang lebih praktis adalah membandingkan latensi dan harga tiap model saat menangani konteks panjang. Anda bisa menguji beberapa model secara paralel melalui antarmuka terpadu APIYI apiyi.com, lalu membandingkannya menggunakan petunjuk dari bisnis Anda sendiri.
Analisis Dampak TPU 8i Max bagi Developer Agent
Membedakan jendela konteks, konkurensi aktual, dan latensi inferensi
Jendela konteks yang tercantum pada spesifikasi model hanya menunjukkan “berapa banyak yang secara teori bisa ditampung”. Angka ini tidak berarti server dapat menangani banyak sesi secara bersamaan pada panjang konteks tersebut, apalagi menjamin latensi yang dapat diterima. Perhitungan sebelumnya menunjukkan bahwa pada konteks 128K yang sama, kebutuhan KV Cache untuk 8 sesi 8 kali lebih besar dibandingkan untuk 1 sesi. Bagi developer, ketiga metrik ini perlu dilihat secara terpisah:
- Jendela konteks: rentang maksimum yang dapat diproses model, menentukan seberapa banyak materi yang bisa dimuat dalam satu permintaan.
- Kapasitas konkurensi aktual: jumlah sesi panjang yang dapat dipertahankan secara bersamaan pada perangkat keras tertentu, dibatasi oleh kapasitas HBM.
- Latensi inferensi: TTFT dipengaruhi oleh jumlah komputasi Prefill, sedangkan kecepatan per Token dipengaruhi oleh bandwidth dan ukuran KV Cache.
Tiga teknik mitigasi yang makin banyak digunakan
Perangkat keras hanyalah setengah dari solusi untuk mengatasi dinding memori; setengah lainnya ada di lapisan perangkat lunak. TPU Sync yang dirilis sebagai sumber terbuka oleh Google pada waktu yang sama, serta vLLM dan SGLang versi TPU, berfokus pada teknik-teknik berikut:
| Teknik | Masalah yang diatasi | Biaya atau hal yang perlu diperhatikan |
|---|---|---|
| KV Cache Offloading | Memindahkan cache yang sementara tidak digunakan dari HBM ke DRAM host, SSD, atau penyimpanan bersama untuk melampaui batas kapasitas | Pemulihan memerlukan waktu transfer dan bergantung pada DMA yang efisien serta transfer asinkron |
| Kuantisasi KV Cache | Mengurangi jumlah byte per elemen sehingga pemakaian kapasitas dan bandwidth ikut berkurang | Dampaknya terhadap akurasi perlu dievaluasi |
| Pemisahan Prefill / Decode | Menempatkan Prefill yang intensif komputasi dan Decode yang intensif bandwidth di node berbeda | Memerlukan transfer KV Cache yang cepat antar-node |
| Prefix Caching | Menggunakan kembali petunjuk sistem dan prefiks riwayat yang sama untuk menghindari Prefill berulang | Bergantung pada seberapa sering prefiks permintaan digunakan berulang kali |
Data TPU Sync yang diumumkan Google menunjukkan bahwa latensi transfer KV Cache dapat turun lebih dari 90%, sedangkan pada skenario cache prefiks dengan konteks 64K, TTFT dapat turun hingga 90%. Namun, pengujian ini menggunakan TPU Ironwood generasi ketujuh. README GitHub saat ini mencantumkan v7x dan v6e sebagai perangkat keras yang telah divalidasi secara aktif, jadi hasil tersebut tidak bisa langsung dianggap sebagai hasil TPU 8i Max.
Dampak pada Performa dan Biaya Resource
Bagi pengguna API, optimasi di balik layar ini pada akhirnya terlihat dari dua hal: apakah latensi permintaan dengan konteks panjang tetap stabil dan apakah biaya berbasis token bisa ditekan. Di sisi aplikasi, Anda juga bisa menerapkan prinsip “mengurangi penggunaan memori”: ringkas petunjuk sistem dan jaga agar prefiks tetap stabil supaya cache bisa digunakan, rangkum keluaran alat sebelum memasukkannya kembali ke konteks, dan berikan kepada sub-Agent hanya bagian yang diperlukan, bukan seluruh riwayat.
Contoh berikut menggunakan output streaming untuk mengukur latensi token pertama pada berbagai panjang konteks. Dengan begitu, Anda bisa mengamati dampak pertumbuhan konteks terhadap Prefill:
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka APIYI yang kompatibel dengan OpenAI
)

def measure_ttft(context: str, model: str = "gpt-4o-mini") -> float:
    start = time.perf_counter()
    stream = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": context + "\n请用一句话总结上文。"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            return time.perf_counter() - start
    return -1.0

print(f"TTFT: {measure_ttft('示例代码片段 ' * 2000):.2f}s")
Lihat kode pengujian batch untuk berbagai model dan panjang konteks
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Satu kunci untuk beralih antar-model dari berbagai penyedia
)

MODELS = ["gpt-4o-mini", "claude-sonnet-4", "gemini-2.5-flash"]
LENGTHS = [1_000, 5_000, 20_000]  # Jumlah pengulangan potongan, untuk memperbesar konteks secara perkiraan

def run_once(model: str, repeat: int) -> dict:
    context = "def handler(event):\n    return process(event)\n" * repeat
    start = time.perf_counter()
    first, tokens = None, 0
    try:
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": context + "\n指出上面代码的潜在问题。"}],
            stream=True,
            max_tokens=200,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                tokens += 1
                if first is None:
                    first = time.perf_counter() - start
        total = time.perf_counter() - start
        return {"model": model, "repeat": repeat, "ttft": first, "total": total, "chunks": tokens}
    except Exception as e:
        return {"model": model, "repeat": repeat, "error": str(e)}

for m in MODELS:
    for n in LENGTHS:
        print(run_once(m, n))
🚀 Mulai cepat: Daftar melalui APIYI di apiyi.com untuk mendapatkan kuota uji coba gratis. Biarkan
base_urlpada skrip di atas tetap menggunakanhttps://api.apiyi.com/v1. Dalam beberapa menit, Anda bisa mendapatkan kurva TTFT berbagai model pada panjang konteks yang berbeda.
Dampak terhadap industri
- Kustomisasi tingkat sistem semakin cepat: Google menggunakan pendekatan “silikon yang sama, sistem yang berbeda” untuk segera menghadirkan konfigurasi bagi beban kerja khusus. Ini menunjukkan bahwa persaingan akselerator mulai bergeser dari spesifikasi satu chip ke desain sistem.
- Kolaborasi perangkat lunak dan perangkat keras menjadi standar: TPU 8i Max dirilis bersama TPU Sync, Agent Compute Engine, dan mesin inferensi versi TPU. Solusi untuk masalah batas memori kini bergantung pada bandwidth perangkat keras sekaligus penjadwalan perangkat lunak.
- Komersialisasi masih dalam tahap awal: Seperti 8t, 8i, dan 8tx, TPU 8i Max tercantum sebagai Coming soon. Harga publik dan tanggal ketersediaan resminya belum diumumkan, sehingga nilai sebenarnya masih perlu dibuktikan.
Pertanyaan Umum (FAQ)
Q1: Apa itu TPU 8i Max?
TPU 8i Max adalah konfigurasi sistem TPU generasi kedelapan yang dirilis Google pada 9 November 2026. Sistem ini mengintegrasikan dua TPU 8i dalam satu kemasan. Kemampuan komputasi, SRAM on-chip, dan bandwidth HBM-nya masing-masing dua kali lipat dibandingkan TPU 8i. TPU 8i Max terutama ditujukan untuk inferensi dengan konteks panjang, konkurensi tinggi, dan kolaborasi banyak agen. Ini bukan chip yang sepenuhnya baru.
Q2: Apakah kapasitas HBM TPU 8i Max menjadi dua kali lipat?
Tidak. Menurut informasi dalam pengarahan media, kapasitas HBM meningkat dari 288 GB menjadi 384 GB, atau sekitar 33%. Yang menjadi dua kali lipat adalah bandwidth HBM (dari sekitar 8,6 TB/s menjadi 17,2 TB/s) dan SRAM (dari 384 MB menjadi 768 MB). Kapasitas dan bandwidth adalah dua metrik yang berbeda, jadi keduanya tidak boleh disamakan.
Q3: Apakah TPU 8i Max sudah bisa digunakan? Berapa harganya?
Hingga 10 November 2026, halaman produk resmi Google Cloud mencantumkan TPU 8i Max sebagai Coming soon. Harga publik dan tanggal GA resminya belum diumumkan, begitu pula pengujian performa independen yang bisa diverifikasi secara publik. Untuk saat ini, satu-satunya acuan yang tersedia adalah pernyataan resmi Google dan spesifikasi dalam pengarahan media.
Q4: Apakah TPU 8i Max memungkinkan satu model mendukung konteks hingga satu juta token?
Google mencantumkan konteks hingga jutaan token sebagai salah satu skenario penggunaan yang dituju, tetapi angka tersebut bukan spesifikasi maksimum konteks yang telah ditetapkan. Panjang konteks yang dapat diproses pertama-tama bergantung pada model itu sendiri. Perangkat keras menentukan seberapa banyak pemanggilan yang bisa berjalan secara bersamaan pada panjang tersebut dan apakah latensinya masih dapat diterima.
Q5: Bagaimana developer aplikasi dapat menguji dampak konteks panjang terhadap latensi?
Cara paling langsung adalah mengukur TTFT dan kecepatan keluaran menggunakan konteks bisnis yang sebenarnya dengan panjang berbeda:
1. Kunjungi APIYI di apiyi.com untuk mendaftar, lalu dapatkan kunci API dan kuota uji coba gratis.
2. Gunakan skrip pengujian dalam artikel ini dan atur `base_url` ke `https://api.apiyi.com/v1`.
3. Dengan kelompok konteks yang sama, coba beberapa model dan bandingkan laju peningkatan latensi seiring bertambahnya panjang konteks.
Q6: Apa keterbatasan kuantisasi dan offloading KV Cache?
Kuantisasi dapat langsung mengurangi penggunaan memori dan bandwidth, tetapi berpotensi menurunkan akurasi sehingga perlu dievaluasi pada tugas yang dituju. Offloading dapat mengatasi batas kapasitas HBM, tetapi data memerlukan waktu untuk dipindahkan kembali. Jika transfer antarlevel data tidak cukup cepat, latensi justru bisa meningkat. Keduanya perlu disetel dengan mempertimbangkan skala konkurensi dan sasaran latensi.
Poin-Poin Utama tentang Konteks Panjang Agent dan TPU 8i Max
- Pergeseran bottleneck: Inferensi Agent kini tidak lagi hanya mengandalkan daya komputasi, tetapi juga menuntut keseimbangan antara komputasi dan pasokan data dari memori.
- KV Cache bertambah secara linear: Llama 3.1 70B membutuhkan sekitar 320 KiB per Token. Satu permintaan dengan konteks 128K membutuhkan sekitar 40 GiB.
- GQA sangat penting: Dengan 8 KV Head, penggunaan cache hanya seperdelapan dari perhatian multi-head standar.
- Decode bergantung pada bandwidth: Setiap kali menghasilkan Token, sistem harus membaca seluruh KV Cache. Pada konteks panjang, bandwidth menjadi faktor utama yang menentukan latensi.
- Skalabilitas yang seimbang: TPU 8i Max menggandakan daya komputasi, SRAM, dan bandwidth HBM secara bersamaan, sementara kapasitas HBM hanya meningkat sekitar 33%.
- Perangkat lunak juga penting: Offloading, kuantisasi, pemisahan Prefill/Decode, dan cache awalan merupakan cara utama untuk mengatasi keterbatasan bandwidth memori.
- Uji langsung: Gunakan APIYI apiyi.com dengan antarmuka terpadu untuk menguji latensi konteks panjang dari beberapa model.
Kesimpulan
Poin-poin utama tentang keterbatasan memori dalam inferensi Agent dengan konteks panjang:
- Sumber tekanan: Repositori kode, hasil penggunaan tool, dan keluaran sub-Agent terus bertambah. Ditambah konkurensi banyak Agent, ukuran KV Cache bisa membengkak berkali-kali lipat.
- Pendekatan perangkat keras: TPU 8i Max tidak sekadar menambah daya komputasi, tetapi juga meningkatkan komputasi, SRAM, dan bandwidth HBM secara bersamaan agar pasokan data tetap seimbang dengan komputasi.
- Batas penerapan: Peningkatan kapasitas HBM terbatas dan produknya belum tersedia secara komersial. Nilai praktisnya masih perlu dibuktikan lewat pengujian sistem secara menyeluruh.
Bagi kebanyakan developer, langkah yang lebih praktis saat ini adalah memahami struktur biaya KV Cache, mengendalikan pertumbuhan konteks pada lapisan aplikasi, serta terus memantau perubahan latensi dan harga layanan model untuk konteks panjang. Cobalah APIYI apiyi.com dengan data bisnis nyata untuk membandingkan kinerja beberapa model dalam menangani konteks panjang. Platform ini menyediakan antarmuka yang kompatibel dengan OpenAI dan kuota gratis bagi pengguna baru.
📚 Referensi
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max: Pengumuman teknis resmi tentang peluncuran ini
- Tautan:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
Keterangan: Mengonfirmasi kemasan dua chip serta penggandaan komputasi, SRAM, dan bandwidth HBM
-
Google Cloud – Inside the eighth-generation TPU: Ulasan mendalam tentang arsitektur TPU generasi kedelapan
- Tautan:
cloud.google.com/blog/products/compute/tpu-8t-and-tpu-8i-technical-deep-dive -
Keterangan: Spesifikasi asli TPU 8i dan arsitektur jaringan Boardfly
-
Google Cloud – Introducing TPU Sync: Pustaka untuk transfer KV Cache dan bobot
- Tautan:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
Keterangan: Hierarki memori dan data pengujian KV Cache Offloading (berdasarkan Ironwood)
-
Network World – Google targets AI’s next infrastructure bottlenecks: Liputan media
- Tautan:
networkworld.com/article/4245897 -
Keterangan: Parameter pasti kapasitas dan bandwidth HBM TPU 8i Max, serta ukuran SRAM
-
Google TPU Sync GitHub: Repositori sumber terbuka
- Tautan:
github.com/google/tpu-sync - Keterangan: Informasi tentang kompatibilitas perangkat keras dan status pengembangan
Penulis: Tim teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui beranda situs resmi APIYI. Informasi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com.