2026년 11월 9일, Google Cloud는 8세대 TPU의 새로운 시스템 구성 두 가지인 TPU 8tx와 TPU 8i Max를 발표했어요. TPU 8i Max는 TPU 8i 두 개를 하나의 패키지에 통합해 연산 성능, 온칩 SRAM, HBM 대역폭을 동시에 두 배로 높였어요. 긴 컨텍스트, 높은 동시 처리량, 여러 에이전트의 협업 추론을 목표로 한 구성입니다.
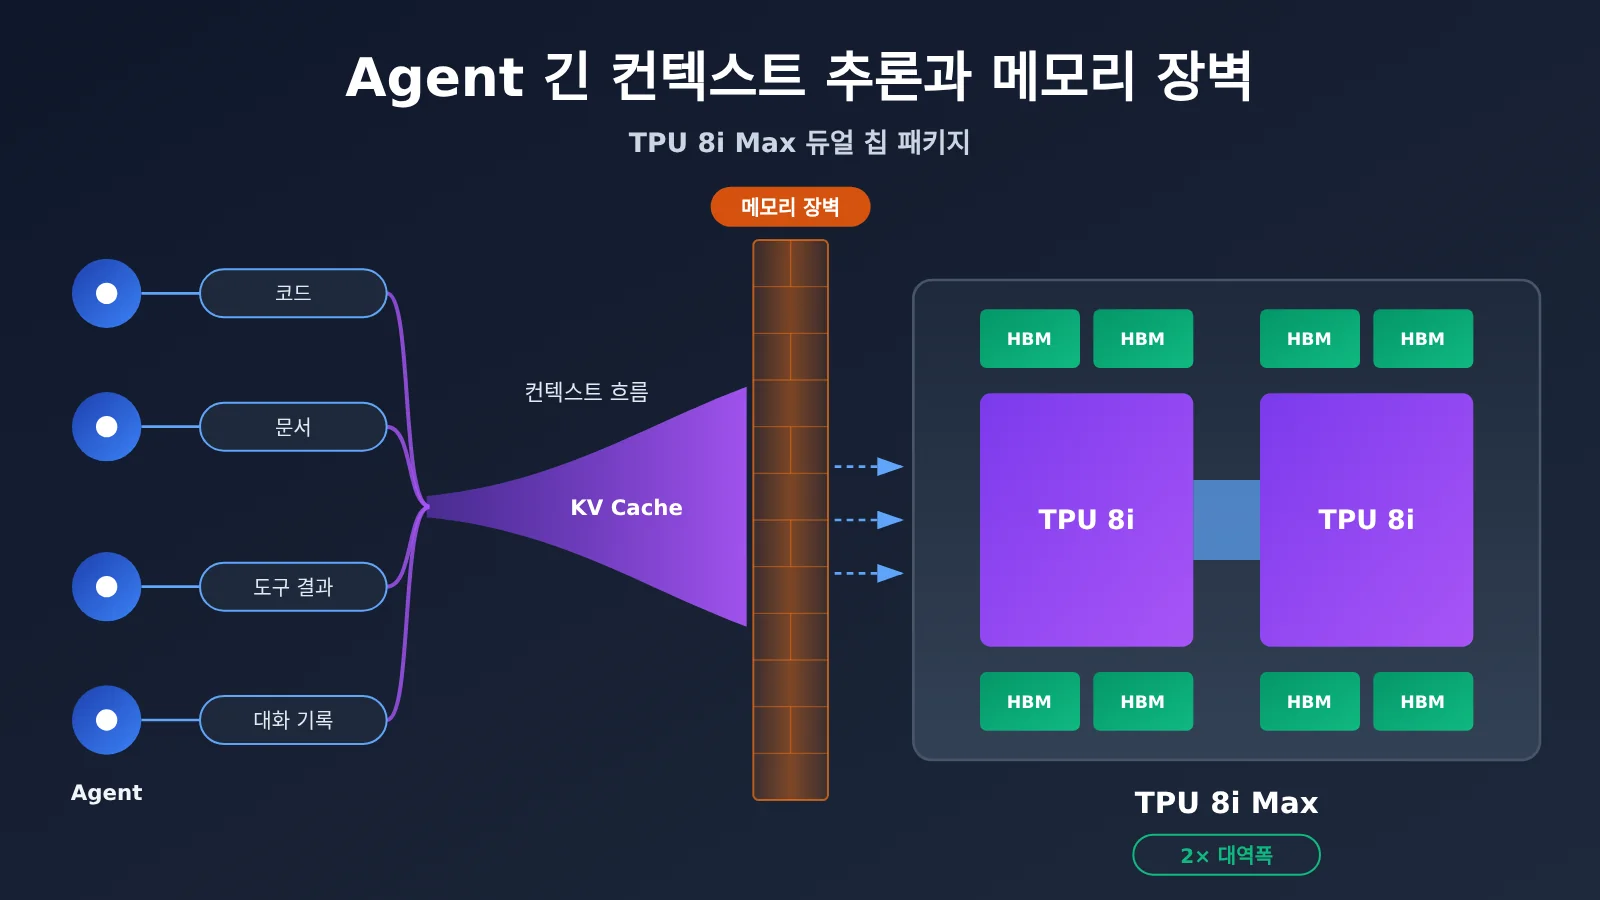
이번 발표는 단순히 연산 성능을 높이는 데 그치지 않아요. Google의 공식 발표와 AMD의 동시 협력 발표, 여러 매체의 보도에서 관련 내용이 확인됐어요. 이 글에서는 칩 사양을 나열하는 대신 KV Cache를 직접 계산해 보며 한 가지를 살펴볼게요. 에이전트 추론의 병목은 이제 ‘얼마나 빠르게 연산하느냐’에서 ‘데이터를 계산 유닛에 제때 전달할 수 있느냐’로 옮겨가고 있어요.
핵심 가치: 이 글을 읽고 나면 긴 컨텍스트 요청 하나에 필요한 GPU 메모리 용량을 직접 추정하고, 메모리 장벽이 생기는 이유를 이해하며, TPU 8i Max와 같은 시스템 설계가 에이전트 서비스에 어떤 의미인지 판단할 수 있어요.
TPU 8i Max와 에이전트의 긴 컨텍스트 핵심 정보 한눈에 보기
| 항목 | 세부 정보 |
|---|---|
| 출시일 | 2026년 11월 9일 |
| 출시 주체 | Google Cloud |
| 제품 특성 | 8세대 TPU의 시스템 구성으로, 완전히 새롭게 설계한 독립형 칩은 아님 |
| 패키징 방식 | TPU 8i 두 개를 하나의 패키지에 통합 |
| 공식 확인된 향상점 | 연산 성능, SRAM, HBM 대역폭 모두 TPU 8i 대비 2배 |
| 미디어 브리핑에서 공개된 사양 | 384 GB HBM, 17.2 TB/s HBM 대역폭, 768 MB SRAM |
| 목표 사용 사례 | 긴 컨텍스트, 높은 동시성의 추론, 멀티 에이전트 협업, 장시간 동영상 분석 등 |
| 출시 상태 | 공식 제품 페이지에 Coming soon으로 표시되어 있으며, 가격과 GA 일정은 아직 공개되지 않음 |
Google은 발표에서 chip과 system을 의도적으로 구분했다는 점에 주목해야 해요. 칩 설계에는 수년이 걸리지만, 패키징과 메모리, 네트워크, 보안 구성 요소를 조정하면 시스템 구성을 새로운 워크로드에 더 빠르게 맞출 수 있어요. TPU 8i Max는 바로 이런 접근 방식의 결과물이에요. 실리콘은 TPU 8i를 그대로 사용하고, 패키징과 시스템 계층을 바꿨죠.
에이전트의 긴 컨텍스트가 일반 채팅보다 메모리를 더 많이 사용하는 이유
일반 채팅은 보통 ‘질문과 답변’을 주고받는 형태라 컨텍스트가 천천히 늘어나고, 대화가 끝나면 상태를 버릴 수 있어요. 에이전트는 달라요. 하나의 목표를 여러 하위 작업으로 나눈 뒤, 외부 자료를 계속 읽고 도구를 호출하며, 피드백을 바탕으로 추론을 이어가요. 결과를 기다리는 동안에도 상태를 보존해야 하죠. 각 단계의 결과가 컨텍스트에 계속 추가되기 때문에 컨텍스트는 점점 커지기만 해요.
소프트웨어 개발 에이전트를 예로 들면, 한 번의 작업에서 다음과 같은 내용을 동시에 다룰 수 있어요.
- 코드베이스: 수백 개의 소스 코드 파일과 파일 간 의존 관계
- 프로젝트 문서: 아키텍처 설명, 인터페이스 규약, 코딩 표준
- 이전 대화: 사용자의 요구 사항을 여러 차례 확인하고 수정한 내용
- 도구 결과: 컴파일 로그, 테스트 출력, 오류 스택 트레이스
- 하위 에이전트의 결과물: 테스트, 검토, 리팩터링을 담당하는 각 하위 에이전트가 반환한 결과
더 중요한 건 동시 실행이에요. 메인 에이전트가 하위 에이전트 4개를 만들면 시스템에는 서로 독립적인 컨텍스트 5개가 동시에 존재하게 돼요. 각 컨텍스트는 추론이 진행되는 동안 메모리에 상주해야 해요. Google이 ‘대규모 소프트웨어 프로젝트의 멀티 에이전트 협업 개발’을 TPU 8i Max의 대표적인 사용 사례로 제시한 이유가 바로 여기에 있어요. 다만 Google이 언급한 ‘백만 토큰 규모의 컨텍스트’는 목표 애플리케이션을 설명한 표현이지, 이미 공개된 고정 최대 컨텍스트 사양은 아니에요.
Agent의 긴 컨텍스트에 따라 선형적으로 증가하는 KV Cache
KV Cache의 역할
Transformer는 새 토큰을 생성할 때마다 현재 토큰의 Query를 모든 이전 토큰의 Key와 비교해 어텐션 점수를 계산한 뒤, 그 가중치로 이전 토큰의 Value를 가중합해요. 토큰을 하나 생성할 때마다 모든 이전 토큰의 Key와 Value를 다시 계산하면 연산량이 길이에 따라 급격히 늘어납니다. KV Cache는 이전 토큰에서 계산한 Key와 Value를 저장해 재사용함으로써 메모리를 연산과 맞바꾸는 방식이에요.
대신 이 캐시는 컨텍스트 길이와 동시 요청 수가 늘어날수록 계속 커집니다. 아래 추정 공식은 vLLM의 KV Cache 메모리 레이아웃에 해당해요.
M_KV = 2 × L × H_KV × D × B × T × N
| 매개변수 | 의미 | Llama 3.1 70B 기준값 |
|---|---|---|
| 2 | Key와 Value 캐시 두 벌 | 2 |
| L | Transformer 레이어 수 | 80 |
| H_KV | Key/Value 어텐션 헤드 수 | 8(GQA) |
| D | KV Head 하나의 차원 | 128 |
| B | 요소 하나의 바이트 수 | 2(BF16) |
| T | 요청 하나의 토큰 수 | 시나리오에 따라 다름 |
| N | 동시 요청 수 | 시나리오에 따라 다름 |
Llama 3.1 70B의 KV Cache 계산 사례
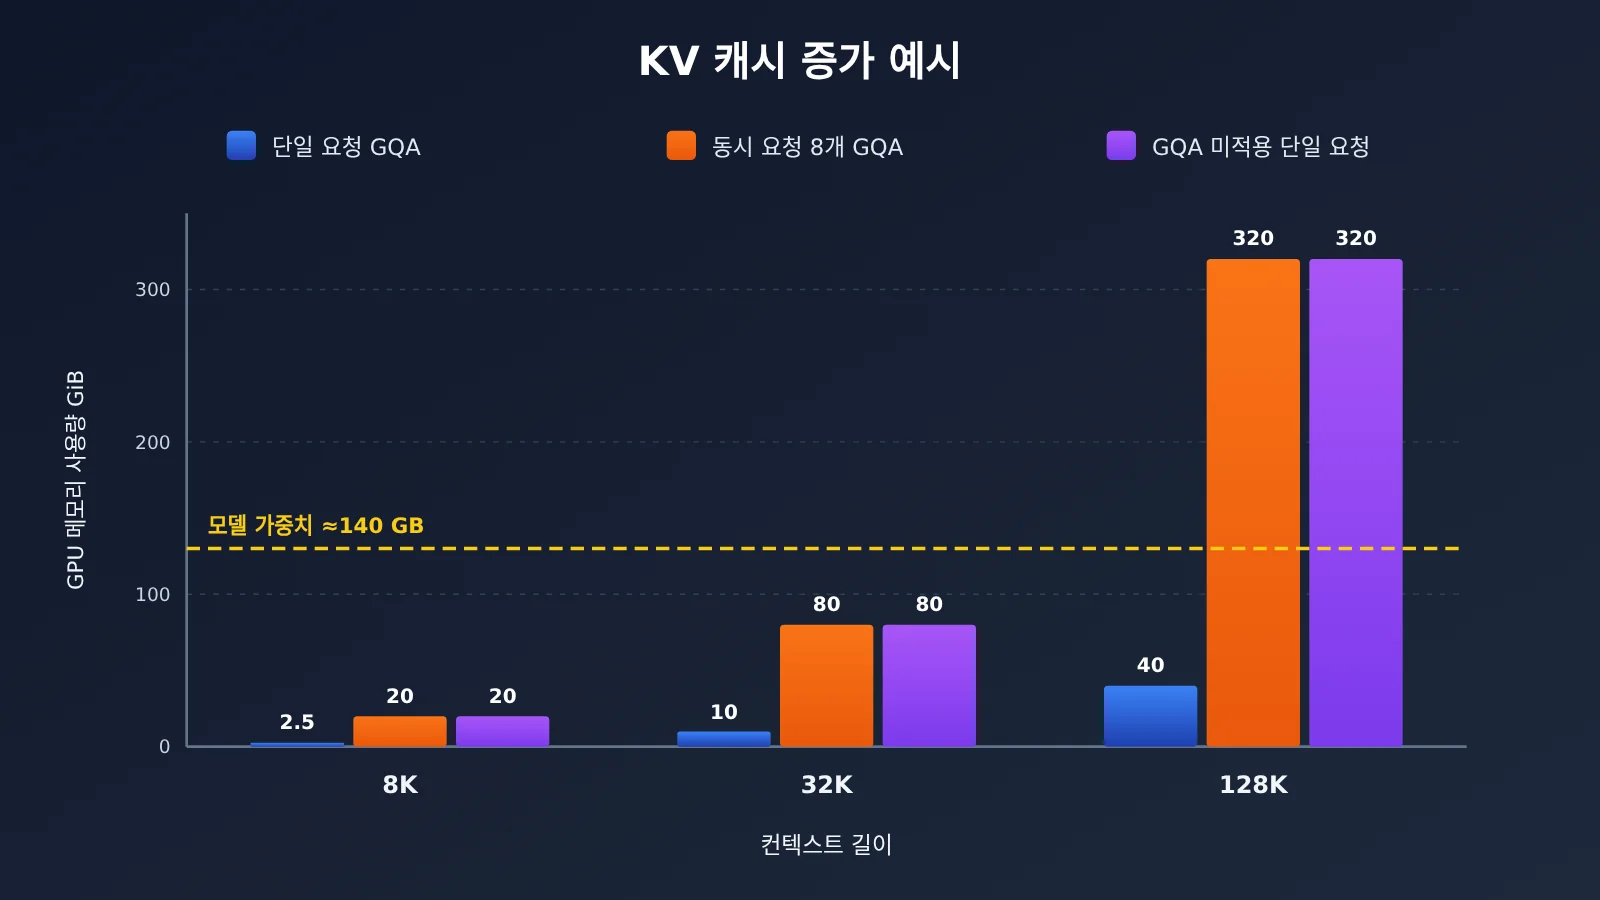
먼저 토큰 하나를 계산해 볼게요. 2 × 80 × 8 × 128 × 2 = 327,680바이트, 즉 토큰당 약 320 KiB예요. 이 수치만 보면 크지 않아 보이지만, 컨텍스트 길이를 곱하면 빠르게 커져요.
| 시나리오 | 컨텍스트 길이 | 동시 실행 수 | 이론상 KV Cache |
|---|---|---|---|
| 짧은 작업 | 8K | 1 | 2.5 GiB |
| 중간 규모 코드 작업 | 32K | 1 | 10 GiB |
| 긴 컨텍스트 Agent | 128K | 1 | 40 GiB |
| 여러 Agent 병렬 실행 | 128K | 8 | 320 GiB |
위 계산에는 KV Cache만 포함되어 있고, 모델 가중치와 런타임 작업 공간, 메모리 단편화 오버헤드는 포함되지 않았어요. 비교를 위해 70B 파라미터 모델의 가중치만 살펴보면, BF16으로 저장할 때 약 140 GB가 필요해요. 즉, 128K 컨텍스트를 사용하는 세션 8개의 KV Cache는 모델 가중치의 두 배를 넘어요.
GQA가 KV Cache 메모리 사용량에 미치는 영향
Llama 3.1 70B에는 Attention Head가 64개 있지만 KV Head는 8개뿐이에요. 이것이 GQA(Grouped-Query Attention)예요. Query 헤드 8개마다 Key/Value 한 쌍을 공유하죠. 계산할 때는 64가 아니라 8을 사용해야 해요. 그렇지 않으면 결과가 8배 크게 나와요.
반대 상황을 가정해 보면 GQA의 이점을 쉽게 알 수 있어요. 이 모델이 표준 멀티헤드 어텐션을 사용해 64개 헤드마다 KV를 따로 유지한다면, 128K 요청 하나의 KV Cache가 40 GiB에서 320 GiB로 늘어나요. 요청 하나만으로도 GQA를 사용하는 동시 실행 8개의 메모리를 전부 차지하는 셈이죠. MQA는 KV Head를 1개로 더 줄여 메모리를 절약하지만, 모델 품질에 미치는 영향도 고려해야 해요. 여기에 KV Cache 양자화를 적용하면(예: BF16에서 8비트로 낮추기) 메모리 사용량을 절반으로 줄일 수 있지만, 정밀도 손실을 평가해야 해요.
아래 스크립트는 위 공식을 그대로 사용해 다양한 컨텍스트 길이와 동시 실행 수에서 모델의 KV Cache 크기를 빠르게 추정할 수 있어요.
def kv_cache_gib(layers, kv_heads, head_dim, bytes_per_elem, tokens, concurrency=1):
    """M_KV = 2 × L × H_KV × D × B × T × N 공식으로 KV Cache를 추정하며, 단위는 GiB입니다."""
    total = 2 * layers * kv_heads * head_dim * bytes_per_elem * tokens * concurrency
    return total / (1024 ** 3)

# Llama 3.1 70B: 레이어 80개, KV Head 8개, 차원 128, BF16
for ctx in (8_192, 32_768, 131_072):
    print(f"{ctx:>7} tokens -> {kv_cache_gib(80, 8, 128, 2, ctx):.1f} GiB")

print("8 并发 x 128K ->", kv_cache_gib(80, 8, 128, 2, 131_072, 8), "GiB")
print("FP8 KV 量化 128K ->", kv_cache_gib(80, 8, 128, 1, 131_072), "GiB")
에이전트의 긴 컨텍스트 추론에서 메모리 월이란 무엇인가
용량, 대역폭, SRAM은 서로 독립적인 세 가지 요소예요
메모리 월을 이야기할 때 가장 흔한 오해는 ‘메모리가 크다’는 것과 ‘메모리가 빠르다’는 것을 같은 의미로 보는 거예요. 실제로 AI 가속기의 메모리 시스템에는 서로 독립적인 지표가 세 가지 이상 있어요.
| 지표 | 결정하는 요소 | 에이전트에 미치는 영향 |
|---|---|---|
| HBM 용량 | 저장할 수 있는 데이터의 양 | 모델 가중치와 KV 캐시를 동시에 얼마나 보관할 수 있는지, 즉 동시 처리 가능한 컨텍스트가 얼마나 되는지 |
| HBM 대역폭 | 단위 시간에 전송할 수 있는 데이터의 양 | 토큰을 생성할 때마다 가중치와 KV 캐시를 계산 코어에 빠르게 전달할 수 있는지 |
| 온칩 SRAM | 계산 코어와 가장 가까운 고속 메모리 | 자주 사용하는 데이터를 온칩에 보관해 HBM에 반복해서 접근하는 시간을 줄일 수 있는지 |
HBM은 여러 층을 쌓고 첨단 패키징을 적용해 병렬 접근을 높인 DRAM이에요. SRAM은 더 빠르고 연산 장치에 가깝지만, 용량당 비용이 높고 물리적인 면적에도 한계가 있어요. 현대 가속기가 특정 메모리 용량만 늘리는 대신 다단계 메모리 계층을 사용하는 이유가 여기에 있어요.
프리필과 디코드는 필요한 데이터가 크게 달라요
LLM 추론은 두 단계로 나뉘어요. 프리필 단계에서는 입력 컨텍스트 전체를 한 번에 처리하고 KV 캐시를 만들어요. 많은 토큰을 병렬로 계산할 수 있어 전형적인 연산 집약형 작업이에요. 디코드 단계에서는 출력 토큰을 하나씩 생성해요. 매 단계마다 새로운 토큰 하나만 처리하지만, 모든 가중치와 전체 KV 캐시를 읽어야 하죠. 연산량은 적고 데이터 이동량은 많아서 대역폭 집약형 작업에 해당해요.
디코드 단계의 부담은 단순화한 계산으로도 가늠할 수 있어요. 128K 요청 하나의 KV 캐시는 약 40 GiB(약 43 GB)이고, 토큰을 생성할 때마다 전체를 한 번씩 읽어야 해요. 단일 TPU 8i 칩의 HBM 대역폭을 약 8.6 TB/s로 보면 KV 캐시를 읽는 데만 약 5밀리초가 걸려요. TPU 8i Max의 17.2 TB/s를 기준으로 하면 이론적인 하한은 약 2.5밀리초예요. 이는 가중치 읽기, 연산과 메모리 전송의 중첩, 병렬 분할을 무시한 값이지만, 컨텍스트가 길어질수록 디코드 시간이 연산보다 데이터 이동에 더 크게 좌우된다는 점을 보여주기에는 충분해요.
계산 장치는 왜 ‘데이터를 기다리게’ 될까요?
계산 코어가 초당 수행할 수 있는 연산량이 메모리에서 초당 공급할 수 있는 데이터량보다 훨씬 많으면, 계산 장치는 데이터를 기다리며 유휴 상태가 돼요. 이것이 메모리 월이에요. 에이전트에서는 긴 컨텍스트로 디코드 단계마다 읽어야 하는 데이터가 늘고, 높은 동시성으로 상주해야 하는 KV 캐시가 많아지며, 여러 차례에 걸친 추론 과정에서 캐시를 반복해서 읽고 갱신해야 해요. 이 세 가지가 겹치면 피크 연산 성능만 높이는 방식의 추가 효과는 점점 줄어들어요.
🎯 기술 팁: 에이전트 애플리케이션을 평가하기 전에 컨텍스트 길이를 달리해 첫 토큰 지연 시간(TTFT)과 출력 속도를 실제로 측정하고, 컨텍스트가 길어질수록 지연 시간이 어떻게 달라지는지 확인해 보세요. APIYI apiyi.com에서는 같은 API 키로 Claude, Gemini, GPT 등의 모델을 전환하며 테스트할 수 있어, 각 모델의 긴 컨텍스트 성능을 비교하기 편리해요.
TPU 8i Max 듀얼 칩 패키징으로 메모리 대역폭 확장하기
TPU 8i 두 개를 어떻게 결합할까요?
TPU 8i Max는 8세대 TPU의 네 번째 시스템 구성입니다. Google은 여러 에이전트가 대규모 코드베이스, 긴 동영상 또는 복잡한 문서를 동시에 처리할 때 병목은 연산 성능이 아니라 칩이 데이터를 읽고 주고받는 속도에 있는 경우가 많다는 점을 확인했어요. 이에 따라 지연 시간이 짧은 TPU 8i 두 개를 하나의 패키지에 통합하고, 같은 랙 설치 공간에 실리콘을 2배로 집적했어요.
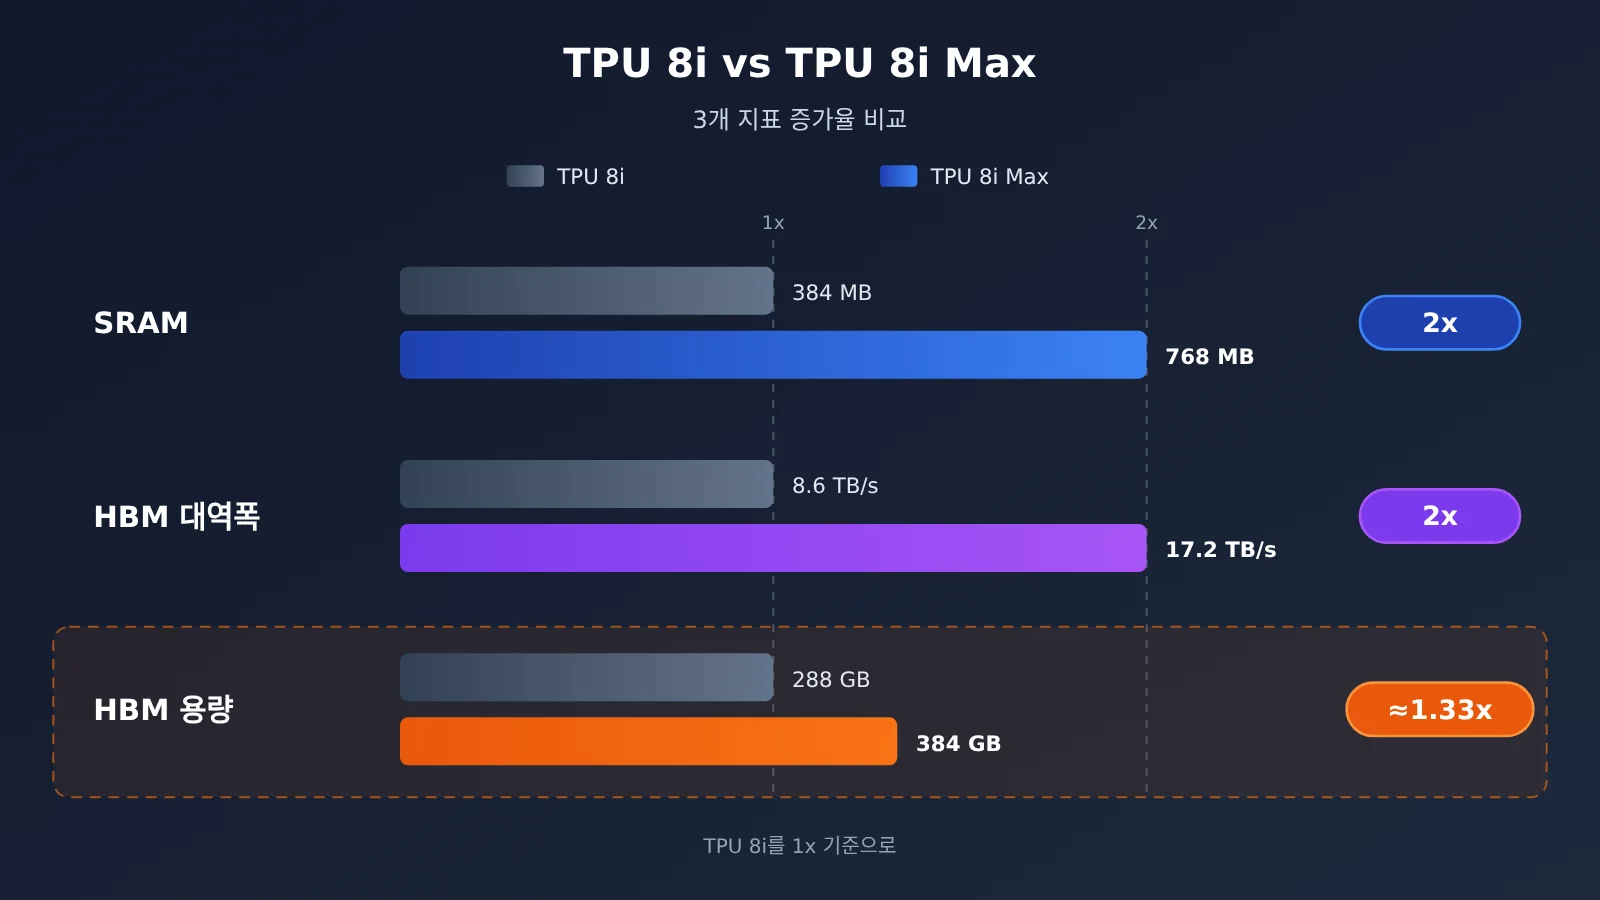
| 지표 | TPU 8i | TPU 8i Max | 변화 폭 |
|---|---|---|---|
| 칩 패키징 | 단일 칩 | 듀얼 칩 | — |
| 연산 성능 | 기준 | 2배 | 2배 |
| 온칩 SRAM | 384 MB | 768 MB | 2배 |
| HBM 대역폭 | 8,601 GB/s | 17,200 GB/s | 약 2배 |
| HBM 용량 | 288 GB | 384 GB | 약 33% 증가 |
참고: TPU 8i 데이터는 Google이 2026년 4월에 공개한 아키텍처 기술 문서에서 가져왔어요. TPU 8i Max의 구체적인 수치는 11월 9일자 언론 브리핑 보도에 따른 것이며, 공식 발표 본문에서 명확히 확인된 내용은 연산 성능, SRAM, HBM 대역폭이 2배로 늘었다는 점이에요.
연산 성능만 높이는 것보다 함께 확장하는 게 중요한 이유
연산 성능만 높이면 디코드 단계에서 대역폭 병목이 더 심해져요. 반대로 대역폭만 늘리면 연산 유닛을 충분히 활용하지 못할 수 있어요. TPU 8i Max는 연산 성능, SRAM, HBM 대역폭을 비슷한 비율로 확장해 ‘데이터 공급 속도 / 연산 속도’의 비율을 기존 설계의 균형점에 가깝게 유지해요. SRAM이 2배로 늘어난 만큼 더 많은 고빈도 데이터를 칩 내부에 저장할 수 있어 HBM에 접근하는 횟수도 줄어들어요.
HBM 용량은 2배가 아니라 약 33% 증가해요
이 부분은 가장 쉽게 잘못 쓰는 세부 정보예요. HBM 대역폭은 약 8.6 TB/s에서 17.2 TB/s로 2배 늘었지만, HBM 용량은 288 GB에서 384 GB로 약 33%만 증가했어요. 앞서 살펴본 수치를 바탕으로 의미를 따져 보면, TPU 8i Max는 메모리 1GB당 대역폭이 더 커서 같은 크기의 KV 캐시를 더 빠르게 읽을 수 있어요. 하지만 동시에 담을 수 있는 전체 컨텍스트의 양은 대역폭만큼 크게 늘어나지 않아요.
다시 말해 TPU 8i Max의 핵심 가치는 단일 모델의 컨텍스트 한도를 2배로 늘리는 것이 아니라, 시스템이 대량의 동시 컨텍스트를 더 효율적으로 처리하고 지원하도록 하는 데 있어요. 용량이 부족할 때는 여전히 KV 캐시 오프로딩, 양자화, 멀티칩 분할 같은 소프트웨어 기법을 활용해야 해요.
GPU와 TPU 8i Max의 메모리 아키텍처 비교
TPU 8i Max의 위치를 이해하려면 NVIDIA의 최신 Rubin 아키텍처를 GPU 비교 대상으로 삼을 수 있어요.
| 항목 | NVIDIA Rubin GPU | Google TPU 8i Max |
|---|---|---|
| 측정 단위 | GPU 1개 | TPU 칩 2개 패키지 |
| HBM 용량 | 288 GB HBM4 | 384 GB HBM(미디어 공개 자료) |
| HBM 대역폭 | 22 TB/s | 17.2 TB/s(미디어 공개 자료) |
| 온칩 메모리 | 아키텍처 구성에 따라 다름 | 768 MB SRAM(미디어 공개 자료) |
| 칩 간 인터커넥트 | NVLink 6 | 저지연 네트워크 Boardfly(TPU 8i 시스템) |
| 소프트웨어 생태계 | CUDA 및 주요 추론 엔진 | JAX, TorchTPU, vLLM / SGLang TPU 백엔드 |
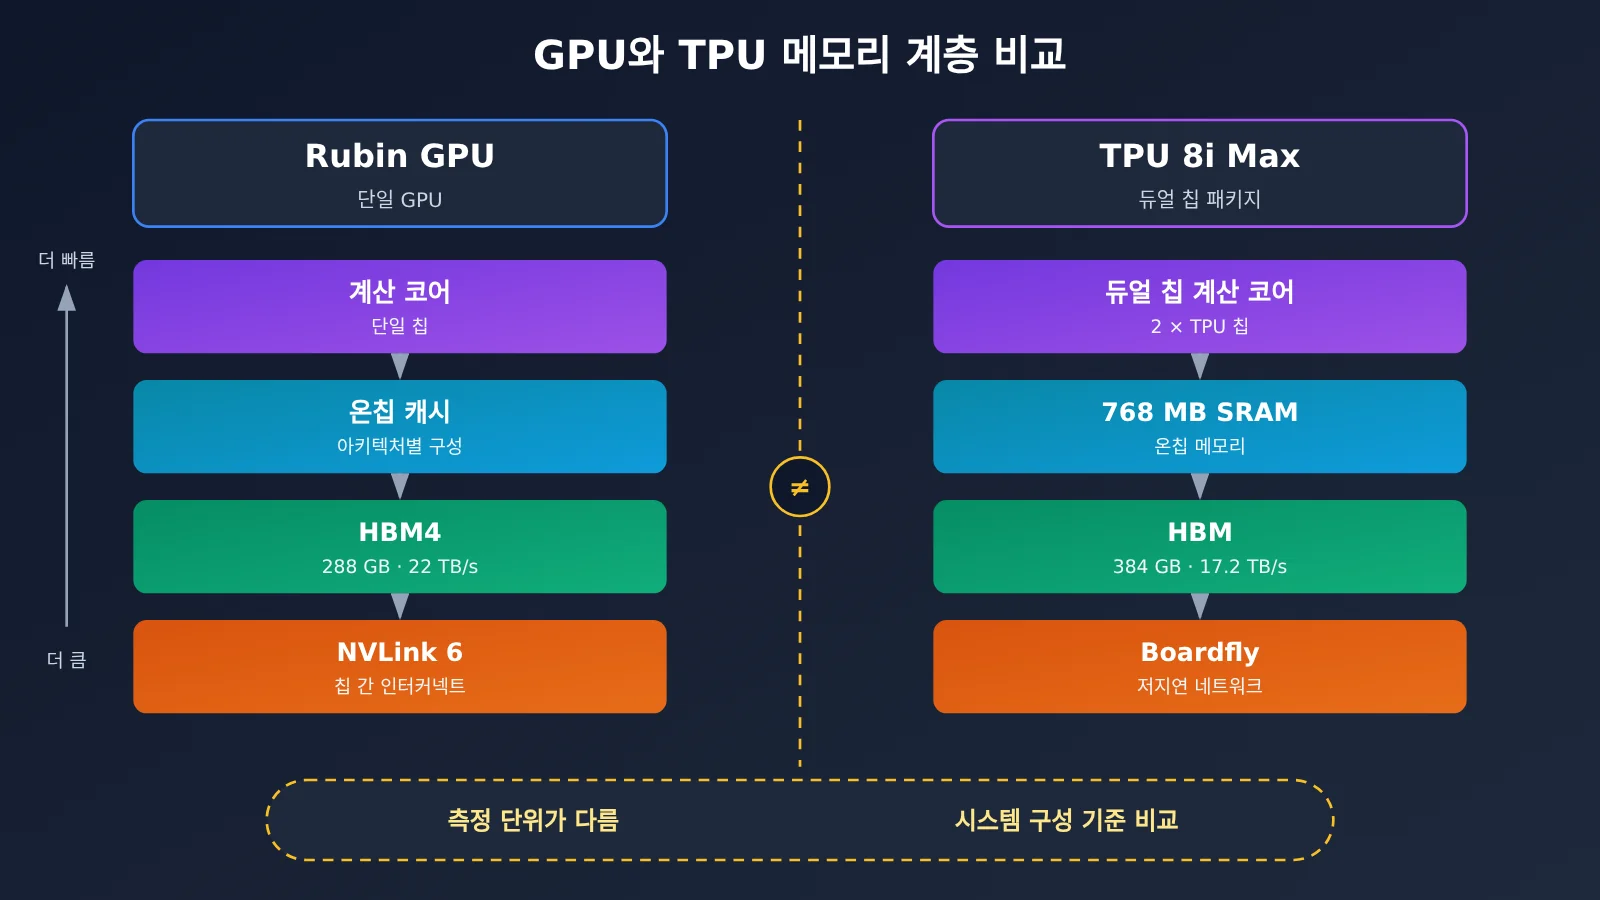
이 표만으로 단순 순위를 매길 수는 없어요. 384 GB와 288 GB의 비교 대상은 각각 듀얼 칩 패키지와 GPU 1개예요. HBM 세대, 인터커넥트 방식, 연산 아키텍처, 전체 시스템 구성도 모두 다르죠. 대역폭만 보면 Rubin GPU 1개가 더 높고, 용량만 보면 TPU 8i Max가 더 크지만, 어느 쪽이든 시스템 규모를 고려하지 않고 따로 논하기는 어려워요.
실제로 비교해야 할 항목은 동일한 전력 소비량, 랙 공간, 비용으로 전체 시스템이 얼마나 많은 유효 동시 컨텍스트를 안정적으로 지원하는지, 그리고 이를 유지할 때의 처리량·지연 시간·에너지 효율이에요. 2026년 11월 10일 기준으로 TPU 8i Max는 공개적으로 검증할 수 있는 독립 실측 결과가 아직 없어요. 이런 시스템 수준의 비교는 정식 상용화 이후 공개될 데이터를 기다려야 해요.
💡 선택 팁: API를 통해 에이전트를 구축하는 대부분의 팀은 기반 하드웨어가 GPU인지 TPU인지 직접 결정할 필요가 없어요. 각 모델의 긴 컨텍스트 처리 시 지연 시간과 단가를 비교하는 편이 실용적이죠. APIYI apiyi.com의 통합 인터페이스를 통해 여러 모델을 병렬로 테스트하고, 실제 업무 프롬프트를 사용해 비교해 보세요.
TPU 8i Max가 에이전트 개발자에게 미치는 영향 분석
컨텍스트 윈도우, 실제 동시 처리량, 추론 지연 시간 구분하기
모델에 표시된 컨텍스트 윈도우는 ‘이론상 얼마나 많은 내용을 담을 수 있는지’만 알려줘요. 이 길이의 입력을 서버가 실제로 몇 개나 동시에 처리할 수 있는지는 보여주지 않으며, 지연 시간이 감당할 만한지도 알 수 없어요. 앞서 계산한 것처럼 컨텍스트 윈도우가 128K로 같아도 세션이 1개일 때와 8개일 때의 KV Cache 크기는 8배 차이가 나요. 개발자는 다음 세 가지 지표를 구분해서 살펴봐야 해요.
- 컨텍스트 윈도우: 모델이 처리할 수 있는 최대 범위로, 한 번에 얼마나 많은 자료를 넣을 수 있는지 결정해요.
- 실제 동시 처리 능력: 주어진 하드웨어에서 긴 세션을 동시에 몇 개나 유지할 수 있는지를 나타내며, HBM 용량의 제약을 받아요.
- 추론 지연 시간: TTFT는 Prefill 연산량의 영향을 받고, 토큰 생성 속도는 대역폭과 KV Cache 크기의 영향을 받아요.
보급이 확대되는 세 가지 메모리 완화 기술
하드웨어는 메모리 월 문제를 해결하는 방법의 절반일 뿐이고, 나머지 절반은 소프트웨어에 있어요. Google이 같은 시기에 오픈소스로 공개한 TPU Sync와 TPU용 vLLM, SGLang은 모두 다음 기술을 중심으로 합니다.
| 기술 | 해결하는 문제 | 비용 또는 주의 사항 |
|---|---|---|
| KV Cache Offloading | 당장 사용하지 않는 캐시를 HBM에서 호스트 DRAM, SSD 또는 공유 스토리지로 옮겨 용량 한계를 넘어섭니다. | 캐시를 복구할 때 전송 시간이 필요하고, 효율적인 DMA와 비동기 전송에 의존합니다. |
| KV Cache 양자화 | 요소당 바이트 수를 줄여 용량과 대역폭 사용량을 직접 낮춥니다. | 정확도에 미치는 영향을 평가해야 합니다. |
| Prefill / Decode 분리 | 연산 집약적인 Prefill과 대역폭 집약적인 Decode를 서로 다른 노드에 배포합니다. | 노드 간 KV Cache를 빠르게 전송해야 합니다. |
| Prefix Caching | 동일한 시스템 프롬프트와 이전 접두부를 재사용해 Prefill이 반복되는 것을 방지합니다. | 요청 접두부가 얼마나 자주 반복되는지에 따라 효과가 달라집니다. |
Google이 공개한 TPU Sync 데이터에 따르면 KV Cache 전송 지연은 90% 넘게 줄었고, 64K 컨텍스트에서 접두부 캐시를 사용했을 때 TTFT는 최대 90% 감소했습니다. 다만 이 테스트는 7세대 Ironwood TPU를 기반으로 했으며, GitHub README에 현재 검증 중인 하드웨어로 명시된 제품은 v7x와 v6e입니다. 따라서 이 결과를 TPU 8i Max의 성능으로 간주해서는 안 됩니다.
실제 성능과 리소스 비용에 미치는 영향
API 호출자에게 이런 저수준 최적화는 결국 두 가지로 나타나요. 긴 컨텍스트 요청의 지연 시간이 안정적인지, 그리고 토큰 단위로 과금되는 비용이 줄어드는지예요. 애플리케이션에서도 메모리 사용량을 줄이는 방식을 참고할 수 있어요. 시스템 프롬프트를 간결하게 다듬고 접두부를 일정하게 유지해 캐시를 적중시키고, 도구 출력은 요약해서 컨텍스트에 다시 넣으세요. 하위 에이전트에는 전체 기록 대신 필요한 부분만 전달하면 돼요.
아래 예제에서는 스트리밍 출력을 사용해 컨텍스트 길이에 따른 첫 토큰 지연 시간을 측정해요. 컨텍스트가 길어질수록 프리필에 어떤 영향을 미치는지 확인할 수 있어요.
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

def measure_ttft(context: str, model: str = "gpt-4o-mini") -> float:
    start = time.perf_counter()
    stream = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": context + "\n请用一句话总结上文。"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            return time.perf_counter() - start
    return -1.0

print(f"TTFT: {measure_ttft('示例代码片段 ' * 2000):.2f}s")
여러 모델과 길이를 일괄 테스트하는 코드 보기
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 하나의 키로 여러 모델 제공업체 전환
)

MODELS = ["gpt-4o-mini", "claude-sonnet-4", "gemini-2.5-flash"]
LENGTHS = [1_000, 5_000, 20_000]  # 반복 횟수로 컨텍스트 크기를 대략 늘립니다

def run_once(model: str, repeat: int) -> dict:
    context = "def handler(event):\n    return process(event)\n" * repeat
    start = time.perf_counter()
    first, tokens = None, 0
    try:
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": context + "\n指出上面代码的潜在问题。"}],
            stream=True,
            max_tokens=200,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                tokens += 1
                if first is None:
                    first = time.perf_counter() - start
        total = time.perf_counter() - start
        return {"model": model, "repeat": repeat, "ttft": first, "total": total, "chunks": tokens}
    except Exception as e:
        return {"model": model, "repeat": repeat, "error": str(e)}

for m in MODELS:
    for n in LENGTHS:
        print(run_once(m, n))
🚀 빠른 시작: APIYI apiyi.com에 가입하면 무료 테스트 크레딧을 받을 수 있어요. 위 스크립트의
base_url을https://api.apiyi.com/v1로 유지하면 몇 분 안에 여러 모델의 컨텍스트 길이별 TTFT 곡선을 확인할 수 있어요.
업계에 미치는 영향
- 시스템 수준의 맞춤화 가속: Google이 ‘같은 실리콘, 서로 다른 시스템’ 방식으로 세분화된 워크로드에 맞춘 구성을 빠르게 선보였어요. 가속기 경쟁의 초점이 단일 칩의 사양에서 시스템 설계로 옮겨가고 있다는 뜻이에요.
- 소프트웨어와 하드웨어의 협업이 표준으로 자리 잡음: TPU 8i Max는 TPU Sync, Agent Compute Engine, TPU용 추론 엔진과 함께 공개됐어요. 메모리 장벽을 해결하려면 하드웨어 대역폭과 소프트웨어 스케줄링이 모두 필요해요.
- 상용화는 아직 초기 단계: TPU 8i Max는 8t, 8i, 8tx와 마찬가지로 ‘Coming soon’으로 표시돼 있어요. 공개 가격과 정식 출시일이 아직 없으므로 실제 가성비는 검증이 필요해요.
자주 묻는 질문 FAQ
Q1: TPU 8i Max란 무엇인가요?
TPU 8i Max는 Google이 2026년 11월 9일 공개한 8세대 TPU 시스템 구성입니다. TPU 8i 두 개를 하나의 패키지에 통합해 연산 성능, 온칩 SRAM, HBM 대역폭을 각각 TPU 8i의 2배로 높였으며, 긴 컨텍스트와 높은 동시성, 여러 에이전트의 협업 추론을 주로 겨냥합니다. 완전히 새로 설계한 칩은 아닙니다.
Q2: TPU 8i Max의 HBM 용량도 두 배로 늘었나요?
아니요. 언론 브리핑에 따르면 HBM 용량은 288 GB에서 384 GB로 약 33% 증가했습니다. 두 배로 늘어난 항목은 HBM 대역폭(약 8.6 TB/s에서 17.2 TB/s)과 SRAM(384 MB에서 768 MB)입니다. 용량과 대역폭은 서로 다른 지표이므로 혼동하지 않아야 합니다.
Q3: 지금 TPU 8i Max를 사용할 수 있나요? 가격은 얼마인가요?
2026년 11월 10일 기준으로 Google Cloud 공식 제품 페이지에는 TPU 8i Max가 ‘Coming soon’으로 표시돼 있습니다. 공개 가격과 정식 GA 일정은 아직 발표되지 않았으며, 공개적으로 검증할 수 있는 독립 성능 테스트도 없습니다. 현재 참고할 수 있는 자료는 Google의 공식 발표와 언론 브리핑에 공개된 사양뿐입니다.
Q4: TPU 8i Max를 사용하면 단일 모델에서 백만 토큰 컨텍스트를 지원할 수 있나요?
Google은 백만 토큰 규모의 컨텍스트를 목표 활용 사례로 제시했지만, 공개된 고정 최대 컨텍스트 사양은 아닙니다. 모델이 처리할 수 있는 컨텍스트 길이는 우선 모델 자체에 달려 있습니다. 하드웨어는 해당 길이에서 어느 정도의 동시성을 유지할 수 있는지, 지연 시간이 감당할 만한 수준인지를 좌우합니다.
Q5: 애플리케이션 개발자는 긴 컨텍스트가 지연 시간에 미치는 영향을 어떻게 확인할 수 있나요?
가장 직접적인 방법은 실제 서비스 컨텍스트를 다양한 길이로 구성해 TTFT와 출력 속도를 측정하는 것입니다.
1. APIYI apiyi.com에 접속해 계정을 만들고 API 키와 무료 테스트 크레딧을 받으세요.
2. 이 글의 테스트 스크립트를 사용하고, `base_url`을 `https://api.apiyi.com/v1`로 설정하세요.
3. 같은 컨텍스트 세트에서 여러 모델을 바꿔 가며 길이에 따른 지연 시간 증가 추이를 비교하세요.
Q6: KV Cache 양자화와 오프로딩에는 어떤 한계가 있나요?
양자화는 메모리와 대역폭 사용량을 직접 줄일 수 있지만, 정확도 저하가 생길 수 있으므로 목표 작업에서 평가해야 합니다. 오프로딩은 HBM 용량 한계를 넘어설 수 있지만, 데이터를 다시 가져오는 데 시간이 걸립니다. 메모리 계층 간 전송 속도가 충분히 빠르지 않으면 오히려 지연 시간이 늘어날 수 있습니다. 두 방법 모두 동시 처리 규모와 지연 시간 목표를 고려해 매개변수를 조정해야 합니다.
Agent의 긴 컨텍스트와 TPU 8i Max 핵심 요약
- 병목의 이동: Agent 추론은 연산 성능 경쟁에서 연산과 메모리 데이터 공급의 균형을 맞추는 방향으로 바뀌고 있어요.
- KV Cache의 선형 증가: Llama 3.1 70B는 토큰당 약 320 KiB를 사용해요. 128K 단일 요청에서는 약 40 GiB가 필요해요.
- GQA의 중요성: KV Head가 8개면 캐시 사용량이 표준 멀티헤드 어텐션의 8분의 1로 줄어요.
- 대역폭을 많이 쓰는 Decode: 토큰을 생성할 때마다 KV Cache 전체를 읽어야 하므로, 컨텍스트가 길어지면 대역폭이 지연 시간을 좌우해요.
- 동시 확장: TPU 8i Max는 연산 성능, SRAM, HBM 대역폭을 함께 두 배로 늘렸지만, HBM 용량은 약 33%만 증가했어요.
- 소프트웨어도 중요: 오프로딩, 양자화, Prefill/Decode 분리, 프리픽스 캐시는 메모리 병목을 완화하는 주요 방법이에요.
- 직접 검증해 보기: APIYI apiyi.com의 통합 인터페이스를 이용해 여러 모델의 긴 컨텍스트 지연 시간을 직접 비교해 볼 수 있어요.
요약
Agent의 긴 컨텍스트 추론에서 메모리 병목과 관련해 알아둘 핵심은 다음과 같아요.
- 부하의 원인: 코드베이스, 도구 결과, 하위 Agent의 출력이 계속 쌓이고 여러 Agent가 동시에 실행되면 KV Cache가 빠르게 커져요.
- 하드웨어 접근 방식: TPU 8i Max는 단순히 연산 성능만 높이는 대신 연산, SRAM, HBM 대역폭을 함께 확장해 데이터 공급과 연산의 균형을 맞춰요.
- 적용 범위의 한계: HBM 용량 증가 폭은 제한적이고 아직 제품이 상용화되지 않았어요. 실제 가치는 시스템 수준의 실측 데이터로 검증해야 해요.
대부분의 개발자라면 우선 KV Cache의 비용 구조를 이해하고, 애플리케이션 수준에서 컨텍스트가 불필요하게 커지지 않도록 관리하는 편이 현실적이에요. 모델 서비스의 긴 컨텍스트 지연 시간과 가격 변화도 꾸준히 살펴보세요. 실제 업무 데이터를 사용해 여러 모델의 긴 컨텍스트 성능을 비교하려면 APIYI apiyi.com을 이용해 보세요. OpenAI 호환 인터페이스와 신규 사용자 무료 사용량을 제공해요.
📚 참고 자료
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max: 이번 발표의 공식 기술 공지
- 링크:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
설명: 듀얼 칩 패키징과 연산 성능, SRAM, HBM 대역폭이 두 배로 늘어난다는 내용을 확인할 수 있어요.
-
Google Cloud – Inside the eighth-generation TPU: 8세대 TPU 아키텍처 심층 분석
- 링크:
cloud.google.com/blog/products/compute/tpu-8t-and-tpu-8i-technical-deep-dive -
설명: TPU 8i의 원래 사양과 Boardfly 네트워크 아키텍처를 다뤄요.
-
Google Cloud – Introducing TPU Sync: KV 캐시 및 가중치 전송 라이브러리
- 링크:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
설명: 다단계 메모리 구조와 KV 캐시 오프로딩 테스트 데이터를 확인할 수 있어요(Ironwood 기반).
-
Network World – Google targets AI’s next infrastructure bottlenecks: 언론 브리핑 보도
- 링크:
networkworld.com/article/4245897 -
설명: TPU 8i Max의 HBM 용량, 대역폭, SRAM 절대 수치를 다뤄요.
-
Google TPU Sync GitHub: 오픈소스 저장소
- 링크:
github.com/google/tpu-sync - 설명: 호환 하드웨어와 개발 현황을 확인할 수 있어요.
작성자: APIYI 기술팀
기술 문의: APIYI 공식 홈페이지에서 문의해 주세요. 추가 연동 자료는docs.apiyi.com문서 센터에서 확인할 수 있어요.