著者注:30分間のソフトウェア開発Agentタスクを例に、Agentの複数回の呼び出しで発生する通常入力、キャッシュへの書き込み、キャッシュからの読み取り、出力、ツールとの往復にかかる費用を分解します。さらに、3社のサービスのキャッシュ料金を比較し、12回の呼び出し例を通じて、どのような条件でキャッシュが本当にコスト削減につながるのかを解説します。
2026年11月9日、Google Cloudは第8世代TPUシステム「TPU 8tx」と「TPU 8i Max」を発表するとともに、KV Cache転送に使う「TPU Sync」をオープンソース化しました。「Agent時代のメモリウォール」が再び話題となり、多くの開発者が自然にこう考えるでしょう。基盤となるKV Cacheがますます高速化するなか、Agent APIの請求額も安くなるのでしょうか?
この記事のポイント:読み終えると、Agentのコストを算出するための完全な計算式、3社のサービスのキャッシュ料金比較、そしてすぐに実践できるコスト最適化チェックリストが手に入ります。
Agentの複数回API呼び出しにかかるコスト:重要ポイントを早わかり
| 項目 | 詳細 |
|---|---|
| 背景となる出来事 | 2026-11-09、GoogleがTPU 8tx、TPU 8i Max、TPU Syncを発表。AgentのメモリとKV Cacheのボトルネックに焦点を当てています |
| 開発者が気にする点 | 基盤技術の最適化によって、AgentのAPI利用料金を下げられるのか |
| 主な結論 | 利用料金は、通常の入力、キャッシュへの書き込み、キャッシュからの読み取り、出力Token、呼び出し回数、ツールの利用料によって決まります |
| 重要な変数 | プロンプトの先頭部分が安定しているか、キャッシュのTTLがツールの待ち時間をカバーできるか、会話履歴が肥大化していないか |
| 影響する範囲 | コーディングAgent、長文書を扱うAgent、複数Agentの協調など、複数回呼び出しが発生するシナリオ |
Agentが30分かけて作業する場合、どんな流れになるのか
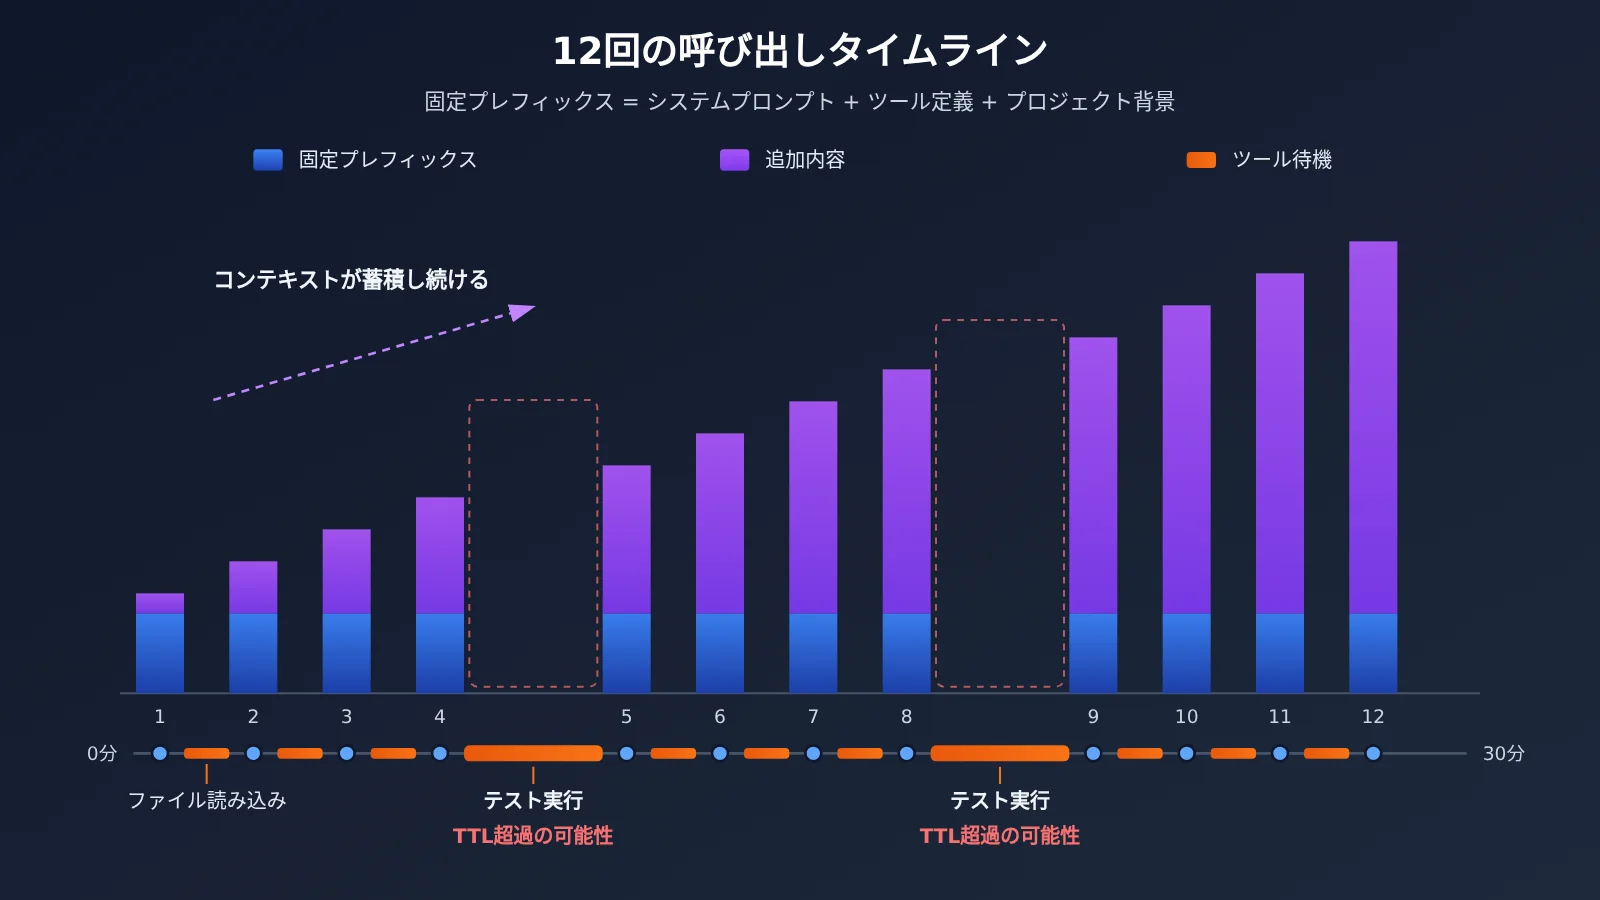
あるソフトウェア開発Agentが、「特定のモジュールで失敗しているテストを修正する」という依頼を受けたとします。まずプロジェクトの構成や関連するソースコードを読み、修正案を作成します。次にツールを使ってファイルを書き換え、テストを実行。テスト結果を待ってから、エラーに基づいてさらに推論を進めます。30分のあいだに、「推論—ツールの実行—待機—推論」というサイクルが十数回繰り返されることもあります。
問題は、大規模言語モデルのAPIが基本的にステートレスであることです。リクエストのたびに、Agentはシステムプロンプト、ツール定義、プロジェクトの背景情報、これまでの会話やツールの出力を、すべてモデルに再送する必要があります。12回目のリクエストには、前の11回分の履歴がほぼすべて含まれていることもあります。これが「コンテキストの重複計算」が発生する理由です。
エージェントの複数回のAPI呼び出しで発生するコストの内訳
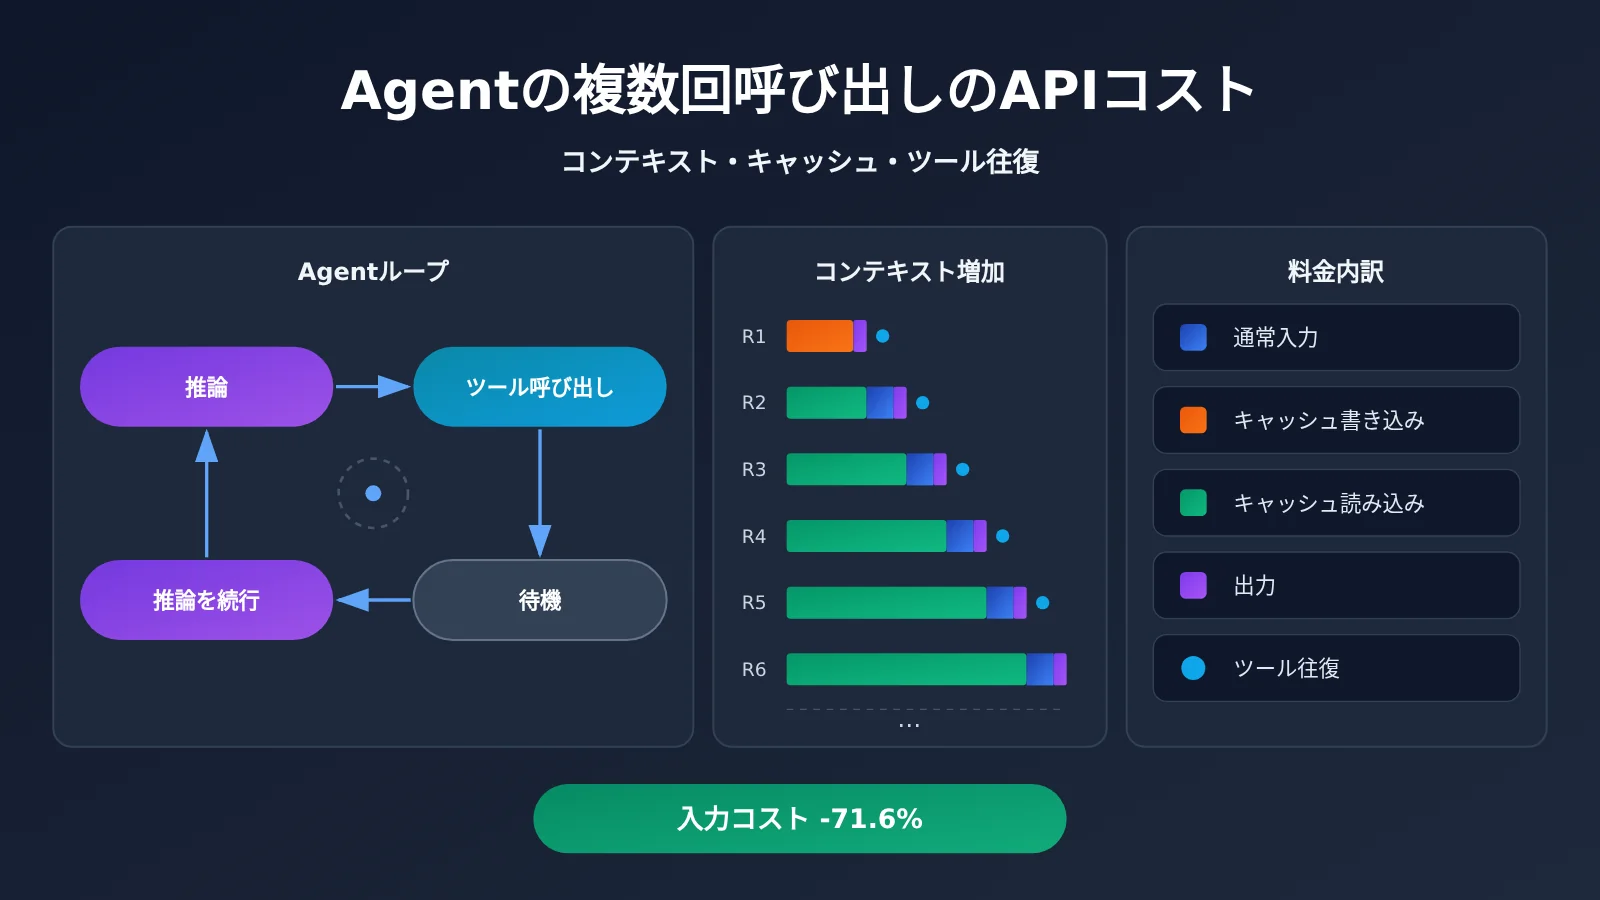
エージェントのタスクを分解すると、費用は少なくとも5つの項目に分けられます。最初の4つはモデルのトークン料金で、5つ目はモデルの外部で発生するものの、見落とされがちな費用です。
| コスト項目 | 内容 | 課金の特徴 |
|---|---|---|
| 通常入力 | キャッシュにヒットせず、標準料金で処理される入力トークン | 標準の入力単価 |
| キャッシュ書き込み | 再利用可能なキャッシュを作成するための入力 | 一部のサービス提供事業者やモデルでは、標準の入力料金より高い倍率で課金される |
| キャッシュ読み取り | 既存のキャッシュにヒットした入力 | 通常、標準の入力単価より大幅に安い |
| 出力トークン | ツール呼び出しのパラメーターを含む、モデルが生成した内容 | 一般に最も単価が高く、キャッシュでは削減できない |
| ツールと外部処理 | 検索、コード実行、データベースなどの外部サービス | 各サービスの料金体系に基づいて課金され、モデルの呼び出し回数も増える |
これをもとに、1つのタスクのコストは次のように表せます。
タスクの総コスト = Σ(通常入力 × 入力単価 + キャッシュ書き込み × 書き込み単価 + キャッシュ読み取り × 読み取り単価 + 出力 × 出力単価)+ ツールと外部処理の費用
式のΣは、タスク内のモデル呼び出しをすべて合計することを表します。つまり、呼び出し回数そのものがコストの乗数になります。ツールとのやり取りが増えるほどモデルの呼び出しも増え、固定のプレフィックスが繰り返し課金される回数も増えます。ツール呼び出しでは、ツール自体の利用料がかかるだけではありません。1回の推論が複数回に分かれ、そのたびにコンテキストを再度渡す必要があります。
Agentのマルチターン呼び出しにおけるKV Cache、Prompt Cache、コンテキスト圧縮の違い
Agentのコストについて話すとき、混同されやすいのがこの3つの概念です。それぞれ異なるレイヤーに属し、請求額への影響も大きく異なります。
| 技術 | レイヤー | 具体的な意味 | APIユーザーへの影響 |
|---|---|---|---|
| KV Cache | モデル推論の基盤レイヤー | 注意機構の計算で使われるKey/Valueの状態を保存し、過去のTokenの再計算を避ける | ユーザーが直接制御するものではなく、サービス提供者のコストやレイテンシに影響する |
| Prompt Cache | APIサービスレイヤー | サービス提供者がプロンプトの重複したプレフィックスを再利用し、キャッシュへの書き込みと読み出しを別途課金する | 請求書のキャッシュ関連項目に直接反映される |
| コンテキスト圧縮 | アプリケーションレイヤー | 履歴を要約、選別、または削減してからリクエストに含める | 実際に送信するToken数を減らせる一方、細部が失われる可能性がある |
注目すべき点として、OpenAIの公式ドキュメントによると、Prompt Cacheが実際に保存するのは元のTokenテキストではなく、KV Tensorです。そのため、Prompt Cachingは、基盤レイヤーにおけるKV状態の再利用機能をサービス化し、課金対象にしたものと捉えられます。KV Cacheと無関係というわけではありませんが、ユーザーが認識できるのは課金ルールだけです。
一方、コンテキスト圧縮は別の仕組みです。変わるのは「どのように再利用するか」ではなく、後続のリクエストに「何を含めるか」です。圧縮を強めるほどToken数は減りますが、Agentが重要な詳細を忘れてしまうリスクも高まります。
Agentのマルチターン呼び出しにおける基盤最適化が、請求額の低下に直結しない理由
Googleが今回発表したTPU 8i Maxは、HBM帯域幅とオンチップSRAMを2倍にしました。TPU Syncは、Ironwoodプラットフォームの内部テストでKV Cacheの転送レイテンシを90%超削減しています。また、Agent Compute Engineは、Agentがアイドル状態のときにセッションを一時停止し、ワーキングメモリをチップの外に移します。これらの最適化は、サービス提供者のリソース利用率や推論レイテンシ(TTFTなど)に作用し、ユーザーにとっては応答の高速化として感じられる可能性があります。
しかし、API価格はサービス提供者が決める商業上の価格設定であり、ユーザーへの請求は引き続きToken数に基づいています。ハードウェア効率の向上が長期的に価格へ影響する可能性はありますが、その効果が自動的に、また同じ割合で価格に反映されるわけではありません。さらに、TPU 8txとTPU 8i Maxは、2026-11-10時点でも「Coming soon」とされており、価格はまだ発表されていません。開発者がすぐに制御できるのは、自分たちのToken構成であり、上流のハードウェアではありません。
AgentのマルチターンAPI呼び出しにかかるコスト:3社のキャッシュ課金を比較
主要3社はいずれもキャッシュ機能を提供していますが、適用条件やTTL、課金方式には大きな違いがあります。以下の表は各社の公式ドキュメントをもとにまとめたものです。詳細は、利用するモデルやインターフェースの説明をご確認ください。
| サービスプロバイダー | キャッシュ方式 | TTLの選択肢 | 書き込み料金 | 読み取り料金 | 利用可能なプラットフォーム |
|---|---|---|---|---|---|
| OpenAI | Prompt Caching。モデルによる自動プレフィックスキャッシュに対応 | 一部の新しいモデルではデフォルトで30分。一部のモデルでは12時間にも対応 | 該当する設定に対応したモデルとインターフェースの場合:30分は通常の入力料金の1.25倍、12時間は2.5倍。その他のキャッシュ方式では、書き込み料金が別途かからない場合もあります | 通常は通常の入力料金の0.1倍。一部のモデルではさらに低価格 | 公式API、APIYI apiyi.com |
| Anthropic | Prompt Caching | デフォルトで5分。最大1時間まで延長可能 | 5分は通常の入力料金の1.25倍、1時間は2倍 | モデルによって異なります | 公式API、APIYI apiyi.com |
| Google Gemini | Context Caching。暗黙的キャッシュと明示的キャッシュ | 明示的キャッシュではTTLを設定可能 | 明示的キャッシュでは、キャッシュするトークン数と保存期間に応じた料金が別途かかります | キャッシュがヒットすると、入力の重複による料金を削減できます | 公式API、APIYI apiyi.com |
Claude Sonnet 5.5の公式価格を例にすると、通常の入力は100万トークンあたり$2.00、5分間のキャッシュ書き込みは$2.50、1時間のキャッシュ書き込みは$4.00、キャッシュ読み取りは$0.10です。キャッシュ読み取りは通常の入力料金のわずか5%です。繰り返し使うプレフィックスによってコストを大幅に抑えられるのは、このためです。
なお、OpenAIはキャッシュが毎回ヒットするとは限らないと明記しています。また、Geminiの明示的キャッシュも「保存料が無料」というわけではなく、保存期間に応じた料金がかかります。キャッシュは条件付きの割引であり、自動的に適用される値下げではありません。
🎯 技術的なアドバイス:上流のモデルによってキャッシュ機能や課金ルール、返却フィールドは異なります。共通のゲートウェイを利用しても、すべてのモデルで同じキャッシュ割引が適用されるわけではありません。APIYI apiyi.comを通じて、同じOpenAI互換コードで候補モデルを個別にテストし、実際に返されるusageフィールドと請求額を確認することをおすすめします。
Agentのマルチターン呼び出しにおけるキャッシュコストを試算:12回呼び出す場合
前述の30分間の開発タスクを引き継ぎ、Claude Sonnet 5.5の公式価格を使って試算します。前提条件は次のとおりです。
- タスク全体でモデルを12回呼び出し、毎回の入力は22,000トークン
- そのうち20,000トークンは、システムプロンプト、ツール定義、プロジェクトの背景情報など、毎回繰り返される内容
- 毎回の新規入力は2,000トークン
- 1時間のキャッシュを利用し、以降のリクエストではすべて正常に再利用できる
キャッシュを使わない場合:12 × 22,000 × $2 / 1,000,000 = $0.528。
1時間キャッシュを使う場合:初回の20,000トークンの書き込みが$0.080、初回の通常入力2,000トークンが$0.004、以降11回分のキャッシュ読み取りが$0.022、以降11回分の新規入力が$0.044となり、合計は$0.150です。入力コストを約71.6%削減できます。
この例では入力トークンのみを計算しており、出力トークン、ツール呼び出し、外部サービスの費用は含めていません。実際のAgentでは履歴がターンごとに増えていきますが、結論は変わりません。繰り返し使われるコンテキストは、Agentのマルチターン呼び出しで最もコストが膨らみやすい要素です。
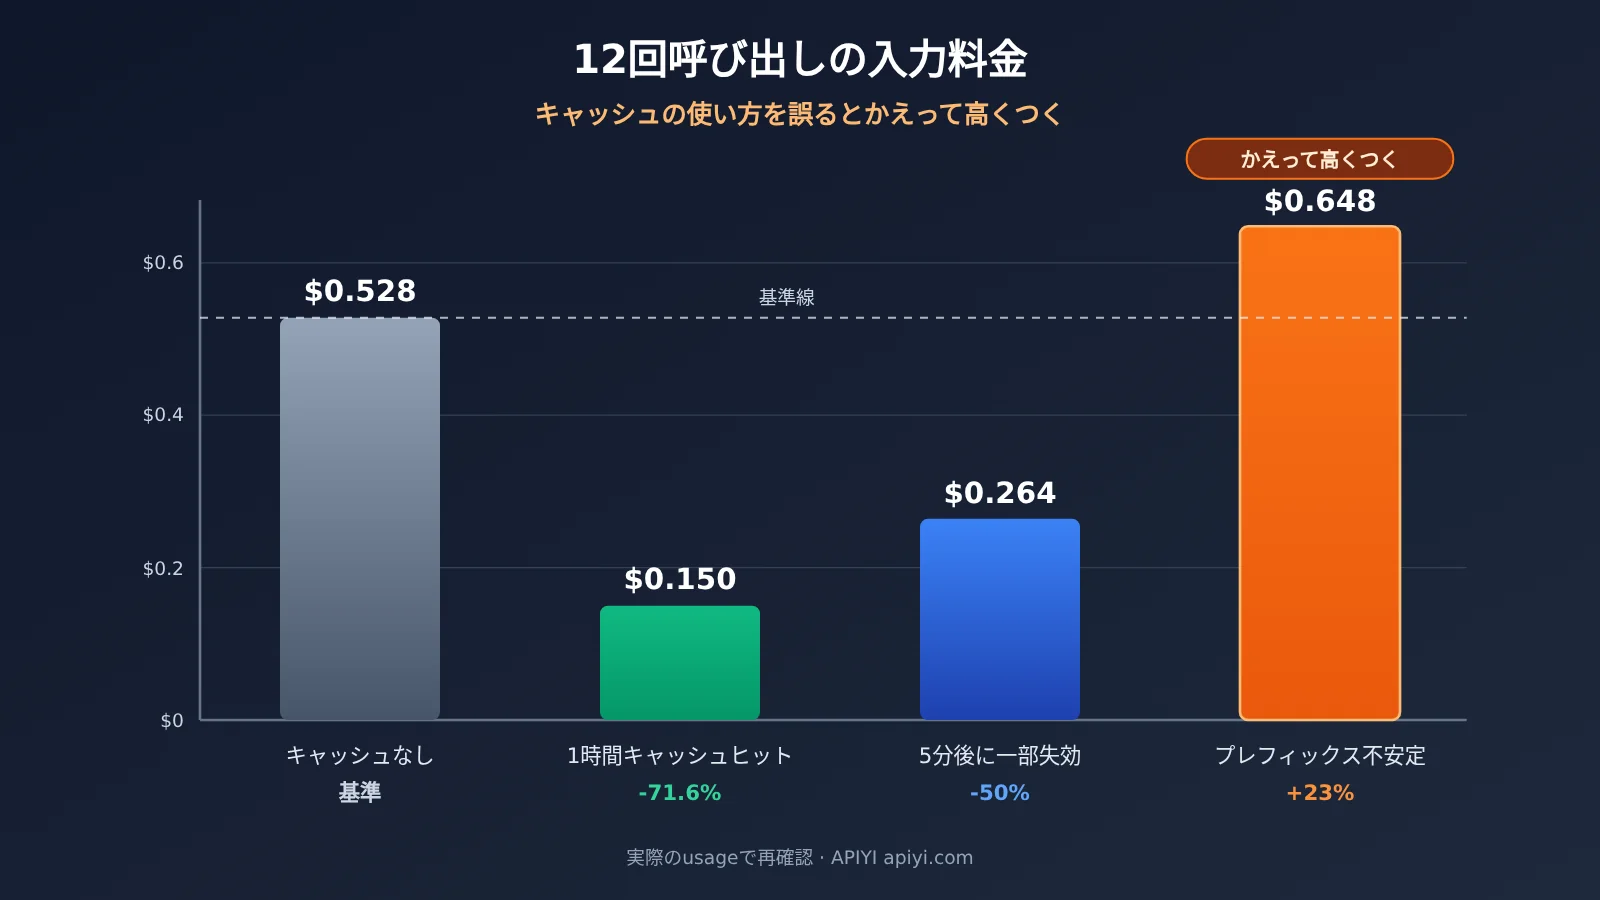
キャッシュの失効、プレフィックスの変化、TTLがAgentのコストに与える影響
ここまでは理想的なケースです。同じ価格を使い、よくある3つの「想定外のケース」を追加で試算します(以下は、記事内で公式単価をもとに独自に計算した例です)。
| シナリオ | 前提 | 入力コスト | キャッシュなしとの比較 |
|---|---|---|---|
| キャッシュなし | 12回すべて通常入力として課金 | $0.528 | 基準 |
| 1時間キャッシュですべてヒット | 初回に1回書き込み、以降11回読み取り | $0.150 | 約71.6%節約 |
| 5分キャッシュですべてヒット | 書き込み単価$2.50、以降11回読み取り | $0.120 | 約77.3%節約 |
| 5分キャッシュで一部失効 | ツールの待機中にタイムアウトし、書き込みが計4回、読み取りが8回 | $0.264 | 約50%節約 |
| プレフィックスが不安定 | リクエストごとにプレフィックスが変わり、12回すべてが5分キャッシュの書き込み料金で課金 | $0.648 | かえって約23%割高 |
判断に役立つポイントをまとめます。
- TTLはツールの待ち時間をカバーするように設定する:5分キャッシュは書き込み料金が安い一方、テストの実行や人による確認に5分以上かかるとキャッシュが失効し、再び書き込みが発生します。その結果、節約効果は大きく低下します。
- TTLよりもプレフィックスの安定性が重要:タイムスタンプやランダムIDをプロンプトの先頭に置くと、リクエストごとにキャッシュがヒットしなくなります。書き込み時に割増料金がかかる方式では、キャッシュを使うことでかえってコストが増える場合があります。
- TTLは長ければよいとは限らない:1時間キャッシュの書き込み単価は5分キャッシュの1.6倍です。呼び出し間隔が5分を超える可能性がある場合にのみ、長いTTLを選ぶメリットがあります。
Agentの複数ターン呼び出しにかかるAPIコストを削減する方法
最小限の例:呼び出しごとのキャッシュヒットを記録する
最適化の第一歩は、コストを「見える化」することです。次のコードは、OpenAI互換インターフェースでリクエストを送信し、usageに含まれるキャッシュ関連のフィールドを表示します。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI互換インターフェース
)

resp = client.chat.completions.create(
    model="your-model-name",  # テストするモデルに置き換えてください
    messages=[
        {"role": "system", "content": "固定的なシステムプロンプトとツールの説明……"},
        {"role": "user", "content": "今回追加するタスクの内容"}
    ]
)
usage = resp.usage
details = getattr(usage, "prompt_tokens_details", None)
print("入力:", usage.prompt_tokens, "出力:", usage.completion_tokens,
      "キャッシュヒット:", getattr(details, "cached_tokens", None))
完全な実装を見る:安定したプレフィックス + タスク単位のコスト追跡
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 固定プレフィックス:システム指示、ツール定義、共通のプロジェクト背景情報を先頭に置き、バイト単位で同一に保つ
STABLE_PREFIX = [
    {"role": "system", "content": "あなたはコード修正Agentです。ツール定義とプロジェクト規約は以下のとおりです……"},
]

@dataclass
class TaskCost:
    # 単価:100万Tokenあたりの米ドル。使用するモデルの公式価格を設定してください
    input_price: float
    cache_read_price: float
    output_price: float
    records: list = field(default_factory=list)

    def add(self, usage):
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        uncached = usage.prompt_tokens - cached
        cost = (uncached * self.input_price
                + cached * self.cache_read_price
                + usage.completion_tokens * self.output_price) / 1_000_000
        self.records.append({"cached": cached, "uncached": uncached,
                             "output": usage.completion_tokens, "cost": cost})

    def summary(self):
        total_in = sum(r["cached"] + r["uncached"] for r in self.records)
        hit = sum(r["cached"] for r in self.records) / max(total_in, 1)
        return {"calls": len(self.records), "cache_hit_rate": round(hit, 3),
                "total_cost": round(sum(r["cost"] for r in self.records), 4)}

def run_turn(history, new_msg, tracker, model="your-model-name"):
    # 新しいメッセージだけを追加し、履歴の順序は変更しない。タイムスタンプなどの動的な情報は末尾に置く
    history.append({"role": "user", "content": new_msg})
    resp = client.chat.completions.create(
        model=model, messages=STABLE_PREFIX + history)
    tracker.add(resp.usage)
    history.append({"role": "assistant",
                    "content": resp.choices[0].message.content})
    return resp

tracker = TaskCost(input_price=2.0, cache_read_price=0.1, output_price=0.0)
history = []
run_turn(history, "テスト test_auth に失敗しました。エラーは以下のとおりです……", tracker)
print(tracker.summary())
なお、上記の見積もりで考慮しているのは読み取り時の割引のみです。使用するモデルでキャッシュへの書き込みに別途料金が発生する場合は、返却されるフィールドに応じて書き込み分も追加してください。usageのフィールド名や意味はモデルによって異なることがあるため、実際の返却値を確認してください。
🚀 すぐに試す:まずはAPIYI(apiyi.com)の無料テスト枠で上記の追跡スクリプトを実行してみましょう。同じタスクを異なるモデルで処理した際のキャッシュヒット率とタスクあたりのコストを確認してから、本番環境で使うモデルやTTLを決めるのがおすすめです。
Agentのマルチターン呼び出しでコストを最適化する5つの方法
- プロンプトのプレフィックスを安定させる:システム指示、ツール定義、共通の参考資料は先頭に置き、タイムスタンプやユーザーごとに変わる情報は末尾に配置します。ツール定義の順序やフィールドも、むやみに変更しないようにしましょう。
- TTLを適切に選ぶ:呼び出し頻度が高く、間隔の短いタスクには短いTTLを使います。長時間のテストやビルド、人による承認を伴うAgentでは、長いTTLによる書き込みコストが、再書き込みの回避による節約で相殺できるかを検討しましょう。
- 履歴コンテキストを管理する:履歴は追加のみとし、並べ替えは避けてキャッシュのプレフィックスを維持します。長大なツール出力は要約し、重要な結論、タスクの状態、必要な根拠を残しましょう。
- 不要なモデル呼び出しを減らす:まとめて実行できるツールは1回の呼び出しに集約し、確定的な処理はモデルに判断させずコードで実行します。往復回数を根本から減らしましょう。
- 実際の指標を監視する:タスクごとに、通常の入力、キャッシュへの書き込み、キャッシュからの読み取り、出力Token、キャッシュヒット率、TTFT、総コストを記録します。評価には単一リクエストのコストではなく、タスク単位のコストを使いましょう。
Agentのマルチターン呼び出しがAPIコストに与える影響
開発者への影響
- コストモデルを「単一リクエスト」から「単一タスク」へ見直す必要がある:Agentの費用は一連の呼び出し全体で決まるため、単価だけを見ると実際の請求額を大幅に過小評価してしまいます。
- プロンプトエンジニアリングで課金構造も考慮するようになる:プレフィックスの安定性がキャッシュの有効性を左右するため、プロンプトの構成設計もコスト最適化の一部になります。
- 複数モデルの選定には実測が欠かせない:キャッシュの割引率、TTL、書き込みコストの上乗せ分はモデルによって異なります。同じタスクでも、モデルを変えるとコストに大きな差が生じることがあります。
業界への影響
- インフラ競争の焦点はAgentの負荷へ:Googleがメモリ帯域幅、KV Cacheの転送、Agentの一時停止と再開を重視していることから、マルチターンや長いコンテキストが主流の負荷形態になっていると分かります。
- ユーザーへのメリットは、まずレイテンシに表れる:基盤技術の最適化によって、まずTTFTやスループットが改善します。Token価格が下がるかどうかはサービス提供者の価格戦略次第なので、開発者は予算にあらかじめ織り込まないようにしましょう。
よくある質問(FAQ)
Q1:Agentの複数ターンにわたる呼び出しで、APIコストが想定より高くなるのはなぜですか?
APIはステートレスで、呼び出しのたびにシステムプロンプト、ツールの定義、過去の会話コンテキストを再度送信する必要があるためです。呼び出し回数が増えるほど、こうした固定コンテンツに対する課金も繰り返されます。ツールとのやり取りが加わると、呼び出し回数はさらに増えます。
Q2:KV CacheとPrompt Cacheは同じものですか?
厳密には異なります。KV Cacheはモデル推論の内部で状態を再利用する仕組みです。一方、Prompt Cacheは、サービス提供者がAPIレイヤーで再利用可能なプレフィックスをキャッシュし、その利用料金を計算する仕組みです。OpenAIのドキュメントによると、保存されるのはKV Tensorです。ユーザーが把握できるのはPrompt Cacheの課金ルールであり、KV Cacheを直接制御することはできません。
Q3:Googleが新しいTPUを発表したら、APIの価格はすぐに下がりますか?
そう判断できる根拠はありません。TPU 8txとTPU 8i Maxは、2026-11-10時点でまだComing soonとなっており、価格も発表されていません。ハードウェアの最適化によって主に改善されるのは、サービス提供者のリソース利用効率やレイテンシです。それがトークン価格に反映されるかどうかは、各サービス提供者の価格設定によって異なります。
Q4:キャッシュを使えば必ずコストを削減できますか?
必ずしもそうではありません。プレフィックスが毎回変わってキャッシュがヒットせず、さらに利用するモードでキャッシュへの書き込みに追加料金がかかる場合、キャッシュを使わないときより費用が高くなることがあります。ツールの待機時間がTTLを超える場合も、頻繁に書き込み直すことで節約効果が薄れます。
Q5:複数のモデルのキャッシュ効果を手早く比較するには?
同じAgentタスクを複数のモデルで実行し、同一の手順で、キャッシュヒット率とタスクあたりの総コストを記録することをおすすめします。APIYI(apiyi.com)では、1つのAPIキーでOpenAI、Claude、Geminiなどのモデルを呼び出せます。modelパラメーターを切り替えるだけで比較できます。
Q6:コンテキストの圧縮にはどのようなリスクがありますか?
圧縮すると、後続のリクエストで送信される内容が変わるため、重要な詳細が失われる可能性があります。その結果、Agentが同じミスを繰り返し、かえって呼び出し回数が増えることもあります。また、圧縮後の内容を毎ターン生成し直すと、キャッシュのプレフィックスが変わってしまうため、キャッシュ戦略と合わせて設計する必要があります。
Q7:統合ゲートウェイ経由で呼び出す場合、キャッシュによる割引はすべてのモデルで同じですか?
同じではありません。キャッシュ機能、課金ルール、レスポンスフィールドは、接続先のモデルによって異なります。APIYI(apiyi.com)でテストする際は、モデルごとにキャッシュ関連のフィールドと実際の課金額を確認したうえで、コストの見積もりに含めてください。
AgentのマルチターンAPI呼び出しコストの要点
- コストの単位はタスク:Agentの請求額は、単発のリクエストではなく、呼び出しチェーン全体の合計です。
- コストの大半はコンテキストの繰り返し:12回呼び出す例では、1時間のキャッシュにより入力コストを約71.6%削減できます。
- キャッシュ割引には条件がある:プレフィックスが安定していない場合やTTLが短すぎる場合、削減効果が薄れ、かえってコストが増えることもあります。
- 3社で課金方式が異なる:書き込み倍率、読み込み時の割引、ストレージ料金は、モデルごとに確認が必要です。
- ハードウェアの最適化が請求額の低下につながるとは限らない:基盤レベルのKV最適化は、まずレイテンシを改善します。料金はサービス提供者の価格設定によって決まります。
- まず計測してから最適化する:APIYI(apiyi.com)の統一インターフェースを活用し、各モデルのキャッシュヒット率とタスクコストを実測しましょう。
まとめ
Agentのマルチターン呼び出しにかかるAPIコストは、コンテキストの重複計算、キャッシュヒット、ツールとの往復によって決まります。どれも欠かせない要素です。
- コンテキストの重複計算がコストの基準になります。呼び出し回数が増えるほど、重複も増えます。
- キャッシュヒットによって、重複部分にどれだけ割引が適用されるかが決まります。プレフィックスの安定性とTTLが重要です。
- ツールとの往復は外部費用を発生させるだけでなく、モデルの呼び出し回数も増やします。
Googleによるインフラ層でのKV Cacheやメモリーウォールへの取り組みによって、Agentの動作は高速化します。一方、開発者がすぐに調整できるのは、自分たちのトークン構成です。プレフィックスの安定化、適切なTTLの設定、履歴の簡素化、呼び出し回数の削減、タスク単位でのモニタリングの5つから始めましょう。APIYI(apiyi.com)を活用し、実データで各最適化の効果を検証することをおすすめします。
📚 参考資料
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max:第8世代TPUの新システム発表
- リンク:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
説明:AgentのメモリウォールとKV Cacheの背景を理解するための資料
-
Google Cloud Blog – Introducing TPU Sync:KV Cacheと重みの転送を行うオープンソースライブラリ
- リンク:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
説明:低レイヤーでのKV Cache転送の最適化と、テストの評価基準を解説
-
OpenAI API ドキュメント – Prompt Caching:キャッシュの仕組みとベストプラクティス
- リンク:
platform.openai.com/docs/guides/prompt-caching -
説明:プレフィックスキャッシュのルール、保持期間、モニタリングの推奨事項を紹介
-
Anthropic ドキュメント – Prompt Caching:キャッシュのTTLと料金
- リンク:
docs.anthropic.com/en/docs/build-with-claude/prompt-caching -
説明:5分間および1時間のキャッシュにおける書き込み・読み取り料金を解説
-
Google AI for Developers – Context Caching:Geminiの暗黙的・明示的キャッシュ
- リンク:
ai.google.dev/gemini-api/docs/caching - 説明:明示的キャッシュのTTLとストレージ料金について解説
著者:APIYI技術チーム
技術交流:APIYI(apiyi.com)のトップページからお気軽にお問い合わせください。接続に関する資料は、ドキュメントセンター(docs.apiyi.com)でもご覧いただけます。