著者注:Astra が Qwen3.5-0.8B の重みを書き換えた実験の検証を通じて、推論モデルの評価における「答えを間違えた」と「答えを書き終えられなかった」の違い、そして出力の打ち切り有無で結果を分けて分析する方法を解説します。
11月2日、MIT CSAIL の4人の研究者がブログ記事「重み空間プログラミングの火花」を公開しました。記事によると、GPT-6 Astra が Qwen3.5-0.8B のパラメータの約0.016%を書き換えただけで、MATH-500 のスコアが7.9%から48.1%に上昇。GSM8K と IFEval でも大幅にスコアが伸びたことから、「AI が AI の脳を改造した」画期的な出来事として広く拡散されました。
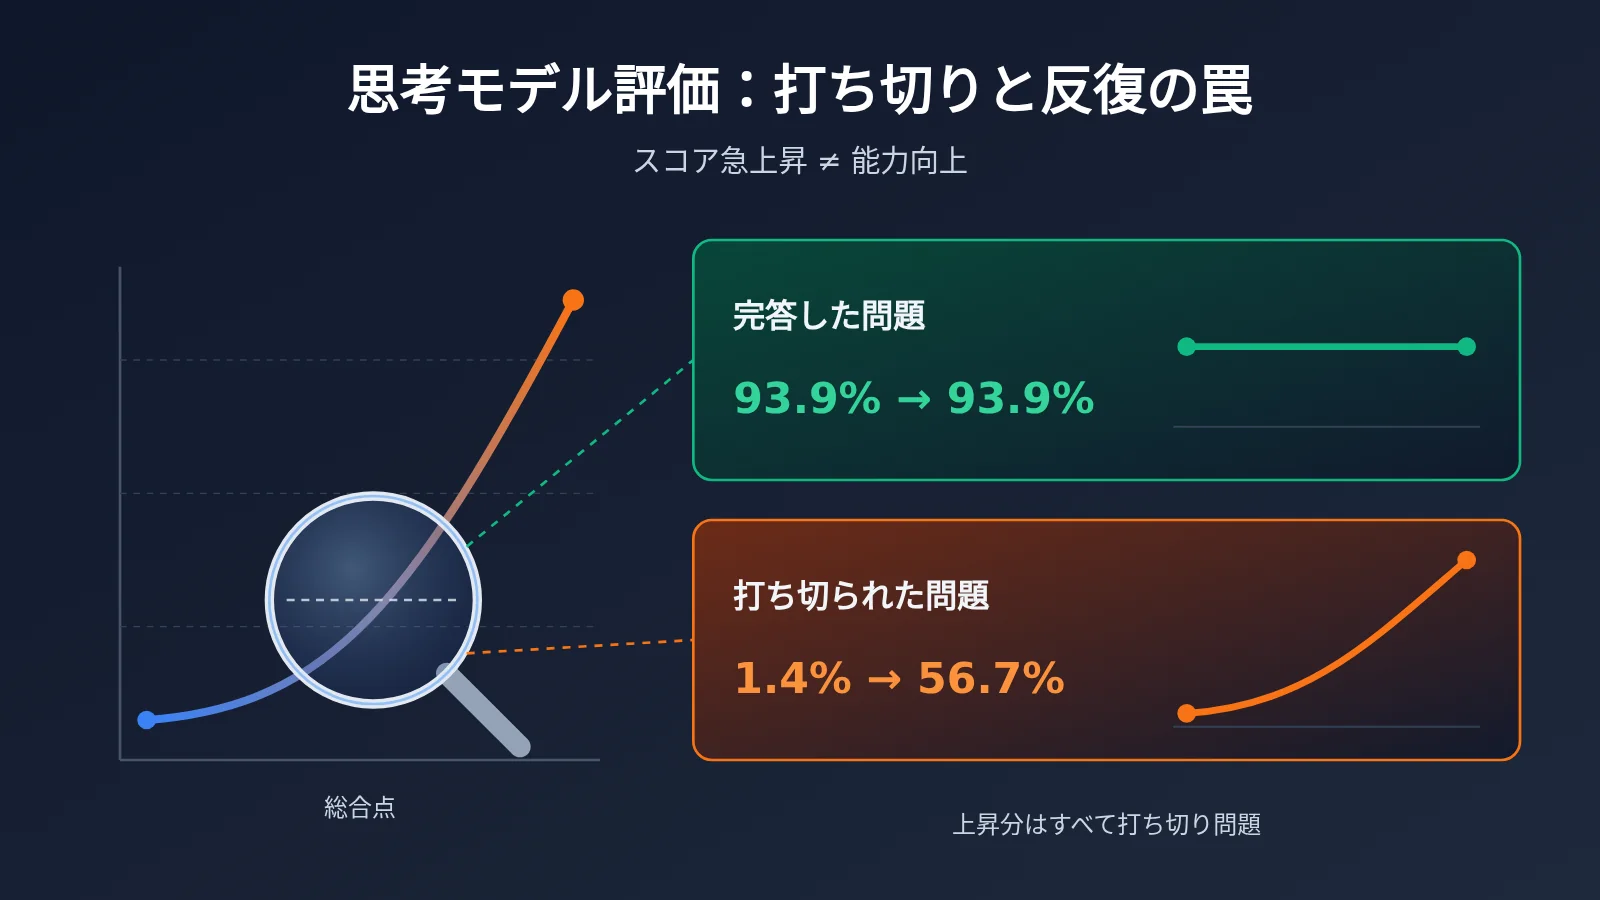
これは研究を否定するものではありません。研究の公開リポジトリには1,125回の呼び出しに関する各ラウンドのログが残されています。メディアが問題ごとの記録を再集計したところ、よりシンプルな結論が見えてきました。スコア上昇のほぼすべては「モデルがようやく答えを書き終えられるようになった」ことによるもので、「数学の問題を解く能力が向上した」ためではなかったのです。
この記事のポイント:RSI が成立したかどうかは改めて議論しません。今回の検証を、再利用できる推論モデルの評価方法として整理します。モデルの選定やパラメータ調整、運用開始前の評価で、スコアの変化が能力の差によるものなのか、それとも同じ出力の繰り返しによる打ち切りが原因なのかを見極めるための方法です。
思考モデルの評価をめぐる一件:重要情報まとめ
まず、この一件における評価関連の重要な事実をまとめます。以下のデータはすべて、元のブログ記事と、公開リポジトリを検証した報道に基づいています。
| 項目 | 詳細 |
|---|---|
| 公開日 | 2026 年 11 月 2 日、MIT CSAIL の研究者ブログ |
| 変更されたモデル | Qwen3.5-0.8B。131,072 個の重みを変更、全体の約 0.016% |
| 公表されたスコア | MATH-500 7.9%→48.1%;GSM8K 13.8%→67.1%;IFEval 21.0%→62.3% |
| 評価設定 | 思考モードを有効化、出力上限 32,768 token、温度 0.6 |
| ベースラインの状態 | 約 93% の回答が上限に達しても停止しなかった |
| 変更後の状態 | 上限に達した回答の割合が 93% から 33% に低下 |
| 検証の結論 | パッチは主に繰り返しループを修正したもので、数学能力は向上していなかった |
思考モデルの評価で「途中打ち切り」が起きる理由
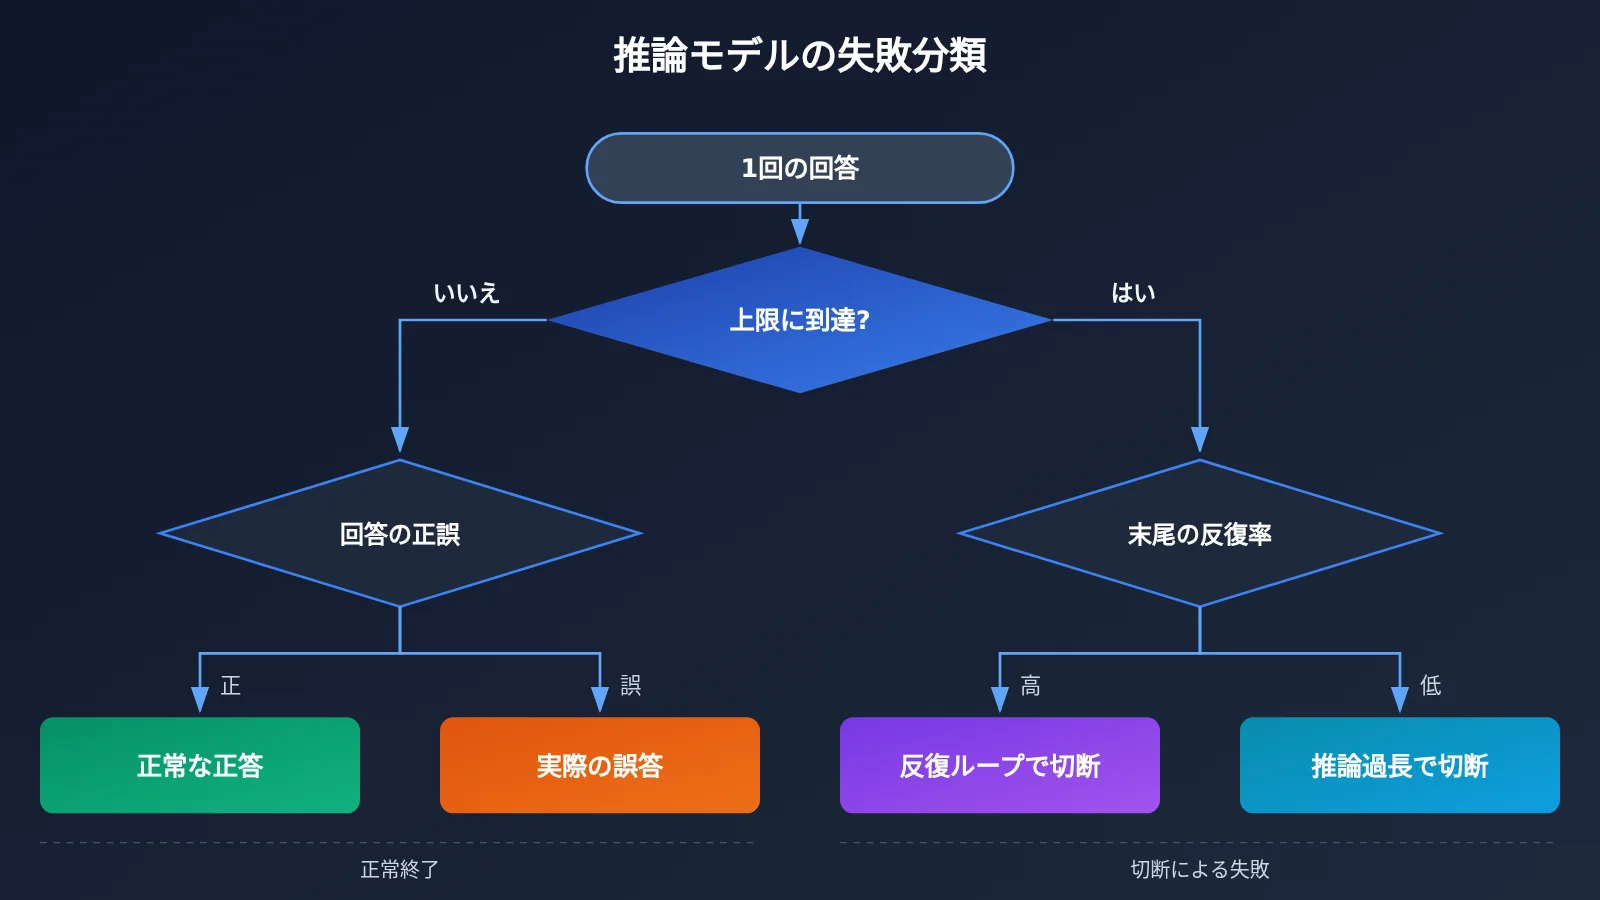
Astra が最初に Qwen で 96 問の練習問題を解かせたところ、正解はわずか 11 問でした。残る 85 問は計算を間違えたのではなく、すべて出力の長さが上限に達しても停止しませんでした。途中で打ち切られたテキストの末尾を 8 語単位で調べると、約 95% が繰り返しでした。正常に回答を終えた 11 問は、すべて正解しています。
つまり、ベースラインのスコアが低かった主な原因は「解けない」ことではなく、「答案を提出できない」ことだったのです。なお、研究者が Astra に最初に与えたプロンプトには、「token 上限で打ち切られる場合、思考の中で同じことを繰り返していることが多い」と失敗の一例が記されていました。また、有効な改善の例として「繰り返しを引き起こす原因を修正する」ことも挙げられています。Astra の最終報告書にも、数学の知識ではなく、繰り返しを対象にしたと明記されています。
思考モデルの評価データを分解:スコア上昇はすべて途中で打ち切られた問題に集中
検証の中で最も説得力があるのは、評価用に取り分けた1,152問の練習問題を使った、変更前後のペアテストです。問題を「もともと回答が途中で打ち切られたかどうか」で2つに分けると、結論がはっきり見えてきます。
| 問題のグループ | 問題数 | 変更前の正答率 | 変更後の正答率 | 変化 |
|---|---|---|---|---|
| もともと最後まで回答できた問題 | 114 | 93.9% | 93.9% | 変化なし |
| もともと途中で打ち切られた問題 | 1,038 | 1.4% | 56.7% | スコア上昇のすべてはここから |
| 不正解から正解に変わった問題 | 579 | — | — | うち576問はもともと途中で打ち切られていた |
| 正解から不正解に変わった問題 | 5 | — | — | ノイズ程度 |
もう一つ、見落としやすい点があります。変更前に「最後まで回答したが不正解だった」問題はわずか7問でしたが、変更後は245問になりました。ループが止まったことで、モデル本来の計算ミスが表面化したのです。正式なMATH-500では、平均回答長が30,868 tokenから22,037 tokenに減少しました。この減少も、もともと上限に達していた回答に集中しています。
対照モデルを使って思考モデルの評価結果を検証
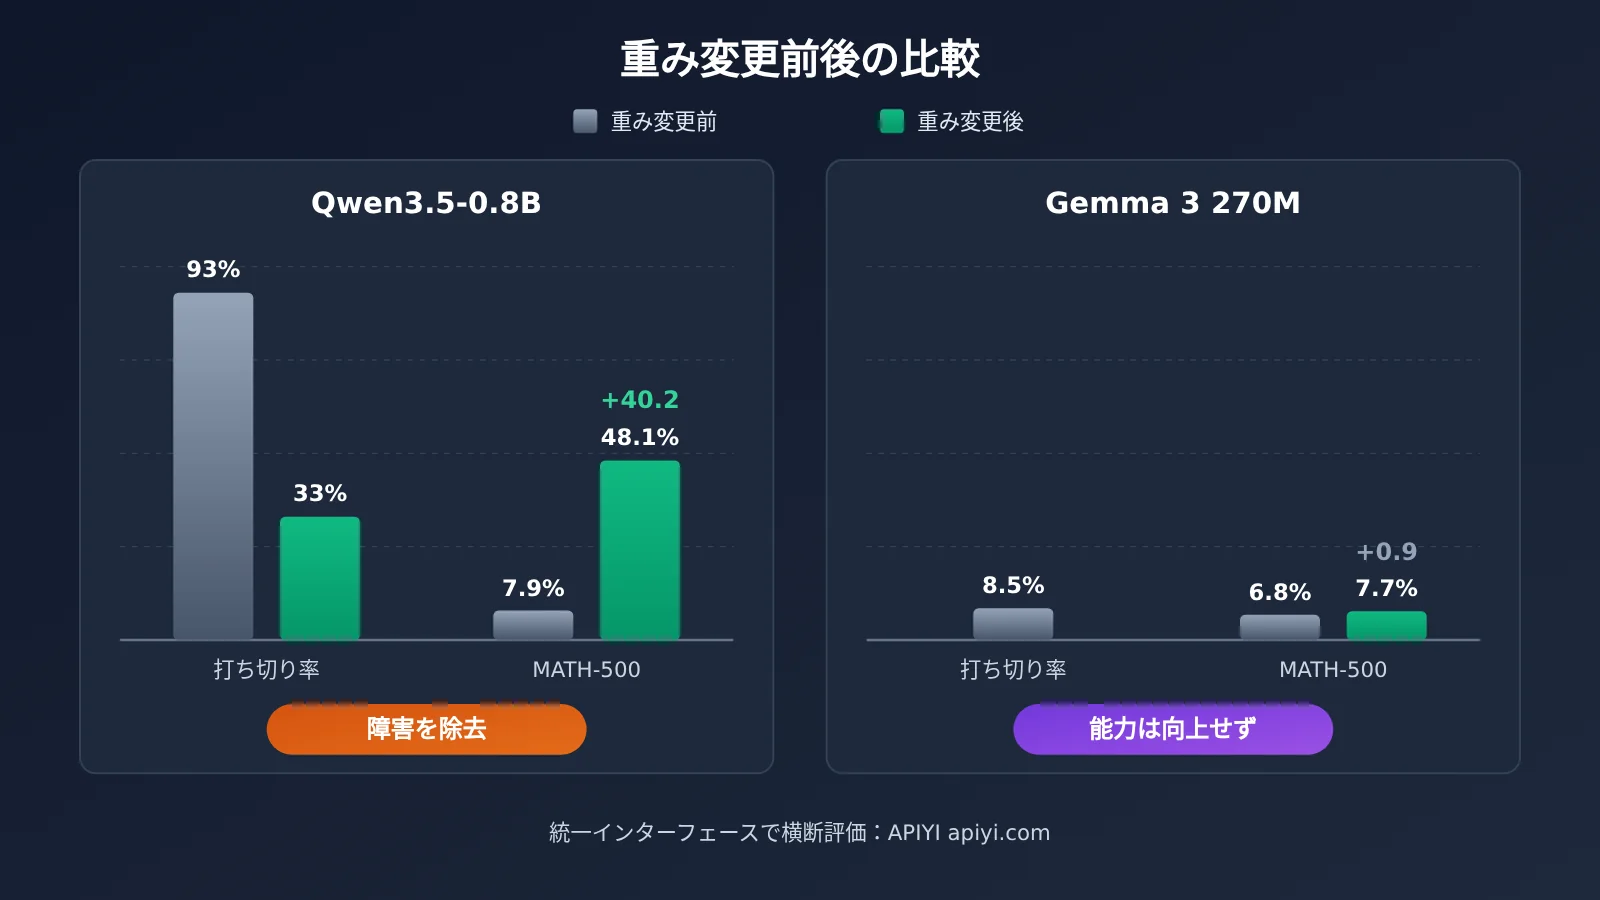
研究者自身もこの点に気づき、Gemma 3 270Mで同じ実験を行いました。2つの実験を比べると、「障害を取り除くこと」と「能力を高めること」は別物だとよくわかります。
| 比較項目 | Qwen3.5-0.8B | Gemma 3 270M |
|---|---|---|
| 上限に達した割合 | 約93% | 約8.5% |
| 主な失敗の種類 | ループを繰り返し、回答を完了できない | 算術ミス、推論ステップの破綻 |
| 重み変更後のMATH-500 | 7.9%→48.1% | 6.8%→最大7.7% |
| 改善の性質 | 能力の発揮を妨げる障害を取り除いた | もともとない能力はほとんど追加できなかった |
元のブログ本文でも、重みの変更は能力の発揮を妨げる障害を取り除くことはできても、モデルにない能力を追加することはできないと認めています。評価者にとって重要なのは、同じ「スコアの大幅上昇」でも、失敗の構造によってその意味はまったく異なるということです。
思考モデルの評価に潜むパラメータの落とし穴:温度と思考モードの切り替え
今回の議論では、見落とされがちな前提がもう一つあります。評価設定そのものがループを誘発しやすいものだった、という点です。検証記事が引用した Qwen3.5-0.8B の公式モデルカードの情報と、研究者が実際に用いた設定には違いがありました。
| パラメータ項目 | モデルカードの説明 | 実験の評価設定 | 影響 |
|---|---|---|---|
| 思考モード | 0.8B ではデフォルトでオフ | 強制的にオン | 小規模モデルは思考ループに陥りやすい |
| 温度(思考モードのテキストタスク) | 推奨値は 1.0 | 0.6 | モデルカードでは 0.6 は画像理解とコーディングのタスクに対応 |
| ループへの対処 | サンプリングパラメータを調整し、ストリーミング出力を適時打ち切る | 32,768 トークンの上限まで出力 | 多くの回答が失敗と判定された |
なお、上記のモデルカードの内容は、メディアの検証記事を通じて伝えられたものです。評価を行う前に、Qwen 公式モデルカードの原文を直接確認することをおすすめします。ここで強調したいのは評価の方法です。同じモデルでも、サンプリングパラメータを変えると「ベースライン」がまったく異なる可能性があります。ベースライン自体がループしやすい設定で測定されていたなら、モデルを「停止できる」ようにする変更は、どれも能力が飛躍的に向上したかのように見えてしまいます。
思考モデル評価のチェックリスト:まず打ち切りを分けてから結論を出す
今回の振り返りから得られた教訓を整理すると、あらゆる思考モデルに使える評価手順が見えてきます。モデルの選定、パラメータの調整、ファインチューニングやプロンプト変更の検証など、どの場面でも次の表に沿ってチェックできます。
| チェック項目 | 具体的な方法 | 判断の目安 |
|---|---|---|
| 1. 打ち切りの有無で分ける | finish_reason == "length" の割合を集計し、グループごとに正答率を計算する |
打ち切り率が10%を超える場合、総合スコアを直接比較できない |
| 2. 繰り返し率を調べる | 打ち切られた回答の末尾で、n-gramの繰り返しを集計する | 末尾の繰り返し率が高ければ、推論が長すぎるのではなく、ループが起きていると考えられる |
| 3. サンプリングパラメータを確認する | モデルカードと照らし合わせ、temperature、top_p、思考機能のオン・オフを確認する | 公式の推奨設定と異なる場合は、その旨を別途明記する |
| 4. ペア比較する | 変更前後の結果を問題ごとに照らし合わせ、不正解から正解、正解から不正解に変わった件数を集計する | スコアの上昇が打ち切りグループに集中していれば、「障害を取り除いた」効果と考えられる |
| 5. 他モデルと比較する | 同じプロンプトとパラメータで、打ち切り率の低い比較対象モデルも評価する | 比較対象モデルのスコアが上がらなければ、改善は能力向上によるものではないと考えられる |
🎯 評価のヒント:他モデルとの比較で面倒なのは、各社のモデルに合わせて呼び出しコードを用意することです。APIYI apiyi.com のOpenAI互換インターフェースを使えば、同じスクリプト、同じプロンプトとパラメータで複数の主要モデルを呼び出せるため、「打ち切り率」を固定の集計列として出力しやすくなります。
思考モデルの評価スクリプト:最小限の例
以下のコードは、一連の問題のうち、長さの上限に達して出力が途中で切れた回答の割合を集計します。finish_reason が length の場合、max_tokens の上限に達したことを示します。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIのOpenAI互換インターフェース
)

questions = ["计算 17 * 23 的结果", "求 1 到 100 的整数和"]
truncated = 0
for q in questions:
    r = client.chat.completions.create(
        model="your-thinking-model",  # 実際のモデル名に置き換える
        messages=[{"role": "user", "content": q}],
        max_tokens=4096,
    )
    if r.choices[0].finish_reason == "length":
        truncated += 1
print(f"截断率: {truncated / len(questions):.1%}")
完全な実装コードを見る(グループ別の正答率と末尾の繰り返し率を含む)
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def tail_repetition_ratio(text: str, n: int = 8, tail_words: int = 400) -> float:
    """テキスト末尾のn-gramの繰り返し率を集計する(中国語では文字単位の分割に変更可能)"""
    words = text.split()[-tail_words:]
    if len(words) < n * 2:
        return 0.0
    grams = [tuple(words[i:i + n]) for i in range(len(words) - n + 1)]
    counts = Counter(grams)
    repeated = sum(c for c in counts.values() if c > 1)
    return repeated / len(grams)

def evaluate(dataset, model, temperature, max_tokens, judge):
    """dataset: [(question, answer)], judge: 回答が正しいかどうかを判定する関数"""
    stats = {"done": [0, 0], "truncated": [0, 0], "loop": 0}
    for q, ans in dataset:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": q}],
            temperature=temperature,
            max_tokens=max_tokens,
        )
        choice = r.choices[0]
        text = choice.message.content or ""
        group = "truncated" if choice.finish_reason == "length" else "done"
        stats[group][0] += 1
        stats[group][1] += int(judge(text, ans))
        if group == "truncated" and tail_repetition_ratio(text) > 0.5:
            stats["loop"] += 1

    for g in ("done", "truncated"):
        total, correct = stats[g]
        rate = correct / total if total else 0
        print(f"{g}: {total} 题,正确率 {rate:.1%}")
    t = stats["truncated"][0]
    print(f"截断题中疑似循环: {stats['loop']} / {t}")
    return stats
思考モードのオン・オフを切り替える方法は、モデルによって異なります。リクエストのフィールドで制御するものもあれば、モデル名で区別するものや、プロンプトのテンプレートに記述するものもあります。思考内容が max_tokens に含まれるかどうかや、別途返されるかどうかもモデルによって異なるため、評価前にそれぞれのドキュメントを確認してください。
🚀 まずは試してみましょう:この分類方法を検証したいだけなら、APIYI(apiyi.com)に登録し、無料テスト枠を使って2〜3種類の思考モデルで数十問を試せます。まずは途中で切れた回答の割合を比較し、その結果を見て評価の規模を広げるかどうかを決めましょう。
思考モデルの評価をめぐる問題の影響分析
開発者への影響
- 総合スコアだけでは信頼できない:全体の正答率だけを見ると、「出力が途中で切れた」と「回答を間違えた」を混同してしまいます。リリース前の評価レポートには、少なくとも出力の打ち切り率とグループ別の正答率を含めるべきです。
- パラメータ調整の効果を誤解する可能性がある:出力上限の引き上げ、温度の調整、繰り返しペナルティの追加によってスコアが大幅に向上することがあります。しかし、これは「障害を取り除いた」のであって、モデル自体が変わったわけではありません。
- 本番環境にも影響する:評価時の出力の打ち切りは、本番環境では応答の長大化、費用の増大、ユーザーの待ち時間として現れます。モデルカード自体でも、ストリーミング出力にループ検出と早期打ち切りを組み合わせることが推奨されています。
モデル評価研究への影響
- 「大幅な向上」の根拠を分解する必要がある:今回の検証は、能力が飛躍的に向上したように見える結果も、出力の打ち切り状況別に分析すると、単なるバグ修正にすぎない可能性があることを示しています。今後、小規模モデルや思考モデルの改善が主張された場合は、打ち切り率の変化も確認する価値があります。
- 対照実験の設計がより重要になる:Gemma 3 270M の追加実験と、Astra 自身が行ったランダムな方向を用いた対照実験(成績の変動は約1.5ポイントにとどまった)は、いずれも真の効果とノイズを区別するうえで、対照実験の設計が重要であることを示しています。
よくある質問 FAQ
Q1:思考モデルの評価における「打ち切りの罠」とは何ですか?
モデルが思考中に同じ内容を繰り返すループに陥り、トークン上限に達するまで書き続けても回答を出せず、評価システムに不正解と判定されることです。この場合の低スコアは「解けない」のではなく、「回答を出し終えていない」ことを示しています。
Q2:打ち切りによる低スコアと、能力不足による低スコアはどう区別しますか?
問題をトークン上限に達したかどうかで2つのグループに分け、それぞれの正答率を計算します。回答を出し終えた問題の正答率が高く、打ち切られた問題ではほぼゼロなら、問題はループにあります。一方、回答を出し終えた問題自体に誤答が多い場合は、能力不足を示しています。Qwen と Gemma の比較は、まさにこの2つのケースに当てはまります。
Q3:Astra が Qwen を改変した今回の実験は、いつ公開されましたか?
元のブログは 2026 年 11 月 2 日に公開され、公開リポジトリのログに基づくメディアの検証記事は 11 月 5 日に公開されました。本文のデータは検証記事に基づいています。モデルカードの詳細は、Qwen の公式原文をご確認ください。
Q4:この評価方法はどのような場面に適していますか?
– **モデル選定**:数学やコードのタスクにおける、異なる思考モデルの性能を比較する
– **パラメータ調整**:温度、上限、思考機能のオン・オフを変更した場合の実際の効果を評価する
– **改善の検証**:ファインチューニング、プロンプト、重みの編集による変化が、能力の向上なのか障害の除去なのかを判断する
Q5:統一されたインターフェースを使って、複数の思考モデルを横断的に評価するにはどうすればよいですか?
1. APIYI apiyi.com でアカウントを登録し、APIキーを取得する
2. 本文のスクリプトの base_url を `https://api.apiyi.com/v1` に設定する
3. プロンプト、温度、max_tokens を固定してモデル名だけを変更し、打ち切り率とグループ別の正答率を出力する
思考機能のオン・オフの指定方法はモデルによって異なるため、それぞれのドキュメントに従ってリクエストパラメータを調整する必要があります。
Q6:このグループ分けの方法にはどのような限界がありますか?
打ち切りによるグループ分けで識別できるのは「回答を出し終えていない」ケースだけで、出し終えた回答が運よく正解したかどうかは判断できません。末尾の繰り返し率のしきい値は言語やタスクに応じて調整する必要があり、中国語テキストは空白ではなく文字単位で分割することをおすすめします。また、思考内容が完全には返されないモデルもあるため、usage のトークン統計と合わせて判断する必要があります。予算が限られている場合は、まず APIYI apiyi.com で少数のサンプルを使って試行し、集計方法を確認してから規模を拡大できます。
思考モデル評価の重要ポイント Key Takeaways
- スコア上昇の内訳:Qwen が最後まで回答した 114 問の正答率は、変更前後ともに 93.9% で、上昇分はすべて途中で打ち切られた問題によるもの
- 失敗のパターン:ベースラインでは回答の 93% が出力上限に達し、末尾の約 95% が繰り返しだった
- パラメータの違い:評価時の温度 0.6 は、モデルカードが推奨する思考テキストの温度 1.0 と一致していない
- 対照モデルの結果:Gemma 3 270M は打ち切り率が低く、重み変更後の MATH-500 の向上幅は 1 ポイント未満だった
- 手法の要点:まず
finish_reasonに基づいて打ち切られた回答を分け、それぞれの正答率を比較する - 試し方:APIYI apiyi.com の統一インターフェースを使い、同じパラメータで複数のモデルの打ち切り率を集計する
まとめ
今回の「Astra による Qwen の重み変更」をめぐる議論は、思考モデルを評価するすべての人にとって、次の点を見直すきっかけになりました。
- スコアが急上昇したら、まず内訳を確認する:トークン上限に達したかどうかでグループを分け、どちらが上昇に寄与したかを見る
- パラメータもベースラインの一部:温度、思考機能のオン・オフ、出力上限をモデルカードと照合し、レポートに明記する
- 障害の除去と能力の向上を区別する:打ち切り率の低い対照モデルを使い、改善の本質を検証する
次に「ある変更でスコアが何倍にもなった」という結論を見かけたら、まず「打ち切り率はどれくらい変わったか」と聞いてみてください。この一問は、総合スコア以上に実態を明らかにしてくれることが少なくありません。
複数の思考モデルを本番投入前に評価するなら、APIYI apiyi.com を通じて同じスクリプトとパラメータで打ち切り率を集計し、その結果を踏まえてモデルの選定方針を決めることをおすすめします。
📚 参考資料
- 硅星人 Pro による振り返り記事(36氪による転載):話題の「Astra による Qwen の頭脳改造」は、私たちが求める RSI とはあまり関係がない
- リンク:
36kr.com/p/4056494372181124 -
説明: 公開リポジトリの問題ごとの記録から再計算したペア比較テストのデータ。本記事の主要なデータソース
-
MIT CSAIL 研究者のブログ:Sparks of Weight-Space Programming
-
説明: 実験の元となる説明と結果表。実験 8 の設定については、原文と照らし合わせて読むことをおすすめします
-
Qwen3.5-0.8B 公式モデルカード:サンプリングパラメータと思考モードの説明
- 説明: 思考モードのデフォルト状態、推奨温度、ループへの対処に関する推奨事項を確認できます
著者: APIYI 技術チーム
技術交流: APIYI 公式サイト apiyi.com からお気軽にお問い合わせください。呼び出し方法の詳細は、ドキュメントセンター docs.apiyi.com をご覧ください