著者注:時間関数 f(t) を使った描画の仕組みと SenseNova 6.8 Code2Video の事例をもとに、動画制作にコード生成とピクセル生成のどちらを使うべきか、4つの質問で判断します。
科学解説や数式の導出、データアニメーションを作るとき、こんな悩みを経験した方は多いのではないでしょうか。映像はきれいなのに文字が間違っていたり、数式が崩れていたりする。再生成すると、今度は別の問題が出てくる。この記事では、コード生成動画とピクセル生成動画の選び方を紹介し、どのような動画なら AI にコードを書かせるべきか、また、そうでない動画は何かを考えます。
この記事は「コードによる手法がすべてに取って代わる」と宣伝するものではありません。 2026年11月3日に公開されたオープンソースモデルの実践共有記事で紹介された SenseNova 6.8 Code2Video を事例に、仕組みと制作フローを解説するとともに、資料ではまだ確認できていない部分もお伝えします。
この記事でわかること:コード生成動画が時間関数 f(t) から MP4 になるまでの仕組みと、作りたい動画にどちらの手法が適しているかを4つの質問で判断する方法。
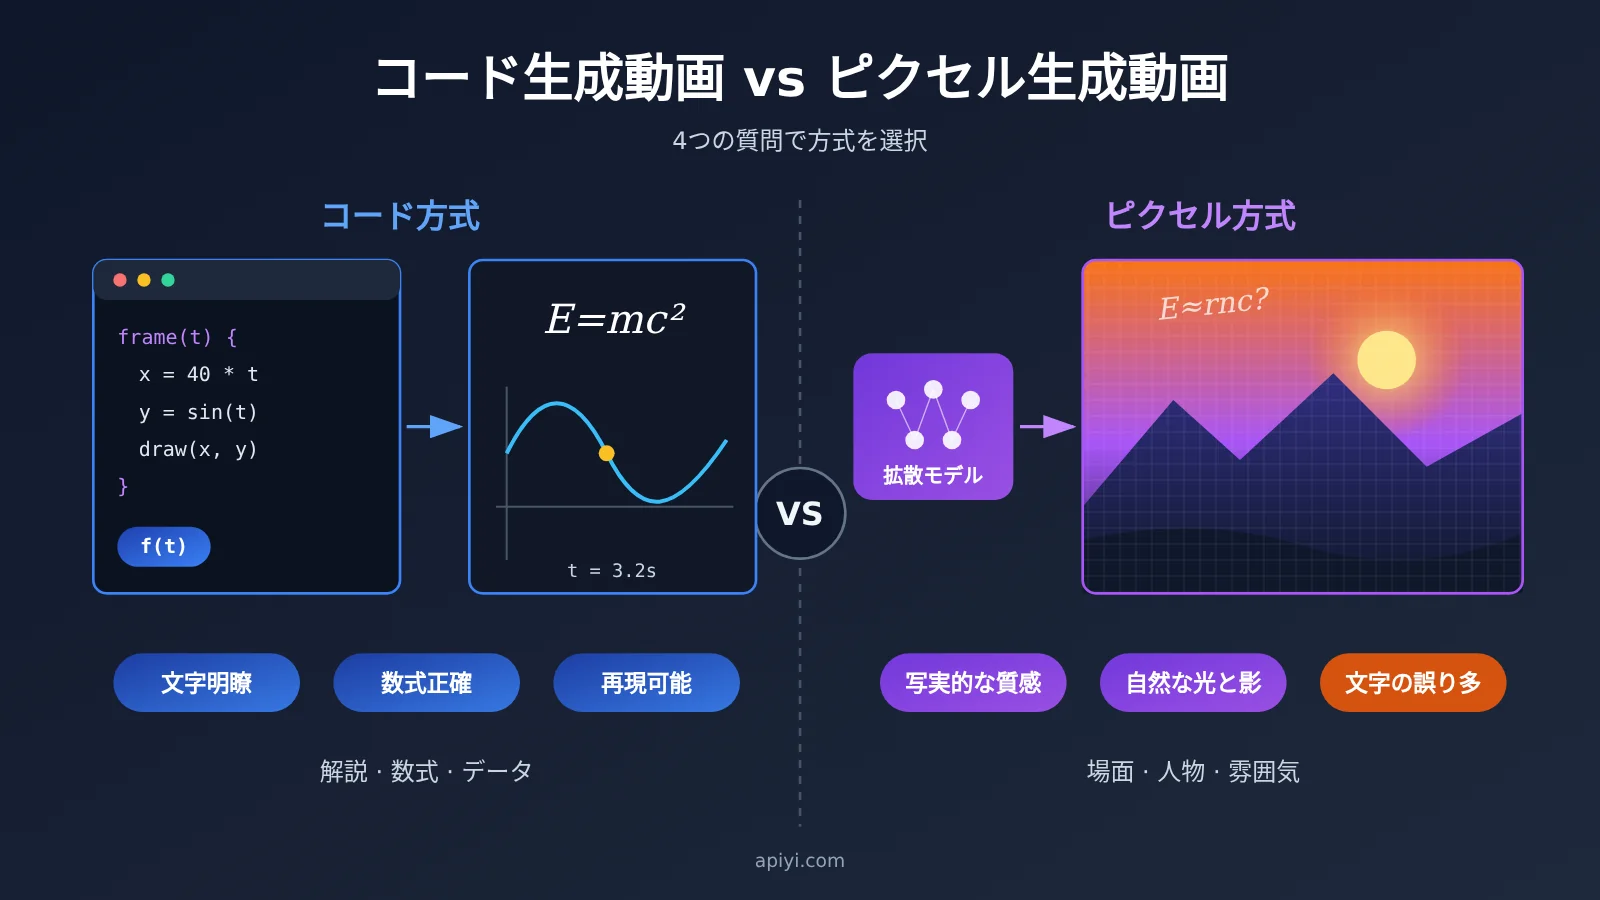
コード生成動画 vs ピクセル生成動画の要点
2つのアプローチの根本的な違いは、モデルの大きさではなく、最終的に何を出力するかにあります。ピクセル生成は映像を直接出力し、コード生成は映像をレンダリングできるプログラムを出力します。
| 比較項目 | コード生成動画 | ピクセル生成動画 |
|---|---|---|
| モデルの出力 | HTML/CSS、Canvas、SVG、Three.js、Manim、p5.js などの実行可能なコード | 各フレームのピクセルを直接生成 |
| 文字と数式 | 文字や入力データとしてレンダリング | モデルが画像として生成。投稿者によると、文字化けや変形がよく見られる |
| 修正方法 | 仕様やソースコードを変更して再レンダリング | 通常はプロンプトを調整して再生成 |
| 再現性 | 同じ純粋関数のコードで繰り返しレンダリングできる | 使用するモデルやツールによる |
| 主なリスク | 写実的な質感が不足する場合があり、レンダリング環境の構築も必要 | 正確な情報を保証しにくく、繰り返し選別する必要がある |
なお、「ピクセル拡散モデルでは文字化け、数式の変形、物体同士のめり込みがよく起きる」というのは投稿者の見解であり、比較テストの結果は示されていません。選定時のリスクとして参考にしつつ、正式に決める前に、自分の素材を使ってそれぞれ試してみることをおすすめします。
コードから動画を生成する仕組み:画面は時間の純粋関数
Code2Video の中核となるのは、各フレームを時間パラメータ t の純粋関数として記述することです。任意の時点を指定すると、プログラムがすべての要素の位置、変形、色を計算します。画面はシステムの実時間に依存しないため、同じコードを繰り返しレンダリングしても、結果は同じになります。
レンダリングの流れは、次の 4 ステップに分けられます。
- 時間関数を書く:モデルが構図、動き、リズムを t に応じて変化するコードとして記述します。
- フレームを順に進める:Playwright がヘッドレス Chromium を起動し、フレームレートに従って時点を順に設定します。たとえば 12 秒、30fps の動画なら、合計 360 フレームのレンダリングが必要です。
- スクリーンショットで連番画像を生成する:各時点で高解像度の画面を撮影します。
- FFmpeg で合成する:連番画像と音声トラックを合成し、最終的な MP4 を作成します。
これは画面録画とは本質的に異なります。画面録画はデバイスのリアルタイム性能に左右されますが、フレームごとのレンダリングでは、あるフレームの計算に時間がかかっても、タイムライン上の位置は変わりません。ただし実際には、シードを固定していない乱数や、マシン間のフォントの違いによって、この決定性が損なわれることもあります。
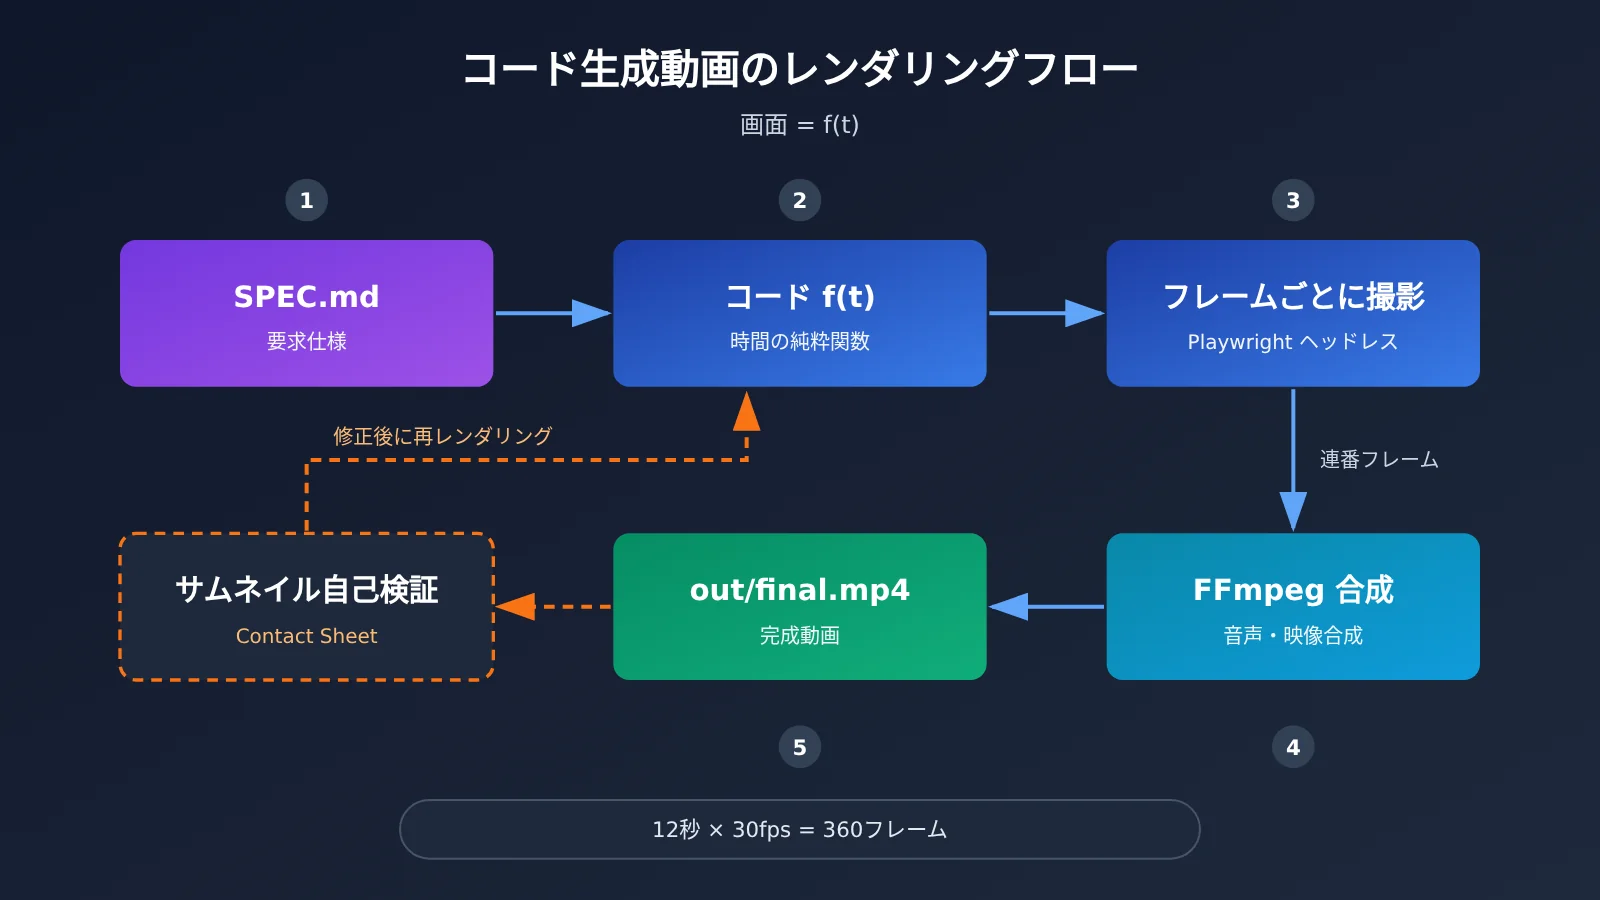
コードによる動画生成の安定性を支えるのは、コードだけでなく仕様
紹介投稿によると、一般的なモデルに一文で指示して生成したコードアニメーションは粗くなりがちです。仕上がりを左右するのは、ワークフローの違いにあります。Code2Video と code-video Skill を組み合わせると、まず要件を検証可能な SPEC.md に落とし込み、構図、配色、イージング曲線、絵コンテのタイムラインを決めます。自然言語による修正も主にこの仕様に反映されるため、何度か調整を重ねても、スタイルやロジックの一貫性を保ちやすくなります。
初回のレンダリング後、モデルはキーフレームを抽出してコンタクトシートを作成し、文字の重なり、要素の画面外へのはみ出し、テンポの問題を確認します。その後、コードを修正して再レンダリングします。投稿によると、1つのタスクで10時間以上、2,000回を超えるツール呼び出しに対応でき、最終的に VERIFY.md と out/final.mp4 を出力します。これらの数値はプロジェクト側の説明によるものです。モデルのパラメータや能力については、公式リポジトリとモデルカードを確認してください。
💡 技術的なヒント:大規模言語モデルをまだ自分でデプロイしたくない場合は、APIYI apiyi.com の統一インターフェースを通じて、複数のテキストモデルに同じ要件から
SPEC.mdを生成させ、絵コンテや制約が明確に書かれているか比較してみましょう。この段階ではレンダリングを行わずに、要件が十分に明確かどうかを手早く検証できます。
4つの質問で判断する、コード生成動画とピクセル生成動画
動画の生成方法を選ぶときは、まずどちらのモデルが優れているかを議論するより、動画の中で間違えられない要素を整理しましょう。次の4つの質問に順番に答えてみてください。
- 一字一句正確でなければならない内容はありますか? 例えば、専門用語、数式、価格、グラフの数値などです。
- 精密に制御する必要がある数値はありますか? 例えば、座標、再生時間、カメラの移動経路、音楽のビートとの同期などです。
- 部分的な修正を繰り返す予定はありますか? 例えば、配色だけを変える、注釈を1つだけ追加するなど、ほかの内容は変えずに済ませたいケースです。
- 映像の価値はリアルな質感に左右されますか? 例えば、実在の人物、実写の環境、自然な光と影などです。
最初の3つの質問のうち2つ以上が「はい」で、4つ目が「いいえ」なら、まずはコードによる生成を検討しましょう。4つ目が「はい」の場合、コードによる生成は第一候補にならない可能性が高いでしょう。ただし、これは原理に基づく推測です。参考資料には写実的なスタイルの比較データがないため、ご自身でテストすることをおすすめします。
| 動画の要素 | 必要な能力 | おすすめの方法 | 判断理由 |
|---|---|---|---|
| 字幕とレイアウト | 文字の正確さ、レイアウトの安定性 | コード優先 | 文字を文字データとして配置できる |
| 数式とグラフ | データと構造の正確さ | コード優先 | 入力した内容を直接反映できる |
| カメラワークとビート | タイミングと経路の正確さ | コード優先 | 再生時間、ビート、経路を数値で指定できる |
| 物理・パーティクルシミュレーション | 方程式に基づく動き | コード優先 | 動きを数学や物理の公式で計算できる |
| 実在の人物と実写の質感 | リアルさと細部の表現 | ピクセル生成または実写優先 | コードによる生成の効果を示す証拠がまだ不足しており、実際のテストが必要 |
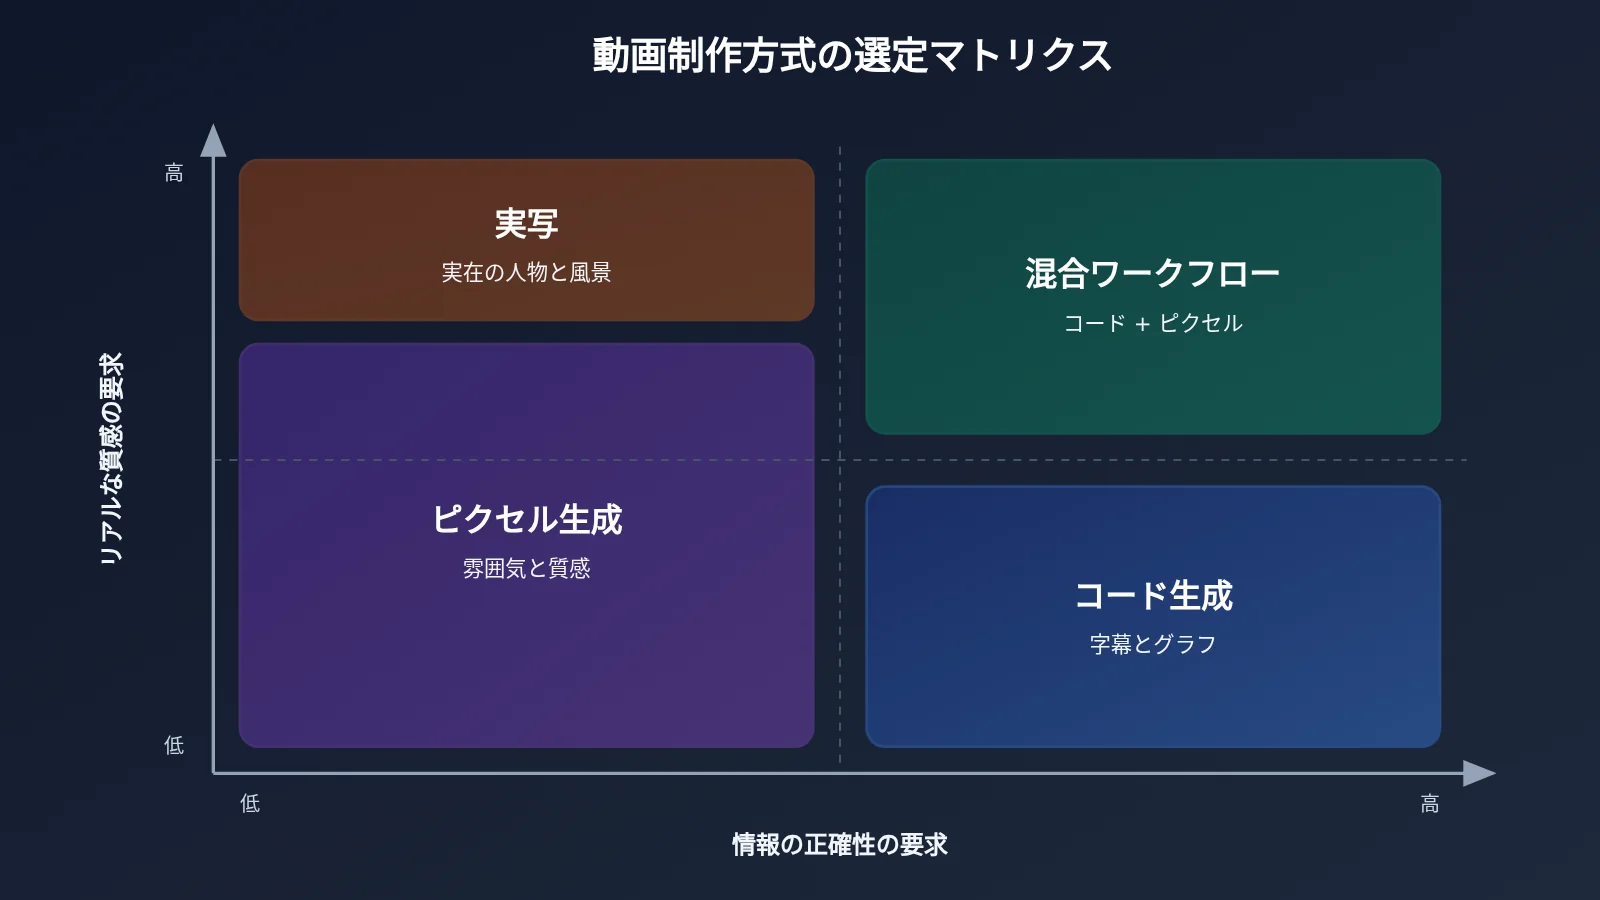
上図に独自の判断基準を加えたい場合は、同じ脚本を使い、APIYI apiyi.com を通じて利用可能なテキストモデルと動画モデルにアクセスし、試作品を比較できます。各モデルの利用可否は、プラットフォームの最新リストをご確認ください。
コード生成動画に適した6つのシーン
code-video Skill には8つの分野の制作ガイドが用意されています。その中から、特に優先して試しやすいシーンをまとめました。表の「適性」は、原理に基づく本記事の判断であり、公式の評価ではありません。
| 動画の種類 | 対応するガイド | 適性 | 注意点 |
|---|---|---|---|
| 科学解説とデータ可視化 | explainer-diagrams.md |
高 | 入力データを事前に確認する |
| 動きのある文字組みとUIアニメーション | motion-graphics-and-promos.md |
高 | 必要なフォントを事前に用意する |
| 音楽のビートに合わせた短編動画 | music-and-beat-sync.md |
高 | ビートとカットの切り替えタイミングを明確にする |
| パーティクル・物理シミュレーション | simulations-and-generative.md |
高 | パラメータとシードを指定する |
| 3D製品紹介 | threejs-scenes-and-cameras.md |
中 | 質感はサンプル動画を見て判断する |
| スタイライズされたキャラクターアニメーション | character-and-creature-motion.md |
中 | 写実的な人物の演技表現とは異なる |
注意したいのは、コードによる生成が保証するのは「入力どおりに正確に表示すること」であって、「内容が必ず正しいこと」ではない点です。脚本に誤った数式が書かれていれば、その誤りも鮮明にレンダリングされます。そのため、事実関係の確認は引き続き人が行う必要があります。
コードから動画を生成する方法:Code2Video でクイックスタート
以下の手順は共有投稿をもとにまとめたもので、すでに GPU 環境を持ち、ワークフローを構築したい方に適しています。デプロイのパラメータはバージョンによって変わる可能性があるため、操作前に公式 README を確認してください。
ステップ 1:コードから動画を生成する環境を準備する
Agent の初回実行時に環境設定で時間を取られないよう、依存関係を事前にインストールしておくことをおすすめします。
| コンポーネント | 要件 | 役割 |
|---|---|---|
| プログラミング Agent | Codex または Claude Code など | コーディング、レンダリング、修正のサイクルを実行 |
| Node.js | 18 以上 | フロントエンドのレンダリングプロジェクトを実行 |
| Python 3 | リポジトリの requirements.txt に記載された依存関係をインストール |
音声と補助スクリプトを処理 |
| FFmpeg / FFprobe | システムから呼び出し可能 | 動画を合成し、メディアストリームを検証 |
| Playwright | Chromium と対象言語のフォントを含む | ヘッドレスブラウザでフレームごとにスクリーンショットを撮影 |
ステップ 2:モデルをデプロイして Skill をインストールする
- 重みをダウンロード:
huggingface-cli download sensenova/SenseNova-6.8-Code2Video --local-dir /path/to/SenseNova-6.8-Code2Video - サービスを起動:投稿では、vLLM コンテナを使って OpenAI 互換インターフェースを提供し、4 枚の GPU によるテンソル並列を例にしています。主なパラメータは
--tensor-parallel-size 4と--max-model-len 524288です。 - リポジトリをクローン:
git clone https://github.com/OpenSenseNova/SenseNova-6.8-Code2Video.git - 隔離用ディレクトリを作成:
mkdir -p ~/video_tasks/methane_explainer/.claude/skills。Agent は Shell コマンドを自動実行するため、重要なプロジェクトのディレクトリ内では実行しないでください。 - Skill をコピー:
cp -r SenseNova-6.8-Code2Video/skills/code-video ~/video_tasks/methane_explainer/.claude/skills/code-video - コンテキストを設定:投稿で指定されている環境変数は、
CODEX_MAX_CONTEXT_TOKENS=524288、CODEX_AUTOCOMPACT_PCT=80、CODEX_MAX_OUTPUT_TOKENS=64000です。
投稿には .claude/skills と .codex/skills の両方のパスが登場します。実際に使用するディレクトリは、利用する Agent と公式ドキュメントを確認してください。
チームがまだ評価段階にある場合は、最初から複数 GPU の環境を用意する必要はありません。まずは APIYI(apiyi.com)を通じて既存のコーディングモデルを利用し、仕様書の作成からシンプルな Canvas アニメーションの生成までを試してから、専用モデルをデプロイするか判断できます。これにより、先に要件とワークフローを検証できますが、完成した動画の品質がそのまま Code2Video の能力を示すわけではありません。
ステップ 3:一文の要件をコードによる動画生成用 Brief に展開する
投稿で紹介されているのは、メタンの燃焼を解説する12秒の科学動画です。一文の要件を構造化された Brief に展開します。リポジトリの prompts/ ディレクトリにある Enhance Prompt テンプレートを使って、dense_prompt.md を生成することもできます。十分な Brief には、少なくとも次の内容を明記しましょう。
- 基本仕様:解像度 1920×1080、フレームレート 30fps、長さ12秒、プログラムで生成する効果音。
- 学習目標:化学反応では原子の並びが変わるだけで、原子が新たに作られたり消滅したりしないことを説明する。
- タイムライン:0〜3秒に反応物を表示し、3〜7秒に結合を切断、7〜10秒に再結合、10〜12秒に係数を合わせた化学反応式を表示する。
- 厳守する制約:右上のカウンターを全編にわたって
C: 1 | H: 4 | O: 4に固定する。
最後の項目は、コードを使う方法の利点をよく表しています。モデルにカウンターの見た目を「覚えて」もらう必要はありません。プログラムでこの値を固定表示するだけで、全編を通して一貫性を保てます。
ステップ 4:自然言語でコード生成した動画をブラッシュアップする
最初の完成動画は、通常はスタート地点にすぎません。投稿では、同じタスクディレクトリで --continue を使って修正を続けることを推奨し、3つのプロンプトのコツを紹介しています。
- 変更しない項目を先に固定する:冒頭に
Keep the molecular coordinates, bond-breaking timing...と書き、スタイルの変更時にタイムラインまで書き換えられるのを防ぎます。 - 正確な時点を指定する:例えば
At 3.5s when bonds break...と書くと、モデルが対象の時間帯を特定しやすくなります。 - 既存ファイルの編集を指示する:末尾に
Edit the existing source in place and overwrite out/final.mp4.と書き、新しいプロジェクトが別途作られるのを防ぎます。
ソースコードがない場合は、参照動画をプロジェクトディレクトリに入れ、モデルにレイアウト、トランジション、動きの軌跡を分析させたうえで、編集可能なプロジェクトとして再構築することもできます。この方法は構成やテンポを学ぶのに役立ちますが、公開に使用する前に、参照素材の著作権と許諾範囲を確認しましょう。
🚀 作業フローのヒント:長時間にわたるタスクを始める前に、APIYI apiyi.com を通じてテキストモデルを呼び出し、スクリプトの数式、用語、ナレーションを確認してから、確定した内容を
SPEC.mdに書き込むとよいでしょう。事実の誤りは、動画の完成後に作り直すより、レンダリング前に修正するほうが一般的に手間を省けます。
コード生成動画とピクセル生成動画に関するよくある質問 FAQ
Q1:コード生成動画とは何ですか?
コード生成動画とは、AI が実行可能なグラフィックスやフロントエンドのコードを書き、そのコードをフレームごとにレンダリングして作る動画です。モデルが直接ピクセルを生成するのではなく、各時点の画面を描くためのルールを定義します。
Q2:コード生成動画とピクセル生成動画の最大の違いは何ですか?
違いは、生成される成果物と修正方法にあります。コード生成では編集可能なプロジェクトが残るため、文字、数式、タイミングの調整に適しています。一方、ピクセル生成では画面が直接出力されます。リアルさの表現や総合的なコストについては、現時点では資料が不足しているため、プロジェクトごとに実際に試して判断する必要があります。
Q3:コード生成動画は Sora や Runway のようなツールを完全に置き換えられますか?
現時点では、そう結論づけることはできません。資料で紹介されているのは主に科学解説、モーショングラフィックス、スタイライズされた映像の事例で、コード生成が実写のような質感を表現できるとは実証されていません。動画で最も重視する要素に応じて方式を選び、必要に応じて両者を組み合わせるのが堅実です。
Q4:コード生成動画は必ずピクセル生成動画より安くなりますか?
必ずしもそうとは限りません。紹介投稿の冒頭で言及されている高額なコストには出典が示されていないため、この記事では根拠として扱いません。コード生成のコストはモデル呼び出し、ハードウェア、反復回数によって変わり、長時間にわたるタスクでは多くのリソースを消費することもあります。まず短いサンプル動画を作ってから見積もることをおすすめします。
Q5:GPU を複数枚使えない場合、コード生成動画のワークフローをどう検証すればよいですか?
まずは 10 秒程度の SVG または Canvas アニメーションを作り、仕様書、レンダリングスクリプト、修正フローを重点的に検証するとよいでしょう。APIYI apiyi.com を通じて互換インターフェースに接続すれば、モデル名を切り替えるだけで、異なるモデルのコード品質を比較できます。インターフェースの設定や利用可能なモデルについては、docs.apiyi.com を参照してください。
Q6:Code2Video について、事前に知っておくべき制限はありますか?
投稿では GPU 4 枚を並列使用する例しか示されておらず、最低ハードウェア構成は明記されていません。INT4 と INT8 の量子化済み重みも、今後の公開を待つ必要があります。また、資料にはレンダリングにかかる時間や客観的に評価できる完成動画のサンプルがなく、写実的な表現も検証が必要です。Agent はコマンドを自動実行するため、必ず隔離されたディレクトリで実行してください。
Q7:2 つの方式を組み合わせて使えますか?
ワークフロー上は試すことができます。例えば、実写映像やピクセル生成モデルで背景素材を作り、コードでタイトル、数式、グラフを重ねる方法があります。ただし、参考資料ではこの方法は検証されていないため、素材の埋め込みとフレームごとのレンダリングが同期するか、事前にテストする必要があります。素材生成用のモデルを比較する際は、APIYI apiyi.com で現在利用可能な選択肢を確認することもできます。
コード生成動画 vs ピクセル生成動画:Key Takeaways
- 主な違い:コード方式はレンダリング可能なプログラムを生成し、ピクセル方式は映像を直接生成します。
- 再現性の仕組み:映像を f(t) の純粋関数として表し、ヘッドレスブラウザでフレームごとにレンダリングします。
- 適した用途:文字、数式、データ、座標、タイミングの正確さが求められる場合は、コード方式を優先して検討します。
- ワークフローの鍵:
SPEC.md、サムネイルによる自己チェック、その場での修正を組み合わせ、複数回の修正を通じた一貫性を保ちます。 - 主な限界:写実的な表現や実写のような質感については裏付けが不足しており、コード方式も同様に得意だとは限りません。
- 始め方のヒント:まずは短い試作動画と APIYI の統一インターフェースで要件を検証し、その後に専用環境へのデプロイを検討しましょう。
まとめ:どんな動画を AI にコードで作らせるべきか
コード生成動画とピクセル生成動画を選ぶ際は、次の3つのポイントを覚えておきましょう。
- 要素を見る:画面内の文字、数式、データ、タイミングに正確さが求められるほど、コード方式に適しています。
- 修正を見る:ほかの内容を変えずに部分的な調整を何度も行う場合は、編集可能なプロジェクトにメリットがあります。
- 質感を見る:実在する人物や実写の雰囲気が重要な場合、コード方式で対応できるとは限りません。
次のステップとして、既存の10〜15秒の動画を1本選び、4つの質問を使って要素を分解したうえで、それぞれの方式で試作品を作ってみましょう。正確さ、修正回数、実際にかかった時間を比較できます。複数のモデルを同時に評価したい場合は、APIYI(apiyi.com)の統一インターフェースを使って脚本の拡張とコード生成をテストし、結果をもとに Code2Video をデプロイするか判断できます。
📚 参考資料
- 紹介記事 – SenseNova 6.8 Code2Video の実践紹介:本記事の仕組み、手順、事例の出典
- リンク:
v2ex.com/t/1254274 -
補足:2026 年 11 月 3 日に公開。比較やコストに関する一部の記述は、独立した検証が行われていません。
-
GitHub – SenseNova 6.8 Code2Video:公式リポジトリと code-video Skill
- リンク:
github.com/OpenSenseNova/SenseNova-6.8-Code2Video -
補足:デプロイ方法、ディレクトリ構造、機能更新についてはこちらを参照してください。
-
Hugging Face – SenseNova 6.8 Code2Video:モデルの重みの公開ページ
- リンク:
huggingface.co/sensenova/SenseNova-6.8-Code2Video - 補足:モデル仕様、重みのバージョン、量子化の進捗を確認できます。
著者:APIYI 技術チーム
技術交流:複数のモデルを統一的に利用する方法については、APIYI の apiyi.com またはドキュメントセンター docs.apiyi.com をご覧ください。