Note de l’auteur : à partir du principe de rendu par la fonction f(t) et du cas de SenseNova 6.8 Code2Video, quatre questions pour déterminer si une vidéo se prête mieux à la génération par code ou par pixels.
Quand on crée une vidéo de vulgarisation, une démonstration mathématique ou une animation de données, on rencontre souvent le même problème : l’image est réussie, mais le texte comporte des erreurs ou les formules sont déformées. Et une nouvelle génération apporte son lot de problèmes. Cet article présente comment choisir entre la génération vidéo par code et la génération vidéo par pixels, pour vous aider à déterminer quand demander à l’IA d’écrire du code et quand privilégier une autre approche.
Cet article ne cherche pas à promouvoir le code comme solution universelle. À partir du cas de SenseNova 6.8 Code2Video, présenté dans une publication du 3 novembre 2026 consacrée à l’utilisation d’un modèle open source, nous examinerons les principes et le processus, ainsi que les points que les sources ne permettent pas encore de confirmer.
À retenir : à la fin de cet article, vous comprendrez comment la génération vidéo par code transforme une fonction temporelle f(t) en fichier MP4, et vous pourrez choisir l’approche adaptée à votre type de vidéo grâce à quatre questions.
Génération vidéo par code ou par pixels : les points essentiels
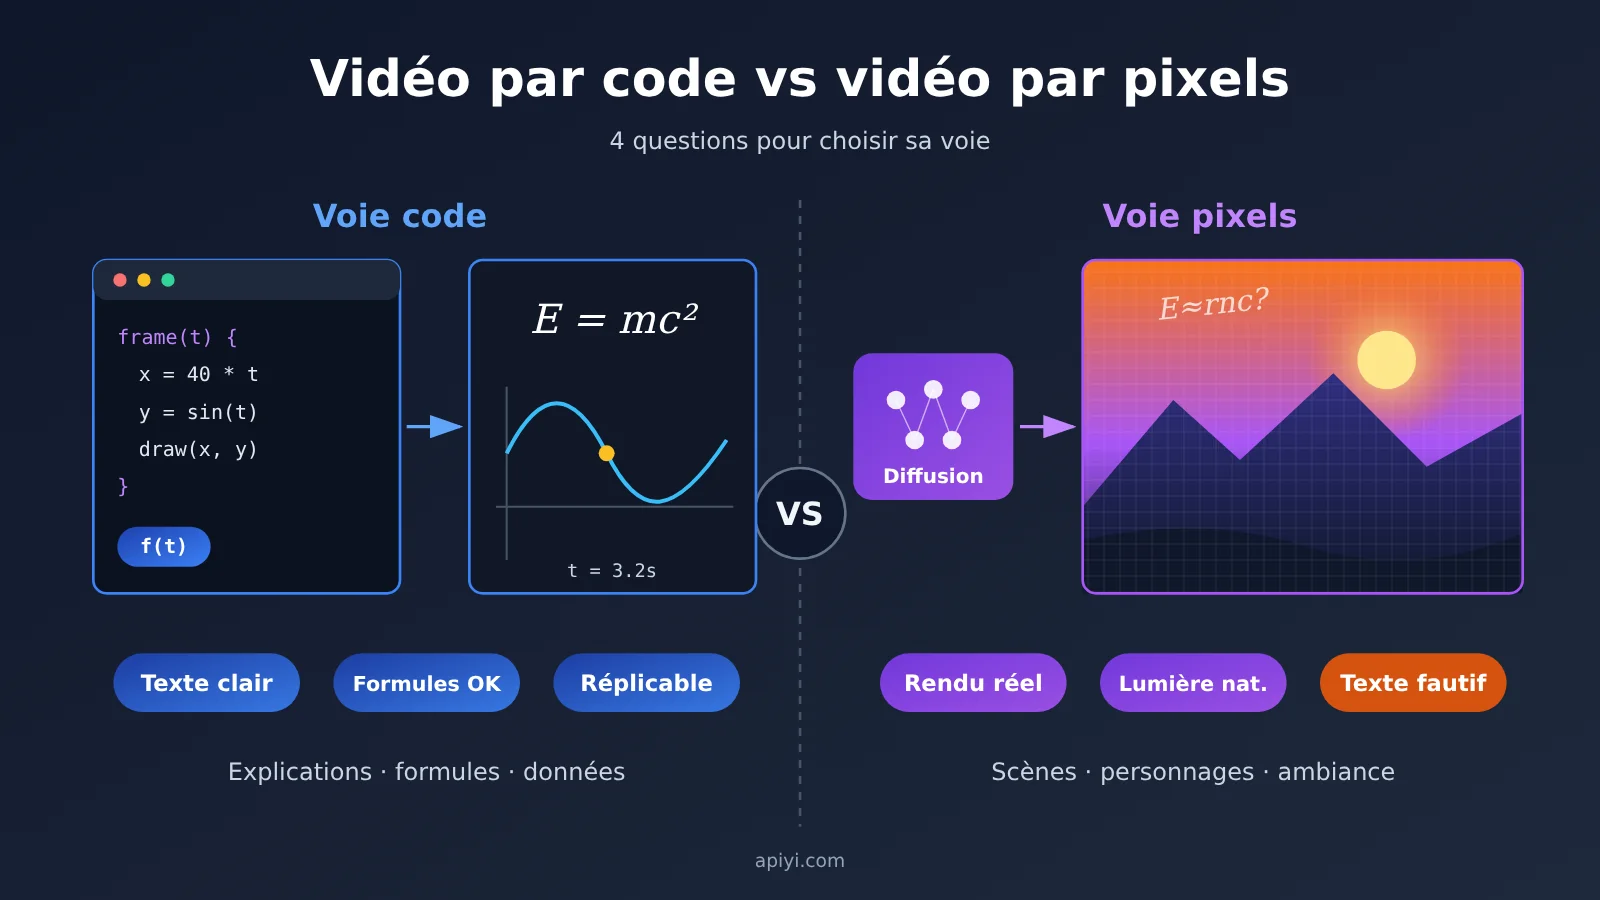
La différence fondamentale entre les deux approches ne tient pas à la taille du modèle, mais à ce qu’il produit. L’approche par pixels génère directement des images ; l’approche par code produit un programme capable de les afficher.
| Critère | Génération vidéo par code | Génération vidéo par pixels |
|---|---|---|
| Production du modèle | Code exécutable en HTML/CSS, Canvas, SVG, Three.js, Manim, p5.js, etc. | Pixels de chaque image générés directement |
| Texte et formules | Affichés à partir de caractères et de données d’entrée | Générés sous forme d’image ; selon l’auteur de la publication, les caractères illisibles et les déformations sont fréquents |
| Modifications | Modification des spécifications ou du code source, puis nouveau rendu | Ajustement de l’invite, puis nouvelle génération dans la plupart des cas |
| Reproductibilité | Un même code fondé sur des fonctions pures peut être rendu plusieurs fois | Dépend du modèle et de l’outil utilisés |
| Principaux risques | Réalisme potentiellement limité et nécessité de mettre en place un environnement de rendu | Précision des informations difficile à garantir et nécessité de sélectionner les résultats à plusieurs reprises |
À noter : l’affirmation selon laquelle « les modèles de diffusion par pixels produisent souvent du texte illisible, des formules déformées et des objets qui se traversent » est une généralisation de l’auteur de la publication, sans test comparatif à l’appui. Il vaut mieux la voir comme un point de vigilance au moment de choisir une approche et tester les deux avec vos propres contenus avant de prendre une décision.
Comment fonctionne la génération de vidéos par code : chaque image est une fonction pure du temps
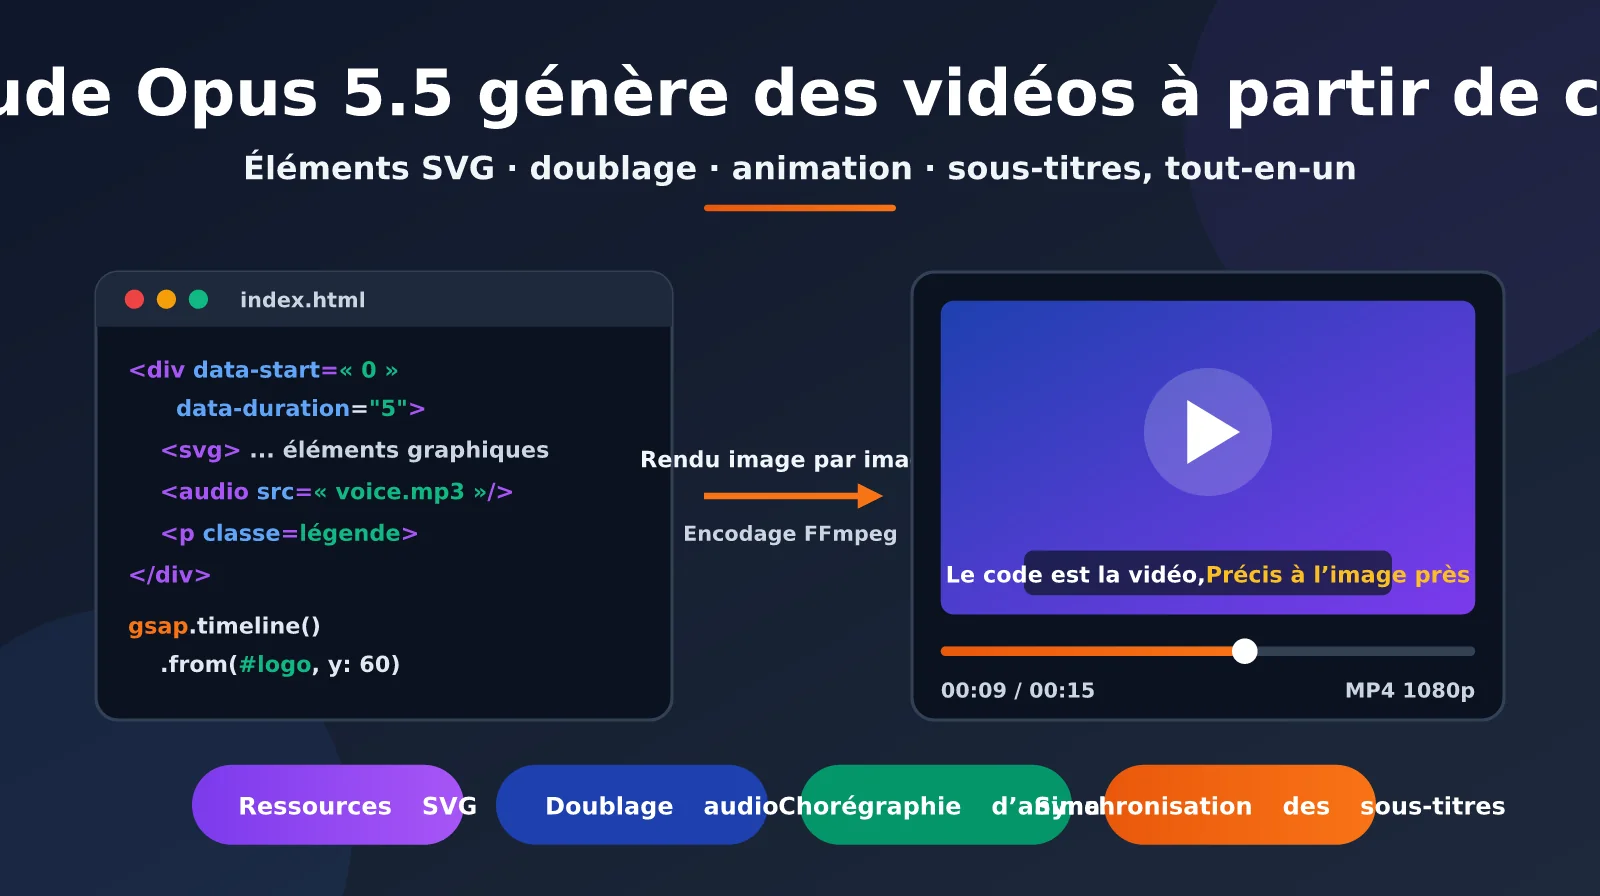
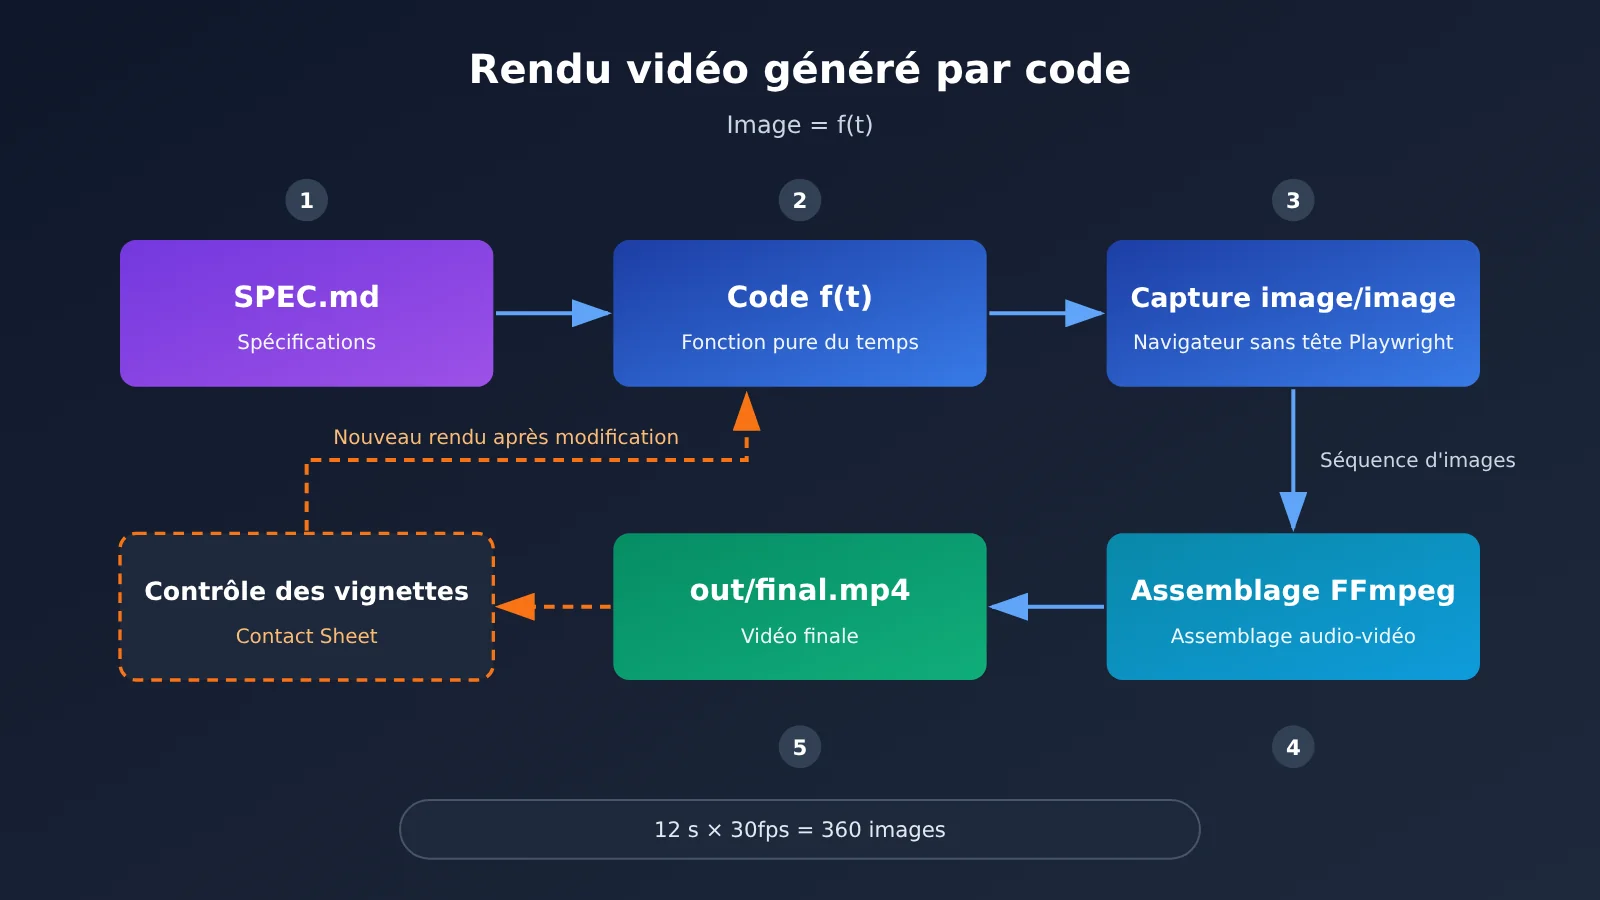
Le principe de Code2Video consiste à écrire chaque image comme une fonction pure du paramètre temporel t. Pour un instant donné, le programme calcule la position, la déformation et la couleur de tous les éléments. Comme l’image ne dépend pas de l’horloge système en temps réel, le rendu d’un même code devrait rester identique d’une exécution à l’autre.
La chaîne de rendu complète se décompose en 4 étapes :
- Écrire la fonction temporelle : le modèle traduit la composition, les mouvements et le rythme en code qui évolue en fonction de t.
- Avancer image par image : Playwright lance Chromium sans interface graphique et définit chaque instant en fonction de la fréquence d’images. Pour une vidéo de 12 secondes à 30 fps, il faut générer 360 images.
- Créer une séquence d’images par capture d’écran : une image haute définition est capturée à chaque instant.
- Assembler avec FFmpeg : la séquence d’images et la piste audio sont assemblées dans le fichier MP4 final.
La différence avec un enregistrement d’écran est fondamentale. Celui-ci dépend des performances de l’appareil en temps réel, tandis que le rendu image par image préserve la position de chaque image sur la timeline, même si son calcul prend plus de temps. En pratique, des nombres aléatoires sans graine fixée ou des différences de polices entre machines peuvent toutefois compromettre ce déterminisme.
La prévisibilité de la vidéo générée par code vient des spécifications, pas seulement du code
Selon la publication, les animations produites par du code généré à partir d’une simple phrase sont souvent peu soignées. La différence se joue surtout dans le flux de travail. Avec le Skill code-video, Code2Video commence par transformer la demande en un fichier SPEC.md vérifiable, qui définit la composition, la palette de couleurs, les courbes d’accélération et de décélération, ainsi que la chronologie du storyboard. Les modifications en langage naturel portent elles aussi principalement sur ces spécifications : le style et la logique restent ainsi plus cohérents au fil des ajustements.
Après un premier rendu, le modèle extrait des images clés pour créer des planches-contact. Il vérifie les chevauchements de texte, les éléments qui sortent du cadre et les problèmes de rythme, puis modifie le code et relance le rendu. Selon la publication, une tâche peut durer plus de 10 heures et mobiliser plus de 2 000 appels d’outils, pour produire finalement VERIFY.md et out/final.mp4. Ces chiffres sont avancés par l’équipe du projet ; pour les paramètres et les capacités du modèle, référez-vous au dépôt officiel et à la fiche du modèle.
💡 Conseil technique : si vous ne souhaitez pas encore déployer un Grand modèle de langage, vous pouvez utiliser l’interface unifiée d’APIYI apiyi.com pour demander à différents modèles textuels de générer un fichier
SPEC.mdà partir des mêmes exigences. Vous pourrez ensuite comparer la clarté des storyboards et des contraintes. Cette étape ne nécessite aucun rendu et permet de vérifier rapidement si les besoins sont suffisamment précis.
Quatre questions pour choisir entre vidéo générée par code et vidéo générée par pixels
Pour faire votre choix, inutile de commencer par débattre du modèle le plus performant. Identifiez d’abord les éléments de la vidéo qui ne tolèrent pas d’erreur. Vous pouvez répondre à ces quatre questions dans l’ordre :
- Certains contenus doivent-ils être reproduits à l’identique ? Par exemple : termes techniques, formules, prix ou valeurs dans un graphique.
- Certaines valeurs doivent-elles être contrôlées avec précision ? Par exemple : coordonnées, durée, trajectoire de caméra ou synchronisation avec la musique.
- Faudra-t-il apporter régulièrement des modifications localisées ? Par exemple : changer uniquement les couleurs ou ajouter une annotation, sans toucher au reste.
- La valeur des images dépend-elle de leur réalisme ? Par exemple : personnes réelles, décors filmés ou lumière et ombres naturelles.
Si vous répondez « oui » à au moins deux des trois premières questions et « non » à la quatrième, privilégiez la génération par code. Si vous répondez « oui » à la quatrième, cette approche ne sera probablement pas votre premier choix. Il s’agit toutefois d’une déduction fondée sur les principes de ces méthodes : les sources ne fournissent pas de comparaison sur le rendu réaliste. Mieux vaut donc faire vos propres tests.
| Élément vidéo | Capacité requise | Approche conseillée | Pourquoi |
|---|---|---|---|
| Sous-titres et mise en page | Exactitude des caractères et stabilité de la mise en page | Code en priorité | Le texte est composé à partir de caractères |
| Formules et graphiques | Exactitude des données et de la structure | Code en priorité | Le contenu peut provenir directement des données d’entrée |
| Caméra et rythme | Précision du timing et des trajectoires | Code en priorité | Durée, rythme et trajectoires sont des valeurs numériques |
| Simulations physiques et de particules | Pilotage par des équations | Code en priorité | Le mouvement peut être calculé à partir de formules mathématiques et physiques |
| Personnes réelles et rendu de prise de vue réelle | Réalisme et détails | Pixels ou prise de vue réelle en priorité | L’efficacité de l’approche par code manque encore de preuves et doit être testée |
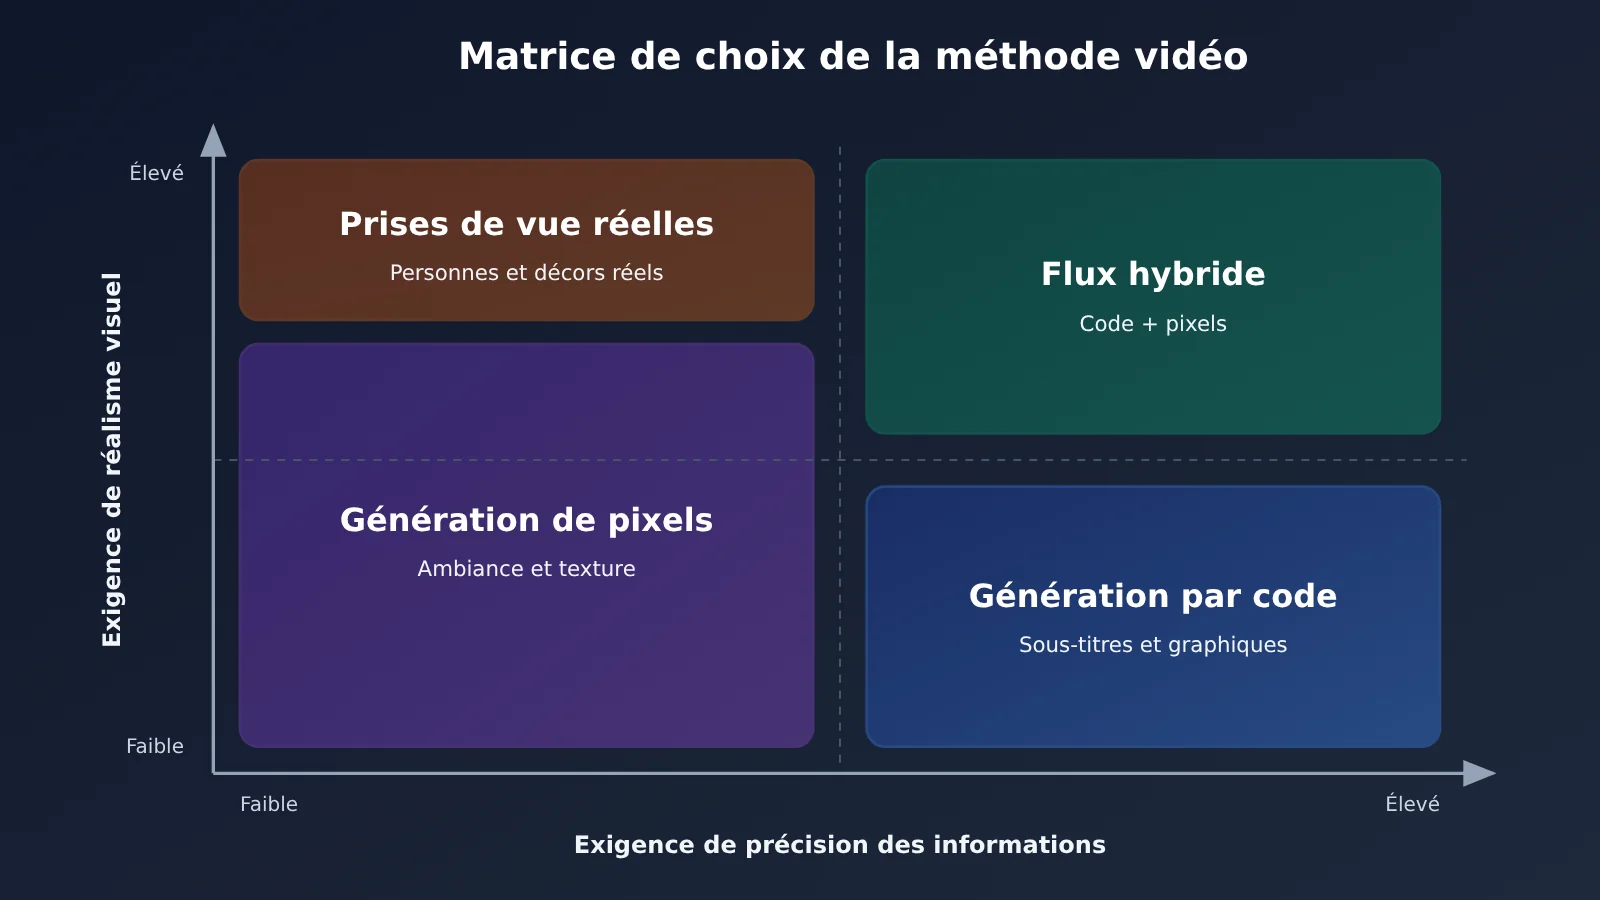
Pour compléter cette matrice avec vos propres critères, vous pouvez utiliser un même script et comparer de courts essais réalisés avec les modèles de texte et de vidéo accessibles via APIYI, sur apiyi.com. Vérifiez la disponibilité des modèles dans la liste actuelle de la plateforme.
6 types de vidéos adaptés à la génération par code
Le skill code-video propose des guides pratiques pour 8 domaines. Parmi eux, voici les types de vidéos qui se prêtent particulièrement bien à un premier essai. Le « niveau d’adéquation » indiqué dans le tableau est une appréciation fondée sur les principes décrits dans cet article, et non une évaluation officielle.
| Type de vidéo | Guide correspondant | Niveau d’adéquation | Points d’attention |
|---|---|---|---|
| Vulgarisation scientifique et visualisation de données | explainer-diagrams.md |
Élevé | Vérifier les données en entrée au préalable |
| Typographie animée et animations d’interface | motion-graphics-and-promos.md |
Élevé | Préparer les polices nécessaires à l’avance |
| Clips courts synchronisés sur la musique | music-and-beat-sync.md |
Élevé | Définir clairement le rythme et les moments de coupe |
| Simulations de particules et de phénomènes physiques | simulations-and-generative.md |
Élevé | Encadrer les paramètres et les graines aléatoires |
| Présentation de produits en 3D | threejs-scenes-and-cameras.md |
Moyen | Juger le rendu des matières sur un aperçu |
| Animation de personnages stylisés | character-and-creature-motion.md |
Moyen | Ne remplace pas une interprétation humaine réaliste |
Attention : l’approche par code garantit une « représentation fidèle aux données fournies », pas l’exactitude du contenu. Si le script contient une formule erronée, il affichera clairement cette formule erronée. La vérification des faits reste donc une responsabilité humaine.
Générer une vidéo avec du code : démarrage rapide avec Code2Video
La procédure suivante, tirée d’une publication de partage, s’adresse aux personnes qui disposent déjà d’un environnement GPU et souhaitent mettre en place un workflow. Les paramètres de déploiement peuvent varier selon la version : consultez le README officiel avant de commencer.
Étape 1 : préparer l’environnement de génération vidéo par code
Installez les dépendances à l’avance pour éviter que l’agent passe trop de temps à configurer l’environnement lors de sa première exécution.
| Composant | Prérequis | Rôle |
|---|---|---|
| Agent de programmation | Codex, Claude Code ou équivalent | Exécuter la boucle d’écriture du code, de rendu et de correction |
| Node.js | Version 18 ou ultérieure | Exécuter le projet de rendu frontend |
| Python 3 | Installer les dépendances du fichier requirements.txt du dépôt |
Traiter l’audio et exécuter les scripts auxiliaires |
| FFmpeg / FFprobe | Accessibles depuis le système | Assembler la vidéo et vérifier les flux multimédias |
| Playwright | Avec Chromium et les polices adaptées à la langue | Capturer les images une par une dans un navigateur sans interface |
Étape 2 : déployer le modèle et installer le Skill
- Télécharger les poids :
huggingface-cli download sensenova/SenseNova-6.8-Code2Video --local-dir /path/to/SenseNova-6.8-Code2Video - Démarrer le service : la publication utilise un conteneur vLLM pour fournir une interface compatible avec OpenAI, avec un exemple de parallélisme tensoriel sur 4 cartes. Les paramètres clés sont
--tensor-parallel-size 4et--max-model-len 524288. - Cloner le dépôt :
git clone https://github.com/OpenSenseNova/SenseNova-6.8-Code2Video.git - Créer un répertoire isolé :
mkdir -p ~/video_tasks/methane_explainer/.claude/skills. L’agent exécutera automatiquement des commandes Shell : ne le lancez pas dans un répertoire de projet important. - Copier le Skill :
cp -r SenseNova-6.8-Code2Video/skills/code-video ~/video_tasks/methane_explainer/.claude/skills/code-video - Définir le contexte : les variables d’environnement indiquées dans la publication sont
CODEX_MAX_CONTEXT_TOKENS=524288,CODEX_AUTOCOMPACT_PCT=80etCODEX_MAX_OUTPUT_TOKENS=64000.
La publication mentionne à la fois les chemins .claude/skills et .codex/skills. Vérifiez le répertoire à utiliser selon l’agent choisi et la documentation officielle.
Si votre équipe en est encore au stade de l’évaluation, inutile d’investir tout de suite dans un environnement à plusieurs cartes. Vous pouvez commencer par accéder à un modèle de programmation existant via APIYI apiyi.com, puis tester le processus avec un cahier des charges et une animation Canvas simple avant de décider si vous souhaitez déployer un modèle spécialisé. Cela permet de valider les besoins et le flux de travail, mais le résultat ne reflétera pas directement les capacités de Code2Video.
Étape 3 : transformer une phrase en Brief pour générer une vidéo avec du code
L’exemple du post est une courte vidéo pédagogique de 12 secondes sur la combustion du méthane. Une demande formulée en une phrase est développée en Brief structuré. Vous pouvez aussi utiliser le modèle Enhance Prompt du répertoire prompts/ du dépôt pour générer dense_prompt.md. Un Brief complet doit préciser au minimum les éléments suivants :
- Spécifications de base : résolution de 1920×1080, fréquence de 30fps, durée de 12 secondes, effets sonores programmatiques.
- Objectif pédagogique : expliquer qu’une réaction chimique réorganise les atomes sans les créer ni les détruire.
- Chronologie : présentation des réactifs de 0 à 3 secondes, rupture des liaisons de 3 à 7 secondes, recomposition de 7 à 10 secondes, affichage de l’équation équilibrée de 10 à 12 secondes.
- Contrainte impérative : le compteur en haut à droite reste fixé à
C: 1 | H: 4 | O: 4pendant toute la vidéo.
Ce dernier point illustre particulièrement bien l’avantage de l’approche par code. Le modèle n’a pas besoin de « mémoriser » l’apparence du compteur : il suffit de programmer l’affichage fixe de ces valeurs pour qu’elles restent cohérentes du début à la fin.
Étape 4 : affiner la vidéo générée par code en langage naturel
La première version de la vidéo n’est généralement qu’un point de départ. Le post conseille de poursuivre les modifications dans le même répertoire de travail avec --continue et de suivre trois conseils pour rédiger vos invites :
- Fixez d’abord ce qui ne doit pas changer : commencez par
Keep the molecular coordinates, bond-breaking timing...pour éviter que la chronologie soit réécrite lors d’une modification du style. - Indiquez des repères temporels précis : par exemple,
At 3.5s when bonds break...aide le modèle à repérer la séquence concernée. - Demandez une modification sur place : terminez par
Edit the existing source in place and overwrite out/final.mp4.pour éviter de créer un nouveau projet.
Si vous ne disposez pas du code source, vous pouvez aussi placer une vidéo de référence dans le répertoire du projet, puis demander au modèle d’analyser sa composition, ses transitions et ses trajectoires de mouvement avant de la reconstruire sous forme de projet modifiable. C’est utile pour étudier la structure et le rythme d’une vidéo. Avant toute publication, vérifiez toutefois les droits d’auteur et les autorisations applicables aux contenus de référence.
🚀 Conseil pratique : avant de lancer une tâche de longue durée, vous pouvez appeler un modèle textuel via APIYI apiyi.com pour vérifier les formules, la terminologie et la narration du script, puis intégrer la version finale dans
SPEC.md. Corriger les erreurs factuelles avant le rendu est généralement plus simple que de retravailler la vidéo une fois terminée.
FAQ : vidéo générée par code ou par pixels
Q1 : Qu’est-ce qu’une vidéo générée par code ?
Une vidéo générée par code est produite par une IA qui écrit du code graphique ou front-end exécutable, puis par un rendu de ce code image par image. Le modèle ne génère pas directement les pixels : il définit les règles qui composent l’image à chaque instant.
Q2 : Quelle est la principale différence entre la génération vidéo par code et par pixels ?
La différence tient au résultat produit et à la façon de le modifier. L’approche par code laisse un projet modifiable, pratique pour contrôler le texte, les formules et le rythme ; l’approche par pixels produit directement les images. Pour le réalisme et le coût global, les informations disponibles ne suffisent pas : il faut les mesurer pour chaque projet.
Q3 : La génération vidéo par code peut-elle remplacer complètement des outils comme Sora ou Runway ?
Il est trop tôt pour l’affirmer. Les ressources présentent surtout des exemples de vulgarisation scientifique, d’animation graphique et de vidéos stylisées. Elles ne démontrent pas que l’approche par code peut reproduire le rendu de prises de vue réelles. Le plus sûr est de choisir une approche selon les éléments essentiels de la vidéo, puis d’essayer une production hybride si nécessaire.
Q4 : La génération vidéo par code est-elle toujours moins chère que la génération par pixels ?
Pas forcément. Le coût élevé mentionné au début de la publication partagée n’est accompagné d’aucune source ; cet article ne le prend donc pas comme référence. Le coût de l’approche par code dépend des invocations du modèle, du matériel et du nombre d’itérations. Les tâches longues peuvent aussi consommer beaucoup de ressources : mieux vaut réaliser un court prototype avant de faire une estimation.
Q5 : Comment tester un workflow de génération vidéo par code sans plusieurs GPU ?
Vous pouvez commencer par une animation SVG ou Canvas d’une dizaine de secondes, pour vérifier avant tout le cahier des charges, le script de rendu et le processus de modification. Après avoir configuré un accès à une interface compatible via APIYI apiyi.com, il suffit de changer le nom du modèle pour comparer la qualité du code produit par différents modèles. Pour la configuration de l’interface et les modèles disponibles, consultez docs.apiyi.com.
Q6 : Quelles sont les limites de Code2Video à connaître avant de se lancer ?
La publication donne seulement un exemple d’exécution parallèle sur 4 cartes, sans préciser la configuration matérielle minimale. Les poids quantifiés en INT4 et INT8 doivent également être publiés ultérieurement. Par ailleurs, les informations disponibles ne précisent pas la durée du rendu et ne fournissent pas d’exemples de vidéos finales permettant une évaluation objective. Le rendu réaliste reste lui aussi à vérifier. L’agent exécute automatiquement des commandes : veillez à le lancer dans un répertoire isolé.
Q7 : Peut-on combiner les deux approches ?
C’est une piste à essayer dans le workflow : par exemple, utiliser des prises de vue réelles ou un modèle à pixels pour créer les arrière-plans, puis superposer des titres, des formules et des graphiques à l’aide de code. Les sources n’ont pas validé cette méthode : il faut d’abord vérifier que l’intégration des éléments et le rendu image par image restent synchronisés. Pour comparer les modèles capables de créer ces éléments, vous pouvez aussi consulter les options actuellement accessibles via APIYI apiyi.com.
Génération vidéo par code vs génération vidéo par pixels : points clés
- Différence centrale : l’approche par code produit un programme capable de générer le rendu, tandis que l’approche par pixels génère directement les images.
- Origine du déterminisme : chaque image est une fonction pure f(t), rendue image par image par un navigateur sans interface graphique.
- Cas à privilégier : pensez au code lorsque le texte, les formules, les données, les coordonnées et le rythme doivent être précis.
- Clés du workflow :
SPEC.md, l’autocontrôle par vignettes et les modifications sur place garantissent ensemble la cohérence au fil des itérations. - Principale limite : les preuves manquent concernant le réalisme et le rendu d’une prise de vue réelle. On ne peut pas supposer que l’approche par code excelle aussi dans ces domaines.
- Pour commencer : validez d’abord vos besoins avec un court prototype et l’interface unifiée d’APIYI, avant d’investir dans un déploiement dédié.
En résumé : pour quels types de vidéos laisser l’IA écrire du code ?
Pour choisir entre la génération vidéo par code et la génération vidéo par pixels, retenez 3 points :
- Examinez les éléments : moins les textes, formules, données et repères temporels tolèrent d’erreurs, plus l’approche par code est adaptée.
- Anticipez les modifications : si vous devez effectuer plusieurs ajustements locaux sans toucher au reste, un projet modifiable offre un avantage.
- Évaluez le rendu : si les personnes réalistes et l’ambiance d’une prise de vue réelle sont essentielles, ne partez pas du principe que l’approche par code fera l’affaire.
Pour passer à l’étape suivante, choisissez une vidéo existante de 10–15 secondes, analysez-la à l’aide des 4 questions, puis créez des prototypes pour comparer leur précision, le nombre de modifications et le temps réellement nécessaire. Si vous devez évaluer plusieurs modèles, l’interface unifiée d’APIYI sur apiyi.com permet de tester l’enrichissement du script et la génération de code, avant de décider si vous souhaitez déployer Code2Video.
📚 Ressources
- Publication – Présentation pratique de SenseNova 6.8 Code2Video : source des principes, du processus et des exemples présentés dans cet article
- Lien :
v2ex.com/t/1254274 -
Remarque : publié le 3 novembre 2026. Certaines comparaisons et affirmations sur les coûts n’ont pas été vérifiées de manière indépendante.
-
GitHub – SenseNova 6.8 Code2Video : dépôt officiel et Skill code-video
- Lien :
github.com/OpenSenseNova/SenseNova-6.8-Code2Video -
Remarque : consultez ce dépôt pour les méthodes de déploiement, la structure des dossiers et les mises à jour des fonctionnalités.
-
Hugging Face – SenseNova 6.8 Code2Video : page de publication des poids du modèle
- Lien :
huggingface.co/sensenova/SenseNova-6.8-Code2Video - Remarque : permet de vérifier les caractéristiques du modèle, les versions des poids et l’avancement de la quantification.
Auteur : équipe technique d’APIYI
Échanges techniques : pour découvrir comment accéder à plusieurs modèles via une interface unifiée, consultez APIYI sur apiyi.com ou le centre de documentation docs.apiyi.com.