Anmerkung des Autors: Anhand des Rendering-Prinzips von f(t) und des Beispiels SenseNova 6.8 Code2Video zeigen vier Fragen, ob sich für ein Video eher die Code- oder die Pixelgenerierung eignet.
Wer Erklärvideos, mathematische Herleitungen oder Datenanimationen erstellt, kennt das Problem: Das Bild sieht gut aus, aber der Text ist falsch oder die Formel verzerrt. Ein neuer Generierungsversuch bringt dann womöglich andere Fehler mit sich. Dieser Artikel zeigt, wie Sie zwischen Codegenerierung und Pixelgenerierung für Videos wählen – und wann Sie KI besser keinen Code schreiben lassen sollten.
Das ist kein Plädoyer dafür, alles durch Codegenerierung zu ersetzen. Als Beispiel dient SenseNova 6.8 Code2Video, vorgestellt in einem Erfahrungsbericht zu einem Open-Source-Modell vom 3. November 2026. Wir erklären das Prinzip und den Ablauf und zeigen, welche Aspekte durch die verfügbaren Informationen noch nicht belegt sind.
Das nehmen Sie mit: Sie verstehen, wie aus der Zeitfunktion f(t) per Code ein MP4-Video wird, und können anhand von vier Fragen entscheiden, welcher Ansatz zu Ihrem Video passt.
Videoerzeugung per Code vs. per Pixel: die wichtigsten Unterschiede
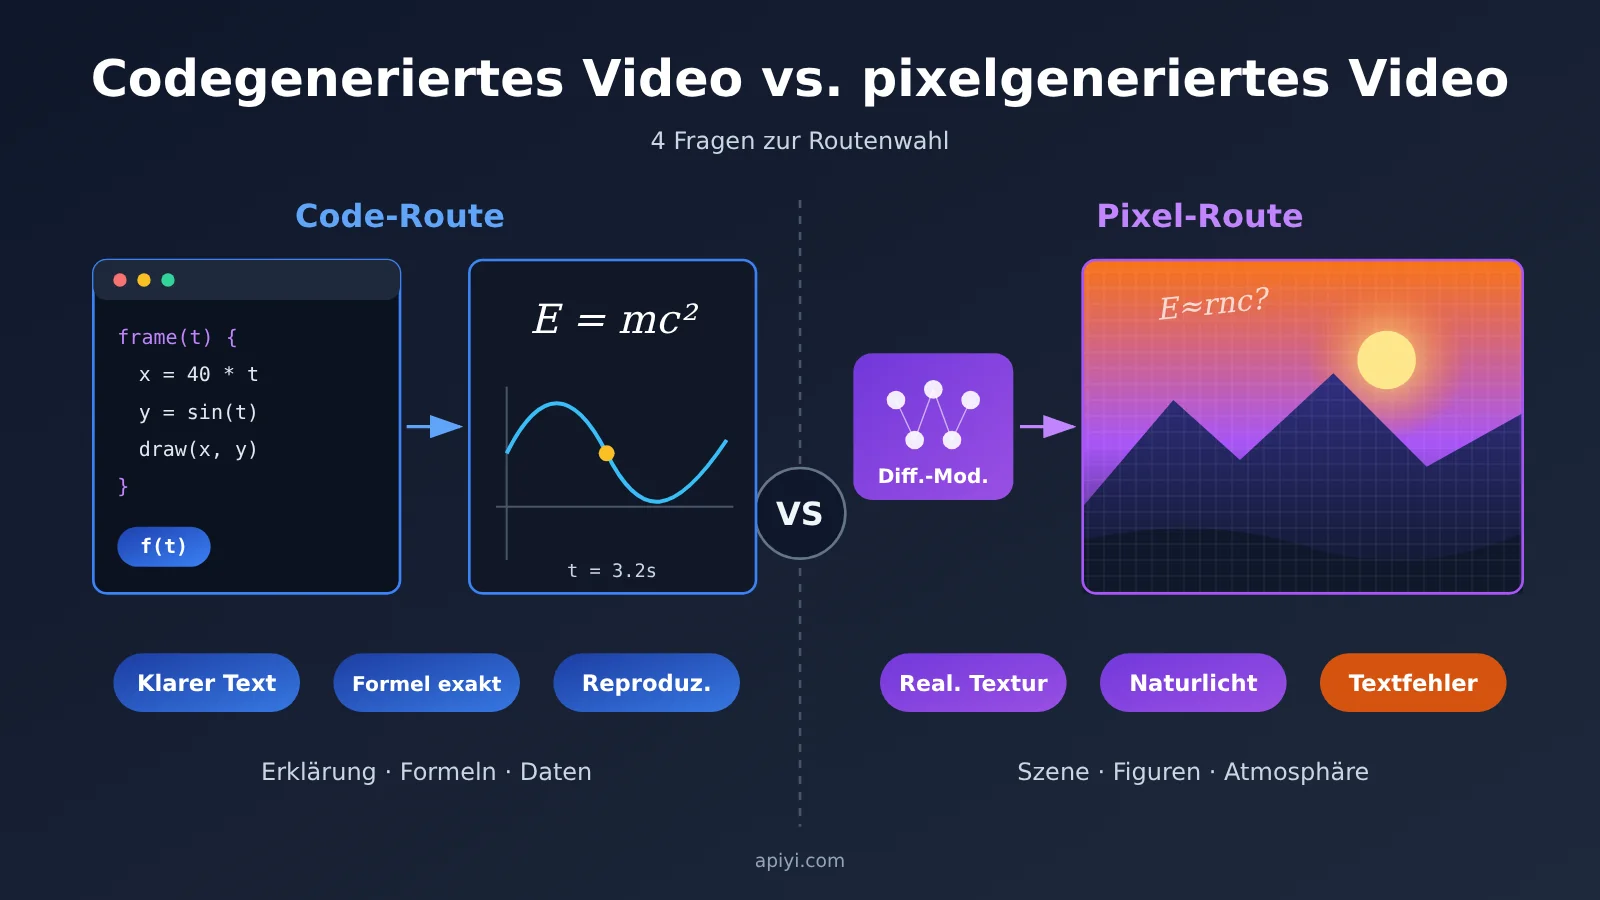
Der grundlegende Unterschied liegt nicht in der Modellgröße, sondern darin, was das Modell ausgibt. Der Pixelansatz erzeugt direkt die Bilder, der Codeansatz dagegen ein Programm, das diese Bilder rendern kann.
| Vergleichsdimension | Videoerzeugung per Code | Videoerzeugung per Pixel |
|---|---|---|
| Modellausgabe | Ausführbarer Code wie HTML/CSS, Canvas, SVG, Three.js, Manim oder p5.js | Die Pixel jedes einzelnen Frames |
| Text und Formeln | Werden aus Zeichen und Eingabedaten gerendert | Werden als Bild generiert; laut dem Autor des Beitrags treten dabei häufig Zeichenfehler und Verformungen auf |
| Änderungen | Spezifikation oder Quellcode ändern und erneut rendern | Meist die Eingabeaufforderung anpassen und neu generieren |
| Reproduzierbarkeit | Derselbe Code aus reinen Funktionen lässt sich wiederholt rendern | Hängt vom jeweiligen Modell und Tool ab |
| Hauptrisiko | Die realistische Anmutung kann fehlen; eine Rendering-Umgebung muss eingerichtet werden | Exakte Informationen sind schwer zu gewährleisten; Ergebnisse müssen wiederholt aussortiert werden |
Wichtig: Die Aussage, dass bei Pixel-Diffusionsmodellen häufig Zeichenfehler, verformte Formeln und physikalisch unmögliche Objektüberschneidungen auftreten, ist eine Einschätzung des Beitragsautors. Vergleichstests wurden dazu nicht vorgelegt. Sie kann als Risikohinweis für die Auswahl dienen. Vor einer endgültigen Entscheidung sollten Sie beide Ansätze am besten mit eigenem Material testen.
So funktioniert die codebasierte Videoerzeugung: Das Bild ist eine reine Funktion der Zeit
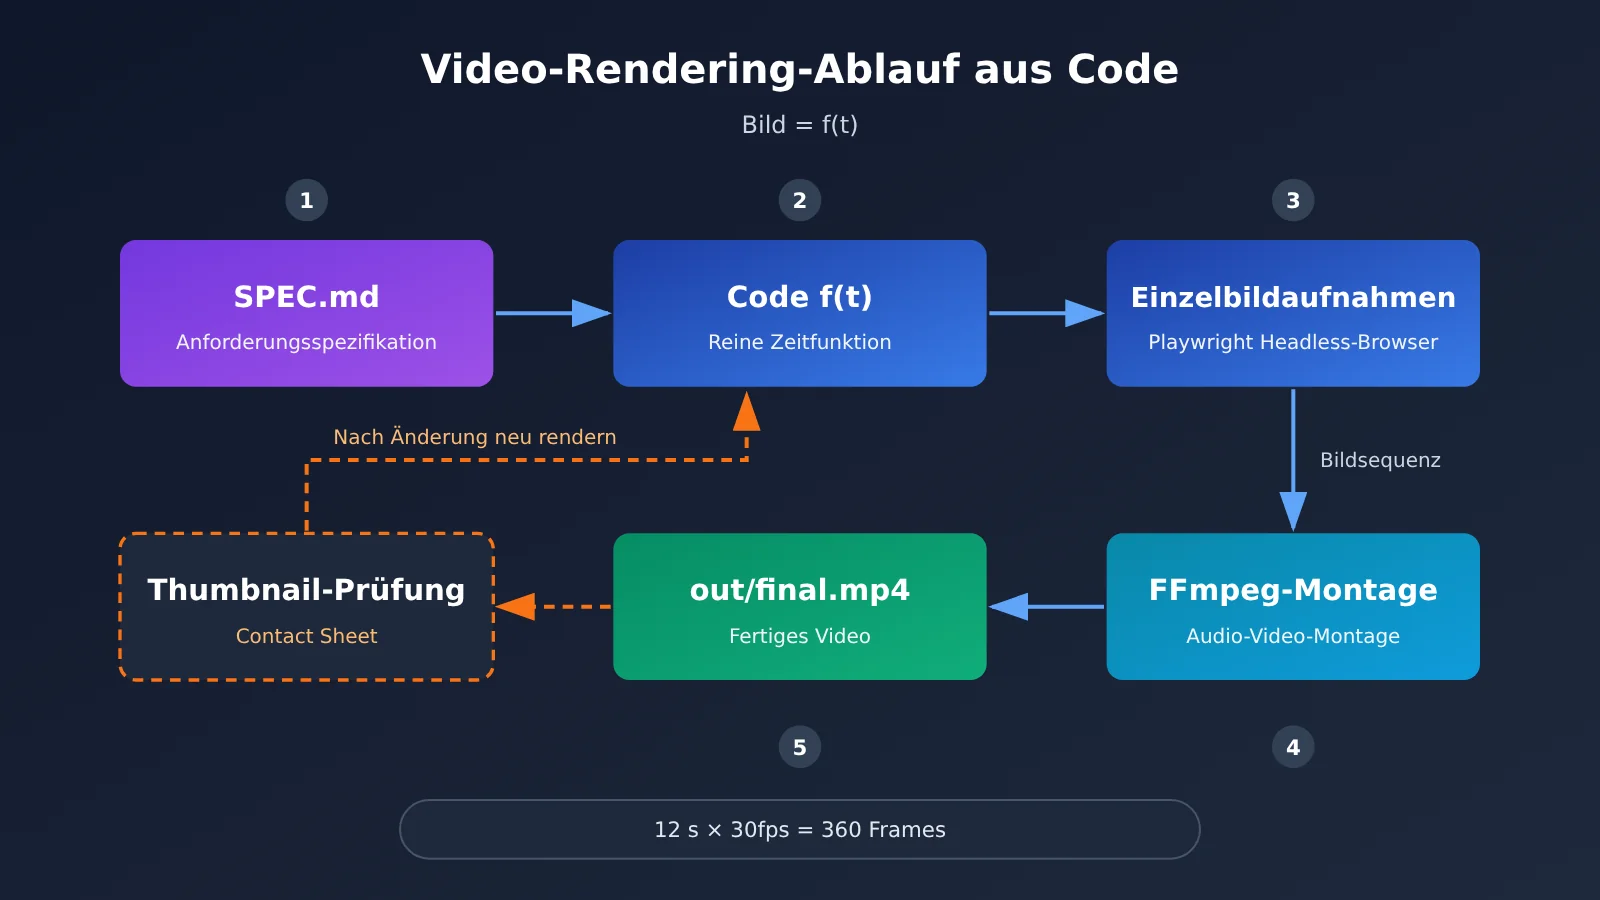
Das Grundprinzip von Code2Video ist, jedes Einzelbild als reine Funktion des Zeitparameters t zu beschreiben. Für jeden beliebigen Zeitpunkt kann das Programm Position, Verformung und Farbe aller Elemente berechnen. Da das Bild nicht von der Echtzeituhr des Systems abhängt, sollte derselbe Code bei wiederholtem Rendern dasselbe Ergebnis liefern.
Der gesamte Renderprozess lässt sich in 4 Schritte aufteilen:
- Zeitfunktion schreiben: Das Modell setzt Bildaufbau, Bewegung und Rhythmus in Code um, der sich mit t verändert.
- Bild für Bild vorgehen: Playwright startet Chromium im Headless-Modus und legt die Zeitpunkte entsprechend der Bildrate fest. Bei 12 Sekunden und 30 fps sind insgesamt 360 Einzelbilder zu rendern.
- Einzelbilder per Screenshot erzeugen: Zu jedem Zeitpunkt wird ein hochauflösender Screenshot aufgenommen.
- Mit FFmpeg zusammensetzen: Die Einzelbilder und die Tonspur werden zur fertigen MP4-Datei zusammengefügt.
Das unterscheidet sich grundlegend von einer Bildschirmaufnahme. Diese hängt von der Echtzeitleistung des Geräts ab. Beim Rendern einzelner Bilder ändert dagegen selbst eine langsame Berechnung nichts an der Position des Bildes auf der Zeitachse. In der Praxis können allerdings Zufallszahlen ohne festgelegten Seed oder unterschiedliche Schriftarten auf verschiedenen Rechnern die Deterministik beeinträchtigen.
Planbare Videos aus Code entstehen durch Spezifikationen, nicht nur durch Code
Laut dem Beitrag wirken Code-Animationen, die ein gewöhnliches Modell aus einem einzigen Satz erstellt, oft unausgereift. Der entscheidende Unterschied liegt im Workflow: Code2Video wandelt die Anforderungen mit dem code-video Skill zunächst in eine überprüfbare SPEC.md um. Darin werden Bildaufbau, Farbpalette, Easing-Kurven und der zeitliche Ablauf der Szenen festgelegt. Auch natürlichsprachliche Änderungswünsche beziehen sich vor allem auf diese Spezifikation. So lassen sich Stil und Logik über mehrere Überarbeitungsrunden hinweg leichter konsistent halten.
Nach dem ersten Rendering extrahiert das Modell Schlüsselframes und erstellt daraus Contact Sheets. Anhand dieser Übersichten prüft es, ob sich Texte überlappen, Elemente aus dem Bild ragen oder der Rhythmus nicht stimmt. Anschließend passt es den Code an und rendert das Video erneut. Dem Beitrag zufolge kann eine einzelne Aufgabe über 10 Stunden dauern und mehr als 2.000 Werkzeugaufrufe umfassen. Am Ende entstehen VERIFY.md und out/final.mp4. Diese Zahlen stammen aus dem Projektumfeld; maßgeblich für Modellparameter und Fähigkeiten sind das offizielle Repository und die Modellkarte.
💡 Technischer Tipp: Wer vorerst kein Großes Sprachmodell selbst bereitstellen möchte, kann über die einheitliche Schnittstelle von APIYI auf apiyi.com verschiedene Textmodelle aus denselben Anforderungen jeweils eine
SPEC.mderstellen lassen. So lässt sich vergleichen, wie klar sie die Szenen und Vorgaben beschreiben. Rendering ist dafür nicht nötig, und es zeigt sich schnell, ob die Anforderungen ausreichend präzise sind.
Vier Fragen zur Wahl zwischen codebasierter und pixelbasierter Videogenerierung
Bei der Auswahl muss man nicht zuerst darüber diskutieren, welches Modell leistungsfähiger ist. Entscheidend ist, welche Elemente im Video auf keinen Fall fehlerhaft sein dürfen. Die folgenden vier Fragen helfen dabei:
- Gibt es Inhalte, die bis auf das letzte Zeichen stimmen müssen? Zum Beispiel Fachbegriffe, Formeln, Preise oder Diagrammwerte.
- Müssen Zahlenwerte exakt gesteuert werden? Zum Beispiel Koordinaten, Dauer, Kamerapfade oder die Synchronisierung mit dem Musikrhythmus.
- Sind wiederholt lokale Änderungen nötig? Zum Beispiel nur die Farben ändern oder eine Beschriftung hinzufügen, während alles andere unverändert bleibt.
- Hängt die Wirkung des Bildes von einer realistischen Anmutung ab? Zum Beispiel bei echten Menschen, realen Umgebungen oder natürlichem Licht und Schatten.
Werden mindestens zwei der ersten drei Fragen mit „Ja“ und die vierte mit „Nein“ beantwortet, ist der codebasierte Ansatz meist die bessere Wahl. Lautet die Antwort auf die vierte Frage „Ja“, ist er wahrscheinlich nicht die erste Wahl. Das ist allerdings nur eine Schlussfolgerung aus den zugrunde liegenden Prinzipien. Die Referenzquellen liefern keine Vergleichsbelege für realistische Stile – eigene Tests sind daher empfehlenswert.
| Videoelement | Erforderliche Fähigkeit | Empfohlener Ansatz | Begründung |
|---|---|---|---|
| Untertitel und Typografie | Zeichengenauigkeit, stabiles Layout | Codebasiert bevorzugen | Text wird zeichenbasiert gesetzt |
| Formeln und Diagramme | Korrekte Daten und Strukturen | Codebasiert bevorzugen | Inhalte können direkt aus der Eingabe stammen |
| Kamera und Rhythmus | Exakte Zeitpunkte und Pfade | Codebasiert bevorzugen | Dauer, Rhythmus und Pfade sind Zahlenwerte |
| Physik- und Partikelsimulation | Steuerung durch Gleichungen | Codebasiert bevorzugen | Bewegung lässt sich anhand mathematischer und physikalischer Formeln berechnen |
| Echte Menschen und Realfilm-Ästhetik | Realismus und Details | Pixelbasiert oder Realfilm bevorzugen | Für die Ergebnisse des codebasierten Ansatzes fehlen noch Belege; praktische Tests sind nötig |
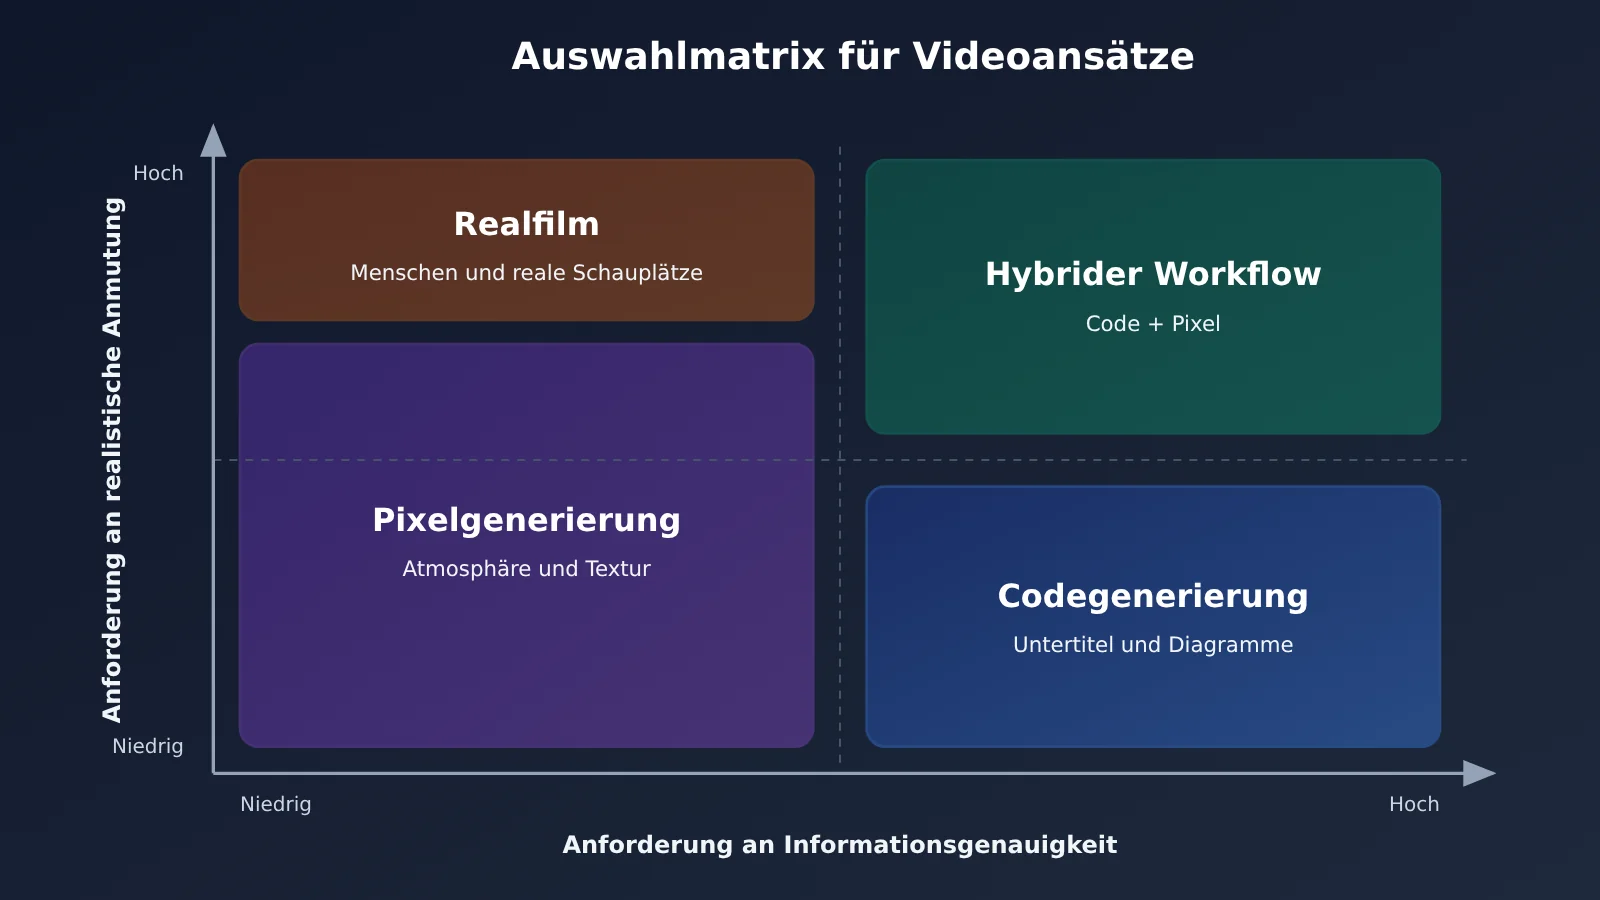
Wer die Grafik um eigene Entscheidungskriterien ergänzen möchte, kann dasselbe Skript verwenden und über APIYI apiyi.com auf verfügbare Text- und Videomodelle zugreifen, um kurze Testversionen zu vergleichen. Ob ein bestimmtes Modell verfügbar ist, zeigt die aktuelle Modellliste der Plattform.
6 geeignete Einsatzbereiche für codegenerierte Videos
Der Skill code-video bietet Anleitungen für acht Bereiche. Daraus lassen sich einige Szenarien ableiten, die sich besonders gut für erste Versuche eignen. Die Eignung in der Tabelle ist eine Einschätzung dieses Artikels auf Basis der Funktionsweise und keine offizielle Bewertung.
| Videotyp | Zugehörige Anleitung | Eignung | Hinweise |
|---|---|---|---|
| Wissensvermittlung und Datenvisualisierung | explainer-diagrams.md |
Hoch | Eingabedaten vorher prüfen |
| Dynamische Typografie und UI-Animationen | motion-graphics-and-promos.md |
Hoch | Benötigte Schriftarten vorher bereitstellen |
| Auf den Musikrhythmus abgestimmte Kurzclips | music-and-beat-sync.md |
Hoch | Beats und Schnittzeitpunkte festlegen |
| Partikel- und Physiksimulationen | simulations-and-generative.md |
Hoch | Parameter und Seeds eingrenzen |
| 3D-Produktpräsentationen | threejs-scenes-and-cameras.md |
Mittel | Die Materialwirkung anhand eines Beispielvideos beurteilen |
| Stilisierte Charakteranimationen | character-and-creature-motion.md |
Mittel | Nicht mit realistischem menschlichem Schauspiel gleichzusetzen |
Wichtig ist: Der Codeansatz gewährleistet eine präzise Darstellung der Eingaben, aber nicht deren inhaltliche Richtigkeit. Steht im Skript eine falsche Formel, wird auch diese klar dargestellt. Die Faktenprüfung bleibt daher Aufgabe des Menschen.
Schnellstart: Videos per Code erzeugen mit Code2Video
Die folgenden Schritte basieren auf einem Erfahrungsbericht und richten sich an alle, die bereits über eine GPU-Umgebung verfügen und einen Workflow einrichten möchten. Die Deployment-Parameter können sich je nach Version ändern. Prüfen Sie deshalb vorab die offizielle README.
Schritt 1: Umgebung für die Videoerzeugung vorbereiten
Installieren Sie die Abhängigkeiten am besten vorab, damit der Agent beim ersten Start nicht viel Zeit mit der Einrichtung verbringt.
| Komponente | Anforderung | Zweck |
|---|---|---|
| Programmier-Agent | Codex, Claude Code oder vergleichbar | Führt den Zyklus aus Programmieren, Rendern und Fehlerbehebung aus |
| Node.js | Version 18 oder höher | Führt das Frontend-Rendering-Projekt aus |
| Python 3 | Abhängigkeiten aus der requirements.txt des Repositorys installieren |
Verarbeitet Audio und Hilfsskripte |
| FFmpeg / FFprobe | Im System aufrufbar | Setzt das Video zusammen und prüft die Medienstreams |
| Playwright | Mit Chromium und Schriftarten für die jeweilige Sprache | Erstellt Einzelbild-Screenshots im Headless-Browser |
Schritt 2: Modell bereitstellen und Skill installieren
- Gewichte herunterladen:
huggingface-cli download sensenova/SenseNova-6.8-Code2Video --local-dir /path/to/SenseNova-6.8-Code2Video - Dienst starten: Der Beitrag verwendet einen vLLM-Container, um eine OpenAI-kompatible Schnittstelle bereitzustellen. Als Beispiel dient Tensorparallelität über vier GPUs. Wichtige Parameter sind
--tensor-parallel-size 4und--max-model-len 524288. - Repository klonen:
git clone https://github.com/OpenSenseNova/SenseNova-6.8-Code2Video.git - Isoliertes Verzeichnis erstellen:
mkdir -p ~/video_tasks/methane_explainer/.claude/skills. Der Agent führt Shell-Befehle automatisch aus. Arbeiten Sie deshalb nicht in einem wichtigen Projektverzeichnis. - Skill kopieren:
cp -r SenseNova-6.8-Code2Video/skills/code-video ~/video_tasks/methane_explainer/.claude/skills/code-video - Kontext festlegen: Der Beitrag nennt die Umgebungsvariablen
CODEX_MAX_CONTEXT_TOKENS=524288,CODEX_AUTOCOMPACT_PCT=80undCODEX_MAX_OUTPUT_TOKENS=64000.
Im Beitrag tauchen sowohl .claude/skills als auch .codex/skills als Pfade auf. Welches Verzeichnis tatsächlich richtig ist, hängt vom verwendeten Agent und der offiziellen Dokumentation ab.
Wenn Ihr Team noch evaluiert, müssen Sie nicht gleich in eine Umgebung mit mehreren GPUs investieren. Über APIYI apiyi.com können Sie zunächst ein vorhandenes Programmiermodell anbinden und den Ablauf von der Spezifikation bis zu einer einfachen Canvas-Animation testen. So lassen sich Anforderungen und Workflow vorab prüfen; die Qualität des fertigen Videos lässt allerdings keine direkten Rückschlüsse auf die Fähigkeiten von Code2Video zu.
Schritt 3: Einen Satz zu einem Briefing für ein codegeneriertes Video ausarbeiten
Das Beispiel im Beitrag ist ein zwölfsekündiges Erklärvideo zur Methanverbrennung. Die Anforderung in einem Satz wird zu einem strukturierten Briefing ausgearbeitet. Alternativ lässt sich mit der Enhance-Prompt-Vorlage im Verzeichnis prompts/ des Repositorys eine Datei dense_prompt.md erstellen. Ein gutes Briefing sollte mindestens Folgendes festhalten:
- Grunddaten: Auflösung 1920×1080, Bildrate 30fps, Dauer 12 Sekunden, programmatisch erzeugte Soundeffekte.
- Lernziel: Erklären, dass eine chemische Reaktion Atome nur neu anordnet, sie aber weder erzeugt noch vernichtet.
- Zeitplan: 0–3 Sekunden Ausgangsstoffe zeigen, 3–7 Sekunden Bindungen aufbrechen, 7–10 Sekunden neu zusammensetzen, 10–12 Sekunden die ausgeglichene Reaktionsgleichung anzeigen.
- Feste Vorgaben: Der Zähler oben rechts bleibt während des gesamten Videos auf
C: 1 | H: 4 | O: 4fixiert.
Der letzte Punkt zeigt besonders gut den Vorteil des codebasierten Ansatzes. Das Modell muss sich das Aussehen des Zählers nicht „merken“: Die Werte werden im Programm fest hinterlegt und gerendert. So bleiben sie durchgehend konsistent.
Schritt 4: Das codegenerierte Video mit natürlicher Sprache verfeinern
Die erste Version des Videos ist meist nur der Ausgangspunkt. Der Beitrag empfiehlt, die Bearbeitung im selben Aufgabenverzeichnis mit --continue fortzusetzen, und nennt drei Tipps für Eingabeaufforderungen:
- Unveränderliches zuerst festlegen: Gleich zu Beginn
Keep the molecular coordinates, bond-breaking timing...schreiben. So wird beim Ändern des Stils nicht der Zeitplan neu geschrieben. - Genaue Zeitpunkte angeben: Zum Beispiel
At 3.5s when bonds break.... So findet das Modell leichter den passenden Abschnitt. - Änderungen an der bestehenden Datei verlangen: Am Ende
Edit the existing source in place and overwrite out/final.mp4.ergänzen. Dadurch wird kein neues Projekt angelegt.
Wenn kein Quellcode vorliegt, lässt sich auch ein Referenzvideo im Projektverzeichnis ablegen. Das Modell kann dann Layout, Übergänge und Bewegungsabläufe analysieren und daraus ein bearbeitbares Projekt erstellen. Das eignet sich, um Struktur und Rhythmus zu studieren. Vor einer Veröffentlichung sollten Sie jedoch das Urheberrecht und den Umfang der Nutzungsrechte am Referenzmaterial prüfen.
🚀 Tipp für den Ablauf: Vor einer längeren Aufgabe können Sie über APIYI apiyi.com ein Textmodell aufrufen, um Formeln, Fachbegriffe und Sprechertext im Skript zu überprüfen. Schreiben Sie die finale Fassung anschließend in
SPEC.md. Sachfehler vor dem Rendern zu korrigieren, ist meist einfacher als eine Nachbearbeitung des fertigen Videos.
Häufige Fragen: Videogenerierung mit Code vs. Pixelgenerierung
Q1: Was ist Videogenerierung mit Code?
Bei der Videogenerierung mit Code schreibt eine KI ausführbaren Grafik- oder Frontend-Code, der anschließend Bild für Bild als Video gerendert wird. Das Modell erzeugt also nicht direkt Pixel, sondern legt fest, wie das Bild zu jedem Zeitpunkt aussehen soll.
Q2: Was ist der größte Unterschied zwischen Videogenerierung mit Code und Pixelgenerierung?
Der Unterschied liegt im Ergebnis und darin, wie es sich bearbeiten lässt. Beim Code-Ansatz entsteht ein editierbares Projekt, mit dem sich Texte, Formeln und Timing gezielt steuern lassen. Der Pixel-Ansatz gibt Bilder direkt aus. Für einen Vergleich von Realismus und Gesamtkosten reichen die verfügbaren Informationen derzeit nicht aus. Beides sollte deshalb für jedes Projekt getestet werden.
Q3: Kann die Videogenerierung mit Code Tools wie Sora oder Runway vollständig ersetzen?
Diesen Schluss kann man derzeit nicht ziehen. Die verfügbaren Beispiele zeigen vor allem Wissensvermittlung, Bewegungsgrafiken und stilisierte Videos. Sie belegen nicht, dass der Code-Ansatz auch den Look realer Filmaufnahmen erreicht. Am besten wählen Sie den Ansatz nach den wichtigsten Anforderungen Ihres Videos und testen bei Bedarf eine Kombination.
Q4: Ist Videogenerierung mit Code immer günstiger als Pixelgenerierung?
Nicht unbedingt. Für die hohen Kosten, die am Anfang des Beitrags genannt werden, gibt es keine Quellenangabe. Deshalb dienen sie hier nicht als Grundlage. Die Kosten des Code-Ansatzes hängen von den Modellaufrufen, der Hardware und der Zahl der Überarbeitungsrunden ab. Auch lange Aufgaben können erhebliche Ressourcen verbrauchen. Erstellen Sie daher am besten zunächst einen kurzen Prototyp und schätzen Sie dann die Kosten.
Q5: Wie lässt sich der Workflow für Videogenerierung mit Code ohne Multi-GPU-System testen?
Erstellen Sie zunächst eine etwa 10 Sekunden lange SVG- oder Canvas-Animation. Dabei können Sie vor allem die Spezifikation, das Rendering-Skript und den Änderungsprozess testen. Über APIYI apiyi.com können Sie eine kompatible Schnittstelle nutzen und verschiedene Modelle vergleichen, indem Sie einfach den Modellnamen wechseln. Informationen zur Schnittstellenkonfiguration und zu den verfügbaren Modellen finden Sie unter docs.apiyi.com.
Q6: Welche Einschränkungen von Code2Video sollte man kennen?
Der Beitrag zeigt nur ein Beispiel mit vier parallel genutzten GPUs und nennt keine Mindestanforderungen an die Hardware. Quantisierte INT4- und INT8-Gewichte sollen erst später veröffentlicht werden. Außerdem fehlen Angaben zur Rendering-Dauer und objektiv beurteilbare Beispiele fertiger Videos. Auch die realistische Darstellung muss noch überprüft werden. Der Agent führt Befehle automatisch aus. Führen Sie ihn daher unbedingt in einem isolierten Verzeichnis aus.
Q7: Lassen sich die beiden Ansätze kombinieren?
Im Workflow lässt sich das ausprobieren: Sie können etwa Hintergrundmaterial mit realen Aufnahmen oder einem Pixelmodell erstellen und anschließend Titel, Formeln und Diagramme per Code darüberlegen. Die Quellen bestätigen diesen Ansatz allerdings nicht. Testen Sie daher zuerst, ob die Einbindung des Materials und das Rendering Bild für Bild synchron funktionieren. Wenn Sie Modelle für das Hintergrundmaterial vergleichen, können Sie über APIYI apiyi.com auch prüfen, welche Optionen aktuell verfügbar sind.
Videoerzeugung per Code vs. Pixelerzeugung: Das Wichtigste in Kürze
- Der zentrale Unterschied: Der Code-Ansatz erzeugt ein ausführbares Programm, der Pixel-Ansatz direkt die Bildinhalte.
- Ursprung der Deterministik: Das Bild ist eine reine Funktion f(t) und wird von einem Headless-Browser Bild für Bild gerendert.
- Bevorzugte Einsatzfälle: Wenn Texte, Formeln, Daten, Koordinaten und Taktzeiten exakt stimmen müssen, ist Code die erste Wahl.
- Entscheidend für den Workflow:
SPEC.md, die Prüfung von Miniaturansichten und Änderungen direkt im Projekt sorgen gemeinsam für Konsistenz über mehrere Bearbeitungsrunden hinweg. - Die wichtigste Grenze: Für Fotorealismus und den Look realer Aufnahmen fehlen Belege. Man sollte daher nicht davon ausgehen, dass der Code-Ansatz auch darin gleich gut ist.
- Empfehlung für den Einstieg: Anforderungen zunächst mit einem kurzen Prototyp und der einheitlichen Schnittstelle von APIYI prüfen, bevor man in eine eigene Bereitstellung investiert.
Fazit: Für welche Videos sollte KI Code schreiben?
Bei der Wahl zwischen Videoerzeugung per Code und Pixelerzeugung helfen drei Fragen:
- Auf die Elemente schauen: Je weniger Fehler bei Texten, Formeln, Daten und Zeitpunkten im Bild tolerierbar sind, desto besser eignet sich der Code-Ansatz.
- Änderungen berücksichtigen: Wenn mehrere lokale Anpassungen nötig sind und der übrige Inhalt unverändert bleiben soll, ist ein bearbeitbares Projekt im Vorteil.
- Auf die Bildwirkung achten: Wenn echte Menschen und die Atmosphäre realer Aufnahmen den Kern ausmachen, sollte man nicht einfach davon ausgehen, dass der Code-Ansatz dafür geeignet ist.
Als nächsten Schritt können Sie ein vorhandenes Video von 10–15 Sekunden anhand von vier Fragen analysieren und dafür separate Prototypen erstellen. Vergleichen Sie anschließend Genauigkeit, Anzahl der Änderungen und tatsächlichen Zeitaufwand. Wenn Sie mehrere Modelle gleichzeitig bewerten möchten, können Sie über APIYI apiyi.com mit einer einheitlichen Schnittstelle die Ausarbeitung von Skripten und die Codegenerierung testen. Entscheiden Sie anhand der Ergebnisse, ob Sie Code2Video bereitstellen möchten.
📚 Quellen
- Erfahrungsbericht – SenseNova 6.8 Code2Video in der Praxis: Quelle für die Grundlagen, den Ablauf und die Beispiele dieses Artikels
- Link:
v2ex.com/t/1254274 -
Hinweis: Veröffentlicht am 3. November 2026. Einige Vergleiche und Kostenangaben sind nicht unabhängig überprüft.
-
GitHub – SenseNova 6.8 Code2Video: Offizielles Repository und code-video Skill
- Link:
github.com/OpenSenseNova/SenseNova-6.8-Code2Video -
Hinweis: Maßgebliche Quelle für Deployment, Verzeichnisstruktur und Funktionsupdates.
-
Hugging Face – SenseNova 6.8 Code2Video: Veröffentlichungsseite für die Modellgewichte
- Link:
huggingface.co/sensenova/SenseNova-6.8-Code2Video - Hinweis: Hier lassen sich Modellspezifikationen, Versionen der Modellgewichte und der Stand der Quantisierung prüfen.
Autor: APIYI-Technikteam
Technischer Austausch: Informationen zum einheitlichen Zugriff auf mehrere Modelle finden Sie bei APIYI unter apiyi.com oder im Dokumentationszentrum unter docs.apiyi.com.