著者注:GDPx の初回評価では、金融と法律の両分野で、厳格な二値判定による検収を完全に通過したモデルはありませんでした。この記事では、公開された2つの事例で実際に起きた誤りを振り返り、「計算ができる、契約書が書ける」ことと「合格基準を満たす成果物を納品できる」ことの違いを考えます。
2026 年 11 月 2 日、SemiAnalysis は、高難度の専門タスクを対象としたベンチマーク GDPx v1.0 を発表しました。11 分野のうち、金融と法律の 2 分野では、当初の二値判定による合格基準を完全に満たしたモデルはありませんでした。研究チームは、モデル間の違いを示すために「平均部分スコア」を用いることにしました。
これは「AI は使えない」という感情的な結論ではありません。 法律の事例で平均部分スコア 44% を獲得したモデルもあれば、金融の事例で検収チェック項目の約半分をクリアしたモデルもあります。本当に注目すべきなのは、半分正しくできても、なぜ納品できないのかという点です。
この記事でわかること:Bellwood-QoE の金融タスクとシリーズ B 資金調達に伴う定款改定タスクについて、重要な金額、失敗回数、採点基準を解説します。AI による支援能力と、独立して責任を持てる納品能力の違いも、より明確になります。
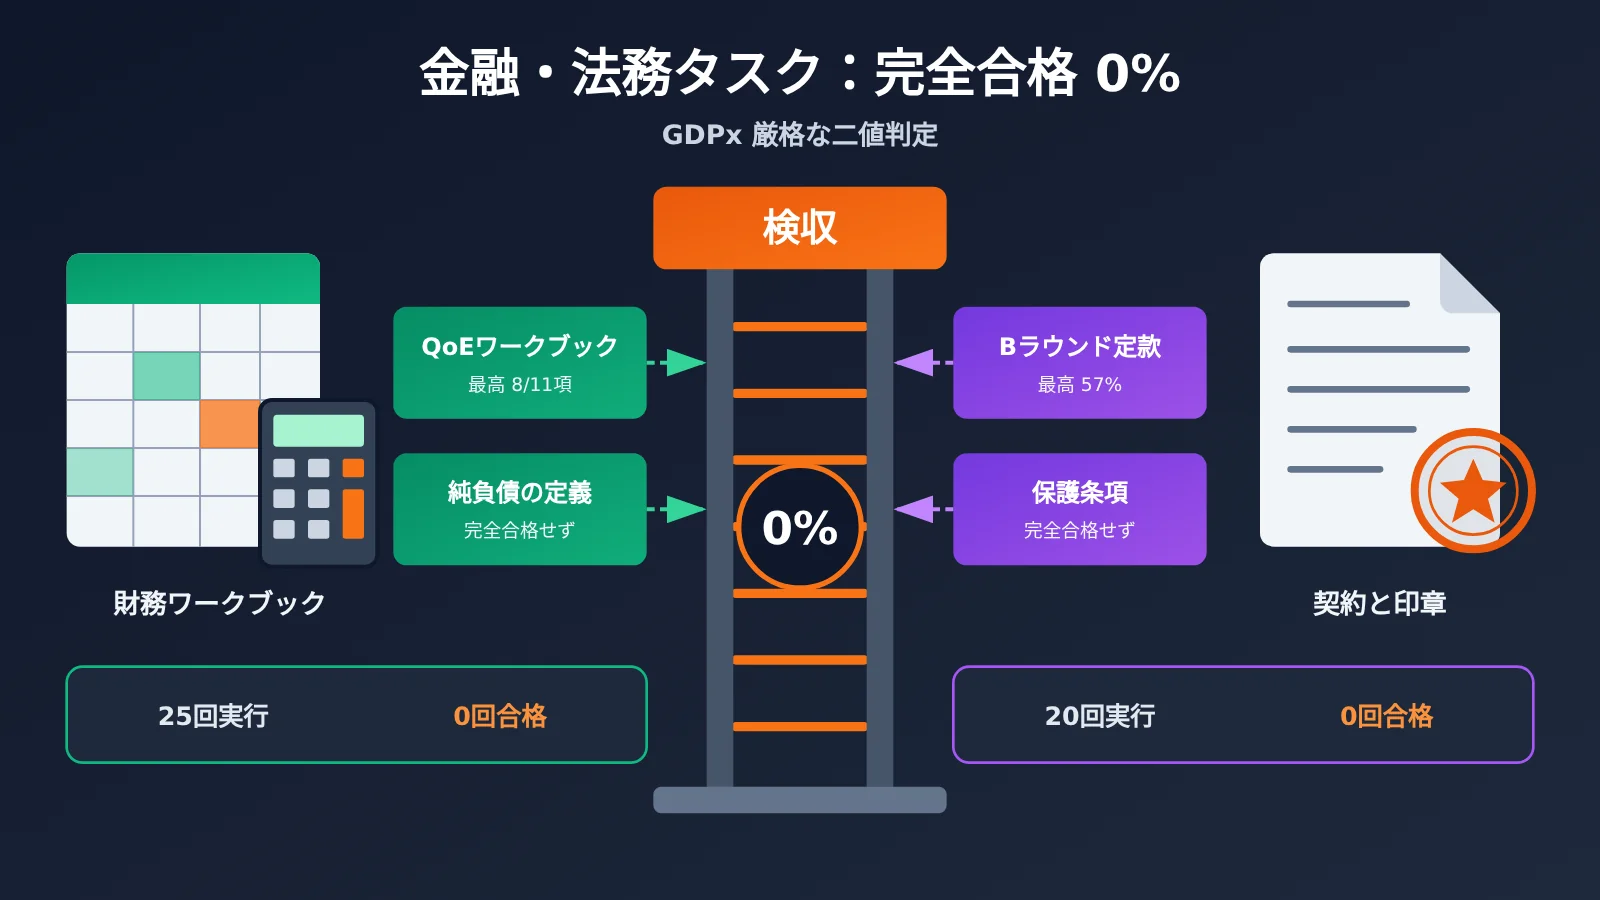
金融・法律タスクは全件不合格:GDPxの主要ポイント
GDPxの初回評価は、11の専門分野、206のタスクを対象とし、原則として各タスクに最大8時間をかけて、「モデル + Agentフレームワーク + ツール + 作業環境」の総合的な性能を測定しています。総合ランキング1位のClaude Opus 5.5でも、スコアはわずか12.0%でした。その中でも、金融と法律の2分野は特に厳しい結果となっています。
| 項目 | 金融分野 | 法律分野 |
|---|---|---|
| タスク数 | 24項目 | 20項目 |
| 専門パートナー | Living Context | Chakra |
| 公開事例 | Bellwood-QoE(利益の質の分析ワークブック) | quillon-series-b-redline(シリーズBの定款改訂) |
| 公開事例の実行回数 | 選定された25回の実行 | 4モデルで計20回の実行 |
| 完全合格回数 | 0回 | 0回 |
| 厳格な二値評価 | 0% | 0% |
| 部分点の結果 | 最良の実行で11項目中8項目に合格 | 平均18%、単一実行の最高57% |
この表を読む際には、2点に注意が必要です。第一に、二値スコアが0%だからといって、すべての実行成果に価値がないわけではありません。部分点は明らかにゼロではありません。第二に、表の25回と20回は、それぞれ1つの公開事例における実行回数です。金融分野の24タスク全体、または法律分野の20タスク全体が、それぞれその回数しか実行されなかったという意味ではありません。
金融・法律タスクで厳格な検収が行われる理由
両分野の成果物は、単なる助言ではなく「実際の取引プロセスにそのまま投入できる文書」です。M&Aのデューデリジェンスや資金調達の交渉では、ネットデットの算定基準に誤りが1つあるだけでも、あるいは抜け道のある保護条項が1つあるだけでも、文書全体が使い物にならなくなる可能性があります。
そのため、GDPxでは専門家の成果物に求められる水準に近い厳格な検収方法を採用しています。これが、0%という結果が出た直接の理由です。
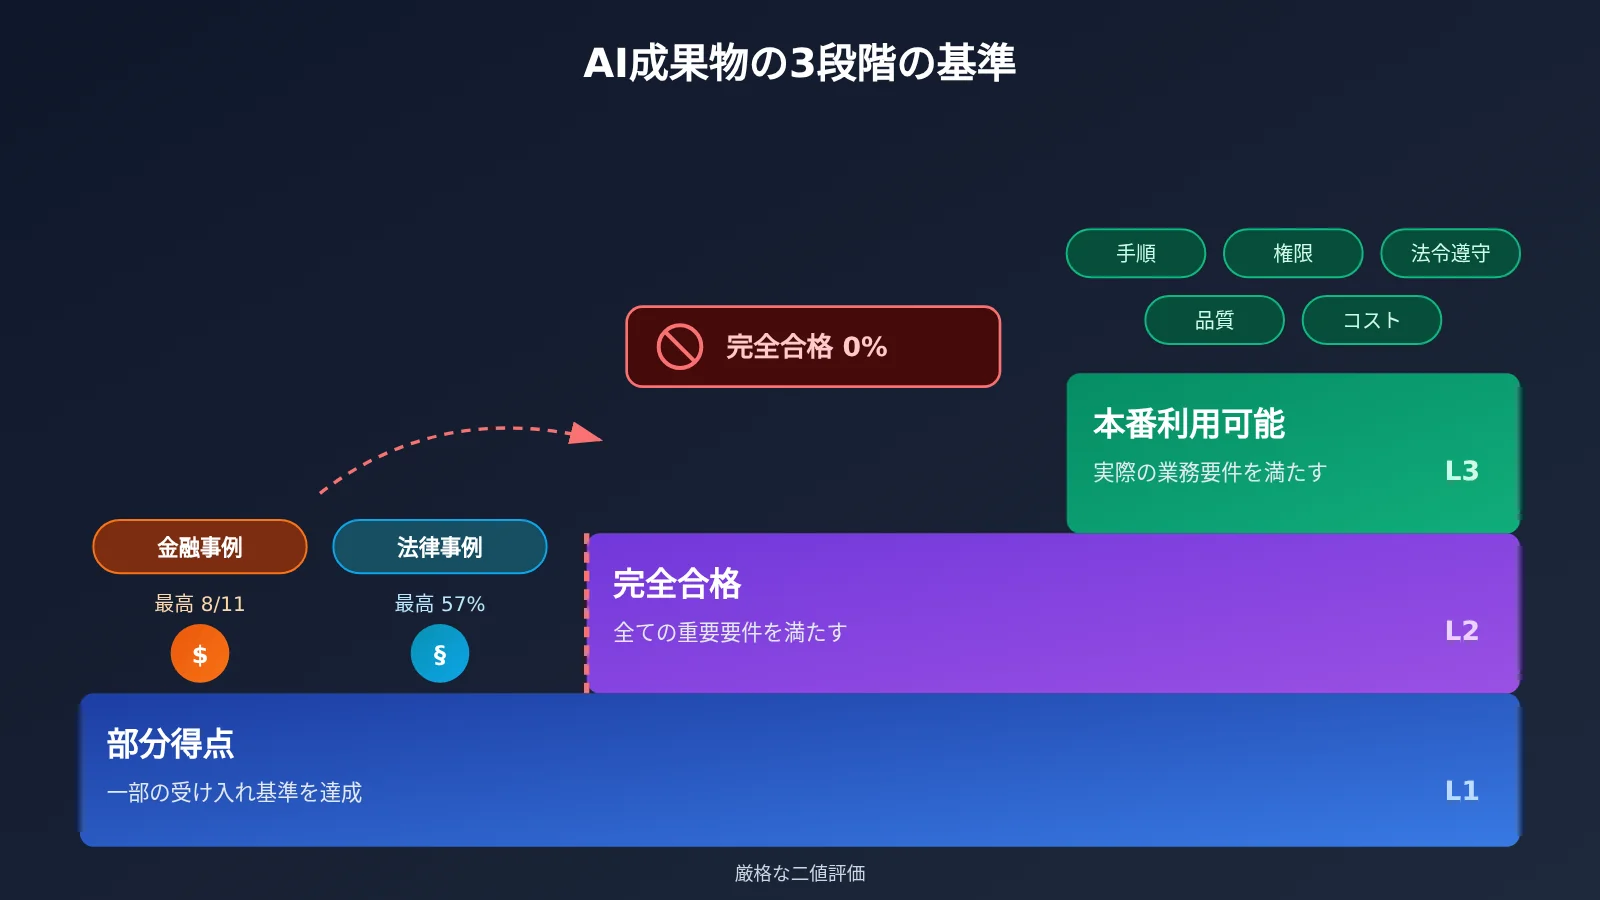
金融業務の事例:Bellwood-QoE では AI の計算が合っていても、成果物は合格に届かなかった
取引の背景とタスクの要件
Living Context は、実際の取引経験を基に匿名化されたテスト環境を構築しました。プライベートエクイティファンドの Bannock Capital が Haverly Snack Company の株式約 62% を約 8.8 億ドルで取得し、別途、条件付き対価も設定された取引です。この環境には約 4,000 件の匿名化されたファイルがあり、財務総勘定元帳、銀行明細、給与資料、売掛金の年齢調べ、契約関連のやり取り、取引契約、過去の調整表、複数のアドバイザーによる作業資料などが含まれています。
モデルは、未完成の収益の質分析(QoE)ワークブックを引き継ぐ必要がありました。既存データのうち正しいものを見極め、正しい項目と計算構造を維持しながら、誤った数値や分類を修正します。さらに、EBITDA 調整の確認、12 か月分の運転資本の整合、純負債の算定範囲への対応、各調整の根拠資料の提示、シート間の参照の整合性確保も求められました。成果物は、修正済みのワークブックそのものです。
Bellwood-QoE の実測結果
| モデル | 11項目の受け入れチェックに平均で合格した項目数 | すべてに合格したか |
|---|---|---|
| GPT-6.1 Sol | 5.6項目 | いいえ |
| Claude Opus 5.5 | 5.4項目 | いいえ |
| GPT-6 Astra | 5.4項目 | いいえ |
| GLM 5.3 | 2項目未満 | いいえ |
| Grok 4.7 | 2項目未満 | いいえ |
| 最良の単一実行 | 8項目 | いいえ |
最も優れたモデルでも、平均で合格したのはチェック項目の約半分でした。最良の実行では8項目に合格しましたが、残りの項目に重大な財務上の誤りがあれば、ワークブック全体を納品することはできません。以下の3種類の誤りから、問題の所在が見えてきます。
財務上の誤りその1:418ドルの調整を拡大解釈
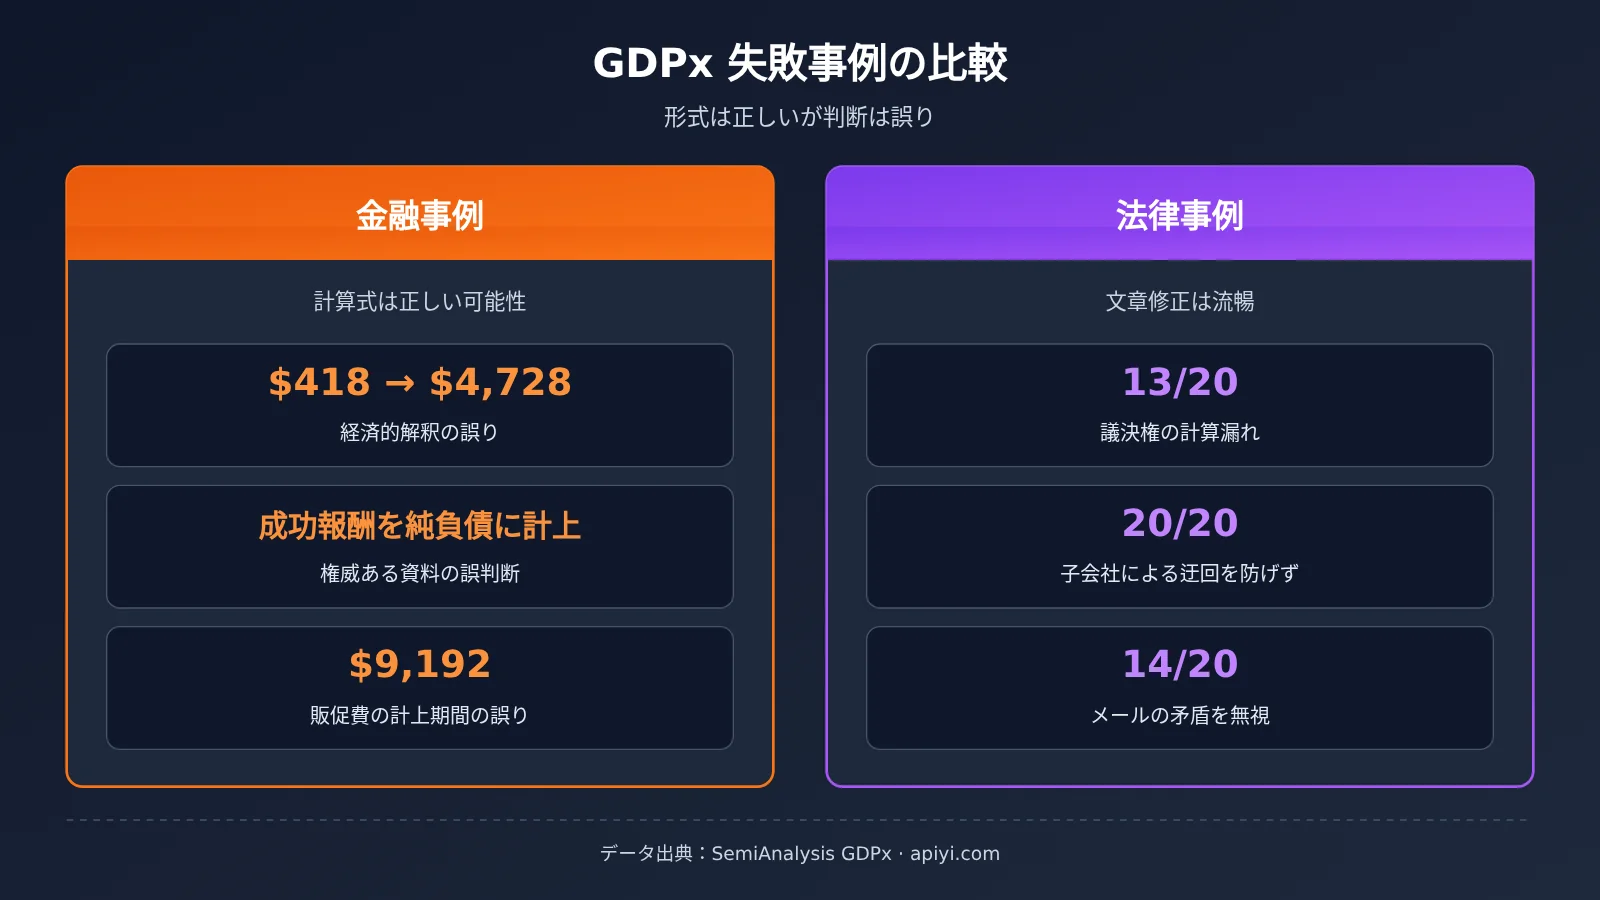
すでに免除された418ドルの保険監査に伴う調整を、一部のモデルは「それまでの労災保険契約全体に関する義務が終了した」と解釈しました。その結果、過去12か月のEBITDAが4728ドル過小評価されました。Opus、Astra、Solによる関連する15回の実行のうち、10回でこのような誤判断が発生しました。
これは掛け算の間違いではありません。モデルが、特定の調整に関する会計上・法律上の意味を、過去の保険責任全体に対する判断へと拡大してしまったのです。4728ドルの差額は、この誤判断の結果として生じたものであり、418ドルの何倍かに相当する額ではありません。計算式自体は正しい可能性があるため、「何度も計算を確認する」だけでは発見しにくい誤りです。
金融分野の誤り2:取引費用を純有利子負債に含めた
15回の実行で、投資銀行への成功報酬が純有利子負債に計上されました。しかし、買収契約では、この報酬を別個の取引費用として扱うよう定められていました。モデルは費用を見つけ、加減算も正しくできましたが、拘束力のある契約上の扱いを採用しませんでした。
これは、「データが存在すること」と「ビジネス上の分類が正しいこと」の違いを示しています。M&Aでは、純有利子負債が買い手の実際の支払額に影響することが多く、分類ミスの影響は表計算シートの中だけにとどまりません。
金融分野の誤り3:調整すべき費用を見落とした
研究チームは、さらに見えにくい問題も発見しました。
- 17回の実行で、実際には働いていない家族への報酬を、企業の通常の営業費用として扱ったままでした。
- 大半の実行で、総勘定元帳の備考欄にしか記載されていないオーナーの個人的な費用を特定できませんでした。
- 最も優れたモデルによる15回の実行のうち10回で、過去の販促費9,192ドルの調整を見落とし、別の期間に属する費用を直近12か月に計上しました。
これらの誤りは、会計期間、費用の性質、証拠の出所、取引の経済的実態にまたがっています。収益の質を分析する意義は、まさにこうした「営業費用のように見えて、実際にはそうではない」項目を取り除くことにあります。これらを見落とすと、EBITDAは企業の真の収益力を反映できません。
法律業務の事例:シリーズB資金調達に伴う定款修正が20回すべてで実用水準に届かなかった理由
法律タスクの要件
quillon-series-b-redline タスクでは、AIがシリーズB資金調達のリード投資家を代理し、締結予定の会社定款を修正します。入力資料には、署名済みの投資条件一覧、資本構成表、顧客からのメール、定款案、その他の取引関連資料が含まれます。成功の条件は、投資家の正当な権利を守りつつ、すでに合意した取引条件を理由なく変更しないことです。これは文章を整える作業ではなく、複数の資料を照合して法的な判断を下すタスクです。
法律事例の結果と3つの主な失敗
| 指標 | 結果 |
|---|---|
| 実用水準を完全に満たした回数 | 0/20回 |
| 平均部分得点 | 18% |
| 各モデルの部分得点 | Opus 5.5は44%、GPT-6 Astraは25%、Gemini 4 Argonは2%、GLM 5.3は0.5% |
| 1回あたりの最高部分得点 | 57%(Opus 5.5) |
| 株主の議決によって保護条項を削除できることを見落とした回数 | 13/20回 |
| 子会社を通じた迂回を防げなかった回数 | 20/20回 |
| 顧客メールと投資条件一覧の矛盾を指摘しなかった回数 | 14/20回 |
なお、18%はこの事例に関連する実行の平均部分得点であり、GDPxの法律分野全体の統一スコアではありません。
失敗1:条項を読むだけで、議決権を計算しない。 13回の実行では、他の株主が、リード投資家に必要な保護条項を削除できるだけの議決権を持っていることに気づきませんでした。定款に保護条項が書かれていても、その保護が確実に維持されるとは限りません。資本構成表と照らし合わせて議決権を計算して初めて、その条項が覆される可能性を判断できます。
失敗2:文面だけを修正し、迂回を防がない。 20回の実行すべてで、会社が子会社を利用して定款上の投資家保護の制限を回避することを、効果的に防げませんでした。条項が会社自体しか拘束していなければ、実際の事業を別の主体に行わせることができます。条項の文面を理解することと、現実に想定される回避ルートを見抜くことは別です。
失敗3:メールを最終合意として扱う。 14回の実行では、顧客メールに記載された希望条項をそのまま採用し、署名済みの投資条件一覧と矛盾することを指摘しませんでした。このような修正は、確定した取引条件を一方的に再交渉することに相当します。適切な対応は、要求をすべて受け入れるのではなく、矛盾を見つけてユーザーに伝えることです。
法律分野の採点では信頼性をどう確保しているか
Chakraの採点設計には、法律の専門家による要件の策定、正解・不正解・部分的に正しいサンプルを使った採点基準の調整、判断が分かれる判定の人手による再確認、採点モデルのバイアスの検証が含まれます。各出力は5回採点され、各評価項目の結果に一貫性があるかも追跡されます。ただし、これは協力企業が説明している内部品質管理であり、完全に独立した機関が採点に誤判定がないことを検証済みだという意味ではありません。
金融・法律タスクの失敗に共通する原因:書けないのではなく、判断を誤る
Living Context は、金融事例でよく見られる誤りを4種類にまとめています。これは、法律事例での観察結果ともよく一致しています。
| 失敗パターン | 金融事例での現れ方 | 法律事例での対応例 | 実務への示唆 |
|---|---|---|---|
| 資料の権威性を誤って判断する | 数値が最も明確に記載された古い表を重視し、署名済みの契約を見落とす | 顧客のメールを条項一覧より優先する | まず「文書の効力の優先順位」を決める |
| 二次的な影響を見落とす | 計算は完了したものの、税務、債務、取引上の義務への影響を見落とす | 保護条項を変更したが、議決権構造への影響を検討していない | 変更ごとに、その先に及ぶ影響を確認する |
| 計算式だけを確認し、前提を確認しない | 四則演算を繰り返し検証しても、ビジネス上の前提が間違っている | 文言は厳密だが、子会社を介する経路をカバーしていない | 計算の確認より前提の検証が重要 |
| 修正時に既存の構造を壊す | 数式を数値に置き換えてハードコードし、表間の連携を断ち切る | 合意済みの商業条件を変更する | 成果物は「正しく修正し、既存の部分を損なわない」ことが大切 |
これらは研究チームがまとめた失敗パターンであり、すべての企業の財務モデルや法的文書に共通するエラー率を示すものではありません。共通して見えてくるのは、重要な難しさは文章の生成よりも、資料の選択、専門的な推論、暗黙の制約、文書間の一貫性、そして最終的な検収にあるということです。モデルの回答が流暢であるほど、こうした問題は見過ごされやすくなります。
金融・法律分野のAI活用への影響:支援と成果物の納品をどう区別するか
企業のAI責任者と開発者への影響
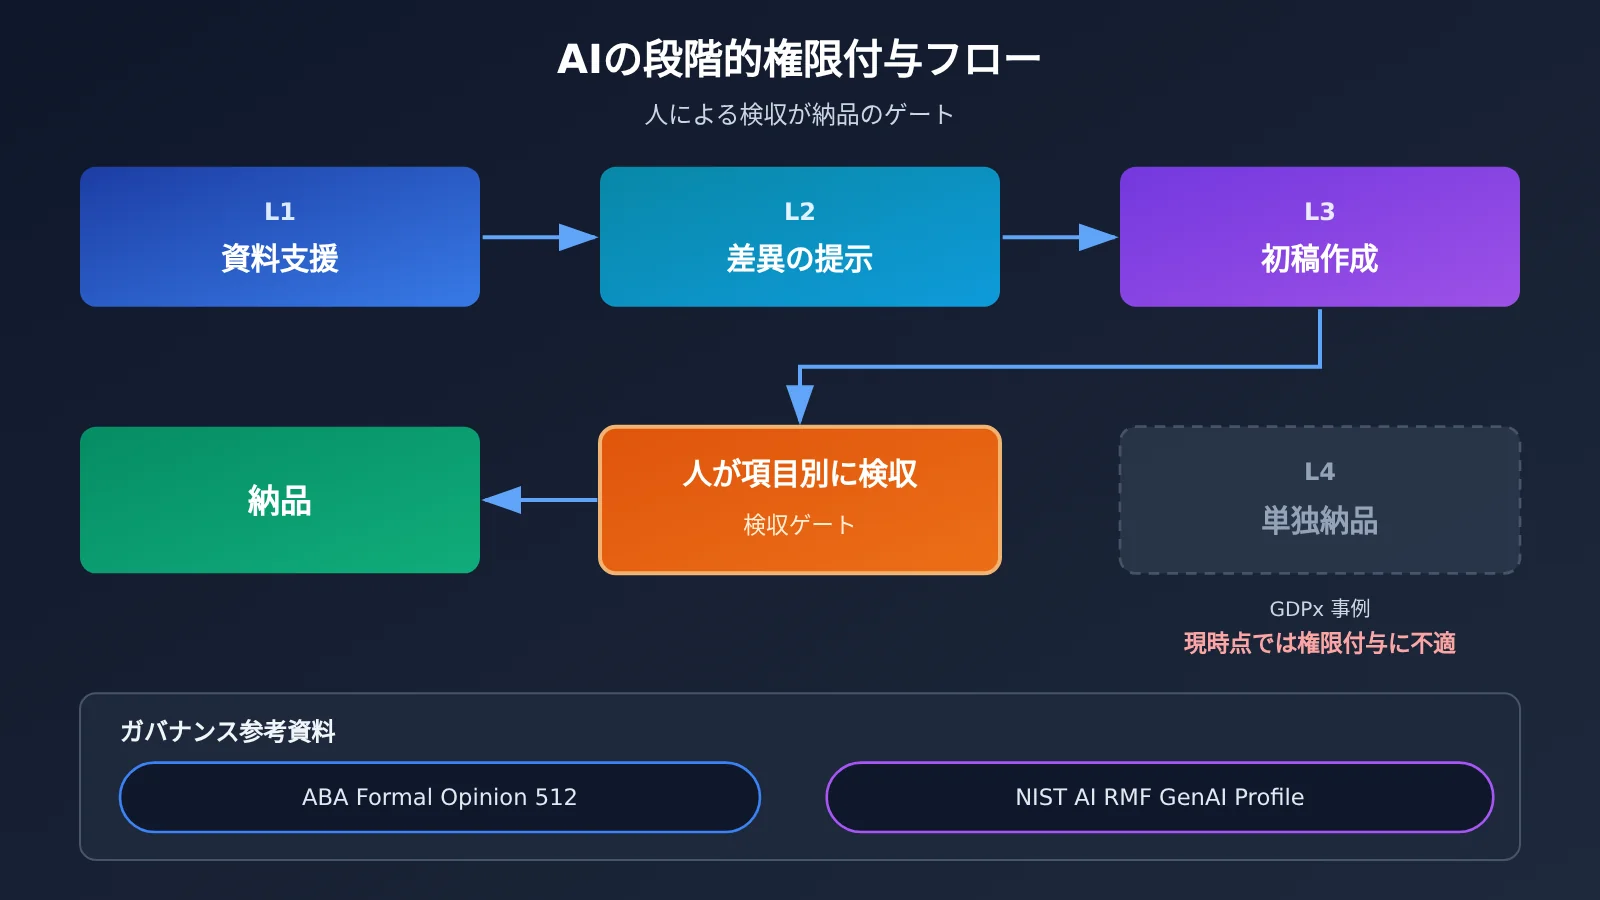
GDPx は、AI が専門業務を支援する価値を否定しているわけではありません。部分点が得られたことは、モデルが受け入れ要件の一定の割合を満たせることを示しています。ただし、研究は人間が関与した場合に時間やコストをどれだけ削減できるかを示していないため、事例の結論をそのまま ROI に換算すべきではありません。より現実的な方法は、リスクに応じて権限を段階的に付与することです。以下の表を参考にできます。
| 権限レベル | 主な用途 | 人間の役割 | 受け入れ方法 |
|---|---|---|---|
| L1 資料支援 | 資料の初期整理、異常データのチェック | 抜き取り確認 | 結果は手がかりとしてのみ使用 |
| L2 差異の提示 | 条項やデータの差異の提示、矛盾点の一覧作成 | 一件ずつ確認 | 専門家が正否を判断 |
| L3 初稿の作成 | ワークブック修正の初稿、定款の変更履歴付き初稿(redline) | 全件レビュー | チェックリストに沿って項目ごとに確認 |
| L4 独立した成果物の納品 | 対外的な署名や提出を直接行う | — | GDPx の事例は、現時点では権限付与が適切でないことを示している |
この段階分けは、外部の規範が示す方向性とも一致しています。米国法曹協会(ABA)が 2024 年 7 月 29 日に発表した Formal Opinion 512 は、弁護士が生成AIを使用する際も、職務遂行能力、依頼者情報の守秘、コミュニケーション、監督、適正な報酬といった責任を考慮しなければならないと指摘しています。また、ツールの能力と限界を理解し、出力を検証せずに採用してはならないとしています。米国 NIST が 2024 年 7 月 26 日に発表した AI RMF の生成AIプロファイルも、組織は利用状況に応じて人間による監督、評価、記録、ガバナンスを整えるべきだと強調しています。
なお、ABA の意見は米国の弁護士向け職業倫理指針であり、NIST の文書も GDPx のテスト結果ではありません。いずれも分野を越えた参考情報として捉える必要があります。
APIで「矛盾を指摘する」補助フローを構築する
GDPxの法務事例でよく見られる失敗の一つが、顧客のメールと署名済み条項の矛盾を指摘できないことです。こうした「差異を見つけ、疑問点を挙げる」作業は、出力を人間が確認するための手がかりとしてのみ使うことを前提に、L2レベルの補助に適しています。以下の例では、モデルに2つのテキストを照合させ、矛盾点と人間による確認が必要な事項を列挙させます。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIのOpenAI互換インターフェース
)

resp = client.chat.completions.create(
    model="claude-sonnet-4-20250514",
    messages=[{"role": "user", "content": "对照【已签署条款清单】与【客户邮件】,只列出冲突项和需人工确认的问题,不要直接修改条款。\n条款清单:...\n客户邮件:..."}]
)
print(resp.choices[0].message.content)
完全な実装コードを見る(複数モデルによる相互照合+人間による審査チェックリスト)
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 1つのキーで複数の提供元のモデルを呼び出す
)

SYSTEM = (
    "你是交易文件审查助手。你的输出只作为专业人员的审查线索,"
    "必须遵守:1) 已签署文件效力优先于邮件和旧表格;"
    "2) 发现冲突时提示,不得自行改写商业条款;"
    "3) 每条结论标注依据的文件名和段落;"
    "4) 无法确认的事项明确写'需人工确认'。"
)

CHECKS = [
    "客户邮件中的要求是否与已签署条款清单冲突",
    "结合股权结构,其他股东能否凭投票权移除保护条款",
    "保护条款是否覆盖子公司,是否存在绕行路径",
]

def review(docs: str, models: List[str]) -> Dict[str, str]:
    """複数のモデルでそれぞれ審査の手がかりを生成し、人間が相互に照合できるようにする"""
    prompt = "请逐项检查:\n" + "\n".join(f"- {c}" for c in CHECKS) + f"\n\n材料:\n{docs}"
    results = {}
    for m in models:
        try:
            r = client.chat.completions.create(
                model=m,
                messages=[{"role": "system", "content": SYSTEM},
                          {"role": "user", "content": prompt}],
                temperature=0
            )
            results[m] = r.choices[0].message.content
        except Exception as e:
            results[m] = f"调用失败: {e}"
    return results

if __name__ == "__main__":
    out = review("条款清单:...\n股权结构表:...\n客户邮件:...\n章程草稿:...",
                 ["claude-sonnet-4-20250514", "gpt-4o"])
    for model, text in out.items():
        print(f"===== {model} =====\n{text}\n")
    # 最終的に採用するかどうかは、弁護士または財務の専門家が確認チェックリストに沿って項目ごとに判断する
🚀 手軽に始めるためのアドバイス:このような補助フローを構築する際は、まずAPIYI apiyi.comを通じて、同じAPIキーで複数の主要モデルに接続し、匿名化した自社のサンプルで矛盾をどの程度検出できるかを比較してみましょう。新規ユーザーは無料テスト枠を使って小規模に検証し、その結果を踏まえて試験導入に進むかどうかを判断できます。
金融・法律テック業界への影響
GDPx の結果は、専門分野向け AI 製品の評価では、対話デモの流暢さだけでなく、最終成果物が専門家の検収に耐えられるかを見る必要があることを示しています。ベンダーにとって、製品の競争力を左右するのは、「権威ある文書の優先順位」「矛盾の指摘」「既存の数式構造の維持」「根拠の追跡」といった実装上の細部になるでしょう。導入を検討する側も、自社の業務に近いタスクで独自にテストすることが大切です。GDPx 自体も公開しているタスクと実行履歴は一部に限られており、さらなる外部検証と再現が必要です。
💡 選定のヒント:モデルの性能は分野によって大きく異なるため、総合ランキングだけでは自社の業務に合うかどうかは分かりません。APIYI apiyi.com の統一インターフェースを通じて、自社のタスクで複数のモデルを並行してテストすることをおすすめします。平均点だけでなく、部分点や重要項目の合否も記録しましょう。各モデルの利用可否は、プラットフォームの最新リストをご確認ください。
よくある質問 FAQ
Q1:金融・法律タスクで「全滅」とは、AI が何一つ正しくできなかったという意味ですか?
いいえ。0% は、厳格な合否判定による結果で、すべての重要要件を満たした実行が一度もなかったことを意味します。金融の事例では、最も良かった単発の実行で 11 項目中 8 項目のチェックに合格しました。法律の事例では、Opus 5.5 の平均部分スコアは 44% でした。一部を達成することと、成果物として合格することは、別の基準です。
Q2:AI は計算が合っていても、なぜ結果を間違えるのですか?
計算式そのものではなく、業務上の前提に誤りがあることが多いためです。例えば、418 ドルの免除に関する調整を保険契約全体の義務が終了したと拡大解釈し、EBITDA を 4728 ドル過小評価したケースがありました。また、銀行担当者への成功報酬の金額は正しく把握したものの、純負債に分類したケースもあります。このような誤りは、繰り返し計算を検算しても発見できません。
Q3:GDPx の結論は、金融・法律分野におけるすべての AI 活用に当てはまりますか?
いいえ。これらの結果は、特定の高難度タスクと採点ルールに基づくものであり、事例から導き出された失敗の原因も業界全体の結論に拡大することはできません。難易度の低い用途や、人間が協力する用途は、個別に評価する必要があります。
Q4:現段階で AI はどのような金融・法律業務に適していますか?
初期段階の資料整理、条項やデータの差異の指摘、初稿の作成、異常なデータのチェック、審査チェックリストの作成支援などが、比較的妥当な活用先です。具体的な業務に適しているかは、リスクの程度と専門的な受け入れ基準を踏まえ、個別にテストする必要があります。
Q5:特定のモデルが自社の業務でどの程度の性能を発揮するか、低コストで検証するにはどうすればよいですか?
以下の手順で進められます。
1. 匿名化した実際のサンプルをいくつか用意し、それぞれに項目別の受け入れチェックリストを作成する;
2. APIYI apiyi.com に登録して APIキーを取得し、無料テスト枠を利用する;
3. 本記事のコードの base_url を `https://api.apiyi.com/v1` に設定し、複数のモデルを並行して呼び出す;
4. 部分スコアと重要項目の合否をそれぞれ記録し、専門家が最終判定する。
Q6:GDPx レポートのタスクコストは、API の料金を見積もる際の参考になりますか?
いいえ。GDPx に記載されたドル金額は、ベンチマークの実行条件下におけるタスクあたりの平均コストであり、どのプラットフォームにも共通する料金ではありません。実際の費用は、利用するプラットフォームの最新料金と自身の呼び出し量を基準にしてください。APIYI apiyi.com のコンソールでは、従量課金の明細を確認できます。
金融・法律タスクの AI 評価:主なポイント
- 厳格な合否判定では全モデルが不合格:GDPx の金融・法律分野では、二値基準ですべての要件を満たしたモデルはありませんでした。
- 部分点は獲得:金融の事例では、1回の実行で最大 11 項目中 8 項目をクリアし、法律の事例では最高得点が 57% でした。
- 誤りは計算ではなく判断にある:418 ドルの調整に関する誤読によって、EBITDA が 4728 ドル過小評価されました。
- 情報源の優先順位が重要:20 回中 14 回の実行で、署名済みの条件リストよりも顧客のメールが優先されました。
- 暗黙の制約への対応が最難関:子会社を介した迂回のリスクは、20 回すべての実行で防げませんでした。
- 3つの概念は分けて考える:部分点の獲得、すべての要件のクリア、実務での利用可能性は、それぞれ別に評価する必要があります。
- まずは補助から、次に試験導入へ:APIYI apiyi.com のマルチモデル統一インターフェースを通じて、自社のサンプルで段階的に検証できます。
まとめ
GDPx の金融・法律タスクから得られる主な示唆は、次の3点にまとめられます。
- 流暢だからといって合格とは限らない:表の計算が正しく、条項がなめらかに書かれていても、経済的な実態、権利関係、文書間の矛盾について判断を誤る可能性があります。
- 専門的な成果物には判断力が欠かせない:情報源の権威性、二次的な影響、暗黙の制約、文書間の整合性こそが、専門業務における難所です。
- 権限は段階的に与え、合格基準を明確にする:ABA と NIST の考え方を参考に、人によるレビューを維持し、AI は補助や初稿作成の役割にとどめます。
AI はすでに複雑な専門タスクの一部で価値を生み出せますが、独立して責任を負う成果物を作成するには、まだ大きな隔たりがあります。金融や法律の分野で AI の導入を検討しているなら、APIYI apiyi.com を通じて自社の業務サンプルで複数モデルの部分点と重要項目の通過率を比較し、そのうえで任せる範囲を決めることをおすすめします。
📚 参考資料
- SemiAnalysis GDPx 原著レポート:金融・法律分野の章、事例と失敗パターン
- リンク:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
説明: Bellwood-QoE と quillon-series-b-redline の事例データの一次情報源
-
GDPx の分野別説明と公開実行トレース:タスク数、協力パートナー、エージェントの実行トレース
- リンク:
gdpx.semianalysis.com/domains、gdpx.semianalysis.com/rollouts -
説明: 一部の公開タスクの実行過程を確認できます
-
ABA Formal Opinion 512 ニュース解説:弁護士による生成AIの使用に関する職業倫理ガイダンス
- リンク:
americanbar.org/news/abanews/aba-news-archives/2024/07/aba-issues-first-ethics-guidance-ai-tools/ -
説明: 米国の弁護士に適用されるもので、人によるレビューの原則を考える際の参考になります
-
NIST AI RMF 生成AI Profile:生成AIのリスク管理フレームワーク
- リンク:
nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence - 説明: 人による監督、評価、ガバナンス対策についての分野横断的な参考資料です
著者:APIYI 技術チーム
技術交流:APIYI公式サイトのトップページからお気軽にお問い合わせください。連携に関する詳しい資料は docs.apiyi.com のドキュメントセンターでご覧いただけます