著者注:この記事では、DeepSeek Super-agentのイベント駆動アーキテクチャの主要な仕組みを解説します。オープンソースのプロトタイプで実現済みの機能、DeepSeek内部の事例、今後のアーキテクチャ構想を区別しながら、能動的なエージェントの製品価値とエンジニアリング上のトレードオフを考えます。
ある開発チームのグループチャットを想像してみてください。誰かが「Safariでまたログインページが開けなくなった」と何気なく発言します。ボットへのメンションもなく、Issueも作成されていません。しばらくすると、チャットに短い通知が届きます。問題を再現し、原因を特定し、修正PRを用意したのでレビュー待ちです、と。DeepSeekの公式技術記事によると、この「ひそかに再現・修正する」という方法は、すでに社内のDeepSeek Harnessグループチャットで採用されている作業方針の一つです。
これは「AIが勝手に行動し始める」という話ではありません。 DeepSeek Super-agentの核となる変化は、システムが外部のイベントを継続的に把握し、明確な権限とルールの下で作業を見つけ、先回りして準備し、適切なタイミングで成果を届けられることです。権限制御と能動的な実行はセットで設計されており、どちらも欠かせません。
この記事のポイント:Super-agentのイベント駆動アーキテクチャを支える5つの主要な仕組みを理解し、オープンソースのプロトタイプで実装済みのものと、社内事例やアーキテクチャ構想にとどまるものを区別できます。また、この考え方を参考に、ユーザーの邪魔をせず、制御可能な能動的エージェントを設計する方法も学べます。
DeepSeek Super-agent の主要情報
詳しく見ていく前に、Super-agent について現在公開されている情報を表にまとめます。特に「実装済み」と「構想」の違いは、このプロジェクトを理解するうえで重要です。
| 項目 | 内容 | 状況 |
|---|---|---|
| プロジェクトの位置づけ | 受動的な応答から能動的な Agent への移行を目指す、イベント駆動型アーキテクチャの探求 | 公式技術記事とオープンソースのプロトタイプ文書に記載 |
| イベントソース(Trigger) | インスタントメッセージ、GitHub Issue、PR コメント、コードレビュー、CI、メール、日程、プロジェクト協業イベント | 公開プロトタイプは主に GitHub に対応し、飛書はオプションで連携可能。メールやカレンダーは、より広範なアーキテクチャ構想に含まれる |
| タスク受付モード | off、observe、auto |
オープンソースの権限付与に関する文書に記載済み。デフォルトは observe |
| 権限付与の仕組み | Mandate。タスクの発生元、権限の強さ、範囲、ポリシーのバージョンを記録 | オープンソースの権限付与に関する文書に記載済み |
| 非同期タスク | タスク開始後に Started を返し、バックグラウンドで実行することで対話を妨げない | DeepSeek Harness に実装済み。ただし、デフォルトではまだ有効になっていない |
| 社内事例 | グループチャットで Bug を「黙って再現・修正」 | DeepSeek 社内での運用事例であり、第三者による独立した検証は行われていない |
| コミュニティからの報告 | 2026 年 11 月 1 日に、Issue → PR の一連の流れが成功したとユーザーが報告 | デプロイの過程では複数の設定上の問題が発生 |
DeepSeek Super-agent のイベント駆動アーキテクチャとは
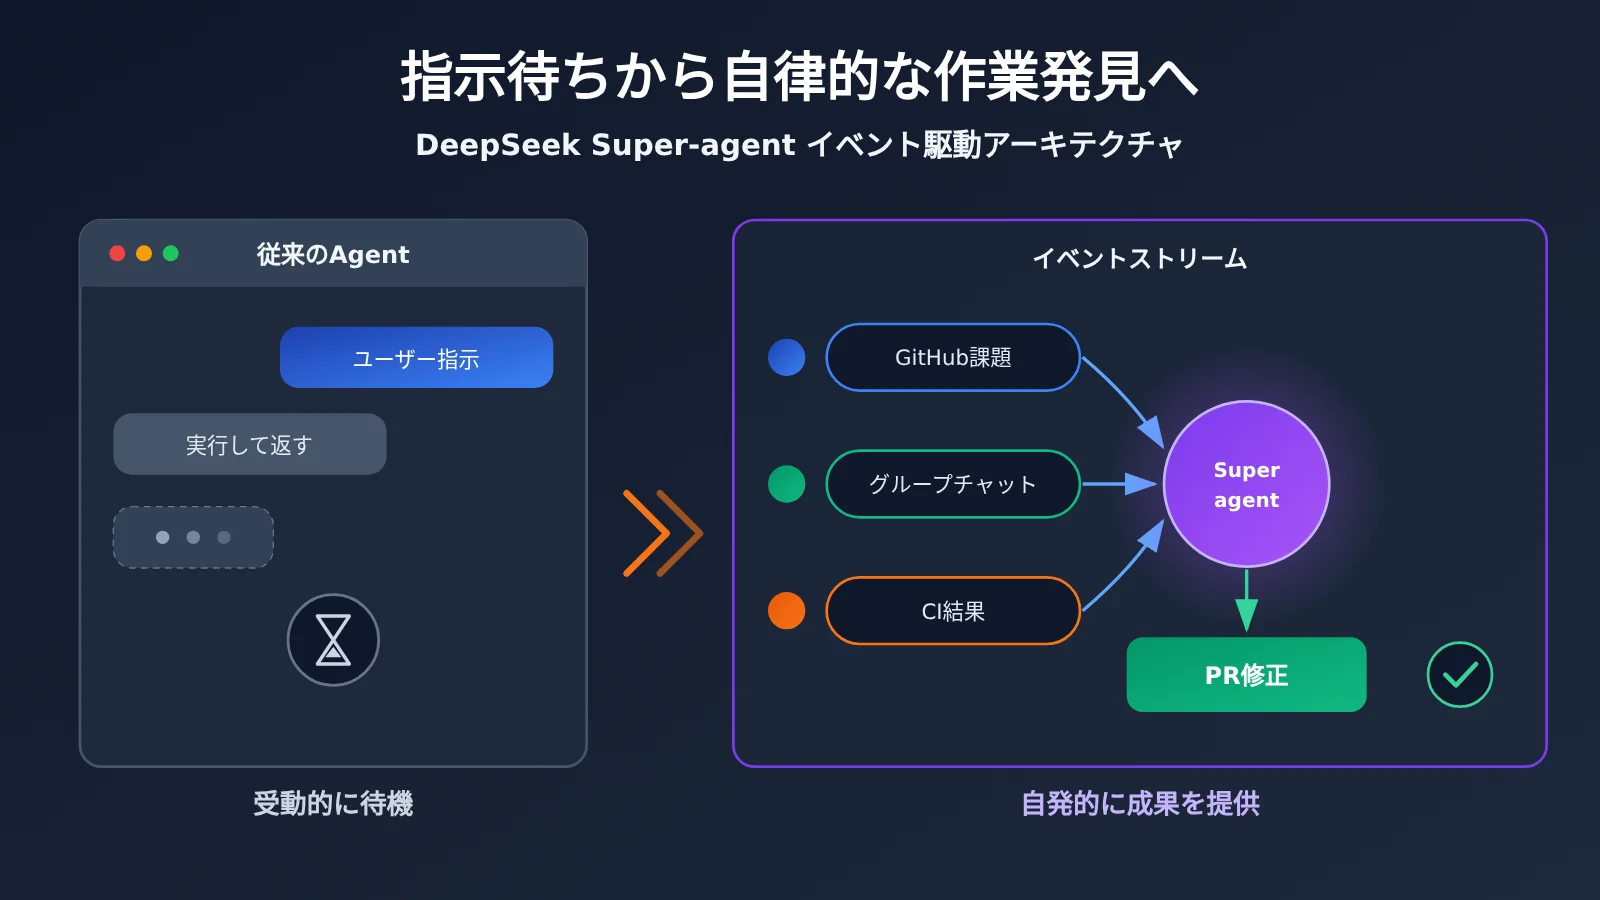
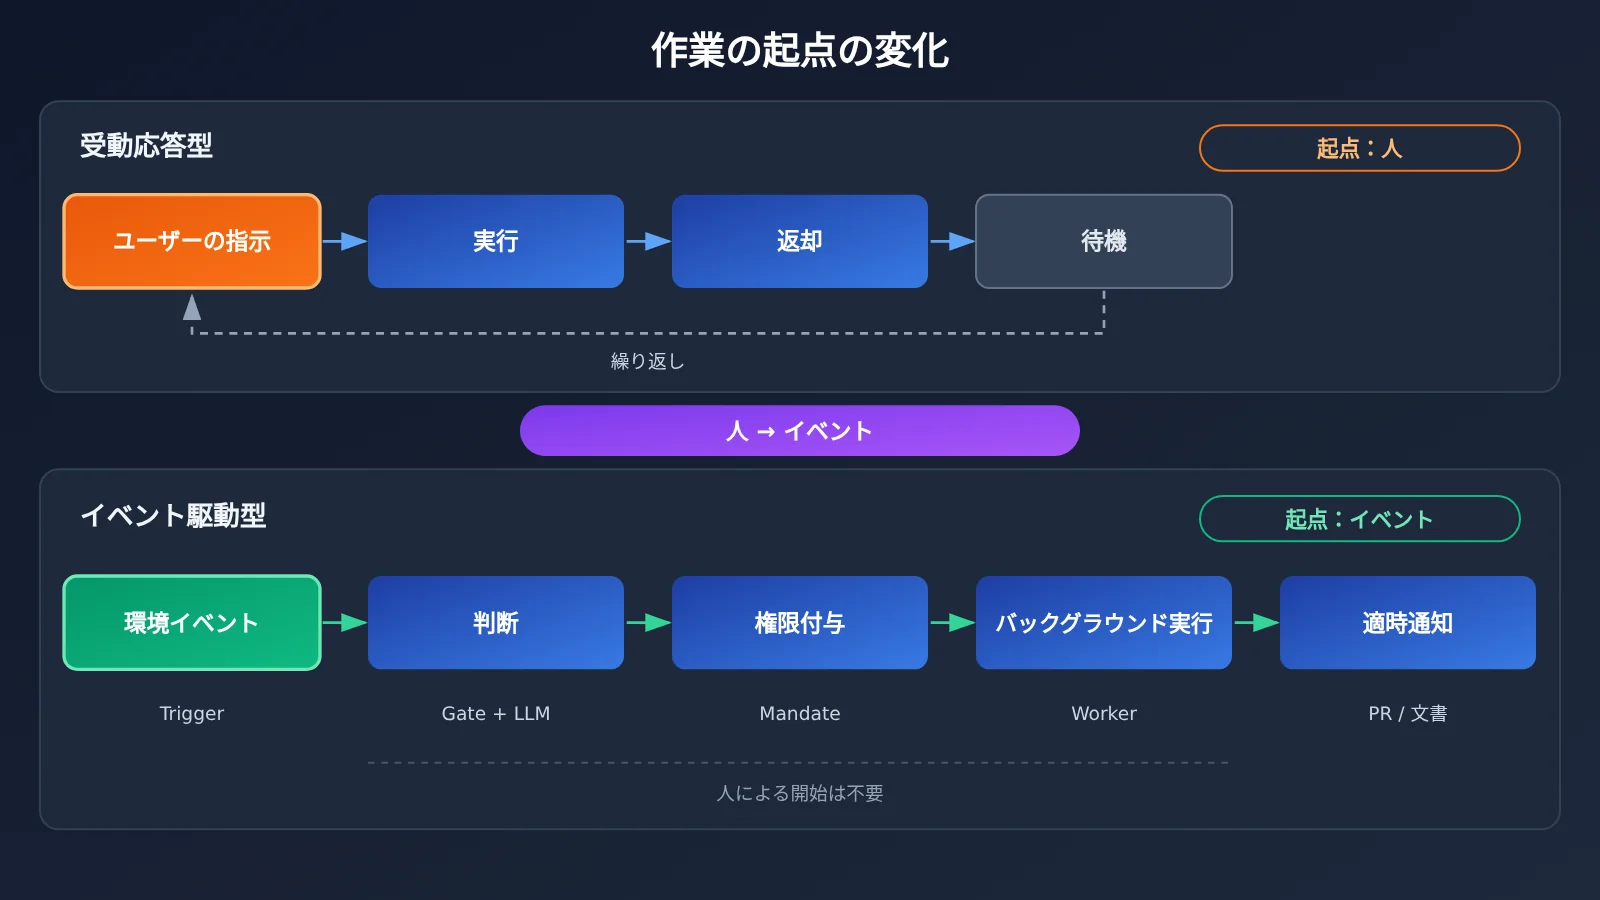
従来のチャット型 Agent は、ユーザーが指示を出し、Agent が実行して結果を返し、次の指示を待つという流れで動きます。Agent がどれほど賢くても、仕事の起点は常にユーザーが始める会話です。ユーザー自身が問題を見つけ、内容を明確に伝え、結果を確認することも忘れないようにしなければなりません。
DeepSeek Super-agent は、この流れを逆転させます。システムが環境からのイベントを継続的に受け取り、対応すべき仕事があるかを判断。権限の範囲内でタスクを作成し、バックグラウンドで実行したうえで、適切なタイミングで人に通知します。つまり、仕事の環境そのものが Agent の入力源となり、チャット画面は唯一の入り口ではなくなります。
| 比較項目 | 受動応答型 Agent | イベント駆動型 Super-agent |
|---|---|---|
| 仕事の起点 | ユーザーが会話を始める | 外部環境のイベント(Trigger) |
| タスクの発見 | 人が問題を見つけて説明する | システムがタスクの手がかりを識別し、人が権限付与と成果物の確認を担当する |
| 実行方法 | 通常は同期的に実行し、結果を待つ | バックグラウンドで非同期に実行し、先回りして準備できる |
| 成果物の提供方法 | 会話の中で段階的に出力する | 簡潔な通知や構造化された成果物(PR、ドキュメント)を届ける |
| 制御方法 | 各ステップでユーザーの指示に依存する | タスクの受け付けモード、Mandate の権限範囲、承認ルールで制御する |
| 主なリスク | 人による管理の負担が大きい | 誤検知、大量のタスク発生、権限逸脱、インジェクション攻撃 |
Super-agent における Trigger の役割
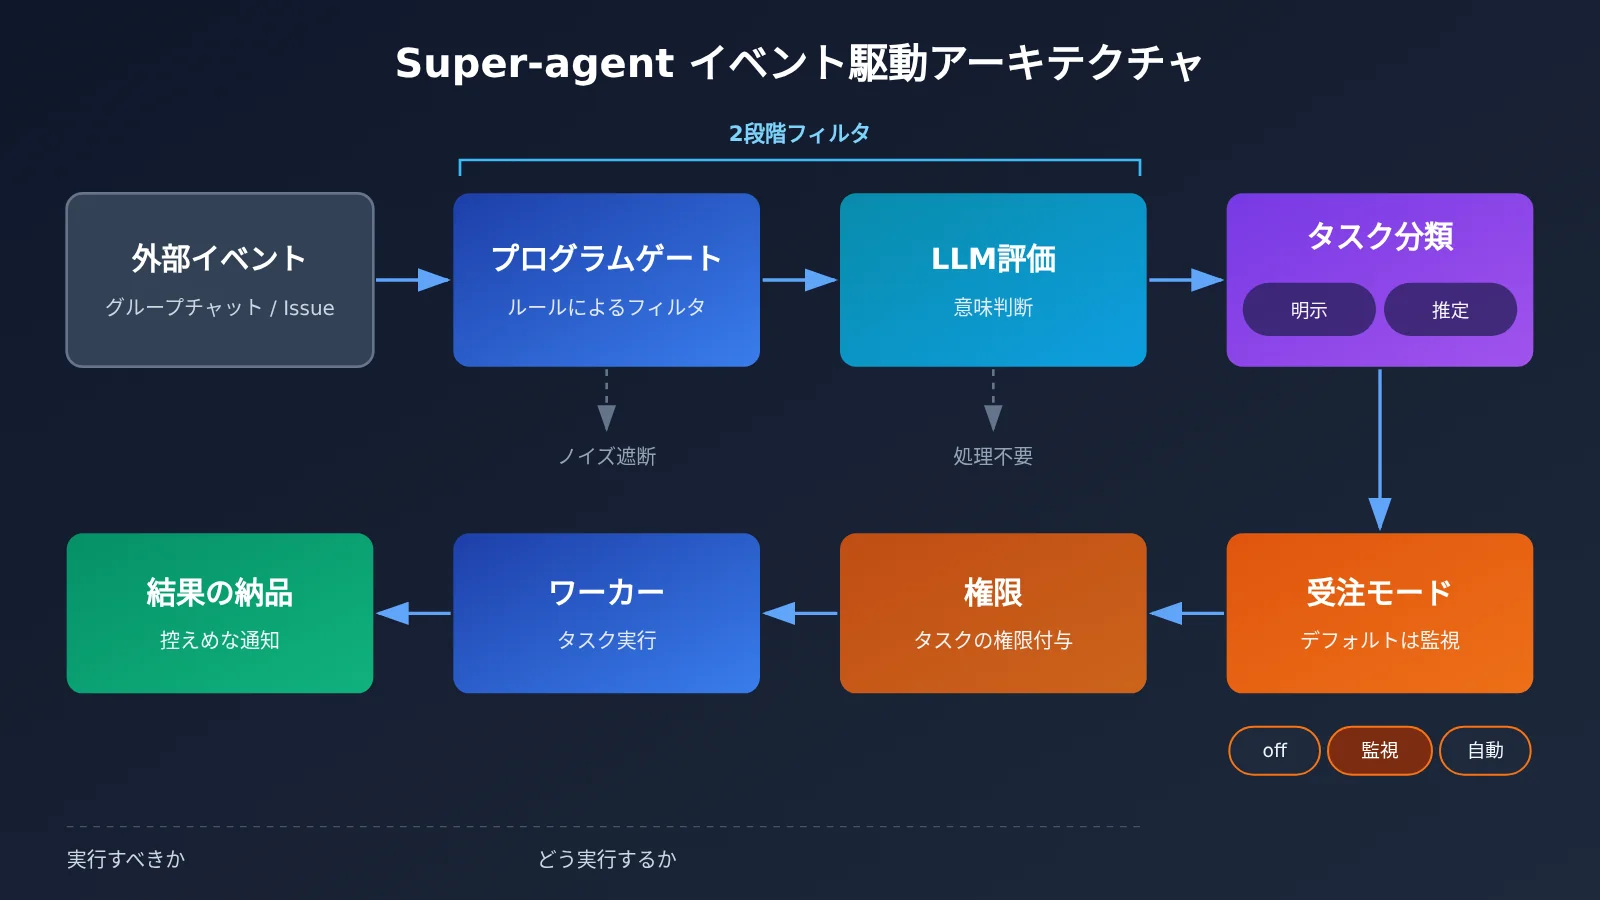
DeepSeek は、外部環境で発生するイベントを総称して Trigger と呼んでいます。グループチャットのメッセージ、新しい Issue、CI ビルドの失敗など、いずれも Trigger になり得ます。重要なのは、Trigger はあくまで「手がかり」であり、「タスク」そのものではないという点です。実際に行動するかどうかは、その後のフィルタリング、評価、権限付与の過程で決まります。
Super-agent はイベントをどうフィルタリングするか:プログラム Gate と LLM Assessment
実際の仕事環境には、大量のノイズがあります。開発者のグループでは、毎日たくさんの雑談や絵文字、重複メッセージが飛び交います。そのすべてを大規模言語モデルに判断させると、トークン費用も応答遅延も急速に増えてしまいます。DeepSeek は、これを2段階のフィルタリングで解決しています。まず低コストの決定的なルールで無関係なイベントの大半を除外し、少数の候補イベントだけをモデルに渡して意味的に判断させます。
| フィルタリング層 | 判断基準 | 大規模言語モデルの呼び出し | 主な役割 |
|---|---|---|---|
| 第1段階:プログラム Gate | イベントの発生元、許可されたユーザーかどうか、監視対象のグループやリポジトリに属するかどうか、Agent への明示的な言及があるかどうか、設定されたイベントの範囲内かどうか | できる限り呼び出さない | 無関係なイベントや権限のないイベントを低コストで遮断する |
| 第2段階:LLM Assessment | 候補イベントの意味内容とコンテキスト | 呼び出す | 障害の兆候など、対応すべき仕事にあたるかどうかを判断する |
「Safari でログインページがまた開かなくなった」を例に考えてみましょう。この発言が権限のあるプロジェクトの議論スレッドから届いた場合、モデルは障害の兆候として認識するかもしれません。一方、単なる無関係な雑談であれば、システムは何も対応しない可能性があります。この2段階の構造は、低コストのルールと高コストの意味理解を組み合わせるものであり、イベント駆動型 Agent のコストを抑えるうえで重要です。
上図の意味的な判断とタスク実行の両方の層は、モデル API に依存しています。開発者が同様のアーキテクチャを再現する際は、APIYI apiyi.com のような OpenAI 互換インターフェースを通じて異なるモデルに統一的に接続すると、層ごとの設定や比較がしやすくなります。
Explicit と Inferred:明示的なリクエストと推論されたタスクの違い
DeepSeek の公式認可ドキュメントでは、タスクを2種類に分けています。Explicit は明示的に認可されたリクエストです。例えば、認可済みの開発者が Issue で Agent にバグの修正を直接依頼するケースが該当します。Inferred は推論されたタスクです。例えば、議論の中で「最近、ビルドが時々失敗する」と言及された場合、正式な修正依頼はなくても、システムが調査に値する手がかりだと判断するケースです。
最も重要なのは、タスクを推論したからといって、実行が許可されるわけではないという点です。Inferred タスクも、組織の受け入れルール、実行範囲、承認要件に従う必要があります。この区別によって、「能動的な発見」が「無断での行動」に変わることを防げます。
Super-agent の3つのタスク受け付けモード:off、observe、auto
オープンソースの認可ドキュメントでは、推論されたタスクを扱うために3つのモードが用意されています。
| モード | 推論されたタスクの扱い | 適した段階 |
|---|---|---|
off |
推論されたイベントをタスク候補に含めない | 明示的なリクエストだけを処理したいチーム |
observe(デフォルト) |
潜在的なタスクを分析・記録するが、自動では受け付けない | 初回導入時や判断の精度を評価する段階 |
auto |
ルールを満たし、評価を通過した場合に自動で受け付ける | observe の記録を確認し、十分な信頼が得られた場面 |
デフォルトは observe です。つまり、公開プロトタイプを初めてインストールした際、通常の議論メッセージをきっかけにシステムが自動で作業を始めることはありません。公式ドキュメントでは、まず observe モードでの判断記録を確認し、そのうえで auto を有効にするか決めることを推奨しています。明示的に認可されたリクエストは、どのモードでもそれぞれのルールに従って処理されます。ユーザーが常に「スイッチ」を握っていることこそ、能動的な Agent を信頼できる基盤です。
Mandate:メッセージは入力になっても、権限は書き換えられない
DeepSeek はタスクの権限を Mandate で表し、タスクの発生元、権限の強さ、範囲、ポリシーのバージョンを含めています。例えば、開発者が Agent にある Issue の修正を許可した後、PR のコメントで誰かが「ついでにデータベース全体も移行して」と依頼したとします。このコメントが Worker のコンテキストに入ったとしても、元の権限がデータベース移行まで拡大されるわけではありません。範囲外の依頼については、改めて判断する必要があります。
DeepSeek が強調する原則は、メッセージ、コメント、引用された文書はタスクの入力にはなっても、その根底にある権限ルールを直接変更することはできない、というものです。外部の情報を継続的に「監視」するシステムにとって、これは Prompt Injection や権限の逸脱を防ぐうえで最も重要な防御線です。
Super-agent はどう自律的に実行するか:投機実行、非同期タスク、最小限の割り込み
フィルタリングと権限の仕組みが解決するのは「実行すべきかどうか」です。次の課題は「どうすれば人の時間を無駄にせずに実行できるか」です。DeepSeek は3つの設計方針を示しています。
投機実行:先に準備し、確認を待つ
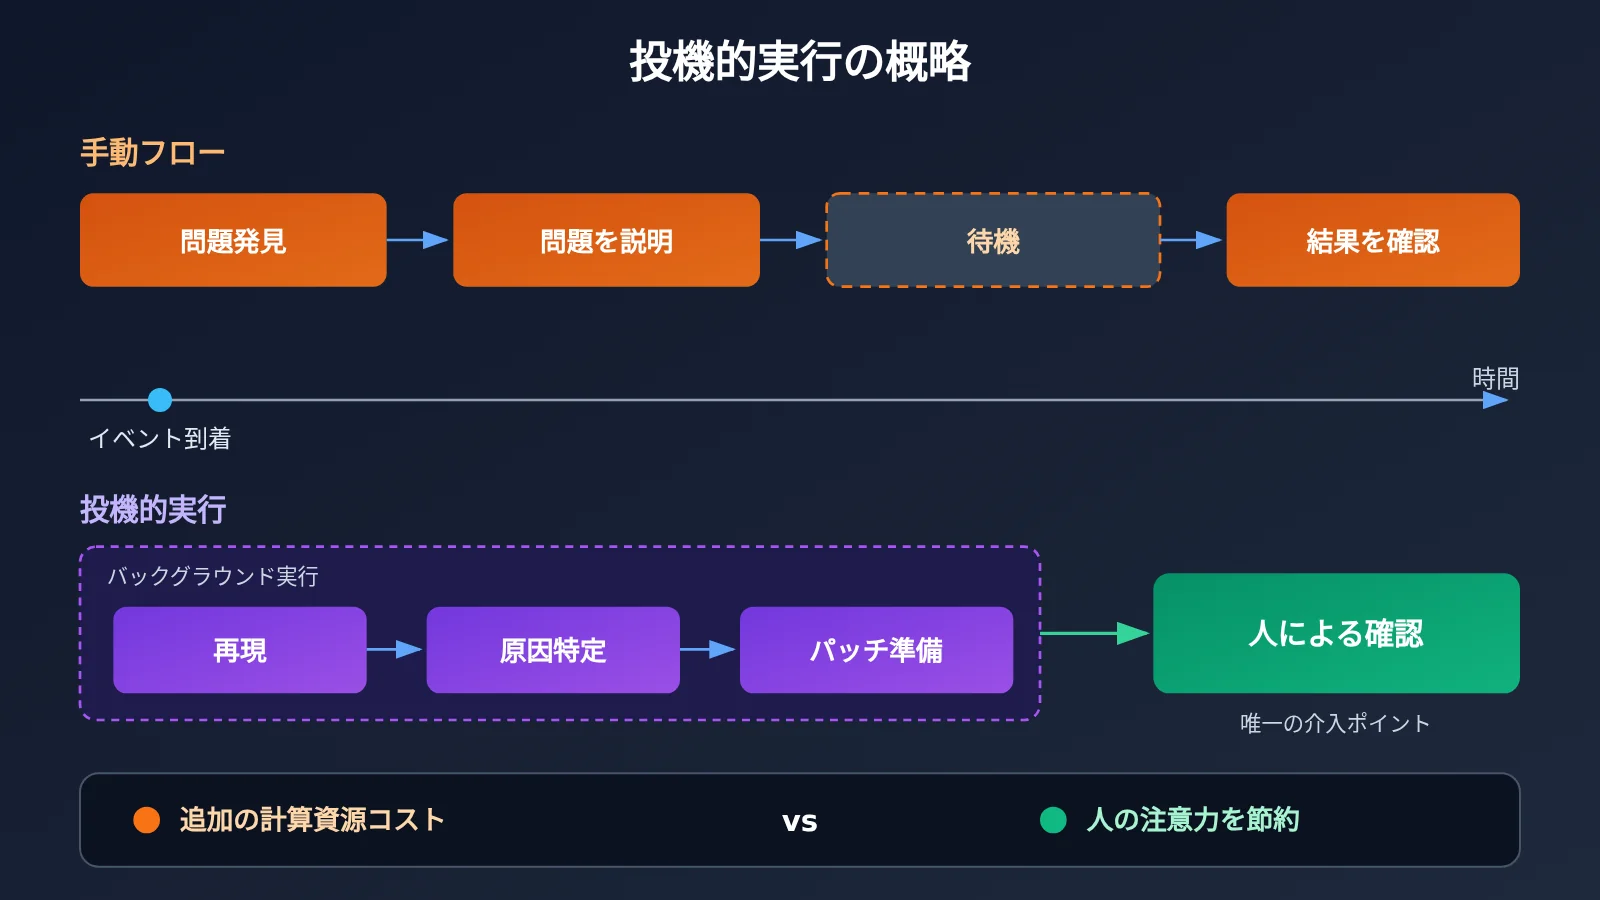
DeepSeek は、コンピューターアーキテクチャにおける Speculative Execution(投機実行)の概念を取り入れています。結果が採用されるかどうか不確かな段階で、リスクの低い準備作業を先に進めるという考え方です。
- パーソナルアシスタントの例:会議への招待を受けたら、Agent は先にスケジュールを確認し、会議の背景を調べ、時間の重複を判断して返信の下書きを作成できます。ただし、実際にメールを送信するには、ユーザーの確認が必要な場合があります。
- 開発の例:チームが Bug について議論している間に、Agent はログの確認、再現の試行、該当コードの特定、パッチ候補の準備を進め、権限ルールを満たしたうえで結果を提出できます。
この仕組みには、最終的に採用されない作業に計算リソースを費やす可能性があります。DeepSeek の判断では、人の待ち時間や操作の手間を削減できる効果が、追加の計算コストを上回る場合に、投機実行に価値があります。これはエンジニアリング上のトレードオフであり、すべてのタスクを先回りして実行する価値があるわけではありません。
非同期 ReAct Loop:バックグラウンドタスクで対話を止めない
従来の同期実行では、Agent が時間のかかるコマンドを実行すると、ツールの結果が返るまで新しいメッセージを処理できません。DeepSeek が提案する非同期設計では、タスクの開始後すぐに Started 状態が返され、バックグラウンドでの実行はその後の対話を妨げません。実行結果は新しいイベントとしてシステムに戻ります。ユーザーはタスクの実行中に別の質問ができ、システムも不要になったバックグラウンド作業を停止できます。
ここで注意したいのは、その適用範囲です。公式によると、この非同期タスクの仕組みは DeepSeek Harness に実装済みですが、デフォルトでは有効になっていません。公開されているプロトタイプには独自のバックグラウンド Worker の仕組みがありますが、構想されている非同期アーキテクチャ全体をデフォルト機能と見なすことはできません。
最小限の割り込み:自律性は存在感とは違う
DeepSeek のプロダクト哲学をまとめた文書では、人の注意力の消費をできる限り抑えながら、できるだけ多くの実用的な価値を生み出すことを目指しています。具体的には、ツール呼び出しの各ステップを逐一報告せず、グループチャットを通知で埋め尽くさず、途中の思考をすべて公開しません。判断や受け入れ確認が必要なときに優先して連絡し、価値の限られるメッセージは控えます。
出力先によって形式も使い分けます。インスタントメッセージでは簡潔に通知し、GitHub、メール、文書では問題の背景、変更内容、検証結果を含む構造化された成果物を届けます。プロダクトの観点では、自律性と通知頻度は別の指標です。頻繁に報告する Agent が、必ずしも役に立つ Agent とは限りません。
Super-agent の実例:内部事例とコミュニティテスト
新しいアーキテクチャを評価するには、「可能性」と「現状」を分けて考える必要があります。現在得られている証拠は大きく2種類あり、それぞれ信頼性と意味合いが異なります。
DeepSeek の内部事例は、アーキテクチャの可能性を示しています。DeepSeek Harness の内部グループチャットで問題が報告されると、エージェントはメッセージを受け取り、調査に値するかを判断したうえで、バックグラウンドで再現を試み、修正方法を検討します。問題を確認でき、簡単な修正方法が見つかれば PR を準備または提出します。価値のある結果が得られなければ、チームの手を煩わせません。これは公式が公開した内部での運用方法であり、公開プロトタイプのデフォルト設定を第三者が独立して検証したものではありません。
GitHub コミュニティのテストは、プロトタイプの現状を示しています。2026 年 11 月 1 日、あるユーザーは Ubuntu 環境で SETUP.md に従ってオープンソースのプロトタイプをデプロイし、Issue のリクエストを処理フローに投入して、最終的に Pull Request の作成まで成功したと報告しました。一方で、GitHub の通知が届かない、システムの状態は正常と表示されているのに作業リクエストを受信できない、Source の Issue とコメントの監視設定を調整する必要がある、システム言語や GitHub アカウントの設定によって互換性の問題が生じる、といった事象にも遭遇しています。
この報告は、「イベントからタスクへ」という処理フローが実際に動作することを示しています。しかし、それだけで、このプロジェクトがバグを24時間確実に自動発見できるようになったとは言えません。PR を生成できることも、変更が人間によるレビューを通過してマージされたことを意味するわけではありません。
モデル API でイベント駆動型 Agent の判断レイヤーを構築する
Super-agent の考え方を取り入れるなら、「プログラムによる Gate + LLM Assessment」のレイヤーが最も実装しやすいでしょう。以下の例はイベントの判断ロジックのみを示すもので、Super-agent の公式実装でも、完全な Agent 製品でもありません。
最小限の例
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI 互換インターフェース
)

event = "登录页面在 Safari 上又打不开了"
resp = client.chat.completions.create(
    model="gpt-4o-mini",  # モデル名はプラットフォームのモデル一覧を参照
    messages=[{"role": "user", "content": f"判断以下消息是否为故障线索,只回答 yes 或 no:{event}"}]
)
print(resp.choices[0].message.content)
完全な実装コードを見る(Gate + Assessment + タスク受付モード)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# プログラム層の Gate 設定:確定的なルールで、LLM は呼び出さない
ALLOWED_SOURCES = {"github", "feishu"}
ALLOWED_USERS = {"alice", "bob"}
WATCHED_CHANNELS = {"repo/web-frontend", "group/dev-team"}
MODE = "observe"  # off / observe / auto

def gate(event: dict) -> bool:
    """第1段階:低コストのルールによるフィルタリング"""
    return (
        event["source"] in ALLOWED_SOURCES
        and event["user"] in ALLOWED_USERS
        and event["channel"] in WATCHED_CHANNELS
    )

def assess(event: dict) -> dict:
    """第2段階:モデルによる意味の判断。explicit と inferred を区別する"""
    prompt = (
        "你是事件分类器。请判断消息是否包含值得处理的工作,"
        "并区分 explicit(明确请求)或 inferred(推断任务)。"
        '仅输出 JSON:{"actionable": bool, "kind": "explicit|inferred|none", "reason": "..."}\n'
        f"消息:{event['text']}"
    )
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
        max_tokens=200
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return {"actionable": False, "kind": "none", "reason": "parse_error"}

def handle(event: dict) -> str:
    if not gate(event):
        return "dropped_by_gate"
    result = assess(event)
    if not result["actionable"]:
        return "ignored"
    if result["kind"] == "explicit":
        return "create_task_with_mandate"   # 権限の範囲は別途確認が必要
    # 推定されたタスクは受付モードに従って処理する
    if MODE == "off":
        return "ignored"
    if MODE == "observe":
        return f"logged_for_review: {result['reason']}"
    return "auto_accept_if_policy_allows"

print(handle({
    "source": "feishu", "user": "alice",
    "channel": "group/dev-team",
    "text": "最近构建有时会失败"
}))
🚀 まずは試してみましょう:イベント判断レイヤーを検証する際は、APIYI(apiyi.com)で無料テスト枠を取得し、同じコードで異なるモデルを切り替えて分類精度とトークン消費量を比較できます。その結果を踏まえて、各レイヤーで使うモデルを決めるとよいでしょう。
階層型モデルスケジューリングの考え方
Super-agent の構造は、外部イベント → プログラムによるフィルタリング → モデルによる意味判断 → 権限判断 → Agent の実行 → 結果の納品、とまとめられます。各層で同じモデルを使う必要はありません。
| 層 | タスクの性質 | モデル選択の考え方 |
|---|---|---|
| プログラム Gate | 発信元、ユーザー、範囲の照合 | LLM を使用しない |
| イベント分類 | 高頻度、短文、構造化出力 | 低コスト・低遅延のモデルを検討 |
| 複雑な実行 | コードの再現、修正、長いコンテキストでの推論 | より高性能なモデル |
| 結果の要約と通知 | 要約、構造化された成果の納品 | 独立して設定可能 |
💡 選択のポイント:階層型スケジューリングで本当にコストを削減できるかは、実際のログと業務テストで検証する必要があります。複数モデルのオーケストレーションが必ずコスト削減につながるとは限りません。APIYI apiyi.com の統一インターフェースを使えば、業務コードを変更せずに各層のモデルを素早く切り替え、A/B 比較ができます。
Super-agent のイベント駆動アーキテクチャがもたらす影響
研究開発・自動化の開発者への影響
- 入口がチャット画面からワークフローへ:Issue、PR コメント、CI の結果、グループチャットのメッセージが Agent の自然な入力となります。開発者には、プロンプトを書くだけでなく、イベントの取り込みとフィルタリングの設計が求められます。
- 権限設計が中核的なスキルに:Explicit/Inferred の区別、タスクの受注モード、Mandate の範囲によって、Agent が実際のチームに受け入れられるかどうかが決まります。
- 評価方法の見直しが必要:能動的な Agent を評価する際は、「実行したアクションの数」だけでなく、タスク発見の質、手戻りの割合、価値のない通知の数も重視する必要があります。
企業の AI アプリケーションチームへの影響
能動的な Agent は、開発での協業、トラブルシューティング、企業の業務プロセス自動化など、さまざまな用途が考えられます。一方で、コスト構造は変化します。イベント評価では継続的にトークンを消費し、先行実行した作業が採用されないこともあります。複雑なタスクには人間によるレビューも必要です。以下は公式アーキテクチャを基に整理した評価フレームワークであり、DeepSeek が公表した正式な性能指標ではありません。
| 評価の観点 | 注目したい指標 |
|---|---|
| タスク発見の質 | 有価値なイベントの識別率、誤作動率、タスクの重複率 |
| 実行品質 | タスク完了率、人間による手戻りの割合、成果物のレビュー通過率 |
| ユーザー体験 | 有効なタスクごとの人間の介入回数、価値のない通知の数、問題発生から検収可能な成果が得られるまでの時間 |
| 運用コスト | イベント評価あたりのトークン消費量、成功したタスクあたりのモデル利用料金、採用されなかった先行実行タスクのコスト |
| セキュリティガバナンス | 未承認タスクのブロック率、重要なポイントでの承認が機能しているか、機密情報の扱いが権限の範囲内か |
直視すべきリスク
能動的な Agent には、誤作動、タスクの大量発生、権限逸脱、プロンプトインジェクション、リソースの浪費、情報漏洩といったリスクがあります。DeepSeek も技術記事の中で、複雑な組織内におけるコンテキストの分離、長期記憶、安全な通信、プライバシーの問題は、依然として解決が必要だと認めています。プライベートリポジトリやローカルの認証情報にアクセスできる Agent では、機密情報がモデルのコンテキストや外部のチャネルに流出するのを防ぐため、デプロイ前から対策を設計に組み込む必要があります。
よくある質問 FAQ
Q1:DeepSeek Super-agent のイベント駆動アーキテクチャとは何ですか?
Agent が外部環境のイベント(Trigger)を継続的に受け取り、プログラムによるフィルタリングとモデルによる判断を経て、許可された範囲内でタスクを作成し、バックグラウンドで実行して、適切なタイミングで人間に通知するアーキテクチャです。作業の起点は「ユーザーの指示」から「環境のイベント」に変わりますが、権限の付与や承認は引き続き人間が管理します。
Q2:タスクを能動的に推論すると、ユーザーは制御できなくなりますか?
いいえ。推論されたタスク(Inferred)は、受け付けルール、実行範囲、承認要件に従う必要があります。公開プロトタイプではデフォルトで `observe` モードが使われ、潜在的なタスクを記録するだけで、自動的には受け付けません。ユーザーは `off` を選んで推論タスクを完全に無効にすることも、記録を確認してから `auto` を有効にすることもできます。また、Mandate の仕組みにより、コメントなどのメッセージによって許可範囲が直接拡大されることはありません。
Q3:オープンソースのプロトタイプは現在どこまで対応していますか?
公開プロトタイプは主に GitHub と、オプションの飛書連携をサポートしており、3種類のタスク受け付けモードと Mandate による権限付与の仕組みを備えています。コミュニティでは Issue から PR までの一連の処理に成功した報告がありますが、デプロイ時には通知が届かない、設定の互換性に問題があるといった課題もあります。メールやカレンダーなどのイベントソースや、デフォルトで有効になる完全な非同期アーキテクチャは、現時点ではより広範な構想または内部実装にとどまっています。
Q4:能動的な Agent のトークンコストはどう抑えますか?
鍵となるのは2段階のフィルタリングです。まず、LLM を呼び出さないプログラムの Gate で無関係なイベントの大半を除外し、少数の候補だけをモデルに判断させます。次に、先行実行は慎重に使い、効果が明らかなタスクだけを事前に準備します。実際の開発では、APIYI apiyi.com の利用量統計を通じて、イベント1件あたりの評価コストと、成功したタスク1件あたりのモデル費用を確認し、フィルタリングルールやモデル設定を調整できます。
Q5:モデル API を使って同様のイベント判断レイヤーを構築するには?
本記事のサンプルを参考にできます。プログラムの Gate がルールに基づくフィルタリングを担当し、LLM Assessment が構造化された判断結果を出力した後、タスク受け付けモードに応じて推論タスクを処理します。モデル呼び出しには OpenAI 互換インターフェースを使用できます。APIYI apiyi.com に登録して APIキーとテスト用クレジットを取得し、サンプルの base_url を本記事に記載されたアドレスのままにすれば実行できます。なお、これはアーキテクチャの考え方を参考にしたものであり、APIYI が提供するのはモデル API の機能であって、完成済みの Super-agent サービスではありません。
Q6:Super-agent には現在どのような既知の制限がありますか?
主な制限として、公開プロトタイプで利用できるイベントソースが限られていること、デプロイ設定に互換性の問題があることが挙げられます。また、内部での「サイレント修正」の事例は第三者による独立した検証がまだ行われていません。「バックグラウンドで動作する」ことは、24時間365日の安定稼働を保証するものではなく、生成された PR にも人間によるレビューが必要です。組織内のコンテキストの分離、長期記憶、プライバシーについても、公式は未解決の課題があるとしています。
DeepSeek Super-agent の重要ポイント Key Takeaways
- 中心となる変化:Agent の仕事の起点がユーザーの指示から環境内のイベントへと移り、チャット画面だけが入口ではなくなります。
- 2段階のフィルタリング:プログラムの Gate が低コストでノイズを除外し、LLM Assessment が意味を判断することで、コストと精度を両立します。
- 権限を優先:Explicit と Inferred を分けて扱い、デフォルトを
observeとするほか、Mandate によってメッセージによる権限の書き換えを防ぎます。 - 能動的な実行:投機的実行と非同期タスクで人の待ち時間を減らしますが、計算コストと実際のメリットを比較する必要があります。
- 邪魔にならない成果の届け方:判断や検収が必要なときだけ連絡します。能動的であることは、通知を増やすことではありません。
- 現状は慎重に評価:社内事例は可能性を示しており、オープンソースのプロトタイプでも Issue → PR の一連の流れが動作していますが、成熟度はまだ限定的です。
- 取り入れ方:まずはモデル API でイベント判断層を構築し、APIYI apiyi.com を通じてモデルごとの分類精度とコストを比較できます。
まとめ
DeepSeek Super-agent のイベント駆動アーキテクチャが答えようとしているのは、「AI は自分で判断できるか」ではなく、「Agent がルールと権限の範囲内で、どうすれば能動的に仕事を引き受けられるか」という問いです。主要な仕組みは、次の3点にまとめられます。
- 検知とフィルタリング:Trigger によって作業環境を入力源にし、2段階のフィルタリングでノイズとトークンコストを抑えます。
- 権限と制御:Explicit/Inferred の区別、3種類の受任モード、Mandate の範囲によって、能動的な行動が権限逸脱につながるのを防ぎます。
- 実行と成果の提供:投機的実行、非同期タスク、邪魔にならない通知によって、人の役割を「タスクの管理」から「判断と検収」へと移します。
能動的な Agent の価値は、実行したアクションの数ではなく、人による管理作業をどれだけ減らし、信頼できる成果をどれだけ届けたかにあります。現在のオープンソースプロトタイプはまだ初期段階にあるため、まずは observe モードで判断記録を蓄積し、少しずつ信頼を築いていくのがよいでしょう。同様のイベント判断・タスク実行の仕組みを設計しているなら、APIYI apiyi.com を通じて各層におけるモデルの性能をすばやく検証し、実際の業務データに基づいて選択することをおすすめします。
📚 参考資料
- DeepSeek Super-agent アーキテクチャ研究:イベント駆動型とプロアクティブな Agent 設計の解説
- リンク:
blog2.eimoon.com/p/deepseek-super-agent-design/ -
内容:Trigger、投機的実行、非同期タスク、社内事例を網羅
-
DeepSeek 認可メカニズムのドキュメント:Explicit/Inferred、受注モード、Mandate
- リンク:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
内容:
off、observe、autoの3つのモードを理解するための公式資料 -
DeepSeek のプロダクト設計哲学:邪魔を最小限に抑える設計と注意力に関する原則
- リンク:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/000-philosophy.md -
内容:プロアクティブな Agent が頻繁に存在をアピールすべきでない理由を解説
-
DeepSeek Domain Model:主要なドメイン概念の定義
- リンク:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
内容:タスク、Worker、イベントの関係を深く理解するのに役立つ資料
-
DeepSeek Setup デプロイ手順:オープンソースプロトタイプのインストールガイド
- リンク:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/SETUP.md -
内容:実際にデプロイする前に必ず読んでおきたいドキュメント
-
GitHub コミュニティの利用レポート:Issue → PR の実測とデプロイに関する問題
- リンク:
github.com/deepseek-ai/deepseek-harness/discussions/11706 - 内容:現在のプロトタイプの実際の稼働状況と限界を把握できる資料
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI のウェブサイトのトップページからお気軽にご連絡ください。モデル連携に関するその他の資料は、ドキュメントセンター docs.apiyi.com をご覧ください。