11月1日、DeepSeek HarnessチームがXで長文記事「スーパーエージェントの設計を探る」を公開し、スーパーエージェント(Super-agent)のアーキテクチャについて論じました。公開から約15時間で、記事は約130万回閲覧され、9.4Kのいいねを獲得しています。これはアーキテクチャの考え方を紹介する記事であり、製品機能の紹介ではありません。
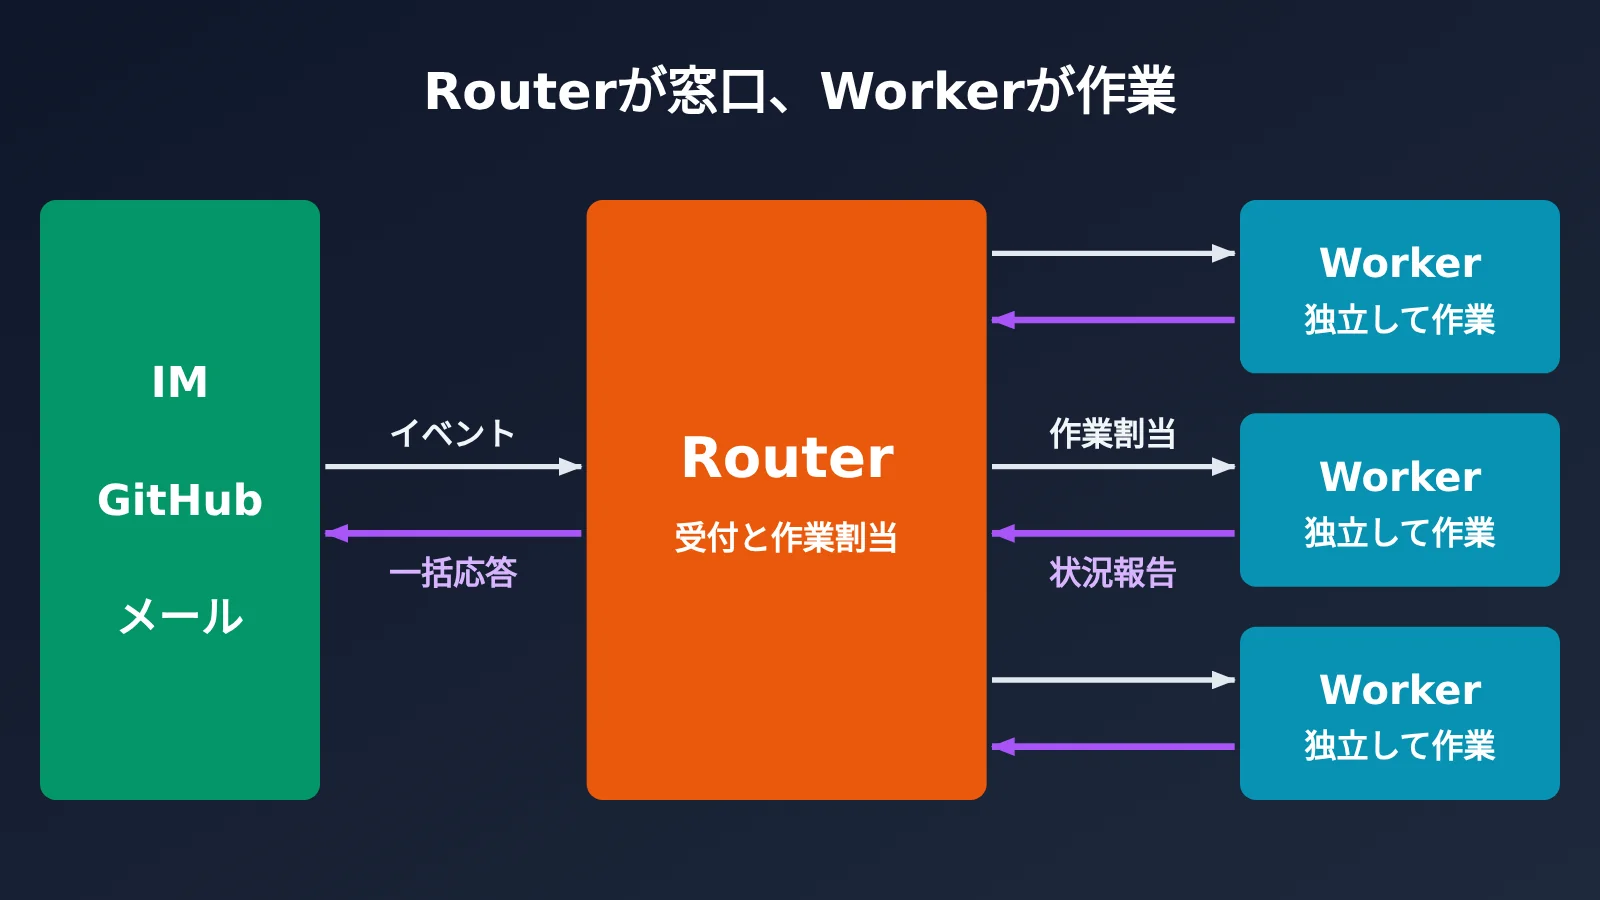
ひと言でまとめると: この設計では、システムが会話の管理を引き受け、ユーザーは一つの窓口だけを使います。Router(窓口での振り分け)が受付と仕事の割り当てを担当し、Worker(バックグラウンドで作業する会話)がタスクを並列実行します。人間は大局的な判断と最終承認に専念できます。
DeepSeekのスーパーエージェントはなぜ単一会話の枠を超えるのか
現在主流のエージェントは、依然として一つの会話を作業単位としています。ユーザーが複数のタスクを同時に進める場合、手動で会話を切り替え、それぞれの文脈を覚えておかなければなりません。DeepSeek Harnessチームの経験では、一人が同時に対応できるアクティブな会話は通常3〜5件です。この数字はチームの経験に基づくもので、一般的な統計ではありませんが、一つのボトルネックを示しています。単一タスクはモデルの能力に、複数タスクは人間の注意力に制約されるということです。
ローカルのエージェントにコマンドラインツールや外部コネクタを追加しても、外部メッセージを受け取れるようになるだけで、次の3つの制約は残ります。
- 同期処理によるブロック: 従来のReAct(考えながらツールを呼び出すループ)は、時間のかかる操作があると完了を待つため、その間は新しいメッセージに応答できません。
- コンテキストの混線: 異なるタスクの途中経過が同じウィンドウに混ざり、互いに干渉します。
- デバイスへの依存: ローカルデバイスがスリープしたりオフラインになったりすると、エージェントは動作を停止します。
そこで記事は、エージェントを手動で操作する個々の会話から切り離し、継続して動作する存在にすることを提案しています。これには以下の4つの特性を同時に備える必要があります。単一のReActループでは実現できず、それを支えるシステムアーキテクチャが必要です。
| スーパーエージェントの特性 | わかりやすく言うと | 主にどのモジュールで実現するか |
|---|---|---|
| 継続性 | IMやGitHubなど、どこでやり取りしても同じエージェントとして対応する | 二層アーキテクチャ、マルチチャネルでのやり取り |
| 効率性 | 前のコマンドが終わる前に新しい指示を受け、複数のタスクを並列実行する | 二層アーキテクチャ、全二重のやり取り |
| 自律性 | 環境のイベントを監視し、対応が必要なときに行動する | イベント駆動 |
| 永続性 | 常時オンラインで、異常が起きても自動復旧する | 計算資源と状態の分離、Watchdog |
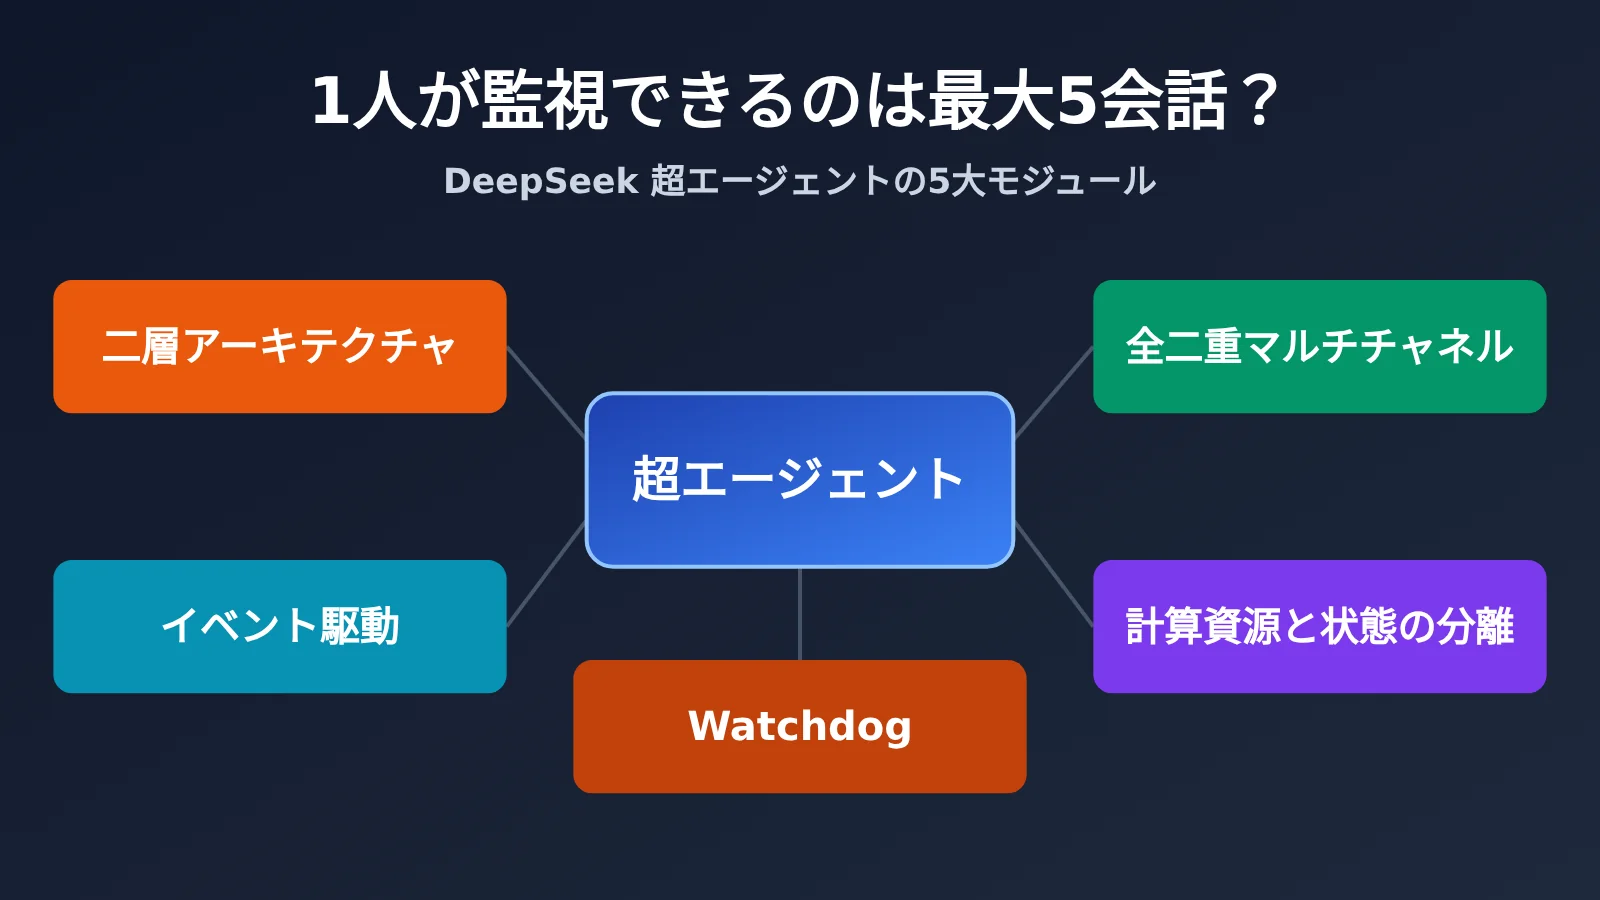
DeepSeekのスーパーエージェントを構成する5つのモジュール
まずは全体像を表で見てみましょう。特に注目したいのは「現在利用できるか」の列です。この記事で紹介するのは設計の方向性であり、すべてが既存の機能として使えるわけではありません。
| モジュール | 解決する課題 | 主な仕組み | 現在利用できるか |
|---|---|---|---|
| 二層アーキテクチャ | 継続性と並行処理の両立が難しい | Routerは対話とタスクの振り分けに専念し、Workerが隔離された環境で実行 | プロトタイプに近いフローはあるが、完全な設計は自分で構築する必要がある |
| イベント駆動 | エージェントが指示を待つしかなく、イベントのノイズも多い | コードで素早く選別し、モデルで詳しく判断。Threadの購読イベントは直接通す | プロトタイプはGitHubを監視可能。飛書(Feishu)も選択可能 |
| 全二重マルチチャネル | 長時間タスクが対話をブロックし、ログがユーザーの邪魔になる | ツールを非同期で呼び出し、チャネルごとに応答ルールを設定 | DeepSeek Harnessは非同期タスクを実装済みだが、デフォルトでは無効 |
| 計算資源・状態・環境の分離 | デバイスがオフラインになると停止し、ほかの環境にアクセスできない | クラウドでループを実行し、状態はデータベースに保存。エンドポイントは元の環境に残す | 外部向けに提供済みかは原文に記載がなく、自分で構築する必要がある |
| Watchdog | プロセスは動いていても、タスクが停滞したり、本来の目的からそれたりする | メインシステムの外にある独立したセッションで定期的に監視 | 外部向けに提供済みかは原文に記載がなく、自分で構築する必要がある |
モジュール1:DeepSeekスーパーエージェントのRouter/Worker二層アーキテクチャ
たとえるなら: Routerはレストランの受付。お客様を迎え、注文を厨房に伝えます。Workerは厨房の調理担当で、それぞれが一つの料理に専念します。
すべてのイベントを一つのセッションに集めると、コンテキストの連続性は保てますが、スループットは低くなります。一方、イベントごとに新しいセッションを開けば並列処理しやすくなるものの、全体のコンテキストが失われ、複数のセッションがそれぞれユーザーに返信するという混乱も生じます。二層アーキテクチャは、この二つの役割を分離します。常時稼働するRouterがユーザーとのやり取りと全体の調整を担当し、Bashツールをまったく持たない構成も可能です。Workerはそれぞれのコンテキストが分離され、一つのタスクだけを担当します。ユーザーには直接発言せず、状態をRouterに報告します。原文の趣旨は、セッションはシステム内部の実装の詳細にとどめ、ユーザーに意識させるべきではない、ということです。
Routerはボトルネックになりそうに見えますが、1回の推論中に届いたTrigger(環境内のイベント)はキューに入り、次の推論でまとめて処理されます。Routerへのリクエストは通常、入力が長く出力が短いのが特徴です。まとめられたイベントはPrefill(モデルが入力を処理する前半の段階)で並列に計算されるため、1リクエストの処理時間は、まとめるイベント数ほどには増えません。チームの経験では、Routerの仕事は思ったよりシンプルで、軽量モデルで十分なことが多いそうです。実装時には、まずAPIYI · apiyi.com経由で deepseek-v4.1-flash をRouterとして試し、タスクの振り分け精度を確認できます。
Workerはタスクの成果やコードの品質を直接左右するため、原文では通常、最も高性能なモデルを使うべきだとしています。APIYI · apiyi.comで同じタスク群を使って deepseek-v4-pro と claude-opus-5-5 を比較し、デフォルトモデルを決めることができます。
モジュール2:DeepSeek 超級インテリジェントエージェントのTriggerによるイベント駆動
たとえるなら: 守衛がまず名簿を見て来訪者を選別し、判断に迷う場合はマネージャーに確認します。既存の顧客からの続きの用件は、元の担当者に直接引き継ぎます。
Agentが自律的に動くには、主な入力を人間によるプロンプトから、グループチャットのメッセージ、CIの結果、コードレビューのコメントといった環境イベントに切り替える必要があります。実際のイベントストリームにはノイズが多く、すべてを大規模言語モデルに判断させると、遅延や計算リソースの負担が大きくなります。そこで、記事では2段階のフィルタリングを設計しています。
- Fast Path(コードによる高速選別): 発信元、グループ、ユーザー、ボットのホワイトリストに基づいて、決定的な条件でチェックします。発信元ごとに「明示的なリクエストにのみ応答する」「候補イベントとして扱う」「無視する」を設定できます。
- Slow Path(モデルによる詳細判断): 高速選別を通過した候補イベントだけをLLMに渡し、コンテキストとプロンプトで記述されたポリシーに基づいて、行動するかどうかを判断します。
ルーティングにも高速・低速の経路があります。同じPR、IMの話題、メールスレッドに属する連続したイベントは1つのThreadを構成します。WorkerがThreadを購読すると、以降のイベントはコードによって直接転送され、Routerが再び判断する必要はありません。複数のWorkerが同じThreadを購読している場合は、同じ通知を受け取り、それぞれが競合を発見して解決する機会を得られます。
コンテキストはキャッシュのように管理します。すぐに使う情報はウィンドウ内に直接配置し(Inline)、めったに使わない情報の全文はウィンドウ外に置いて、参照先や要約だけを残します(Spill)。記事では先回りして行動する方法にも触れています。バックグラウンドで先にカレンダーを確認したり、issueを再現したりして、役立つ結果だけを届け、残りは破棄します。追加の計算リソースを使うことで、人間の待ち時間や介入を減らす仕組みです。
モジュール3:DeepSeekスーパーエージェントの全二重・マルチチャネル対話
たとえば: お湯を沸かすとき、やかんのそばで待つ必要はありません。沸いたら知らせてくれるので、その間は別の人と話せます。
非同期ReActでは、時間のかかる呼び出しに start() と stop() を使います。start() はすぐに制御を返し、ツールはバックグラウンドで動作します。完了すると、結果が新しいイベントとしてセッションに返されます。処理が長引いた場合は、モデルが stop() でコマンドを終了することもできます。これにより、現在の推論ステップが終われば、ユーザーからの新しい入力を処理できます。原文では、DeepSeek Harnessにはこの非同期タスクの仕組みがすでに実装されているものの、デフォルトではまだ有効になっていないと明記されています。
マルチチャネルが解決するのは、「どう伝えるか」という問題です。IMでは簡潔に、相手の作業をなるべく中断しないようにし、判断や承認が必要なときだけ通知します。チームが検証した明確なルールとして、1回の返信は100語以内に収めます。一方、GitHubやメール、ドキュメントでは、PRに問題の背景、変更内容、検証結果を明記するなど、構造化された情報密度の高い出力が求められます。
モジュール4:DeepSeekスーパーエージェントの計算リソース・状態・環境の分離
たとえば: 資料を会社の書庫に保管しておけば、社員が席を移っても仕事を続けられます。また、特定の機械にあるツールが必要なら、その機械のところへ人を派遣して操作してもらえます。
記事では、2段階で構成要素を切り離しています。まず、エージェントのループをステートレスなクラウドコンテナ上で実行し、セッション状態をデータベースに保存します。これにより、コンテナを再起動・交換してもタスクを継続できます。次に、実行環境は元の場所に残し、各エンドポイントには軽量なデーモン(バックグラウンドで常駐する小さなプログラム)だけを置きます。デーモンはセッション状態を保持せず、コマンドの実行と結果の返却だけを担当します。
この設計は、BYOM(Bring Your Own Machine:自分のコンピューターをクラウド上のエージェントに接続する方式)にも対応しています。これにより、コミット前の変更やローカルの認証情報をすべてクラウドに同期する必要がありません。デバイスが再びオンラインになれば、クラウド上のエージェントはそのデバイスで実行する必要があるタスクを続行できます。Anthropicの “Decoupling the brain from the hands” でも同様の分離の考え方が採用されているので、あわせて読むと参考になります。
モジュール5:DeepSeek スーパーエージェントの Watchdog による外部監視
たとえるなら: 当番の管理者が実作業には加わらず、誰の作業が止まっているか、誰の作業が目的から外れているかを定期的に見回ります。
Agent の異常は、必ずしもクラッシュとは限りません。プロセスは動いていても、モデルが成果の出ないループに陥っていることがあり、従来の死活監視では検知できません。Watchdog はメインシステムの外で動く独立したセッションで、定期的なメッセージをきっかけに動作します。API エラーや状態の復元失敗といったインフラ障害に対処するほか、各 Worker の作業が実質的に進んでいるかをモデルで判断します。保守担当者は「なぜ失敗したのか」を自然言語で尋ねたり、システムの稼働中にプロンプトやトリガールールの調整を指示したりできます。
DeepSeek スーパーエージェントのプロトタイプはどこまで試せる?
関連リポジトリは github.com/deepseek-ai/dsh-superagent-prototype で、MIT ライセンスを採用しています。2026-11-02 の取得時点では、8,636 stars、863 forks でした。これは研究用プロトタイプであり、DeepSeek の公式製品ではありません。また、チームの内部バージョンや記事で説明されている完全な実装と同じものでもありません。記事中の設計の一部は今後の構想であり、プロトタイプには実装されていません。
プロトタイプは、単一の GitHub リポジトリを対象とする自律的なコーディング Agent で、DeepSeek Harness の bundle としてパッケージ化されています。GitHub を監視し、オプションで飛書にも接続できます。作業を依頼されると作業項目を作成し、専用のセッションとディレクトリで作業を完了した後、元の会話に戻って PR の提出などを報告します。人が対応する必要のある事項を表示する Web ダッシュボードもあります。
DeepSeek Super-agentの2つの実験データから何がわかるか
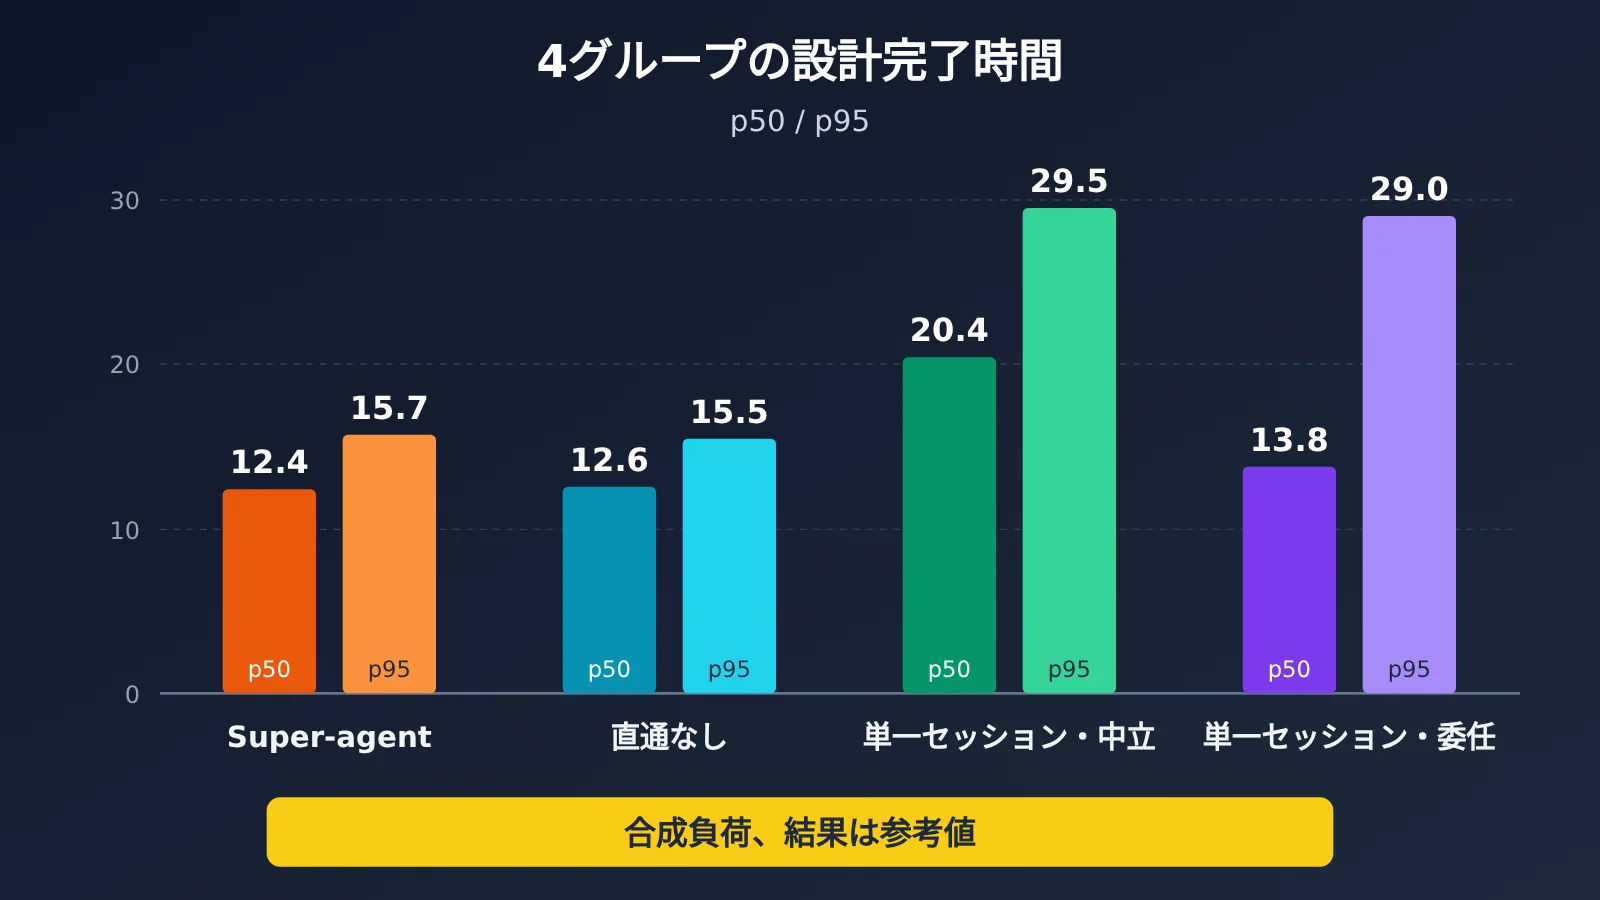
以下のデータはすべて公式記事で報告されたものです。実験には合成負荷と簡略化された環境が使われており、著者は結果を参考値と位置づけています。1つ目の実験では、1回の実行につき約300件のメッセージがあり、そのうち約20件が作業リクエストでした。各設計で5回ずつ実験を繰り返しています。コーディング作業は時間だけを消費するツールでシミュレートされているため、測定対象はスケジューリングと調整であり、タスクの実行品質ではありません。
表のp50は半数のタスクがその時間内に完了したことを、p95は95%のタスクがその時間内に完了したことを示します。cache-read tokensは、キャッシュ読み取り(キャッシュ済みのコンテキストを再処理せずに直接再利用すること)に使われたトークン数で、ここでは全セッションの合計です。
| 設計 | p50(分) | p95(分) | cache-read tokens / 回 |
|---|---|---|---|
| Super-agent | 12.4 | 15.7 | 23.2M |
| Pass-through(サブスクリプションの直接転送)なし | 12.6 | 15.5 | 31.8M |
| 単一セッション + サブAgent(中立的なプロンプト) | 20.4 | 29.5 | 6.1M |
| 単一セッション + サブAgent(委譲を優先するプロンプト) | 13.8 | 29.0 | 10.8M |
中立的なプロンプトでは、モデルは5回の実行すべてでサブAgentを呼び出しませんでした。委譲を優先するプロンプトでは、5回中4回は委譲し、残る1回は作業量が少ないと判断して自分で処理しました。この負荷条件では、単一セッションの性能がプロンプトとモデルのその場での判断に大きく左右される一方、2層アーキテクチャでは委譲がシステムレベルで組み込まれていることがわかります。その代償も明確です。Super-agentはキャッシュ読み取りの消費量が大幅に多く、トークンを使うことで、より短く安定した完了時間を得ています。
直接転送を外しても完了時間はほとんど変わりませんでしたが、Routerの判断回数は約30%、cache-read tokensは約37%増加しました。つまり、この負荷条件では直接転送による高速化は見られず、主な効果はRouterのオーバーヘッドの削減でした。
2つ目の実験では、Router層だけに負荷をかけています。Routerは実際のモデルを呼び出し、Workerには模擬モデルを使用して、Routerの判断を必要とするTriggerの到着率を段階的に上げました。
| 到着率(回/分) | 平均バッチサイズ | 1リクエストあたりの時間 | 1判断あたりの推論時間 |
|---|---|---|---|
| 約1 | 1.0 | 2.5秒 | 6.4秒 |
| 約40 | 2.8 | 3.9秒 | 1.6秒 |
1つの判断には複数回のLLMリクエストが含まれる場合があるため、1判断あたりの推論時間が1リクエストあたりの時間を上回ることがあります。このデータからは、イベントが突発的に集中した際、自動的にまとめて処理することでRouterの実効スループットを高められることがわかります。ただし、実際の本番環境でも同じ結果になることを証明するものではなく、タスクの品質や異なるコードベースでの性能についても判断できません。
DeepSeek スーパーエージェントの4つの未解決課題
記事では、以下の問題が未解決であることを明確に認めています。導入方法を検討する際は、これらも考慮する必要があります。
- アーキテクチャをどう拡張するか: タスクが大規模化し、各要素の結びつきが強まったとき、Routerを分割すべきか、どの程度細かく分けるか、Worker同士がいつ直接通信すべきかは、まだ決まっていません。細かく分割するほど並列処理の度合いは高まりますが、共有できる記憶やコンテキストは少なくなります。長期記憶も大きなボトルネックです。
- セッションがなくなったらどう使うか: タスクをどう表示するか、バックグラウンド処理を中断せずに人が重要な部分にどう介入するかなど、新しい対話方法が必要です。
- コンテキストの境界とA2A: A2A(agent-to-agent)は、異なるAgent間のコミュニケーションや協力を広く指します。組織が大きくなると、Super-agentの設定は、どのコンテキストを共有し、どれを分離するかを決めることになります。権限の境界を越えてどう安全に連携するかは、まだ答えが出ていません。
- セキュリティとプライバシー: これは最優先で評価すべき項目です。クラウド上のループは外部イベントを継続的に受け取り、エンドポイントはプライベートなコードやローカルの認証情報を保持しています。サーバーが侵入されたり、ループがプロンプトインジェクション(入力に隠された悪意ある指示)によって突破されたりすると、接続されたエンドポイントがすべて乗っ取られる可能性があります。記事では、Agentには「認証情報を使えても、その内容は見えない」仕組みが必要だとしています。
DeepSeek スーパーエージェントを小規模チームで導入するための最小チェックリスト
以下は、原文の考え方をもとに提案する導入順序であり、公式のロードマップではありません。まずは単一のリポジトリと信頼できる範囲で試験導入し、Routerのシャーディングは当面行いません。
ステップ1:まずRouterとWorkerを分離する
- コード: 常時稼働するRouterの窓口を設け、Bashツールは使わせません。タスクごとに独立したWorkerを起動し、それぞれに専用のコンテキストと作業ディレクトリを用意します。Workerは結果をRouterにのみ報告します。
- モデル: Routerには軽量モデル、Workerにはより高性能なモデルを使います。それぞれ別に設定し、個別に交換できるようにします。
- 人: Routerとのみ対話し、タスクの範囲を定義します。判断を求められた場合の対応と、最終承認も担当します。
ステップ2:Triggerによるフィルタリングを追加する
- コード: 送信元のホワイトリストと3段階のポリシーを設定し、PRやIMのトピックをThreadに対応付けます。購読済みの後続イベントは、そのままWorkerに渡します。
- モデル: 候補イベントに対してのみ意味を判断し、対応が必要か、新しいWorkerを起動するかを決めます。
- 人: プロンプトに行動条件を明記します。誤って起動したケースや起動しなかったケースを定期的に確認し、ホワイトリストとポリシーを調整します。
ステップ3:最後にWatchdogを追加する
- コード: メインシステムの外部にデプロイし、定期メッセージで動作させます。APIエラーや状態の復元失敗など、インフラ上の問題を確認します。
- モデル: Workerの進捗記録を読み取り、実質的に前進しているのか、行き詰まっているのか、目標から外れているのかを判断します。
- 人: Watchdogに与える修復権限を設定し、プロンプトやトリガールールの変更を承認します。また、失敗の原因を振り返ります。
導入初日から、本番環境の認証情報をモデルのコンテキストに直接入れることは避け、権限も必要最小限に設定しましょう。非同期ツール呼び出しと計算リソースの分離は、上記の3ステップが安定して稼働し、処理の停止やデバイスのオフライン化といった問題が実際に発生してから対応しても構いません。
DeepSeekスーパーエージェントのモデル構成とコスト試算
以下は、2026年11月2日時点で確認したAPIYI・apiyi.comのモデル一覧です。単位は$/100万トークンです。モデルと価格はプラットフォームのモデル一覧を、実際の請求額はコンソールを確認してください。
| モデル | 入力 | 出力 | キャッシュ読み取り |
|---|---|---|---|
| deepseek-v4.1-flash | 0.3 | 1.2 | 0.006 |
| deepseek-v4-flash | 0.44 | 1.32 | 0.01408 |
| deepseek-v4-pro | 1.32 | 3.96 | 0.043996 |
| claude-opus-5-5 | 4 | 20 | 0.2 |
以下はすべて公開価格に基づく試算であり、実測値ではありません。1回の呼び出しで入力2万トークン、出力2,000トークンを消費すると仮定し、キャッシュは考慮していません。
deepseek-v4.1-flashは約$0.0084、deepseek-v4-proは約$0.0343、claude-opus-5-5は約$0.12です。- Routerに
deepseek-v4.1-flash、Workerにdeepseek-v4-proを使ってそれぞれ1回実行すると、合計約$0.0427です。両方にclaude-opus-5-5を使うと約$0.24で、前者の約5.6倍になります。 - この使用量で1日20セット実行すると、混合構成では約$0.85、すべて
claude-opus-5-5を使う場合は約$4.8です。実際のWorkerは複数回呼び出されることが多いため、自分のログに記録されたトークン数で計算し直してください。
長時間稼働するシステムでは、キャッシュ読み取りの費用も別途計算する必要があります。実験で使われた2,320万キャッシュ読み取りトークンを基に試算すると、すべてdeepseek-v4.1-flashの料金で計算した場合は約$0.14、deepseek-v4-proでは約$1.02、claude-opus-5-5では約$4.64です。これは費用の規模感を示す参考値にすぎません。実験では各レイヤーのトークン分布が公開されておらず、入力と出力の費用も含まれていません。
RouterとWorkerのモデルは、設定項目として切り替えられるようにしておくと便利です。APIYI・apiyi.comでは、1つのAPIキーでこれらのモデルを切り替えられます。OpenAI互換インターフェースのbase_urlはhttps://api.apiyi.com/v1で、切り替え時は主にモデル名を変更するだけなので、同じタスクで品質とコストを比較しやすくなります。価格はモデル選定の判断材料の一つにすぎません。Workerのデフォルトモデルは、タスクの成功率や手戻りの量も踏まえて選びましょう。
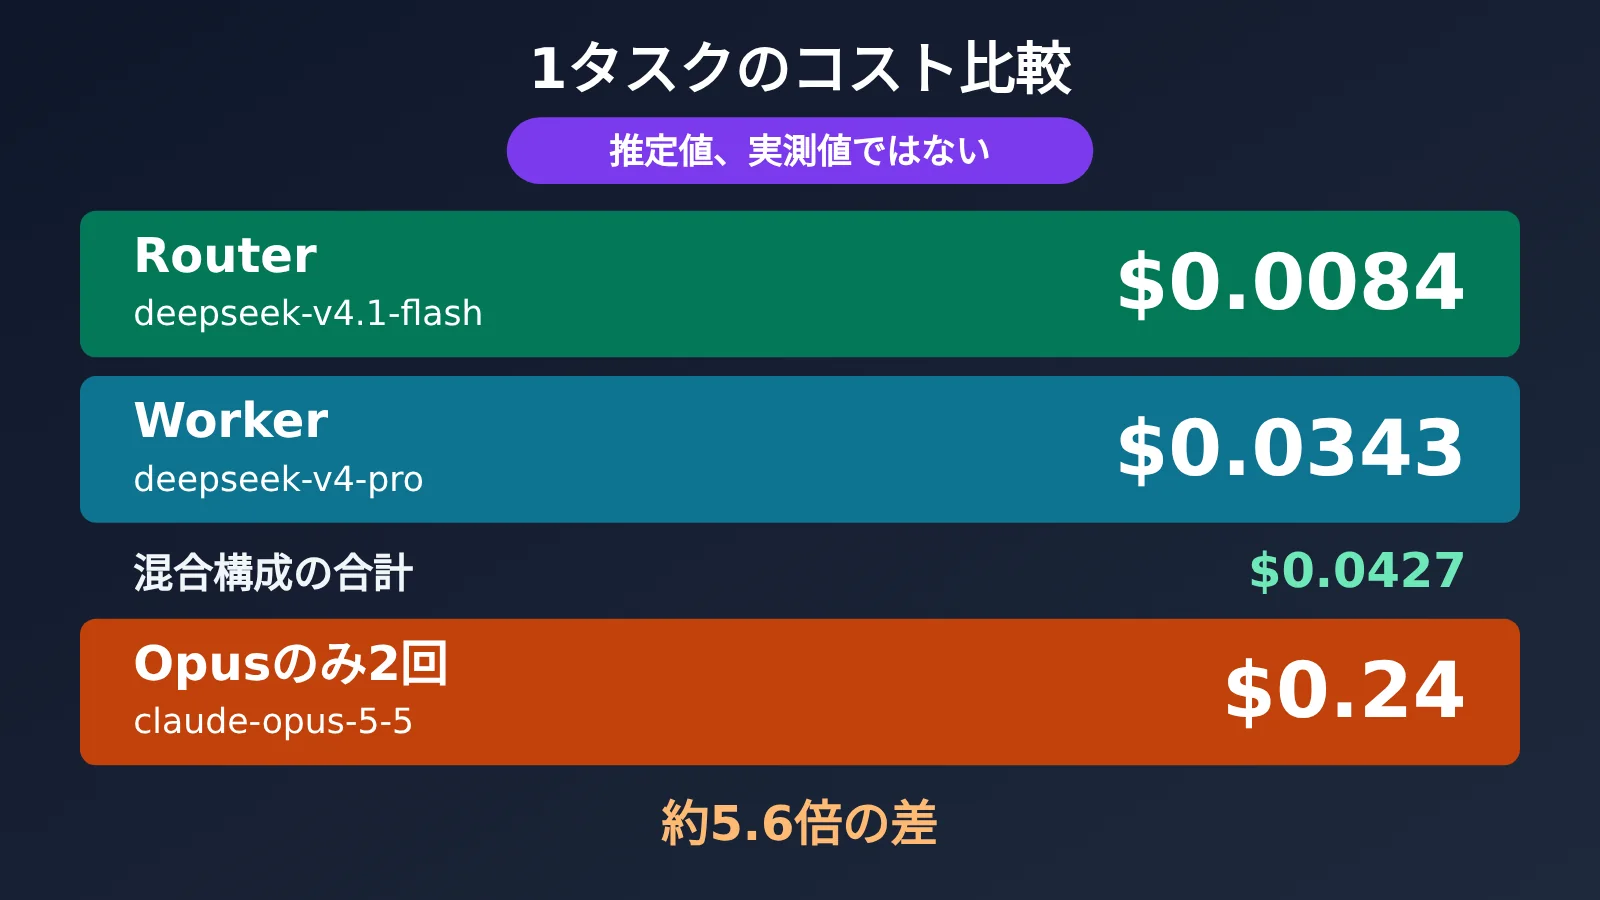
上図はAPIYI・apiyi.comのモデル一覧に記載された標準価格に基づく試算です。予算を立てる際は、ご自身のトークン使用量に置き換えて計算してください。
DeepSeek スーパーエージェントに関するよくある質問(FAQ)
Q1:これは新しいモデルですか?
いいえ。この記事では、Agentシステムのアーキテクチャを取り上げています。周辺システムがセッション、イベント、状態、監視をどのように管理するかに焦点を当てたもので、新しいモデルは発表されていません。
Q2:一般の開発者もすぐに使えますか?
5つのモジュールをそのまますぐに使える機能として利用することはできません。現時点では、研究用プロトタイプを試すか、記事の考え方に沿って自分で構築できます。原文で既存の実装として明確に言及されているのは、DeepSeek Harnessの非同期タスク機構だけで、デフォルトでは無効になっています。
Q3:dsh-superagent-prototypeは公式製品ですか?
いいえ。READMEには研究の参考用と明記されており、DeepSeekの公式製品ではありません。また、内部バージョンや、記事で説明されている完全な実装と同じものでもありません。
Q4:マルチAgentはコストが高くなりますか?
この実験では、キャッシュ読み取りトークン数は確かに増えています。Super-agentが23.2Mだったのに対し、単一セッション方式は6.1M〜10.8Mでした。その代わり、完了時間は短く、安定しています。実際の総コストはモデルの組み合わせやタスクの規模にも左右されます。Routerに軽量モデルを使ったり、Threadへの直接接続を有効にしたりすることで、コストを抑えられます。
Q5:中国国内からこれらのモデルに接続するにはどうすればよいですか?
APIYI · apiyi.comに登録してAPIキーを取得できます。新規ユーザーには無料のテスト枠があります。その後、クライアントのbase_urlを上記のアドレスに変更し、モデルパラメータに表内のモデル名を指定します。これらのDeepSeekおよびClaudeのモデルは、いずれもchat、messagesエンドポイントに対応しています。本番運用前に、少量のリクエストで動作を確認することをおすすめします。
まとめ
DeepSeekのスーパーエージェントに関するこの記事の価値は、従来のシステムエンジニアリングの考え方をAgentに応用した点にあります。要点は次のとおりです。
- 課題の所在: 単一タスクでは人の介入がますます少なくなる一方、マルチタスクのボトルネックは人の注意力に移りつつあります。
- 5つのモジュール: 二層アーキテクチャ、イベント駆動、全二重マルチチャネル、計算・状態・環境の分離、Watchdogによって、連続性、効率性、能動性、持続性という4つの特性を実現します。
- 根拠の範囲: 2組の実験はいずれも著者が報告した合成負荷による結果であり、設計の参考にとどめる必要があります。
- 導入の順序: まずRouterとWorkerを分離し、次にTriggerによるフィルタリングを加え、最後にWatchdogを導入します。安全上の境界は一貫して優先します。
モデルの組み合わせを最初から固定する必要はありません。APIYI · apiyi.comを通じて同じタスクで小規模な比較を行い、成功率と請求額を見ながら構成を決められます。
まずは自分が「人間Router」を務める状態から抜け出し、それからAgentを増やすことを考えましょう。
著者:APIYI技術チーム
技術交流:APIYIのWebサイトのトップページからお気軽にお問い合わせください。詳しい資料はdocs.apiyi.comのドキュメントセンターをご覧ください。