著者注:GPT-Live-1.1 の WebRTC セッションが待機状態に入ると、音声単価が毎分 0.05 ドルから 0.02 ドルに下がります。本記事では、設定方法、課金の確認方法、そして1通話で実際にどれだけ節約できるかを説明します。
一言まとめ:GPT-Live-1.1 の WebRTC セッションが条件を満たして待機状態に入ると、音声単価が毎分 0.05 ドルから 0.02 ドルに下がります。実際にどれだけ節約できるかは、アクティブと待機がそれぞれどれだけの時間を占めるか、そしてバックエンドのモデルやツールの使用量によって決まります。
結論には前提があります。待機を設定し、推論が一時停止された WebRTC セッションでのみ、毎分 0.02 ドルの待機価格を適用できます。この前提のもとでは、節約率はおよそ「待機時間の割合 × 60%」となります。会話中ずっと誰かが話している場合や、WebSocket や SIP のメイン接続を使っている場合は、この値下げはほぼ適用されません。また、バックエンドの推論やツール呼び出しは別途課金され、長い通話ではこれらが音声料金よりも高くなることもよくあります。
これは価格表をそのまま伝えるニュース記事ではありません。 以下では OpenAI の公式ドキュメントに沿って課金条件と設定フィールドを分解し、照合できる試算方法を提示します。本記事に登場するシナリオの算例はすべて仮定のもので、計算方法を説明するためのものであり、実際の請求額を示すものではありません。
GPT-Live-1.1 WebRTC スタンバイ関連の用語(To Know)
まず用語をいくつか整理しておきます。以降の課金と設定は、すべてここで定義する内容を基準にします。
- WebRTC:ブラウザとデバイスの間で音声などのメディアをリアルタイムに伝送する通信技術で、GPT-Live のネイティブスタンバイで唯一使える伝送方式でもあります。
- WebSocket:持続的な双方向接続です。アプリケーションはこれを使って音声、セッションイベント、あるいはサイドバンドの制御メッセージをやり取りできます。
- SIP:電話網でよく使われるセッション確立・制御のプロトコルで、GPT-Live の電話接続はこの経路を通ります。
- スタンバイ:本記事では、条件を満たす WebRTC セッションが接続を維持したまま推論を停止しているときの課金状態を指します。
- アクティブ時間:アクティブ料率で課金される段階で、一時停止の条件に達する前の静かな期間を含む場合があります。
- 音声ウェイクアップ:サービスが発話を検出すると、推論を開始または再開します。
- アイドルしきい値:セッションが音声なしの状態でどれくらい経過するとスタンバイに入るかを決める値で、設定できます。
- サイドバンド接続:メインの音声接続とは別に、サーバー制御やイベント監視に使う接続で、一般的な形式は sideband WebSocket です。
GPT-Live-1.1 WebRTC 待機の核心ポイント
| 要点 | 説明 | 開発者にとっての価値 |
|---|---|---|
| 2つの料金区分 | アクティブ $0.05/分、条件を満たす WebRTC 待機 $0.02/分(OpenAI Pricing) | 静かな時間帯の単価が60%低下 |
| 秒単位の課金 | どちらの料率も秒単位で精算され、分単位での丸めはなし | 短い一時停止も節約に反映 |
| WebRTC 限定 | 標準の低価格待機は、待機を設定し推論を一時停止した WebRTC セッションにのみ適用 | 転送方式を選ぶ時点でコストを考慮する必要 |
| バックエンドは別計算 | バックエンドのモデルとツールの利用量は別途課金 | 待機は請求項目の1つだけを最適化 |
| 初回応答の遅延 | 待機から復帰した後、短い音声の初回応答が遅くなる可能性 | コストと体験の間でトレードオフが必要 |
課金表から読み解く GPT-Live-1.1 待機「60%」の分母
まず日付の基準について。OpenAI API Changelog ではこの更新を 2026-11-19 と記載していますが、OpenAI 開発者コミュニティの提供開始告知ページでは 2026-11-20 となっています。1日の差はタイムゾーンの基準の違いによるものと考えられます。本記事で日付に触れる際は出典を明記します。OpenAI Pricing ページによると、GPT-Live の2つのモデルはいずれもアクティブ音声が $0.05/分、条件を満たす WebRTC 待機が $0.02/分 で、秒単位で課金され、バックエンドのモデルとツールの利用量は別途計算されます。
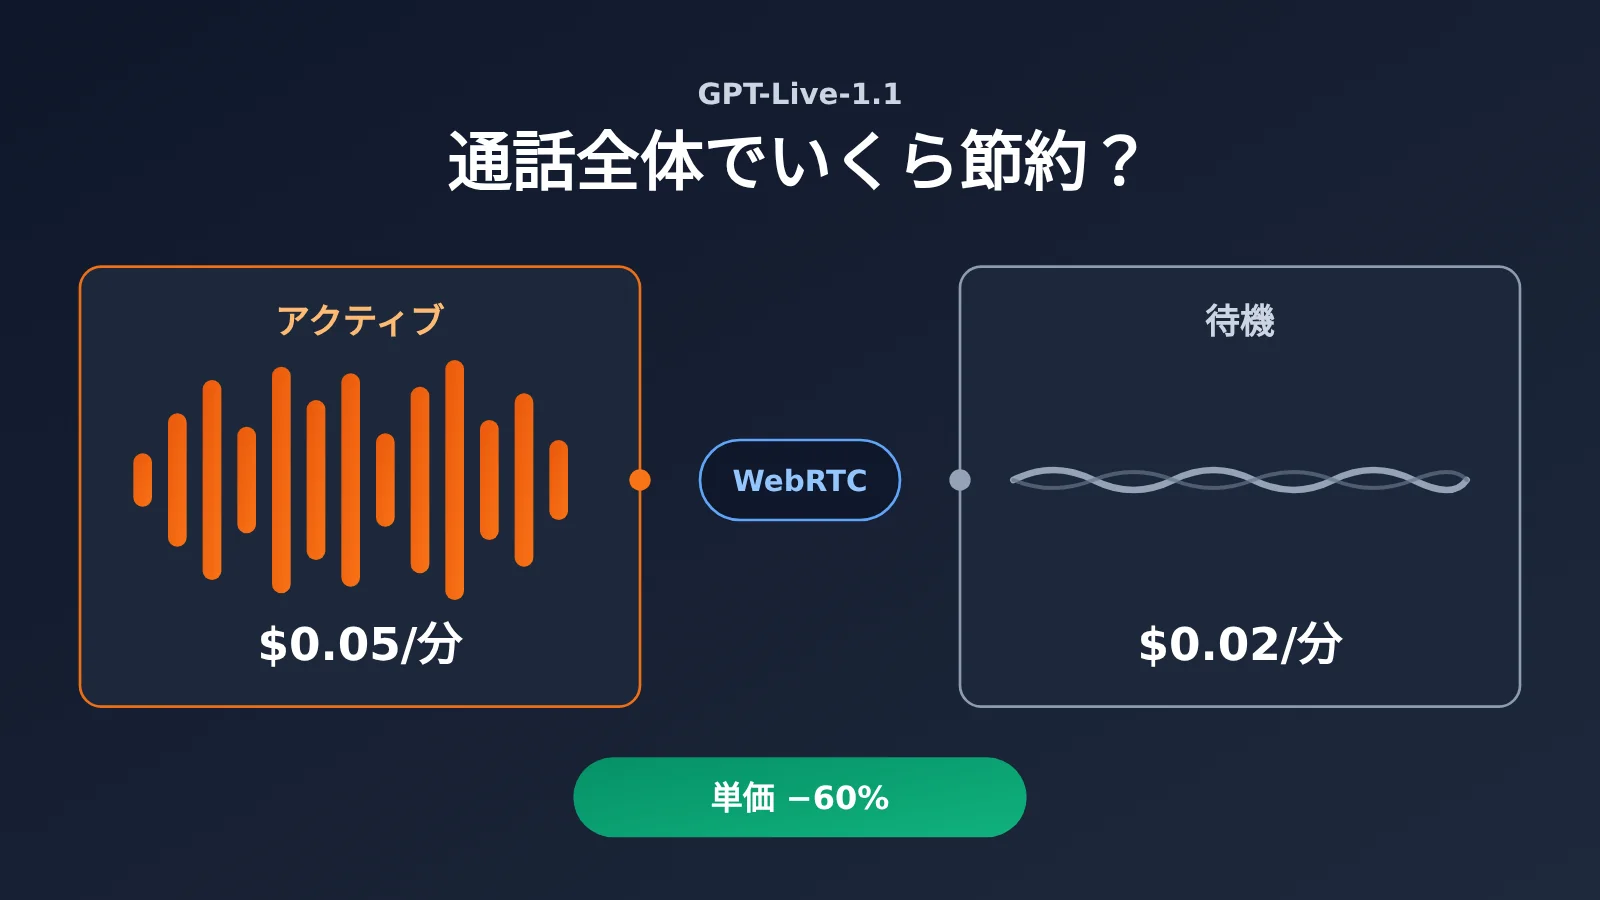
「60% 削減」はしばしば「通話全体で60%節約」と誤解されます。60% の分母はアクティブ単価であり、(0.05 − 0.02) ÷ 0.05 = 60% は、待機に入った後の1分あたりの単価の低下率だけを表します。通話全体の節約率は、さらに待機時間の割合を掛けて計算する必要があります。
仮の例を挙げます。10分間のセッションで、課金対象時間のうちアクティブが4分、待機が6分の場合、音声料金は 4×0.05 + 6×0.02 = $0.32 です。同じ10分間を全時間アクティブで利用すると $0.50 です。比較すると音声料金は 36% 低下しており、これは 60% の単価削減率に待機割合 60% を掛けた値にちょうど一致します。
| 課金項目 | 単価(OpenAI 公式価格) | 課金の粒度 | 待機の影響 |
|---|---|---|---|
| アクティブ音声 | $0.05/分 | 秒単位 | あり。一部が待機に置き換わる |
| WebRTC 待機音声 | $0.02/分 | 秒単位 | 条件を満たす WebRTC のみ |
| バックエンドモデルの token | 選択したモデルの料金による | token 単位 | なし |
| ツール呼び出し | ツールの料金による | 回数または従量 | なし |
GPT-Live-1.1 WebRTC 待機モードの設定方法:セッション設定から課金照合まで
OpenAI の「Managing GPT-Live sessions」に基づくと、WebRTC 待機モードの設定項目はそれほど多くありませんが、そのどれもが課金フェーズの区切り方に直接影響します。
| フィールド / イベント | 値または意味 | 設定のポイント |
|---|---|---|
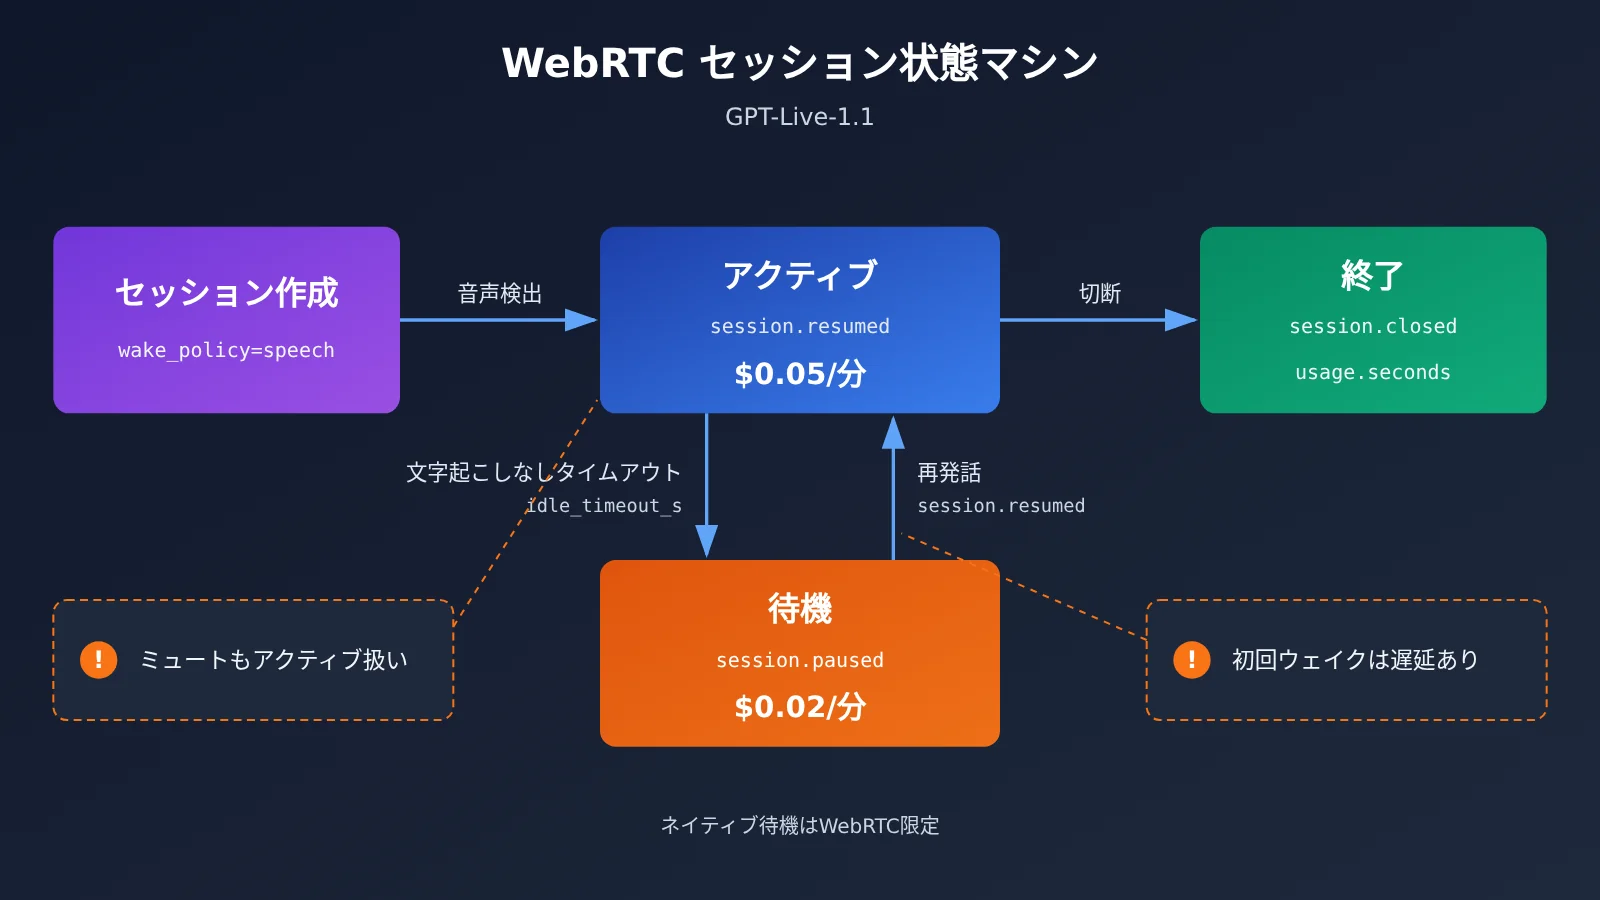
session.wake_policy.type |
"speech" に設定 |
セッションは音声を検出してから推論を開始します。接続と同時に推論するわけではありません |
session.idle_timeout_s |
5〜60 の整数(秒) | 未設定の場合、初回ウェイクアップ後は推論がずっとアクティブのままになります |
session.wake_policy.vad_threshold |
0〜1、デフォルト 0.5(サードパーティ OrcaRouter によるドキュメントの整理) | 環境が騒がしく誤ウェイクアップが頻発するときは値を高くします |
session.paused |
アイドルタイムアウト後に推論が一時停止 | 待機開始として記録 |
session.resumed |
推論が復帰して準備完了。初回ウェイクアップでも発生します | アクティブ開始として記録 |
session.closed |
セッション終了。最終的な usage.seconds を含みます |
請求内容との照合に使用 |
GPT-Live-1.1 待機設定の 4 ステップ
- WebRTC セッション作成時に音声ウェイクアップを有効にする:
session.wake_policy.type = "speech"を設定します。 - アイドルしきい値を設定する:
session.idle_timeout_sには 5〜60 の整数を指定します。しきい値が短いほど早く待機に入りますが、ユーザーの間が少し長いだけでも一時停止が発生しやすくなります。 - マイクトラックをアクティブに保つ:待機中もマイクトラックはアクティブにしておく必要があります。そうすることでサービスが音声を検出してウェイクアップできます。接続とセッション ID は変わらず、復帰時には会話履歴が引き継がれます。
- イベントを監視してタイムスタンプを記録する:
session.pausedとsession.resumedによって、サーバー側が現在どのフェーズにあるかを判断します。
以下はセッション設定の一例です。フィールドパスは公式ドキュメントに基づいており、リクエストの完全な構造は OpenAI の「Create session」を参照してください。
{
  "session": {
    "wake_policy": {
      "type": "speech",
      "vad_threshold": 0.5
    },
    "idle_timeout_s": 15
  }
}
どの「静かな時間」が依然としてアクティブ料金で課金されるか
「静か」に見える状況で計算を間違えやすいのは3種類あります。
- タイムアウト前の静かな期間:最後の発話が終わってから
idle_timeout_sに達するまでの間、セッションは依然としてアクティブとして課金されます。閾値を30秒に設定すると、毎回の停止で少なくとも30秒はアクティブ料金で計算されます。 - マイクのミュート:ユーザーがクライアント側でミュートを押しても、セッションがそれによって待機状態に入るわけではなく、アクティブなままです。
- バックエンドの応答待ち:推論が一時停止していない、バックエンドモデルやツールの結果を待っている時間も、アクティブ段階として課金されます。
さらに初期化費用もあります。OrcaRouterが公式ドキュメントを整理した内容によると、POST /v1/live/sessions でWebRTCセッションを作成すると、まず15秒分の音声時間が課金され、セッションが実行を開始した後にその時間費用から控除されます。頻繁に試験的にセッションを作成するアプリにとっては実際のコストとなります。実際のところはOpenAI Pricingを基準にしてください。
イベント時間でコストを検証する
コスト検証の考え方は、イベントのタイムスタンプで各段階の時間を推定し、session.closed 内の最終的な usage.seconds と実際の請求書を照合するというものです。以下はイベント記録の例です。イベントがどのチャネルから届くか(WebRTCデータチャネルかサイドチャネル接続か)は、公式ドキュメントを基準にしてください。
const timeline = [];
function onServerEvent(evt) {
  if (["session.resumed", "session.paused", "session.closed"].includes(evt.type)) {
    timeline.push({ type: evt.type, t: Date.now() / 1000 });
  }
  if (evt.type === "session.closed") {
    console.log("usage.seconds =", evt.usage?.seconds, timeline);
  }
}
テスト時には、同じスクリプト、同じバックエンド、同じ録音で「待機オン」と「待機オフ」をそれぞれ実行し、さらに最初の音声セグメントが返ってくる時間を記録して、ウェイクアップ後の初回ラウンドの遅延コストを定量化します。
もう一つ、ワークフロー面での注意点があります。CellCogは同じ構成での比較試験を公開しており、まず560件のスクリプト会議を実行し、さらに120件の再テストを追加しました。元のスクリプトは早めに質問を出す形で、旧バージョンは160個の質問のうち134個をバックエンドに委任し、1.1は91個、約84%対57%でした。再テストでは最初の質問を第10秒以降に置くと、両バージョンとも48/60(80%)になりました。これは単一チームによる短い会議・特定プロンプト下での委任パフォーマンスに過ぎず、待機コストは測定していませんが、一点を示しています。バックエンドへの委任回数はスクリプトによって変化しますが、バックエンド費用は待機の影響を受けないということです。
GPT-Live-1.1 のスタンバイ機能:WebSocket と SIP における実装上の境界
OpenAI は WebRTC、WebSocket、電話 SIP の3種類の Live 接続をサポートしていますが、ネイティブな低価格スタンバイが適用されるのは WebRTC だけです。ここで1点、区別しておきたいことがあります。WebRTC または SIP セッションには、制御と監視用のサイドチャネル WebSocket を別途接続できます。これは「WebSocket で主音声を伝送する」こととは別物です。WebRTC の主接続にサイドチャネル WebSocket が付いていても、スタンバイは利用できます。
| 主音声の伝送 | ネイティブスタンバイ $0.02 | 公式推奨のアイドル処理 | コスト面の注意点 |
|---|---|---|---|
| WebRTC | ✅ 条件を満たす場合に適用 | wake_policy + idle_timeout_s | タイムアウト前の静かな時間はアクティブ扱い |
| WebRTC + サイドチャネル WebSocket | ✅ 主接続に適用 | サイドチャネルは制御とイベントのみ担当 | サイドチャネル自体は課金フェーズを変えない |
| 主 WebSocket | ❌ 根拠なし | アプリ側でアイドルを検出し、クローズ後に再構築 | セッション再構築には初期化コストがある |
| SIP 電話 | ❌ 根拠なし | セッション切断が着信に与える影響を先に確認 | 通話保持中はアクティブとして予算計上 |
主 WebSocket の場合の実装:アプリ側でアイドル状態を管理し、音声の入出力、再生状態、バックエンドで完了待ちのタスクを追跡します。長時間静かで、かつ切断が許容される場合に限り、session.close を呼び出して session.closed を待ちます。ユーザーが戻ったらセッションを再構築します。保存が許可され、記録が完了している旧セッションに対しては fork を実行できます。また、アプリ自身が保存したテキスト状態からコンテキストを復元することもできます。ローカル音声ウェイクアップを有効にしている場合は、接続確立中に取りこぼしが起きないよう、冒頭の音声を先にキャッシュしてください。
SIP の場合の実装:セッションを閉じると着信接続自体に影響する可能性があるため、「切断後に再接続」をその場でのスタンバイとして扱うことはできません。通話を保持する必要がある場合は、アプリまたは電話システム側で保留ストリームを処理し、OpenAI のアクティブ音声費用を予算に計上します。もう1つの方法は、独自のメディアブリッジを構築し、OpenAI 側で実際に WebRTC スタンバイを使用して検証することです。ここまで述べた内容はすべて、伝送方式とセッション状態のレベルにおける実装上の境界です。非 WebRTC 伝送でも $0.02 のスタンバイ料金を利用できるという根拠はありません。
一通の通話でどれだけ節約できるか:GPT-Live-1.1 の待機コストをすぐに理解する
シンプルなコスト試算
次の関数は「節約率 = 待機割合 × 60%」をコードにしたもので、入力は秒単位です:
ACTIVE, STANDBY = 0.05, 0.02  # OpenAI 公式価格、米ドル/分

def voice_cost(active_s: float, standby_s: float) -> tuple[float, float]:
    with_standby = active_s / 60 * ACTIVE + standby_s / 60 * STANDBY
    all_active = (active_s + standby_s) / 60 * ACTIVE
    return round(with_standby, 4), round(1 - with_standby / all_active, 4)

print(voice_cost(240, 360))      # 10分:アクティブ4分 + 待機6分
print(voice_cost(60, 30))        # 90秒:アクティブ60秒 + 待機30秒
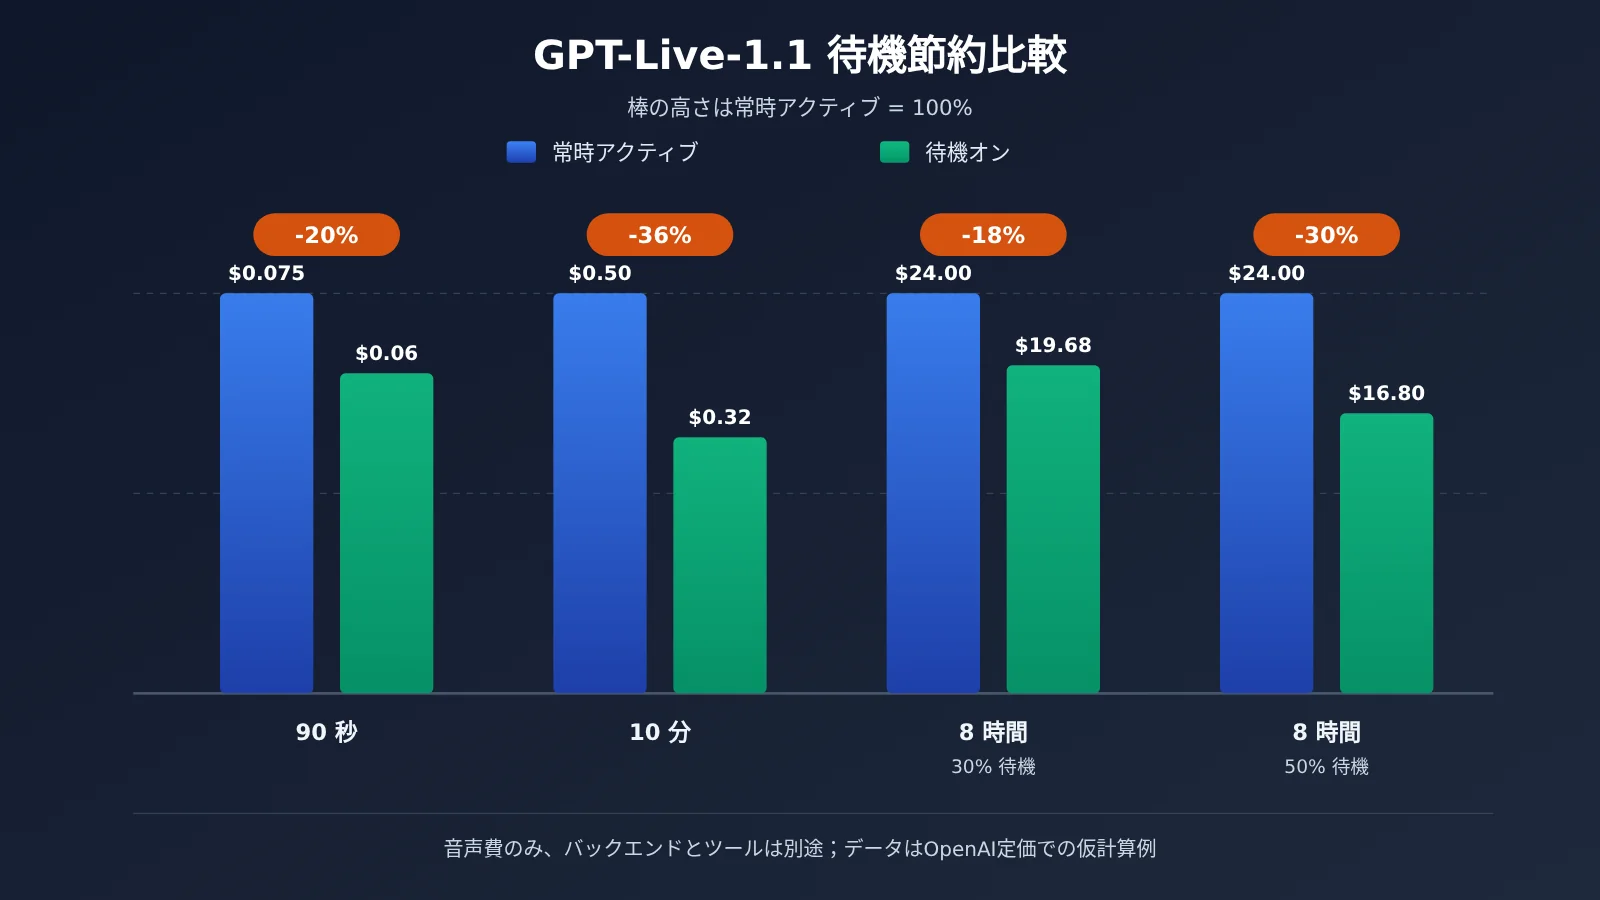
| 想定シナリオ | アクティブ / 待機 | 待機有効時の音声料金 | 全時間アクティブの音声料金 | 音声料金の削減率 |
|---|---|---|---|---|
| 公式の例(OrcaRouter による引用) | 60秒 / 30秒 | $0.06 | $0.075 | 20% |
| 10分の相談(本記事の想定) | 4分 / 6分 | $0.32 | $0.50 | 36% |
| 8時間の待機対応、待機30%(OrcaRouter の試算例) | 5.6時間 / 2.4時間 | $19.68 | $24.00 | 18% |
| 8時間の待機対応、待機50%(OrcaRouter の試算例) | 4時間 / 4時間 | $16.80 | $24.00 | 30% |
表には音声料金のみを計上しています。実際の導入では、バックエンドのモデル費用やツール費用が請求額のうちより大きな項目になることがよくあります。OrcaRouter の記事では、OpenAI のドキュメントがまず gpt-6-luna を使い、複雑なバックエンドタスクでは gpt-6-sol に切り替えることを推奨しており、どちらも token の標準料金で課金されると述べています。長時間の通話では、バックエンド費用が音声料金を完全に上回る可能性があります。
💡 試算のヒント:上の表はすべて公式価格に基づく想定であり、実際の請求額は
usage.secondsとプラットフォームの請求書を基準にしてください。他のリアルタイム音声ソリューションも併せて検討している場合は、APIYI apiyi.com の無料テスト枠を使って、同じ台本で token 課金の Realtime モデルと比較できます。
GPT-Live-1.1 の音声レイヤー、バックエンドモデル、APIエントリを切り分けて選ぶ
確認日時点(2026-11-20)において、GPT-Live-1.1 専用のセッションインターフェースと分単位の料金は、いずれも OpenAI 公式によるものです。第三者である OrcaRouter のまとめによると、GPT-Live は Live sessions エンドポイント経由でのみ接続可能で、Chat Completions、Responses、Realtime などの他のエンドポイントはサポートしていません。
APIYI に関しては、公開モデルレジストリ(2026-11-20 15:17(UTC+8)に生成、全 289 件のレコード)に gpt-live-1 や gpt-live-1.1 はありません。動的アーカイブにも対応するリリース告知は見当たりません。したがって、現時点で APIYI が GPT-Live シリーズ、/v1/live/sessions、あるいは分単位の課金を提供しているとは考えられません。また、APIYI が OpenAI のインターフェースと互換性があるからといって、こうした専用の音声セッションをサポートしていると推測することもできません。
APIYI がすでに公開しているリアルタイム音声の選択肢は、独立した Realtime 製品です:
| プラン | 接続方式 | 課金方式 | 待機 / WebRTC / SIP | 利用可能なプラットフォーム |
|---|---|---|---|---|
| GPT-Live-1.1 | /v1/live/sessions、WebRTC / WebSocket / SIP |
アクティブ $0.05、待機 $0.02 分ごと、バックエンドは別途計算 | WebRTC はネイティブ待機に対応 | OpenAI 公式 |
| gpt-realtime-2.1 | /v1/realtime WebSocket |
音声入力/出力 $32/$64 100万音声トークンあたり | WebRTC、SIP は未開放 | APIYI apiyi.com |
| gpt-realtime-2.1-mini | /v1/realtime WebSocket |
音声入力/出力 $10/$20 100万音声トークンあたり | WebRTC、SIP は未開放 | APIYI |
APIYI Realtime の価格は APIYI のドキュメントに基づいています(ページには 2026-09-14 時点の照合であると記載されています)。課金単位はテキスト・音声・画像のトークンであり、GPT-Live の分単位課金とは直接換算できません。
APIYI Realtime のシンプルな接続例
import os, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # APIYI の統一インターフェース
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1"

async def main():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        print(await ws.recv())  # 最初のサーバーイベントを出力

asyncio.run(main())
完全なコードを表示:メイン WebSocket のアプリ側アイドル切断
import os, time, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # APIYI Realtime のエントリポイント
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1-mini"
IDLE_LIMIT_S = 45          # アプリ側のアイドル閾値。業務に合わせて調整可能
pending_backend_tasks = 0  # アプリ側で管理:バックエンドの未完了タスク数
is_playing = False         # アプリ側で管理:音声を再生中かどうか

async def run_session():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    last_activity = time.monotonic()
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        async def reader():
            nonlocal last_activity
            async for _ in ws:
                last_activity = time.monotonic()  # サーバーからのイベントはすべてアクティビティと見なす

        task = asyncio.create_task(reader())
        while True:
            await asyncio.sleep(1)
            idle = time.monotonic() - last_activity
            busy = pending_backend_tasks > 0 or is_playing
            if idle > IDLE_LIMIT_S and not busy:
                print(f"空闲 {idle:.0f}s,主动关闭,用户回来后再重建")
                await ws.close()
                break
        task.cancel()

asyncio.run(run_session())
イベント形式とクエリパラメータは、APIYI の『Realtime リアルタイム音声(WebSocket)』ドキュメントに準拠します。このように切断して再構築する方法は、アプリ層でアイドル接続を削減するだけのものであり、公式の低価格な待機料率には該当しません。
🚀 導入のヒント:GPT-Live ネイティブの待機機能が必要な WebRTC シーンでは、現時点では OpenAI に直接接続してください。WebSocket でリアルタイム音声のプロトタイプを素早く構築し、複数モデルを一元管理したい場合は、まず APIYI(apiyi.com)上で
gpt-realtime-2.1-miniを使ってフローを通し、その後コストに応じて正式な方案を決めるとよいでしょう。
よくある質問(FAQ)
Q1: GPT-Live-1.1 の WebRTC 待機とは何ですか?
これは WebRTC セッションの課金状態の一種です。音声によるウェイクアップとアイドルしきい値を設定すると、セッションは音声がない時間帯に推論を停止しますが、接続は維持され、$0.02/分で課金されます。再び誰かが話すと、推論が再開し、元の会話履歴も引き継ぎます。
Q2: 60% の値下げは、通話全体が 60% 安くなるという意味ですか?
いいえ。60% は待機単価がアクティブ単価に対して下がる割合です。通話全体の音声料金の削減率は、待機の割合に 60% を掛けた値になります。待機が半分なら、音声料金は約 30% 節約できます。バックエンドとツールの費用には影響しません。
Q3: GPT-Live-1.1 が API に公開されたのはいつですか?
OpenAI API Changelog のエントリ日付は 2026-11-19、OpenAI 開発者コミュニティの告知ページでは 2026-11-20 と表示されており、この違いはタイムゾーンの基準に由来する可能性があります。GPT-Live-1 は以前、2026-09-10 に正式に利用可能になっています(OrcaRouter の整理による)。
Q4: どのようなシーンで待機を有効にすると最もお得ですか?
– **カスタマーサポートの待ち行列**:顧客がオンラインにつながったまま長時間話さないケース。
– **車載またはデスクトップアシスタント**:常時接続で、たまにウェイクアップするケース。
– **長時間の待機型オペレーター席**:待機の割合が高いほど、節約額が大きくなります。
会話が密な短いセッションでは待機の割合が低く、さらにウェイクアップ後の最初の応答が遅くなる代償もあるため、メリットは限定的です。
Q5: APIYI 経由で GPT-Live-1.1 を呼び出せますか?
2026-11-20 時点で、APIYI の公開モデルレジストリには GPT-Live シリーズがなく、公開のお知らせもありません。リアルタイム音声が必要な場合は、APIYI apiyi.com で公開済みの `gpt-realtime-2.1` / `gpt-realtime-2.1-mini` を利用できます。`/v1/realtime` WebSocket 経由で接続し、音声トークンに基づいて課金されます。新規ユーザーには無料のテスト枠があるので、まず検証できます。
Q6: GPT-Live-1.1 の待機にはどのような既知の制限がありますか?
– WebRTC のみに適用され、WebSocket と SIP のメイン接続には $0.02 の根拠がありません。
– タイムアウト前の静かな期間、マイクのミュート、バックエンド待ちの時間はすべてアクティブとして課金されます。
– ウェイクアップ後の短い音声では、最初の応答が遅くなる可能性があります。
– 現時点では、待機のウェイクアップと請求照合に関する第三者データが不足しています。Artificial Analysis のランキング上のスコアも GPT-Live-1 にのみ対応するもので、1.1 にそのまま当てはめることはできません。
GPT-Live-1.1 WebRTC 待機の要点 Key Takeaways
- 単価:アクティブ時 $0.05/分、条件を満たす WebRTC 待機は $0.02/分。いずれも秒単位で課金されます。
- 計算式:通話全体の音声料金の削減率は「待機比率 × 60%」で決まり、固定の 60% ではありません。
- 設定:
wake_policy.type="speech"と 5〜60 秒のidle_timeout_sを設定し、マイクのトラックはアクティブのまま維持します。 - 検算:paused/resumed のタイムスタンプでフェーズごとの時間を概算し、
usage.secondsと請求明細を突き合わせます。 - 境界:WebSocket と SIP はアプリ側で切断した後に再構築するしかなく、低価格の待機としてはカウントできません。
- 入口:GPT-Live は OpenAI への直結が必要です。WebSocket のリアルタイム音声は APIYI apiyi.com で Realtime モデルを試せます。
まとめ
GPT-Live-1.1 WebRTC 待機の要点:
- 値下げには条件がある:待機を設定し、推論が一時停止中の WebRTC セッションのみ $0.02/分で課金されます。
- 節約額は比率次第:10 分のうち 6 分を待機にすると、音声料金は $0.50 から $0.32 に下がり、約 36% の節約になります。
- 請求は全体で見る:バックエンドのモデルとツールは別途課金され、待機はそのうちの 1 項目だけを最適化するものです。
まずは同じ会話シナリオで待機のオン・オフを A/B テストし、イベント発生時刻と初回ターンの遅延を記録したうえで、アイドルしきい値を決めるのがおすすめです。リアルタイム音声の選択肢をまだ比較検討中なら、APIYI apiyi.com で Realtime のプロトタイプを先に動かし、無料枠でコストと体験を比べてみてください。
📚 参考資料
-
OpenAI API Pricing:GPT-Live のアクティブ料率と待機料率
- リンク:
developers.openai.com/api/docs/pricing - 説明: $0.05 と $0.02 の公式表示価格の出典
- リンク:
-
OpenAI Managing GPT-Live sessions:待機設定とイベントの説明
- リンク:
developers.openai.com/api/docs/guides/live-conversations - 説明: wake_policy、idle_timeout_s、および転送境界について
- リンク:
-
OpenAI API Changelog:GPT-Live-1.1 の更新エントリ
- リンク:
developers.openai.com/api/docs/changelog - 説明: エントリ日付 2026-11-19
- リンク:
-
CellCog 比較試験:GPT-Live-1.1 vs GPT-Live-1
- リンク:
cellcog.ai/blog/gpt-live-1-1-vs-gpt-live-1/ - 説明: 680 件のスクリプト会議における委任データ(待機コストは含まない)
- リンク:
-
OrcaRouter リリース解説:GPT-Live-1.1 の待機課金分析
- リンク:
orcarouter.ai/blog/gpt-live-1-1-api-release-standby-pricing - 説明: 公式の計算例の引用と 8 時間シフトでの試算
- リンク:
著者: APIYI 技術チーム
技術交流: APIYI のウェブサイトトップページからお気軽にお問い合わせください。Realtime の接続詳細については docs.apiyi.com のドキュメントセンターをご参照ください