2026年11月19日、Google は Gemini Interactions API で、プレビュー版として Tool Retrieval(ツール検索) の提供を開始しました。エージェントはまずツールの名前と簡単な説明だけを参照でき、実際に呼び出す必要が生じた時点で完全なパラメータスキーマをコンテキストに読み込みます。主に解決するのは、「接続するツールが増えるほど、使われないツール定義でコンテキストが埋まってしまう」という問題です。ツールの数が多く、呼び出しが少数の高頻度ツールに集中し、同時に多数のロングテールツールが存在するエージェントに最も適しています。すべてのアプリケーションでデフォルトで有効にすればコストを削減できる、というわけではありません。
この記事でわかること
- Tool Retrieval が変えるものとは何か、そして「開発者は引き続き完全なツール宣言を送信する必要がある」と「モデルは事前に完全なスキーマを読む必要がない」がなぜ同時に成り立つのか
- ツール登録から
function_callまでの完全な実行チェーン、およびサーバー側検索とクライアント側検索の役割分担 - 現在明確に対応している 4 つのモデル ID、標準価格、および「機能ごとの追加料金はないが、トークンは通常どおり課金される」という意味
- 公式が示した、方向性の異なる 2 つの試算例:いつコストを抑えられるのか、いつむしろ高くなるのか
- 導入前に注意すべき制限、および自分のエージェントに採用する価値があるかを見極める方法
索引:後述の概念表と影響の概要を使って、背景をすばやく把握できます。「客観的事実」パートでは、発表情報、動作の仕組み、ハイブリッド読み込みとリモート MCP、対応モデルとコスト、利用上の制限を順に説明します。内容はすべて Google の公式発表と開発者向けドキュメントに基づきます。「分析・判断」パートでは、適用シーンの判断、移行前のベースライン測定方法、いくつかのよくある疑問を示します。判断や予測を含む内容には、個別にその旨を明記します。
Gemini API Tool Retrieval を理解するために押さえておきたい概念(To Know)
| 概念 | 簡単な説明 |
|---|---|
| Tool Retrieval | 必要なツールを先に検索し、ヒットしたツールの完全なパラメータ定義をモデルのコンテキストに追加する仕組み |
| Interactions API | Gemini のエージェント向けインターフェース。インタラクション履歴、ツール実行ステップ、モデル出力を管理し、2026年6月に正式提供開始 |
| パラメータSchema | 関数が受け取るパラメータ、型、必須項目などの構造を記述したもの。通常は JSON Schema で表現 |
| Function Calling | モデルが関数名とパラメータを生成し、アプリケーションが関数を実行して、その結果をモデルに戻す仕組み |
tool_search |
ツール検索メカニズムを宣言するツールタイプ。モデルはこれを使ってツール定義を検索・読み込みする |
defer_loading |
サーバーサイドモードの設定。ツールの完全なパラメータ定義を、検索ヒット時まで遅延して読み込む |
short_description |
遅延ツールの短い説明。モデルが初期カタログでツールを識別するために使用 |
| リモートMCP | Model Context Protocol を介して、アプリケーション外部のサードパーティサービスが提供するツールに接続 |
| 暗黙的キャッシュ | プラットフォームが同じコンテキストプレフィックスを自動的に再利用し、ヒットした部分はキャッシュ入力の料金レートで課金 |
Gemini API Tool Retrieval の影響を一目で理解
- エージェントに大量の業務ツールを接続している開発者:自前のツール検索器を構築しなくても、モデルが必要に応じて数十、場合によっては100以上のツールのSchemaを読み取れるようになります。ただし、毎回のリクエストで完全なツール配列を送信する必要は依然としてあり、キャッシュと課金を再評価する必要があります。移行前に、既存のFunction Callingフローでツール定義が実際に占める量を測定しておくことをおすすめします。APIYI apiyi.com のようなマルチモデル統合インターフェースを利用すれば、比較用のベースラインをすばやく取得できます。
- プロダクトとコストの責任者:個別の機能利用料はありませんが、サーバーサイド検索のたびに追加のモデル推論が発生します。コストを抑えられるかは、ツールの規模、コンテキスト長、検索頻度に依存します。請求明細の項目で検証する必要があり、宣伝の方向性だけで判断すべきではありません。
- ツールが少なく、呼び出しが安定しているアプリケーション:公式の試算例では、小規模なツールセットと長いコンテキストを組み合わせると、Token総量がかえって増えることが示されています。引き続き直接読み込むほうが安定した選択です。
- エージェントフレームワークを利用するチーム:これはモデルAPIレイヤーの新機能であり、フレームワークがすぐに対応するとは限りません。フレームワーク層での段階的読み込みについては、すでに解決済みとみなすことはできません。
客観的事実:Gemini API Tool Retrieval は何を発表したのか
Gemini API Tool Retrieval の発表情報と背景
Google の公式ブログは2026年11月19日に「Introducing Tool Retrieval in the Gemini API」を公開しました。著者は Gemini API のプロダクトマネージャーである Lucia Loher 氏と、Google DeepMind のリサーチサイエンティストである Nora Kassner 氏です。この機能は現在プレビュー段階にあり、Interactions API でのみ利用できます。v1beta バージョンが必要で、旧来の generateContent メソッドはサポートしていません。
エンジニアリング側の準備は発表より早く進んでいました。11月18日、Google 公式 Python SDK は v3.6.0 をリリースし、更新履歴には Tool Retrieval と関数結果に関連する公開 Schema が追加されたと記されています。同日、Go SDK v1.79.0 にも対応する更新が含まれていました。時系列から見ると、今回はすでに GA 済みの Interactions API に、ツールの検出とオンデマンド読み込みの機能を追加したものであり、新しい API 製品を打ち出したわけではありません。
開発者からの要望も記録で確認できます。2026年3月18日、ある開発者が Python SDK リポジトリで Issue #2185 を提出し、defer_loading と tool_search への対応を求めました。理由は、Agent が30以上のツールを接続すると、完全な Schema によってコンテキストが膨らむためです。Google のメンテナーは3月20日に返答し、機能リクエストとして登録しました。これらは要望のフィードバックであり、パフォーマンステストではありません。
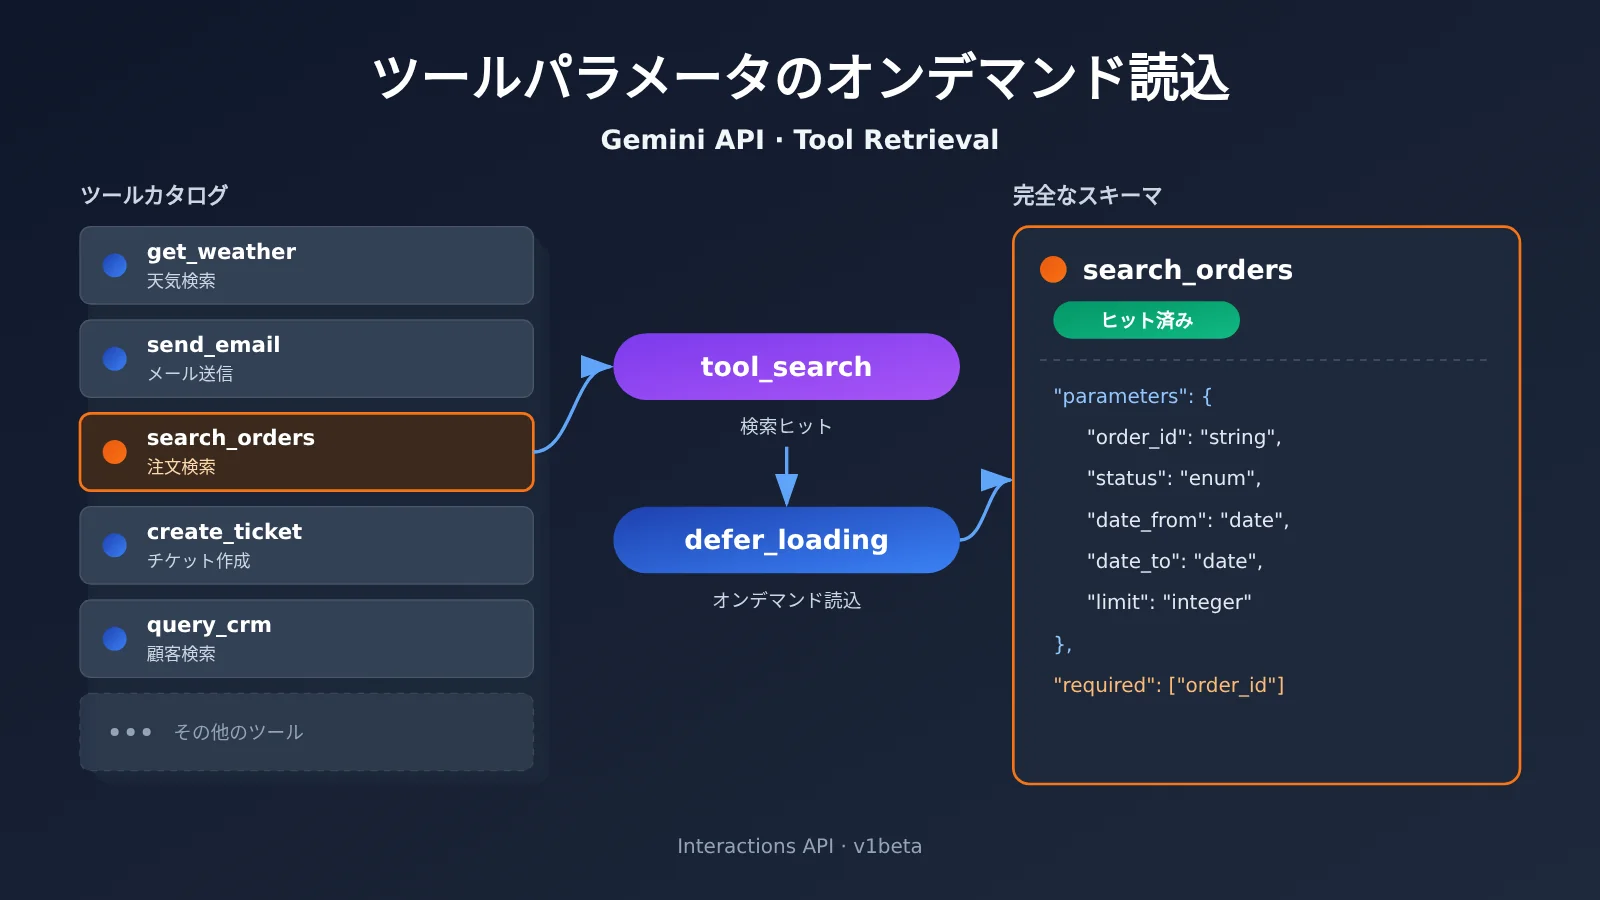
Tool Retrieval を一文でまとめると、ツールはまず発見でき、具体的なパラメータは呼び出しが必要になったときに読み取る となります。
Tool Retrieval がツールスキーマの読み込み方式を変える仕組み
従来の静的な読み込み方法では、ユーザーがたった1件の返金処理を行いたいだけでも、注文・物流・在庫・CRM など数十個のツールのパラメータ宣言が、毎回の推論と一緒にコンテキストへ入り込みます。Google のドキュメントでは、数十個の関数宣言が数万トークンを占める可能性があると示されています。そうなると会話履歴の領域を圧迫しますし、似たツールが増えてくると、モデルが適切なツールを選ぶ際の妨げにもなり得ます。
Tool Retrieval の要点は、3 つのレイヤーを明確に区別することにあります。
- API リクエスト層:開発者はこれまで通り完全なツール定義を、パラメータのスキーマを含めて送信します。
- モデルの初期コンテキスト:
defer_loading: trueとマークされたツールは、ツール名とshort_descriptionの形式でしか現れません。短い説明文が設定されていなければ、完全なdescriptionの最初の一文が使われます。 - ツール呼び出しの段階:ツールが検索でヒットした後に、完全なスキーマがコンテキストへ入り、モデルはそれに基づいてパラメータ化された呼び出しを生成します。
つまりタイトルの「毎回すべてのツールパラメータを読み込むようにはならない」という表現の正確な意味は、モデルが毎ラウンド事前にすべての完全なパラメータを読み取らない、という点にあります。開発者が完全な宣言を送信しなくて済む、という意味ではありません。サーバー側モードでは、公式に毎回のリクエストで完全な tools 配列を再送信することが求められており、previous_interaction_id を使う場合でも例外ではありません。
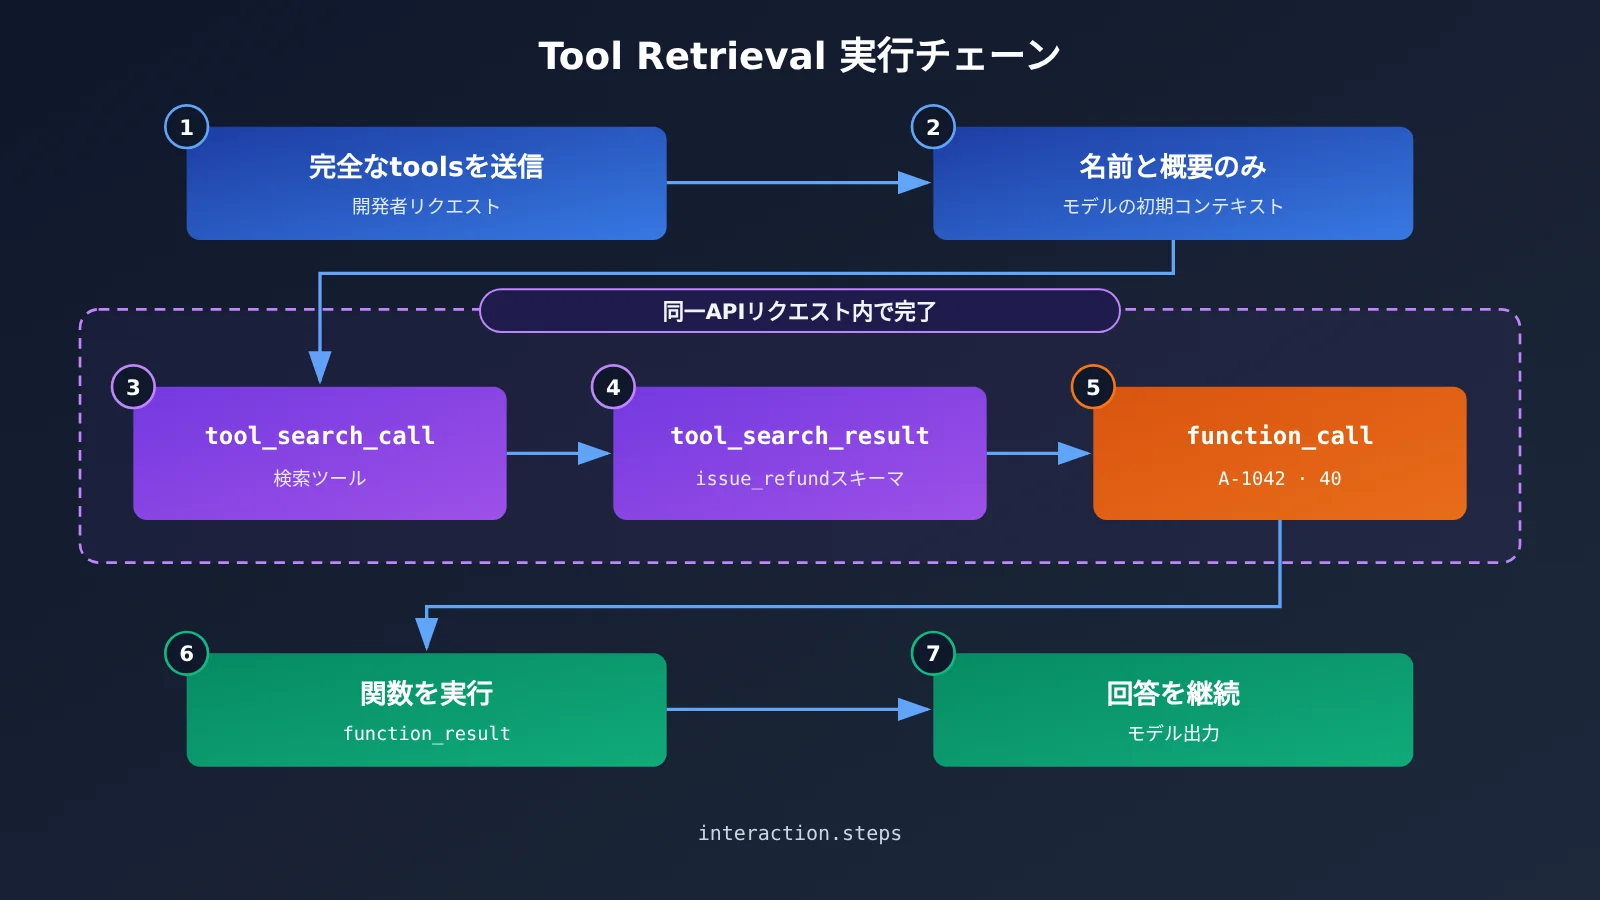
Tool Retrieval の実行フロー:公式の返金事例を例に
Google の発表では、注文返金のシナリオが使われています。注文 A-1042 の商品は到着時に破損しており、ユーザーが 40 ドルの返金を求めています。必要なツールは issue_refund です。サーバー側検索の完全なプロセスは次のとおりです。
- リクエスト内で
{"type": "tool_search"}を宣言し、issue_refundなどの低頻度ツールにdefer_loading: trueを設定します。 - モデルはタスクに基づいて返金機能が必要だと判断し、
tool_search_callを発行します。 - API は
tool_search_resultを返します。これにはissue_refundの完全なパラメータスキーマが含まれます。 - モデルはパラメータ定義を読み取り、
function_callを生成します。パラメータはorder_id: "A-1042"とamount: 40です。 - アプリケーションが関数を実行して
function_resultを返し、モデルはそれに基づいてタスクを続行します。
検索、読み込み、関数呼び出しの生成は、同じ外部 API リクエスト内で完了できます。すべてのステップは interaction.steps で確認できます。ただし、同じリクエストであっても内部で推論が 1 回だけ行われるわけではなく、サーバー側の検索のたびに、追加の課金対象となるモデル呼び出しが発生します。また、これはデモ用の事例であり、返金成功率に関する統計を示すものではありません。
以下は公式ドキュメントに基づいて整理したサンプルコードです。Google のエンドポイントに直接接続し、リクエスト構造の提示のみを目的としています。
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "issue_refund",
        "description": "Refund an order.",
        "short_description": "Refund a customer order.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "amount": {"type": "number"}
            },
            "required": ["order_id", "amount"]
        }
    }
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Refund 40 USD for order A-1042.",
    tools=tools
)
for step in interaction.steps:
    print(step.type)  # tool_search_call / tool_search_result / function_call
Function Calling の従来の役割分担に変更はありません。カスタム関数の場合、API は function_call のみを返します。返金の実行、データベースへのアクセス、権限の処理は引き続きアプリケーションの役割です。リモート MCP サーバーに接続する場合に限り、API が代理でリモート呼び出しを開始し、mcp_server_tool_call と mcp_server_tool_result を返します。
Tool Retrieval のハイブリッド読み込み、リモート MCP、2 種類の検索モード
Google は、高頻度で利用するツールは直接読み込み、低頻度で専門的なロングテールツールは遅延読み込みする、ハイブリッドな使い方を推奨しています。こうすることで、シンプルなタスクでは最初に検索を行う必要がなく、ロングテールの機能がコンテキストを長期にわたって占有することもありません。リモート MCP サーバーもサーバー単位で遅延読み込みを設定できます。たとえば、type: "mcp_server" の設定に defer_loading: true を付けると、そのサーバーが公開するツールはオンデマンドで読み込まれ、個別に宣言する必要はありません。
Gemini が検索を担うサーバー側モードに加え、公式ではクライアント側モードも提供しています。開発者が execution: "client" の tool_search を宣言し、自社アプリケーションがツールレジストリを検索して、一致した完全なツール宣言を function_result.result に入れてモデルに返します。両者の違いは次のとおりです。
| 比較項目 | サーバー側検索 | クライアント側検索 |
|---|---|---|
| 実行場所 | Gemini API サーバー側(デフォルトは server) |
開発者アプリケーション(client) |
| 検索器の自前構築 | 不要 | 必要 |
| ツールライブラリの事前宣言 | 必要 | 不要。会話中に新しいツールを導入可能 |
defer_loading |
適用可能 | 適用不可 |
| 追加のネットワークラウンドトリップ | 追加のクライアント往復は不要 | 検索ごとに 1 回、追加の往復が発生 |
| 権限管理 | リクエストで宣言されたツールセットによって決まる | 自前のユーザー単位の権限フィルタリングと組み合わせ可能 |
| 典型的なユースケース | 大規模で比較的固定されたツールセット | 動的なツールライブラリ、マルチテナント、企業のプライベートレジストリ |
クライアント側モードで返す関数宣言は構造化オブジェクトである必要があり、JSON 文字列に変換してはいけません。同一リクエスト内で 2 つのモードを併用することはできず、tool_search は最大 1 つだけ宣言できます。
Gemini API Tool Retrieval の対応モデルと料金
Googleの発表はやや広範で、Gemini 3.6以降のモデルがすべて対応するとしています。これにはGemini 4のすべてのモデルが含まれます。ただし、開発ドキュメントで11月20日時点に明記されているのは4つのモデルIDだけです。実装時は開発ドキュメントを基準にしてください。未対応のモデルに defer_loading を設定すると、HTTP 400が返されます。
| モデル ID | 標準入力料金(米ドル/100万トークン) | 標準出力料金(Thinking込み) | 備考 |
|---|---|---|---|
gemini-4-hydrogen |
$1.50 | $7.50 | Free Tier あり |
gemini-4-argon |
$2.00(12月1日から $4.00) | $10.00(12月1日から $20.00) | Free Tier なし |
gemini-3.8-flash |
$0.75(2027年1月1日から $1.50) | $3.75(2027年1月1日から $7.50) | Free Tier あり |
gemini-3.6-flash |
$0.75(2027年1月1日から $1.50) | $3.75(2027年1月1日から $7.50) | Free Tier あり |
料金はGoogle Gemini Developer APIの料金ページにあるStandard プランに基づきます。Free Tierの実際のクォータとレート制限は、プロジェクトごとに確認が必要です。
課金について、GoogleはTool Retrieval自体に独立した機能料金はないと明言していますが、これは検索が無料という意味ではありません。遅延読み込みされるツールの簡易リスト、tool_search を有効にすると追加される固定の検索指示、サーバー側で検索するたびに発生する追加の推論、読み込まれる完全なスキーマ、そして後続のターンでそれらが保持されることによるトークン消費は、いずれも選択したモデルの料金で課金されます。コストを確認する際は、total_tool_use_tokens フィールドに特に注意してください。これは、サーバー側検索によって発生した追加のモデル呼び出し入力を記録しています。初回の入力トークンの減少だけを見ると、節約効果を過大評価しやすくなります。
Tool Retrieval の公式トークン算例
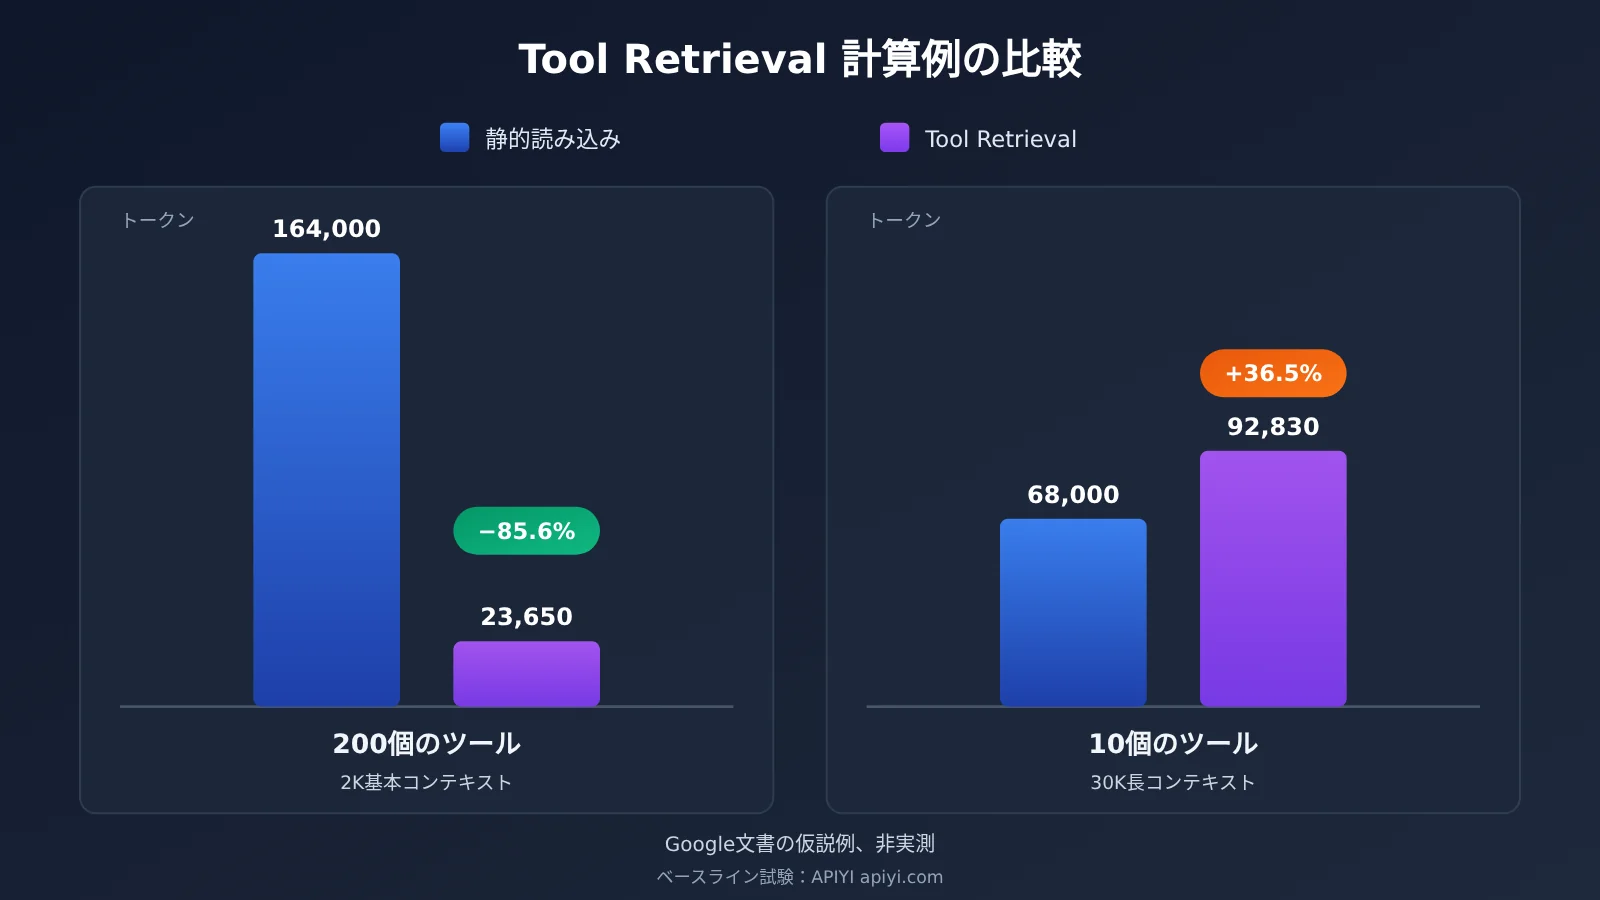
Googleの初期テストでは、各遅延ツールが初期ディレクトリ内で平均約26トークンを占めると報告されています。これは概算値であり、固定のオーバーヘッドではありません。ドキュメントにはさらに2つの仮定算例が示されており、結論は逆方向となっています。
| シナリオ(公式の仮定) | 全ツールを静的ロード | Tool Retrieval | 変化 |
|---|---|---|---|
| 200ツール、各400トークン、基本コンテキスト2,000、2ツールを使用、計2リクエスト | 164,000 | 約23,650 | 約85.6%削減(算例による試算) |
| 10ツール、各400トークン、基本コンテキスト30,000、2ツールを使用、計2リクエスト | 68,000 | 92,830 | 約36.5%増加(算例による試算) |
2つ目の算例が高コストになる理由は、サーバー側の検索で追加の推論が1回必要となり、すでに長くなったコンテキストを再処理するためです。一方で10ツール自体の占有量はさほど大きくないため、節約できるSchemaが検索のオーバーヘッドを補いません。どちらの数値もGoogleが明記した仮定の例であり、出力トークンやキャッシュの利得は含まれておらず、本番環境のベンチマークではありません。資料確認日の時点で、Googleはこの機能の実測トークン削減率、レイテンシ改善、ツール選択精度の向上を公表していません。
キャッシュについて、GoogleはTool Retrievalが暗黙的キャッシュをサポートすると述べています。完全なSchemaが初期プレフィックスに現れないため、システム指示やツールディレクトリなどのプレフィックスがより安定しやすくなります。ただしドキュメントは、遅延ロードによって初期プロンプトが短くなるため、本来大量のSchemaがあって初めてキャッシュの最低しきい値に達するリクエストが、しきい値を下回る可能性があるという点も注意を促しています。
Tool Retrieval の現時点での使用制限
以下の点は公式ドキュメントに記載されている内容で、開発時に最もつまずきやすい箇所です。
- 読み込んだツールはアンロードできない:スキーマは一度取得されると、そのセッション中ずっと保持されます。非常に長いセッションで新しいツールを検索し続けると、コンテキストは増え続けてしまいます。
- リクエストごとにツール配列全体を再送信する:
tool_search、遅延ツールと非遅延ツールのすべて、および関連する MCP 設定を含みます。nameとshort_descriptionだけを渡してparametersを省略することはできません。 - システム指示で直接指定したツールは遅延させない:モデルが検索を迂回して直接呼び出し、読み込みコンテキストが欠けた状態でエラーになる可能性があります。
- ステートレスなセッションでは検索手順を完全に保持する:
store=falseで履歴を自分で管理する場合、tool_search_call、tool_search_resultとそのsignatureは削除・変更できません。そうしないと HTTP 400 が返される可能性があります。 - デバッグでは steps を確認する:
interaction.statusがrequires_actionでなくても、結果に実行待ちのfunction_callが含まれていることがあります。 - ヒットしない場合はテキストが返ることがある:サーバー側の検索で一致するツールが見つからない場合、必ずしも構造化されたエラーが返されるとは限りません。
分析と評価:Gemini API の Tool Retrieval は Agent 開発にとって何を意味するか
Tool Retrieval の適用シーン判断
今回のアップデートの実質的な価値は、「完全なツールリストを維持すること」と「毎回の推論でそのリストをすべて読み終えること」を、二つの別々の事柄に切り分けた点にあります。ツールライブラリは拡張を続けられますが、モデルのコンテキストに常駐するのは、とても薄いカタログだけになります。新しい業務システムを継続的に接続していくチームにとって、これは事前にツールセットを絞り込む負担を軽減します。また、Token を抑えるためにアプリケーション側で毎回動的にツールを選別し、その結果キャッシュプレフィックスを壊してしまう状況も減らせます。
ただし、公式の試算例は、そのメリットに条件があることをすでに示しています。公式のエンジニアリング推奨を踏まえ、次の表で初步的な判断ができます(これはエンジニアリング上の選択に関する推奨であり、厳密な数量の基準ではありません)。
| Agent の種類 | ツールの特徴 | 推奨 |
|---|---|---|
| カスタマーサポート、業務フローアシスタント | 数十個のツールがあり、少数の照会系が高頻度、返金・承認・契約などは低頻度 | 高頻度のものは直接ロードし、ロングテールはサーバー側で検索 |
| 複数 MCP サーバーの開発/運用保守 Agent | 各サーバーのツールが多いが、1 回のタスクで使うのはごく一部 | MCP サーバー全体に defer_loading を設定 |
| マルチテナント、権限に応じてツールを開放するプラットフォーム | ツール集合がユーザーやワークスペースによって変わる | クライアント側で検索し、自前のレジストリと権限フィルタを組み合わせる |
| 小型アシスタント | 約 20 個未満の安定したツールで、その多くが毎回使われる | 引き続き静的ロード |
| ロングコンテキスト + 頻繁な検索 | 会話が長く、毎回何度も検索が必要になりがち | まず測定してから決定する。正味コストが上昇するリスクがある |
私たちの判断は、ツール呼び出しの分布が「ロングテール」であるほど、Tool Retrieval は使う価値があるというものです。逆に、ほとんどのツールが毎回使われるのであれば、遅延ロードは単に 1 回分の検索推論を増やすだけになります。
Tool Retrieval へ移行する前に、ツール Schema の実際の占有量を測っておこう
移行すべきかどうかを判断する最も信頼できる根拠は、自社の業務データそのものです。移行の前に、既存の OpenAI 互換 Function Calling フローを使って、「全ツールを渡した場合」と「実際に使うツールだけを渡した場合」の 2 種類のリクエストで入力 Token の差を測れば、ツール Schema が実際にどれだけ占有しているかが分かります。以下のスクリプトはこうしたベースライン測定を行うものであり、Tool Retrieval そのものではありません。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース。静的ロードのベースライン測定用
)

def make_tool(name, desc):
    return {"type": "function", "function": {
        "name": name, "description": desc,
        "parameters": {"type": "object",
                       "properties": {"order_id": {"type": "string"}},
                       "required": ["order_id"]}}}

all_tools = [make_tool(f"crm_tool_{i}", f"CRM operation {i}") for i in range(50)]
messages = [{"role": "user", "content": "查询订单 A-1042 的状态"}]

for label, tools in [("全量 50 个工具", all_tools), ("仅 1 个工具", all_tools[:1])]:
    resp = client.chat.completions.create(
        model="your-model-id", messages=messages, tools=tools)
    print(label, "prompt_tokens =", resp.usage.prompt_tokens)
完全版のベースライン測定スクリプトを見る(ツール数ごとの一括比較)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース経由で各モデルのツール Schema オーバーヘッドを測定
)

def load_tools(path: str) -> list:
    """業務用ツールレジストリ(JSON ファイル)から OpenAI 形式のツール定義を読み込む"""
    with open(path, "r", encoding="utf-8") as f:
        return json.load(f)

def measure(model: str, tools: list, prompt: str) -> int:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools if tools else None,
        max_tokens=16,
    )
    return resp.usage.prompt_tokens

def baseline_report(model: str, tools: list, prompt: str, steps=(0, 10, 20, 50, 100)):
    base = measure(model, [], prompt)
    print(f"无工具基础输入: {base} tokens")
    for n in steps:
        if n == 0 or n > len(tools):
            continue
        used = measure(model, tools[:n], prompt)
        print(f"{n:>4} 个工具: {used} tokens, Schema 约占 {used - base} tokens")

if __name__ == "__main__":
    tools = load_tools("tool_registry.json")
    baseline_report("your-model-id", tools, "查询订单 A-1042 的状态")
🎯 技術的なヒント:Tool Retrieval を評価する前に、APIYI apiyi.com 上で 1 つの APIキーを使い、複数の主要モデルで静的ロードのベースラインを実行してみましょう。ツール Schema が自分のリクエストの中で実際にどれだけの Token を占めているのかを把握できます。ベースラインが得られたら、次に Gemini Interactions API で
tool_searchを有効にして対照実験を行い、total_input_tokensとtotal_tool_use_tokensの合計を比較してください。
補足しておきたいのは、Tool Retrieval は Interactions API の v1beta インターフェースと専用フィールドに依存しているという点です。上記の OpenAI 互換呼び出しは、あくまで静的ロードのオーバーヘッドを測るためのものです。対照テストでは、モデル・ツールライブラリ・タスクセット・コンテキスト長・キャッシュ条件を揃えたうえで、合計課金コスト、エンドツーエンドの所要時間、正しいツール選択率、平均検索回数を比較すると、差異を検索戦略の違いにきちんと帰属させられます。同じスクリプト群の中で複数モデルのベースライン差を横並びで確認したいなら、APIYI apiyi.com の統一インターフェースを使えば各社を個別に接続する手間を省けます。
注目すべき今後の展開(予測的判断)
以下は判断であり、確認済みの事実ではありません。
第一に、アナウンスと開発ドキュメントではサポート対象モデルの範囲に差異があり、Gemini 4 Carbon、Gemini 4 Neon といったモデルが互換リストに入るかどうかは、ドキュメントの更新を注視する必要があります。第二に、「ロード済みの Schema をアンロードできない」という点は長セッション Agent の明らかな弱点であり、正式版でアンロードや淘汰の仕組みが提供されるかどうかが、長いタスクでの性能に直接影響します。第三に、Google ADK のユーザーは以前 Issue #7241 で段階的ローディングとキャッシュ無効化の問題を報告しており、モデル API が新機能をサポートしたからといってフレームワークが自動的に採用するわけではないため、フレームワーク層での対応ペースを追跡する価値があります。
ツール定義をオンデマンドで読み込むという考え方は、業界では以前から先例があり、Google は今回それを Gemini の Agent インターフェースに組み込んだ形です。Preview 段階ではインターフェースが変更される可能性があるため、本番システムに組み込む際は静的ローディングへフォールバックするスイッチを残しておくことをお勧めします。
Gemini API Tool Retrieval に関するよくある疑問
Q1:Tool Retrieval を有効にすると、リクエストボディは小さくなりますか?
いいえ。サーバーサイドモードでは毎回のリクエストで完全なツール配列を送信する必要があり、小さくなるのはモデルの初期コンテキスト内でのツール占有量です。既存のリクエストに含まれるツール定義の量を先に把握したい場合は、前述のスクリプトを使って APIYI apiyi.com 経由でベースラインを測定できます。
Q2:Google の公式発表では 85% 節約できるのですか?
そのような実測結果はありません。85.6% はツール 200 個という仮定のケースから試算された数値であり、同じドキュメントにはツール数が少ない場合に Token が約 36.5% 増加するという反例も示されています。
Q3:Tool Retrieval は課金されますか?
単独の機能利用料はありませんが、検索命令、追加の推論、読み込まれた Schema はいずれもモデルの料金レートで Token が課金されます。予算に敏感なチームは、まず APIYI apiyi.com を通じて従量課金で小規模にさまざまなモデルの Function Calling コストをテストし、そのうえで Agent のモデル選定を決めるとよいでしょう。
Q4:Tool Retrieval を使えば、自分で関数を実行する必要はなくなりますか?
いいえ。カスタム関数は依然としてアプリケーション側で実行し、結果を返す必要があり、Tool Retrieval はツール定義を見つけて読み込む役割だけを担います。API が代行して呼び出すのはリモート MCP ツールのみです。
ツールライブラリはどんどん大きくなりますが、各ラウンドで本当に必要になるのは、そのうちのごく数個であることが多いものです。Tool Retrieval は「ツールを揃える」ことと「必要に応じて取り出す」ことを切り分けて扱います。うまく使えば大規模 Agent をより軽くできますが、使い方を誤ると推論 1 ラウンド分を余計に支払う代償にもなり得ます。『論語・衛霊公』にあるように、「工欲善其事、必先利其器」(仕事をうまく進めたいなら、まず道具を研ぎ澄ませよ)。まず手元の一つひとつの「器」の重さを量り、それからどう配置するかを決めましょう。
📚 参考資料
-
Google 公式発表: Introducing Tool Retrieval in the Gemini API(2026-11-19)
- リンク:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - 説明:リリース情報、設計目標、2種類の検索モードと料金設定の原則
- リンク:
-
Google Tool Retrieval 開発ドキュメント:設定、制限、課金と計算例
- リンク:
aistudio.google.com/docs/tool-retrieval - 説明:対応モデル一覧、Usage フィールド、ベストプラクティスとよくあるエラー
- リンク:
-
Gemini Developer API の料金:モデルの標準価格とキャッシュ料率
- リンク:
aistudio.google.com/docs/pricing - 説明:各モデルの入力・出力単価および適用開始日
- リンク:
-
Interactions API ドキュメント:インターフェースの位置づけと実行ステップ
- リンク:
aistudio.google.com/docs/interactions-overview - 説明:ステートフルな対話、steps 構造、および generateContent との違い
- リンク:
-
Google Python SDK v3.6.0 と Issue #2185:実装面の裏付けと開発者ニーズの記録
- リンク:
github.com/googleapis/python-genai/releases/tag/v3.6.0 - リンク:
github.com/googleapis/python-genai/issues/2185 - 説明:SDK の公開 Schema 更新と初期のコミュニティニーズ
- リンク:
作者:APIYI 技術チーム
技術交流:APIYI apiyi.com のトップページからお気軽にお問い合わせください。接続に関する詳しい資料は docs.apiyi.com ドキュメントセンターでご覧いただけます