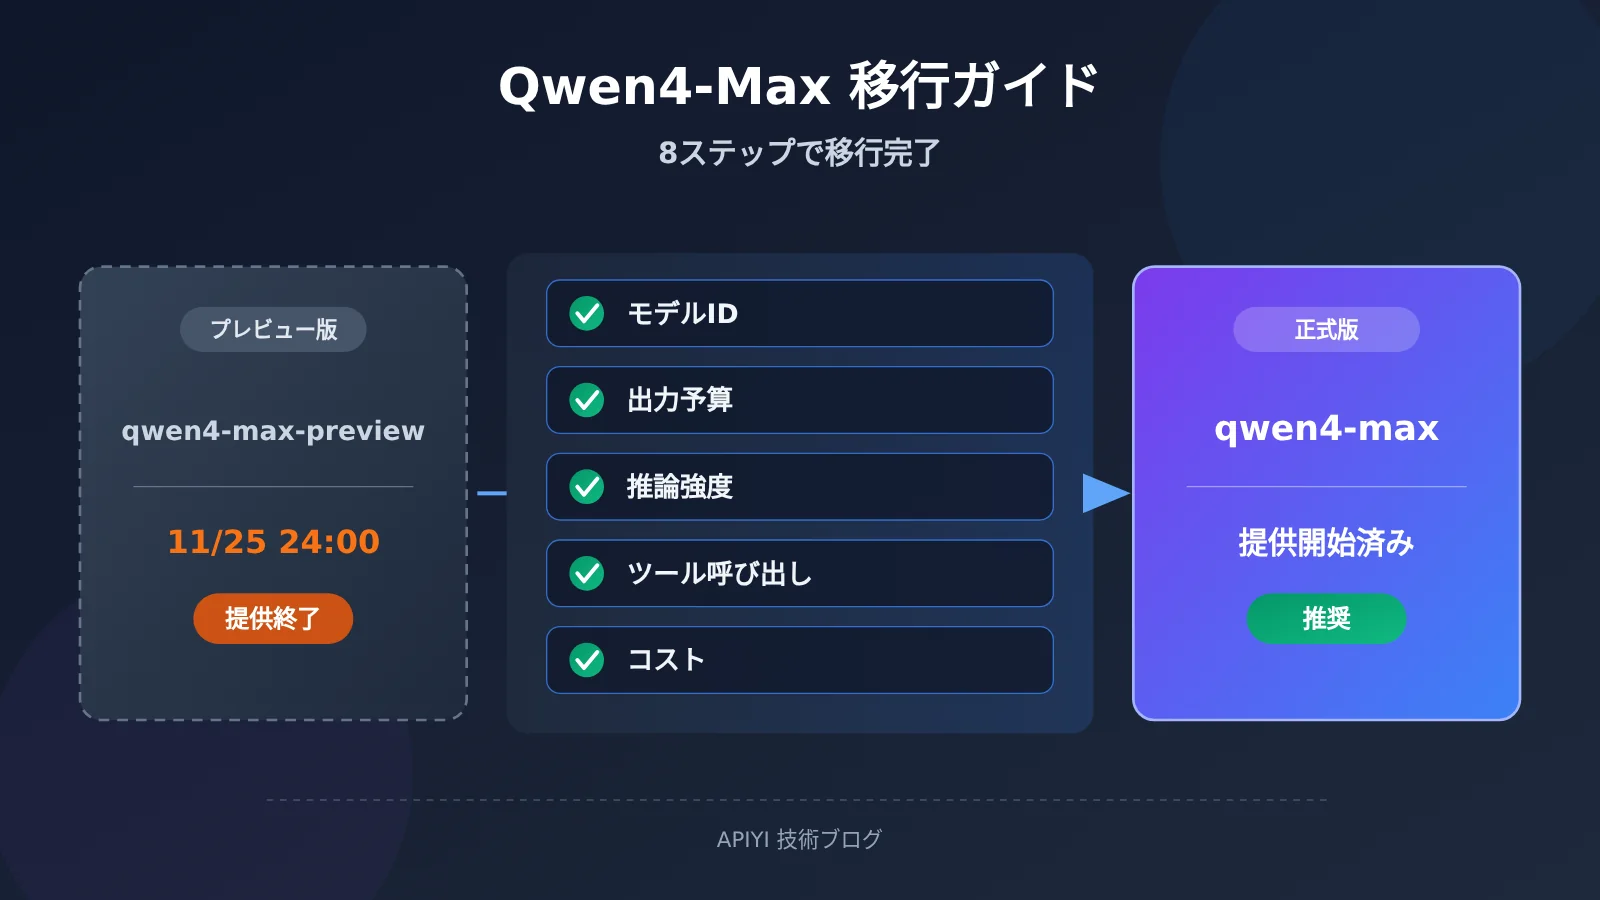
要約:本記事では、Qwen4-Max-Preview と正式版 Qwen4-Max の出力予算、推論のデフォルト値、課金方式を比較し、11月25日のPreview提供終了前に項目ごとに実行できる移行チェック手順を示します。
Qwen4-Max-Preview は 2026年11月25日 24:00(UTC+8)にプレビューを終了し、提供を終了します。正式版 Qwen4-Max は11月16日にリリースされ、モデル ID は qwen4-max です。正式版へ移行する際は、連携プロダクト、出力予算、推論のデフォルト値、ツールの挙動、コストの5項目を同時に確認する必要があります。両バージョンとも100万トークンのコンテキストウィンドウを提供しますが、正式版では思考モードの出力上限が393,216から262,144に下がり、デフォルトの推論強度がxhighからhighに変わり、課金もToken Plan Creditsから従量課金へと広がります。モデル ID を変更するだけでは、本番タスクの結果が同じになることは保証できません。
以下ではまず、Preview と正式版のタイムラインと仕様の違いを整理し、続いて正式版の APIプロトコル、リージョン、価格、キャッシュを紹介します。その後、「ベースラインの保存、接続設定、リクエストパラメータ、機能検証、請求の監視、段階的ロールアウト」の順に移行チェックリストを示し、最後に長文レポート、コード生成、マルチターンAgentなどのタスクにおける受け入れ要点を挙げます。読み終えると、今回の切り替えをチームで再利用できるモデルバージョン管理プロセスとして整理できるようになります。
知っておきたい:Qwen4-Max 移行用語
| 用語 | 説明 |
|---|---|
| Model ID | リクエスト内で特定のモデルバージョンを指定するための識別子。たとえば qwen4-max など。 |
| Base URL | クライアントが特定の製品、特定リージョンのサービスに接続する際に使用するインターフェースのベースアドレス。 |
| コンテキストウィンドウ | 1回のリクエストでモデルが処理できる総容量。入力、履歴、生成内容を含みます。 |
| 出力予算 | 1回のリクエストで生成できる Token の上限。思考モードでは、推論内容と最終回答がこの予算を共有します。 |
| reasoning_effort | 推論の強度を制御するリクエストパラメータ。Preview と正式版ではデフォルト値が異なります。 |
| thinking_budget | 思考 Token の予算を制御するパラメータ。Preview では reasoning_effort と同時に設定できません。 |
| Token Plan | 阿里云百炼のサブスクリプションサービス。Credits で計量され、Preview における唯一の接続チャネルでもあります。 |
| Function Calling | モデルがツール定義に基づいて呼び出しリクエストを返し、アプリケーションがツールを実行して結果を返す仕組み。 |
| JSON Schema | JSON データの構造、フィールド、制約を記述する仕様。モデルの出力形式を制約するために使用します。 |
| TTL | キャッシュの保持期間。キャッシュ再利用の範囲と、それに伴う費用に影響します。 |
| リグレッション検証 | 既存の代表的なタスクを使って、バージョン切り替え後の機能、結果、コストの変化を確認すること。 |
1 Qwen4-Max-Preview はいつ終了するのか、正式版はいつ公開されるのか
1.1 Qwen4-Max のバージョンタイムライン
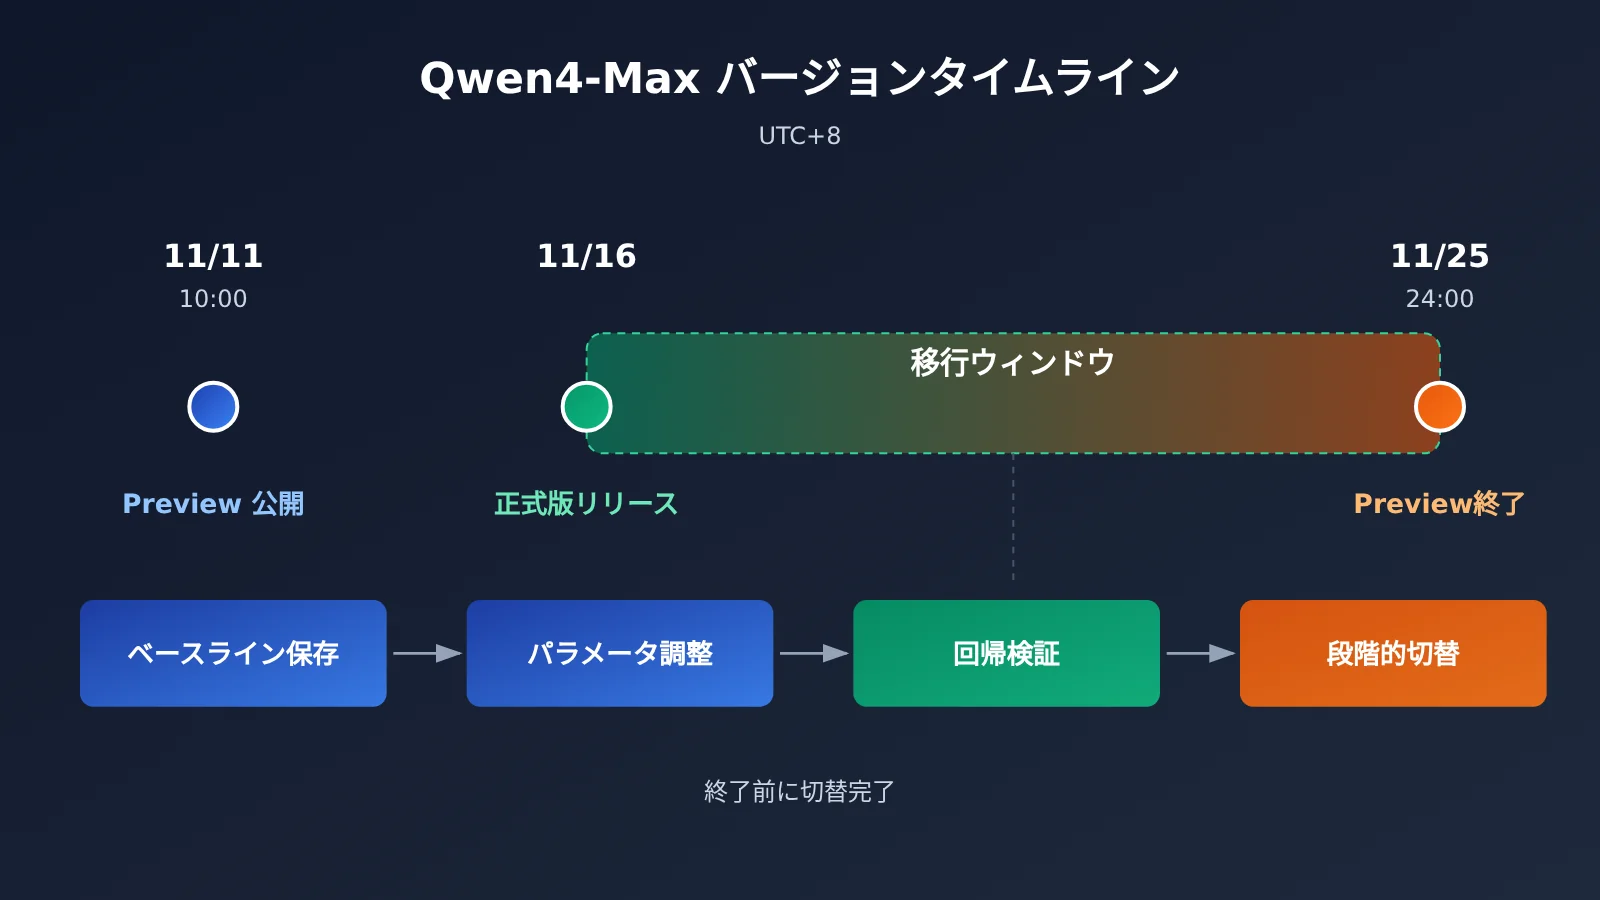
Alibaba Cloud Token Plan の機能更新記録には、2つの独立したイベントが記載されています。11月11日に Preview が公開され、11月16日に正式版が公開されました。正式版のリリース後も、Preview に当初設定されていた提供終了日は変更されていません。Preview の公式ドキュメントの冒頭にも、「正式版 Qwen4-Max が公開されました。正式版の利用を推奨します」という案内が表示されています。
| 日時(UTC+8) | イベント | 開発者にとっての意味 |
|---|---|---|
| 2026-11-11 10:00 | Qwen4-Max-Preview 公開 | Token Plan の個人版またはチーム版からのみ呼び出し可能 |
| 2026-11-16 | Qwen4-Max 正式版公開 | 従量課金 API に対応。Token Plan 経由でも利用可能 |
| 2026-11-25 24:00 | Preview のプレビュー期間終了・提供停止 | qwen4-max-preview は呼び出せなくなり、フォールバック先としても使用不可 |
1.2 2つのモデル ID とそれぞれのチャネル
Preview のモデル ID は qwen4-max-preview、別名は qwen4.0-max-preview です。どちらの ID でも呼び出し可能で、請求書には統一して qwen4.0-max-preview と表示されます。Preview の接続方法は、Token Plan 専用の APIキーと専用 Base URL https://token-plan.cn-beijing.maas.aliyuncs.com を使う形で、従量課金には対応していません。
正式版のモデル ID は qwen4-max です。正式版には2つの利用経路があります。1つは Token Plan の個人版またはチーム版、もう1つは百炼(Model Studio)の従量課金 API です。この2つの経路では、キー、Base URL、課金方式がそれぞれ異なるため、移行する際にはまずどちらを使うかを決める必要があります。
2 Qwen4-Max-Preview と正式版の仕様差異
2.1 Qwen4-Max 仕様対照表
以下のデータは Preview 版と正式版の公式モデルドキュメントに基づいています。
| 技術指標 | Qwen4-Max-Preview | Qwen4-Max 正式版 |
|---|---|---|
| Model ID | qwen4-max-preview |
qwen4-max |
| コンテキストウィンドウ | 1,000,000 | 1,000,000 |
| 最大入力(非思考 / 思考) | ドキュメントに単独記載なし | 991,808 / 983,616 |
| 最大出力(非思考モード) | ドキュメントに単独記載なし | 131,072 |
| 思考 + 回答の最大合計 | 393,216 | 262,144 |
| デフォルトの推論強度 | xhigh | high |
| デフォルトの思考予算 | Preview のインターフェースパラメータによる | 131,072 |
| API プロトコル | OpenAI Chat Completions、Responses、Anthropic Messages | 上記3つ + DashScope |
| 課金方式 | Token Plan Credits のみ | 従量課金 API、または Token Plan |
2.2 コンテキスト・入力・出力・思考予算の違い
この4つの数字が示す対象はそれぞれ異なり、移行時に最も混同しやすいポイントです。コンテキストウィンドウは1回のリクエストで処理できる総容量で、両バージョンとも100万です。最大入力は1回に詰め込める資料の上限を決めます。正式版では思考モードで983,616となり、非思考モードより少し少なくなりますが、その分の余裕は推論に割り当てられます。最大出力は1回で生成できる Token の上限を決め、思考予算はそのうちどれだけを推論に使えるかを決めます。
最も大きな変化は出力側にあります。Preview では思考と回答が393,216 Tokensを共有しますが、正式版では思考モードでの合計上限が262,144、デフォルトの思考予算は131,072です。デフォルト設定で試算すると、正式版で最終回答に残される領域は約13万 Tokensです。Preview 上で1回あたり20万以上の長い出力に依存している業務がある場合、切り替え後は出力方式を再設計する必要があります。
3 Qwen4-Max 正式版のAPI接続機能とコスト
3.1 プロトコルと機能
正式版は、OpenAI Chat Completions、OpenAI Responses、Anthropic Messages、DashScope の4種類のプロトコルに対応しています。機能面では、公式が Function Calling、並列ツール呼び出し、Web検索、JSON Object、JSON Schema、明示的キャッシュ、暗黙的キャッシュ、さらに推論チェーンの要約と暗号化を挙げています。
Preview と比べると、正式版のドキュメントでは DashScope プロトコル、並列ツール呼び出し、2種類のキャッシュに関する説明が新たに追加されています。これまでのアプリケーションが単一の tool_call しか処理していなかった場合は、1回のレスポンスで複数のツール呼び出しが返されるケースを正しく扱えるか、コードを確認しておきましょう。
3.2 リージョンと従量課金価格
正式版の従量課金APIは6つのリージョンをカバーしています。リージョンを選ぶ際は、価格だけでなく、ネットワーク遅延、データの所在要件、業務の展開範囲も考慮する必要があります。各リージョンの具体的な提供機能は、公式の機能マトリクスを参照してください。
| リージョン | 展開範囲 | 入力(元/百万トークン) | 出力(元/百万トークン、思考を含む) |
|---|---|---|---|
| 華北2(北京) | 中国内地 | 10 | 30 |
| アメリカ(バージニア) | グローバル | 10 | 30 |
| ドイツ(フランクフルト) | グローバル | 10 | 30 |
| 日本(東京) | グローバル | 10 | 30 |
| 中国香港 | グローバル | 10 | 30 |
| シンガポール | 国際 | 10.938 | 32.813 |
北京リージョンの公式ページには、100万トークンの無料枠が掲載されており、有効期間は90日です。起算日は、百錬(Bailian)の開通、モデルのリリース、申請の承認などの条件のうち、最も遅い時点となります。上記の価格は正式版にのみ適用されます。Preview の2割引、および夜間割引を重ねた8%の料率は Token Plan Credits による優遇措置であり、正式版のコスト試算にそのまま流用することはできません。
3.3 明示的キャッシュと暗黙的キャッシュ
正式版では、キャッシュは個別に課金されます。明示的キャッシュは開発者が能動的に作成するもので、システムプロンプト、ツールの説明、固定の参考資料など、長期間変わらないプレフィックスを対象とするのに適しています。TTL は5分または1時間から選択でき、Chat Completions、Responses、Anthropic Messages に対応します。暗黙的キャッシュは、同一のプレフィックスの繰り返しなどの条件に基づいてプラットフォームが自動的に処理するもので、追加の設定は不要です。
マルチターンのエージェントでは、毎ターン同じツール定義と背景資料を送信します。キャッシュを適切に活用すれば、重複入力のコストを明確に削減できます。TTL は会話の間隔に応じて選びましょう。やり取りが密なセッションには5分、間隔の長いバッチ処理フローには1時間を検討するとよいでしょう。
4 Qwen4-Max-Preview から正式版へ移行するための操作ステップ
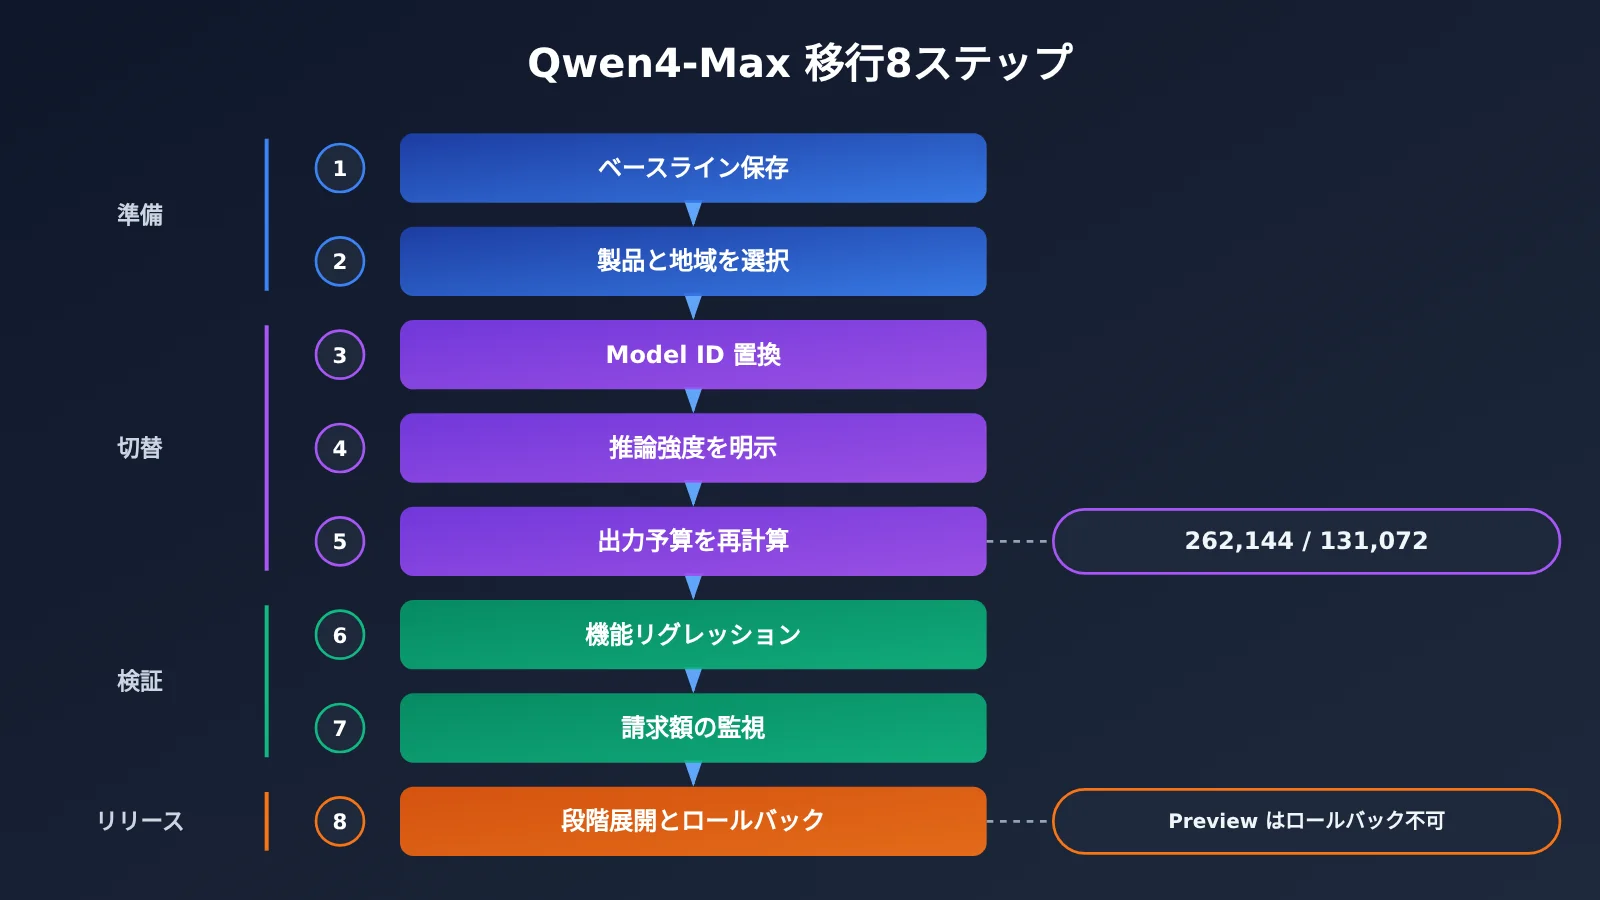
以下に示す 8 ステップは、公式仕様に基づいて整理した開発者向けのチェックフローです。公式からは自動移行ツールが提供されておらず、すべてのリクエストパラメータがシームレスに互換であるとも宣言されていません。そのため、各ステップを自社の業務環境で実際に検証する必要があります。
| ステップ | チェック項目 | 合格基準 |
|---|---|---|
| 1 | 旧設定と代表タスクを保存 | Preview のリクエストパラメータ、出力サンプル、所要時間、使用量がアーカイブ済み |
| 2 | 接続プロダクトを選択し、リージョン・Key・Base URL を確認 | バックエンドサービスは従量課金 API、インタラクティブツールは Token Plan を使用 |
| 3 | model を qwen4-max に置き換え |
スモークリクエストが正常に返り、請求書上のモデル名が正しい |
| 4 | 推論強度を明示的に設定 | タスクごとに reasoning_effort または対応するフィールドを明記し、デフォルト値に依存しない |
| 5 | 出力バジェットを再計算 | 思考モードの合計 ≤ 262,144、非思考モード ≤ 131,072 |
| 6 | ツール呼び出し、JSON 構造、長文出力、複数ターンの履歴を検証 | 代表タスクの合格率が Preview のベースラインと同等 |
| 7 | 使用量とキャッシュ請求を観察 | 入力・出力・キャッシュの各費用が想定どおり |
| 8 | 小流量で切り替え、ロールバック設定を準備 | ロールバック先が有効なモデルであり、Preview は含まれない |
4.1 旧構成の保存と代表タスクの選定
Previewの提供終了前に、qwen4-max-preview を呼び出しているすべての構成をエクスポートしておきましょう。max_tokens、reasoning_effort または thinking_budget、ツール定義、response_format、システムプロンプトなどが対象です。あわせて、代表的なタスクを10〜30件ほど選び、Previewの出力・所要時間・使用量を比較用のベースラインとして保存します。11月25日以降は、Previewの結果を取得できなくなります。
4.2 接続先プロダクトの選定とKey・Base URLの確認
Token Planは、Claude Code、Cursor、Qwen Code、Qoderといったコーディングツールやエージェントツール上での対話的な利用に限られます。自動化スクリプト、自社アプリのバックエンド、ワークフロープラットフォームからの一括呼び出しは許可範囲外であり、違反するとサブスクリプションの一時停止やKeyの凍結につながる可能性があります。PreviewをQoderなど特定のツール内でしか使っていない場合は、引き続きToken Planで正式版へ切り替えられます。自社バックエンドに接続する場合は、正式版の従量課金APIへ移行し、コンソールで該当リージョンのKeyとBase URLを使用してください。
Token Planの個人版には、データ利用許諾に関する条項もあります。利用期間中、入力内容と生成内容はサービス改善に利用されます。機密資料を扱うチームは、接続先プロダクトを選ぶ際にこの条項も評価対象に含める必要があります。
4.3 Model IDを置き換える:Qwen4-Max クイックスタート
モデルIDを qwen4-max に変更するだけで、最初のリクエストを送信できます。以下はOpenAI互換インターフェースを使った最小例です。まずリクエストが正常に通ることを確認し、その後でパラメータ調整に進みます。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIの統一インターフェース。百炼の該当地域に対応するBase URLに置き換えることもできます
)

resp = client.chat.completions.create(
    model="qwen4-max",                   # 元の値は qwen4-max-preview
    messages=[{"role": "user", "content": "用三句话说明你的版本信息"}],
    reasoning_effort="high",             # 明示的に指定し、デフォルト値に依存しない
    max_tokens=8192
)
print(resp.choices[0].message.content)
同じOpenAI互換インターフェースで利用できるモデルは、プラットフォームのリアルタイムなモデルリストを基準にしてください。本番環境ではリリース前にもう一度確認してください。
4.4 推論パラメータを明示的に設定する
Previewではデフォルトがxhigh、正式版ではデフォルトがhighです。元のコードで推論強度を指定していない場合、切り替え後に推論強度が自動的に低下し、複雑なタスクの品質、所要時間、Token使用量が変化する可能性があります。タスクの種類に応じて推論強度を明示することをおすすめします。複雑なコードや科学研究系の推論では、まずPreviewと同じ強度をベースラインとして比較し、単純な抽出やフォーマット整形のタスクでは下げて試してみてください。
Previewのドキュメントでは、reasoning_effort と thinking_budget を同時に設定できないと規定されています。正式版におけるChat Completions、Responses、Anthropic Messages、DashScopeの4つのプロトコルでのフィールド名と値は、対応するプロトコルのドキュメントを基準にしてください。Previewではマルチターン会話で preserve_thinking がデフォルトで有効になり、過去の思考内容を reasoning_content フィールドに戻す必要があります。アプリケーションが思考内容を返送する場合も、正式版で履歴メッセージの形式が正しく受け付けられることを検証する必要があります。
4.5 新しい上限に基づく出力予算の再計算
Preview では max_tokens と max_completion_tokens は等価で、思考と回答が 393,216 の総予算を共有します。正式版になると、思考モードの総予算は 262,144、非思考モードの出力上限は 131,072 です。Preview 上で 262,144 を超える値を設定していたリクエストは、すべて引き下げる必要があります。もともと予算が厳しめだったリクエストでは、デフォルトの思考予算 131,072 が占める分も考慮しなければなりません。
完全な移行設定コードを表示(予算チェック+フォールバック)
from openai import OpenAI

# 正式版の公式上限(思考モードは思考と回答の合計)
LIMITS = {
    "qwen4-max": {"thinking": 262_144, "non_thinking": 131_072},
}

def plan_max_tokens(model: str, thinking: bool,
                    answer_tokens: int, thinking_tokens: int = 0) -> int:
    """モードごとに max_tokens を計算し、公式上限を超える場合は即座にエラーにして暗黙の切り捨てを防ぐ"""
    limit = LIMITS[model]["thinking" if thinking else "non_thinking"]
    need = answer_tokens + (thinking_tokens if thinking else 0)
    if need > limit:
        raise ValueError(f"{model} 预算 {need} 超过上限 {limit},请拆分任务")
    return need

PRIMARY = {
    "model": "qwen4-max",
    "base_url": "https://api.apiyi.com/v1",  # APIYI の OpenAI 互換エンドポイント
    "reasoning_effort": "high",
}
# フォールバック先は現役のモデルである必要がある。qwen4-max-preview はサービス終了後に使えない
FALLBACK = {
    "model": "YOUR_FALLBACK_MODEL",
    "base_url": "https://api.apiyi.com/v1",
}

def call(cfg: dict, messages: list, max_tokens: int):
    client = OpenAI(api_key="YOUR_API_KEY", base_url=cfg["base_url"])
    kwargs = {"model": cfg["model"], "messages": messages, "max_tokens": max_tokens}
    if "reasoning_effort" in cfg:
        kwargs["reasoning_effort"] = cfg["reasoning_effort"]
    return client.chat.completions.create(**kwargs)

def run(messages: list, answer_tokens: int = 60_000, thinking_tokens: int = 131_072):
    budget = plan_max_tokens("qwen4-max", True, answer_tokens, thinking_tokens)
    try:
        resp = call(PRIMARY, messages, budget)
    except Exception as e:
        print(f"主模型失败,切换回退:{e}")
        resp = call(FALLBACK, messages, min(budget, 32_000))
    choice = resp.choices[0]
    if choice.finish_reason == "length":
        print("警告:输出因长度被截断,需要拆分任务或调整预算")
    print("用量:", resp.usage)
    return choice.message.content

if __name__ == "__main__":
    print(run([{"role": "user", "content": "生成一份模型迁移回归报告的大纲"}]))
4.6 ツール呼び出し、構造化出力、長い出力の検証
代表的なタスクを使って、項目ごとにリプレイします。Function Calling が同じツール名とパラメータ構造を返すか、並列ツール呼び出しがコード側で正しく処理されるか、JSON Schema の出力が既存のバリデータを通過できるか、長い出力が finish_reason == "length" で終了するか、複数ターンの履歴を戻した後にコンテキストが一貫しているか、といった点を確認します。各項目は 4.1 で保存したベースラインと比較し、差異を記録します。
4.7 使用量とキャッシュの請求を確認する
Credits から従量課金に切り替えた後は、入力・出力(思考を含む)・キャッシュの3項目ごとにコストを計算する必要があります。正式版の出力単価は入力の3倍で、さらに思考トークンも出力に計上されるため、推論の強度設定が請求額に直接影響します。まず北京リージョンの無料枠でリグレッションを一通り実行し、その後、実際の使用量をもとに月額コストを試算するとよいでしょう。
4.8 少量トラフィックで切り替え、ロールバック設定を保持する
まず 5% から 10% のトラフィックを qwen4-max に切り替え、エラー率、切り捨て(トランケーション)率、1タスクあたりのコストを観察し、安定していることを確認してから全量切り替えを行います。ロールバック設定は、引き続きサービス中のモデルを指すようにします。たとえば同シリーズの他の利用可能なバージョンや、すでに検証済みの他社モデルです。Preview は提供終了後、ロールバック先として使用できません。
🎯 技術的なアドバイス:ロールバック用モデルは、できればグレーリリース前に同じ代表タスク群で検証を完了しておくのが望ましいです。APIYI apiyi.com の OpenAI 互換インターフェースを利用すれば、1つの APIキーで複数の主要モデルを切り替えられ、
modelフィールドを変更するだけでロールバック演習を完了できます。
5 Qwen4-Max への移行後に最も発生しやすい問題
5.1 出力の切り捨て
これが最もよくある問題です。Preview では完全に生成できた長いレポートや大きなファイルが、正式版に切り替えた後、262,144 の上限やデフォルトの思考予算の消費によって切り捨てられる可能性があります。対処法は finish_reason を確認し、超長いタスクは章ごと、またはファイルごとに分割して生成し、同時に回答部分に明確な予算を確保することです。
5.2 デフォルトの推論強度の低下
xhigh から high に下がると、複雑なタスクの性能が変化する可能性があり、簡単なタスクでは所要時間とコストが下がる可能性があります。推論パラメータを記述しないコードは、知らないうちに動作が変わってしまいます。すべての本番リクエストでは推論強度を明示的に設定し、A/B リプレイによってタスク種別ごとに適切なレベルを確定すべきです。
5.3 ツール呼び出しとプロトコルの差異
正式版では並列ツール呼び出しが明確にサポートされており、1回のレスポンスに複数のツール呼び出しリクエストが含まれる場合があります。最初の tool_call だけを読み取るコードではツールの実行が漏れ、Agent フローが中断してしまいます。プロトコルを切り替える際、たとえば Chat Completions から DashScope に変更する場合、フィールド名や思考内容の返却方法についてもドキュメントと照合し直す必要があります。
5.4 キャッシュと課金基準の変化
Preview の Credits 消費は課金係数、キャッシュヒット、ツール呼び出しなどの要因に影響され、そのまま毎百万 Token の単価に換算することはできません。正式版では元/百万 Token の価格体系を採用し、キャッシュは別途課金されます。従来 Credits ベースで構築した予算モデルは再構築が必要で、明示的キャッシュの書き込みコストと TTL の選択も組み込む必要があります。
6 Qwen4-Max 正式版で再テストが必要なタスク
| タスク種別 | 重点検証項目 | 注目すべきパラメータ |
|---|---|---|
| 長文レポート生成 | 打ち切りがないか、章立てが完全か、事実関係に前後矛盾がないか | 出力バジェット、finish_reason |
| 複雑なコード生成 | コンパイルとテストの合格率、単一ファイルの長さ、ファイル間の一貫性 | reasoning_effort、出力バジェット |
| マルチターン Agent | ツール呼び出しの順序、並列呼び出しの処理、履歴思考の返送 | tool_calls、reasoning_content |
| 長文書検索 | 段落横断の関連付け精度、入力が 983,616 または 991,808 を超えていないか | 最大入力、キャッシュヒット |
| JSON 構造化出力 | Schema 検証の合格率、フィールド欠落と型エラー | response_format、JSON Schema |
長文書検索では特に注意が必要です。正式版の最大入力はモードによって異なり、思考モードは非思考モードより約 8,000 Tokens 少なくなります。上限ギリギリまで資料を詰め込むタスクでは、モードを切り替えると制限を超える可能性があります。コード系のタスクは、既存のユニットテストセットをそのまま再利用し、テスト合格率を合格基準にすることをおすすめします。人間が出力を読むより信頼性が高い方法です。
💡 選択のヒント:Qwen4-Max と他のフラッグシップモデルでこうしたタスクの性能を同時に比較したい場合は、APIYI apiyi.com の統一インターフェースで同一のタスクバッチをリプレイできます。ベンダーごとに個別のアダプターコードを書く手間を減らせます。
7 Qwen4-Max-Preview 移行に関するよくある質問
Q1:Qwen4-Max-Preview の提供終了後、旧リクエストは自動的に正式版へ転送されますか?
公式ドキュメントには、Preview が提供終了となり正式版の使用を推奨する旨のみが記載されており、自動転送については言及されていません。11月25日 24:00 までに、手動で model を `qwen4-max` に変更し、本文第4節のチェックを完了してください。
Q2:モデル ID を qwen4-max に変更するだけで十分ですか?
十分ではありません。出力上限、デフォルトの推論強度、課金方式がすべて変更されています。少なくとも出力予算の再計算、推論強度の明示的な設定、さらにツール呼び出しと構造化出力の回帰検証を行う必要があります。
Q3:Preview の2割引と夜間割引は正式版でも有効ですか?
これら2つの割引は、Token Plan における Preview の Credits 消費にのみ適用されます。正式版の従量制 API は、北京リージョンで入力10元、出力30元/百万トークンが基準となるため、コストを再試算する必要があります。
Q4:バックエンドサービスは引き続き Token Plan のキーを使用できますか?
できません。Token Plan は、指定されたコーディングツールまたはエージェントツール内での対話的な使用にのみ許可されています。自社開発アプリケーションのバックエンドでは、正式版の従量制 API に切り替えるか、APIYI apiyi.com のように OpenAI 互換インターフェースと従量制課金を提供する集約サービスを利用してください。
Q5:移行期間中に回帰環境を素早く構築するにはどうすればよいですか?
代表的なタスクを固定のリクエストセットとして整理し、同じコードで model フィールドを切り替えるだけでリプレイを完了できます。APIYI apiyi.com は新規ユーザーに無料のテスト枠を提供しており、フォールバックモデルの検証や比較に利用できます。
8 結語:モデルバージョン管理を Qwen4-Max の本番フローに組み込む
今回の Qwen4-Max-Preview から正式版への切り替えは、継続的に管理すべき5つの側面に関わっています。
- モデルID:設定センターで一元管理し、コード内にハードコードしない。あわせてモデルのライフサイクル告知を購読する。
- インターフェースパラメータ:推論強度、思考予算、response_format をすべて明示的に設定する。
- 出力制限:各モデルについてコンテキスト、最大入力、最大出力、思考予算の4つの数値を記録し、リクエスト送信前に検証する。
- コスト:入力、出力、キャッシュごとに監視し、課金モデルが変わった際には予算モデルを再構築する。
- 回帰テスト:代表的なタスクセットとベースライン結果を保持し、バージョンを切り替えるたびに完全にリプレイする。
Preview のライフサイクルはわずか2週間で、正式版の後にも新しいバージョンと提供終了計画が必ず存在します。「ベースラインの保存、パラメータの明示、段階的な切り替え、利用可能なロールバック」という固定フローを確立しておけば、次回のバージョン更新時には数日以内に移行を完了できます。複数モデルのロールバック方案を準備したいチームは、APIYI apiyi.com を通じて同一インターフェース上で検証を完了できます。
参考資料
-
Qwen4-Max 正式版の公式ドキュメント:コンテキスト、入出力の上限、デフォルトの推論強度、リージョン、価格とキャッシュ
- リンク:
help.aliyun.com/zh/model-studio/qwen4-max - 説明: 移行パラメータの主な根拠
- リンク:
-
Qwen4-Max-Preview の公式ドキュメント:Preview の仕様、接続方法、提供終了時期
- リンク:
help.aliyun.com/zh/model-studio/qwen4-max-preview - 説明: 旧設定を保存する際の照合根拠
- リンク:
-
Token Plan 機能アップデート:Preview と正式版の公開記録
- リンク:
help.aliyun.com/zh/model-studio/token-plan-product-updates - 説明: バージョンタイムラインの出典
- リンク:
-
Token Plan の権限と利用規範:インタラクティブ利用の範囲と禁止シナリオ
- リンク:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - 説明: 接続製品を選ぶ際のコンプライアンス根拠
- リンク:
-
Token Plan 個人版のサブスクリプションと特典:プラン、Credits と Preview の優待
- リンク:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - 説明: Preview 優待と正式版課金の区別
- リンク:
作者:APIYI 技術チーム
技術交流:APIYI apiyi.com のトップページからお問い合わせください。さらに詳しい接続資料は docs.apiyi.com ドキュメントセンターでご覧いただけます