概要:VibeVideoBench のコード駆動型動画タスクでは、GPT-6 Astra は Claude Opus 5.5 と同等の水準にあり、総合品質はやや高く、コストは低くなっています。Opus 5.5 のほうが納品は安定しています。OpenAI の次世代汎用モデルは未公開で、その動画能力は公開後の実測が必要です。
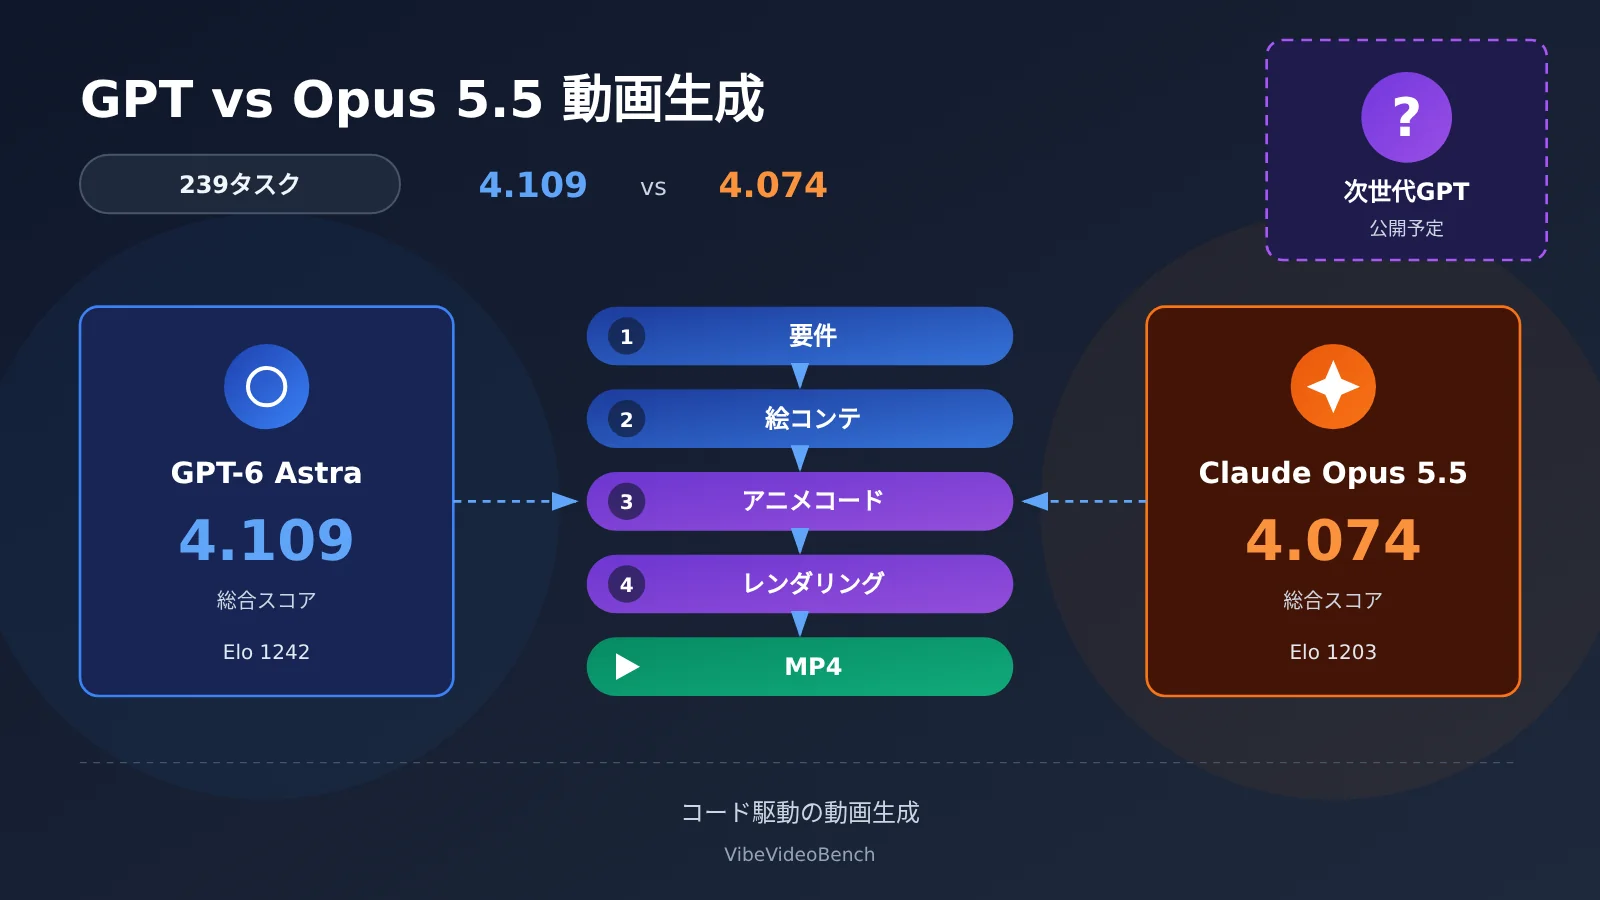
先に結論:2026年11月15日時点で、「エージェントがコードを書き、レンダリングツールを呼び出し、完全な MP4 を納品する」という路線において、GPT-6 Astra と Claude Opus 5.5 は VibeVideoBench で最も近接した2つのシステムです。Astra の総合品質スコアは 4.109、Opus 5.5 は 4.074。人手によるブラインドテストの Elo はそれぞれ 1242 と 1203 で、統計的には区別できません。Opus 5.5 は全239件のタスクを納品し、厳格なタスク成功率は76.3%で、Astra の74.5%を上回っています。Astra のタスクあたり平均 API コストは8.19ドルで、Opus 5.5 の約半分です。OpenAI は、内部モデルが Astra より有意に強いことを示す2つの証拠を公開していますが、次世代汎用 GPT の名称、公開時期、動画に特化した成績はいずれも未公表です。したがってタイトルの問いへの答えは、現行 GPT はすでに追いついており、次世代が差を広げられるかは公開後の実測次第、となります。
内容の予告:以下ではまず評価範囲を定め、VibeVideoBench の総合成績、カテゴリ別スコア、人手による選好、コストデータを分解して、両者それぞれの強みがどこから来るのかを説明します。続いて OpenAI 内部モデルの公開シグナルと次世代モデルの公開状況を整理し、動画エージェントの真のボトルネックを分析します。最後に、新モデル公開後にそのまま再利用できる比較テスト手法を提示し、既存の構成を置き換える価値があるかどうかを判断できるようにします。
To Know:本記事を読む前に知っておきたい用語
| 用語 | 説明 |
|---|---|
| Code-driven Video Generation | コード駆動型動画生成:AI がアニメーションとレンダリングプログラムを作成し、最終的に MP4 を出力します |
| Native Video Generation | ネイティブ動画生成:モデルがテキストや画像から直接動画の画面を生成します。代表的な製品には Sora、Veo があります |
| VibeVideoBench | AI Agent が自律的に完全な動画を制作することを専門にテストする評価ベンチマーク。2026年10月26日に公開 |
| Harness | モデルの実行環境。コード実行、ファイルアクセス、ツール呼び出しなどの機能を提供します(例:Codex CLI、Claude Code) |
| L1 / L2 / L3 | 評価の3層:プログラム納品チェック、タスク要件の項目別チェック、マルチモーダル審査による動画品質スコアリング |
| 厳格なタスク成功率 | 動画が正常に納品され、すべての制約を満たしたタスクの割合。単純な「納品率」よりも厳格です |
| Bradley–Terry Elo | 人手によるペアごとの比較結果から、モデルの相対的な選好を算出するスコアリング手法 |
| Multi-agent Orchestration | マルチエージェント編成:複数の Agent に役割を分担させて協力させ、その後で結果を統合します |
| Render Pipeline | 動画レンダリングパイプライン:画面生成、音声処理、エンコード・合成を経て最終出力に至る流れです |
| Remotion / FFmpeg | 前者は React コードで動画アニメーションを記述し、後者は音声・動画のエンコードと合成を担当します |
| ffprobe | FFmpeg に付属する検査ツール。動画の解像度、フレームレート、長さ、音声トラックなどの情報を読み取るために使います |
| Cache Hit | キャッシュヒット率:繰り返し利用されるコンテキストがキャッシュから読み込まれる割合。長いタスクの API コストに直接影響します |
| BenchCAD 2.0 | AI の3D部品再構築、機械組立設計、PCB接続認識能力をテストするエンジニアリング評価 |
1 結論から:GPTはすでにOpus 5.5の動画制作競争領域に入っている
1.1 本記事が比較する“動画を書く”とは何か
AI動画制作には現在2つのルートがあります。ネイティブ動画生成はモデルが直接連続した映像を出力するもので、人物、物理運動、カメラワークを得意とします。一方、コード駆動型動画生成はモデルを監督兼プログラマーとして機能させます。要件を理解し、スクリプトと絵コンテを書き、Remotion、Three.js、Cairo、Blenderでアニメーションをコーディングし、TTSでナレーションを生成し、FFmpegで合成して完成品をチェックする、という流れです。
本記事で扱うのは2番目のルート、すなわちCodex CLIやClaude CodeといったAgentを通じて完成したMP4と編集可能なプロジェクトを納品する能力です。このルートはデータ可視化、製品紹介、知識解説、動的インフォグラフィック、ブランドプロモーション映像に適しており、GPTとClaudeが現在独自のベンチマークで比較可能な領域でもあります。
OpenAI自身のネイティブ動画製品ラインはすでに変化しています。Sora製品は2026年4月26日にサービスを停止し、Sora 2モデルおよびVideos APIは9月24日に終了しました。公式の廃止告知には、1対1で代替するAPIはないと明記されています。11月4日にリリースされたGPT-Image-2.6は2~16フレームのGIFアニメーション出力をサポートし、スタンプ、ループアニメーション、絵コンテプレビューに適していますが、完全なMP4制作とは異なるワークフローです。したがって、GPTシリーズの“動画を書く”能力は、現在主にコード駆動型ルートに現れています。
1.2 タイトルの問いに一言で答える
GPT-6 AstraはVibeVideoBenchでOpus 5.5に極めて近く、総合スコアはやや高く、納品の安定性はやや低いです。OpenAIの次世代モデルにはさらなる向上を示す技術的シグナルがありますが、公開されている動画専用の成績は依然としてAstraが基準です。
2 239件の実動画タスク:GPT-6 Astra と Opus 5.5、どちらが強いのか?
2.1 VibeVideoBench は GPT と Opus 5.5 の動画能力をどう測定するのか
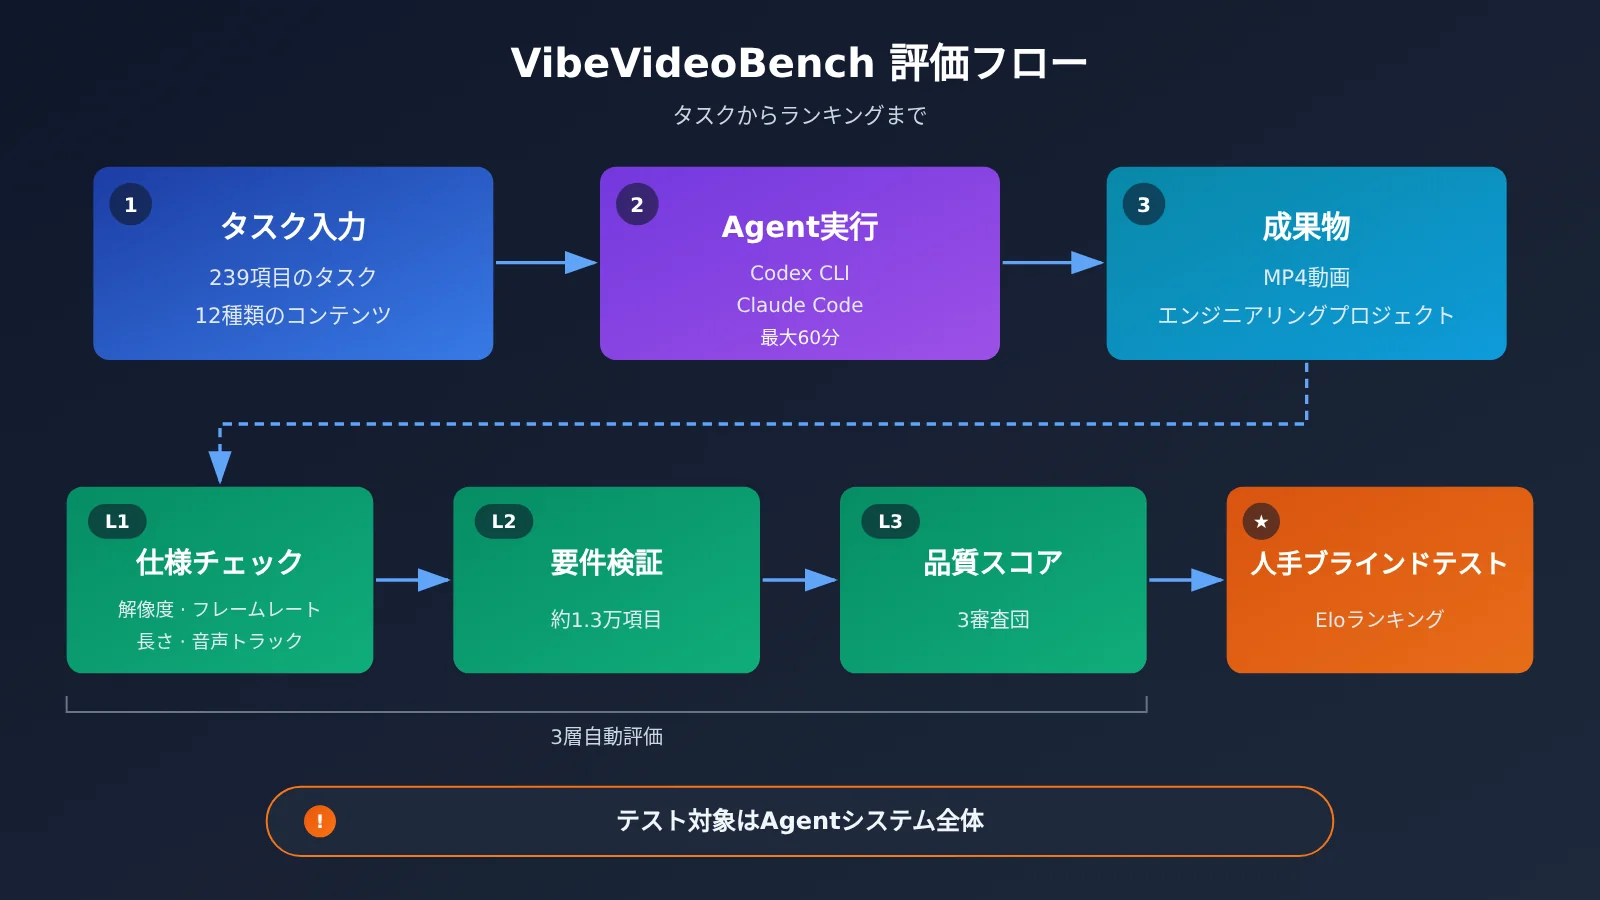
VibeVideoBench は239件の実動画制作タスクを構築し、12カテゴリのコンテンツをカバー、9つの Agent システム、計2,151回の実行をテストしています。各タスクは AI がサンドボックス内で自律的に完遂することを求められ、再生可能な MP4、動画を再生成できるエンジニアリングプロジェクト、そして制作手順書の納品が必要です。各タスクの制限時間は60分で、すべてのシステムはそれぞれのネイティブ開発環境と利用可能な最大の推論強度を使用し、途中で人的な指示を追加することはありません。
GPT-6 Astra は Codex CLI 上で、Claude Opus 5.5 は Claude Code 上で動作します。そのほかの参測システムには Claude Sonnet 5.5、Gemini 4 Argon、DeepSeek V4.1 Flash、Kimi K3、GLM-5.3 Flash、GPT-5.6 Sol、Gemini 3.8 Flash が含まれます。採点は3層構造です。L1 では MP4 が納品されたかどうか、および解像度・フレームレート・尺・音声トラックなどの仕様をチェックします。L2 では約1.3万項目のタスク要件を1件ずつ検証します。L3 では3つのマルチモーダル審査システムが画質、美感性、コンテンツの論理、動きのリズム、音声同期を評価します。
2.2 GPT-6 Astra と Opus 5.5 の総合成績比較
| 指標 | GPT-6 Astra | Claude Opus 5.5 | リード |
|---|---|---|---|
| 動画の納品成功 | 238/239 | 239/239 | Opus |
| 動画納品率 | 99.6% | 100% | Opus |
| 仕様適合率 | 93.7% | 99.6% | Opus |
| タスク要件通過率 | 97.1% | 97.3% | Opus |
| 動画品質 | 4.08 | 3.99 | Astra |
| 視覚的美感 | 4.30 | 4.19 | Astra |
| 内容的論理 | 4.20 | 4.18 | Astra |
| モーションとリズム | 3.95 | 3.95 | 同等 |
| 音声品質と同期 | 4.10 | 4.07 | Astra |
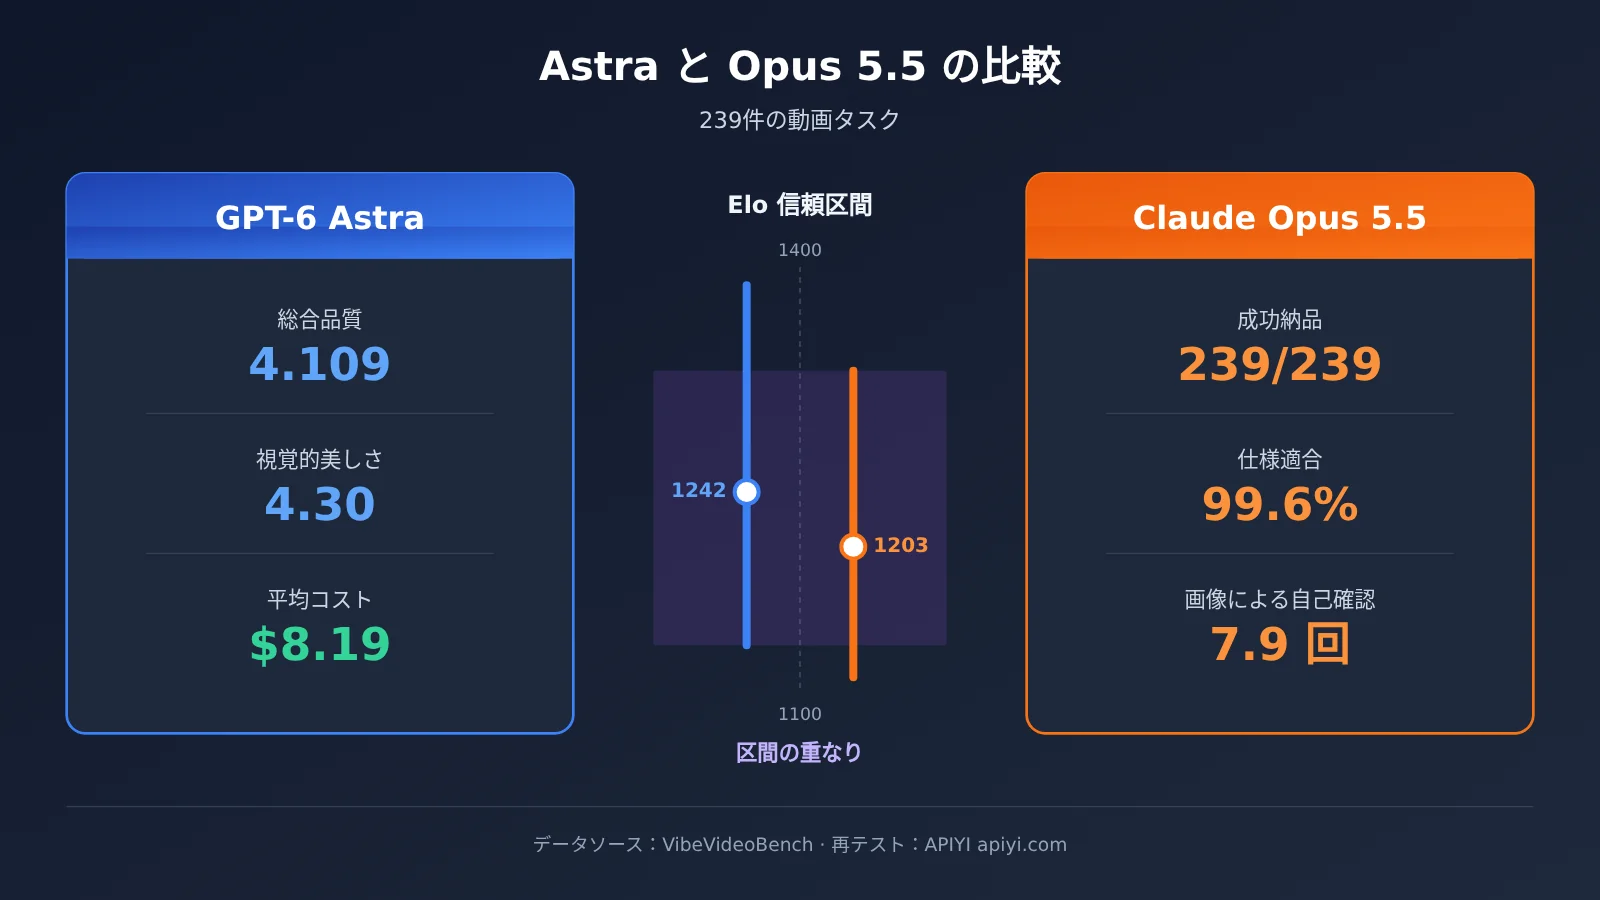
| 総合品質スコア | 4.109 | 4.074 | Astra |
| 厳格タスク成功率 | 74.5% | 76.3% | Opus |
| 人間選好 Elo | 1242 | 1203 | 統計的に区別できない |
データは3名の審査員による平均結果に基づくもので、採点範囲は1〜5点です。両システムはいずれも他の参加システムをリードしています。
この表からは、明確な役割分担が見て取れます。Astra は「出来上がった動画の見栄え」の面でやや優位に立ち、総合品質で 0.035 点、視覚的美感で 0.11 点リードしています。一方、Opus 5.5 は「仕様どおりに納品できるか」の面でより信頼性が高く、仕様適合率は 5.9 ポイント、厳格タスク成功率は 1.8 ポイント上回っています。0.035 点の差はごく小さく、Elo の信頼区間を踏まえると、両者は同じティアに位置していると言えるでしょう。
2.3 動画タイプ別に見る GPT と Opus 5.5 の優位性の分布
| 動画カテゴリ | Astra | Opus 5.5 | リード |
|---|---|---|---|
| ブランドとマーケティング | 4.18 | 4.18 | 引き分け |
| 製品と機能紹介 | 4.20 | 4.24 | Opus |
| 音楽とサウンドドリブン | 3.83 | 3.92 | Opus |
| 論文解説 | 4.03 | 4.07 | Opus |
| 概念とプロセスの説明 | 4.19 | 4.15 | Astra |
| データと事実ストーリー | 4.14 | 4.01 | Astra |
| ビジュアルアート | 3.94 | 3.91 | Astra |
| ゲームとスポーツ | 4.15 | 4.12 | Astra |
| イベントと個人的表現 | 4.03 | 3.93 | Astra |
| ストーリーとビジュアルコメディ | 4.00 | 3.88 | Astra |
| 建造と製作プロセス | 3.97 | 3.94 | Astra |
| 教室での授業 | 4.47 | 4.45 | Astra |
データは論文の Appendix E.4 に由来し、未納品の動画にはゼロ点を計上しています。
Astra は 12 カテゴリのうち 8 カテゴリでリードしており、差が最も大きいのはデータと事実ストーリー(0.13)とストーリーとビジュアルコメディ(0.12)です。一方、Opus 5.5 は製品紹介、音楽ドリブン、論文解説でリードしており、音楽ドリブンの差は 0.09 となっています。音楽系のタスクは音と映像の同期に高い要求があり、製品紹介は仕様や細部への要求が高いため、これは Opus が仕様適合率で優位な方向と一致します。ほとんどのカテゴリの差は 0.05 点以内であり、モデル選択にはすでにタスクタイプによる違いが現れていますが、単一カテゴリの差は依然として繰り返しテストを踏まえて判断する必要があります。
2.4 Opus 5.5 が依然として競争力を持つ理由
人手によるブラインドテストでは、Bradley–Terry モデルを用いて Elo を計算しています。Astra は 1242(95% 信頼区間 1134–1387)、Opus は 1203(1111–1327)で、両者の順位の信頼区間はいずれも 1–3 です。論文で示された比較確率は P=0.69 で、統計的に区別できないという結論でした。注意すべきなのは、人手によるテストは納品済みの動画だけを評価しており、納期内に納品する能力は測れないという点です。そして、納品こそ Opus の強みです。
自己点検の行動がこれを説明しています。Opus は 1 回の実行あたり平均 7.9 回レンダリング画像を確認し、ffprobe を 3.9 回使用しました。Astra はそれぞれ 3.4 回と 2.1 回です。Opus は自分の出力をより頻繁に検査し、問題を見つけて修正することで、100% の納品率と 99.6% の仕様適合率を実現しました。Anthropic は Opus 5.5 を長時間実行される Agentic Coding モデルとして位置づけており、コミュニティには、約 30 分で iOS アプリのプロモーション動画を完成させ、1080×1920 の縦型ニュースショート動画を SRT 字幕付きで自動制作したというユーザー自身の事例もあります。これらは個人の事例であり、ワークフローの完全性を示す傍証として参考になります。
2.5 動画タスクのコスト:GPT-6 Astra は単価が高いが、タスクあたりでは安い
| 指標 | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| 標準入力価格(米ドル/100万トークン) | 10 | 4 |
| 標準出力価格(米ドル/100万トークン) | 50 | 20 |
| 平均タスクコスト | $8.19 | $15.38 |
| 中央値タスクコスト | $7.88 | $10.19 |
| P90 タスクコスト | $11.88 | $31.22 |
| 平均出力トークン数 | 61K | 130.7K |
| タスクあたり API 呼び出し回数 | 46 | 51 |
| キャッシュヒット率 | 97% | 65% |
Astra の標準単価は Opus 5.5 の 2.5 倍ですが、平均タスクコストは約 46.7% 低くなっています。理由は 2 つあります。Astra は出力トークンが約 53.3% 少ないこと、そして Astra のキャッシュヒット率が 97% に達するのに対し、Opus ではタスクコストの約 76% がキャッシュ書き込みに由来していることです。P90 コストの差はさらに顕著で、複雑なタスクにおける Opus のコスト変動はより大きくなります。論文でも、単にトークン消費を増やしても、それに見合った品質向上は得られないと指摘されています。
このコスト群は公開 API 価格で換算した等価コストであり、完全な商用動画に必要な人件費や素材費は含まれていません。Opus 5.5 の公式 Batch API では入出力が半額になるため、オフラインで一括制作する場合にはコスト構造が変わります。
💰 コスト最適化:動画エージェントのタスク単価はキャッシュヒット率と出力長の影響を大きく受けるため、単価だけを見ると誤った判断につながりやすくなります。APIYI apiyi.com 上で同一タスクを両モデルでそれぞれ実行し、「1 本の完成動画あたりの実消費」で核算することをおすすめします。表示価格での比較は避けてください。
3 OpenAI 次世代GPTの能力向上シグナル
3.1 Navier–Stokes研究:内部モデルはGPT-6 Astraより大幅に強力
2026年9月8日、OpenAIはNavier–Stokes方程式のミレニアム懸賞問題に関する研究成果を発表しました。公式記事には、使用した内部モデルがGPT-6 Astraより大幅に強く、大規模強化学習で訓練されており、発表時点でも訓練が続いていると記されています。
この研究の実行規模は、マルチエージェント能力を直接示すものです。約10,000のエージェントが同時に参加し、研究には約88時間を要しました。生成されたのは270万件のメッセージ、約1,300億の出力トークンです。エージェントはグループごとに異なるバージョンの問題を研究し、グループ間で情報を交換しました。Codexが中間成果を統合し、システムは継続的に、より有望なルートへリソースを集中させました。最後のLeanによる形式検証には追加で17時間を要し、そこではGPT-6 Astraが使用されました。
動画制作の観点で最も関連するのは、数学能力そのものではなく、長期的なタスクスケジューリングとマルチエージェント連携です。複雑な動画も同様に、スクリプト、アニメーション、音声の並列処理が必要で、その後、統合、確認、やり直しが発生します。
3.2 BenchCAD 2.0:エンジニアリング能力が0.594から0.875へ向上
2026年11月3日、OpenAIは「Accelerating engineering for the physical world」の中で、比較的新しい内部モデルがBenchCAD 2.0で平均スコア0.875を獲得し、GPT-6 Astraが最高推論強度で0.594だったと発表しました。相対的な向上率は約47.3%です。テスト内容には3D部品の再構築、機械アセンブリ設計、PCB接続の識別が含まれます。
これら2つの証拠は分けて見るべきです。OpenAIは、BenchCADのテストモデルとNavier–Stokes研究のモデルが同一かどうかを明らかにしておらず、名称や公開時期も公表していません。BenchCADはOpenAI自身が公表したエンジニアリングテストであり、空間理解と複雑なエンジニアリング知識の進歩を示すシグナルではありますが、動画生成タスクに直接対応するものではありません。
3.3 次世代GPTはいつリリースされるか:11月15日時点の公開状況
| 日付 | 公開状況 |
|---|---|
| 11月2日 | The Nationalの報道によると、Altman氏はADIPECで、数学研究にまもなく公開されるGPTモデルを使用し、約10,000のエージェントが約4日間協力したと述べました。同報道は、この記述が独立検証されていないと注記しています |
| 11月3日 | OpenAIが内部モデルのBenchCAD 2.0データを公表 |
| 11月4日 | The Informationが関係者の話として、OpenAIが早ければ11月6日に次世代のAstra、Sol、サイバーセキュリティモデルを発表する可能性があると報じました |
| 11月5日 | OpenAI API ChangelogがGPT-6 Cyberのリリースを確認。次世代の汎用AstraまたはSolは未リリース |
| 11月15日 | 公式モデルカタログの汎用フラッグシップは依然としてGPT-6 Astra、GPT-6.1 Sol、GPT-6.1 Terra、GPT-6 Luna |
ネット上で広まっているGPT-6.2 Astra、GPT-6.2 Solなどの名称は、現時点でOpenAIの公式確認を得ていません。同様に注意が必要なのは、VibeVideoBenchが測定したのはGPT-6 AstraとGPT-5.6 Solであり、AstraのスコアをそのままGPT-6.1 SolやTerraに当てはめることはできないという点です。
4 次世代GPTが動画制作でOpus 5.5を超えるために必要なもの
4.1 動画エージェントの真のボトルネック:時間管理と納品
VibeVideoBenchの全2,151回の実行のうち、224回は再生可能な動画を納品できませんでした。そのうち169回は時間管理の問題に該当します。最終レンダリングの開始が遅すぎたり、実行が遅すぎたり、あるいはまったく開始されなかったりといったケースで、全失敗の約75%を占めています。テスト環境は8コアCPU、32GBメモリ、GPUなしの統一Dockerコンテナで、レンダリング自体にかなりの時間がかかります。
これは、モデルの推論能力が向上した後も、それを実行のペースに落とし込む必要があることを示しています。どれだけ精巧にアニメーションを書いても、55分の時点でようやくレンダリングを開始したのでは、結果はゼロ点のままです。AstraとOpus 5.5は品質の面ですでに甲乙つけがたくなっており、次世代GPTが差を広げる余地は主に納品側にあります。
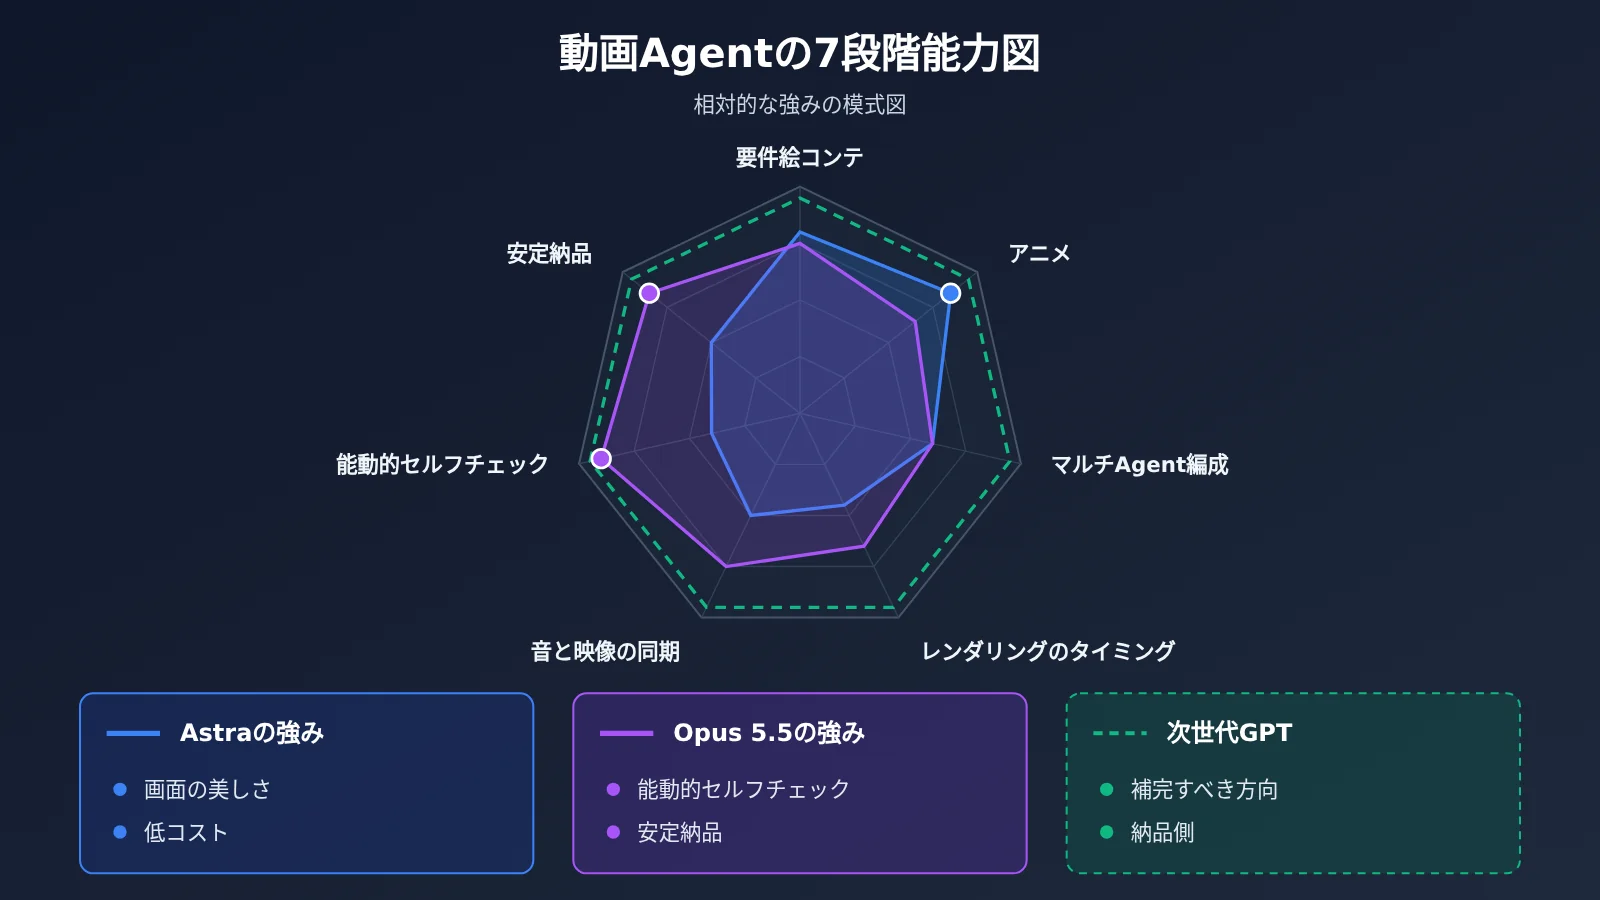
4.2 次世代GPTが動画ワークフローで改善すべき7つのポイント
両者の現在の強みと弱みを踏まえると、次世代モデルがOpus 5.5を明確に超えるには、以下の項目で同時に進歩する必要があります。
- 要件と絵コンテの理解:テーマ、対象読者、スタイルを正確に捉え、要件をカット順序とタイムラインに分解します。
- 複雑なアニメーションコード:Remotion、Three.js、Pythonのアニメーションを一度で正しく書き、再レンダリングを減らします。
- マルチエージェントのスケジューリング:スクリプト、アニメーション、音声を並列化します。内部モデルが数学研究で示したオーケストレーション能力を、こうしたエンジニアリングタスクにも移す必要があります。
- レンダリングのタイミング:十分なレンダリング時間を確保し、失敗全体の約4分の3を占める時間管理の問題を避けます。
- 映像と音声の同期:ナレーションや効果音を映像のリズムに合わせます。これはOpusが音楽駆動型タスクでリードしている方向です。
- 能動的なセルフチェック:Opusは平均7.9回画像を見直し、Astraは3.4回です。セルフチェックの頻度と仕様適合率は直接関係しています。
- 安定した納品:完全なMP4と編集可能なプロジェクトを、仕様を一発で満たして納品します。
5 次世代GPTのリリース後、本当にOpus 5.5を超えたかをどう検証するか
5.1 7ステップの比較テスト手法
公開ベンチマークは1回だけ実行され、制限時間は60分、しかも英語タスクが中心(239項目中209項目が英語)です。中国語の業務シーンでは、自分で再テストする必要があります。以下の方法は、新しいモデルがリリースされた当日にそのまま再利用できます。
| ステップ | やり方 | 注目する指標 |
|---|---|---|
| 1 タスクセットの固定 | 実際の業務動画ニーズを10—20件選び、脚本・アニメーション・データ可視化・製品紹介をカバー | タスクのカバー範囲 |
| 2 環境の固定 | ツールチェーン(Remotion/FFmpegのバージョン)、マシン構成、制限時間を統一。Harnessの差異は個別に記録 | 比較可能性 |
| 3 工程ごとのテスト | まずAPIで絵コンテとアニメーションコードを単体テストし、その後Agent環境で全工程を実行 | 各工程のスコア |
| 4 消費量の記録 | 各実行の所要時間、入出力Token、キャッシュヒット | 動画1本あたりのコスト |
| 5 納品チェック | ffprobeで解像度、フレームレート、長さ、音声トラックを確認 | 納品率、仕様適合率 |
| 6 ブラインドテストとリピート | モデル名を隠して2者比較を行い、各タスクを最低3回実行 | 選好勝率、分散 |
| 7 総合スコアリング | 品質、成功率、修正コスト、動画1本あたりのコストを重み付け | 最終的な選定結論 |
ステップ3では「モデル能力」と「Agent環境の能力」を切り分けます。VibeVideoBenchが測定するのはAgentシステム全体であり、Codex CLIとClaude Code自体にも違いがあります。同じOpenAI互換インターフェースを使って両社のモデルを直接呼び出し、絵コンテとアニメーションコードを生成すれば、まずHarnessの影響を排除して、モデル自体の差をはっきり見ることができます。
5.2 統一インターフェースで工程ごとの比較を行うコード例
次のミニマルな例では、同じ base_url を通じて2つのモデルを呼び出し、同一の動画要件に対して絵コンテを生成します。モデル名はプラットフォームのモデル一覧に従ってください。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース。1つのキーで GPT と Claude を呼び出し
)

prompt = "家計簿アプリの30秒縦型プロモーション動画を設計してください:6つのカットの絵コンテ、ナレーション、各カットの長さを示してください。"
for model in ["gpt-6-astra", "claude-opus-5-5"]:
    r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
    print(model, r.usage.total_tokens, "\n", r.choices[0].message.content[:300])
完全なマルチターン比較テストスクリプトを見る(所要時間とTokenを記録)
import time
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 経由で統一呼び出し。切り替えと比較が容易
)

MODELS = ["gpt-6-astra", "claude-opus-5-5"]  # プラットフォームのモデル一覧に従う。新モデル公開後はそのまま追加
RUNS = 3  # 各タスクの繰り返し実行回数

TASKS = {
    "storyboard": "家計簿アプリの30秒縦型プロモーション動画を設計し、6つのカットの絵コンテ、ナレーション、長さを出力してください(JSON)。",
    "remotion": "Remotion で10秒の棒グラフ成長アニメーションコンポーネントを書いてください。データは [12, 30, 45, 80]、タイトルと数値ラベル付きです。",
    "data_story": "「ある都市の2020〜2025年の新エネルギー車普及率が5%から48%へ上昇」を、45秒のデータストーリー動画のスクリプトとカット説明にしてください。",
}

SYSTEM = "あなたは動画ディレクター兼フロントエンドアニメーションエンジニアです。コード駆動の動画制作にそのまま使える内容を出力してください。"


def run_once(model: str, prompt: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        max_tokens=4000,
    )
    return {
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "output": resp.choices[0].message.content,
    }


results = []
for task_name, prompt in TASKS.items():
    for model in MODELS:
        for i in range(RUNS):
            try:
                rec = run_once(model, prompt)
            except Exception as e:
                rec = {"error": str(e)}
            rec.update({"task": task_name, "model": model, "run": i + 1})
            results.append(rec)
            print(task_name, model, i + 1, rec.get("seconds"), rec.get("completion_tokens"))

# 結果を保存し、モデル名を伏せてからレビュアーにブラインドテストを依頼
with open("video_bench_results.json", "w", encoding="utf-8") as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
🚀 クイックスタート:工程ごとの比較では GPT と Claude を同時に呼び出す必要があります。APIYI apiyi.com なら1つの APIキーと OpenAI 互換インターフェースで両社のモデルを切り替えられます。新規ユーザーには無料テスト枠があり、次世代 GPT が公開されたらモデル名を
MODELSリストに追加するだけで同じタスク群を再実行できます。
5.3 全フロー(通し)テストの注意点
各フェーズのテストに合格したら、続いて Codex CLI と Claude Code で動画タスクを通しで実行し、納品率と ffprobe の検査結果を記録します。人手によるブラインドテストは納品済みの動画だけを評価対象とするため、納品率は必ず別途集計してください。そうしないと、VibeVideoBench の人手テストが抱えていた死角をそのまま繰り返してしまいます。各タスクは少なくとも 3 回以上繰り返し、平均値と分散を取ることで、1 回だけの実行結果を安定した性能と誤認することを避けられます。
6 意思決定のアドバイス:GPT と Opus 5.5 の動画シーンでの選び方
6.1 シーン別に GPT-6 Astra か Opus 5.5 を選ぶ
VibeVideoBench のカテゴリ別スコアと納品データに基づくと、現時点では次のように割り当てられます。
- GPT-6 Astra を優先:データ・事実系のストーリー、概念やプロセスの解説、ストーリー系およびゲーム系の動画。大量生産や単位コストを重視するシーンに向いており、平均タスクコストは 8.19 ドル、P90 コストもより抑えられます。
- Claude Opus 5.5 を優先:製品・機能の紹介、音楽ドリブンの動画、論文解説。解像度や再生時間が固定されている、必ず音声トラック付きでなければならないといった、仕様や納品に厳格な要件がある商用納品に向いています。
- ブランドマーケティング:両モデルのスコアはともに 4.18 なので、コストとチームがすでに使っているツールチェーンで判断します。
6.2 次世代 GPT を待つべきか、それとも今すぐ運用を始めるべきか
現行の 2 モデルはすでに実用レベルの動画を安定して生成できるため、ビジネス側で次世代モデルを待つ必要はありません。より現実的なのは、第 5 節の方法で自社のタスクセットとベースラインのスコアを構築しておき、新モデルが公開された当日に再実行して、データに基づいて切り替えを判断することです。
💡 選択のヒント:両者の差は主に納品の安定性とコスト構造に集約されており、最終的な選択は動画の種類と納品要件によって決まります。APIYI apiyi.com を通じて、同じ実タスクのセットで両方をそれぞれテストすることをおすすめします。共通のインターフェースなので、並べて比較しやすく、後から新しいモデルへ切り替えるのも容易です。
7 最終結論:次世代 GPT の競争目標は、もはや Opus 5.5 に追いつくことだけではない
7.1 GPT と Opus 5.5 の動画能力に関する要点
- 現状:GPT-6 Astra と Claude Opus 5.5 は、VibeVideoBench のコード駆動型動画タスクでともにトップティアに位置し、総合品質は 4.109 対 4.074 です。
- Astra の強み:視覚的な美しさ、多くのコンテンツカテゴリでのスコア、そして平均タスクコストが約 46.7% 低いことです。
- Opus 5.5 の強み:239/239 の全件納品、99.6% の仕様適合率、より頻繁な自己チェックです。
- 人手による選好:1242 対 1203 で、信頼区間が重なるため統計的には区別できません。
- 次世代モデルの兆候:社内モデルは BenchCAD 2.0 で 0.875(Astra は 0.594)を達成し、1万規模のエージェント協調能力も示しました。名称、公開時期、動画の成績はいずれも未公表です。
- 真のボトルネック:納品失敗の約 75% は時間管理に起因しており、競争の焦点は生成品質から実行と納品へ移っています。
- 検証方法:タスクと環境を固定し、複数回のブラインドテストを行い、動画単位のコストで採算を評価できます。APIYI apiyi.com の統一インターフェース上で工程単位の再テストも完了できます。
7.2 競争の終着点は総合的な生産効率
タイトルに戻ると、GPT はすでに Opus 5.5 に追いついており、現行の Astra は品質とコストでやや優位、Opus 5.5 は納品の信頼性でリードを維持しています。OpenAI の社内モデルは、より強力な汎用能力とマルチエージェント実行のポテンシャルを示しており、次世代の汎用 GPT には動画制作能力をさらに高める可能性があります。具体的な伸び幅は、公開後の独立評価と皆さん自身の業務テストを待つ必要があります。
今後の競争は総合的な生産効率に集約されます。アイデアを理解してから、信頼性が高く、正確で、修正可能な動画を1本出力するまで、より低コストでより多くのタスクをこなせるのは誰か、という競争です。今のうちに APIYI apiyi.com で自社の動画タスクのベースラインを構築しておけば、新モデルの公開直後に直接比較できます。
参考資料
- VibeVideoBench 公式評価サイト:動画エージェントのランキングと品質スコア
- リンク:
vibevideobench.github.io -
説明: 総合ランキングと評価設計の概要
-
VibeVideoBench 論文:方法論、カテゴリ別スコア、コスト、人手による選好、失敗原因
- リンク:
arxiv.org/abs/2610.35864 -
説明: 本文の表データの主要な出典。カテゴリ別スコアは Appendix E.4 を参照
-
Anthropic Claude Opus 5.5 リリース告知:モデルの位置づけと公式事例
- リンク:
anthropic.com/claude-opus-5-5 -
説明: Opus 5.5 の能力とコスト変化についての公式な説明
-
OpenAI:On the Navier–Stokes Millennium Prize Problem:内部モデルとマルチエージェントによる研究
- リンク:
openai.com/index/navier-stokes-solution -
説明: 10,000 の並列エージェント、88 時間の研究などのデータ
-
OpenAI:Accelerating engineering for the physical world:BenchCAD 2.0 における内部モデルのスコア
- リンク:
openai.com/index/accelerating-engineering-for-the-physical-world -
説明: 内部モデル 0.875 と GPT-6 Astra 0.594 の比較
-
OpenAI API Changelog とモデルカタログ:リリース状況の確認
- リンク:
developers.openai.com/api/docs/changelog、developers.openai.com/api/docs/models -
説明: GPT-6 Cyber のリリース記録と、現在公開されているフラッグシップモデル
-
OpenAI API Deprecations:Sora 2 と Videos API の提供終了情報
- リンク:
developers.openai.com/api/docs/deprecations - 説明: ネイティブ動画生成路線の現状
作者:APIYI 技術チーム
技術交流:動画エージェントのテスト経験について、APIYI apiyi.com のトップページからお気軽にお問い合わせください。接続に関する資料は docs.apiyi.com のドキュメントセンターをご覧ください。