
Catatan penulis: Menginterpretasikan data penggunaan ChatGPT dari 165 kategori aktivitas kerja yang dipublikasikan dalam OpenAI Signals v3.0, memperjelas cakupan statistik, dan menganalisis nilai referensinya bagi pengembang dan aplikasi AI perusahaan.
Pada 26 Oktober 2026, tim riset ekonomi OpenAI merilis “ChatGPT’s expanding world of work” (judul resmi bahasa Mandarin “ChatGPT 不断拓展的工作版图”), mempublikasikan data penggunaan ChatGPT yang mencakup hampir 100 negara dan wilayah, 165 kategori aktivitas kerja, dan 7 kuartal berturut-turut. Kumpulan data ini merupakan bagian dari program OpenAI Signals v3.0, tersedia untuk diunduh gratis di bawah lisensi CC BY 4.0, dan peneliti dapat langsung menggunakan CSV untuk analisis sekunder.
Ini bukan peluncuran model atau fitur baru, melainkan seperangkat data penggunaan ekonomi yang ditujukan untuk peneliti. Pengumuman resmi, kamus data, dan verifikasi pihak ketiga terhadap CSV mentah telah muncul bersamaan, dan cakupan angka dapat saling mengonfirmasi. Artikel ini akan secara jelas membedakan kesimpulan resmi dan perhitungan pihak ketiga, untuk menghindari kesalahpahaman “proporsi pesan” sebagai “penggantian posisi kerja”.
Nilai inti: Dalam beberapa menit, pahami apa yang sebenarnya dihitung dan ditemukan dari data 165 kategori aktivitas kerja OpenAI, serta makna referensi praktisnya bagi pengembang aplikasi AI.
Sekilas Informasi Inti Data 165 Kategori Aktivitas Kerja OpenAI
Mari kita mulai dengan tabel yang menjelaskan fakta-fakta dasar dari publikasi data penggunaan ChatGPT kali ini:
| Item Informasi | Detail |
|---|---|
| Tanggal Publikasi | 26 Oktober 2026 |
| Penerbit | Tim Riset Ekonomi OpenAI (OpenAI Signals v3.0) |
| Sistem Klasifikasi | Intermediate Work Activities (IWA) O*NET Amerika Serikat |
| Cakupan | Hampir 100 negara dan wilayah, 165 kategori aktivitas kerja |
| Rentang Waktu | Kuartal pertama 2025 hingga kuartal ketiga 2026, total 7 kuartal |
| Sumber Sampel | Akun pribadi Free, Go, Plus, Pro dengan usia terdaftar di atas 18 tahun |
| Cakupan yang Dikecualikan | ChatGPT Enterprise, Codex, akun yang dihapus, sampel yang tidak diizinkan untuk pelatihan |
| Lisensi Data | CC BY 4.0, dapat dilihat gratis dan diunduh sebagai CSV, wajib mencantumkan atribusi |
165 Kategori Aktivitas Kerja Bukan 165 Jenis Pekerjaan
Ini adalah titik yang paling sering salah dipahami saat menginterpretasikan data OpenAI ini. O*NET adalah database informasi pekerjaan resmi yang didukung pemerintah Amerika Serikat, yang memecah “pekerjaan” menjadi beberapa lapisan “aktivitas kerja”. Misalnya, aktivitas “menyunting materi tertulis” muncul tidak hanya dalam pekerjaan editor, tetapi juga dalam keseharian guru, pengacara, insinyur, dan staf keuangan.
Oleh karena itu, yang dihitung OpenAI adalah “apa yang dilakukan orang dengan ChatGPT”, bukan “orang dengan pekerjaan apa yang menggunakan ChatGPT”. IWA (Intermediate Work Activities, aktivitas kerja tingkat menengah) berada di antara perilaku kerja yang luas dan tugas yang sangat spesifik. Dalam sistem referensi O*NET terdapat total 332 entri IWA.
OpenAI hanya melaporkan secara terpisah aktivitas yang umum dan memenuhi ambang batas sampel, sementara aktivitas berfrekuensi rendah digabungkan. Menurut verifikasi PPC Land terhadap CSV asli, tabel publik sebenarnya berisi 164 kategori bernama ditambah 1 kategori gabungan “Other IWA”, sehingga totalnya 165 hasil klasifikasi. Jadi tidak bisa dikatakan OpenAI telah menghitung secara lengkap semua 332 kategori IWA.
Bagaimana Data Dikumpulkan dan Diklasifikasikan
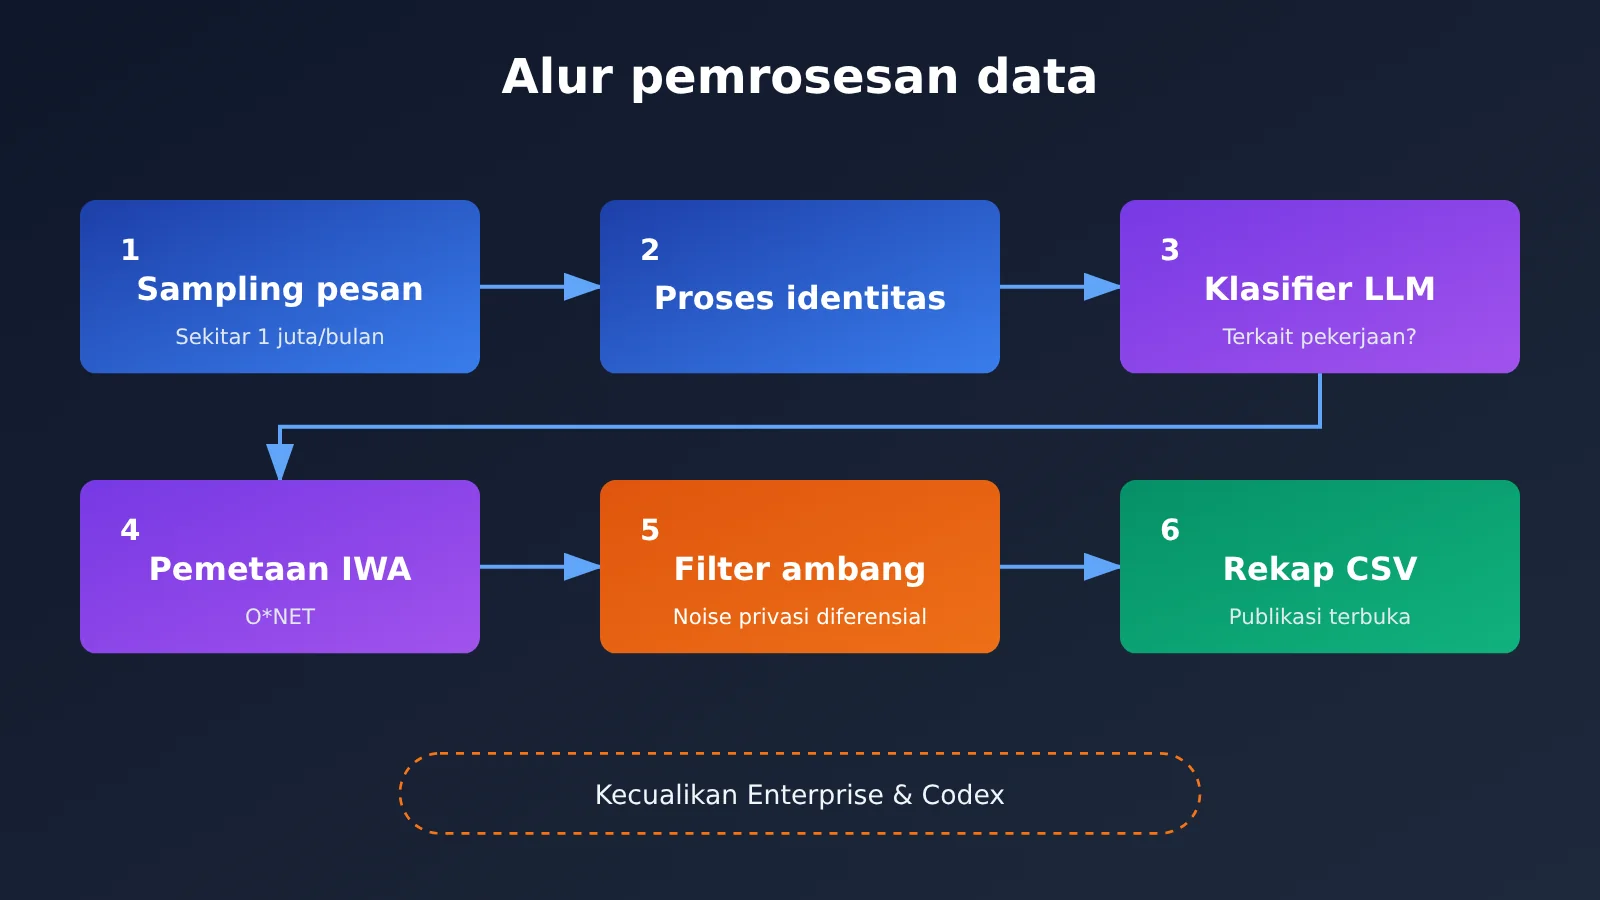
Signals v3.0 mengambil sampel sekitar 1 juta pesan ChatGPT setiap bulan, dengan cakupan keseluruhan dari Juli 2024 hingga September 2026 selama 27 bulan, total sekitar 27 juta sampel terklasifikasi. Perlu dicatat, 27 juta adalah jumlah sampel dari setiap bulan, yang tidak sama dengan jumlah pengguna unik, dan juga tidak berarti semuanya adalah pesan terkait pekerjaan.
Klasifikasi dilakukan oleh pengklasifikasi model bahasa otomatis: pertama menentukan apakah pesan terkait pekerjaan, kemudian memetakannya ke aktivitas kerja O*NET, sekaligus menandai dimensi seperti topik, niat, waktu, dan wilayah. Dalam hal privasi, OpenAI menyatakan bahwa peneliti tidak membaca obrolan mentah secara langsung, informasi identitas diproses sebelum klasifikasi, hanya hasil agregat yang dipublikasikan, dan sampel kecil disembunyikan serta ditambahkan noise differential privacy. Untuk distribusi aktivitas kerja per negara per kuartal, diperlukan setidaknya 1000 pesan valid agar dapat dipublikasikan.
Temuan inti data penggunaan ChatGPT: penggunaan untuk pekerjaan makin beragam
Kesimpulan utama yang disampaikan OpenAI adalah: jenis pekerjaan yang ditangani pengguna individu dengan ChatGPT semakin beragam. Di 74 negara dan wilayah yang memiliki catatan lengkap selama 7 kuartal, sepuluh jenis aktivitas kerja yang paling umum di tiap negara mengalami penurunan rata-rata proporsi yang cukup signifikan dalam pesan kerja yang telah diklasifikasikan di negara tersebut.
| Periode | Rata-rata proporsi sepuluh aktivitas kerja teratas per negara |
|---|---|
| Kuartal 1 2025 | 56,0% |
| Kuartal 3 2026 | 51,1% |
| Perubahan | -4,9 poin persentase |
Ada dua hal soal definisi yang harus dijelaskan dengan gamblang. Pertama, 51,1% bukan proporsi dari satu daftar sepuluh teratas global yang seragam, melainkan dihitung dulu sepuluh teratas masing-masing negara, lalu dirata-ratakan ke 74 negara, dan sepuluh teratas tiap negara bisa berbeda. Kedua, penurunan proporsi tidak sama dengan penurunan jumlah pesan. Jika penggunaan secara keseluruhan tumbuh, jumlah permintaan absolut untuk aktivitas teratas tetap bisa meningkat.
Dengan kata lain, lebih banyak aktivitas kerja “ekor panjang” yang mendapat porsi lebih besar. Perlu dicatat bahwa 74 negara dan hampir 100 negara adalah dua cakupan sampel yang berbeda, jadi tidak boleh dicampur saat dikutip.
Aktivitas kerja spesifik apa yang paling umum
PPC Land pada 27 Oktober 2026 melakukan perhitungan independen berdasarkan seluruh CSV yang dipublikasikan, menghitung untuk masing-masing dari 74 negara lalu dirata-ratakan. Berikut enam aktivitas kerja bernama yang paling umum pada kuartal ketiga 2026 (perhitungan pihak ketiga, bukan daftar langsung dari pengumuman OpenAI):
| Peringkat | Aktivitas kerja | Rata-rata proporsi pesan di 74 negara |
|---|---|---|
| 1 | Menyunting materi atau dokumen tertulis | 15,0% |
| 2 | Membuat desain visual atau konten presentasi | 7,9% |
| 3 | Mengembangkan materi pemasaran atau promosi | 5,1% |
| 4 | Menjelaskan informasi bahasa atau budaya | 4,0% |
| 5 | Menyiapkan materi informasi atau pengajaran | 3,2% |
| 6 | Memprogram sistem komputer atau peralatan produksi | 3,1% |
Menyunting dokumen tetap menjadi penggunaan kerja yang paling umum, sementara desain visual sudah naik ke posisi kedua. Konten pemasaran, materi pengajaran, dan pemahaman lintas bahasa semuanya menunjukkan permintaan yang jelas, sedangkan pemrograman meskipun penting, tidak menempati porsi terbesar dalam sampel akun individu ini.
Desain visual meningkat, porsi pemrograman menurun
Menurut perhitungan PPC Land, rata-rata porsi “membuat desain visual atau konten presentasi” di 74 negara naik dari 3,1% pada kuartal pertama 2025 menjadi 7,9% pada kuartal ketiga 2026, meningkat 4,8 poin persentase, dan menjadi aktivitas spesifik dengan kenaikan terbesar di antara 165 kategori. Pada periode yang sama, AS naik dari 2,4% ke 7,6%; pada kuartal ketiga 2026 Brasil mencapai 11,2% dan India 8,7%.
Sebaliknya, “memprogram sistem komputer atau peralatan produksi” turun dari 7,8% menjadi 3,1%; AS turun dari 6,7% menjadi 2,4%; India masih 5,8% pada kuartal ketiga 2026. Aktivitas terkait seperti memecahkan masalah komputer dan meneliti desain teknis juga ikut menurun. Salah satu hipotesis yang masuk akal adalah para developer beralih ke agen pemrograman khusus seperti Codex, tetapi data itu sendiri tidak membuktikan peralihan tersebut. Rumusan yang lebih aman: dalam data yang mengecualikan Codex dan akun perusahaan ini, porsi pesan pekerjaan terkait pemrograman menurun secara signifikan.
Pemasaran adalah sinyal lain yang patut diperhatikan. Rata-rata porsi “membuat materi pemasaran atau promosi” bergerak dari 5,2% ke 5,1%, hampir datar; Argentina, Pakistan, Nigeria, dan negara lain mencapai sekitar 9% pada kuartal ketiga 2026. Ini menunjukkan bahwa meskipun porsi penulisan umum menurun, kebutuhan akan konten pemasaran khusus tetap stabil.
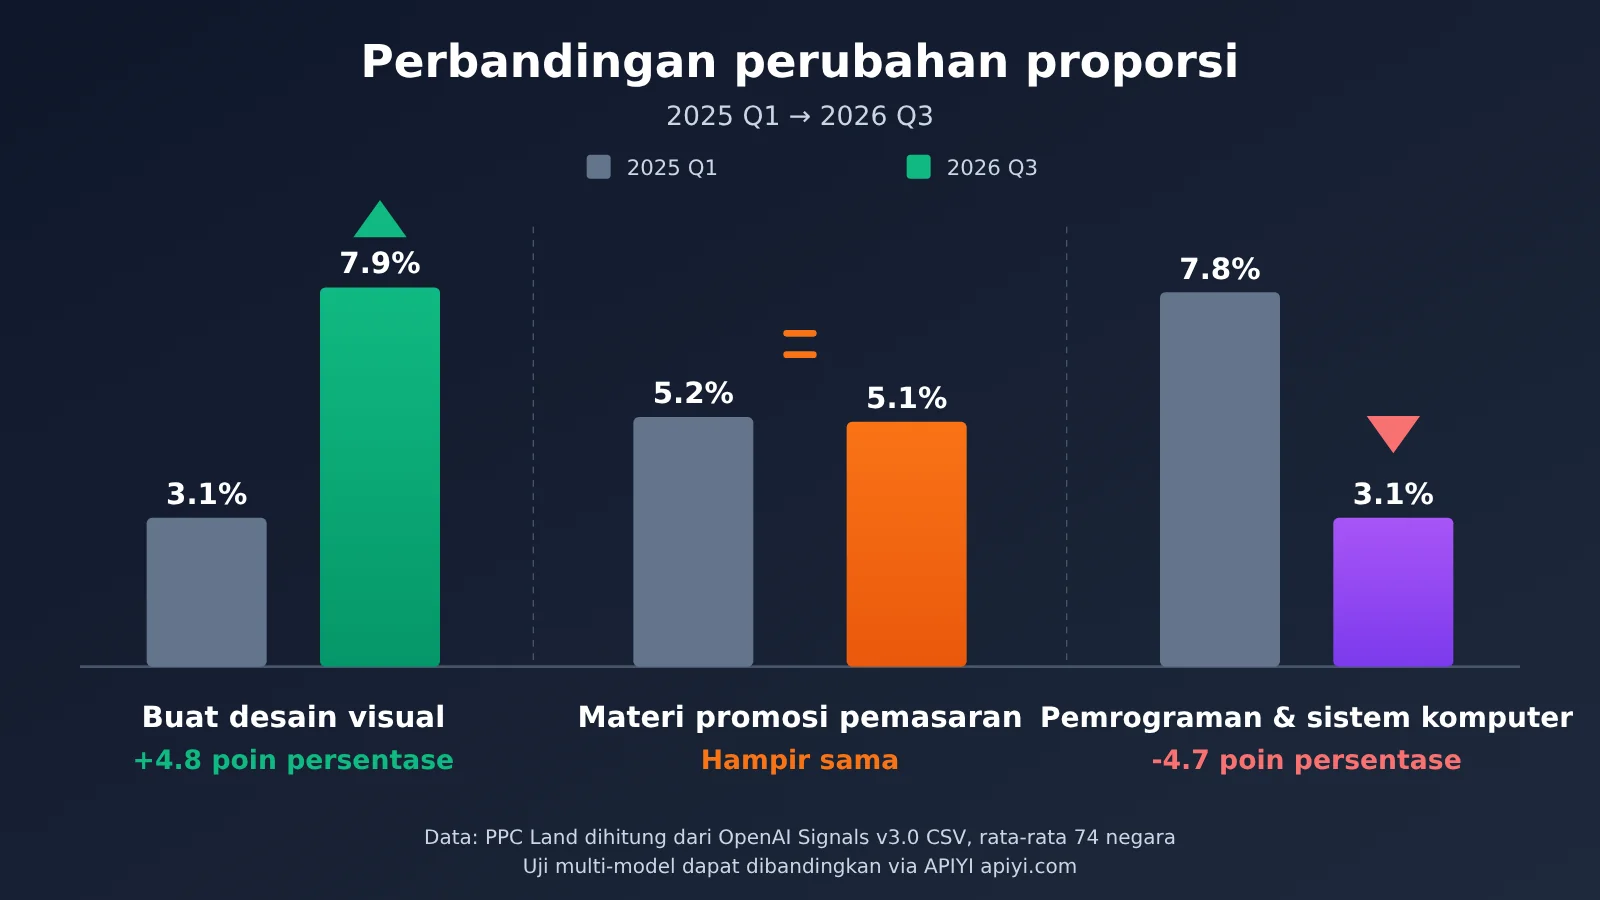
📊 Keterangan grafik: Data pada grafik di atas berasal dari perhitungan ulang PPC Land terhadap CSV publik OpenAI. Jika Anda ingin memverifikasi di bisnis Anda sendiri model mana yang paling cocok untuk permintaan “desain”, “copywriting”, dan “pemrograman”, Anda dapat menggunakan APIYI apiyi.com untuk beralih antara model OpenAI, Claude, Gemini, dan lainnya dengan kunci API yang sama untuk melakukan perbandingan skala kecil.
Perbandingan Struktur Kerja ChatGPT di Amerika Serikat dan Jerman
PPC Land juga membaca satu per satu kategori Generalized Work Activities yang lebih luas dalam grafik interaktif OpenAI (perlu dicatat, ini bukan tingkat yang sama dengan IWA di atas, jadi tidak bisa dicampur). Cakupan statistiknya adalah proporsi pesan terkait pekerjaan di masing-masing negara:
| Aktivitas kerja yang lebih luas | AS Q1 2025 | AS Q1 2026 | Jerman Q1 2025 | Jerman Q1 2026 |
|---|---|---|---|---|
| Membuat keputusan dan memecahkan masalah | 22,8% | 21,6% | 22,0% | 19,4% |
| Berpikir kreatif | 11,8% | 15,6% | 11,3% | 13,1% |
| Mencatat informasi | 10,6% | 11,8% | 10,3% | 11,4% |
| Menggunakan komputer | 11,7% | 6,7% | 12,7% | 8,4% |
| Memberikan konsultasi dan saran | 5,5% | 9,0% | 7,1% | 11,7% |
| Menjelaskan informasi kepada orang lain | 5,1% | 4,0% | 9,5% | 8,6% |
Kedua negara sama-sama menunjukkan bahwa “pengambilan keputusan dan pemecahan masalah” menjadi penggunaan yang penting, sementara porsi “berpikir kreatif” dan “konsultasi dan saran” naik cukup jelas. Ini menggambarkan jenis permintaan pengguna, bukan berarti ChatGPT sudah membuat keputusan bisnis secara mandiri, dan juga bukan berarti ia memberikan konsultasi tingkat ahli yang sudah terverifikasi.
Di antara kedua negara, indikator perbedaan distribusi lintas negara yang dibaca PPC Land (jarak variasi total) naik tipis dari sekitar 22,2% menjadi sekitar 23,0%. OpenAI juga mengakui bahwa perbedaan ini bisa berasal dari struktur kerja, bahasa dan budaya, ketersediaan alat, serta kebiasaan penggunaan; data kali ini belum cukup untuk membuktikan hubungan kausal.
Analisis dampak data 165 kategori aktivitas kerja terhadap pengembang
Dampak bagi pengembang aplikasi AI
- Kebutuhan makin luas: Pengguna tidak lagi hanya memakai ChatGPT untuk mengubah dokumen. Desain visual, pemasaran, materi pengajaran, dan saran konsultasi juga memiliki porsi yang signifikan. Alat AI dengan satu fungsi perlu mempertimbangkan skenario multitugas.
- Multimodal makin penting: Desain visual adalah aktivitas dengan kenaikan terbesar. Pada periode yang sama, topik “multimedia” di seluruh pesan pribadi naik dari 2,0% menjadi 8,8% (perhitungan PPC Land). Kemampuan gambar layak dimasukkan ke dalam perencanaan produk.
- Skenario pemrograman makin terspesialisasi: Proporsi pesan pemrograman dalam obrolan umum menurun. Ini menunjukkan bahwa kebutuhan terkait pemrograman mungkin lebih sering muncul di agen khusus atau lingkungan perusahaan, sehingga cocok ditangani dengan model kode dan alur kerja khusus.
- Metode klasifikasi yang dapat digunakan ulang: OpenAI menggunakan classifier LLM untuk memetakan pesan ke sistem tugas standar. Pendekatan ini juga dapat Anda gunakan untuk analisis log produk Anda sendiri.
Dampak terhadap implementasi AI di perusahaan
Data akun pribadi tidak bisa mewakili penggunaan di perusahaan. Data Enterprise Signals lain dari OpenAI menunjukkan bahwa hingga Juni 2026, di antara pelanggan perusahaan yang dianalisis, Codex menyumbang 64% dari total Token keluaran ChatGPT dan Codex. Ini menunjukkan bahwa struktur penggunaan di sisi perusahaan bisa sangat berbeda dari akun pribadi, jadi saat mengevaluasi solusi AI internal, gunakan log tugas Anda sendiri, bukan langsung menerapkan data pribadi dari Signals.
🚀 Mulai cepat: Jika Anda ingin memberi label “aktivitas kerja” pada permintaan bisnis Anda sendiri seperti yang dilakukan OpenAI, disarankan membangun prototipe dengan cepat melalui APIYI apiyi.com. Platform ini menyediakan antarmuka yang kompatibel dengan OpenAI, pengguna baru mendapat kuota uji gratis, dan contoh di bawah ini bisa dijalankan dalam beberapa menit.
Mereproduksi pendekatan “klasifikasi aktivitas kerja” dengan API
Berikut contoh sangat sederhana yang menggunakan Model Bahasa Besar untuk mengklasifikasikan satu permintaan pengguna ke sejumlah kecil label aktivitas kerja. Prinsipnya sama dengan pengklasifikasi OpenAI (label hanya ilustrasi sederhana, bukan sistem O*NET lengkap):
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI dari APIYI
)

labels = "编辑文档, 视觉设计, 营销推广, 语言解释, 教学材料, 编程, 决策分析, 其他"
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": f"从[{labels}]中选一个标签描述这条工作请求,只输出标签:帮我写一份新品发布的公众号推文"}]
)
print(resp.choices[0].message.content)
Lihat kode lengkap untuk klasifikasi batch dan statistik proporsi
import openai
from collections import Counter
from typing import List

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Satu Key dapat beralih antar beberapa model
)

LABELS = ["编辑文档", "视觉设计", "营销推广", "语言解释",
          "教学材料", "编程", "决策分析", "非工作", "其他"]

SYSTEM = (
    "你是工作活动分类器。先判断请求是否与工作相关,"
    f"再从以下标签中选择一个:{', '.join(LABELS)}。只输出标签本身。"
)

def classify(text: str, model: str = "gpt-4o-mini") -> str:
    try:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": SYSTEM},
                      {"role": "user", "content": text}],
            temperature=0,
            max_tokens=10,
        )
        label = r.choices[0].message.content.strip()
        return label if label in LABELS else "其他"
    except Exception as e:
        print(f"Error: {e}")
        return "其他"

def activity_share(messages: List[str]) -> dict:
    counts = Counter(classify(m) for m in messages)
    work = {k: v for k, v in counts.items() if k != "非工作"}
    total = sum(work.values()) or 1
    return {k: round(v / total * 100, 1) for k, v in work.most_common()}

if __name__ == "__main__":
    logs = [
        "帮我润色这份季度汇报",
        "设计一组活动海报的构图建议",
        "这段 Python 为什么读不到数据",
        "周末去哪里露营比较好",
    ]
    print(activity_share(logs))
Sama seperti metode OpenAI, klasifikasi otomatis ini bisa salah menilai, dan satu tugas juga bisa dipecah menjadi beberapa pesan, jadi “proporsi pesan” yang dihitung tidak bisa langsung disamakan dengan beban kerja atau nilai bisnis.
Referensi pemilihan model untuk berbagai aktivitas kerja
Dengan melihat aktivitas yang proporsinya tinggi dalam data, kita bisa melakukan pemilihan awal berdasarkan jenis tugas. Namun, hasil konkretnya tetap perlu diuji pada data Anda sendiri:
| Aktivitas kerja | Fokus kemampuan | Pendekatan pemilihan | Platform yang tersedia |
|---|---|---|---|
| Menyunting materi tertulis | Pemahaman dan penulisan ulang teks | Model percakapan umum dengan rasio harga-kinerja yang baik | APIYI apiyi.com, API resmi |
| Desain visual dan presentasi | Pembuatan dan pemahaman gambar | Model multimodal / gambar | APIYI apiyi.com, API resmi |
| Materi pemasaran dan promosi | Kreativitas dan kontrol gaya | Model unggulan dengan gaya penulisan yang konsisten | APIYI apiyi.com, API resmi |
| Pemrograman dan debugging | Penalaran kode | Model dengan kemampuan kode yang kuat atau agen khusus | APIYI apiyi.com, API resmi |
| Pengambilan keputusan dan konsultasi | Penalaran konteks panjang | Model penalaran, disertai tinjauan manusia | APIYI apiyi.com, API resmi |
Keterbatasan data 165 kategori aktivitas kerja OpenAI
Data ini sangat berharga, tetapi batasannya juga jelas. Berikut beberapa hal yang paling perlu diperhatikan saat mengutipnya:
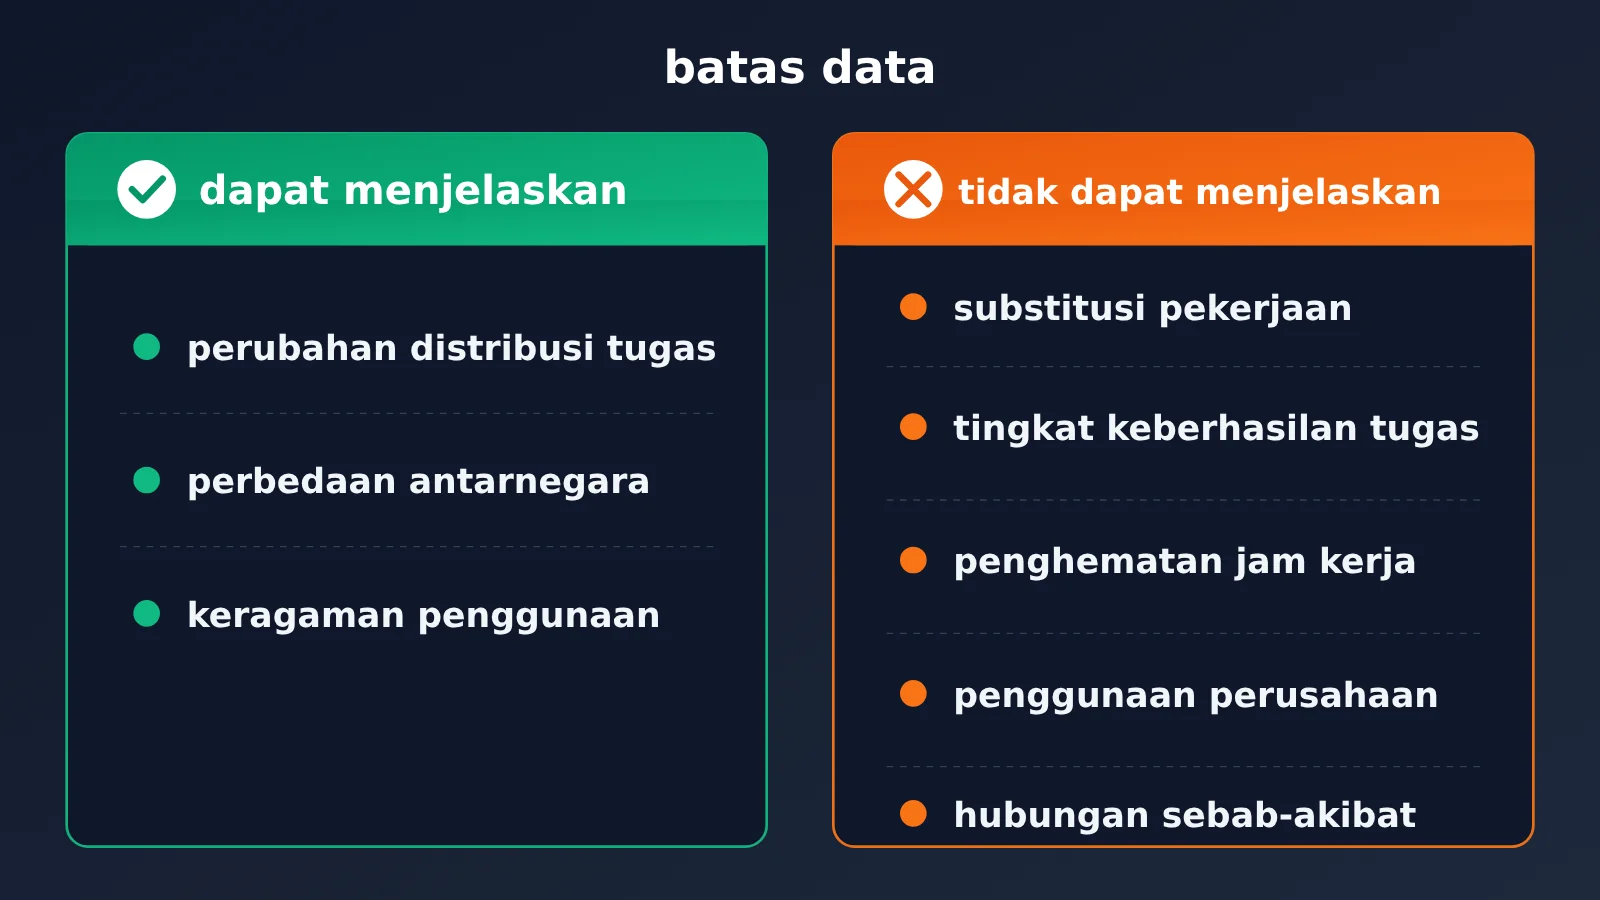
- Sampel hanya mencakup akun pribadi orang dewasa: mengecualikan Enterprise dan Codex, sehingga tidak dapat mewakili seluruh penggunaan produk perusahaan OpenAI untuk pekerjaan.
- Klasifikasi dilakukan secara otomatis: pengklasifikasi LLM dapat salah menafsirkan maksud, misalnya “merancang rencana promosi acara” bisa jadi pekerjaan pemasaran sungguhan, bisa juga sekadar minat pribadi.
- Proporsi pesan tidak sama dengan output: ini tidak mewakili jumlah tugas, durasi kerja, jumlah pengguna, penghematan jam kerja, atau tingkat keberhasilan.
- Ada noise privasi dan ambang sampel: hasil dengan sampel kecil disembunyikan, dan noise privasi diferensial ditambahkan.
- Tidak berkorelasi satu-satu dengan ekonomi nyata: dengan pembobotan berdasarkan jumlah pekerja, sekitar 43% aktivitas kerja nyata di AS masuk kategori “Other IWA”. Ini tidak berarti 43% pekerjaan tidak dapat diselesaikan oleh AI, juga tidak berarti 57% sisanya sudah tercakup oleh ChatGPT.
Selain itu, perhitungan PPC Land menunjukkan bahwa proporsi seluruh pesan pribadi yang ditandai terkait pekerjaan turun dari sekitar 51,6% pada Juli 2024 menjadi sekitar 32,2% pada September 2026. Ini lebih mungkin terkait dengan banyaknya pengguna non-kerja yang bergabung serta sebagian pekerjaan profesional yang beralih ke akun perusahaan dan agen khusus. Oleh karena itu, ini tidak bisa dijadikan dasar untuk menyimpulkan bahwa ChatGPT menjadi tidak penting bagi dunia kerja.
Pertanyaan Umum (FAQ)
Q1: Apa itu data 165 kategori aktivitas kerja yang dirilis OpenAI?
Ini adalah kumpulan data agregat yang dipublikasikan secara terbuka oleh program OpenAI Signals v3.0. Data ini memetakan pesan terkait pekerjaan dari pengguna ChatGPT individu ke 165 kategori aktivitas kerja tingkat menengah O*NET, mencakup hampir 100 negara dan wilayah, dari Q1 2025 hingga Q3 2026 atau total 7 kuartal, dan CSV-nya dapat diunduh gratis.
Q2: Apa perbedaan antara 165 kategori aktivitas kerja dan 165 jenis pekerjaan?
Aktivitas kerja adalah “apa yang dikerjakan”, sedangkan pekerjaan adalah “posisi apa”. Aktivitas yang sama (misalnya mengedit dokumen) bisa muncul di banyak pekerjaan. Jadi, data ini menggambarkan jenis pekerjaan apa yang dibantu diselesaikan dengan ChatGPT, bukan tingkat penggunaan tiap pekerjaan, apalagi menyimpulkan pekerjaan mana yang akan tergantikan.
Q3: Kapan data ini dirilis, dan apakah akan diperbarui?
OpenAI merilisnya pada 26 Oktober 2026, dengan data hingga Q3 2026. Pihak resmi melacak perubahan per kuartal. Apakah nanti akan terus diperbarui mengikuti pengumuman di halaman data OpenAI Signals; artikel ini tidak berspekulasi.
Q4: Proporsi pesan pemrograman menurun, apakah itu berarti kebutuhan AI untuk coding menyusut?
Tidak bisa disimpulkan begitu. Data ini mengecualikan Codex dan akun perusahaan, sedangkan Enterprise Signals menunjukkan porsi token output Codex di sisi perusahaan sangat tinggi. Kebutuhan pemrograman mungkin beralih ke agen khusus, atau mungkin terkait perubahan struktur pengguna; data itu sendiri tidak bisa membedakannya.
Q5: Bagaimana cara mereproduksi analisis klasifikasi aktivitas kerja serupa menggunakan API?
Anda dapat merujuk pada contoh kode di artikel ini, menggunakan Model Bahasa Besar untuk memberi label pada permintaan pengguna Anda sendiri, lalu menghitung proporsinya:
1. Kunjungi APIYI apiyi.com untuk mendaftar akun dan mendapatkan kunci API
2. Dapatkan kuota uji coba gratis untuk pengguna baru
3. Setel base_url dalam kode ke `https://api.apiyi.com/v1`, lalu Anda dapat beralih antar model untuk membandingkan hasil klasifikasi
Q6: Ingin membandingkan performa berbagai model pada tugas desain, copywriting, dan pemrograman. Apakah ada cara yang mudah?
Cara paling praktis adalah memanggil beberapa model melalui antarmuka terpadu, menjalankan kumpulan petunjuk yang sama, lalu mengevaluasi secara manual. Melalui APIYI apiyi.com, satu kunci API dapat digunakan untuk memanggil model OpenAI, Claude, Gemini, dan lainnya, dengan penagihan sesuai penggunaan, cocok untuk eksperimen perbandingan skala kecil seperti ini.
Poin Utama Data 165 Jenis Aktivitas Kerja OpenAI
- Yang dihitung adalah aktivitas, bukan profesi: 165 jenis merujuk pada aktivitas kerja O*NET, termasuk 1 kategori gabungan “Lainnya”.
- Penggunaannya lebih tersebar: rata-rata pangsa sepuluh aktivitas teratas di 74 negara turun dari 56,0% menjadi 51,1%.
- Desain visual mencatat kenaikan terbesar: perhitungan pihak ketiga menunjukkan kenaikan dari 3,1% menjadi 7,9%.
- Pangsa pemrograman turun, tetapi perlu ditafsirkan dengan hati-hati: sampel tidak mencakup Codex dan akun perusahaan.
- Permintaan pemasaran stabil: pangsa materi promosi pemasaran relatif bertahan sekitar 5%.
- Pangsa pesan tidak sama dengan output: tidak bisa disimpulkan adanya penggantian posisi, penghematan jam kerja, atau tingkat keberhasilan.
- Metode klasifikasi dapat digunakan kembali: dengan antarmuka multi-model APIYI apiyi.com, Anda dapat dengan cepat membangun analisis klasifikasi tugas sendiri.
Ringkasan
Informasi inti dari data penggunaan ChatGPT untuk 165 jenis aktivitas kerja OpenAI:
- Sifat data: satu set data riset gratis dan terbuka yang dilacak setiap kuartal, mengukur “aktivitas kerja apa yang dilakukan pengguna dengan ChatGPT” pada akun pribadi.
- Temuan utama: penggunaan untuk kerja makin tersebar; desain visual, saran konsultasi, dan pemikiran kreatif meningkat; sementara pangsa pesan pemrograman umum turun.
- Batas interpretasi: data tidak mencakup akun perusahaan dan Codex; pangsa pesan tidak bisa disamakan dengan beban kerja, dampak pada posisi, atau nilai ekonomi.
Yang benar-benar diungkapkan data ini bukanlah 165 jenis pekerjaan mana yang akan segera hilang, melainkan bahwa AI memasuki berbagai alur kerja dengan cara yang lebih terperinci dan beragam, serta berbeda menurut negara dan jenis tugas. Bagi pengembang, daripada bertanya “siapa yang akan digantikan AI”, lebih baik melihat aktivitas apa yang sebenarnya diselesaikan pengguna dengan AI, lalu memilih model dan alur kerja yang tepat untuk aktivitas tersebut.
Disarankan untuk memverifikasi performa berbagai model dalam skenario bisnis Anda melalui APIYI apiyi.com. Platform ini menyediakan kuota uji gratis dan antarmuka terpadu untuk banyak model.
📚 Referensi
- Pengumuman resmi OpenAI: ChatGPT’s expanding world of work: Sumber utama dari rilis kali ini
- Tautan:
openai.com/index/chatgpt-expanding-world-of-work -
Keterangan: 165 kategori aktivitas, hampir 100 negara, temuan resmi seperti 56,0% ke 51,1%
-
Unduhan data dan penjelasan metodologi OpenAI Signals: Pintu masuk CSV asli dan kamus data
- Tautan:
openai.com/signals/data-download -
Keterangan: Cakupan sampel, penanganan privasi, dan penjelasan lisensi CC BY 4.0
-
PPC Land: Writing drops from 34% to 21% of ChatGPT requests since July 2024: Analisis CSV pihak ketiga
- Tautan:
ppc.land/writing-drops-from-34-to-21-of-chatgpt-requests-since-july-2024 -
Keterangan: Peringkat aktivitas spesifik, perubahan proporsi desain visual dan pemrograman
-
PPC Land: Americans use ChatGPT at work most to make decisions: Pembacaan grafik interaksi AS–Jerman
- Tautan:
ppc.land/americans-use-chatgpt-at-work-most-to-make-decisions-1-in-5-requests -
Keterangan: Data perbandingan antarnegara untuk aktivitas kerja yang luas
-
Situs resmi O*NET: Sistem klasifikasi aktivitas kerja dan profesi
- Tautan:
onetcenter.org -
Keterangan: Memahami definisi IWA dan 332 entri referensi
-
OpenAI Enterprise Signals: Data penggunaan akun perusahaan
- Tautan:
openai.com/signals/enterprise-data - Keterangan: Digunakan untuk membedakan cakupan data individu dan perusahaan
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami di halaman utama situs APIYI, lebih banyak materi integrasi dapat diakses di pusat dokumentasi docs.apiyi.com




