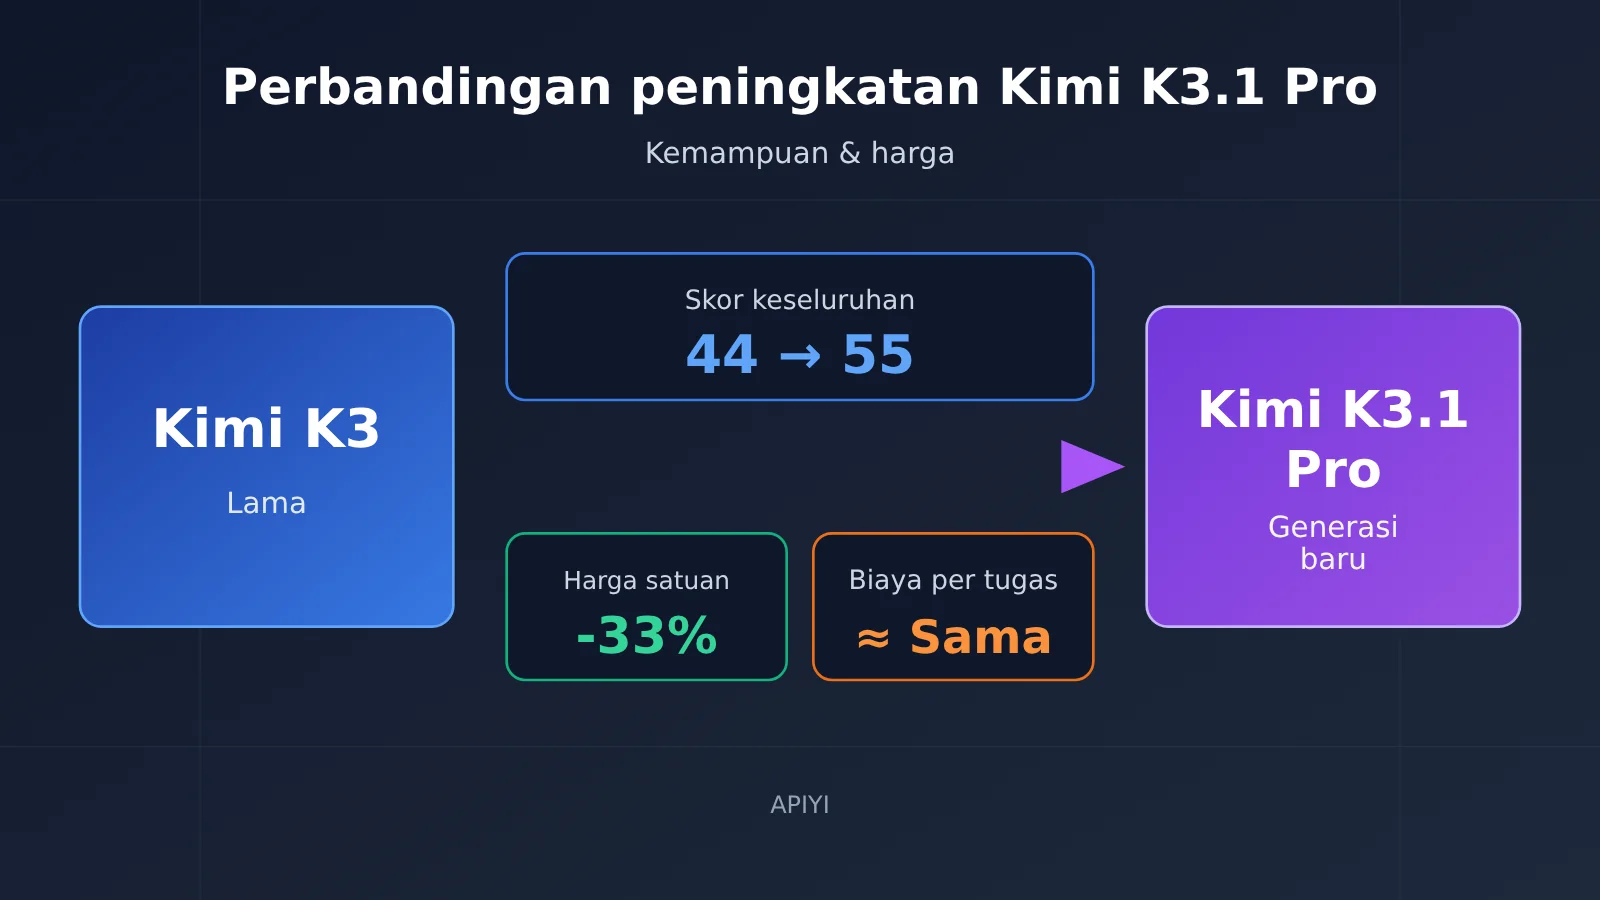
Dari segi kemampuan, Kimi K3.1 Pro mengalami peningkatan signifikan dibandingkan K3: skor Intelligence Index dari Artificial Analysis, pihak ketiga, naik dari 44 menjadi 55. Skor K3.1 Pro di Terminal-Bench 4.0, benchmark terminal untuk coding agent, juga naik dari 13% menjadi 67%. Harganya justru turun sepertiga: tarif input, output, dan cache masing-masing 33% lebih rendah daripada K3. Namun, output-nya lebih panjang dan model selalu berpikir, sehingga biaya untuk menjalankan satu tugas pada praktiknya kurang lebih sama dengan K3.
Berikut bukti pendukungnya. Setiap informasi diberi label sesuai sumbernya: «klaim resmi», «pihak ketiga», atau «belum terverifikasi». Artikel ini bukan rangkuman acara peluncuran dan juga tidak menyarankan semua orang langsung beralih. Tujuannya membantu developer yang sedang menggunakan K3 menilai apakah bisnis mereka perlu beralih, kapan waktu yang tepat, dan hal apa saja yang perlu diperhatikan saat migrasi.
1. 5 perbedaan utama Kimi K3.1 Pro dibandingkan generasi sebelumnya
K3.1 Pro bukan model baru yang dilatih dari awal, melainkan hasil «pascapelatihan» berskala besar pada K3. Pascapelatihan adalah proses menyesuaikan cara model bekerja menggunakan lebih banyak data dan umpan balik setelah model dasar selesai dilatih. Menurut klaim resmi, model ini adalah «model pertama dalam seri K3.1» dan «model berbobot terbuka kelas 3T terkuat». Istilah bobot terbuka berarti file parameter model akan dipublikasikan dan bisa diunduh untuk diterapkan sendiri. Artificial Analysis mencatat total parameter model ini sebesar 2.8T, dengan 104B parameter aktif yang terlibat dalam komputasi setiap kali model digunakan.
| Aspek | Kimi K3 | Kimi K3.1 Pro | Sumber |
|---|---|---|---|
| Metode pelatihan | Versi dasar | Pascapelatihan berbasis K3, dengan peningkatan besar pada komputasi pascapelatihan | Klaim resmi |
| Kemampuan keseluruhan | Intelligence Index 44 | 55, peringkat ke-4 di seluruh daftar | Pihak ketiga (AA, 2026-10-23) |
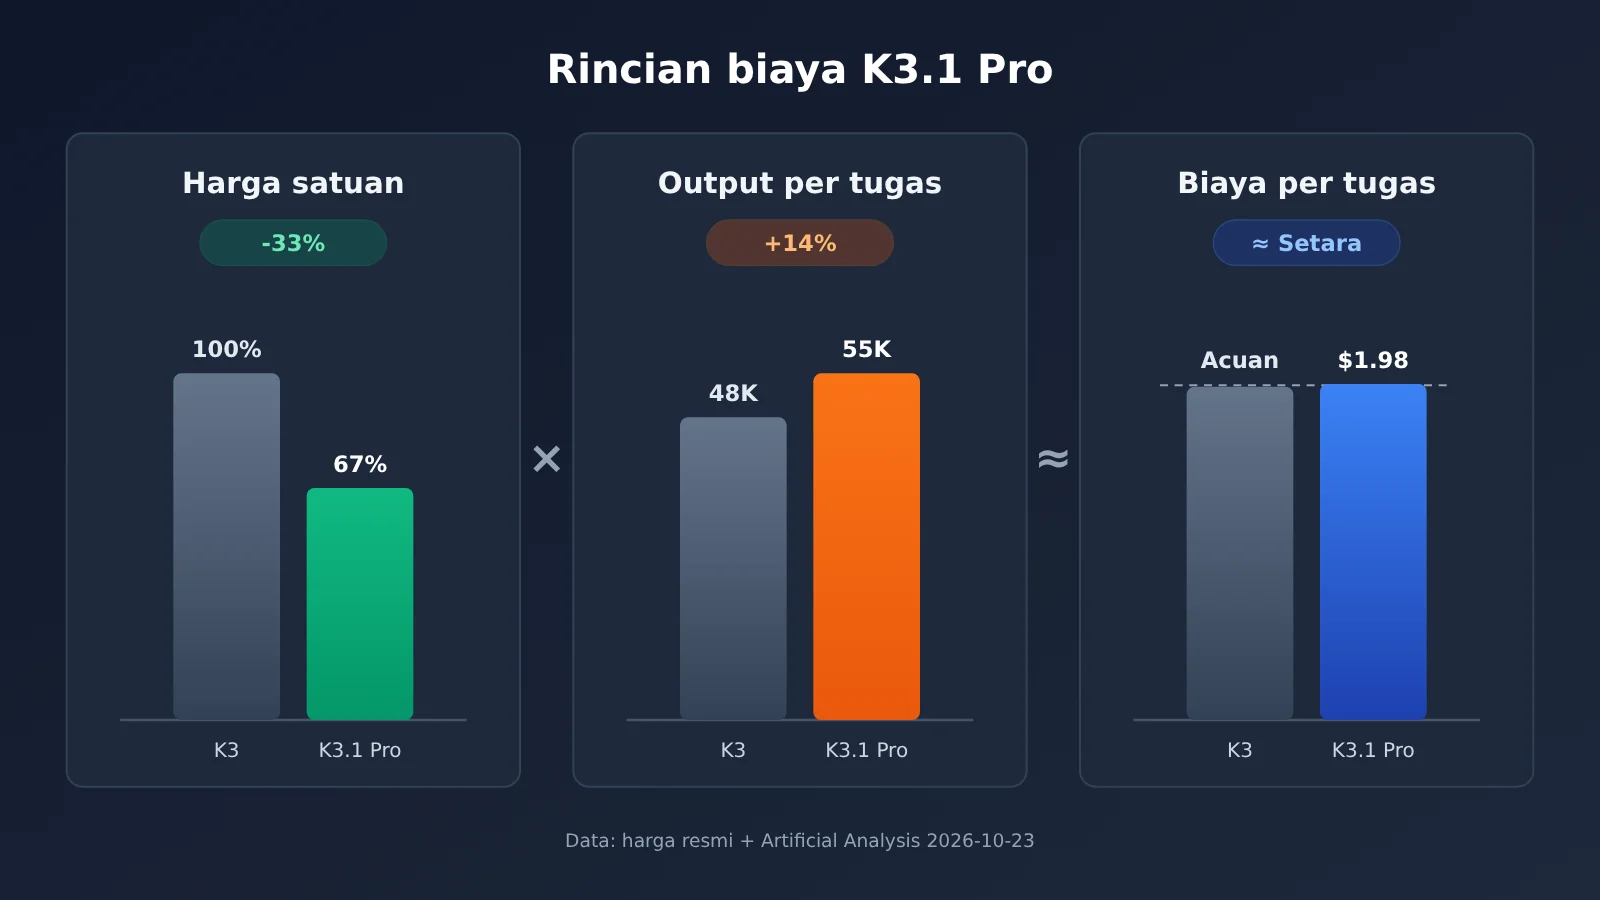
| Tarif | Input $3 / output $15 | Input $2 / output $10, turun 33% | Harga resmi |
| Output per tugas | Rata-rata 48K token | Rata-rata 55K token, naik 14% | Pihak ketiga (AA) |
| Konteks / modalitas | 1M / teks+gambar | 1M / teks+gambar, tidak berubah | Klaim resmi |
Token adalah satuan dasar untuk menghitung penggunaan dan biaya model. Secara sederhana, token bisa dipahami sebagai «potongan kata»; satu karakter Mandarin biasanya setara dengan satu hingga dua token. Saat membaca tabel ini, perhatikan dua perubahan utama: skor kemampuan meningkat dan tarif turun. Kolom ketiga, «output per tugas», menentukan seberapa besar penghematan yang benar-benar bisa diperoleh setelah tarif turun. Bagian 4 akan membahasnya lebih lanjut.
Untuk bobot model, pihak resmi berjanji akan merilis bobot lengkap sebelum 2026-11-04. Berdasarkan tanggal saat ini (2026-10-24), hal ini masih berupa janji dan belum dipenuhi, sehingga statusnya «belum terverifikasi». Menurut analisis Artificial Analysis, setelah bobotnya dirilis, K3.1 Pro akan menjadi model berbobot terbuka dengan skor tertinggi dalam daftar lembaga tersebut. Selisih antara model berbobot terbuka dan model tertutup dengan skor tertinggi juga akan menyusut dari 12 poin menjadi 3 poin.
2. Perbandingan Skor Kimi K3.1 Pro: Dua Acuan Berbeda dari Klaim Resmi dan Pengujian Pihak Ketiga
Perlu diperjelas terlebih dahulu: dua tabel di bawah berasal dari lembaga dan lingkungan pengujian yang berbeda, jadi skornya tidak bisa dibandingkan langsung. Contoh paling jelas adalah Terminal-Bench 4.0. Skor yang dilaporkan sendiri oleh pihak resmi adalah 65,7%, sedangkan Artificial Analysis mengukur skor 67% secara independen. Keduanya berasal dari dua pengujian berbeda, bukan selisih dari satu skor yang sama. Pihak resmi juga tidak memberikan skor K3 untuk Terminal-Bench 4.0; angka 13% untuk K3 hanya berasal dari Artificial Analysis.
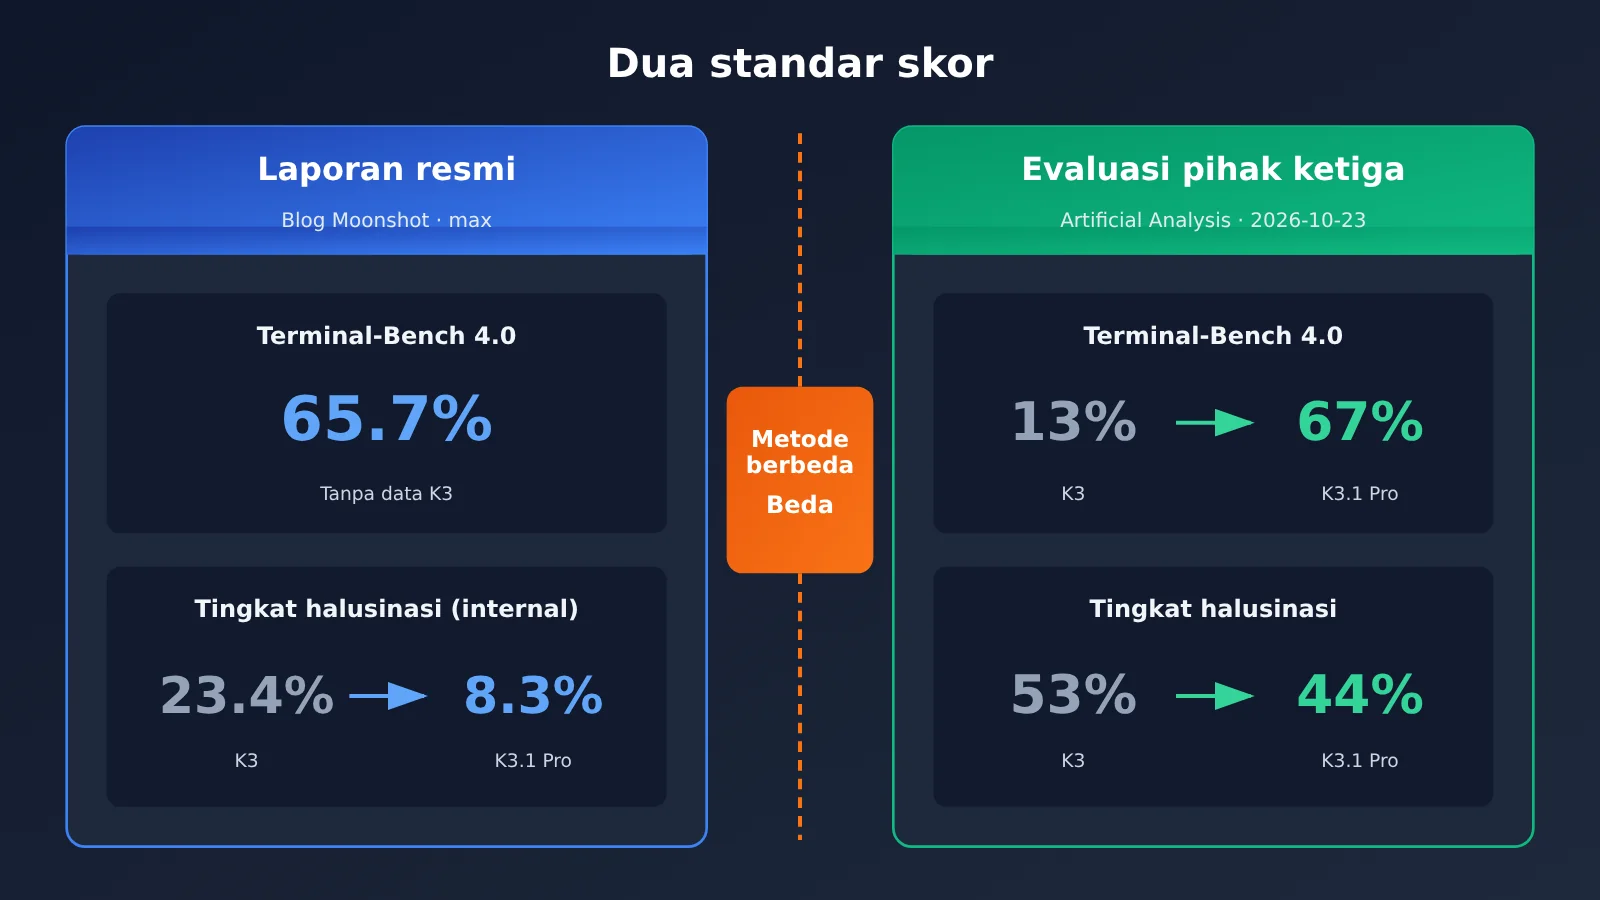
2.1 Skor Kimi K3.1 Pro yang Dilaporkan Pihak Resmi
Sumber: blog resmi Moonshot. Kondisi pengujian: kecuali disebutkan secara khusus, semua pengujian menggunakan reasoning_effort=max (intensitas penalaran diatur ke maksimum), temperature=1.0, dan top_p=0.95. Label «internal» menandakan bahwa pengujian menggunakan set data buatan Moonshot sendiri dan tidak bisa direplikasi oleh pihak luar.
| Aspek | K3.1 Pro | Pembanding | Catatan |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra 58.2%, Claude Opus 5.5 66.4% | Opus 5.5 diuji menggunakan harness Claude Code |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | K3 55.95% | Internal, tugas pemrograman dengan rangkaian langkah panjang |
| BenchCAD | 92.7% (dengan alat) | Opus 5.5 96.2%, GPT-6 Astra 95.9% | Mengubah gambar teknik multiview menjadi kode CAD |
| OfficeQA Pro v2 | 64.4 | Lebih tinggi daripada K3 | Analisis dokumen laporan keuangan nyata; pihak resmi menyebutnya sebagai SOTA |
| Financial Modeling / Research | 7.2 / 11.6 poin lebih tinggi daripada K3 | K3 | Internal |
| Business Operation | Sekitar 4.2 kali skor K3 | K3 | Simulasi operasi bisnis internal |
| Kimi Hallu Bench Hard | Tingkat halusinasi tingkat klaim 8.3% | K3 23.4% | Uji tekanan faktualitas internal |
| xdev-bench-hard (pass@3) | 81.0% | Versi pembanding yang belum melalui penyaringan keamanan: 90.5% | Pencarian kerentanan |
Beberapa istilah: harness adalah «kerangka kendali» yang dipasang di luar model saat pengujian. Kerangka ini bertugas memanggil alat dan menjalankan perintah. Skor bisa berubah jika kerangkanya berbeda, jadi skor Opus 5.5 perlu dilihat secara terpisah. pass@3 berarti model mendapat tiga kesempatan untuk menjawab soal yang sama, dan dianggap lulus jika berhasil sekali. Baris terakhir menunjukkan bahwa demi keamanan, pihak resmi sengaja membatasi kemampuan model dalam mencari kerentanan. Versi resminya mencetak skor sekitar 9.5 poin persentase lebih rendah daripada versi internal yang belum dibatasi.
2.2 Skor Kimi K3.1 Pro dari Pengujian Pihak Ketiga (Artificial Analysis)
Sumber: Artificial Analysis, data per 2026-10-23. Proses pengujian dilakukan secara seragam oleh lembaga tersebut, dengan metode yang sama untuk K3 dan K3.1 Pro.
| Metrik | K3.1 Pro | K3 | Perubahan |
|---|---|---|---|
| Intelligence Index | 55 (peringkat ke-4) | 44 | +11 |
| GDPval-AA (Elo untuk tugas kerja nyata) | 1846 (peringkat ke-3) | 1534 | +312 |
| Terminal-Bench 4.0 | 67% | 13% | +54 poin persentase |
| AutomationBench-AA (alur kerja SaaS) | 73% | 58% | +15 |
| Humanity’s Last Exam | 52% | 47% | +5 |
| CritPt / SciCode | 25% / 61% | 23% / 59% | +2 / +2 |
| AA-Omniscience Index | 30 | 20 | +10 |
| Tingkat halusinasi / akurasi | 44% / 51% | 53% / 48% | Halusinasi -9 |
| Rata-rata token keluaran per tugas | 55K | 48K | +14% |
Di papan peringkat Artificial Analysis, K3.1 Pro berada di posisi ke-4, setelah Claude Opus 5.5 (58), Claude Sonnet 5.5 (56), dan Muse Wonder Full (56). Skor 67% pada Terminal-Bench 4.0 merupakan yang tertinggi di antara semua model yang pernah diuji lembaga tersebut. Sonnet 5.5 memperoleh skor 64%.
Kesimpulan dari kedua pengujian soal halusinasi sejalan, tetapi angka spesifiknya sangat berbeda: hasil uji tekanan internal menunjukkan penurunan dari 23,4% menjadi 8,3%, sedangkan AA mencatat penurunan dari 53% menjadi 44%. Keduanya menggunakan kumpulan soal yang berbeda, dengan tingkat kesulitan dan metode penghitungan yang juga berbeda. Saat mengutip data untuk publik, cantumkan sumbernya dan jangan menggabungkannya menjadi klaim seperti “tingkat halusinasi turun menjadi 8%”.
3. 5 aspek yang mengalami peningkatan signifikan pada Kimi K3.1 Pro
Bagian ini hanya membahas aspek yang menunjukkan peningkatan berdasarkan kedua rangkaian data, atau yang peningkatannya cukup besar.
- Agent pemrograman dan tugas terminal. Agent adalah asisten AI yang mampu memecah tugas sendiri, menggunakan alat, dan menjalankan beberapa langkah. AA mencatat skor Terminal-Bench 4.0 naik dari 13% menjadi 67%, sementara pengujian internal resmi untuk pemrograman dengan rangkaian langkah panjang naik dari 55,95% menjadi 61,2%. Jika Agent kode yang Anda jalankan dengan K3 sering tersendat saat menjalankan perintah, mengelola file, atau menelusuri kesalahan dalam beberapa langkah, inilah aspek dengan peningkatan paling besar.
- Tugas kerja nyata. GDPval-AA mengukur kemampuan model menyelesaikan tugas profesional di dunia nyata menggunakan skor Elo. Elo adalah sistem peringkat dalam pertandingan; sistem ini juga digunakan untuk peringkat pemain catur. Semakin besar selisih skornya, semakin besar pula perbedaan tingkat kemenangannya. K3.1 Pro unggul 312 poin dari K3 dan menempati peringkat ke-3. Ini menunjukkan peningkatan nyata untuk pekerjaan sehari-hari seperti menyusun proposal, membuat spreadsheet, dan merapikan materi.
- Otomatisasi alur kerja SaaS. AutomationBench-AA mengukur kemampuan model menjalankan proses otomatisasi di berbagai perangkat lunak online, misalnya membaca email, mengubah tiket, dan menyinkronkan spreadsheet. Skornya naik dari 58% menjadi 73%. Dalam pengujian internal resmi berupa simulasi operasi bisnis (Business Operation), skornya mencapai sekitar 4,2 kali skor K3. Hasil ini juga menunjukkan peningkatan kemampuan menjalankan proses panjang, tetapi karena berasal dari data internal, anggaplah sebagai referensi saja.
- Faktualitas dan halusinasi. Halusinasi adalah saat model dengan yakin mengarang fakta yang sebenarnya tidak ada. Dalam pengujian internal resmi, tingkat halusinasi pada level klaim (dihitung berdasarkan setiap pernyataan fakta) turun dari 23,4% menjadi 8,3%. Jumlah jawaban yang mengandung setidaknya satu kesalahan fakta tinggal 42,4% dari jumlah pada K3. Tingkat halusinasi AA turun dari 53% menjadi 44%, sementara akurasinya naik dari 48% menjadi 51%.
- Pemodelan keuangan dan laporan riset. Menurut pihak resmi, skor OfficeQA Pro v2 sebesar 64,4 merupakan SOTA (skor terbaik saat ini). Skor internal Financial Modeling dan Financial Research masing-masing naik 7,2 poin dan 11,6 poin dibandingkan K3. Hasil-hasil ini belum diuji ulang secara independen oleh pihak ketiga, jadi kategorikan sebagai «klaim resmi».
Metrik penalaran ilmiah (Humanity’s Last Exam, CritPt, SciCode) juga meningkat, tetapi hanya sebesar 2–5 poin persentase. Jika bisnis Anda berfokus pada tanya jawab akademis atau kode untuk riset ilmiah, peningkatan K3.1 Pro tidak sebesar pada tugas Agent. Pengguna dengan kebutuhan seperti ini tidak perlu terburu-buru beralih hanya karena hasil pada beberapa metrik tersebut.
4. Hal yang Tidak Banyak Berubah pada Kimi K3.1 Pro dan Dampaknya terhadap Biaya
4.1 Tiga hal yang tidak berubah pada Kimi K3.1 Pro
- Jendela konteks tetap 1M: 1.048.576 token, sama seperti K3. Jendela konteks bisa dipahami sebagai jumlah total konten yang dapat “dilihat” model dalam sekali proses.
- Modality tetap teks + gambar: belum ada tambahan metode input seperti audio atau video.
- Belum ada tolok ukur kecepatan yang diumumkan secara resmi: AA mengukur kecepatan output sebesar 80,7 token/detik, yang masuk tingkat ke-2 dari 4 kategori kecepatan lembaga tersebut. Pihak resmi menyebut versi highspeed 2–3 kali lebih cepat, tetapi tidak memberikan kondisi pengujian yang bisa direproduksi. Klaim ini untuk sementara berstatus “belum terverifikasi”.
4.2 Perbandingan harga Kimi K3.1 Pro dalam lima kategori
Berikut adalah harga resmi, diambil pada 2026-10-24, dalam dolar AS per satu juta token, belum termasuk pajak.
| Model | Input | Output | Cache hit | Penulisan cache 5 menit | Penulisan cache 1 jam |
|---|---|---|---|---|---|
kimi-k3.1-pro |
$2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
kimi-k3 |
$3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
Cache hit berarti konten awalan yang sama dikirim berulang kali—misalnya petunjuk sistem yang tetap atau dokumen panjang yang sama—akan dikenai tarif lebih rendah mulai pengiriman kedua. Penulisan cache 5 menit dan 1 jam adalah biaya untuk menyimpan konten ke cache; semakin lama disimpan, semakin tinggi biayanya. Cache sangat berguna untuk tugas Agent atau tanya jawab tentang dokumen panjang. Jika struktur petunjuk stabil, biaya input pada tagihan bisa jauh lebih hemat.
4.3 Dampak biaya Kimi K3.1 Pro: harga turun bukan berarti lebih hemat
K3.1 Pro selalu berpikir, artinya model melakukan penalaran internal sebelum menjawab. Penalaran ini dihitung sebagai token output. AA mengukur rata-rata output sebanyak 55K token per tugas, 14% lebih banyak daripada K3 yang menghasilkan 48K token.
Jika hanya melihat harga per token, penurunan sebesar 33% semestinya memberikan penghematan yang cukup besar. Namun, pengujian AA menunjukkan biaya per tugas sekitar $1,98 (halaman detail model mencantumkan $2,11), hampir sama dengan K3. Lembaga tersebut tidak memublikasikan rincian perhitungan biaya, jadi belum ada penjelasan resmi tentang mengapa biaya tidak turun. Salah satu kemungkinannya, jumlah token input ikut meningkat dalam pemanggilan berulang untuk tugas Agent. Namun, ini hanya dugaan dan masih “belum terverifikasi”.
Selain itu, harga versi highspeed dua kali lipat dari versi standar. Tim yang sensitif terhadap biaya sebaiknya menguji sejumlah sampel tugas nyata sebelum beralih, lalu membandingkan total pengeluaran—jangan hanya membandingkan harga per token.
Untuk membandingkan biaya penggunaan K3 dan K3.1 Pro dengan kode yang sama, Anda bisa mulai dengan menghubungkan antarmuka yang kompatibel dengan OpenAI dari APIYI apiyi.com, lalu menjalankan kimi-k3 sebagai acuan. Nama model dan harga K3.1 Pro di platform mengikuti daftar model yang tersedia di platform. Kami akan segera menghadirkan model ini.
5. Rekomendasi penggunaan Kimi K3.1 Pro: kapan sebaiknya beralih dan kapan belum perlu
Berikut kesimpulan berdasarkan jenis tugas, sebagai referensi bagi pengguna K3 saat ini.
| Jenis tugas | Kesimpulan | Alasan |
|---|---|---|
| Agent pemrograman, otomatisasi terminal | Sebaiknya segera beralih | Skor Terminal-Bench pihak ketiga naik dari 13% menjadi 67%, sementara skor resmi untuk pemrograman dengan rangkaian langkah panjang meningkat lebih dari 5 poin |
| Analisis dokumen, laporan riset, pemodelan keuangan | Sebaiknya beralih | Skor Elo GDPval naik 312 poin. Dalam pengujian resmi untuk laporan keuangan dan laporan riset, hasilnya unggul di semua aspek dibandingkan K3, dengan halusinasi yang jauh berkurang |
| Alur kerja SaaS, proses bisnis bertahap | Sebaiknya beralih | Skor AutomationBench-AA naik dari 58% menjadi 73% |
| Tugas kecil dalam jumlah besar (klasifikasi, ekstraksi, penulisan ulang) | Belum perlu | Biaya per tugas setara dengan K3. Mode selalu berpikir menambah panjang keluaran, sedangkan peningkatan kemampuan tidak terlalu berpengaruh untuk tugas sederhana |
| Skenario yang sensitif terhadap latensi (percakapan real-time, layanan pelanggan online) | Uji dulu sebelum memutuskan | Tidak ada data kecepatan resmi. Mode selalu berpikir memperpanjang waktu hingga karakter pertama muncul, sedangkan harga highspeed menjadi dua kali lipat |
“Belum perlu” bukan berarti K3 tidak bagus. K3 sudah cukup untuk tugas sederhana, dengan latensi dan biaya yang lebih mudah diperkirakan. Anda tidak perlu menulis ulang seluruh pipeline pemrosesan batch hanya demi skor keseluruhan yang lebih tinggi. Evaluasi lagi setelah bobot K3.1 Pro dirilis dan data kecepatan dari pihak ketiga lebih lengkap. Tidak ada kata terlambat untuk beralih nanti.
5.1 Skenario umum yang cocok untuk Kimi K3.1 Pro
- Memperbaiki bug, melakukan refaktor, dan menulis pengujian di seluruh repositori kode—model perlu menjalankan perintah sendiri, memeriksa pesan kesalahan, lalu melakukan perbaikan.
- Tanya jawab dan peringkasan laporan keuangan, kontrak, serta laporan riset yang panjang dan menuntut akurasi fakta tinggi.
- Alur otomatisasi yang melibatkan beberapa alat online, dengan lebih dari sepuluh langkah untuk menyelesaikan satu tugas.
5.2 Skenario umum yang cocok untuk tetap menggunakan Kimi K3 sementara
- Klasifikasi label dan ekstraksi kolom untuk ratusan ribu data setiap hari, dengan biaya dihitung berdasarkan jumlah data.
- Interaksi real-time yang membutuhkan latensi rendah dan stabil, dengan parameter batas waktu dan percobaan ulang yang sudah disesuaikan untuk K3.
Rekomendasi: Cara paling andal adalah menjalankan 50–100 sampel nyata dari bisnis Anda di kedua model, lalu membandingkan tingkat penyelesaian dan total biayanya. APIYI apiyi.com memungkinkan Anda beralih antar-model menggunakan satu kunci API, sehingga cocok untuk pengujian perbandingan seperti ini. Sebelum K3.1 Pro tersedia, Anda bisa menggunakan
kimi-k3untuk menjalankan pengujian dasar. Jenis model dan harga K3.1 Pro mengikuti daftar model di platform. Kami akan menyediakan model ini secepatnya.
6. Rekomendasi dan Hal yang Perlu Diperhatikan Saat Bermigrasi ke Kimi K3.1 Pro
6.1 Jadwal Penghentian Seri Kimi K2
Jika Anda masih menggunakan seri K2, prioritaskan migrasi ini. Dokumentasi resmi menyebutkan bahwa mulai 2026-10-31, seri K2 tidak lagi tersedia bagi pengguna baru, lalu seluruh modelnya akan dihentikan sebelum akhir 2026. Pengguna lama mungkin masih bisa menggunakannya untuk sementara, tetapi sebaiknya migrasi diselesaikan dalam dua bulan ke depan. Langsung beralih ke K3 atau K3.1 Pro, jangan menunggu hingga modelnya dihentikan.
6.2 Tiga Hal yang Perlu Diperhatikan Saat Beralih ke Kimi K3.1 Pro
- Mulai sesi baru, jangan berganti model di tengah sesi. Pihak resmi menyarankan penggunaan K3.1 Pro di sesi baru. Melanjutkan percakapan K3 yang sudah ada dengan K3.1 Pro dapat menimbulkan masalah kompatibilitas pada format konteks atau konten pemikiran.
- Utamakan antarmuka native. Menurut pihak resmi, tiga antarmuka native—Responses, Chat Completions, dan Messages—adalah pilihan yang paling stabil.
- Pastikan nama model ditulis dengan tepat. Jika nama
kimi-k3.1-prosalah ditulis saat dimasukkan ke alat pihak ketiga, permintaan akan dialihkan ke K2.8 Preview dan model tidak akan melakukan proses pemikiran. Masalah ini tidak memunculkan pesan kesalahan, tetapi kualitas hasilnya menurun sehingga perlu waktu untuk melacak penyebabnya. Sebelum digunakan di lingkungan produksi, periksa kolom model pada respons.
6.3 Perbedaan Tingkat Keanggotaan Kimi Code
Ada persyaratan tingkat keanggotaan untuk menggunakan model baru di Kimi Code:
k3.1-promemerlukan keanggotaan Plus atau lebih tinggi.- Konteks 1M memerlukan keanggotaan Pro atau lebih tinggi.
- Versi highspeed memerlukan keanggotaan Pro atau lebih tinggi dan menghabiskan kuota sekitar 2 kali lipat.
Anggota Plus bisa menggunakan K3.1 Pro, tetapi tidak mendapatkan konteks 1M secara penuh. Jika Anda mengandalkan konteks sangat panjang untuk membaca seluruh repositori kode, pastikan tingkat keanggotaan Anda sebelum memutuskan untuk meningkatkannya.
6.4 Daftar Pemeriksaan untuk Integrasi melalui API
- Isi
base_urldenganhttps://api.apiyi.com/v1, yaitu alamat APIYI apiyi.com yang kompatibel dengan OpenAI. Kode yang menggunakan OpenAI SDK hanya perlu mengubah alamat ini dan kunci API. - Gunakan
kimi-k3terlebih dahulu untuk memastikan alur kerja berjalan, lalu isi nama model K3.1 Pro yang tepat sesuai daftar model di platform. Nama model dan harga K3.1 Pro mengacu pada daftar model di platform. Kami akan segera menyediakan model ini. - Atur waktu tunggu lebih lama. Mode pemikiran selalu aktif dapat membuat setiap respons lebih lambat.
- Jangan mengatur
max_tokensterlalu ketat karena konten pemikiran bisa mengurangi ruang untuk keluaran utama.
FAQ
Q1: Apa itu Kimi K3.1 Pro, dan apa hubungannya dengan K3?
K3.1 Pro adalah versi baru yang dikembangkan Moonshot dengan menambah komputasi pascapelatihan pada K3. Menurut pihak resmi, model ini merupakan model pertama dalam seri K3.1. Jendela konteks dan modalitas inputnya sama dengan K3, sementara peningkatan utamanya berfokus pada Agent pemrograman, tugas kerja nyata, dan akurasi faktual.
Q2: Skor Terminal-Bench Kimi K3.1 Pro sebenarnya 65,7% atau 67%?
Keduanya benar, tetapi sumbernya berbeda. Angka 65,7% dilaporkan oleh pihak resmi, sedangkan 67% diperoleh dari pengujian independen Artificial Analysis. Lingkungan pengujian dan harness yang digunakan berbeda, jadi kedua angka tersebut tidak bisa dianggap sebagai skor yang sama. Cantumkan sumber saat mengutipnya.
Q3: Harga satuan Kimi K3.1 Pro turun 33%. Kenapa biayanya tidak lebih murah?
Model ini selalu berpikir, sehingga rata-rata keluarannya untuk setiap tugas 14% lebih banyak daripada K3. Dalam pengujian AA, biaya per tugas sekitar $1,98 (halaman model mencantumkan $2,11), kurang lebih sama dengan K3. Lembaga tersebut tidak merinci penyebabnya, jadi sebaiknya uji dengan tugas Anda sendiri.
Q4: Kapan bobot Kimi K3.1 Pro akan dibuka?
Pihak resmi berjanji akan merilis bobot lengkap sebelum 2026-11-04. Per 2026-10-24, hal ini masih sebatas janji dan belum terealisasi. Jika berencana melakukan deployment mandiri, tunggu pengumuman resmi dan jadikan rilis aktual sebagai acuan.
Q5: Bagaimana cara cepat membandingkan Kimi K3.1 Pro dan K3 melalui API?
Anda bisa mendaftar di APIYI apiyi.com untuk mendapatkan kunci API dan kuota uji coba gratis. Gunakan antarmuka yang kompatibel dengan OpenAI untuk menjalankan `kimi-k3` sebagai baseline. Nama model dan harga K3.1 Pro di platform mengikuti daftar model yang tersedia. Kami akan segera menghadirkan model ini. Setelah tersedia, Anda cukup mengubah parameter `model` untuk membandingkannya.
Q6: Apa saja batasan Kimi K3.1 Pro yang sudah diketahui?
– Pihak resmi belum memublikasikan tolok ukur kecepatan; harga versi highspeed dua kali lipat.
– Model ini selalu berpikir, sehingga kurang cocok untuk skenario yang membutuhkan latensi sangat rendah.
– Beberapa hasil yang mengesankan berasal dari set pengujian internal dan tidak dapat direproduksi oleh pihak eksternal.
– Kemampuan menemukan kerentanan dibatasi demi keamanan, sehingga lebih rendah daripada versi yang belum melalui penyaringan.
Q7: Saya masih menggunakan K2. Apakah sebaiknya langsung beralih ke K3.1 Pro?
Seri K2 akan ditutup untuk pengguna baru mulai 2026-10-31 dan dihentikan sebelum akhir tahun, jadi Anda harus bermigrasi. Untuk kebutuhan Agent pemrograman dan bisnis berbasis dokumen, Anda bisa langsung beralih ke K3.1 Pro. Untuk tugas kecil dalam jumlah besar, beralih ke K3 akan lebih praktis. Di APIYI apiyi.com, Anda bisa memulai migrasi dengan `kimi-k3`. Nama model dan harga K3.1 Pro mengikuti daftar model yang tersedia di platform. Kami akan segera menghadirkan model ini.
Poin-Poin Utama Kimi K3.1 Pro
- Kemampuan meningkat signifikan: Skor keseluruhan AA naik dari 44 menjadi 55, menempati peringkat ke-4, hanya di bawah tiga model closed-source.
- Peningkatan terbesar ada pada Agent pemrograman: Pengujian pihak ketiga di Terminal-Bench 4.0 menunjukkan skor naik dari 13% menjadi 67%.
- Pisahkan dua sumber data: Data yang dilaporkan sendiri oleh pihak resmi menggunakan tolok ukur berbeda dari AA. Cantumkan sumber saat mengutipnya.
- Harga lebih rendah bukan berarti biaya ikut turun: Harga per unit turun 33%, tetapi biaya per tugas pada dasarnya setara dengan K3.
- Spesifikasi dasar tidak berubah: Jendela konteks 1M, mendukung teks dan gambar, tanpa data kecepatan resmi.
- Pastikan nama model ditulis dengan benar saat migrasi: Jika salah, sistem akan kembali ke K2.8 Preview tanpa mode berpikir.
- Cara mengakses: Anda bisa mulai dengan memakai APIYI apiyi.com untuk menjalankan baseline K3. Nama model dan harga K3.1 Pro mengikuti daftar model di platform. Kami akan segera menyediakan model ini.
Kesimpulan: Apakah Kimi K3.1 Pro Layak Dimigrasikan dari K3?
Perubahan Kimi K3.1 Pro dibandingkan generasi sebelumnya dapat dirangkum dalam tiga poin:
- Kemampuan: Agent pemrograman, tugas terminal, tugas kerja nyata, otomatisasi SaaS, dan faktualitas meningkat signifikan. Arah data pihak ketiga dan data resmi juga selaras.
- Harga: Harga per unit untuk kelima tingkat turun 33% dibandingkan K3. Namun, mode berpikir yang selalu aktif menghasilkan keluaran lebih panjang, sehingga biaya per tugas pada dasarnya tidak berkurang.
- Migrasi: Bisnis yang menggunakan Agent pemrograman serta dokumen dan laporan riset disarankan segera beralih. Untuk tugas kecil dalam jumlah besar dan skenario yang sensitif terhadap latensi, uji terlebih dahulu sebelum memutuskan. Pengguna K2 perlu menyelesaikan migrasi sebelum akhir tahun.
APIYI apiyi.com saat ini menyediakan model Kimi seperti kimi-k3 (input $3 / output $15). Anda bisa memakai kunci yang sama dan antarmuka yang kompatibel dengan OpenAI untuk membuat baseline biaya dan performa terlebih dahulu. Nama model dan harga Kimi K3.1 Pro di platform mengikuti daftar model yang tersedia. Kami akan segera menyediakan model ini. Setelah tersedia, Anda cukup mengganti nama model untuk membandingkannya.
Referensi
- Blog resmi Moonshot: Catatan peluncuran Kimi K3.1 Pro dan hasil benchmark yang dilaporkan secara resmi
- Catatan: Sumber data untuk bagian “laporan resmi” dalam artikel ini. Kondisi pengujian:
reasoning_effort=max,temperature=1.0,top_p=0.95 - Dokumentasi resmi Moonshot: Harga, jadwal penghentian K2, rekomendasi migrasi model, dan informasi keanggotaan Kimi Code
- Catatan: Harga diambil pada 2026-10-24, dalam dolar AS per satu juta token, belum termasuk pajak
- Artificial Analysis: Evaluasi model oleh pihak ketiga independen
- Tautan:
artificialanalysis.ai - Catatan: Sumber data untuk bagian “pihak ketiga” dalam artikel ini. Data per 2026-10-23
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman beranda situs resmi APIYI. Materi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com. Jadikan daftar model di platform sebagai acuan untuk mengetahui nama model dan harga Kimi K3.1 Pro. Kami akan segera menghadirkan model ini.