gpt-6-astra dirilis pada 3 September 2026 dan dibuka untuk umum keesokan harinya. Baru seminggu berjalan, media sosial sudah dibanjiri keluhan bahwa "gpt-6-astra makin bodoh": dengan petunjuk yang sama, kualitas output tidak sebagus hari-hari awal peluncuran; tingkat penalaran Extra high berjalan lebih cepat, namun hasilnya justru lebih kasar. Di saat yang sama, kuota Astra di ChatGPT dan Codex jauh lebih ketat dibandingkan generasi sebelumnya, GPT-5.6 Sol, sehingga banyak pengembang yang pekerjaannya terhenti di tengah jalan karena limit kuota. Artikel ini akan membahas 5 langkah investigasi untuk memastikan apakah gpt-6-astra benar-benar mengalami penurunan kualitas, serta solusi menggunakan layanan proksi API resmi sebagai cadangan sementara saat kuota habis, agar alur kerja Anda tetap stabil.
Nilai Inti: Setelah membaca artikel ini, Anda akan mampu membedakan antara "penurunan kualitas nyata" dan "bias persepsi", memahami batas nyata kuota langganan, serta belajar menggunakan intensitas penalaran yang terkontrol dan strategi caching untuk memanggil gpt-6-astra versi penuh dengan biaya yang wajar.
Poin Utama Kontroversi Penurunan Kualitas gpt-6-astra
Sebelum mulai melakukan investigasi, mari kita bedah fakta yang ada saat ini. Menurut rangkuman media luar negeri seperti Decrypt, keluhan mulai muncul secara massal seminggu setelah peluncuran Astra. Beberapa pengembang (termasuk tim opencode) beralih kembali ke GPT-5.6 Sol karena biaya yang membengkak dan kualitas yang tidak sesuai ekspektasi. Namun hingga artikel ini ditulis, OpenAI belum memberikan pernyataan resmi mengenai Astra, dan banyak pengguna senior berpendapat bahwa modelnya sendiri tidak berubah, hanya saja setelah "masa bulan madu" berakhir, orang-orang mulai lebih memperhatikan kesalahannya.
| Poin | Fakta yang Diketahui | Arti bagi Anda |
|---|---|---|
| Waktu Rilis | 03-09-2026 dibuka untuk pengguna terpilih, 04-09 tersedia penuh | Model masih dalam tahap awal, strategi sisi server mungkin sering berubah |
| Keluhan Kualitas | Pengguna melaporkan output petunjuk yang sama memburuk, durasi penalaran tinggi lebih singkat | Perlu diverifikasi dengan cara yang dapat direproduksi, jangan hanya berdasarkan perasaan |
| Respon Resmi | Belum ada pernyataan resmi mengenai Astra | Tidak bisa memastikan apakah intensitas penalaran default telah diubah |
| Preseden Historis | Juli 2026 Sol juga mengalami keraguan serupa, OpenAI membantah adanya penurunan sengaja, namun mengakui adanya eksperimen pengaturan "intensitas penalaran" | Anggaran penalaran di sisi ChatGPT tidak sepenuhnya Anda kendalikan |
| Pengetatan Kuota | Plus di Work/Codex sekitar 5-45 pesan/5 jam, sekitar setengah dari era Sol | Pengguna berat akan mudah mencapai batas di jam sibuk |
Mengapa gpt-6-astra "terasa makin bodoh"
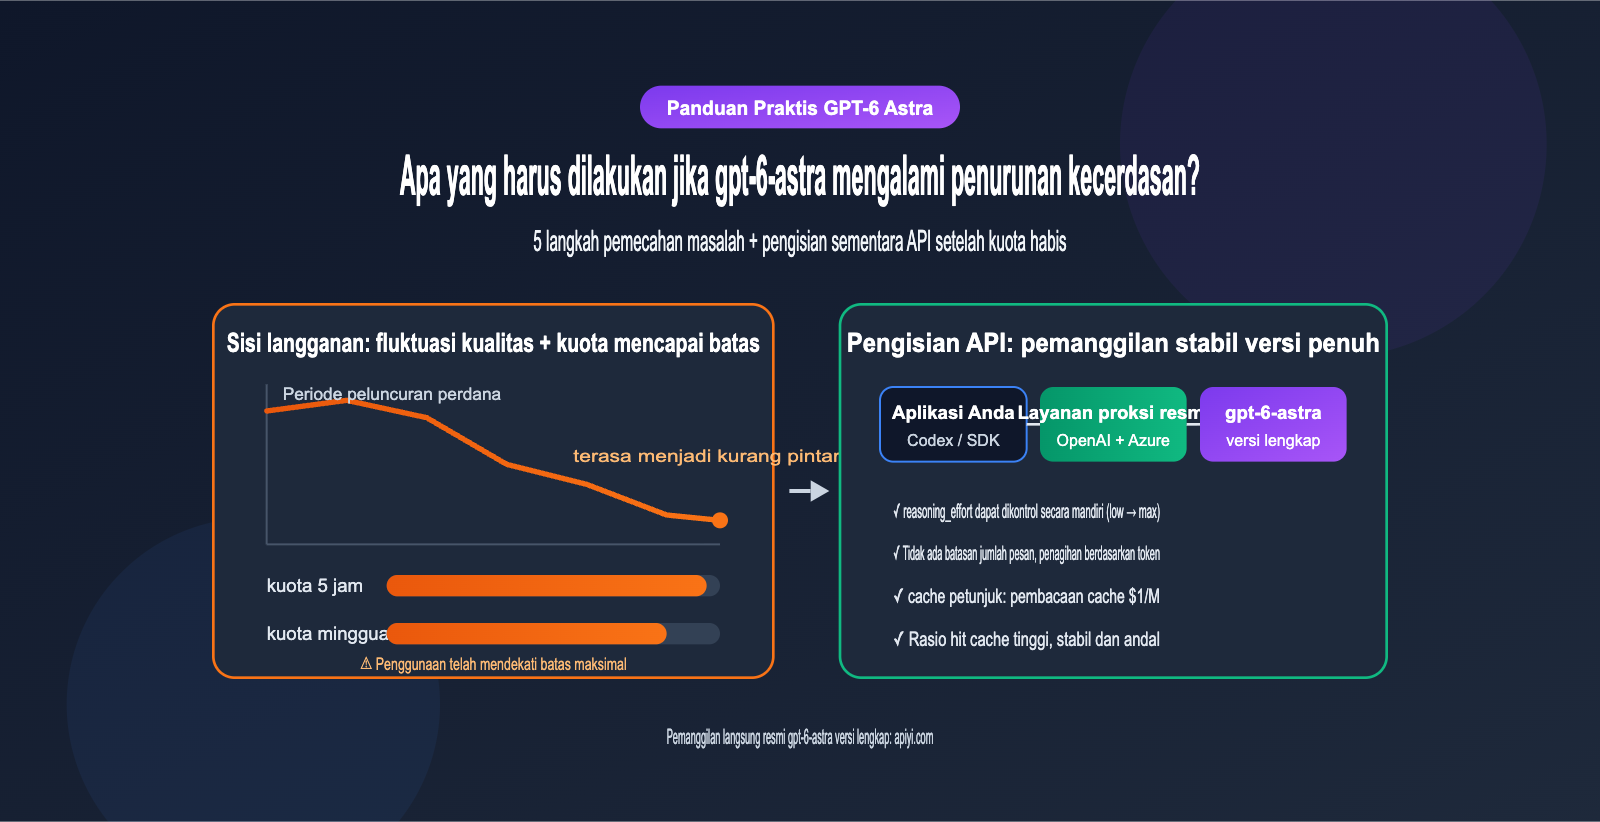
Kemungkinan bobot model diganti secara diam-diam sebenarnya sangat kecil, penyebab yang lebih umum terletak pada "anggaran penalaran". gpt-6-astra dalam API mendukung lima tingkat intensitas penalaran: low, medium, high, xhigh, dan max. Semakin tinggi tingkatannya, semakin banyak langkah berpikir yang dilakukan model sebelum menjawab, sehingga kualitas dan waktu yang dibutuhkan meningkat secara bersamaan. Dalam produk langganan seperti ChatGPT dan Codex, anggaran penalaran dikelola secara terpusat oleh platform. Begitu platform menurunkan anggaran aktual untuk mengatasi tekanan komputasi, yang dilihat pengguna adalah hasil yang "lebih cepat tapi lebih kasar", yang sangat cocok dengan isi keluhan.
Di sisi lain, pengembang seperti Theo menunjukkan bahwa varians output Astra sendiri cukup besar. Untuk tugas yang sama, model bisa memberikan hasil yang memukau, namun juga bisa melakukan kesalahan mendasar. Saat peluncuran, orang cenderung mengingat kasus yang memukau, dan setelah lama digunakan, kasus kegagalan menjadi lebih menonjol. Kesenjangan psikologis ini juga sering diartikan sebagai "penurunan kualitas". Jadi, kunci investigasi adalah memisahkan tiga variabel: "penjadwalan platform", "varians model", dan "cara penggunaan Anda sendiri".
Panduan 5 Langkah Mengatasi Penurunan Kualitas (Degradasi) gpt-6-astra
Prosedur berikut ini dirancang agar Anda dapat melakukan pengecekan secara berurutan saat mencurigai adanya penurunan kualitas pada gpt-6-astra. Setiap langkah akan membantu mengeliminasi satu kategori penyebab, sehingga Anda tidak perlu asal mengganti model.
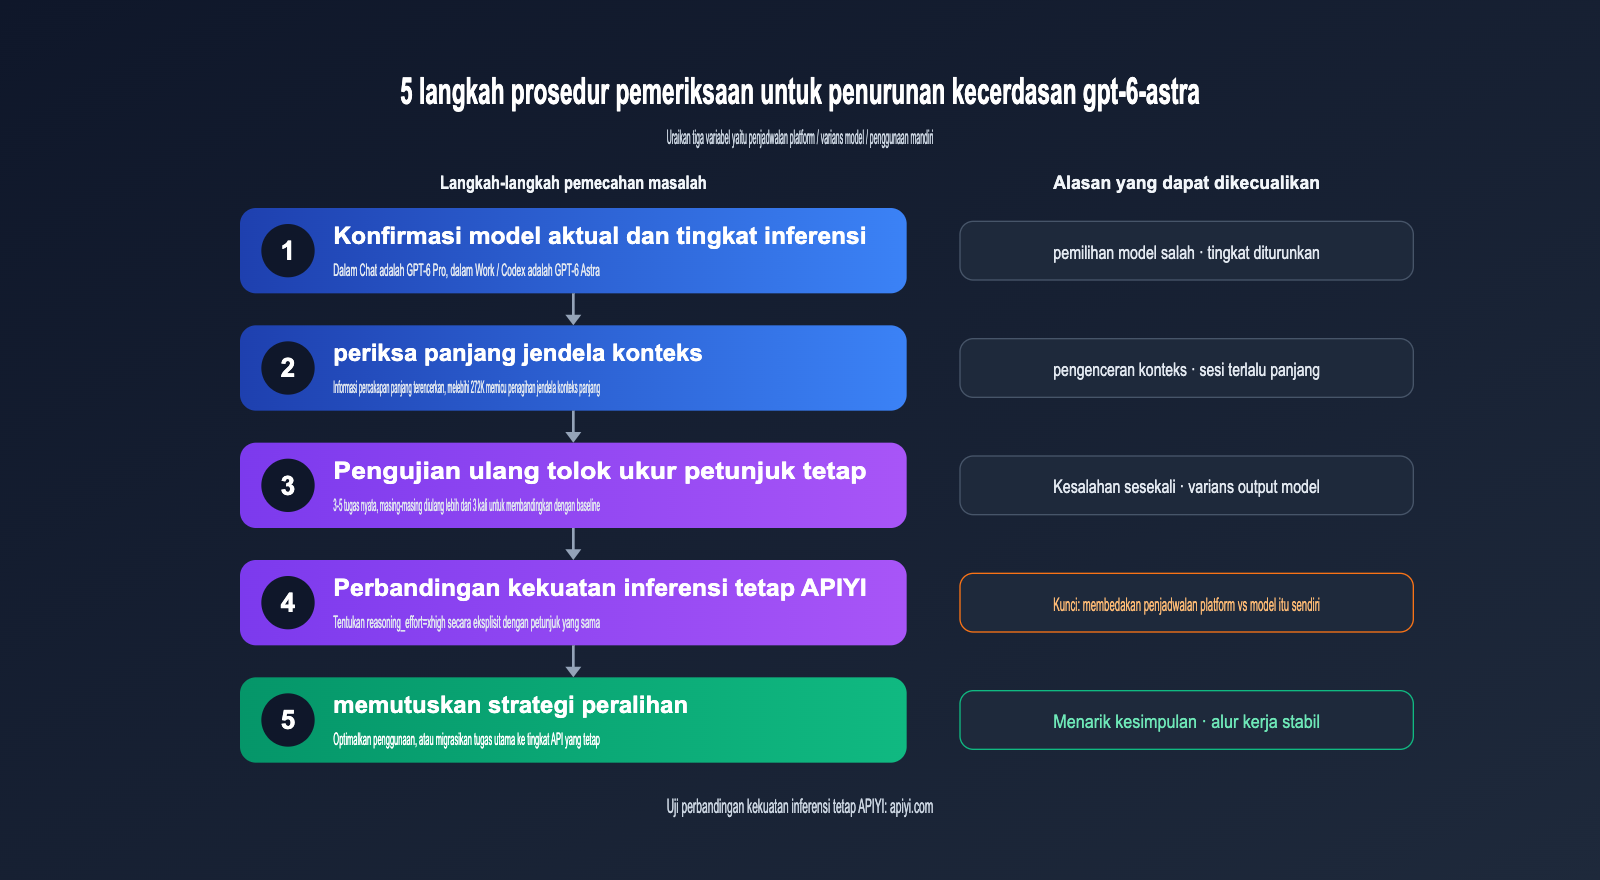
- Konfirmasi model dan tingkat penggunaan: Di ChatGPT, Astra muncul sebagai GPT-6 Pro dalam obrolan, sedangkan di Work dan Codex disebut sebagai GPT-6 Astra. Keduanya memiliki sistem kuota yang berbeda. Pastikan model mana yang sedang Anda gunakan dan tingkat intensitas penalaran yang dipilih. Cek apakah antarmuka sudah memberikan peringatan penurunan kualitas karena kuota menipis.
- Periksa apakah jendela konteks terlalu panjang: Astra memiliki jendela konteks sebesar 1.050.000 token, namun pengenceran informasi awal dalam sesi yang panjang adalah masalah umum pada semua Model Bahasa Besar. Jika sesi Codex sudah berlangsung berjam-jam, mulailah sesi baru dan ringkas materi latar belakang sebelum melakukan pengujian kembali.
- Lakukan pengujian dasar dengan petunjuk tetap: Pilih 3-5 tugas nyata yang Anda kenal, simpan hasil output awal sebagai tolok ukur (baseline), dan jalankan petunjuk yang sama minimal 3 kali. Lihat apakah kualitasnya menurun secara konsisten atau hanya kesalahan sesekali. Perbandingan satu kali saja tidak memiliki signifikansi statistik.
- Gunakan API dengan intensitas penalaran tetap sebagai pembanding: Melalui API, tentukan
reasoning_effortsecara eksplisit, lalu bandingkan outputnya dengan versi ChatGPT menggunakan petunjuk yang sama. Jika hasilxhighdi API jauh lebih baik daripada versi langganan, kemungkinan besar masalahnya ada pada anggaran penalaran platform, bukan pada modelnya sendiri. - Tentukan strategi berdasarkan kesimpulan: Jika masalahnya ada pada cara penggunaan, optimalkan petunjuk dan manajemen sesi Anda. Jika masalahnya ada pada penjadwalan platform atau kuota, pindahkan tugas-tugas penting ke pemanggilan API yang lebih terkontrol.
| Fenomena | Penyebab Paling Mungkin | Metode Verifikasi | Tindakan yang Disarankan |
|---|---|---|---|
| Jawaban cepat tapi penalaran dangkal | Anggaran penalaran diturunkan | Bandingkan dengan xhigh di API |
Pindahkan tugas penting ke API dengan tingkat tetap |
| Sering error di sesi panjang | Pengenceran konteks atau melebihi 272K | Uji ulang di sesi baru | Pecah tugas, ringkas jendela konteks |
| Tugas yang sama kadang bagus kadang buruk | Varians output model tinggi | Jalankan petunjuk 3-5 kali | Tambah langkah verifikasi atau sampling ulang |
| Tiba-tiba muncul notifikasi kuota habis | Kuota 5 jam atau mingguan tercapai | Cek panel penggunaan | Tunggu reset atau gunakan API sebagai cadangan |
| Kualitas kode menurun drastis | Tingkat penalaran berubah atau petunjuk melenceng | Bandingkan dengan baseline awal | Kunci petunjuk sistem dan tingkat penalaran |
🎯 Saran Pengecekan: Langkah ke-4 adalah kunci untuk membedakan antara "masalah platform" dan "masalah model". Kami menyarankan untuk menggunakan APIYI (apiyi.com) dengan petunjuk yang sama untuk menjalankan tingkat
highdanxhigh. Platform ini menyediakan akses langsung ke gpt-6-astra dengan parameter pemanggilan yang sama persis dengan antarmuka asli OpenAI, sehingga hasil perbandingannya jauh lebih akurat.
Apa yang harus dilakukan saat kuota gpt-6-astra habis?
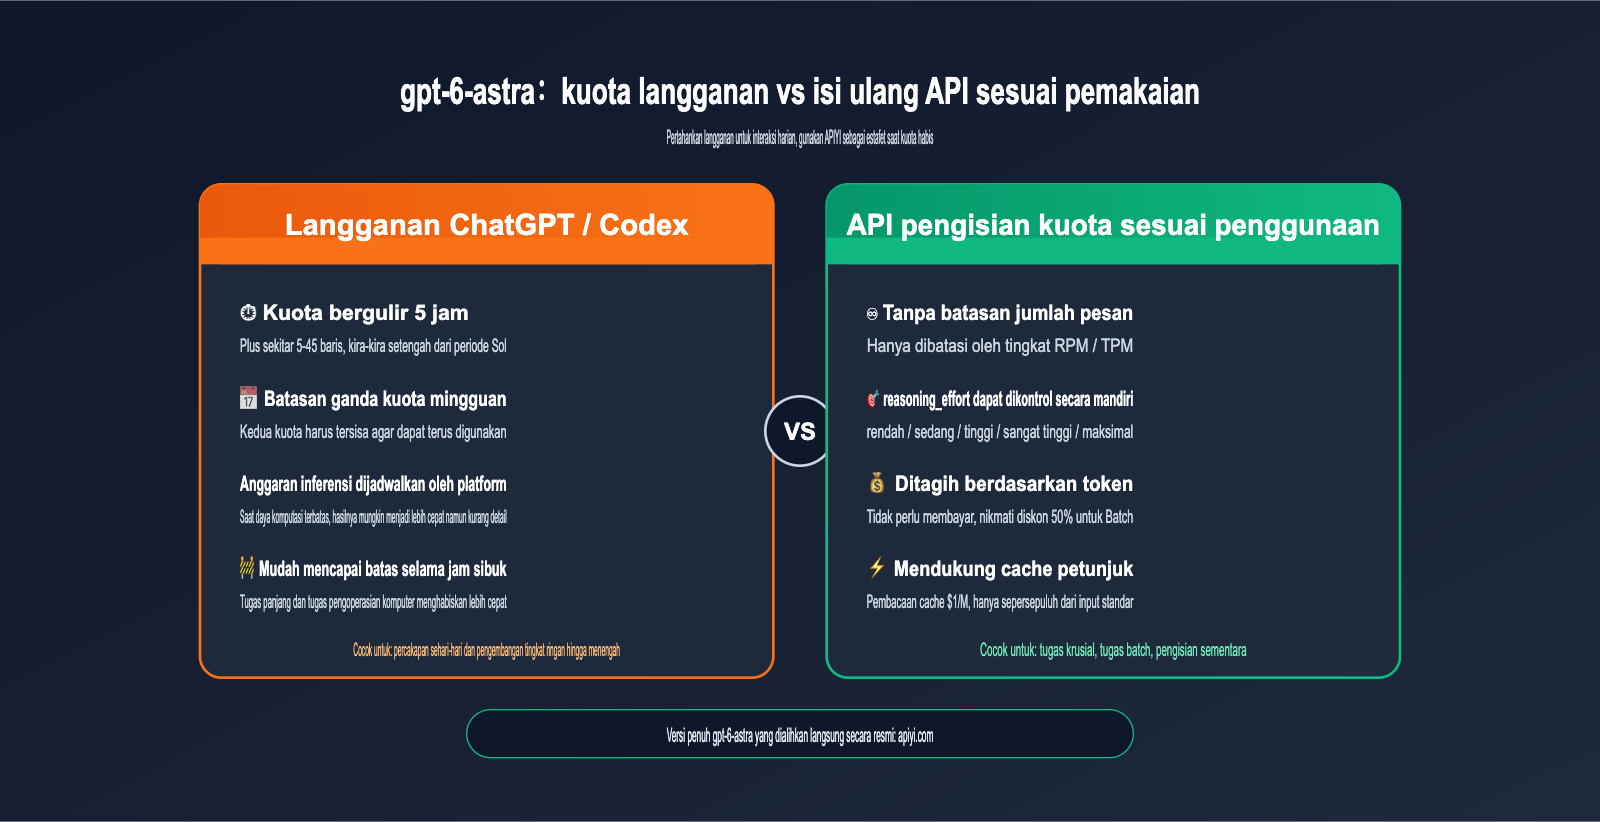
Meskipun model tidak mengalami penurunan performa (sering disebut "penurunan kecerdasan"), masalah kuota saja sudah cukup untuk mengganggu ritme kerja Anda. Berdasarkan informasi dari media luar negeri dan komunitas, Astra menerapkan batasan ganda "kuota bergulir 5 jam + kuota mingguan" pada ChatGPT Work dan Codex. Anda harus memiliki sisa di kedua batasan tersebut agar bisa terus menggunakannya. Selain itu, ada laporan bahwa setelah reset kuota massal pada 5 September, batas atas untuk pengguna berat diperketat lebih lanjut. Tabel di bawah ini menunjukkan estimasi yang dikumpulkan oleh komunitas; angka aktual tetap mengacu pada panel penggunaan resmi OpenAI.
| Paket Berlangganan | Estimasi Kuota Astra di Work/Codex | GPT-6 Pro di Chat | Target Pengguna |
|---|---|---|---|
| Plus | Sekitar 5-45 pesan / 5 jam | Tidak tersedia | Pengalaman ringan, tugas kompleks sesekali |
| Pro $100 | Sekitar 25-225 pesan / 5 jam | Sekitar 50 pesan / minggu | Pengembang utama harian |
| Pro $200 | Sekitar 100-900 pesan / 5 jam | Sekitar 200 pesan / minggu | Penggunaan berat sepanjang waktu |
| API Pay-as-you-go | Tanpa batas pesan, tunduk pada RPM/TPM | Tidak berlaku | Tugas batch, tugas kritis, cadangan sementara |
Rentang estimasi yang lebar ini terjadi karena kuota yang dikonsumsi per pesan bergantung pada kompleksitas tugas, tingkat penalaran, dan panjang jendela konteks. Konsumsi untuk tugas pengoperasian komputer selama 40 menit tentu tidak sebanding dengan tanya jawab sederhana. Bagi kebanyakan pengembang, meningkatkan ke paket $200 hanya untuk mengatasi lonjakan kuota sesekali tidaklah efisien. Cara yang lebih ekonomis adalah tetap menggunakan langganan saat ini dan menggunakan API sebagai cadangan saat kuota habis.
Tiga keunggulan API sebagai cadangan gpt-6-astra
Menggunakan API sebagai cadangan sementara bukan sekadar "mendapatkan kuota tambahan", tetapi yang lebih penting adalah mendapatkan kembali kendali. Pertama, intensitas penalaran ditentukan secara eksplisit oleh Anda dan tidak akan disesuaikan secara diam-diam oleh platform, yang secara langsung mengatasi ketidakpastian "penurunan kecerdasan". Kedua, API ditagih berdasarkan token, sehingga tidak ada biaya saat tidak digunakan, cocok untuk kebutuhan intermiten seperti saat lonjakan kuota. Ketiga, API mendukung optimasi biaya seperti Batch dan cache petunjuk, sehingga biaya tetap terkendali dalam jangka panjang.
Saat memilih saluran, kuncinya adalah apakah itu layanan proksi API resmi. Beberapa saluran pihak ketiga mungkin menggunakan antarmuka reverse-engineered atau merutekan permintaan ke model lain, yang justru akan memperburuk masalah "penurunan kecerdasan". gpt-6-astra yang disediakan oleh APIYI (apiyi.com) adalah versi penuh, menggunakan jalur langsung resmi OpenAI dan Azure, dengan parameter antarmuka yang sepenuhnya konsisten dengan versi resmi, menjadikannya pelengkap yang stabil di luar langganan Anda.
Memulai cepat API gpt-6-astra
gpt-6-astra mendukung tiga endpoint: Chat Completions, Responses, dan Batch. Input mendukung teks dan gambar, sedangkan output berupa teks. Contoh minimal di bawah ini menggunakan SDK resmi OpenAI; Anda hanya perlu mengganti base_url dan kunci API untuk menjalankannya.
Contoh pemanggilan minimal gpt-6-astra
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gpt-6-astra",
    reasoning_effort="xhigh",  # low / medium / high / xhigh / max
    messages=[
        {"role": "system", "content": "Anda adalah insinyur backend senior, berikan kode yang dapat dijalankan dalam jawaban Anda."},
        {"role": "user", "content": "Implementasikan cache LRU dengan waktu kedaluwarsa menggunakan Python"}
    ]
)
print(response.choices[0].message.content)
print(response.usage)  # Perhatikan prompt_tokens_details.cached_tokens
Lihat kode lengkap: Enkapsulasi dengan kunci cache, percobaan ulang, dan statistik penggunaan
import time
from openai import OpenAI, APIError, RateLimitError

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Petunjuk sistem panjang yang tetap diletakkan di awal agar mudah mengenai cache petunjuk
SYSTEM_PROMPT = open("system_prompt.md", encoding="utf-8").read()


def ask_astra(user_input: str,
              effort: str = "high",
              cache_key: str = "project-alpha-v1",
              max_retries: int = 3) -> str:
    """Memanggil gpt-6-astra, menetapkan intensitas penalaran dan menggunakan kembali kunci cache"""
    for attempt in range(max_retries):
        try:
            resp = client.chat.completions.create(
                model="gpt-6-astra",
                reasoning_effort=effort,
                prompt_cache_key=cache_key,
                messages=[
                    {"role": "system", "content": SYSTEM_PROMPT},
                    {"role": "user", "content": user_input},
                ],
            )
            usage = resp.usage
            cached = 0
            if usage.prompt_tokens_details:
                cached = usage.prompt_tokens_details.cached_tokens or 0
            hit_rate = cached / usage.prompt_tokens if usage.prompt_tokens else 0
            print(f"Input {usage.prompt_tokens} | Cache {cached} "
                  f"| Hit rate {hit_rate:.1%} | Output {usage.completion_tokens}")
            return resp.choices[0].message.content
        except RateLimitError:
            wait = 2 ** attempt
            print(f"Batas laju terpicu, mencoba lagi dalam {wait} detik")
            time.sleep(wait)
        except APIError as e:
            print(f"Kesalahan antarmuka: {e}")
            time.sleep(1)
    raise RuntimeError("Gagal setelah beberapa kali percobaan ulang")


if __name__ == "__main__":
    tasks = [
        "Tinjau penggunaan indeks SQL ini: SELECT ...",
        "Rancang skema percobaan ulang idempoten untuk layanan pesanan",
    ]
    for t in tasks:
        print(ask_astra(t, effort="xhigh")[:200])
💡 Saran penggunaan: Untuk pemanggilan pertama, disarankan menggunakan tingkat
mediumuntuk memastikan alur berjalan, lalu tingkatkan secara bertahap sesuai kesulitan tugas. Anda bisa mendaftar di APIYI (apiyi.com) untuk mendapatkan kuota uji coba, dan pastikan kualitas output sesuai harapan sebelum memigrasikan tugas resmi.
Beralih ke API gpt-6-astra di Codex
Jika Anda terutama menggunakan Astra di Codex CLI, Anda tidak perlu menghentikan pekerjaan saat kuota habis. Anda dapat mengonfigurasi penyedia model kustom di ~/.codex/config.toml dan menggunakan kunci API untuk terus bekerja:
model = "gpt-6-astra"
model_provider = "apiyi"
model_reasoning_effort = "high"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
Setelah konfigurasi selesai, jalankan export APIYI_API_KEY=kunci_anda sebelum memulai Codex. Setelah kuota langganan diatur ulang, Anda cukup memberi komentar pada model_provider untuk kembali ke metode login asli. Kedua mode ini dapat dialihkan sesuai kebutuhan.
Cara memilih intensitas penalaran gpt-6-astra
Intensitas penalaran secara langsung menentukan kualitas, waktu pemrosesan, dan biaya. Disarankan untuk membagi tingkat berdasarkan jenis tugas, alih-alih selalu menggunakan tingkat maksimal.
| Intensitas Penalaran | Skenario Tipikal | Kinerja Kualitas | Waktu & Biaya |
|---|---|---|---|
| low | Konversi format, tanya jawab sederhana, ekstraksi informasi | Memenuhi kebutuhan dasar | Terendah |
| medium | Pelengkapan kode harian, penulisan dokumen | Seimbang | Lebih rendah |
| high | Refaktor kompleks, desain arsitektur, analisis data | Stabil dan andal | Sedang |
| xhigh | Lokalisasi bug sulit, tugas agen rantai panjang | Mendekati pengalaman awal | Lebih tinggi |
| max | Pembuktian matematika, audit keamanan, keputusan bernilai tinggi | Batas atas tertinggi | Tertinggi, perlu kontrol frekuensi |
🎯 Saran pemilihan: Jika Anda curiga ada "penurunan kecerdasan" pada sisi langganan, Anda dapat menetapkan tugas kritis yang biasanya dijalankan di ChatGPT ke tingkat
xhigh. Saat memanggil melalui APIYI (apiyi.com), intensitas penalaran sepenuhnya ditentukan oleh parameter permintaan, sehingga memudahkan Anda mengendalikan fluktuasi kualitas dalam batas yang dapat dijelaskan.
Kontrol Biaya dan Optimasi Rasio Hit Cache gpt-6-astra
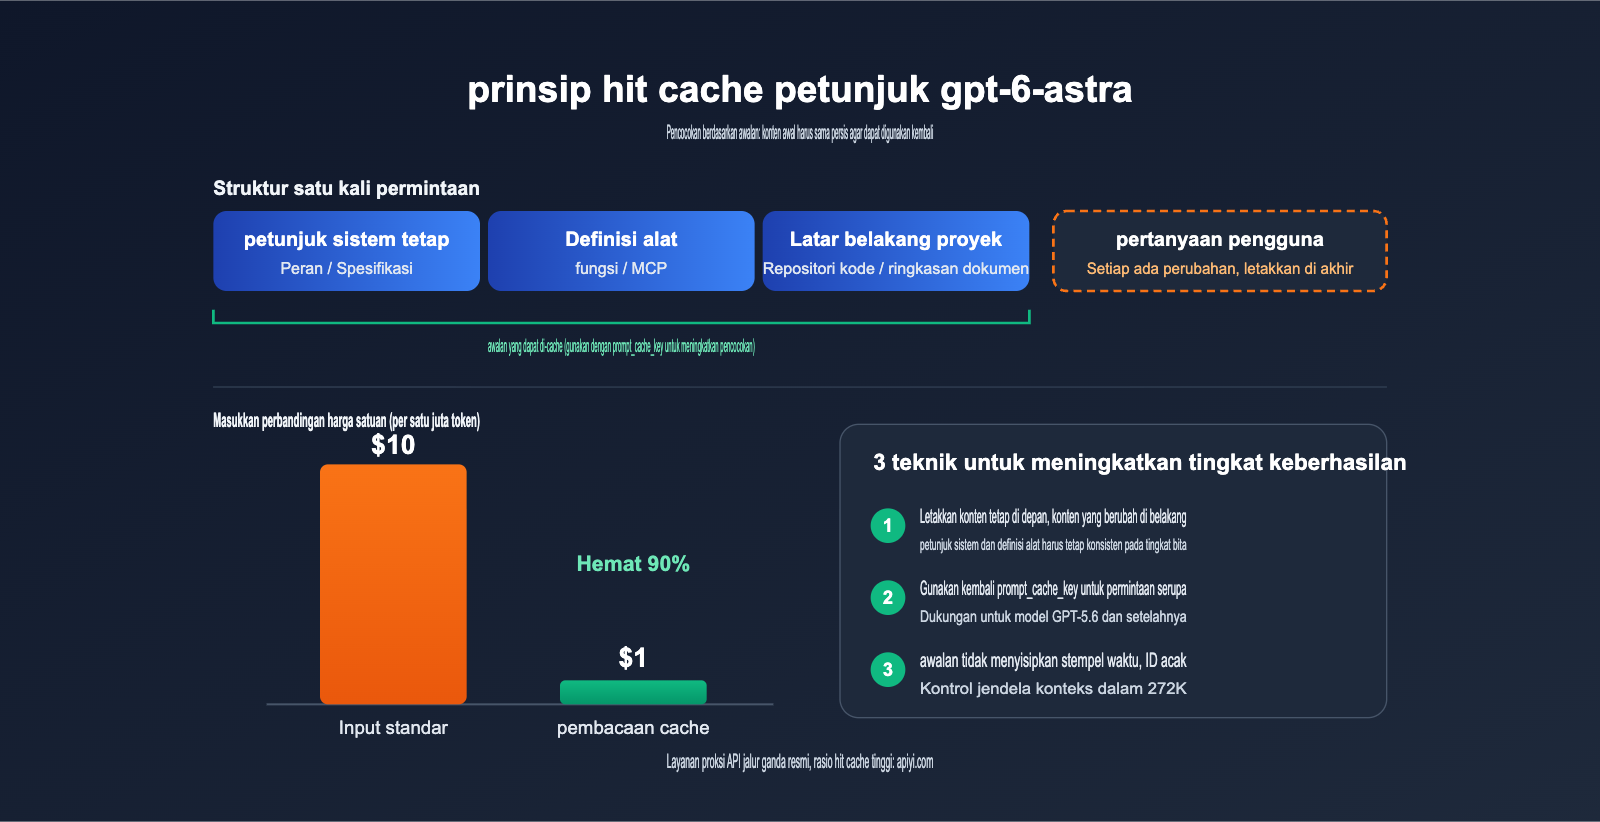
Harga resmi gpt-6-astra adalah $10 untuk input dan $50 untuk output (per juta token), beberapa kali lipat lebih mahal dari harga peluncuran GPT-5.6 Sol. Oleh karena itu, kontrol biaya harus dipertimbangkan sejak awal saat menggunakan API sebagai cadangan. Kabar baiknya, harga input cache Astra hanya $1, atau 10% dari harga input standar. Tinggi rendahnya rasio hit cache akan berdampak langsung pada tagihan Anda.
| Item Penagihan | Harga Resmi (per juta token) | Penjelasan |
|---|---|---|
| Input Standar | $10 | Berlaku jika input tidak melebihi 272K token |
| Pembacaan Cache | $1 | Bagian yang mengenai cache petunjuk, hemat 90% |
| Penulisan Cache | $12.5 | Awalan yang baru ditulis ke cache, sedikit lebih mahal dari input standar |
| Output Standar | $50 | Termasuk token penalaran |
| Konteks Panjang | 2x harga input/cache, 1.5x output | Terpicu jika input melebihi 272K token |
| Batch / Flex | 50% dari harga standar | Cocok untuk tugas yang tidak memerlukan respons real-time |
4 Tips Meningkatkan Rasio Hit Cache gpt-6-astra
Cache petunjuk dicocokkan berdasarkan "awalan" (prefix). Selama konten di awal permintaan benar-benar sama, hasil perhitungan sebelumnya dapat digunakan kembali. Berdasarkan mekanisme ini, Anda bisa melakukan optimasi dari beberapa aspek berikut:
- Letakkan konten tetap di depan: Letakkan konten yang tidak berubah seperti petunjuk sistem, definisi alat, dan spesifikasi proyek di bagian paling depan pesan. Letakkan konten yang berubah seperti pertanyaan pengguna atau stempel waktu di bagian akhir.
- Gunakan prompt_cache_key: Model GPT-5.6 dan setelahnya mendukung parameter ini. Menggunakan kunci cache yang sama untuk permintaan dengan awalan panjang yang sama dapat meningkatkan probabilitas kecocokan secara signifikan.
- Hindari memasukkan nilai dinamis di awalan: Menulis waktu saat ini atau ID acak di dalam petunjuk sistem akan membuat awalan setiap permintaan berbeda, sehingga cache langsung tidak berlaku.
- Jaga konteks di bawah 272K: Melebihi ambang batas ini akan memicu penagihan konteks panjang dan harga pembacaan cache akan berlipat ganda. Untuk dokumen panjang, disarankan melakukan pencarian terlebih dahulu sebelum dikirim ke model.
Rasio hit cache juga berkaitan dengan stabilitas infrastruktur dasar. Jika permintaan sering berpindah antar backend, cache akan sulit untuk terus mengenai sasaran. APIYI apiyi.com menggunakan layanan proksi API langsung dari OpenAI dan Azure, serta melakukan optimasi rute yang ramah cache untuk gpt-6-astra. Dalam skenario awalan tetap, Anda bisa mendapatkan rasio hit cache yang tinggi. Anda dapat memeriksa hasilnya secara langsung melalui kolom cached_tokens dalam respons.
Pertanyaan Umum tentang Penurunan Kualitas dan Cadangan gpt-6-astra
Q1: Apakah gpt-6-astra benar-benar mengalami penurunan kualitas oleh OpenAI?
Saat ini tidak ada bukti resmi yang menyatakan bobot model telah diganti, dan OpenAI juga belum memberikan penjelasan resmi. Penjelasan yang lebih mungkin adalah perubahan penjadwalan anggaran penalaran pada sisi langganan, ditambah dengan varians output dari model itu sendiri. Disarankan untuk menggunakan metode pemeriksaan 5 langkah dalam artikel ini dan melakukan perbandingan dengan pengaturan API yang tetap sebelum mengambil kesimpulan.
Q2: Apakah gpt-6-astra yang dipanggil melalui API sama dengan yang ada di ChatGPT?
Itu adalah model yang sama. Perbedaannya adalah API memungkinkan Anda menentukan intensitas penalaran secara eksplisit, sedangkan anggaran penalaran pada produk langganan diatur oleh platform. APIYI apiyi.com menyediakan gpt-6-astra versi penuh yang langsung dari sumber resmi, di mana intensitas penalaran dijalankan sepenuhnya sesuai dengan parameter yang Anda masukkan.
Q3: Bisakah kuota langganan dan API digunakan secara bersamaan?
Bisa, keduanya independen. Pendekatan yang disarankan adalah tetap menggunakan kuota langganan untuk interaksi sehari-hari, dan beralih ke API saat kuota habis atau saat memerlukan pemrosesan batch. Anda dapat beralih dengan cepat melalui file konfigurasi di Codex.
Q4: Apakah menggunakan API sebagai cadangan akan sangat mahal?
Tergantung pada cara penggunaannya. Mengontrol tingkat penalaran, meningkatkan rasio hit cache, dan memasukkan tugas non-real-time ke dalam Batch dapat menekan biaya hingga lebih dari setengahnya. Disarankan untuk menghitung biaya per tugas dengan beberapa tugas nyata di APIYI apiyi.com sebelum memutuskan skala cadangan Anda.
Q5: Bagaimana cara mengombinasikan gpt-6-astra dan GPT-5.6 Sol?
Sol memiliki harga yang jauh lebih murah, cocok untuk pengkodean rutin dan tugas batch. Astra memiliki keunggulan nyata dalam pengoperasian komputer, penalaran kompleks, dan tugas agen dengan alur panjang. Anda bisa menjadikan Sol sebagai model default dan hanya meningkatkan ke Astra untuk masalah yang sulit, sehingga kualitas tetap terjaga dan biaya terkontrol.
Ringkasan: Mengubah Ketidakpastian gpt-6-astra Menjadi Variabel yang Terkendali
gpt-6-astra adalah Model Bahasa Besar unggulan OpenAI yang paling mumpuni saat ini. Namun, kontroversi mengenai penurunan performa ("dumbing down") dan pengetatan kuota di awal peluncurannya mengungkap karakteristik mendasar dari produk berlangganan: anggaran inferensi dan batas penggunaan sepenuhnya ditentukan oleh platform, sementara pengguna hanya bisa menerima apa adanya. Menghadapi situasi ini, daripada terus menebak-nebak apakah model tersebut menjadi kurang pintar, lebih baik kita membangun tolok ukur kualitas sendiri menggunakan petunjuk dan tingkat inferensi yang tetap.
Secara praktis, Anda bisa menempuhnya dalam tiga langkah: pertama, gunakan metode pengecekan 5 langkah untuk membedakan antara penjadwalan platform, varians model, dan cara penggunaan Anda sendiri; kedua, saat kuota habis, gunakan API sebagai cadangan dan kunci tugas-tugas penting pada tingkat high atau xhigh; terakhir, tekan biaya dengan menggunakan awalan tetap, prompt_cache_key, dan Batch. Dengan cara ini, alur kerja utama Anda akan tetap stabil, terlepas dari perubahan apa pun yang dilakukan pada sisi langganan.
Jika Anda membutuhkan saluran cadangan yang stabil, kami merekomendasikan untuk memanggil versi penuh gpt-6-astra melalui APIYI (apiyi.com). Platform ini menyediakan layanan proksi API resmi langsung dari OpenAI dan Azure, antarmuka yang sepenuhnya kompatibel dengan versi resmi, serta tingkat cache hit yang tinggi, sehingga sangat cocok sebagai pelengkap yang andal di luar langganan ChatGPT dan Codex.
Referensi:
- Dokumentasi Model OpenAI (gpt-6-astra): developers.openai.com/api/docs/models/gpt-6-astra
- Pusat Bantuan OpenAI untuk Penjelasan Penggunaan Astra: help.openai.com
- Laporan Decrypt mengenai kontroversi penurunan performa Astra: decrypt.co
- Dokumentasi prompt caching Microsoft Foundry: learn.microsoft.com
- Dokumentasi Model APIYI: docs.apiyi.com
Tentang Penulis: Tim teknis APIYI, fokus pada integrasi API Model Bahasa Besar AI dan praktik rekayasa. Mari berdiskusi mengenai optimasi pemanggilan dan pengendalian biaya gpt-6-astra melalui APIYI di apiyi.com.