Catatan penulis: Harga input dan output gpt-6-sol dan gpt-6.1-sol sama, tetapi tarif baca cache-nya berbeda dua kali lipat. Artikel ini menjelaskan cara menurunkan biaya cache untuk sesi panjang hanya dengan mengubah kolom model pada permintaan.
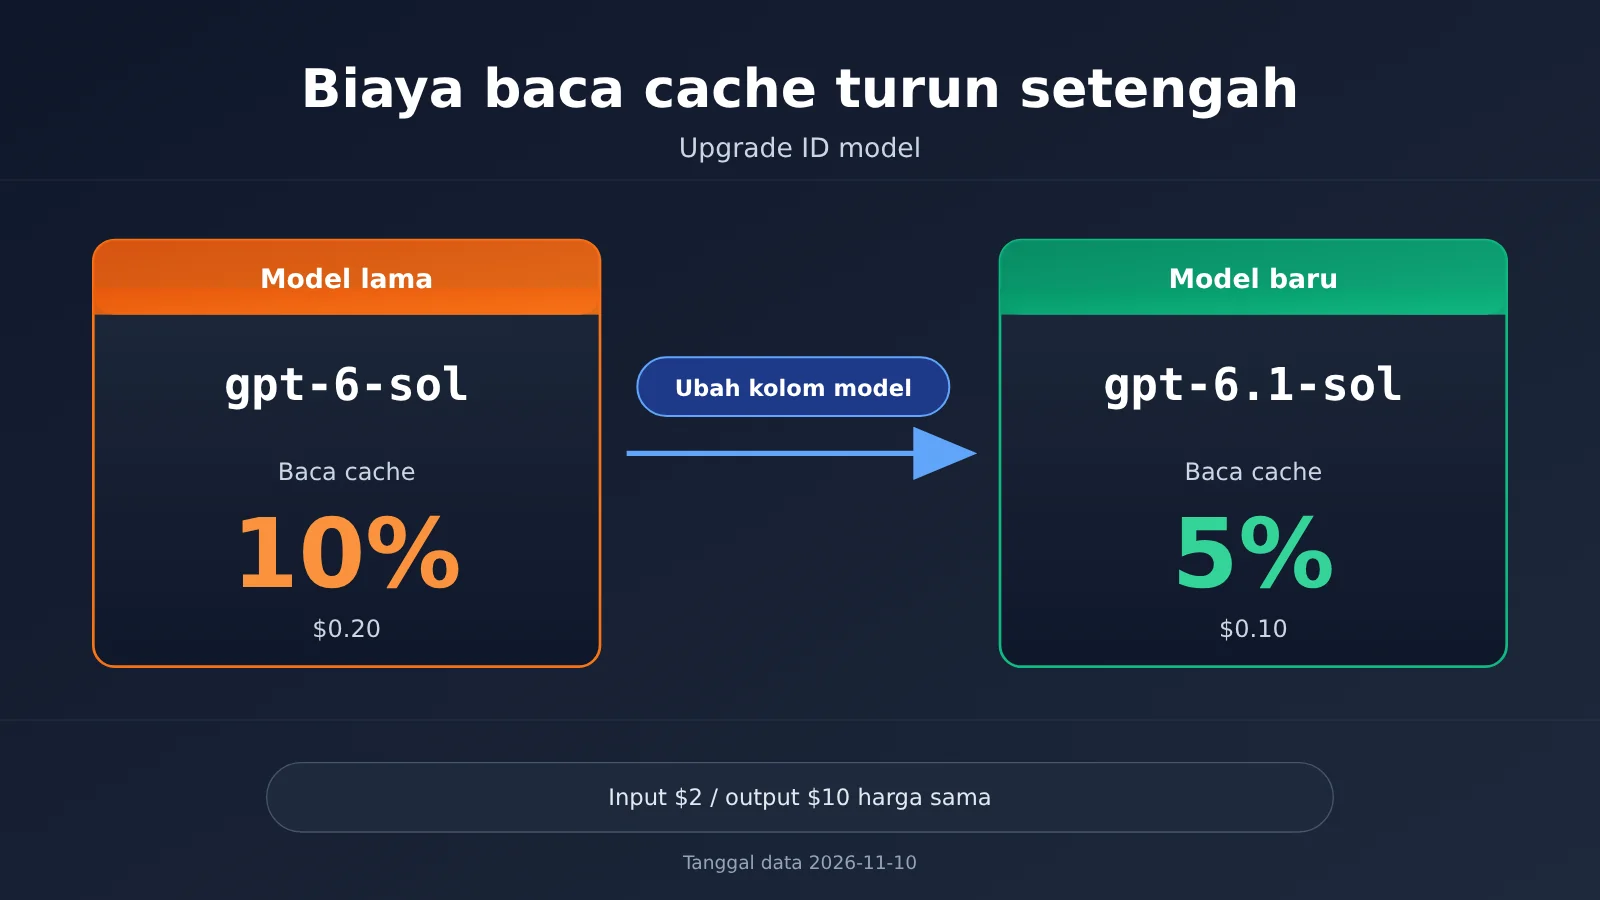
Banyak developer sudah menggunakan 6.1 Sol, 6.1 Terra, dan 6 Luna dalam pekerjaan sehari-hari. Namun, saat memeriksa konfigurasi proyek, mereka mungkin mendapati bahwa permintaan dari salah satu layanan lama masih menggunakan gpt-6-sol. Artikel ini membahas perubahan sederhana: ganti gpt-6-sol dengan gpt-6.1-sol. Harga input dan output tetap sama, sementara tarif baca cache turun dari 10% menjadi 5% dari harga input.
Ini bukan promosi, dan Anda juga tidak perlu berganti paket. Perbedaan harga antara kedua varian Sol tercantum langsung dalam daftar harga resmi OpenAI. Tarif pada daftar model platform APIYI juga sesuai dengan harga resmi. Yang perlu diubah hanya satu string dalam permintaan.
Manfaat utama: Setelah membaca artikel ini, Anda akan tahu ID model mana yang perlu diganti, berapa banyak biaya baca cache yang bisa dihemat, dan mengapa kesimpulan “tarif baca cache turun setengah” ini tidak bisa begitu saja diterapkan pada model selain Terra dan Luna—terutama Luna.
Poin penting harga gpt-6-sol dan gpt-6.1-sol
Lihat tabel paling penting berikut. Semua harga dihitung per satu juta token. Data per 2026-11-10, bersumber dari harga standar resmi OpenAI dan sudah dicocokkan dengan nilai pengali yang dikembalikan oleh API harga APIYI.
| ID model | Harga input | Harga output | Harga pembacaan cache | Pembacaan cache dibanding harga input |
|---|---|---|---|---|
gpt-6-sol |
$2 | $10 | $0.20 | 10% |
gpt-6.1-sol |
$2 | $10 | $0.10 | 5% |
Tabel ini menunjukkan bahwa kedua model Sol tidak memiliki perbedaan harga input maupun output. Satu-satunya perbedaan ada pada pembacaan cache. Untuk permintaan singkat satu putaran, selisih ini hampir tidak terasa. Namun, dalam skenario yang berulang kali menyertakan petunjuk sistem yang panjang, definisi alat yang panjang, dan riwayat percakapan yang panjang, token pembacaan cache sering kali mencakup sebagian besar input permintaan. Selisih pengali dua kali lipat akan terus bertambah seiring waktu.
Mengapa harga pembacaan cache gpt-6.1-sol perlu diperhatikan secara khusus
Prompt Cache berfungsi agar token pada awalan permintaan yang sama dengan permintaan sebelumnya dikenai harga pembacaan cache, bukan harga input penuh. Aplikasi seperti Agent, asisten coding, dan bot layanan pelanggan biasanya mengirim ulang petunjuk sistem dan riwayat pesan yang sama di setiap putaran, sehingga tingkat kecocokan cache umumnya tinggi.
Dalam beban kerja seperti ini, harga satuan pembacaan cache sering kali lebih langsung memengaruhi tagihan dibandingkan harga input. Pembacaan cache gpt-6-sol dikenai biaya $0.20, sedangkan gpt-6.1-sol dikenai biaya $0.10. Untuk jumlah cache hit yang sama, biaya model pertama dua kali lebih besar. Jika layanan Anda masih menggunakan ID lama dan menangani percakapan panjang, Anda terus membayar lebih untuk konteks yang sama.
Hubungan antara pengali platform dan harga resmi
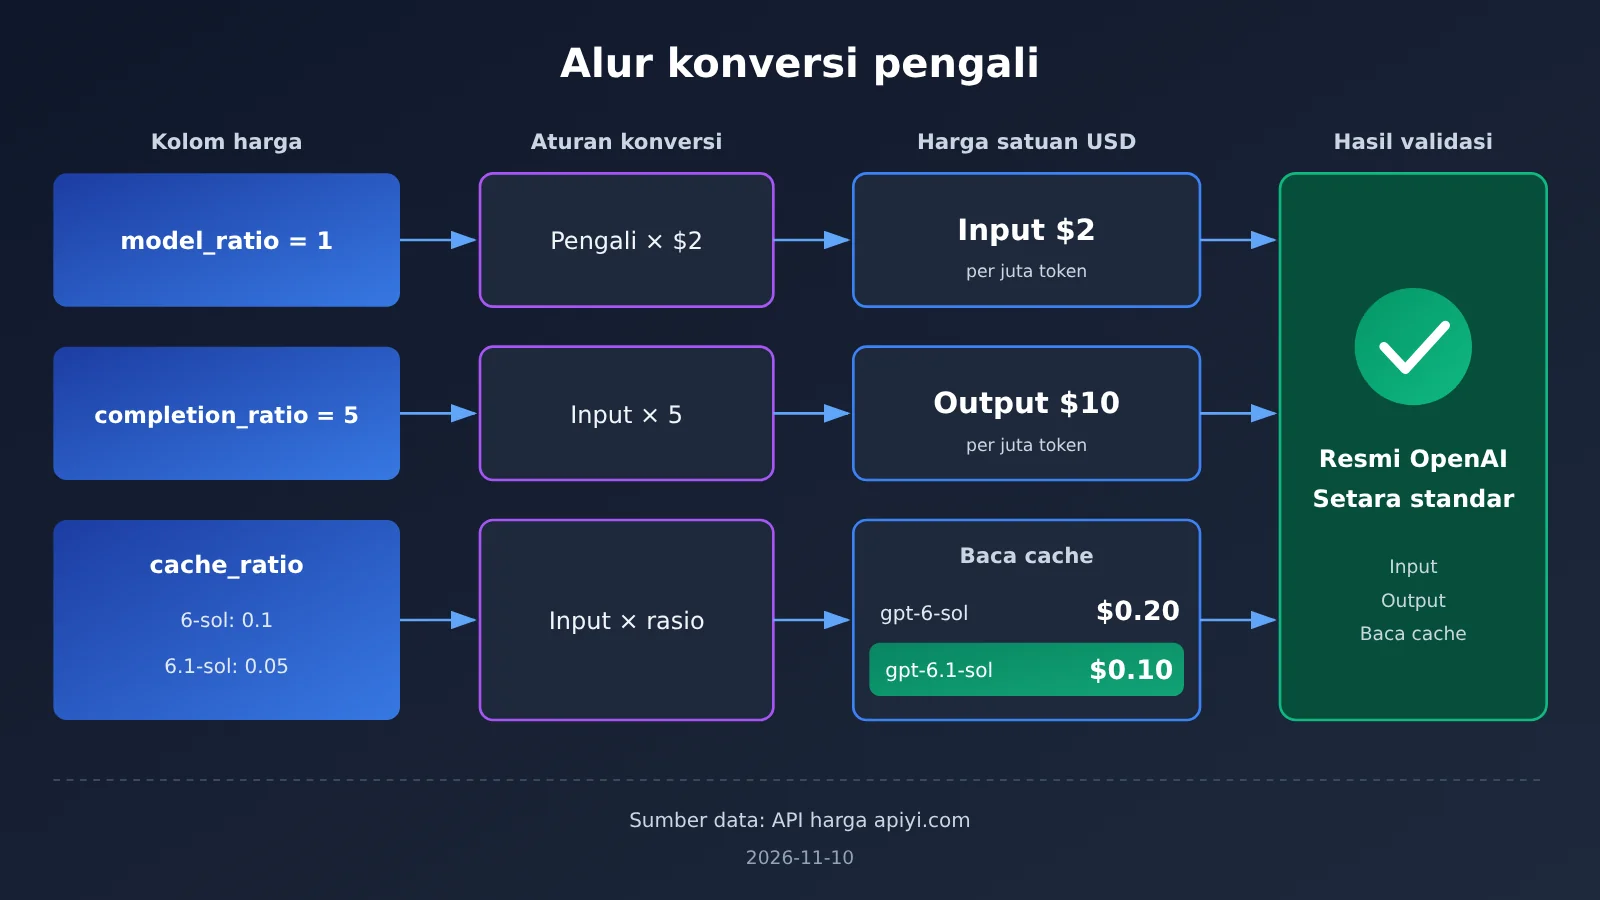
API harga APIYI menyatakan harga dalam bentuk pengali. Data yang dikembalikan pada 2026-11-10 mencantumkan kedua model Sol dengan pengali berikut:
| Kolom | gpt-6-sol |
gpt-6.1-sol |
Keterangan |
|---|---|---|---|
| model_ratio | 1 | 1 | Pengali 1 setara dengan input $2 per satu juta token |
| completion_ratio | 5 | 5 | Harga output 5 kali harga input, yaitu $10 |
| cache_ratio | 0.1 | 0.05 | Harga pembacaan cache sebesar 10% / 5% dari harga input |
Dengan patokan “pengali 1 = input $2 per satu juta token”, harga kedua model adalah $2 untuk input dan $10 untuk output. Harga pembacaan cache masing-masing $0.20 dan $0.10, sesuai dengan harga resmi. Perlu diperhatikan bahwa perhitungan ini hanya menggunakan pengali model, tanpa memperhitungkan pengali grup. Untuk biaya akhir, lihat grup akun dan daftar model yang tersedia di platform Anda. Untuk memeriksa harga, kunjungi halaman harga model APIYI di apiyi.com dan cocokkan ketiga pengali tersebut.
Cara menghitung biaya cache untuk sesi panjang gpt-6.1-sol
Harga satuan saja kurang memberi gambaran yang jelas. Berikut contoh hitungan sederhana untuk menunjukkan selisihnya. Misalkan sebuah sesi Agent terdiri dari 100 giliran, dan setiap permintaan memiliki prefiks yang terkena cache sekitar 50 ribu token. Dengan begitu, total token baca cache selama sesi mencapai 5 juta.
| Komponen perhitungan | gpt-6-sol |
gpt-6.1-sol |
|---|---|---|
| Total token baca cache | 5 juta | 5 juta |
| Harga baca cache (per juta) | $0.20 | $0.10 |
| Biaya baca cache | $1.00 | $0.50 |
| Bagian input dan output | Harga satuan sama | Harga satuan sama |
Ini baru hitungan untuk satu sesi. Jika ada ribuan sesi serupa setiap hari, biaya baca cache akan konsisten menjadi setengahnya. Karena harga satuan input dan output sama persis, beralih ke gpt-6.1-sol tidak akan menaikkan biaya bagian lainnya. Penghematannya berasal dari biaya baca cache yang menjadi setengah.
Namun, contoh ini mengasumsikan cache benar-benar terkena. Jika prefiks permintaan selalu berubah—misalnya, Anda meletakkan stempel waktu atau ID acak di awal petunjuk sistem—tingkat cache yang terkena akan sangat rendah. Dalam kondisi seperti ini, manfaat beralih ke ID model lain juga terbatas. Agar hasilnya lebih terasa, letakkan konten tetap di bagian prefiks dan konten yang berubah di bagian akhir, lalu pertimbangkan untuk mengganti ID model.
Cara cepat mengubah gpt-6-sol menjadi gpt-6.1-sol
Perubahan yang diperlukan sangat kecil: kedua ID model tersebut sudah tersedia di daftar model APIYI. Anda bisa langsung menggunakan kunci API yang sama tanpa perlu mengaktifkan atau membeli paket baru. Yang perlu diubah hanya kolom model di isi permintaan.
Cara paling sederhana: beralih dalam 3 langkah
- Cari ID lama: Cari
gpt-6-soldi seluruh repositori kode dan pusat konfigurasi. Pastikan tidak ikut mengubah string yang sudah menggunakan ID baru, sepertigpt-6.1-sol. Agar lebih akurat, cari nilai lengkap di dalam tanda kutip. - Ganti kolom model: Ubah
model="gpt-6-sol"menjadimodel="gpt-6.1-sol". Inisialisasi klien tetap sama, yaitubase_url="https://api.apiyi.com/v1"dengan kunci API yang sudah Anda gunakan. - Validasi dengan sebagian kecil trafik: Alihkan sebagian permintaan terlebih dahulu. Periksa kolom token cache pada
usagedi respons untuk memastikan cache berfungsi dengan normal, lalu terapkan perubahan ke semua permintaan.
Dengan OpenAI Python SDK resmi, klien ditulis seperti ini: client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1"). Saat memanggil model, cukup ganti nilai model di client.chat.completions.create(model="gpt-6.1-sol", messages=messages). messages dan parameter lainnya tidak perlu diubah.
Rekomendasi: gunakan konfigurasi
Jika nama model ditulis langsung di beberapa bagian proyek, sebaiknya sekalian ubah menjadi konfigurasi saat melakukan migrasi ini. Simpan ID model di variabel lingkungan, misalnya OPENAI_MODEL=gpt-6.1-sol, lalu baca nilainya di kode melalui os.getenv("OPENAI_MODEL", "gpt-6.1-sol"). Jika ada versi baru nanti, Anda hanya perlu mengubah satu konfigurasi, bukan mencari dan mengganti satu per satu di seluruh repositori.
Sebaiknya alamat klien juga dibaca dari variabel lingkungan, misalnya OPENAI_BASE_URL=https://api.apiyi.com/v1. Karena antarmukanya kompatibel dengan OpenAI, Anda tetap bisa menggunakan SDK, LangChain, dan berbagai framework Agent yang sudah ada. Pastikan saja nilai base_url dan model sudah benar.
🚀 Mulai cepat: Sebelum mengganti ID, periksa daftar model APIYI di apiyi.com untuk memastikan
gpt-6.1-soltersedia di grup akun Anda. Setelah dikonfirmasi, peralihan hanya memerlukan perubahan satu string pada kolommodeldi permintaan. Pengguna baru juga bisa mencoba validasi dengan trafik kecil menggunakan kuota uji coba gratis.
Beberapa hal yang perlu diperhatikan saat beralih
- Hanya sebagian layanan yang diperbarui: Layanan utama sudah menggunakan ID baru, tetapi tugas terjadwal atau skrip pemrosesan batch offline masih menggunakan ID lama. Akibatnya, tagihan akan menampilkan penggunaan kedua model.
- Ada daftar putih model di gateway: Jika gateway internal atau lapisan proksi Anda memeriksa nama model berdasarkan daftar putih, tambahkan
gpt-6.1-solterlebih dahulu. - Log dan pemantauan dikelompokkan berdasarkan nama model: Jika dasbor menghitung biaya berdasarkan nama model, amati ID lama dan baru secara bersamaan setelah beralih. Jika tidak, Anda mungkin mengira jumlah pemanggilan menurun.
Perbandingan Diskon Cache gpt-6.1-sol, Terra, dan Luna
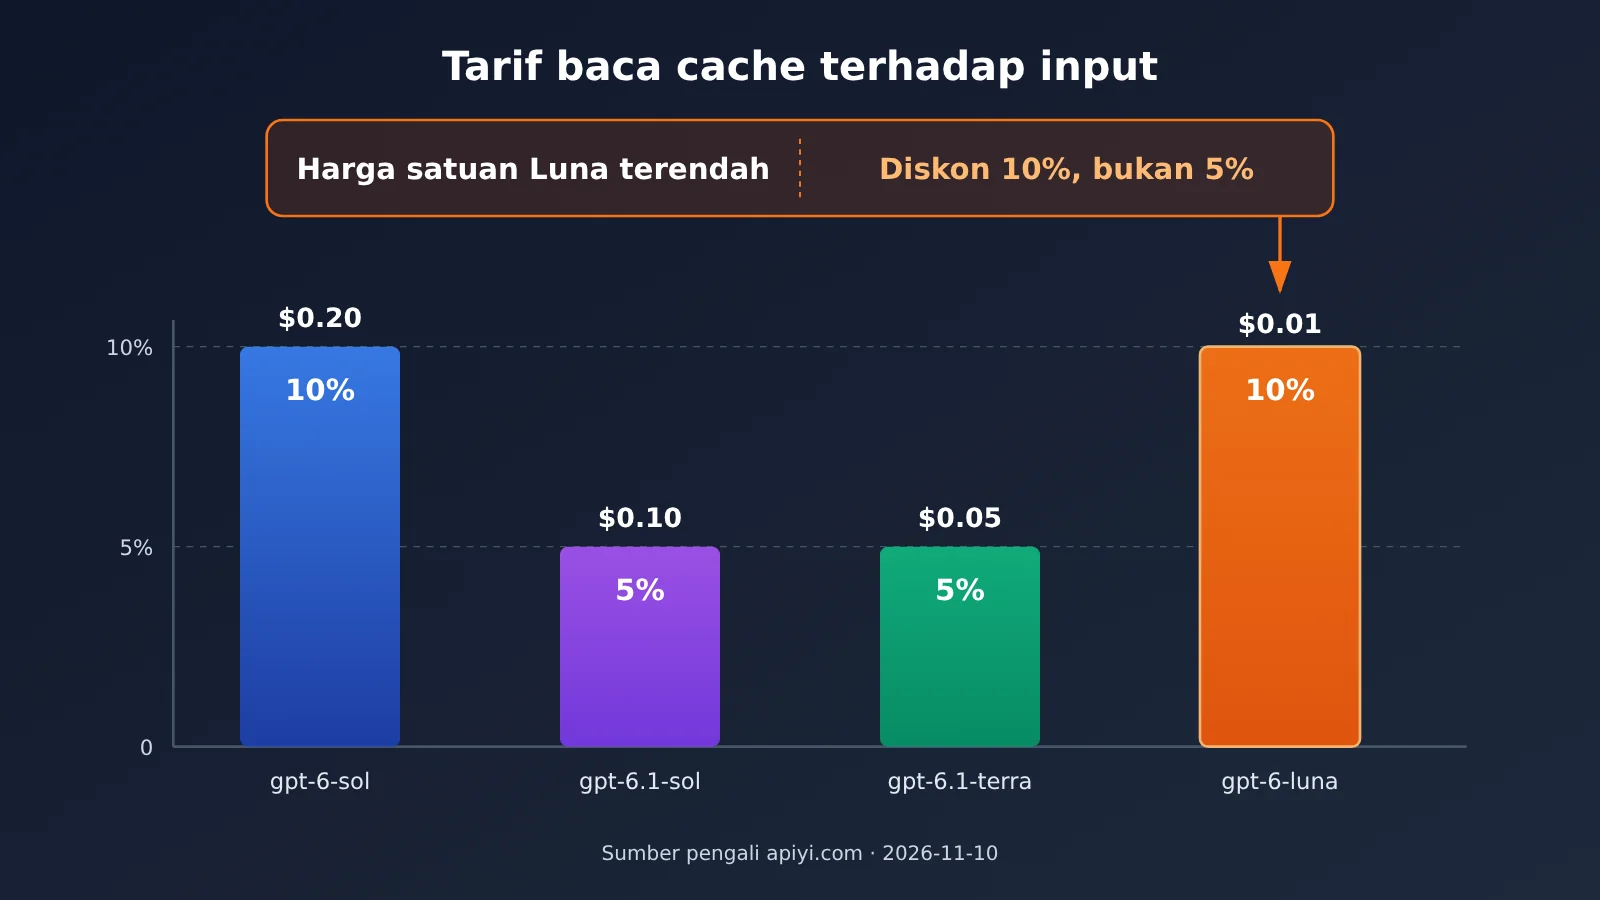
Banyak developer menggunakan beberapa model sekaligus, sehingga mudah berasumsi bahwa jika pembacaan cache Sol 6.1 sebesar 5%, model lain pasti sama. Padahal, rasio pembacaan cache ditetapkan untuk setiap model secara terpisah, jadi tidak bisa disamaratakan. Berikut perbandingan harga resmi dan rasio platform pada hari yang sama:
| ID model | Harga input | Harga output | Harga pembacaan cache | cache_ratio | Platform yang tersedia |
|---|---|---|---|---|---|
gpt-6-sol |
$2 | $10 | $0.20 | 0.1 | APIYI apiyi.com, OpenAI resmi |
gpt-6.1-sol |
$2 | $10 | $0.10 | 0.05 | APIYI apiyi.com, OpenAI resmi |
gpt-6.1-terra |
$1 | $5 | $0.05 | 0.05 | APIYI, OpenAI resmi |
gpt-6-luna |
$0.10 | $0.50 | $0.01 | 0.1 | APIYI, OpenAI resmi |
Analisis perbandingan
Analisis Terra: Pembacaan cache gpt-6.1-terra juga sebesar 5% dari harga input, dengan harga satuan yang lebih rendah. Namun, artikel ini membahas “ID mana yang sebaiknya dipilih untuk Sol di kelas yang sama”. Terra berada di kelas kemampuan yang berbeda. Beralih dari Sol ke Terra adalah persoalan pemilihan model dan tidak termasuk dalam cakupan perubahan kali ini.
Analisis Luna: gpt-6-luna memiliki harga satuan paling murah, dengan biaya pembacaan cache hanya $0.01. Namun, diskon cachenya sebesar 10% dari harga input, bukan 5%. Jadi, kesimpulan “beralih dari Sol ke 6.1 menghemat separuh biaya cache” hanya berlaku untuk Sol. Jangan gunakan kesimpulan itu untuk memperkirakan anggaran Luna.
💡 Saran pemilihan: Jika tugas Anda memerlukan kemampuan kelas Sol, mengganti ID lama langsung ke
gpt-6.1-soladalah langkah dengan manfaat paling pasti dan risiko paling kecil. Jika Anda mempertimbangkan penghematan biaya dengan beralih ke kelas lain, coba panggil berbagai model menggunakan kunci yang sama di APIYI untuk membandingkan hasilnya, lalu perkirakan biaya aktual dengan mempertimbangkan rasio cache.
FAQ Umum
Q1: Apa perbedaan harga gpt-6-sol dan gpt-6.1-sol?
Perbedaannya hanya pada pembacaan cache. Harga input keduanya sama, yaitu $2 per juta token, dan harga outputnya $10. Biaya pembacaan cache `gpt-6-sol` adalah $0.20, sedangkan `gpt-6.1-sol` $0.10—masing-masing 10% dan 5% dari harga input. Data per 2026-11-10; harga resmi dan pengali platform sama.
Q2: Apakah saya perlu membeli paket baru atau membuat akun baru untuk beralih ke gpt-6.1-sol?
Tidak perlu. Kedua ID model tersedia di daftar model APIYI, dan keduanya bisa dipanggil dengan kunci API yang sama. Anda hanya perlu mengubah kolom `model` di dalam permintaan. `base_url` dan metode autentikasi klien tetap sama.
Q3: Bagaimana cara mengonversi pengali APIYI menjadi harga dalam dolar AS?
Dengan patokan “pengali 1 = input $2 per juta token”: `model_ratio` sebesar 1 berarti input $2; `completion_ratio` sebesar 5 berarti output $10; `cache_ratio` sebesar 0.05 berarti pembacaan cache $0.10. Biaya akhir juga bergantung pada grup akun. Lihat daftar model APIYI di apiyi.com untuk mengetahui harga yang berlaku.
Q4: Dalam skenario apa peralihan ke gpt-6.1-sol memberikan penghematan paling besar?
Terutama pada skenario dengan konteks panjang dan tingkat cache yang tinggi:
– **Agent multi-giliran**: petunjuk sistem, definisi alat, dan pesan sebelumnya dikirim berulang kali pada setiap giliran.
– **Asisten kode**: kumpulan file repositori yang sama berulang kali dikirim sebagai konteks.
– **Tanya jawab basis pengetahuan**: awalan berupa dokumen panjang yang tetap, disertai pertanyaan pengguna yang berubah-ubah.
Q5: Apakah Luna dan Terra juga bisa diperkirakan dengan asumsi “biaya pembacaan cache turun setengah”?
Tidak bisa digeneralisasi seperti itu. Biaya pembacaan cache `gpt-6.1-terra` adalah 5% dari harga input, sedangkan `gpt-6-luna` 10%. Harga satuan Luna memang paling rendah, tetapi persentase diskon cache-nya bukan 5%. Saat memperkirakan anggaran, hitung masing-masing berdasarkan `cache_ratio`-nya.
Q6: Mengapa tagihan tidak banyak turun setelah ID diganti?
Penyebab paling umum adalah tingkat cache yang rendah. Misalnya, awalan permintaan berisi stempel waktu atau kolom acak sehingga setiap permintaan ditagih sebagai input penuh. Kemungkinan lainnya, sebagian layanan masih menggunakan ID lama. Periksa kolom token cache pada `usage` yang dikembalikan, lalu lihat detail pemanggilan per model di konsol APIYI.
Q7: Apakah kualitas output akan berubah setelah beralih?
Keduanya merupakan versi berbeda dalam tingkat kemampuan yang sama, tetapi performanya bisa berbeda untuk tugas tertentu. Sebaiknya bandingkan terlebih dahulu dengan lalu lintas kecil atau kumpulan data pengujian. Setelah output dipastikan memenuhi kebutuhan bisnis, barulah lakukan peralihan penuh.
Poin Penting tentang Harga Cache Read gpt-6.1-sol
- Harga sama, cache berbeda: Input dan output untuk kedua model Sol sama, masing-masing $2 dan $10, tetapi harga cache read berbeda dua kali lipat.
- Harga cache read:
gpt-6-solseharga $0.20 dangpt-6.1-solseharga $0.10 per satu juta token. - Paling menguntungkan untuk sesi panjang: Semakin banyak cache hit, semakin besar penghematan saat beralih ke
gpt-6.1-sol. - Hanya perlu satu perubahan: Cukup ubah kolom
modeldalam permintaan. Tidak perlu paket baru. - Jangan samakan dengan Luna: Harga cache read Luna adalah 10% dari harga input, bukan 5%.
- Cara mulai: Gunakan kunci API yang sama di APIYI untuk menguji dengan volume kecil, lalu terapkan sepenuhnya.
Ringkasan
Poin utama saat beralih dari gpt-6-sol ke gpt-6.1-sol:
- Struktur harga: Harga input dan output sama persis. Harga cache read turun dari 10% menjadi 5% dari harga input. Data per 2026-11-10.
- Cakupan perubahan: Kedua ID tercantum di daftar model platform. Anda hanya perlu mengganti nama model dalam permintaan;
base_urldan kunci API tetap sama. - Batas penerapan: “Harga cache read turun setengah” hanya berlaku untuk Sol. Hitung pengali cache Terra dan Luna secara terpisah.
Jika layanan sesi panjang Anda masih menggunakan ID lama, ini adalah optimasi yang hampir tidak memerlukan biaya. Sebaiknya periksa daftar model dan pengalinya di APIYI apiyi.com terlebih dahulu, lalu ikuti 3 langkah dalam artikel ini untuk beralih. Jadikan daftar model platform sebagai acuan untuk model dan harganya.
📚 Referensi
- Daftar harga resmi OpenAI: harga input, output, dan input cache untuk model standar
- Tautan:
developers.openai.com/api/docs/pricing -
Keterangan: Periksa harga resmi per unit untuk
gpt-6-sol,gpt-6.1-sol,gpt-6.1-terra, dangpt-6-luna -
Endpoint daftar harga APIYI: data pengali model di platform
- Tautan:
api.apiyi.com/api/pricing - Keterangan: Lihat tiga pengali: model_ratio, completion_ratio, dan cache_ratio
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman beranda situs APIYI. Informasi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com.