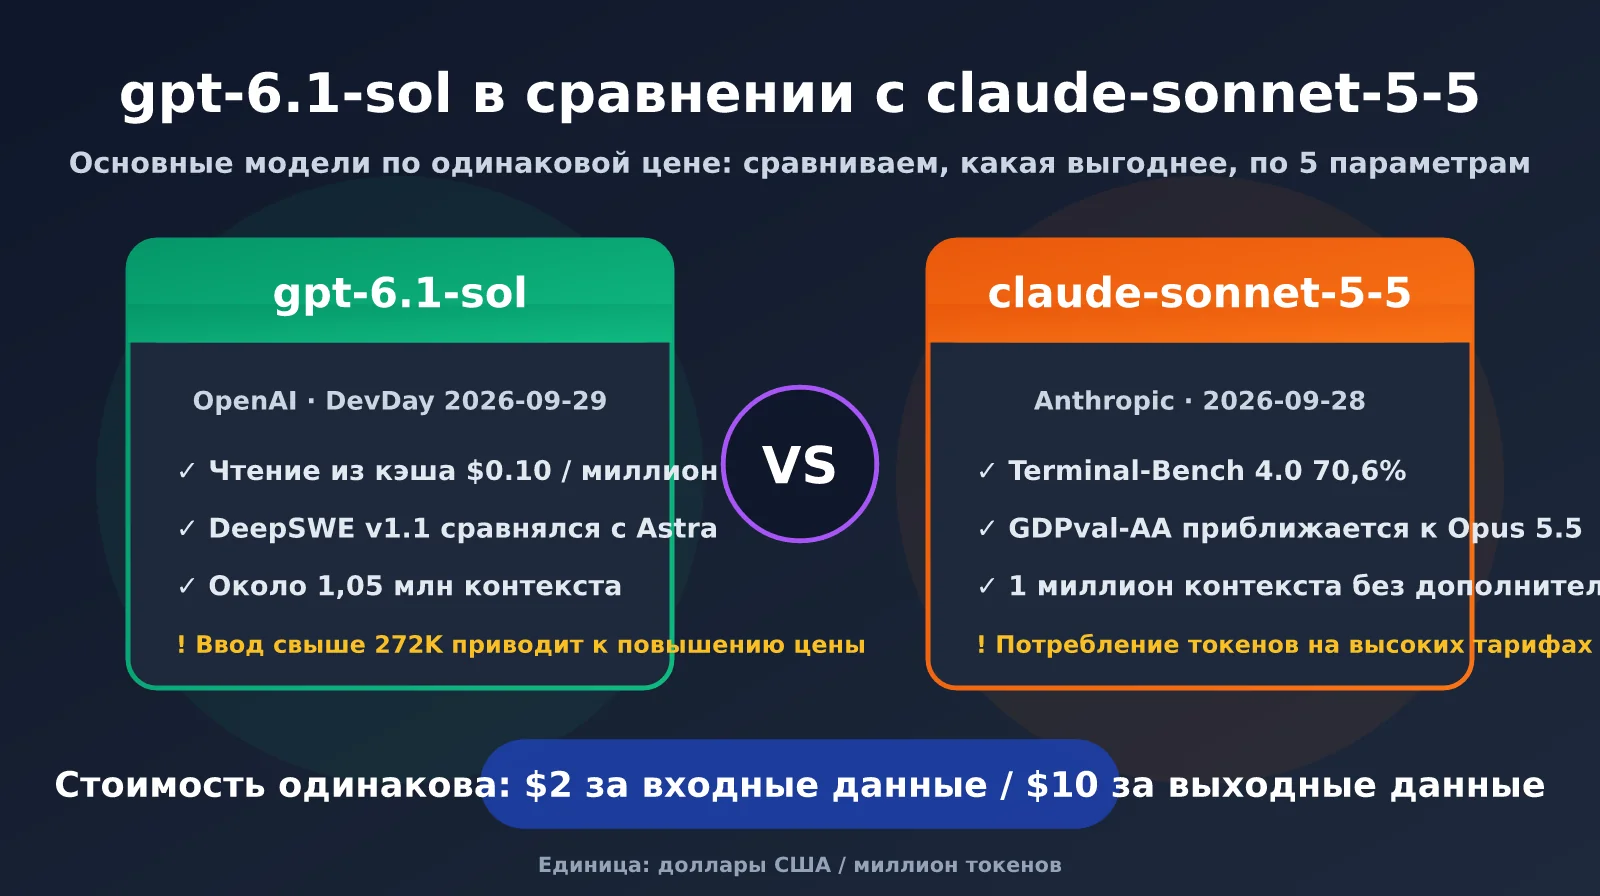
Примечание автора: у gpt-6-sol и gpt-6.1-sol одинаковая цена на входные и выходные токены, а стоимость чтения кэша отличается вдвое. В статье рассказываем, как снизить расходы на кэш в длинных диалогах, просто изменив поле model в запросе.
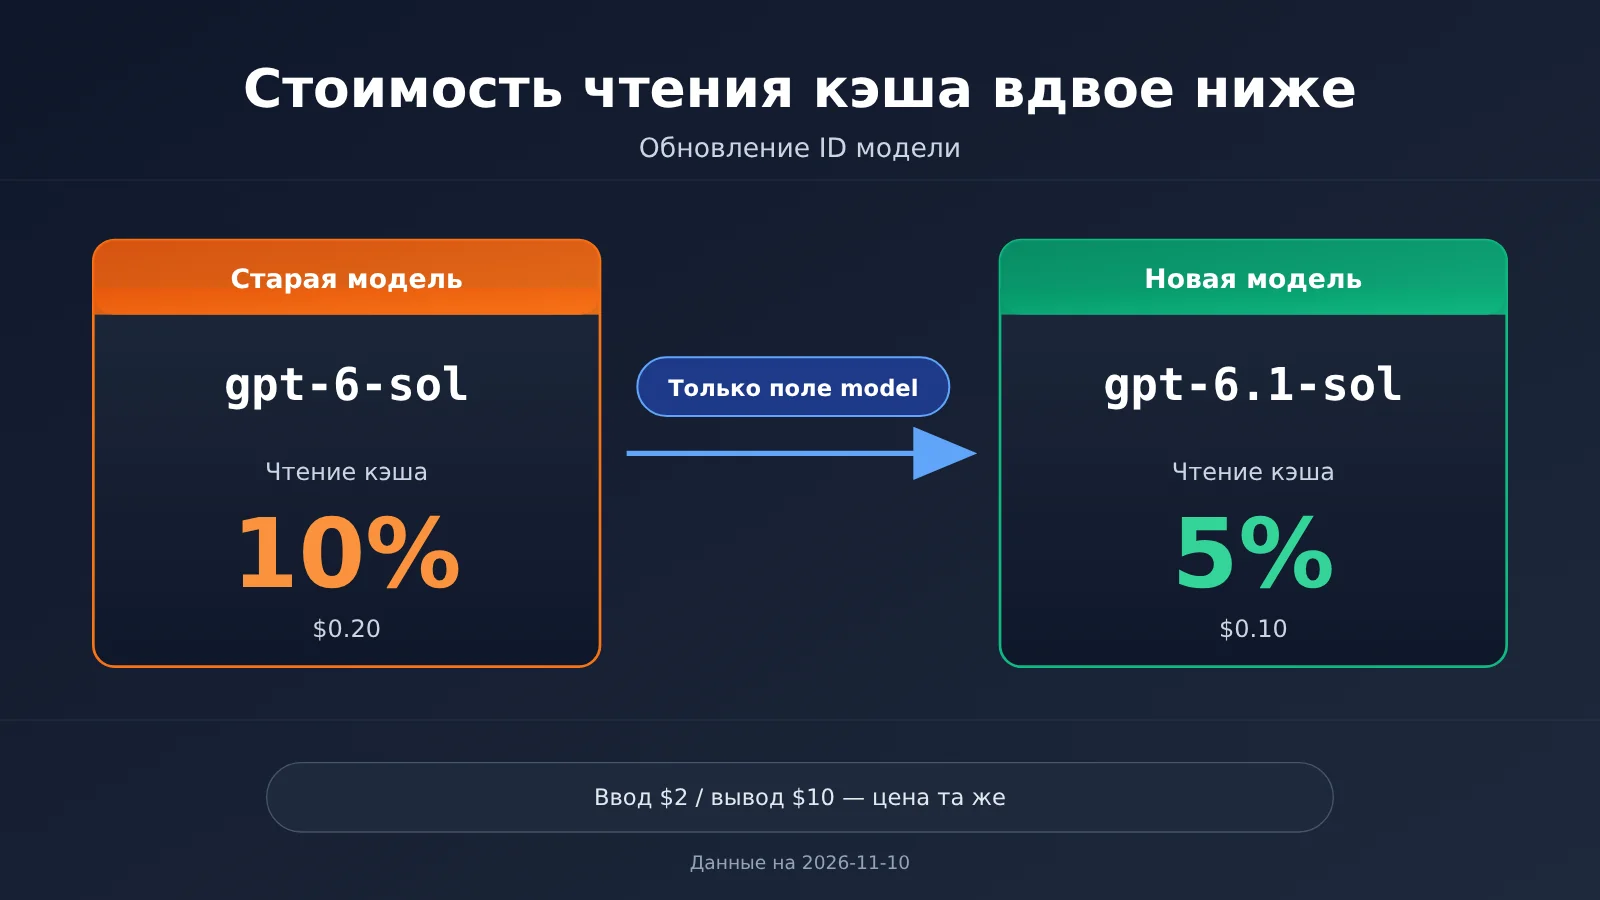
Многие разработчики уже используют 6.1 Sol, 6.1 Terra и 6 Luna, но в конфигурации проекта у какого-нибудь старого сервиса всё ещё может быть указан gpt-6-sol. В этой статье мы покажем, как исправить это с минимальными изменениями: заменить gpt-6-sol на gpt-6.1-sol. Цена на входные и выходные токены не изменится, а стоимость чтения кэша снизится с 10% до 5% от цены входных токенов.
Это не акция и не предложение сменить тариф. Разница в ценах на две версии Sol указана в официальном прайс-листе OpenAI, а коэффициенты на платформе APIYI соответствуют официальным. Нужно изменить всего одну строку в запросе.
Главное: прочитав статью, вы узнаете, какой ID модели нужно изменить, сколько можно сэкономить на чтении кэша и почему вывод о «снижении стоимости чтения кэша вдвое» нельзя автоматически переносить на Terra, Luna и другие модели — особенно на Luna.
Ключевые моменты о ценах gpt-6-sol и gpt-6.1-sol
Сначала — самая важная таблица. Все цены указаны за миллион токенов. Данные актуальны на 2026-11-10. Источник — стандартные тарифы OpenAI; значения также совпадают с коэффициентами, возвращаемыми интерфейсом APIYI.
| ID модели | Ввод | Вывод | Чтение из кэша | Чтение из кэша относительно цены ввода |
|---|---|---|---|---|
gpt-6-sol |
$2 | $10 | $0.20 | 10% |
gpt-6.1-sol |
$2 | $10 | $0.10 | 5% |
Из таблицы видно, что цены на ввод и вывод у обеих версий Sol одинаковые. Разница только в стоимости чтения из кэша. Для короткого запроса в один ход она почти незаметна. Но в сценариях, где каждый раз передаются длинный системный промпт, описания инструментов и история диалога, токены чтения из кэша часто составляют бо́льшую часть входных данных. Поэтому разница в коэффициенте в два раза будет постоянно накапливаться.
Почему стоит отдельно обратить внимание на чтение из кэша в gpt-6.1-sol
Prompt Cache позволяет тарифицировать токены общего префикса запроса, совпадающего с префиксом предыдущих запросов, по цене чтения из кэша, а не по полной цене ввода. В приложениях с агентами, помощниками по программированию и чат-ботами поддержки на каждом ходу повторно передаются одни и те же системные промпты и история сообщений, поэтому доля попаданий в кэш обычно высокая.
При такой нагрузке стоимость чтения из кэша часто влияет на счёт заметнее, чем цена ввода. У gpt-6-sol чтение из кэша стоит $0.20, а у gpt-6.1-sol — $0.10. При одинаковом количестве попаданий в кэш за первый вариант придётся платить вдвое больше. Если ваш сервис всё ещё использует старый ID и работает с длинными диалогами, вы постоянно переплачиваете за один и тот же контекст.
Как соотносятся коэффициенты платформы и официальные цены
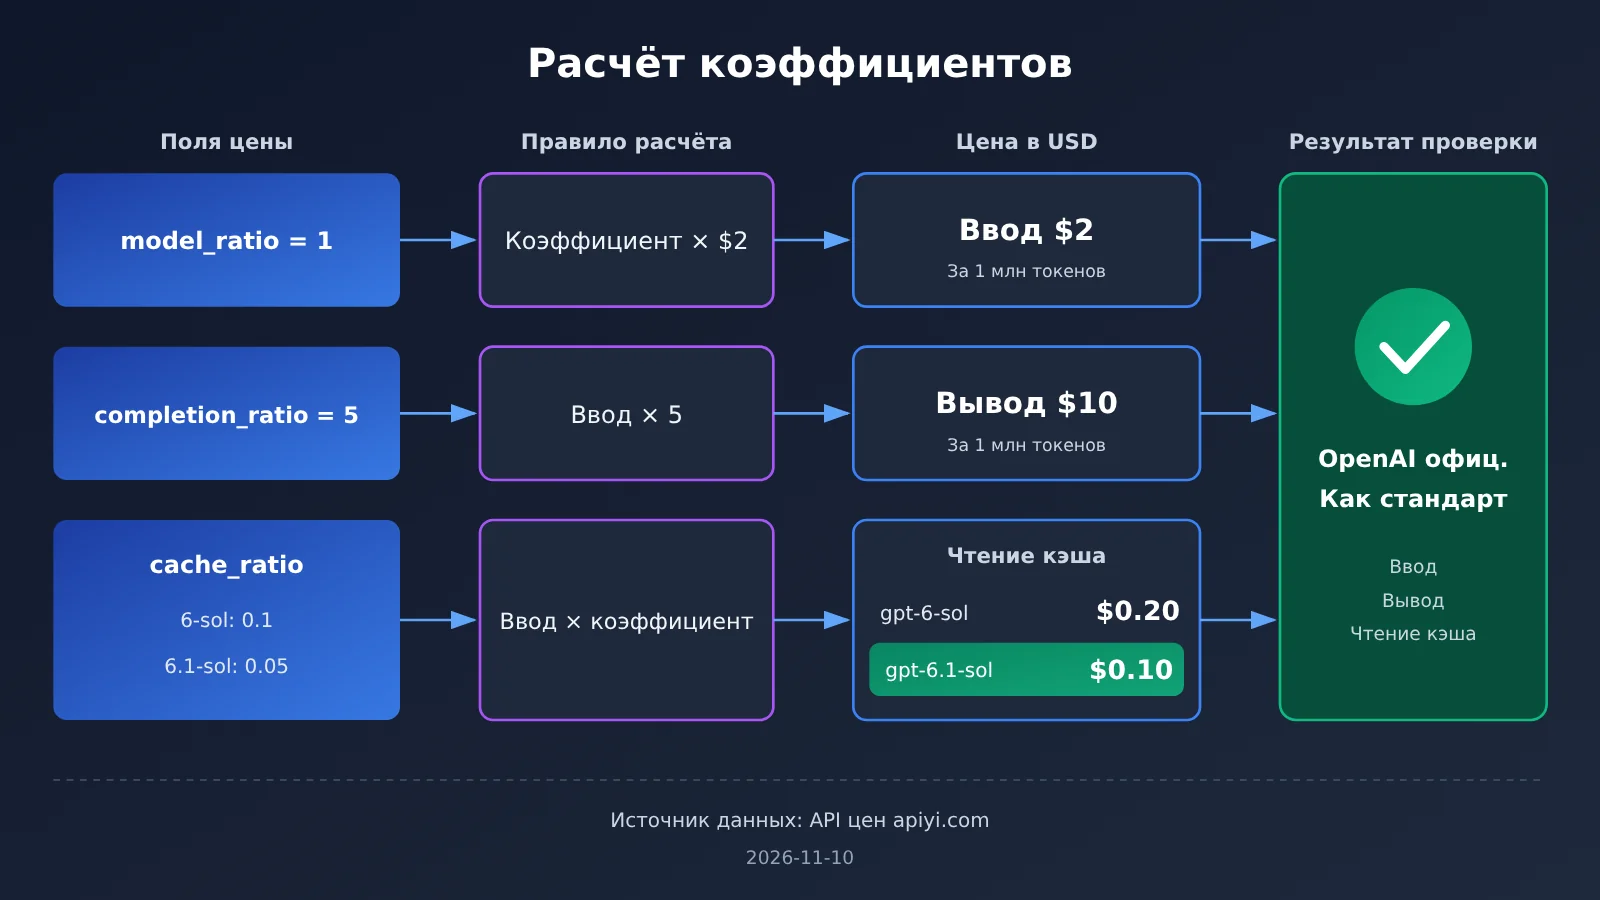
В прайс-листе APIYI цены представлены в виде коэффициентов. В данных, полученных 2026-11-10, есть обе версии Sol со следующими значениями:
| Поле | gpt-6-sol |
gpt-6.1-sol |
Значение |
|---|---|---|---|
| model_ratio | 1 | 1 | Коэффициент 1 соответствует цене ввода $2 за миллион токенов |
| completion_ratio | 5 | 5 | Вывод стоит в 5 раз дороже ввода, то есть $10 |
| cache_ratio | 0.1 | 0.05 | Чтение из кэша стоит 10% / 5% от цены ввода |
Если считать, что «коэффициент 1 = $2 за миллион входных токенов», то для обеих моделей цена ввода составит $2, вывода — $10, а чтения из кэша — соответственно $0.20 и $0.10. Это полностью совпадает с официальными тарифами. Учтите, что здесь пересчитываются только коэффициенты самой модели, без учёта коэффициентов групп. Итоговую стоимость проверяйте с учётом группы, к которой относится ваш аккаунт, и списка моделей на платформе. Сверить эти три коэффициента можно на странице цен моделей APIYI по адресу apiyi.com.
Как рассчитать стоимость кэширования длинных сессий в gpt-6.1-sol
По одним только тарифам разницу оценить сложно, поэтому разберём простой пример. Допустим, сессия Agent состоит из 100 раундов, и в каждом запросе в кэш попадает префикс примерно на 50 тысяч токенов. За всю сессию получится 5 миллионов токенов, прочитанных из кэша.
| Показатель | gpt-6-sol |
gpt-6.1-sol |
|---|---|---|
| Всего токенов, прочитанных из кэша | 5 млн | 5 млн |
| Стоимость чтения из кэша (за миллион токенов) | $0.20 | $0.10 |
| Стоимость чтения из кэша | $1.00 | $0.50 |
| Ввод и вывод | Одинаковая стоимость | Одинаковая стоимость |
Это расчёт для одной сессии. Если каждый день проходят тысячи таких сессий, стоимость чтения из кэша будет стабильно вдвое ниже. Тарифы на ввод и вывод не меняются, поэтому после перехода на gpt-6.1-sol остальные расходы не вырастут — вы сэкономите именно на чтении из кэша.
Разумеется, этот пример предполагает, что кэш действительно срабатывает. Если префикс запроса каждый раз меняется — например, в начало системного промпта добавляются временная метка или случайный ID, — частота попаданий в кэш будет низкой. В таком случае переход на другой ID модели даст лишь небольшой эффект. Сначала вынесите неизменяемую часть в начало, а изменяемую — в конец, и только потом меняйте ID: так результат будет заметнее.
Как быстро перейти с gpt-6-sol на gpt-6.1-sol
Изменения минимальны: обе модели уже есть в списке моделей APIYI, и для вызова можно использовать тот же API-ключ. Подключать или покупать новый тариф не нужно. Достаточно изменить поле model в теле запроса.
Самый простой способ: переход за 3 шага
- Найдите старый ID: выполните глобальный поиск
gpt-6-solв репозитории и конфигурациях. Будьте внимательны, чтобы случайно не затронуть строки с новым ID, напримерgpt-6.1-sol. Для этого можно искать точное значение в кавычках. - Замените значение поля model: измените
model="gpt-6-sol"наmodel="gpt-6.1-sol". Инициализацию клиента менять не нужно: оставьтеbase_url="https://api.apiyi.com/v1"и свой API-ключ. - Проверьте на небольшой доле трафика: сначала переключите часть запросов и проверьте поле кэшированных токенов в
usage, чтобы убедиться, что кэш работает корректно. После этого можно переключить всё остальное.
Например, с официальным Python SDK OpenAI клиент создаётся так: client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1"). При вызове client.chat.completions.create(model="gpt-6.1-sol", messages=messages) достаточно изменить значение model — messages и остальные параметры трогать не нужно.
Рекомендуемый способ: вынести настройки в конфигурацию
Если в проекте название модели указано напрямую в нескольких местах, заодно с переходом можно вынести его в конфигурацию. Например, сохраните ID модели в переменной окружения OPENAI_MODEL=gpt-6.1-sol, а в коде считывайте его через os.getenv("OPENAI_MODEL", "gpt-6.1-sol"). Тогда при выходе новой версии достаточно будет изменить одну настройку, а не искать и заменять её по всему репозиторию.
Адрес клиента тоже лучше считывать из переменной окружения, например OPENAI_BASE_URL=https://api.apiyi.com/v1. Благодаря совместимости с OpenAI можно и дальше использовать прежние способы подключения через SDK, LangChain и различные фреймворки для агентов — достаточно проверить значения base_url и model.
🚀 Быстрый старт: перед сменой ID проверьте в списке моделей APIYI на apiyi.com, доступна ли модель
gpt-6.1-solв группе вашего аккаунта. После этого переход сводится к изменению одной строки в полеmodel. Новые пользователи могут сначала провести тест на небольшом трафике, используя бесплатный лимит.
На что обратить внимание при переходе
- Обновили не все сервисы: основной сервис уже использует новую модель, а в задачах по расписанию и скриптах пакетной обработки остался старый ID. В счёте будут отображаться обе модели.
- В шлюзе настроен белый список моделей: если внутренний шлюз или прокси проверяет названия моделей по белому списку, сначала добавьте туда
gpt-6.1-sol. - Логи и мониторинг сгруппированы по названию модели: если на дашборде стоимость считается отдельно для каждой модели, после перехода отслеживайте старый и новый ID вместе. Иначе может показаться, что число вызовов снизилось.
Сравнение скидок на чтение из кэша для gpt-6.1-sol, Terra и Luna
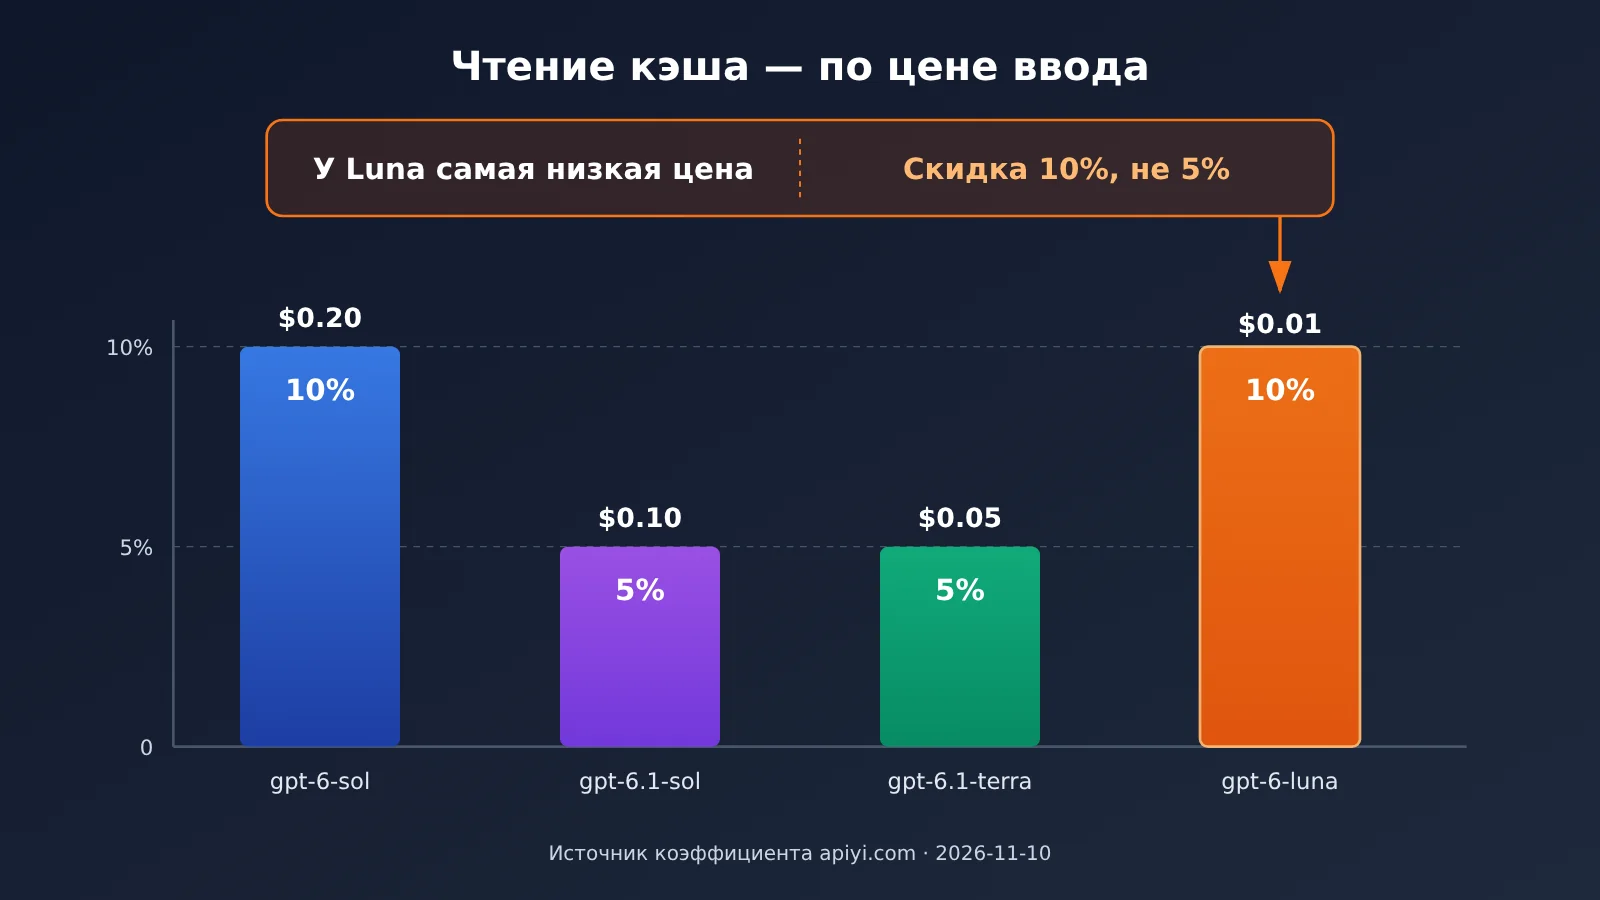
Многие разработчики используют сразу несколько моделей и могут интуитивно предположить: если чтение из кэша для Sol 6.1 стоит 5% от входной цены, то и для остальных моделей должно быть так же. На деле коэффициент для чтения из кэша задаётся отдельно для каждой модели, поэтому переносить это соотношение на другие модели нельзя. Ниже приведено сравнение официальных цен и коэффициентов платформы за один и тот же день:
| ID модели | Цена входных токенов | Цена выходных токенов | Цена чтения из кэша | cache_ratio | Доступные платформы |
|---|---|---|---|---|---|
gpt-6-sol |
$2 | $10 | $0.20 | 0.1 | APIYI apiyi.com, официальный OpenAI |
gpt-6.1-sol |
$2 | $10 | $0.10 | 0.05 | APIYI apiyi.com, официальный OpenAI |
gpt-6.1-terra |
$1 | $5 | $0.05 | 0.05 | APIYI, официальный OpenAI |
gpt-6-luna |
$0.10 | $0.50 | $0.01 | 0.1 | APIYI, официальный OpenAI |
Сравнение моделей
Сравнение с Terra: чтение из кэша для gpt-6.1-terra также стоит 5% от цены входных токенов, а абсолютная стоимость ещё ниже. Но здесь речь идёт о том, какой ID выбрать для моделей уровня Sol. Terra относится к другому уровню возможностей, поэтому переход с Sol на Terra — отдельный вопрос выбора модели, который выходит за рамки этой статьи.
Сравнение с Luna: у gpt-6-luna самая низкая абсолютная стоимость — чтение из кэша стоит всего $0.01. Но скидка на кэш составляет 10% от цены входных токенов, а не 5%. Поэтому вывод «переход с Sol на 6.1 вдвое снижает стоимость чтения из кэша» справедлив только для моделей уровня Sol. Не используйте его для расчёта бюджета на Luna.
💡 Совет по выбору: если вашей задаче нужны возможности уровня Sol, переход со старого ID на
gpt-6.1-sol— самый надёжный и предсказуемый способ сэкономить. Если вы рассматриваете переход на модель другого уровня ради снижения затрат, сравните разные модели в APIYI с одним и тем же ключом, а затем оцените реальные расходы с учётом коэффициента чтения из кэша.
Часто задаваемые вопросы
Вопрос 1. В чём именно разница в цене между gpt-6-sol и gpt-6.1-sol?
Разница только в стоимости чтения из кэша. Ввод для обеих моделей стоит $2 за миллион токенов, вывод — $10. Чтение из кэша для `gpt-6-sol` стоит $0.20, а для `gpt-6.1-sol` — $0.10, то есть 10% и 5% от цены ввода соответственно. Данные актуальны на 2026-11-10. Официальные цены совпадают с тарифными коэффициентами платформы.
Вопрос 2. Нужно ли покупать новый тариф или регистрировать новый аккаунт, чтобы перейти на gpt-6.1-sol?
Нет. Обе модели есть в списке моделей APIYI, поэтому для вызова подойдёт тот же API-ключ. Нужно изменить только поле `model` в запросе — `base_url` и способ авторизации остаются прежними.
Вопрос 3. Как пересчитать тарифный коэффициент APIYI в цену в долларах?
Расчёт ведётся исходя из того, что «коэффициент 1 = $2 за миллион токенов ввода»: при `model_ratio` равном 1 ввод стоит $2; при `completion_ratio` равном 5 вывод стоит $10; при `cache_ratio` равном 0.05 чтение из кэша стоит $0.10. Фактическая стоимость также зависит от группы аккаунта. Ориентируйтесь на цены в списке моделей APIYI на apiyi.com.
Вопрос 4. В каких случаях переход на gpt-6.1-sol даст наибольшую выгоду?
В первую очередь — в сценариях с длинным контекстом и высокой долей попаданий в кэш:
— **Многошаговые агенты**: в каждом запросе повторно передаются системный промпт, описания инструментов и история сообщений.
— **Помощники для работы с кодом**: одни и те же файлы репозитория регулярно отправляются в качестве контекста.
— **Вопросы и ответы по базе знаний**: неизменный префикс с длинным документом дополняется вопросами пользователей.
Вопрос 5. Можно ли для Luna и Terra тоже считать, что чтение из кэша подешевело вдвое?
Нет, такое правило нельзя переносить на другие модели. Для `gpt-6.1-terra` чтение из кэша стоит 5% от цены ввода, а для `gpt-6-luna` — 10%. У Luna самая низкая абсолютная цена, но скидка на кэш составляет не 5%. При расчёте бюджета учитывайте `cache_ratio` каждой модели отдельно.
Вопрос 6. Почему после смены ID счёт заметно не уменьшился?
Чаще всего причина — низкая доля попаданий в кэш. Например, если в префикс запроса добавить метку времени или случайное значение, каждый запрос будет тарифицироваться как полный ввод. Кроме того, некоторые сервисы могут по-прежнему вызывать старую модель. Проверьте поле с количеством токенов из кэша в ответе `usage`, а также детализацию вызовов каждой модели в консоли APIYI.
Вопрос 7. Изменится ли качество ответов после перехода?
Это разные версии моделей одного уровня возможностей, но на конкретных задачах их результаты могут различаться. Для надёжности сначала сравните их на небольшой доле трафика или на тестовом наборе и переходите полностью, только убедившись, что результаты соответствуют требованиям бизнеса.
Ключевые выводы о цене чтения из кэша gpt-6.1-sol
- Одинаковые цены, но разная стоимость чтения из кэша: у обеих моделей Sol вход стоит $2, а выход — $10, но чтение из кэша у
gpt-6.1-solобходится вдвое дешевле. - Точные цены чтения из кэша: $0.20 у
gpt-6-solи $0.10 уgpt-6.1-solза миллион токенов. - Больше всего выиграют длинные сессии: чем чаще срабатывает кэш, тем больше экономия при переходе на
gpt-6.1-sol. - Меняется только одно: достаточно изменить поле
modelв запросе — новый тарифный план не нужен. - Не переносите это правило на Luna: чтение из кэша у Luna стоит 10% от цены входных токенов, а не 5%.
- Как начать: проверьте работу на небольшом трафике с тем же ключом APIYI и только потом переключайте всё остальное.
Итоги
Главное при переходе с gpt-6-sol на gpt-6.1-sol:
- Структура цен: стоимость входных и выходных токенов полностью совпадает, а чтение из кэша подешевело с 10% до 5% от цены входных токенов. Данные актуальны на 2026-11-10.
- Что нужно изменить: обе модели есть в списке моделей платформы. Достаточно заменить название модели в запросе —
base_urlи API-ключ остаются прежними. - Границы применимости: снижение стоимости чтения из кэша вдвое относится только к Sol. Для Terra и Luna нужно отдельно учитывать коэффициент чтения из кэша для каждой модели.
Если ваш сервис с длинными сессиями всё ещё использует старый ID, это оптимизация почти без затрат. Сначала проверьте список моделей и коэффициенты на APIYI apiyi.com, а затем выполните переход в 3 шага, описанные в статье. Ориентируйтесь на список моделей платформы — в нём указаны актуальные названия и цены.
📚 Источники
- Официальные цены OpenAI: цены на входные и выходные токены, а также на кешированные входные токены для моделей стандартного уровня
- Ссылка:
developers.openai.com/api/docs/pricing -
Примечание: проверьте официальные цены для
gpt-6-sol,gpt-6.1-sol,gpt-6.1-terraиgpt-6-luna -
Интерфейс APIYI с ценами: данные о коэффициентах моделей на платформе
- Ссылка:
api.apiyi.com/api/pricing - Примечание: проверьте три коэффициента: model_ratio, completion_ratio и cache_ratio
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI. Дополнительные материалы по подключению доступны в центре документации: docs.apiyi.com