作者注:gpt-6-sol 與 gpt-6.1-sol 輸入輸出同價,緩存讀倍率相差一倍。本文說明如何只改請求裏的 model 字段,把長會話的緩存成本降下來。
很多開發者日常已經在用 6.1 Sol、6.1 Terra、6 Luna,但翻開項目配置,會發現某個老服務的請求裏還寫着 gpt-6-sol。本文介紹一個改動很小的做法:把 gpt-6-sol 換成 gpt-6.1-sol,輸入輸出單價不變,緩存讀從輸入價的 10% 降到 5%。
這不是促銷,也不是要你換套餐。兩檔 Sol 的價格差異直接寫在 OpenAI 官方價目裏,API易 平臺列表的倍率與官方一致。要改的只是請求裏的一個字符串。
核心價值:讀完本文,你會知道哪一個模型 ID 該改、改完緩存讀能省多少,以及爲什麼這個“緩存讀減半”的結論不能套到 Terra、Luna 以外的推斷上,尤其不能套到 Luna 上。
gpt-6-sol 與 gpt-6.1-sol 價格核心要點
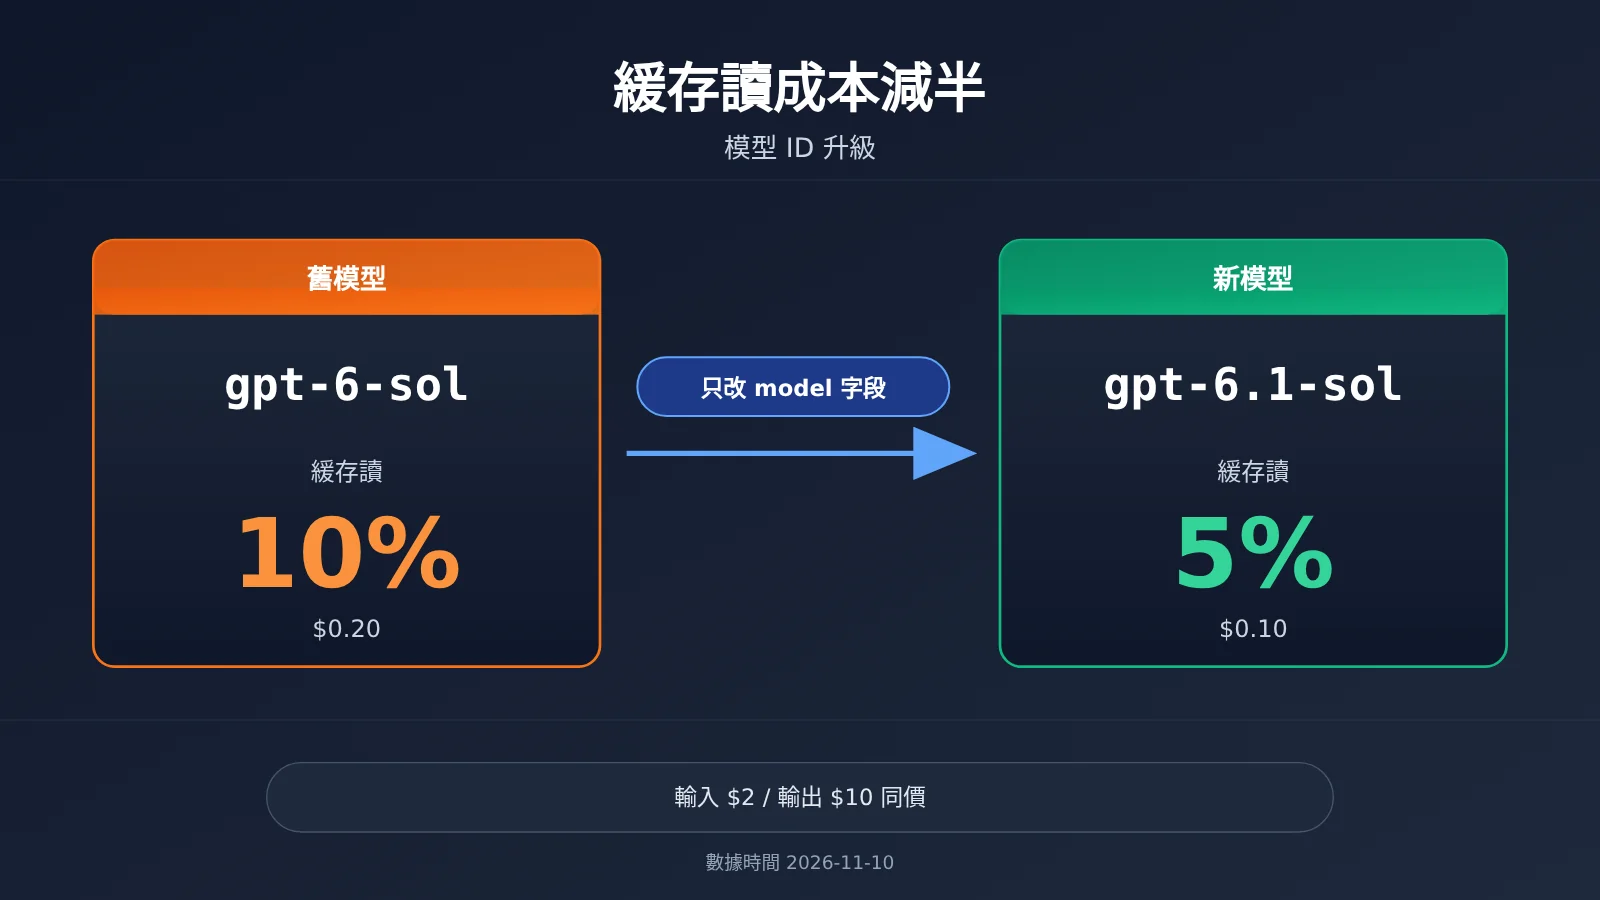
先看最關鍵的一張表。以下價格均爲每百萬 token,數據時間 2026-11-10,來源是 OpenAI 官方價目的標準檔,並與 API易 價目接口返回的倍率覈對一致。
| 模型 ID | 輸入價 | 輸出價 | 緩存讀價 | 緩存讀佔輸入價 |
|---|---|---|---|---|
gpt-6-sol |
$2 | $10 | $0.20 | 10% |
gpt-6.1-sol |
$2 | $10 | $0.10 | 5% |
這張表說明了一件事:兩檔 Sol 在輸入和輸出上沒有任何價差,唯一的區別在緩存讀。對於單輪短請求,這個差別幾乎感知不到;但對於會反覆帶上長系統提示、長工具定義、長對話歷史的場景,緩存讀 token 往往佔請求輸入的大頭,差一倍的倍率會持續累積。
gpt-6.1-sol 緩存讀爲什麼值得單獨關注
Prompt Cache 的作用是:當請求前綴與之前的請求相同時,這部分 token 按緩存讀價格計費,而不是按完整輸入價計費。Agent、代碼助手、客服機器人這類應用,每一輪都會把同樣的系統提示和歷史消息再發一遍,命中緩存的比例通常很高。
在這種工作負載下,緩存讀單價對賬單的影響往往比輸入單價更直接。gpt-6-sol 的緩存讀是 $0.20,gpt-6.1-sol 是 $0.10,同樣的緩存命中量,前者要付兩倍。如果你的服務還停留在舊 ID 上,並且又是長會話,就等於一直在爲同樣的上下文多付一份錢。
平臺倍率與官方價如何對應
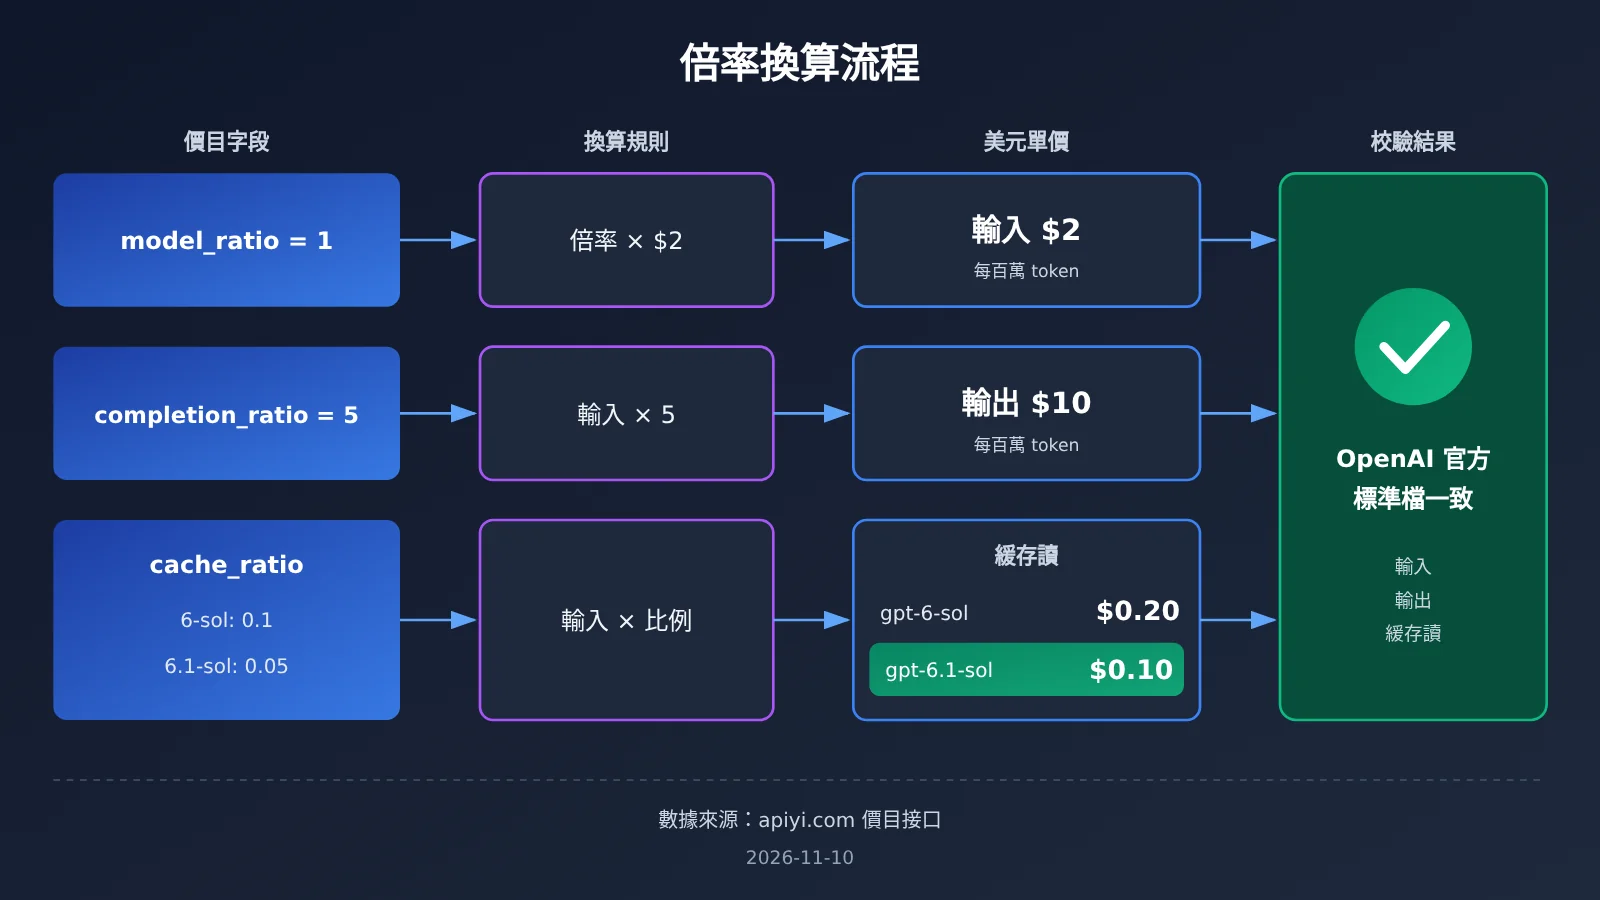
API易 的價目接口用倍率表達價格。2026-11-10 返回的數據裏,兩檔 Sol 都在列表中,倍率如下:
| 字段 | gpt-6-sol |
gpt-6.1-sol |
含義 |
|---|---|---|---|
| model_ratio | 1 | 1 | 倍率 1 對應輸入 $2 / 百萬 token |
| completion_ratio | 5 | 5 | 輸出爲輸入的 5 倍,即 $10 |
| cache_ratio | 0.1 | 0.05 | 緩存讀爲輸入的 10% / 5% |
按“倍率 1 = 輸入 $2 / 百萬 token”的口徑換算,兩者都是輸入 $2、輸出 $10,緩存讀分別是 $0.20 和 $0.10,與官方價目完全對得上。需要說明的是,這裏只換算模型本身的倍率,不涉及任何分組倍率,具體結算請以你賬戶所在分組和平臺型號列表爲準。查價時可以直接訪問 API易 apiyi.com 的模型價格頁面覈對這三個倍率。
gpt-6.1-sol 長會話緩存成本怎麼算
只看單價不夠直觀,下面用一個純算術的例子說明差距。假設某個 Agent 會話共 100 輪,每輪請求中命中緩存的前綴約 5 萬 token,那麼整個會話累計緩存讀 token 爲 500 萬。
| 計算項 | gpt-6-sol |
gpt-6.1-sol |
|---|---|---|
| 累計緩存讀 token | 500 萬 | 500 萬 |
| 緩存讀單價(每百萬) | $0.20 | $0.10 |
| 緩存讀費用 | $1.00 | $0.50 |
| 輸入、輸出部分 | 單價相同 | 單價相同 |
這只是一個會話的數字。如果同類會話每天有上千個,緩存讀這一項就是穩定的一半差額。由於輸入和輸出單價完全相同,換成 gpt-6.1-sol 後其他部分的成本不會上升,節省下來的就是緩存讀那一半。
當然,這個例子的前提是緩存確實命中。如果你的請求前綴每次都變化,比如把時間戳、隨機 ID 放在系統提示最前面,那麼緩存命中率本身就很低,換模型 ID 帶來的收益也會很有限。這種情況下,先把固定內容放到前綴、變化內容放到末尾,再考慮換 ID,效果會更明顯。
如何把 gpt-6-sol 改成 gpt-6.1-sol 快速上手
改動的範圍非常小:兩個模型 ID 今天都在 API易 的型號列表裏,同一個 API Key 可以直接調用,不需要再開通或購買新的套餐。你要改的只是請求體裏的 model 字段。
極簡改法:3 步完成切換
- 定位舊 ID:在代碼倉庫和配置中心裏全局搜索
gpt-6-sol,注意不要誤傷gpt-6.1-sol這類已經是新 ID 的字符串,搜索時可以精確匹配引號內的完整值。 - 替換 model 字段:把
model="gpt-6-sol"改爲model="gpt-6.1-sol",客戶端初始化保持不變,仍然是base_url="https://api.apiyi.com/v1"加上你原有的 API Key。 - 小流量驗證:先在一部分請求上切換,觀察返回的 usage 中緩存 token 字段,確認緩存命中正常,再全量替換。
以 OpenAI 官方 Python SDK 爲例,客戶端寫法是 client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1"),調用時把 client.chat.completions.create(model="gpt-6.1-sol", messages=messages) 中的 model 換掉即可,messages 和其他參數都不用動。
推薦的配置化寫法
如果你的項目裏有多處直接寫死模型名,建議借這次切換順手做一次配置化。把模型 ID 抽到環境變量裏,例如 OPENAI_MODEL=gpt-6.1-sol,代碼中通過 os.getenv("OPENAI_MODEL", "gpt-6.1-sol") 讀取。這樣以後再有新版本,只需要改一處配置,而不是在倉庫裏逐個搜索替換。
客戶端部分同樣建議從環境變量讀取,例如 OPENAI_BASE_URL=https://api.apiyi.com/v1。OpenAI 兼容接口意味着 SDK、LangChain、各類 Agent 框架都可以沿用原有的接入方式,只需確認 base_url 和 model 兩個值。
🚀 快速開始:改 ID 之前,可以先到 API易 apiyi.com 的型號列表確認
gpt-6.1-sol在你賬戶可用的分組裏。確認之後,切換就只是請求裏model字段的一個字符串變化,新用戶還可以用免費測試額度先跑一輪小流量驗證。
切換時容易踩的幾個坑
- 只改了一部分服務:主服務換了,但定時任務、離線批處理腳本里還是舊 ID,賬單上會看到兩種模型同時出現。
- 網關有模型白名單:如果你的內部網關或代理層對模型名做了白名單校驗,要先把
gpt-6.1-sol加進去。 - 日誌與監控按模型名聚合:看板若按模型名統計成本,切換後要把新舊 ID 合併觀察,否則會誤以爲調用量下降。
gpt-6.1-sol 與 Terra、Luna 緩存摺扣對比
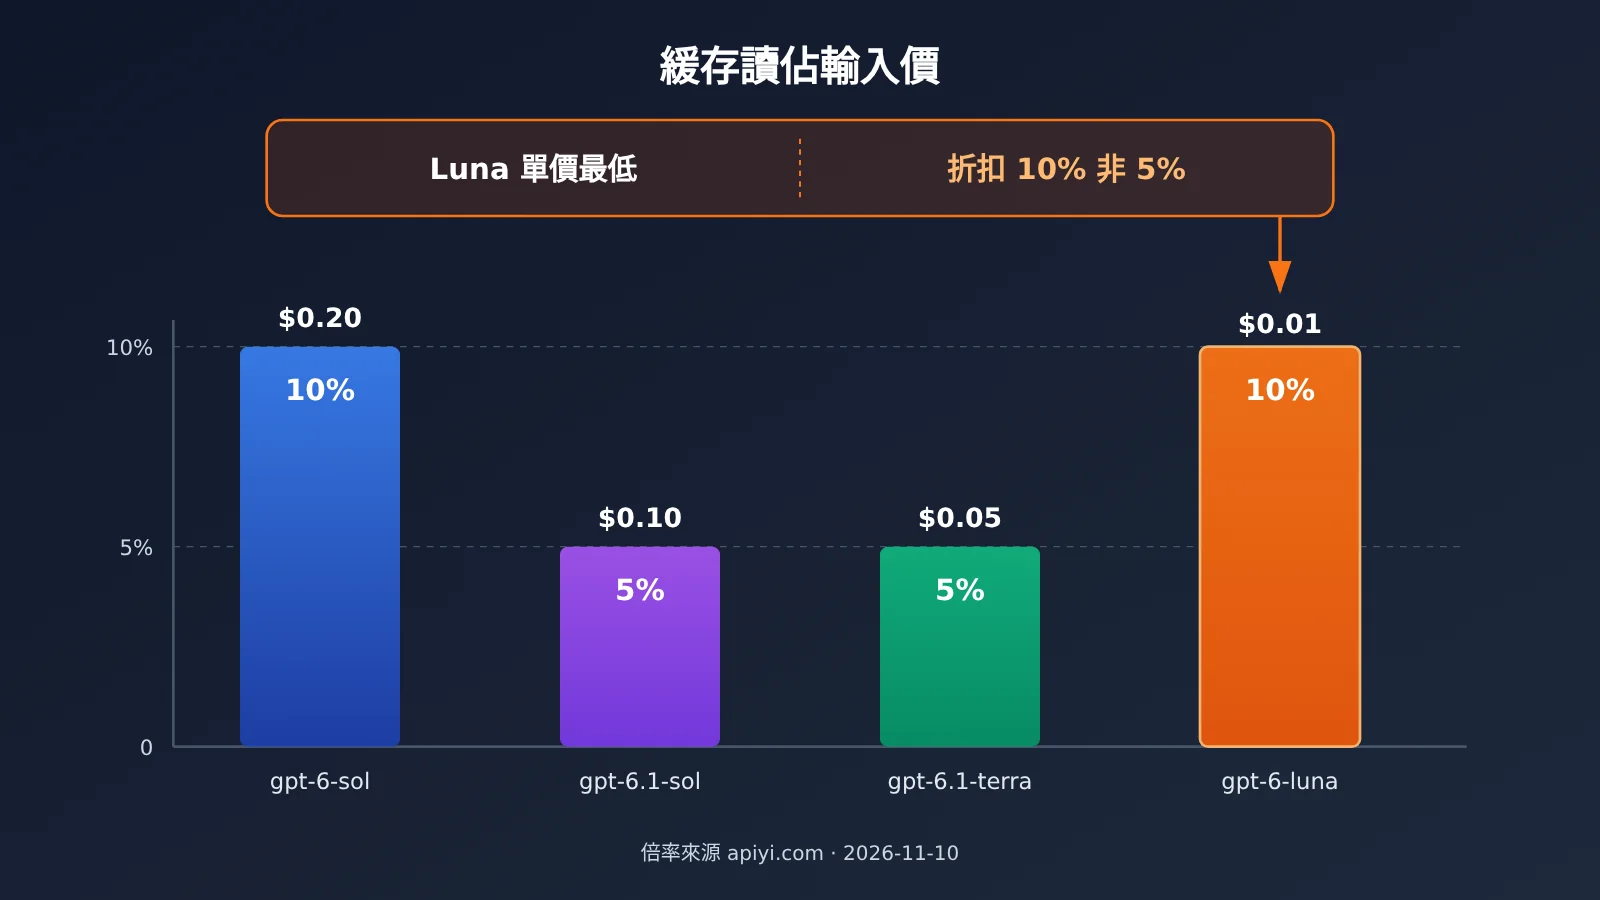
很多開發者同時在用幾個型號,容易產生一個直覺:既然 6.1 的 Sol 緩存讀是 5%,那其他型號是不是也一樣。實際上緩存讀倍率是按型號分別定的,不能簡單類推。下面是同一天官方價與平臺倍率的對照:
| 模型 ID | 輸入價 | 輸出價 | 緩存讀價 | cache_ratio | 可用平臺 |
|---|---|---|---|---|---|
gpt-6-sol |
$2 | $10 | $0.20 | 0.1 | API易 apiyi.com、OpenAI 官方 |
gpt-6.1-sol |
$2 | $10 | $0.10 | 0.05 | API易 apiyi.com、OpenAI 官方 |
gpt-6.1-terra |
$1 | $5 | $0.05 | 0.05 | API易、OpenAI 官方 |
gpt-6-luna |
$0.10 | $0.50 | $0.01 | 0.1 | API易、OpenAI 官方 |
對比解讀
Terra 對標分析:gpt-6.1-terra 的緩存讀同樣是輸入價的 5%,絕對單價也更低。但本文討論的是“同一檔 Sol 該用哪個 ID”,Terra 是另一個能力檔位,是否從 Sol 降到 Terra 屬於選型問題,不在這次改動範圍內。
Luna 對標分析:gpt-6-luna 在絕對單價上最便宜,緩存讀只有 $0.01。但它的緩存摺扣是輸入價的 10%,不是 5%。所以“Sol 換成 6.1 就省一半緩存”這個結論只適用於 Sol 這一檔,不要套到 Luna 上去推算預算。
💡 選擇建議:如果你的任務需要 Sol 檔位的能力,直接把舊 ID 換成
gpt-6.1-sol是收益最確定、風險最小的一步。如果你在考慮跨檔位降本,建議在 API易 上用同一個 Key 分別調用不同型號做對照,再結合緩存倍率估算實際成本。
常見問題 FAQ
Q1:gpt-6-sol 和 gpt-6.1-sol 的價格區別到底在哪?
只在緩存讀。兩者輸入都是每百萬 token $2,輸出都是 $10;緩存讀 `gpt-6-sol` 是 $0.20,`gpt-6.1-sol` 是 $0.10,即輸入價的 10% 和 5%。數據時間 2026-11-10,官方價與平臺倍率一致。
Q2:換成 gpt-6.1-sol 需要重新購買套餐或新開賬號嗎?
不需要。兩個模型 ID 都在 API易 的型號列表裏,同一個 API Key 即可調用。改的只是請求裏的 `model` 字段,客戶端的 base_url 和鑑權方式都不變。
Q3:API易 的倍率怎麼換算成美元價格?
按“倍率 1 = 輸入 $2 / 百萬 token”的口徑:model_ratio 爲 1 即輸入 $2;completion_ratio 爲 5 即輸出 $10;cache_ratio 爲 0.05 即緩存讀 $0.10。實際結算還與賬戶分組有關,以 API易 apiyi.com 型號列表顯示爲準。
Q4:哪些場景切換到 gpt-6.1-sol 收益最明顯?
主要是緩存命中率高的長上下文場景:
– **多輪 Agent**:每輪重複攜帶系統提示、工具定義和歷史消息。
– **代碼助手**:反覆發送同一批倉庫文件作爲上下文。
– **知識庫問答**:固定的長文檔前綴加上變化的用戶問題。
Q5:Luna 和 Terra 也能按“緩存讀減半”來估算嗎?
不能這樣類推。`gpt-6.1-terra` 的緩存讀是輸入價的 5%,`gpt-6-luna` 是 10%。Luna 絕對單價最低,但緩存摺扣比例並不是 5%,估算預算時請按各自的 cache_ratio 分別計算。
Q6:換了 ID 但賬單沒明顯下降,可能是什麼原因?
最常見的是緩存命中率低,比如請求前綴裏放了時間戳或隨機字段,導致每次都按完整輸入計費。其次是部分服務仍在調用舊 ID。建議檢查返回 usage 中的緩存 token 字段,並在 API易 控制檯按模型查看調用明細。
Q7:切換後輸出質量會有變化嗎?
兩者是同一能力檔位的不同版本,但不同版本在具體任務上的表現可能有差異。穩妥的做法是先在小流量或測試集上對比,確認輸出符合業務要求後再全量切換。
gpt-6.1-sol 緩存讀價格核心要點 Key Takeaways
- 同價不同緩存:兩檔 Sol 輸入 $2、輸出 $10 相同,緩存讀差一倍。
- 緩存讀具體數字:
gpt-6-sol$0.20,gpt-6.1-sol$0.10,每百萬 token。 - 長會話最受益:緩存命中越多,切換到
gpt-6.1-sol省得越多。 - 改動只有一處:只改請求裏的
model字段,無需新套餐。 - 不要類推到 Luna:Luna 緩存讀是輸入價 10%,不是 5%。
- 上手方式:用 API易 同一個 Key 小流量驗證後再全量替換。
總結
把 gpt-6-sol 換成 gpt-6.1-sol 的核心要點:
- 價格結構:輸入輸出完全同價,緩存讀從輸入價的 10% 降到 5%,數據時間 2026-11-10。
- 改動範圍:兩個 ID 都在平臺列表中,只需替換請求裏的模型名,base_url 與 Key 不變。
- 適用邊界:“緩存讀減半”只針對 Sol 這一檔,Terra 與 Luna 要按各自的緩存倍率單獨計算。
如果你的長會話服務還在調舊 ID,這是一次幾乎沒有成本的優化。建議先在 API易 apiyi.com 覈對型號列表與倍率,再按本文 3 步完成切換。型號與價格以平臺型號列表爲準。
📚 參考資料
- OpenAI 官方價目:標準檔模型輸入、輸出、緩存輸入價格
- 鏈接:
developers.openai.com/api/docs/pricing -
說明:覈對
gpt-6-sol、gpt-6.1-sol、gpt-6.1-terra、gpt-6-luna的官方單價 -
API易 價目接口:平臺模型倍率數據
- 鏈接:
api.apiyi.com/api/pricing - 說明:查看 model_ratio、completion_ratio、cache_ratio 三項倍率
作者:APIYI 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心