作者注:gpt-6-sol 与 gpt-6.1-sol 输入输出同价,缓存读倍率相差一倍。本文说明如何只改请求里的 model 字段,把长会话的缓存成本降下来。
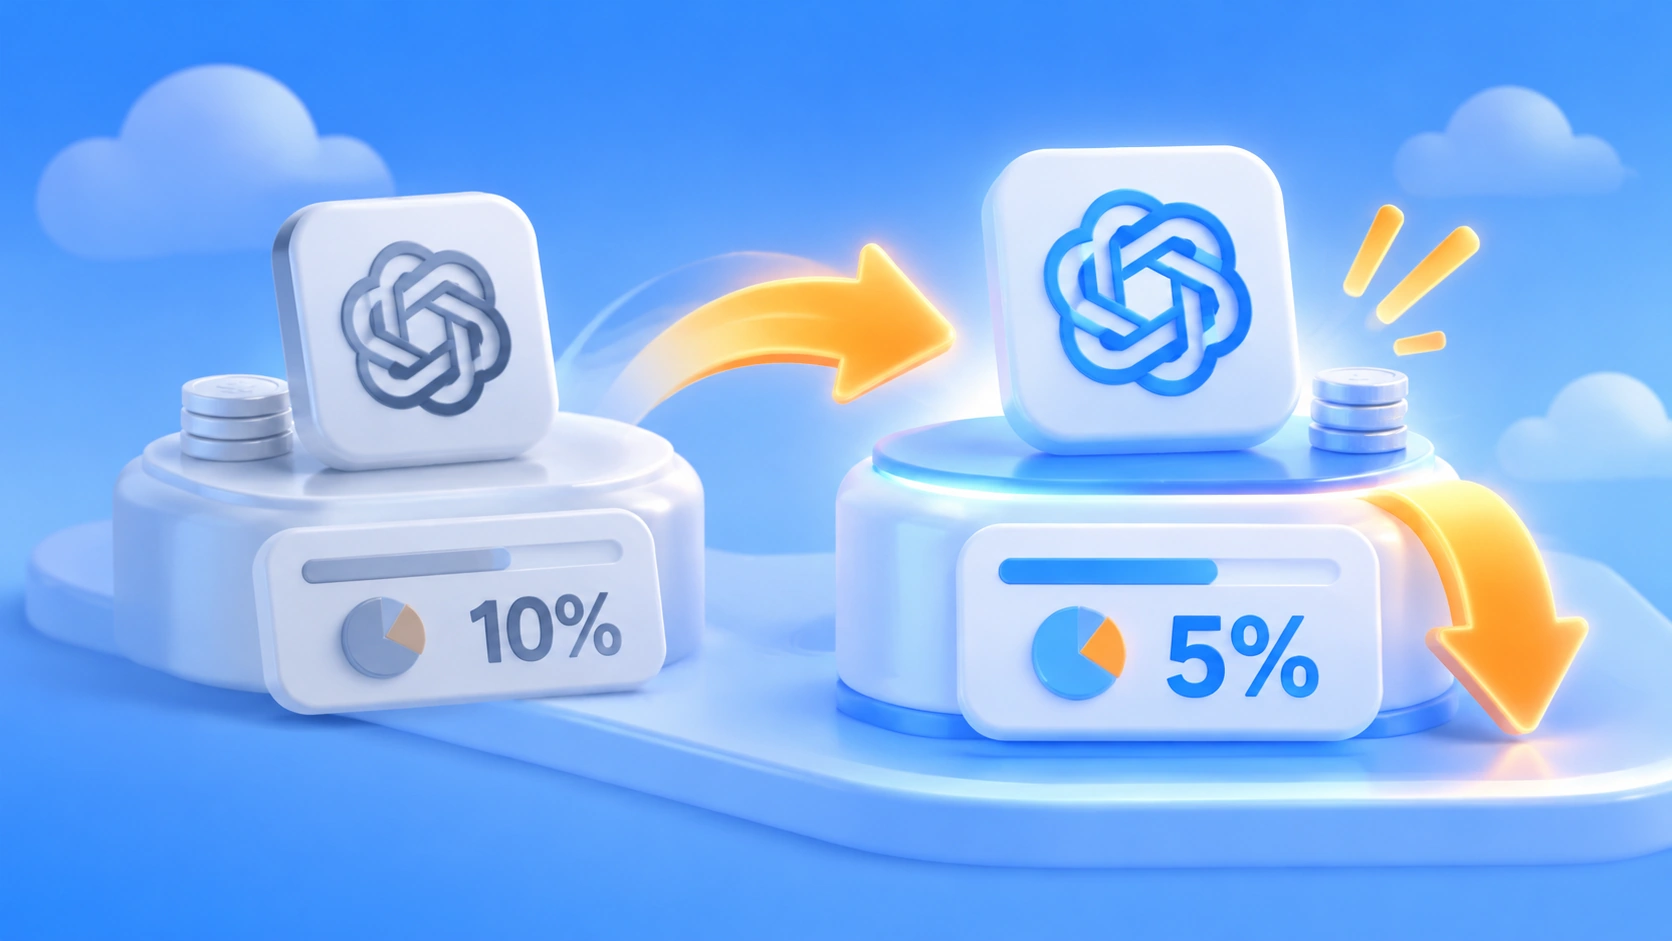
很多开发者日常已经在用 6.1 Sol、6.1 Terra、6 Luna,但翻开项目配置,会发现某个老服务的请求里还写着 gpt-6-sol。本文介绍一个改动很小的做法:把 gpt-6-sol 换成 gpt-6.1-sol,输入输出单价不变,缓存读从输入价的 10% 降到 5%。
这不是促销,也不是要你换套餐。两档 Sol 的价格差异直接写在 OpenAI 官方价目里,API易 平台列表的倍率与官方一致。要改的只是请求里的一个字符串。
核心价值:读完本文,你会知道哪一个模型 ID 该改、改完缓存读能省多少,以及为什么这个“缓存读减半”的结论不能套到 Terra、Luna 以外的推断上,尤其不能套到 Luna 上。
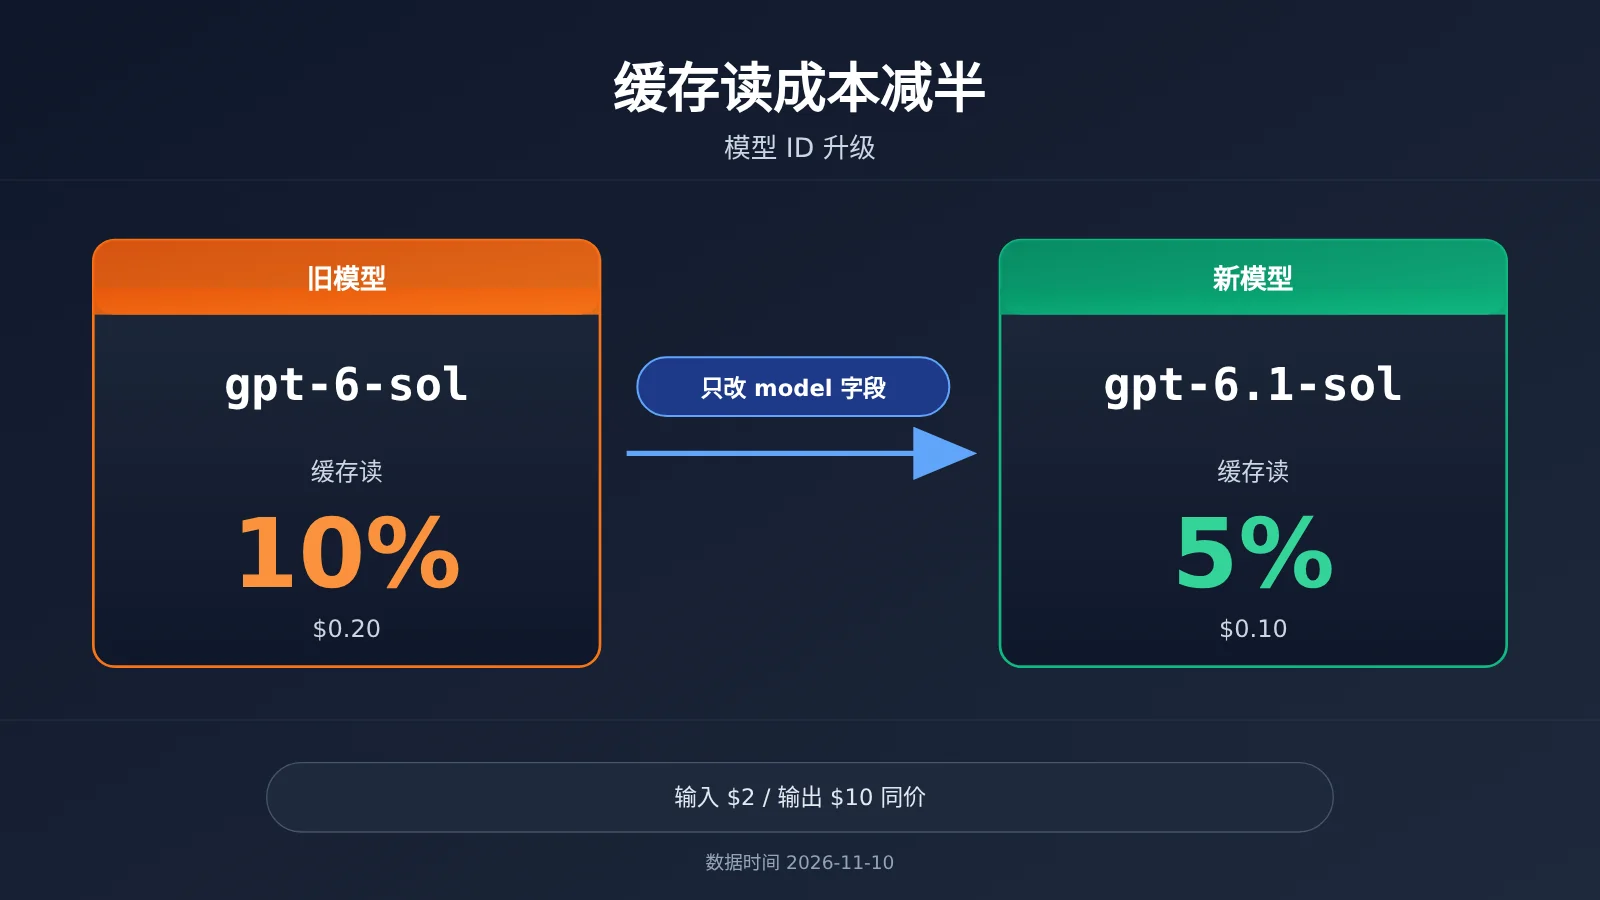
gpt-6-sol 与 gpt-6.1-sol 价格核心要点
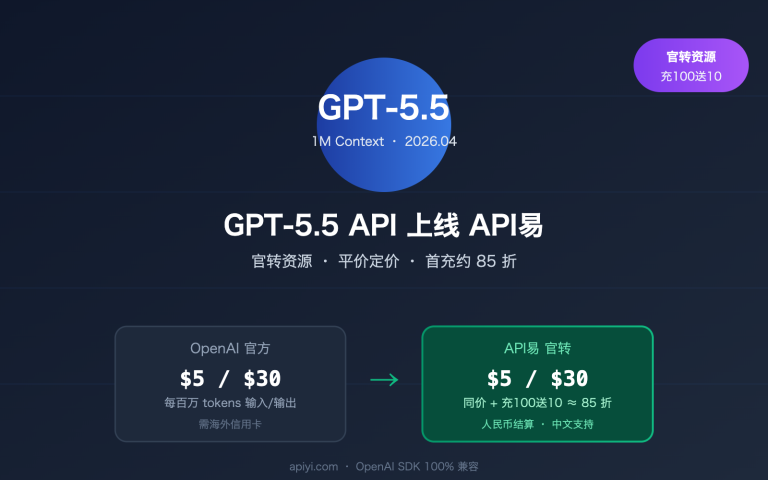
先看最关键的一张表。以下价格均为每百万 token,数据时间 2026-11-10,来源是 OpenAI 官方价目的标准档,并与 API易 价目接口返回的倍率核对一致。
| 模型 ID | 输入价 | 输出价 | 缓存读价 | 缓存读占输入价 |
|---|---|---|---|---|
gpt-6-sol |
$2 | $10 | $0.20 | 10% |
gpt-6.1-sol |
$2 | $10 | $0.10 | 5% |
这张表说明了一件事:两档 Sol 在输入和输出上没有任何价差,唯一的区别在缓存读。对于单轮短请求,这个差别几乎感知不到;但对于会反复带上长系统提示、长工具定义、长对话历史的场景,缓存读 token 往往占请求输入的大头,差一倍的倍率会持续累积。
gpt-6.1-sol 缓存读为什么值得单独关注
Prompt Cache 的作用是:当请求前缀与之前的请求相同时,这部分 token 按缓存读价格计费,而不是按完整输入价计费。Agent、代码助手、客服机器人这类应用,每一轮都会把同样的系统提示和历史消息再发一遍,命中缓存的比例通常很高。
在这种工作负载下,缓存读单价对账单的影响往往比输入单价更直接。gpt-6-sol 的缓存读是 $0.20,gpt-6.1-sol 是 $0.10,同样的缓存命中量,前者要付两倍。如果你的服务还停留在旧 ID 上,并且又是长会话,就等于一直在为同样的上下文多付一份钱。
平台倍率与官方价如何对应
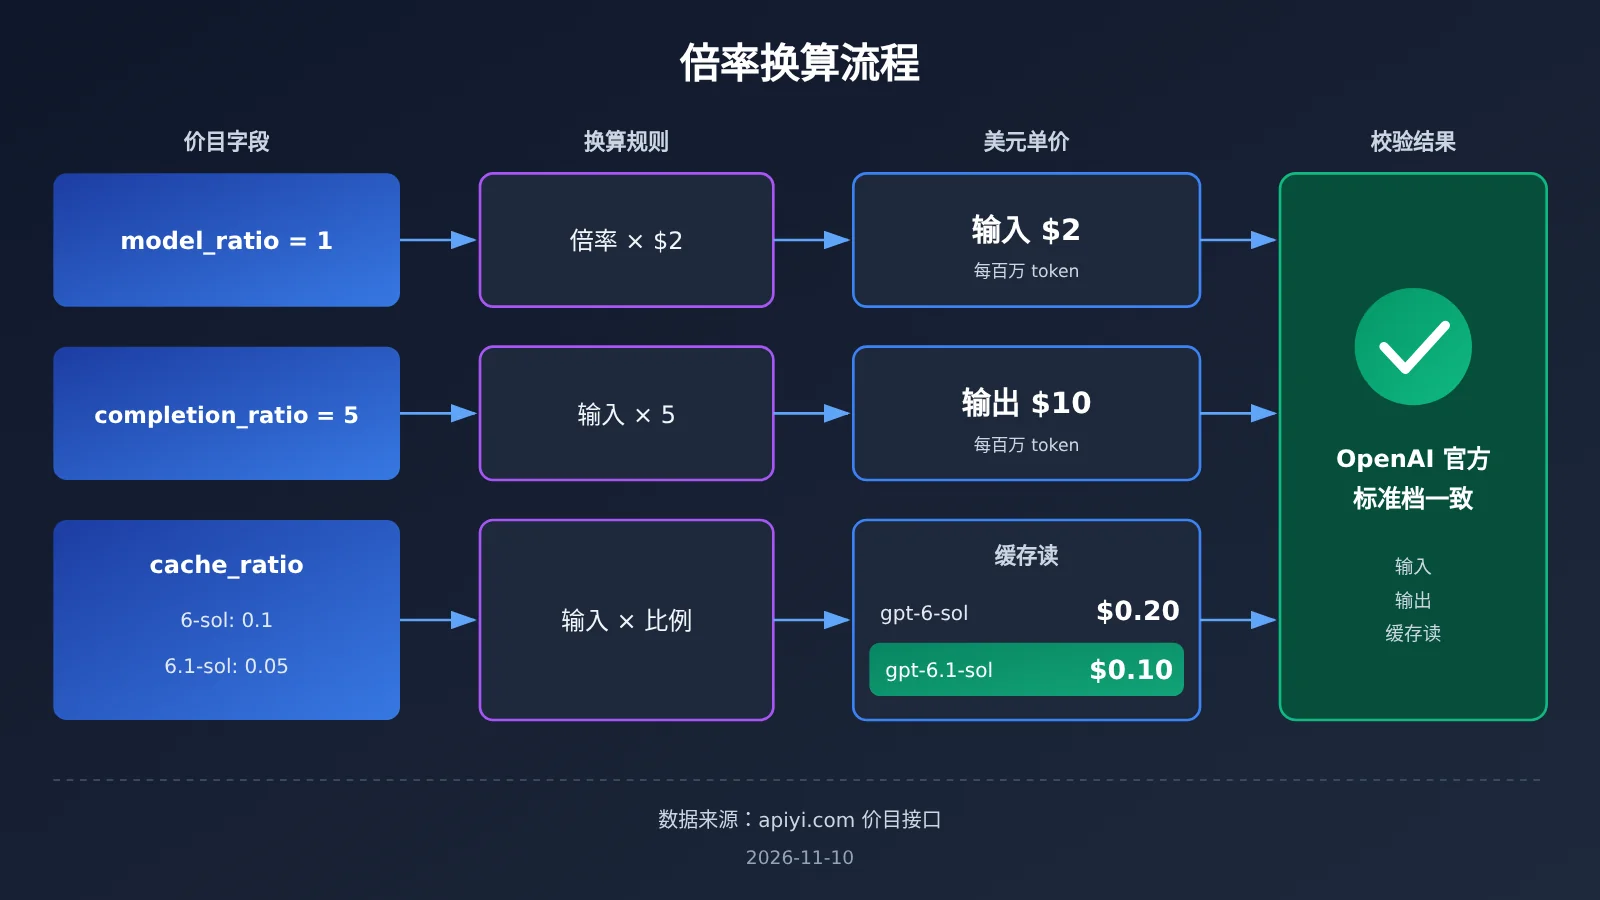
API易 的价目接口用倍率表达价格。2026-11-10 返回的数据里,两档 Sol 都在列表中,倍率如下:
| 字段 | gpt-6-sol |
gpt-6.1-sol |
含义 |
|---|---|---|---|
| model_ratio | 1 | 1 | 倍率 1 对应输入 $2 / 百万 token |
| completion_ratio | 5 | 5 | 输出为输入的 5 倍,即 $10 |
| cache_ratio | 0.1 | 0.05 | 缓存读为输入的 10% / 5% |
按“倍率 1 = 输入 $2 / 百万 token”的口径换算,两者都是输入 $2、输出 $10,缓存读分别是 $0.20 和 $0.10,与官方价目完全对得上。需要说明的是,这里只换算模型本身的倍率,不涉及任何分组倍率,具体结算请以你账户所在分组和平台型号列表为准。查价时可以直接访问 API易 apiyi.com 的模型价格页面核对这三个倍率。
gpt-6.1-sol 长会话缓存成本怎么算
只看单价不够直观,下面用一个纯算术的例子说明差距。假设某个 Agent 会话共 100 轮,每轮请求中命中缓存的前缀约 5 万 token,那么整个会话累计缓存读 token 为 500 万。
| 计算项 | gpt-6-sol |
gpt-6.1-sol |
|---|---|---|
| 累计缓存读 token | 500 万 | 500 万 |
| 缓存读单价(每百万) | $0.20 | $0.10 |
| 缓存读费用 | $1.00 | $0.50 |
| 输入、输出部分 | 单价相同 | 单价相同 |
这只是一个会话的数字。如果同类会话每天有上千个,缓存读这一项就是稳定的一半差额。由于输入和输出单价完全相同,换成 gpt-6.1-sol 后其他部分的成本不会上升,节省下来的就是缓存读那一半。
当然,这个例子的前提是缓存确实命中。如果你的请求前缀每次都变化,比如把时间戳、随机 ID 放在系统提示最前面,那么缓存命中率本身就很低,换模型 ID 带来的收益也会很有限。这种情况下,先把固定内容放到前缀、变化内容放到末尾,再考虑换 ID,效果会更明显。
如何把 gpt-6-sol 改成 gpt-6.1-sol 快速上手
改动的范围非常小:两个模型 ID 今天都在 API易 的型号列表里,同一个 API Key 可以直接调用,不需要再开通或购买新的套餐。你要改的只是请求体里的 model 字段。
极简改法:3 步完成切换
- 定位旧 ID:在代码仓库和配置中心里全局搜索
gpt-6-sol,注意不要误伤gpt-6.1-sol这类已经是新 ID 的字符串,搜索时可以精确匹配引号内的完整值。 - 替换 model 字段:把
model="gpt-6-sol"改为model="gpt-6.1-sol",客户端初始化保持不变,仍然是base_url="https://api.apiyi.com/v1"加上你原有的 API Key。 - 小流量验证:先在一部分请求上切换,观察返回的 usage 中缓存 token 字段,确认缓存命中正常,再全量替换。
以 OpenAI 官方 Python SDK 为例,客户端写法是 client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1"),调用时把 client.chat.completions.create(model="gpt-6.1-sol", messages=messages) 中的 model 换掉即可,messages 和其他参数都不用动。
推荐的配置化写法
如果你的项目里有多处直接写死模型名,建议借这次切换顺手做一次配置化。把模型 ID 抽到环境变量里,例如 OPENAI_MODEL=gpt-6.1-sol,代码中通过 os.getenv("OPENAI_MODEL", "gpt-6.1-sol") 读取。这样以后再有新版本,只需要改一处配置,而不是在仓库里逐个搜索替换。
客户端部分同样建议从环境变量读取,例如 OPENAI_BASE_URL=https://api.apiyi.com/v1。OpenAI 兼容接口意味着 SDK、LangChain、各类 Agent 框架都可以沿用原有的接入方式,只需确认 base_url 和 model 两个值。
🚀 快速开始:改 ID 之前,可以先到 API易 apiyi.com 的型号列表确认
gpt-6.1-sol在你账户可用的分组里。确认之后,切换就只是请求里model字段的一个字符串变化,新用户还可以用免费测试额度先跑一轮小流量验证。
切换时容易踩的几个坑
- 只改了一部分服务:主服务换了,但定时任务、离线批处理脚本里还是旧 ID,账单上会看到两种模型同时出现。
- 网关有模型白名单:如果你的内部网关或代理层对模型名做了白名单校验,要先把
gpt-6.1-sol加进去。 - 日志与监控按模型名聚合:看板若按模型名统计成本,切换后要把新旧 ID 合并观察,否则会误以为调用量下降。
gpt-6.1-sol 与 Terra、Luna 缓存折扣对比
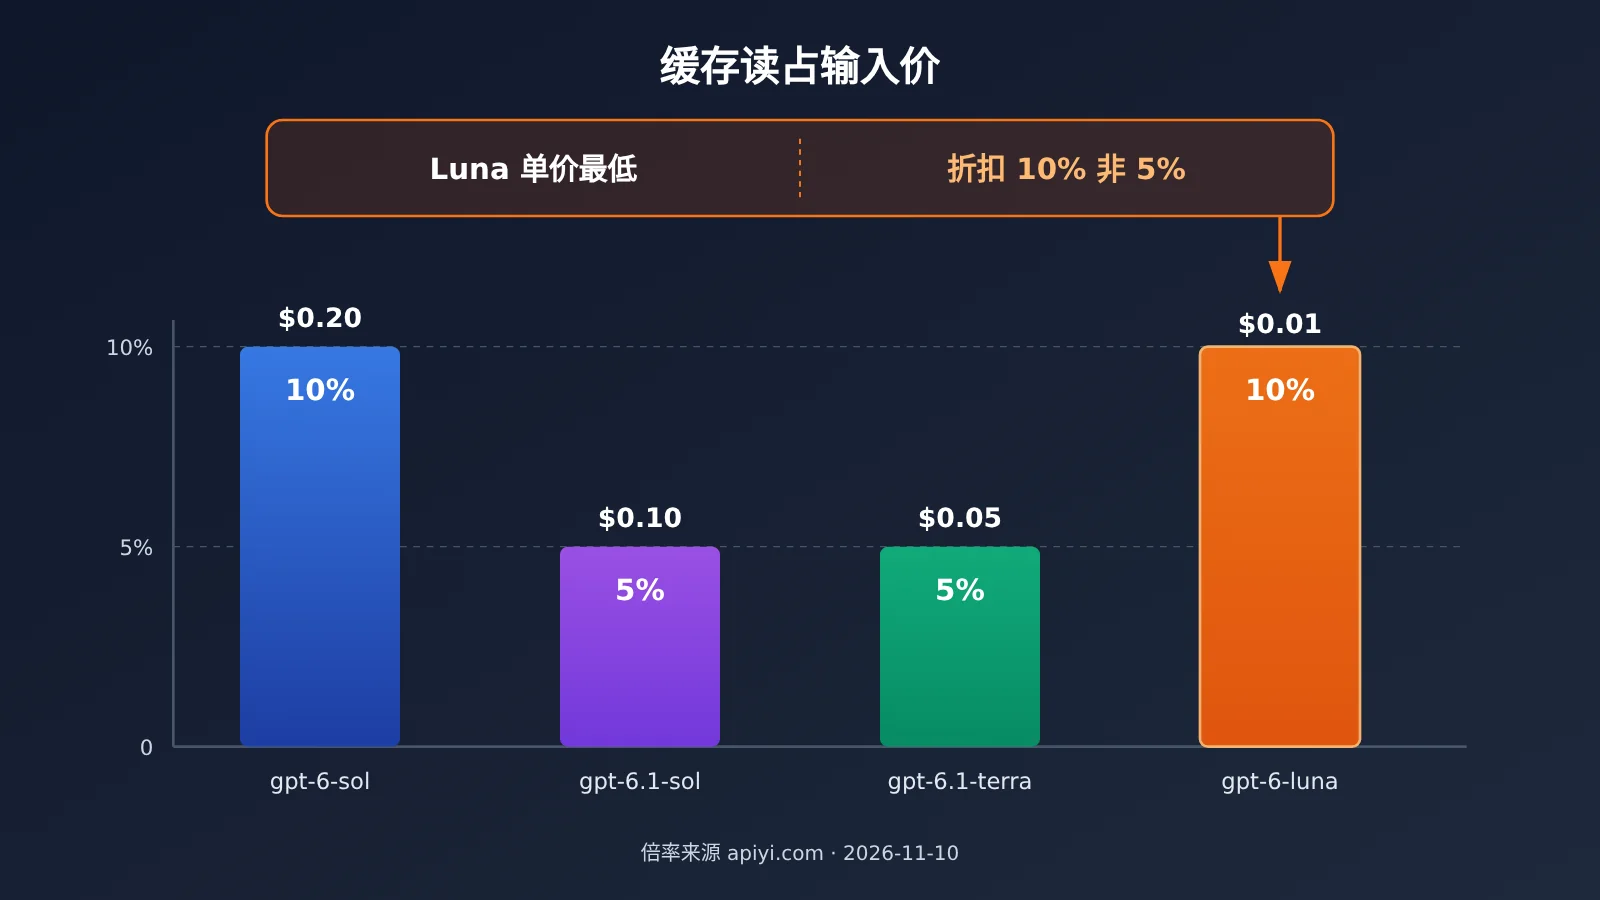
很多开发者同时在用几个型号,容易产生一个直觉:既然 6.1 的 Sol 缓存读是 5%,那其他型号是不是也一样。实际上缓存读倍率是按型号分别定的,不能简单类推。下面是同一天官方价与平台倍率的对照:
| 模型 ID | 输入价 | 输出价 | 缓存读价 | cache_ratio | 可用平台 |
|---|---|---|---|---|---|
gpt-6-sol |
$2 | $10 | $0.20 | 0.1 | API易 apiyi.com、OpenAI 官方 |
gpt-6.1-sol |
$2 | $10 | $0.10 | 0.05 | API易 apiyi.com、OpenAI 官方 |
gpt-6.1-terra |
$1 | $5 | $0.05 | 0.05 | API易、OpenAI 官方 |
gpt-6-luna |
$0.10 | $0.50 | $0.01 | 0.1 | API易、OpenAI 官方 |
对比解读
Terra 对标分析:gpt-6.1-terra 的缓存读同样是输入价的 5%,绝对单价也更低。但本文讨论的是“同一档 Sol 该用哪个 ID”,Terra 是另一个能力档位,是否从 Sol 降到 Terra 属于选型问题,不在这次改动范围内。
Luna 对标分析:gpt-6-luna 在绝对单价上最便宜,缓存读只有 $0.01。但它的缓存折扣是输入价的 10%,不是 5%。所以“Sol 换成 6.1 就省一半缓存”这个结论只适用于 Sol 这一档,不要套到 Luna 上去推算预算。
💡 选择建议:如果你的任务需要 Sol 档位的能力,直接把旧 ID 换成
gpt-6.1-sol是收益最确定、风险最小的一步。如果你在考虑跨档位降本,建议在 API易 上用同一个 Key 分别调用不同型号做对照,再结合缓存倍率估算实际成本。
常见问题 FAQ
Q1:gpt-6-sol 和 gpt-6.1-sol 的价格区别到底在哪?
只在缓存读。两者输入都是每百万 token $2,输出都是 $10;缓存读 `gpt-6-sol` 是 $0.20,`gpt-6.1-sol` 是 $0.10,即输入价的 10% 和 5%。数据时间 2026-11-10,官方价与平台倍率一致。
Q2:换成 gpt-6.1-sol 需要重新购买套餐或新开账号吗?
不需要。两个模型 ID 都在 API易 的型号列表里,同一个 API Key 即可调用。改的只是请求里的 `model` 字段,客户端的 base_url 和鉴权方式都不变。
Q3:API易 的倍率怎么换算成美元价格?
按“倍率 1 = 输入 $2 / 百万 token”的口径:model_ratio 为 1 即输入 $2;completion_ratio 为 5 即输出 $10;cache_ratio 为 0.05 即缓存读 $0.10。实际结算还与账户分组有关,以 API易 apiyi.com 型号列表显示为准。
Q4:哪些场景切换到 gpt-6.1-sol 收益最明显?
主要是缓存命中率高的长上下文场景:
– **多轮 Agent**:每轮重复携带系统提示、工具定义和历史消息。
– **代码助手**:反复发送同一批仓库文件作为上下文。
– **知识库问答**:固定的长文档前缀加上变化的用户问题。
Q5:Luna 和 Terra 也能按“缓存读减半”来估算吗?
不能这样类推。`gpt-6.1-terra` 的缓存读是输入价的 5%,`gpt-6-luna` 是 10%。Luna 绝对单价最低,但缓存折扣比例并不是 5%,估算预算时请按各自的 cache_ratio 分别计算。
Q6:换了 ID 但账单没明显下降,可能是什么原因?
最常见的是缓存命中率低,比如请求前缀里放了时间戳或随机字段,导致每次都按完整输入计费。其次是部分服务仍在调用旧 ID。建议检查返回 usage 中的缓存 token 字段,并在 API易 控制台按模型查看调用明细。
Q7:切换后输出质量会有变化吗?
两者是同一能力档位的不同版本,但不同版本在具体任务上的表现可能有差异。稳妥的做法是先在小流量或测试集上对比,确认输出符合业务要求后再全量切换。
gpt-6.1-sol 缓存读价格核心要点 Key Takeaways
- 同价不同缓存:两档 Sol 输入 $2、输出 $10 相同,缓存读差一倍。
- 缓存读具体数字:
gpt-6-sol$0.20,gpt-6.1-sol$0.10,每百万 token。 - 长会话最受益:缓存命中越多,切换到
gpt-6.1-sol省得越多。 - 改动只有一处:只改请求里的
model字段,无需新套餐。 - 不要类推到 Luna:Luna 缓存读是输入价 10%,不是 5%。
- 上手方式:用 API易 同一个 Key 小流量验证后再全量替换。
总结
把 gpt-6-sol 换成 gpt-6.1-sol 的核心要点:
- 价格结构:输入输出完全同价,缓存读从输入价的 10% 降到 5%,数据时间 2026-11-10。
- 改动范围:两个 ID 都在平台列表中,只需替换请求里的模型名,base_url 与 Key 不变。
- 适用边界:“缓存读减半”只针对 Sol 这一档,Terra 与 Luna 要按各自的缓存倍率单独计算。
如果你的长会话服务还在调旧 ID,这是一次几乎没有成本的优化。建议先在 API易 apiyi.com 核对型号列表与倍率,再按本文 3 步完成切换。型号与价格以平台型号列表为准。
📚 参考资料
- OpenAI 官方价目:标准档模型输入、输出、缓存输入价格
- 链接:
developers.openai.com/api/docs/pricing -
说明:核对
gpt-6-sol、gpt-6.1-sol、gpt-6.1-terra、gpt-6-luna的官方单价 -
API易 价目接口:平台模型倍率数据
- 链接:
api.apiyi.com/api/pricing - 说明:查看 model_ratio、completion_ratio、cache_ratio 三项倍率
作者:APIYI 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心