Note de l’auteur : gpt-6-sol et gpt-6.1-sol ont le même prix pour les entrées et les sorties, mais le tarif de lecture du cache est divisé par deux. Cet article explique comment réduire le coût du cache dans les longues conversations en modifiant uniquement le champ model de la requête.
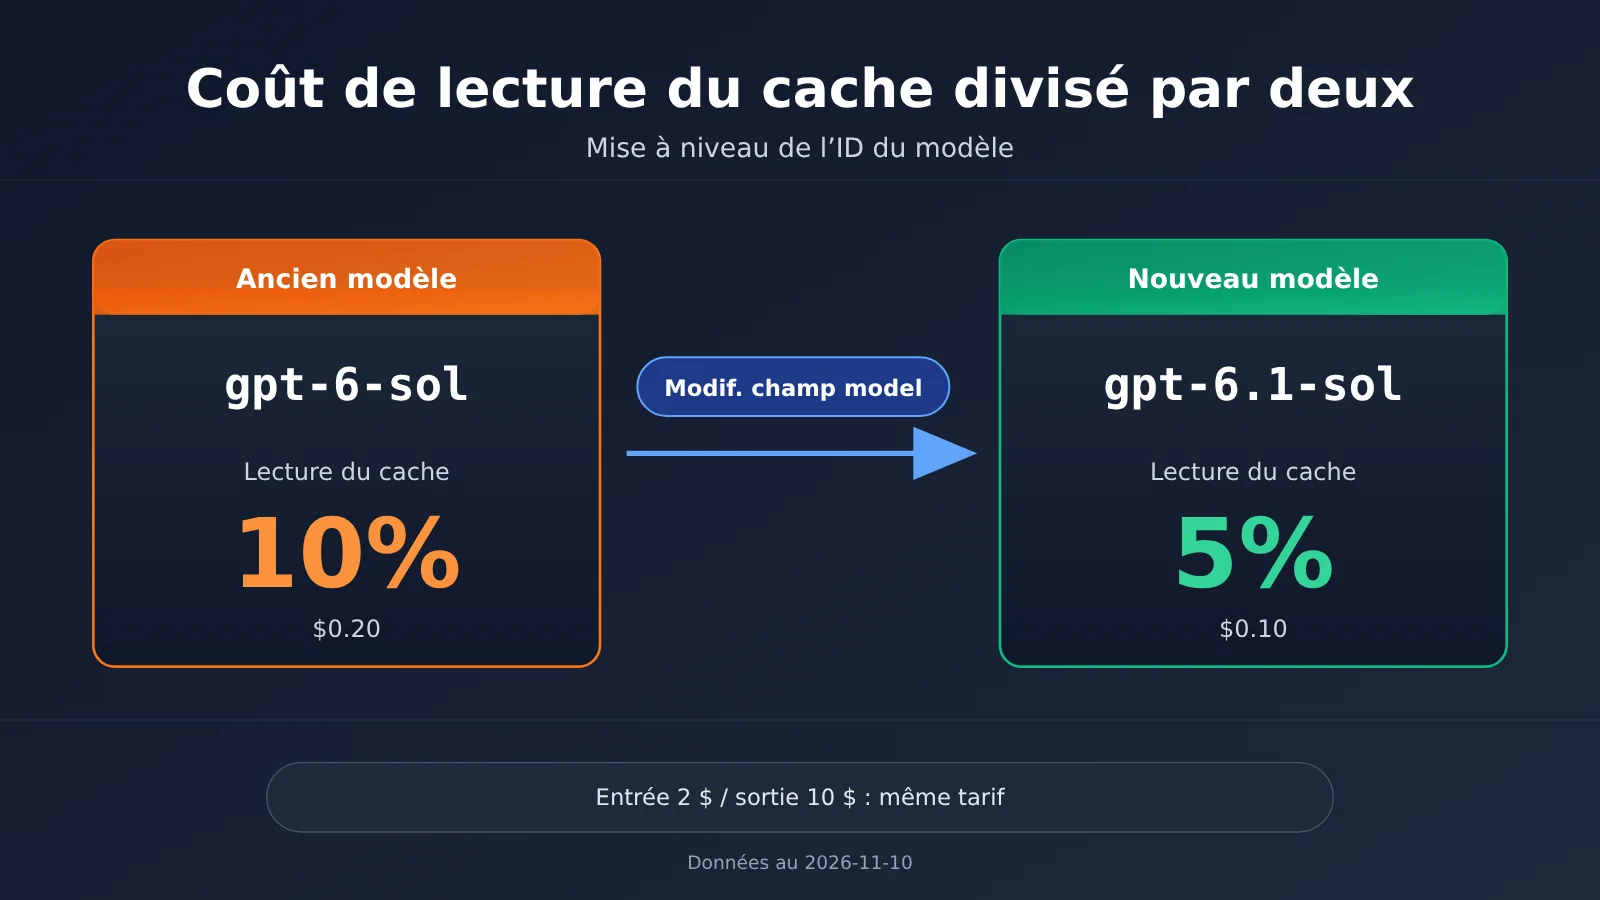
Beaucoup de développeurs utilisent déjà 6.1 Sol, 6.1 Terra ou 6 Luna au quotidien. Pourtant, en consultant la configuration de leurs projets, ils découvrent parfois qu’un ancien service envoie encore des requêtes avec gpt-6-sol. Voici une modification toute simple : remplacer gpt-6-sol par gpt-6.1-sol : le prix unitaire des entrées et des sorties reste le même, tandis que la lecture du cache passe de 10 % à 5 % du prix des entrées.
Il ne s’agit ni d’une promotion ni d’un changement d’offre. La différence de prix entre les deux modèles Sol figure directement dans la grille tarifaire officielle d’OpenAI, et les tarifs affichés sur la plateforme APIYI correspondent aux tarifs officiels. Il suffit de modifier une chaîne de caractères dans la requête.
L’essentiel : après avoir lu cet article, vous saurez quel ID de modèle modifier, combien la lecture du cache vous fera économiser et pourquoi cette baisse de moitié ne peut pas être extrapolée à d’autres modèles que Terra et Luna — et surtout pas à Luna.
Points clés sur les tarifs de gpt-6-sol et gpt-6.1-sol
Commençons par le tableau le plus important. Les tarifs ci-dessous sont indiqués par million de tokens. Les données datent du 10 novembre 2026 et proviennent de la grille tarifaire officielle d’OpenAI pour l’offre standard. Elles concordent avec les coefficients renvoyés par l’API de tarification d’APIYI.
| ID du modèle | Tarif d’entrée | Tarif de sortie | Tarif de lecture du cache | Lecture du cache en % du tarif d’entrée |
|---|---|---|---|---|
gpt-6-sol |
$2 | $10 | $0.20 | 10% |
gpt-6.1-sol |
$2 | $10 | $0.10 | 5% |
Ce tableau met en évidence un point important : les tarifs d’entrée et de sortie sont identiques pour les deux modèles Sol. La seule différence concerne la lecture du cache. Pour une requête courte à un seul tour, l’écart est presque imperceptible. En revanche, dans les scénarios où de longues invites système, des définitions d’outils détaillées et un historique de conversation conséquent sont régulièrement réutilisés, les tokens lus depuis le cache représentent souvent une grande partie des entrées. Un coefficient deux fois plus élevé finit alors par peser sur la facture.
Pourquoi le tarif de lecture du cache de gpt-6.1-sol mérite une attention particulière
Le cache de prompt permet de facturer les tokens d’un préfixe identique à celui d’une requête précédente au tarif de lecture du cache, plutôt qu’au tarif d’entrée complet. Dans les applications comme les agents, les assistants de programmation et les robots du service client, les mêmes invites système et les mêmes messages d’historique sont renvoyés à chaque tour. Le taux de succès du cache est donc souvent élevé.
Dans ce type de charge de travail, le tarif unitaire de lecture du cache a souvent un effet plus direct sur la facture que le tarif d’entrée. La lecture du cache coûte $0.20 avec gpt-6-sol et $0.10 avec gpt-6.1-sol : à volume de cache identique, le premier revient deux fois plus cher. Si votre service utilise encore l’ancien ID pour de longues conversations, vous payez en continu un supplément pour le même contexte.
Correspondance entre les coefficients de la plateforme et les tarifs officiels
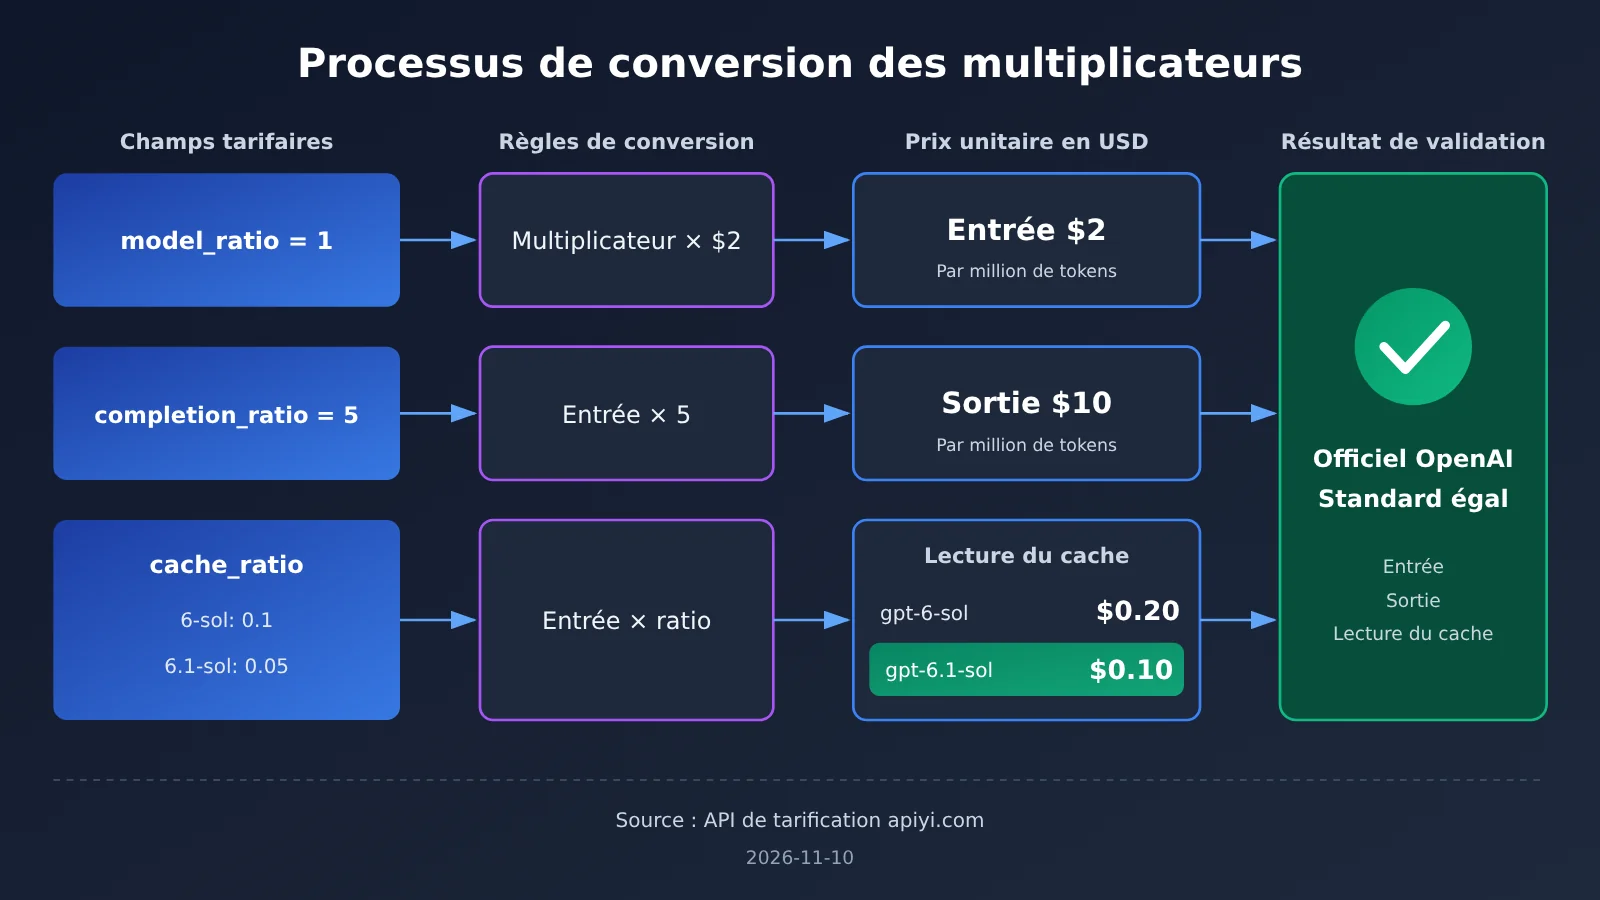
L’interface de tarification d’APIYI exprime les prix sous forme de coefficients. Les données renvoyées le 10 novembre 2026 incluent les deux modèles Sol, avec les coefficients suivants :
| Champ | gpt-6-sol |
gpt-6.1-sol |
Signification |
|---|---|---|---|
| model_ratio | 1 | 1 | Un coefficient de 1 correspond à un tarif d’entrée de $2 par million de tokens |
| completion_ratio | 5 | 5 | La sortie coûte 5 fois le tarif d’entrée, soit $10 |
| cache_ratio | 0.1 | 0.05 | La lecture du cache coûte 10 % / 5 % du tarif d’entrée |
En prenant comme référence « coefficient 1 = $2 par million de tokens en entrée », les tarifs des deux modèles sont de $2 en entrée et de $10 en sortie. La lecture du cache revient respectivement à $0.20 et $0.10, ce qui correspond exactement à la grille tarifaire officielle. À noter que cette conversion porte uniquement sur les coefficients du modèle lui-même, et non sur les coefficients de groupe. Pour connaître le montant exact facturé, consultez le groupe associé à votre compte et la liste des modèles de la plateforme. Vous pouvez vérifier ces trois coefficients directement sur la page des tarifs des modèles d’APIYI, à l’adresse apiyi.com.
Comment calculer le coût du cache pour une longue conversation avec gpt-6.1-sol
Les tarifs unitaires ne suffisent pas toujours à se faire une idée. Voici un exemple de calcul simple pour mieux visualiser l’écart. Supposons qu’une session d’agent comporte 100 tours et que chaque requête réutilise environ 50 000 jetons du préfixe mis en cache. Au total, la session génère donc 5 millions de jetons lus depuis le cache.
| Poste de calcul | gpt-6-sol |
gpt-6.1-sol |
|---|---|---|
| Total de jetons lus depuis le cache | 5 millions | 5 millions |
| Tarif de lecture du cache (par million) | $0.20 | $0.10 |
| Coût de lecture du cache | $1.00 | $0.50 |
| Entrée et sortie | Même tarif | Même tarif |
Ces chiffres ne concernent qu’une seule session. Si vous en avez des milliers du même type chaque jour, le coût de lecture du cache est systématiquement réduit de moitié. Comme les tarifs d’entrée et de sortie restent exactement les mêmes, passer à gpt-6.1-sol n’augmente pas le coût des autres postes : l’économie porte entièrement sur la lecture du cache.
Bien sûr, cet exemple suppose que le cache est effectivement utilisé. Si le préfixe de vos requêtes change à chaque fois — par exemple parce que vous placez un horodatage ou un identifiant aléatoire au début de l’invite système — le taux d’utilisation du cache sera très faible. Le gain obtenu en changeant d’identifiant de modèle sera alors limité. Dans ce cas, placez d’abord le contenu fixe au début du préfixe et le contenu variable à la fin, puis envisagez de changer d’identifiant : le résultat sera plus marqué.
Prise en main rapide : passer de gpt-6-sol à gpt-6.1-sol
Le changement est minime : les deux identifiants de modèle figurent aujourd’hui dans la liste des modèles d’APIYI. Vous pouvez utiliser la même clé API, sans souscrire ni acheter de nouvelle offre. Il suffit de modifier le champ model dans le corps de la requête.
Méthode express : 3 étapes
- Repérez l’ancien identifiant : recherchez
gpt-6-soldans tout votre dépôt de code et votre centre de configuration. Veillez à ne pas remplacer par erreur des chaînes contenant déjà le nouvel identifiant, commegpt-6.1-sol. Pour éviter cela, recherchez la valeur exacte entre guillemets. - Remplacez le champ model : remplacez
model="gpt-6-sol"parmodel="gpt-6.1-sol". L’initialisation du client ne change pas : conservezbase_url="https://api.apiyi.com/v1"et votre clé API actuelle. - Validez sur un petit volume : commencez par basculer une partie des requêtes. Vérifiez dans le champ
usagede la réponse que les tokens mis en cache sont bien pris en compte, puis effectuez le remplacement partout.
Avec le SDK Python officiel d’OpenAI, le client s’initialise ainsi : client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1"). Lors de l’appel, il suffit de modifier le champ model dans client.chat.completions.create(model="gpt-6.1-sol", messages=messages). Ne touchez pas à messages ni aux autres paramètres.
Une configuration plus facile à faire évoluer
Si le nom du modèle est écrit en dur à plusieurs endroits dans votre projet, profitez de cette migration pour le définir dans la configuration. Placez l’identifiant du modèle dans une variable d’environnement, par exemple OPENAI_MODEL=gpt-6.1-sol, puis récupérez-le dans le code avec os.getenv("OPENAI_MODEL", "gpt-6.1-sol"). Lorsqu’une nouvelle version sortira, vous n’aurez plus qu’à modifier la configuration au lieu de rechercher et remplacer l’identifiant dans tout le dépôt.
Vous pouvez aussi lire les paramètres du client depuis des variables d’environnement, par exemple OPENAI_BASE_URL=https://api.apiyi.com/v1. Comme l’interface est compatible avec OpenAI, vous pouvez conserver votre méthode d’intégration actuelle avec le SDK, LangChain ou les différents frameworks d’agents. Vérifiez simplement les valeurs de base_url et de model.
🚀 Pour commencer rapidement : avant de modifier l’identifiant, consultez la liste des modèles sur APIYI, à l’adresse apiyi.com, et vérifiez que
gpt-6.1-solest disponible dans un groupe auquel votre compte a accès. Une fois cette vérification faite, le changement se limite à modifier la chaîne du champmodeldans la requête. Les nouveaux utilisateurs peuvent aussi commencer par valider le modèle sur un petit volume grâce au crédit d’essai gratuit.
Quelques pièges à éviter lors de la migration
- Certains services n’ont pas été mis à jour : le service principal utilise le nouvel identifiant, mais les tâches planifiées ou les scripts de traitement par lots hors ligne utilisent encore l’ancien. Votre relevé de facturation affichera alors les deux modèles.
- La passerelle applique une liste blanche de modèles : si votre passerelle interne ou votre couche proxy vérifie les noms de modèles à l’aide d’une liste blanche, ajoutez-y
gpt-6.1-solavant la migration. - Les journaux et les tableaux de bord regroupent les données par nom de modèle : si les coûts sont ventilés par modèle, suivez ensemble les nouveaux et les anciens identifiants après le changement. Sinon, vous pourriez croire à tort que le volume d’appels a diminué.
Comparaison des remises sur la lecture du cache de gpt-6.1-sol, Terra et Luna
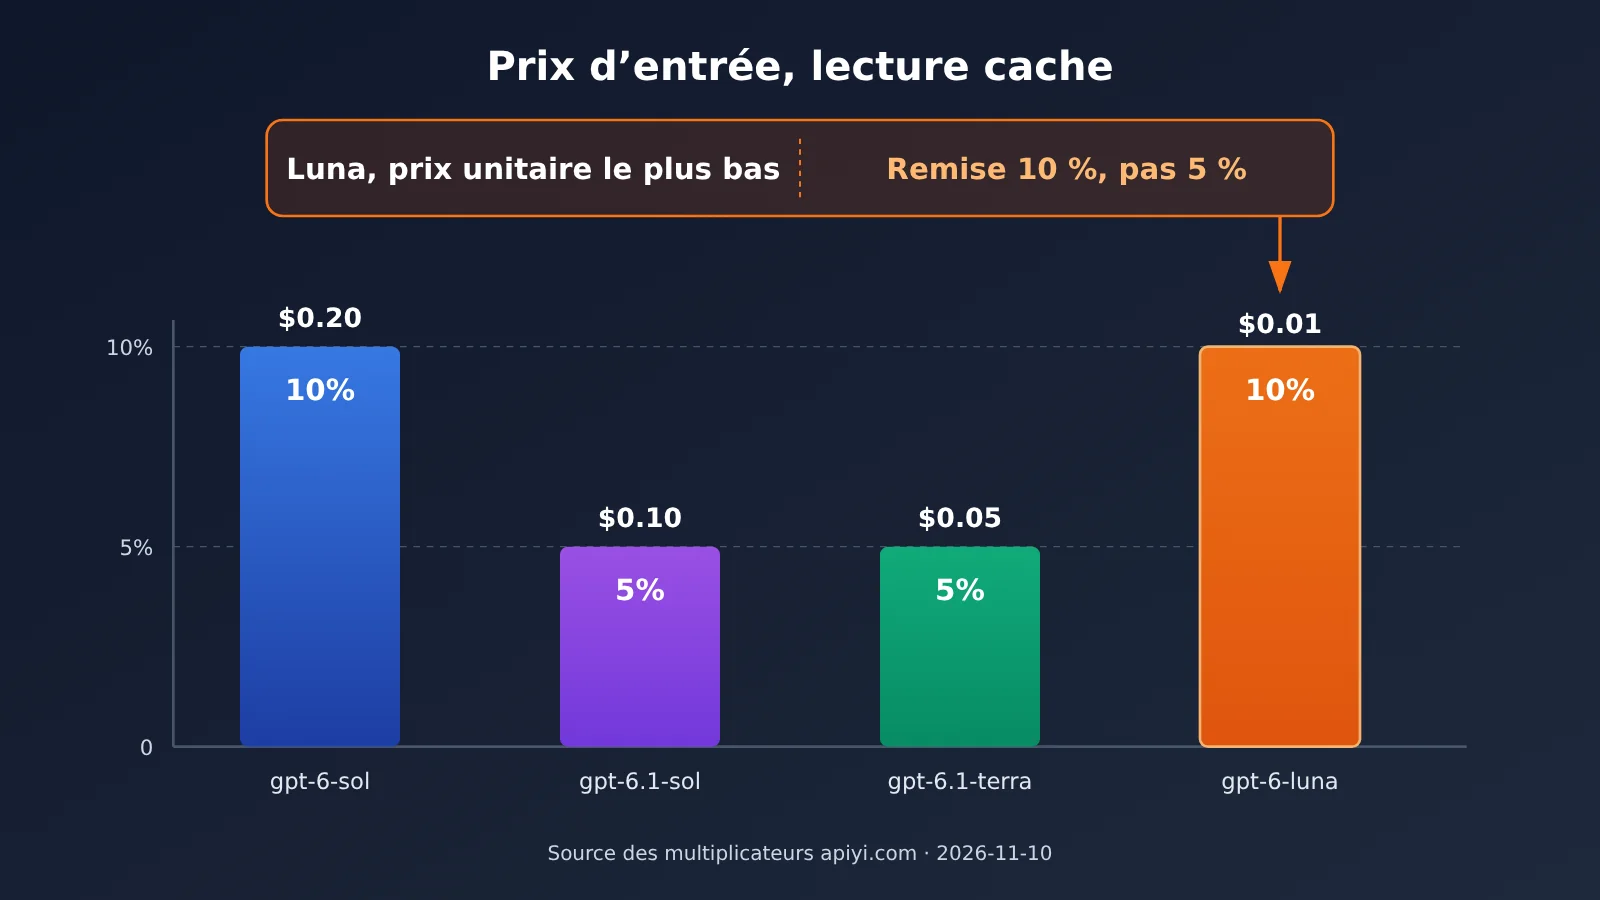
Beaucoup de développeurs utilisent plusieurs modèles à la fois et peuvent facilement en déduire que, puisque la lecture du cache de 6.1 Sol est facturée à 5 %, il en va de même pour les autres modèles. En réalité, le ratio de lecture du cache est défini séparément pour chaque modèle : on ne peut pas simplement extrapoler. Voici une comparaison des tarifs officiels et des ratios de la plateforme à la même date :
| ID du modèle | Prix d’entrée | Prix de sortie | Prix de lecture du cache | cache_ratio | Plateformes disponibles |
|---|---|---|---|---|---|
gpt-6-sol |
2 $ | 10 $ | 0,20 $ | 0.1 | APIYI apiyi.com, OpenAI officiel |
gpt-6.1-sol |
2 $ | 10 $ | 0,10 $ | 0.05 | APIYI apiyi.com, OpenAI officiel |
gpt-6.1-terra |
1 $ | 5 $ | 0,05 $ | 0.05 | APIYI, OpenAI officiel |
gpt-6-luna |
0,10 $ | 0,50 $ | 0,01 $ | 0.1 | APIYI, OpenAI officiel |
Comparaison et analyse
Comparaison avec Terra : la lecture du cache de gpt-6.1-terra représente elle aussi 5 % du prix d’entrée, et son prix unitaire est encore plus bas. Toutefois, cet article porte sur le choix entre les ID d’un même niveau Sol. Terra se situe à un autre niveau de capacité : décider de passer de Sol à Terra relève du choix du modèle et ne fait pas partie du périmètre de cette comparaison.
Comparaison avec Luna : gpt-6-luna est le moins cher en prix unitaire, avec une lecture du cache à seulement 0,01 $. Mais sa remise sur le cache correspond à 10 % du prix d’entrée, et non à 5 %. La conclusion « passer de Sol à 6.1 réduit de moitié le coût du cache » ne vaut donc que pour le niveau Sol ; ne l’appliquez pas à Luna pour estimer votre budget.
💡 Conseil : si votre tâche nécessite les capacités du niveau Sol, remplacer directement l’ancien ID par
gpt-6.1-solest la démarche la plus avantageuse et la moins risquée. Si vous envisagez de réduire les coûts en passant à un autre niveau, essayez différents modèles avec la même clé sur APIYI, puis estimez le coût réel en tenant compte des ratios de lecture du cache.
FAQ : questions fréquentes
Q1 : quelle est la différence de prix entre gpt-6-sol et gpt-6.1-sol ?
La différence concerne uniquement les lectures du cache. Pour les deux modèles, l’entrée coûte $2 par million de tokens et la sortie $10. La lecture du cache coûte $0.20 pour `gpt-6-sol` et $0.10 pour `gpt-6.1-sol`, soit respectivement 10 % et 5 % du prix de l’entrée. Données au 10 novembre 2026 : les tarifs officiels et les multiplicateurs de la plateforme sont cohérents.
Q2 : faut-il racheter un forfait ou créer un compte pour passer à gpt-6.1-sol ?
Non. Les deux identifiants de modèle figurent dans la liste des modèles d’APIYI, et vous pouvez les appeler avec la même clé API. Il suffit de modifier le champ `model` dans la requête ; le `base_url` du client et le mode d’authentification restent inchangés.
Q3 : comment convertir les multiplicateurs d’APIYI en prix en dollars ?
En prenant comme référence « multiplicateur 1 = $2 en entrée par million de tokens » : un `model_ratio` de 1 correspond à $2 en entrée ; un `completion_ratio` de 5, à $10 en sortie ; et un `cache_ratio` de 0.05, à $0.10 pour la lecture du cache. Le montant réellement facturé dépend aussi du groupe associé au compte. Consultez la liste des modèles sur APIYI, à l’adresse apiyi.com, pour connaître les tarifs applicables.
Q4 : dans quels cas le passage à gpt-6.1-sol est-il le plus avantageux ?
Surtout dans les scénarios avec un long contexte et un taux élevé de cache :
– **Agents à plusieurs tours** : l’invite système, les définitions des outils et l’historique des messages sont renvoyés à chaque tour.
– **Assistants de code** : les mêmes fichiers du dépôt sont régulièrement envoyés comme contexte.
– **Questions-réponses sur une base de connaissances** : un long préfixe de document fixe est combiné à des questions utilisateur qui varient.
Q5 : peut-on aussi estimer que Luna et Terra réduisent de moitié le coût des lectures du cache ?
Non, cette règle ne s’applique pas à tous les modèles. La lecture du cache de `gpt-6.1-terra` coûte 5 % du prix de l’entrée, contre 10 % pour `gpt-6-luna`. Luna a le prix unitaire le plus bas, mais son taux de réduction pour le cache n’est pas de 5 %. Pour estimer votre budget, calculez chaque modèle séparément à partir de son `cache_ratio`.
Q6 : pourquoi ma facture n’a-t-elle pas beaucoup baissé après le changement d’identifiant ?
La cause la plus fréquente est un faible taux de cache : par exemple, si le préfixe de la requête contient un horodatage ou un champ aléatoire, chaque appel est facturé comme une entrée complète. Il se peut aussi que certains services utilisent encore l’ancien identifiant. Vérifiez le champ des tokens mis en cache dans la réponse `usage`, puis consultez le détail des appels par modèle dans la console APIYI.
Q7 : la qualité des réponses change-t-elle après le passage au nouveau modèle ?
Les deux modèles se situent dans la même catégorie de capacités, mais leurs performances peuvent varier selon les tâches. Pour procéder sans risque, commencez par un test sur un petit volume de trafic ou sur un jeu de données de test. Passez ensuite à l’ensemble du trafic une fois que les résultats répondent aux exigences de votre activité.
gpt-6.1-sol : points clés sur le prix de la lecture du cache
- Même prix, cache différent : les deux modèles Sol coûtent 2 $ en entrée et 10 $ en sortie, mais la lecture du cache coûte deux fois moins cher avec
gpt-6.1-sol. - Prix précis de la lecture du cache : 0,20 $ pour
gpt-6-solet 0,10 $ pourgpt-6.1-sol, par million de tokens. - Les longues sessions sont les plus avantageuses : plus les réponses proviennent du cache, plus le passage à
gpt-6.1-solpermet d’économiser. - Une seule modification à faire : changez uniquement le champ
modelde la requête. Aucun nouveau forfait n’est nécessaire. - Ne transposez pas cette règle à Luna : pour Luna, la lecture du cache coûte 10 % du prix d’entrée, et non 5 %.
- Pour commencer : effectuez un test à faible volume avec la même clé sur APIYI, puis migrez l’ensemble du trafic.
Résumé
Voici l’essentiel pour passer de gpt-6-sol à gpt-6.1-sol :
- Structure des prix : les prix d’entrée et de sortie sont identiques. Le prix de lecture du cache passe de 10 % à 5 % du prix d’entrée. Données du 10 novembre 2026.
- Modifications à apporter : les deux identifiants figurent dans la liste des modèles de la plateforme. Il suffit de remplacer le nom du modèle dans la requête ;
base_urlet la clé restent inchangés. - Limites de cette règle : la réduction de moitié du prix de lecture du cache concerne uniquement Sol. Calculez séparément les multiplicateurs de cache de Terra et Luna.
Si votre service utilise encore l’ancien identifiant pour ses longues sessions, cette optimisation est presque sans coût. Vérifiez d’abord la liste des modèles et les multiplicateurs sur APIYI, à l’adresse apiyi.com, puis suivez les trois étapes de cet article pour effectuer le changement. La liste des modèles de la plateforme fait foi pour les identifiants et les prix.
📚 Références
- Tarifs officiels d’OpenAI : tarifs des modèles standard pour les entrées, les sorties et les entrées mises en cache
- Lien :
developers.openai.com/api/docs/pricing -
À vérifier : les tarifs officiels unitaires de
gpt-6-sol,gpt-6.1-sol,gpt-6.1-terraetgpt-6-luna -
API de tarification d’APIYI : données sur les multiplicateurs des modèles de la plateforme
- Lien :
api.apiyi.com/api/pricing - À consulter : les trois multiplicateurs
model_ratio,completion_ratioetcache_ratio
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site d’APIYI. Pour plus d’informations sur l’intégration, consultez le centre de documentation à l’adresse docs.apiyi.com.