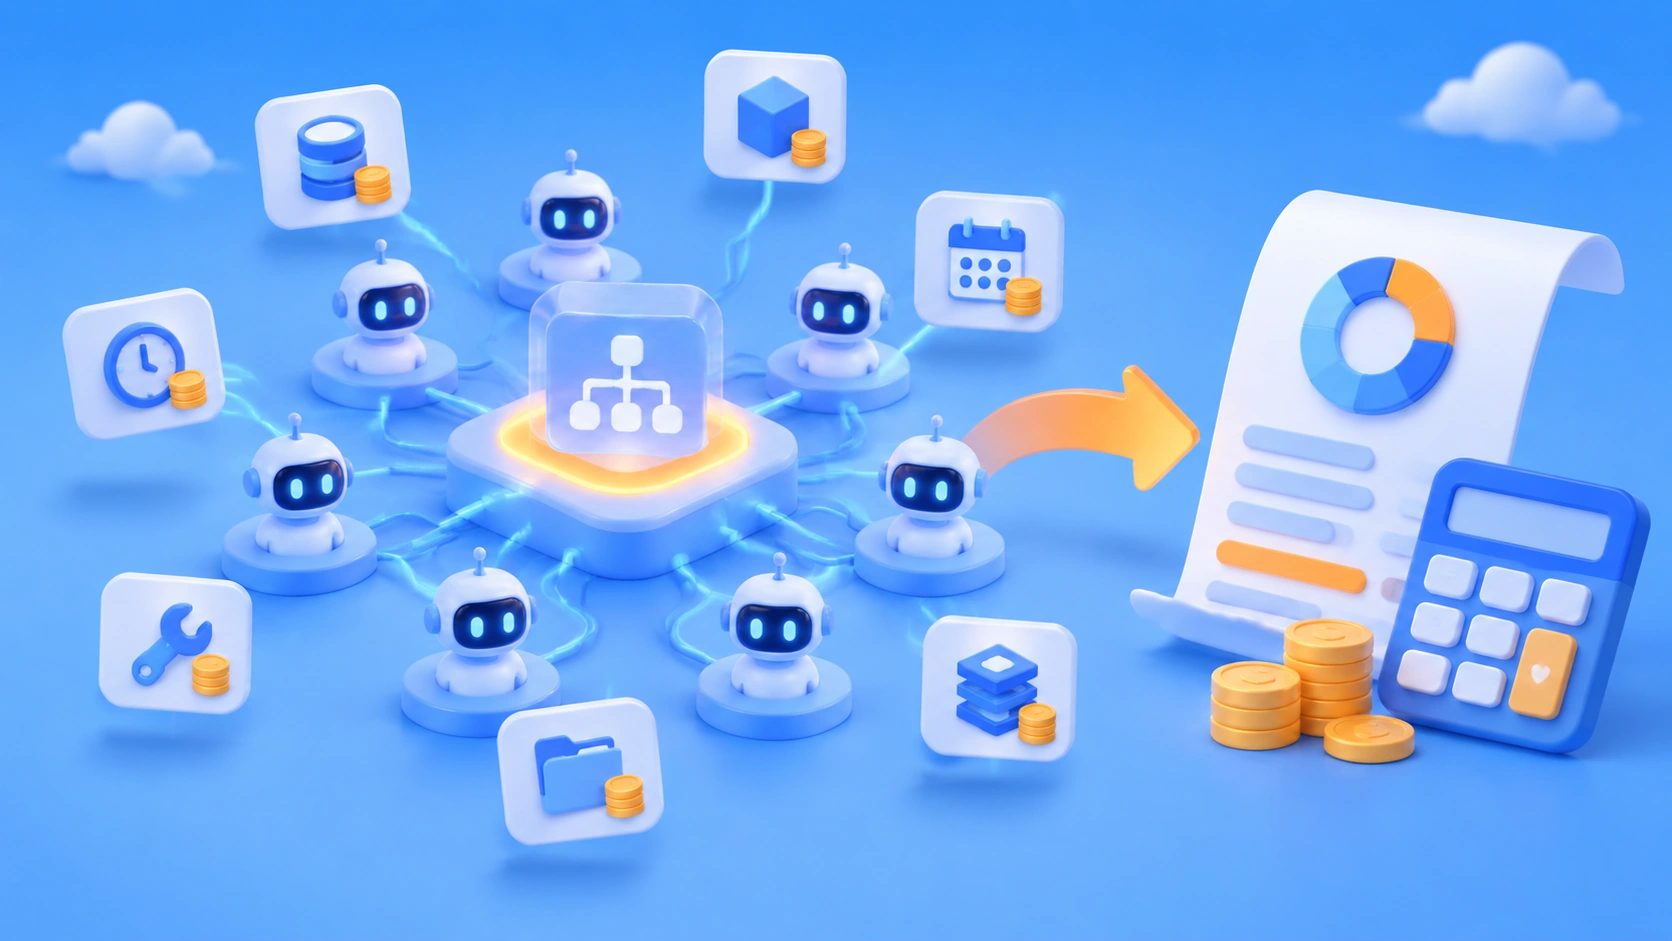
Anthropic mengungkapkan sebuah eksperimen internal saat merilis Claude Fable 5.2 pada 9 November 2026: Fable 5.2 memulai dari folder kosong, mengoordinasikan lebih dari 1.000 subagen, bekerja terus-menerus selama 8 hari, dan menghasilkan prototipe sistem operasi yang bisa dijalankan di laptop.
Nilai utama: Setelah membaca artikel ini, Anda akan memahami komponen biaya alur kerja multiagen Claude Fable 5.2, aturan penagihan yang mudah disalahartikan, serta cara mengendalikan total biaya lewat pemilihan model dan pengelolaan pemanggilan.
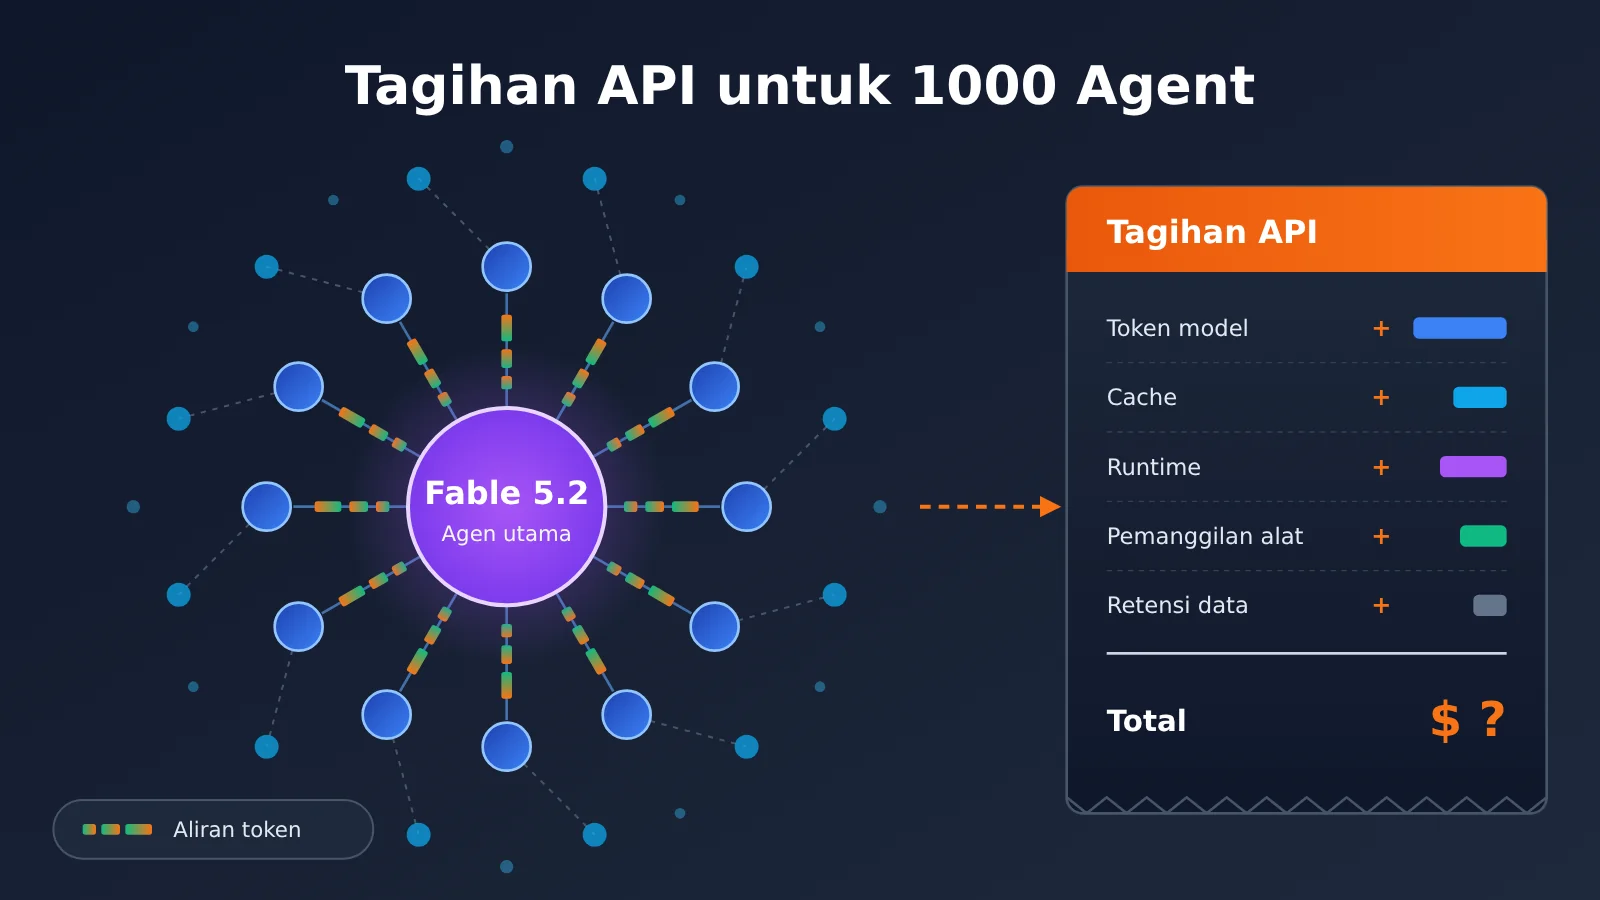
Eksperimen sistem operasi Claude Fable 5.2: Mengapa tagihan untuk 1.000 agen belum diketahui
Mari lihat informasi utama yang sudah diungkapkan secara resmi. Eksperimen ini menunjukkan bukan hanya kemampuan model dalam menulis kode, tetapi juga kemampuannya mengatur rekayasa perangkat lunak berskala besar, mengoordinasikan banyak agen, menjaga progres dalam jangka panjang, serta terus memvalidasi kode.
| Informasi | Detail |
|---|---|
| Tanggal rilis | 9 November 2026 |
| Pihak yang merilis | Anthropic |
| Titik awal eksperimen | Folder kosong; tugasnya merancang dan membuat prototipe sistem operasi |
| Skala agen | Lebih dari 1.000 subagen |
| Durasi pengerjaan | Bekerja terus-menerus selama 8 hari untuk menulis, menguji, meninjau, dan merevisi kode |
| Hasil akhir | Prototipe sistem operasi yang bisa dijalankan di laptop sungguhan, lengkap dengan kernel, driver disk/keyboard/jaringan, penyimpanan berkas, sistem jendela, antarmuka login, program instalasi, dan fitur Claude bawaan |
| Informasi yang belum diungkapkan | Total penggunaan Token, biaya eksperimen, struktur pembagian tugas antaragen, protokol komunikasi, jumlah baris kode, dan lainnya |
Perlu ditekankan bahwa meski disebut sebagai prototipe sistem operasi yang berfungsi, hasil ini belum tentu sudah setara dengan sistem operasi komersial yang matang. Selain itu, Anthropic belum mengungkap tagihan sebenarnya untuk eksperimen ini. Jadi, angka apa pun tentang “berapa biaya pembuatan sistem operasi ini” hanya berupa perkiraan.
Berapa banyak lapisan pemanggilan API yang dihasilkan oleh tim agen?
Meski kita tidak mengetahui tagihan sebenarnya, kita tetap bisa memahami tekanan biaya multiagen dari strukturnya. Agen utama perlu memahami tujuan, membagi tugas, mendelegasikannya kepada subagen, lalu mengumpulkan hasil untuk dirangkum dan divalidasi. Setiap subagen juga perlu membaca konteks proyek, petunjuk alat, dan kode yang relevan, lalu melakukan penalaran dan menghasilkan keluaran secara mandiri.
Artinya, di balik satu tugas yang “selesai” terdapat beberapa lapisan pemanggilan model: pemanggilan untuk perencanaan, eksekusi, pengiriman hasil, dan validasi, serta pemanggilan ulang jika terjadi kegagalan. Ketika jumlah agen bertambah dan waktu pengerjaan berlangsung berhari-hari, biaya Token, pemanggilan secara paralel, dan durasi operasi yang panjang akan sama-sama menjadi variabel dalam tagihan.
Harga API Claude Fable 5.2: Titik Awal Biaya Multi-Agent
Untuk membahas biaya multi-Agent, kita perlu melihat harga per unit terlebih dahulu. Semua harga di bawah ini adalah harga publik dari Anthropic, dalam dolar AS per juta token (MTok).
| Model | Harga input | Harga output | Kegunaan |
|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | Tugas kompleks, terbuka, dan berjalan lama |
| Claude Opus 5.5 | $4 | $20 | Titik awal yang direkomendasikan secara resmi untuk sebagian besar pekerjaan pemrograman dan pengetahuan |
| Claude Sonnet 5.5 | $2 | $10 | Subtugas dengan tingkat kesulitan menengah dan pengolahan materi |
| Claude Haiku 5.5 | $0.10 | $0.50 | Subtugas sederhana dengan frekuensi tinggi (input tidak lebih dari 100K token) |
Jika input Haiku 5.5 melebihi 100K token, harganya berubah menjadi $0.50/MTok untuk input dan $2.50/MTok untuk output. Sebelumnya, Fable 5.1 dibanderol $10 untuk input dan $50 untuk output. Artinya, harga standar per token Fable 5.2 turun 20%.
💡 Saran pemilihan: Model yang berbeda tidak bisa saling menggantikan dengan kemampuan yang setara. Pilihan akhirnya bergantung pada tingkat kesulitan tugas dan kualitas yang dibutuhkan. Anda bisa memakai APIYI apiyi.com dengan antarmuka kompatibel OpenAI yang sama untuk membandingkan hasil dan penggunaan token dari beberapa model Claude, lalu menentukan pembagian model untuk tiap jenis subtugas. Model yang tersedia dapat dilihat di daftar model platform.
Spesifikasi Claude Fable 5.2 dan Fast Mode
API Model ID Fable 5.2 adalah claude-fable-5-2, dengan jendela konteks 1M token dan output maksimum 128K token. Batas pengetahuannya adalah Juni 2026. Adaptive Thinking selalu aktif, dengan Effort default High. Pilihan lainnya adalah Low, Medium, High, Xhigh, dan Max. Effort bukan parameter gaya jawaban; pengaturan ini langsung memengaruhi kedalaman penalaran, waktu eksekusi, dan penggunaan token.
| Komponen biaya | Harga (dolar AS/MTok) | Keterangan |
|---|---|---|
| Input / output biasa | $8 / $40 | Mode standar |
| Input / output Fast Mode | $16 / $80 | Harganya dua kali lipat, dengan kecepatan output hingga 2,5 kali mode biasa |
| Input / output Batch API | $4 / $20 | Permintaan batch asinkron mendapat diskon 50% dan tidak bisa digunakan bersamaan dengan Fast Mode |
| Penulisan cache 5 menit | $10 | Menyimpan prefiks input untuk digunakan kembali |
| Penulisan cache 1 jam | $16 | Masa berlaku lebih lama |
| Pembacaan cache | $0.20 | Hanya 2,5% dari harga input biasa |
Tabel ini menunjukkan satu hal penting: model terkuat tidak perlu menangani setiap subtugas. Jika Fable 5.2 digunakan untuk pekerjaan seperti merapikan format atau melakukan klasifikasi sederhana, harga per unitnya 4 kali lipat Sonnet 5.5 dan 80 kali lipat Haiku 5.5, sementara kemampuan penalaran tambahannya hampir tidak memberikan manfaat.
Bagaimana Biaya Multi-Agent Terakumulasi: Bedah Alur Kerja Claude Fable 5.2
Dalam sistem multi-Agent, Agent utama bertugas menyusun rencana dan merangkum hasil, sedangkan Agent turunan menjalankan tugas tertentu. Sekilas, pekerjaan terlihat “dibagi-bagi”, tetapi Token tidak hilang begitu saja. Sebaliknya, penggunaannya justru bisa meningkat di beberapa tahap.
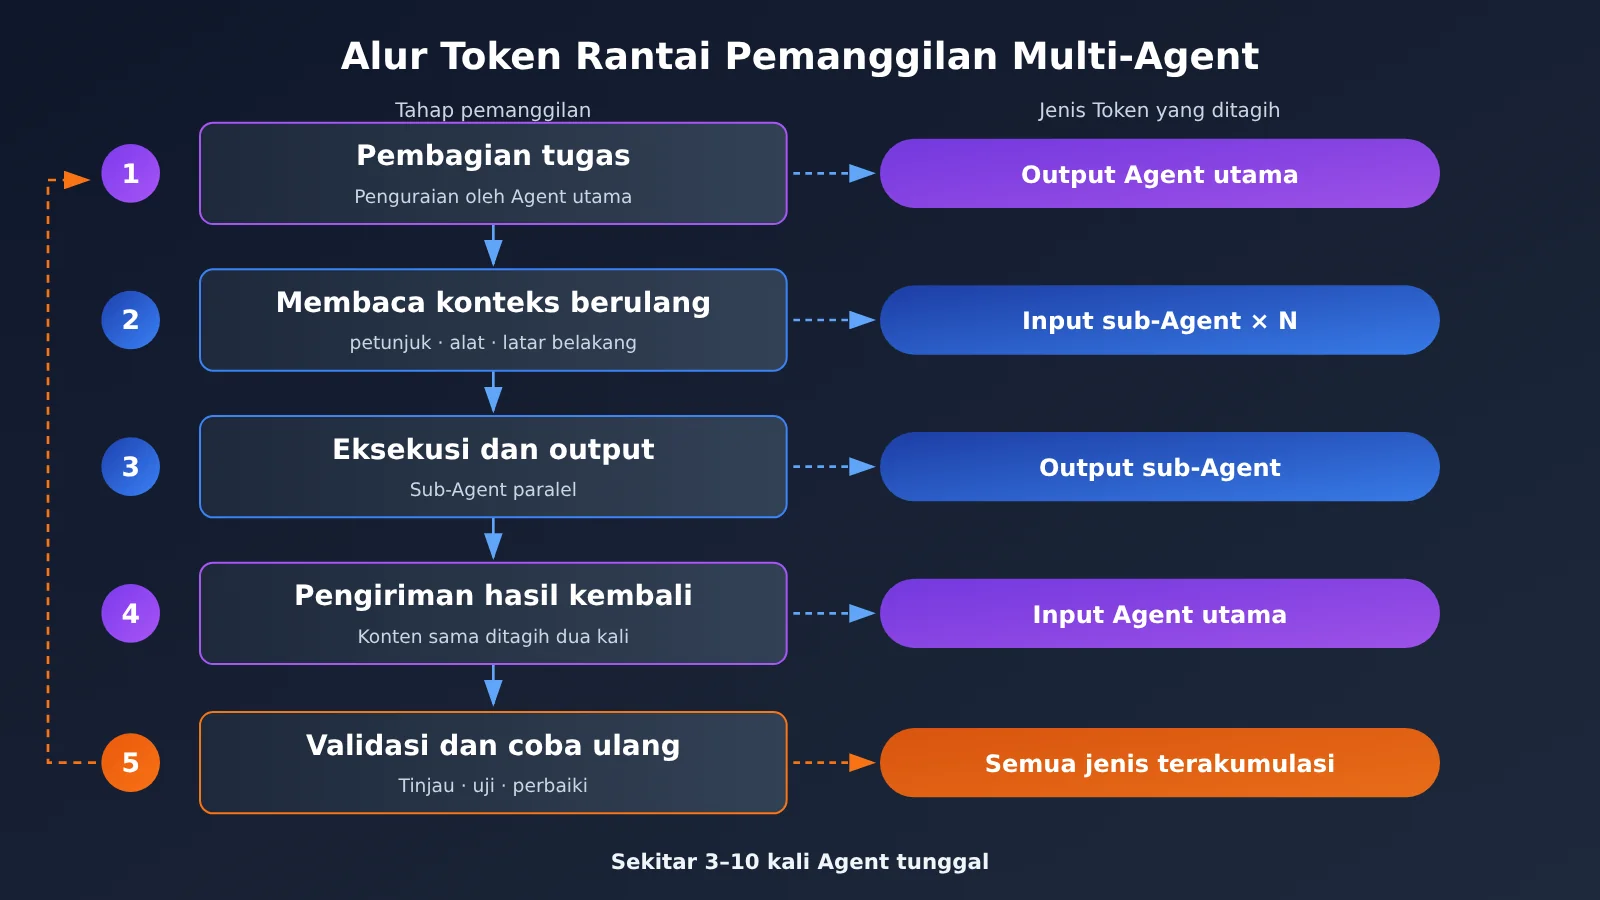
- Pembagian tugas: Deskripsi tugas yang dibuat Agent utama dihitung sebagai Token output dan dikenai biaya sesuai harga model Agent utama.
- Konteks berulang: Setiap Agent turunan harus membaca ulang System Prompt, keterangan alat, dan latar belakang proyek. Konten yang sama pun ditagihkan berkali-kali.
- Pengiriman hasil: Output Agent turunan menjadi input bagi Agent utama. Artinya, konten yang sama dikenai biaya dua kali.
- Validasi berulang: Setelah hasil ditinjau dan diuji, masalah yang ditemukan akan memicu penugasan perbaikan. Setiap putaran merupakan pemanggilan baru.
- Percobaan ulang setelah gagal: Jika pemanggilan gagal atau hasilnya tidak memenuhi syarat, tugas dijalankan kembali dan penggunaan Token pun bertambah.
Panduan rekayasa multi-Agent Anthropic tahun 2026 menyebutkan bahwa untuk tugas yang sama, sistem multi-Agent biasanya menggunakan Token 3–10 kali lebih banyak daripada sistem Agent tunggal. Ini adalah kisaran umum untuk perbandingan pada tugas yang sama, bukan pengali yang pasti. Sebagai ilustrasi saja, misalkan biaya Token untuk suatu tugas Agent tunggal adalah $1.60. Dengan model serta rasio input-output yang sama, penggunaan 3 kali lipat berarti $4.80, sedangkan 10 kali lipat berarti $16.
Inilah sebabnya menjalankan proses secara paralel tidak berarti total biayanya menjadi lebih rendah. Pemrosesan paralel memang mempersingkat waktu nyata, tetapi penggunaan Token setiap Agent tetap sama, bahkan ada biaya koordinasi tambahan. Yang benar-benar perlu dikendalikan bukan jumlah Agent itu sendiri, melainkan penggunaan Token aktual setiap Agent.
Simulasi Hipotetis Multi-Agen Claude Fable 5.2: Berapa Biaya Sebuah Alur Kerja?
Berikut simulasi hipotetis sebuah alur kerja: 1 Agen utama Fable 5.2 bertugas menyusun rencana dan merangkum, sementara 10 Agen anak Sonnet 5.5 menangani tugas pemrosesan informasi secara mandiri. Semua penggunaan Token di bawah ini hanyalah asumsi, bukan tagihan nyata dari eksperimen sistem operasi Anthropic atau pengujian perbandingan model untuk tugas dengan kualitas setara.
Agen utama (Fable 5.2): diasumsikan menggunakan 100.000 Token input dan 10.000 Token output.
- Input: 100.000 × $8 / 1.000.000 = $0.80
- Output: 10.000 × $40 / 1.000.000 = $0.40
- Subtotal: $1.20
10 Agen anak (Sonnet 5.5): diasumsikan masing-masing menggunakan 100.000 Token input dan 20.000 Token output, sehingga totalnya 1.000.000 Token input dan 200.000 Token output.
- Input: 1.000.000 × $2 / 1.000.000 = $2.00
- Output: 200.000 × $10 / 1.000.000 = $2.00
- Subtotal: $4.00
| Komponen | Biaya input | Biaya output | Total |
|---|---|---|---|
| Agen utama Fable 5.2 | $0.80 | $0.40 | $1.20 |
| 10 Agen anak Sonnet 5.5 | $2.00 | $2.00 | $4.00 |
| Total biaya Token | $2.80 | $2.40 | $5.20 |
| Session Runtime (diasumsikan 1 Session berjalan tepat selama 8 jam) | — | — | $0.64 |
| Total contoh (belum termasuk biaya alat) | — | — | $5.84 |
Cara Menghitung Biaya Session Runtime Managed Agents
Jika menggunakan Claude Managed Agents, tagihan akan mencakup biaya tambahan Session Runtime sebesar $0.08 per jam Session. Biaya hanya dihitung selama Session berstatus running. Waktu idle, menunggu konfirmasi pengguna, dan Session yang sudah dihentikan tidak dikenai biaya. Token Agen anak tetap dihitung terpisah sesuai harga masing-masing model.
Biaya $0.64 pada tabel di atas hanya berdasarkan asumsi “satu Session berjalan tepat selama 8 jam”: 8 × $0.08 = $0.64. Runtime dihitung berdasarkan durasi Session berjalan, bukan dengan mengalikan jumlah Agen dengan tarif per jam setiap Agen. Jika beberapa Session dalam sistem menghasilkan waktu berjalan, hitung durasi running setiap Session sesuai pemakaian aktual, lalu jumlahkan. Jadi, $0.64 bukan nilai tetap untuk biaya operasional sistem multi-Agen.
Dampak Caching, Batch, dan Pemanggilan Alat terhadap Total Biaya
Beberapa jenis biaya lain dapat membuat tagihan aktual alur kerja yang sama berbeda dari $5.84:
- Prompt Caching: Jika System Prompt dan latar belakang proyek yang digunakan bersama oleh Agen anak cocok dengan cache, biaya untuk membacanya hanya $0.20/MTok. Namun, penulisan awal ke cache lebih mahal daripada input biasa. Jika cache terlalu jarang digunakan, biayanya justru tidak sebanding.
- Batch API: Token untuk permintaan batch asinkron bisa mendapatkan diskon 50%. Namun, Managed Agents adalah Session interaktif yang bersifat stateful, sehingga tidak dapat menggunakan diskon Batch dari Messages API. Diskon 50% tersebut tidak berlaku untuk biaya Session.
- Pemanggilan alat: Web Search di Managed Agents dikenai biaya $10 per 1.000 kali penggunaan. Biaya Agen yang banyak melakukan pencarian perlu dihitung secara terpisah.
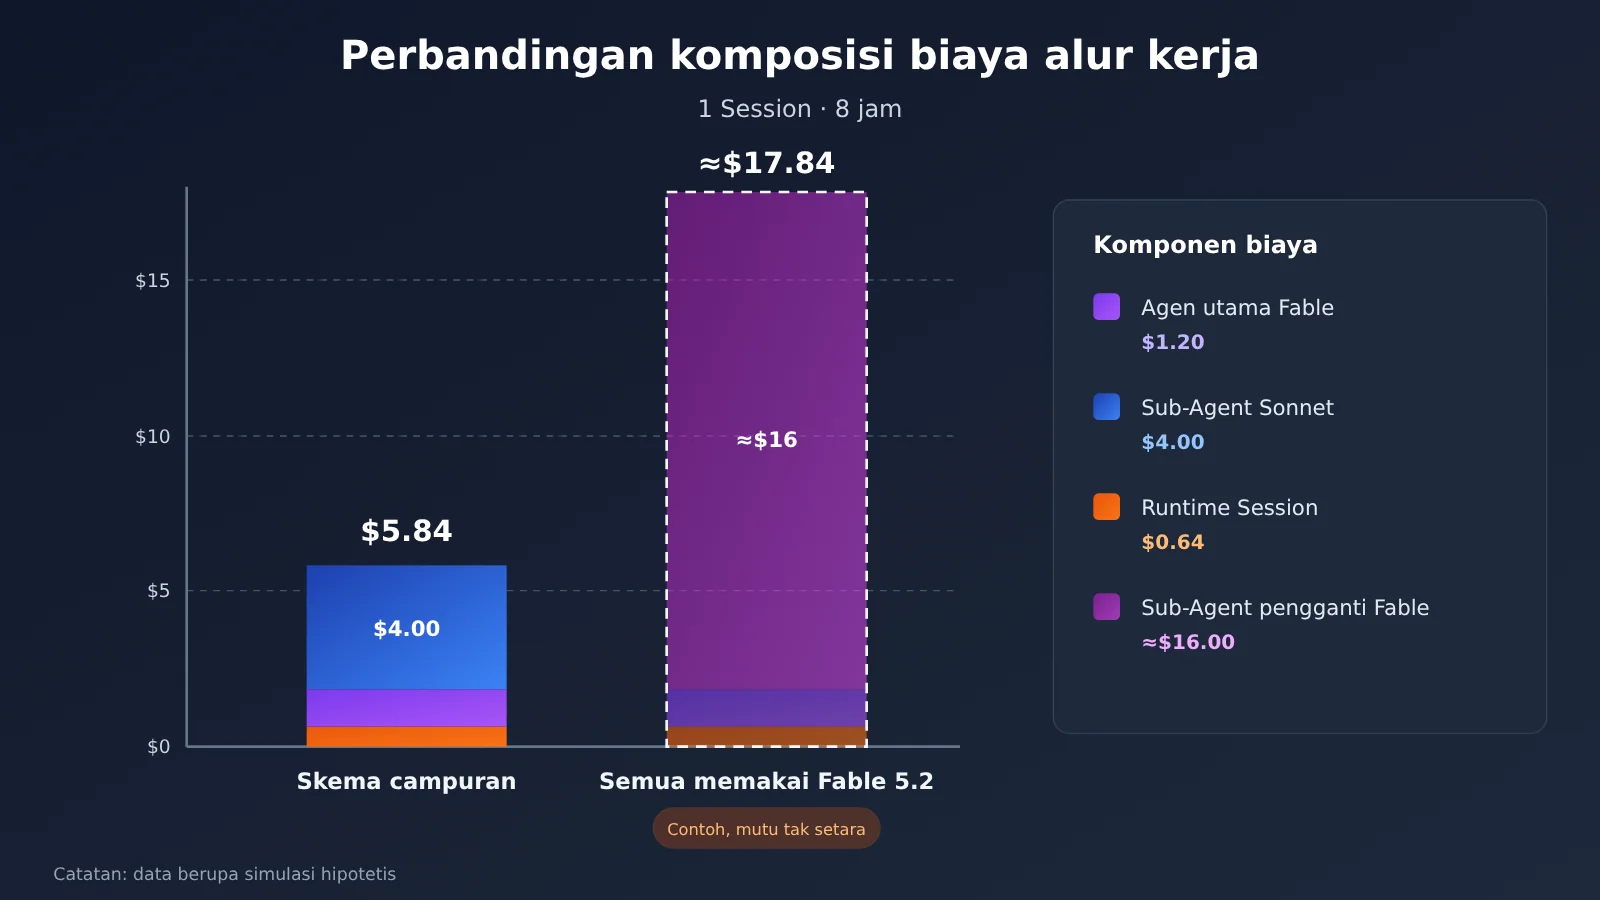
📊 Keterangan gambar: Data pada gambar di atas merupakan simulasi hipotetis berdasarkan harga yang dipublikasikan. Untuk memperkirakan biaya alur kerja Anda sendiri, coba jalankan beberapa permintaan nyata melalui APIYI apiyi.com, lihat jumlah Token aktual pada kolom
usagedi respons, lalu gunakan angka tersebut bersama tabel harga untuk menghitung biaya.
Cara Menekan Biaya Sistem Multi-Agent Claude Fable 5.2
Contoh sederhana berikut menunjukkan cara membaca usage dari respons dan memperkirakan biaya satu kali pemanggilan berdasarkan daftar harga. Ganti nama model dengan ID model yang tersedia di platform.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka yang kompatibel dengan OpenAI dari APIYI
)

resp = client.chat.completions.create(
    model="claude-sonnet-model-id",  # Ganti dengan ID aktual dari daftar model di platform
    messages=[{"role": "user", "content": "总结这段需求文档的要点"}]
)
u = resp.usage
cost = u.prompt_tokens * 2 / 1e6 + u.completion_tokens * 10 / 1e6  # Harga Sonnet 5.5
print(resp.choices[0].message.content, f"估算费用: ${cost:.4f}")
Lihat implementasi lengkap: pemanggilan bertingkat berdasarkan model dan akumulasi anggaran
import openai

# Satuan: dolar AS per satu juta token, berdasarkan harga publik Anthropic
PRICES = {
    "planner": {"model": "claude-fable-model-id", "in": 8, "out": 40},
    "worker":  {"model": "claude-sonnet-model-id", "in": 2, "out": 10},
    "simple":  {"model": "claude-haiku-model-id", "in": 0.10, "out": 0.50},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

class BudgetTracker:
    def __init__(self, limit_usd: float):
        self.limit = limit_usd
        self.spent = 0.0

    def add(self, tier: str, usage) -> float:
        p = PRICES[tier]
        cost = usage.prompt_tokens * p["in"] / 1e6 + usage.completion_tokens * p["out"] / 1e6
        self.spent += cost
        if self.spent > self.limit:
            raise RuntimeError(f"预算超限:已花费 ${self.spent:.2f}")
        return cost

def run(tier: str, prompt: str, tracker: BudgetTracker) -> str:
    resp = client.chat.completions.create(
        model=PRICES[tier]["model"],
        messages=[{"role": "user", "content": prompt}],
    )
    cost = tracker.add(tier, resp.usage)
    print(f"[{tier}] 本次 ${cost:.4f},累计 ${tracker.spent:.4f}")
    return resp.choices[0].message.content

tracker = BudgetTracker(limit_usd=10.0)
plan = run("planner", "把资料整理任务拆成 3 个独立子任务,每行一个", tracker)
results = [run("worker", f"执行子任务:{t}", tracker) for t in plan.splitlines() if t.strip()]
summary = run("planner", "汇总以下结果:\n" + "\n".join(results), tracker)
print(summary)
🚀 Saran untuk mulai cepat: Coba dulu kuota uji coba gratis untuk pengguna baru melalui APIYI apiyi.com. Jalankan skrip pelacakan anggaran di atas untuk menguji alur minimum “perencanaan—eksekusi—perangkuman”. Setelah mengetahui distribusi token yang sebenarnya, barulah tingkatkan skala Agent.
Berdasarkan aturan penagihan di atas, ada lima cara untuk mengendalikan biaya:
| Metode | Cara | Batas penerapan |
|---|---|---|
| Pilih model sesuai tingkat kesulitan | Serahkan perencanaan dan penalaran kompleks kepada Fable 5.2 atau Opus 5.5 | Rekomendasi resmi: mulai sebagian besar tugas dengan Opus 5.5 |
| Gunakan model yang lebih ringan untuk subtugas sederhana | Serahkan klasifikasi, pemformatan, dan ekstraksi kepada Sonnet 5.5 atau Haiku 5.5 | Pastikan kualitas model yang lebih murah sudah memadai |
| Aktifkan Prompt Caching | Cache System Prompt bersama, petunjuk penggunaan alat, dan dokumen panjang | Besarnya penghematan bergantung pada jumlah cache hit dan konsistensi konteks |
| Aktifkan Fast Mode sesuai kebutuhan | Gunakan hanya untuk permintaan interaktif yang sensitif terhadap latensi | Biayanya dua kali lipat, jadi tidak cocok untuk tugas luring |
| Anggaran dan pemantauan | Catat penggunaan per model, Agent, dan tugas, lalu tetapkan batas | Semakin cepat diterapkan, semakin mudah mendeteksi penggunaan yang tidak wajar |
Perlu ditambahkan batasan Batch API: API ini cocok untuk tugas yang dapat diproses secara asinkron, seperti klasifikasi dokumen dalam jumlah besar, pembuatan konten secara offline, dan analisis data nonreal-time. Namun, Batch API tidak cocok untuk semua sesi Agent yang berjalan dalam waktu lama.
Peran API Gateway di Era Multi-Agent Claude Fable 5.2
Pada 9 November 2026, Vercel mengumumkan bahwa Claude Fable 5.2 telah tersedia di AI Gateway dengan ID model anthropic/claude-fable-5.2. Ini bisa menjadi contoh nyata untuk mengamati cara kerja gateway multi-model. Model ini mendukung antarmuka AI SDK, OpenAI Chat Completions, OpenAI Responses, dan Anthropic Messages. Developer dapat mengaksesnya melalui satu titik masuk terpadu.
Pada lapisan perutean, model yang sama dapat dipilih dari beberapa penyedia, seperti Anthropic, AWS Bedrock, dan Google Vertex AI, lalu diurutkan berdasarkan harga, latensi token pertama, atau kecepatan throughput. Contoh Fallback dari Vercel adalah memanggil Fable 5.2 terlebih dahulu. Jika permintaan ditolak oleh klasifikator keamanan, sistem akan beralih ke Opus 5.5 lalu Sonnet 5.5. Vercel juga menyediakan laporan penggunaan, statistik biaya, anggaran kunci API, Retry, dan Failover.
Mengapa sistem multi-Agent lebih membutuhkan infrastruktur seperti ini dibandingkan obrolan sederhana? Jika obrolan gagal sekali, pengguna bisa mengirim ulang pesan. Namun, dalam alur kerja Agent yang berjalan selama berhari-hari, satu kegagalan pemanggilan dapat menghentikan seluruh rangkaian tugas. Sementara itu, percobaan ulang dapat meningkatkan konsumsi Token. Pemilihan model, pengelolaan pemanggilan, pengalihan saat terjadi gangguan, dan pencatatan biaya yang sebelumnya hanya menjadi “nilai tambah” kini menjadi kebutuhan dalam skenario multi-Agent.
🎯 Saran teknis: Bagi developer di Tiongkok, APIYI apiyi.com menyediakan lapisan akses multi-model dengan pendekatan serupa: satu kunci API dapat digunakan untuk mengakses model-model utama seperti OpenAI, Claude, dan Gemini. Antarmuka yang kompatibel dengan OpenAI mengurangi perbedaan antarmuka di antara penyedia, sementara penagihan berdasarkan penggunaan memudahkan penghitungan biaya untuk setiap Agent dan tugas.
Retensi Data Claude Fable 5.2: Masalah Kepatuhan untuk Aplikasi Multi-Agent Perusahaan
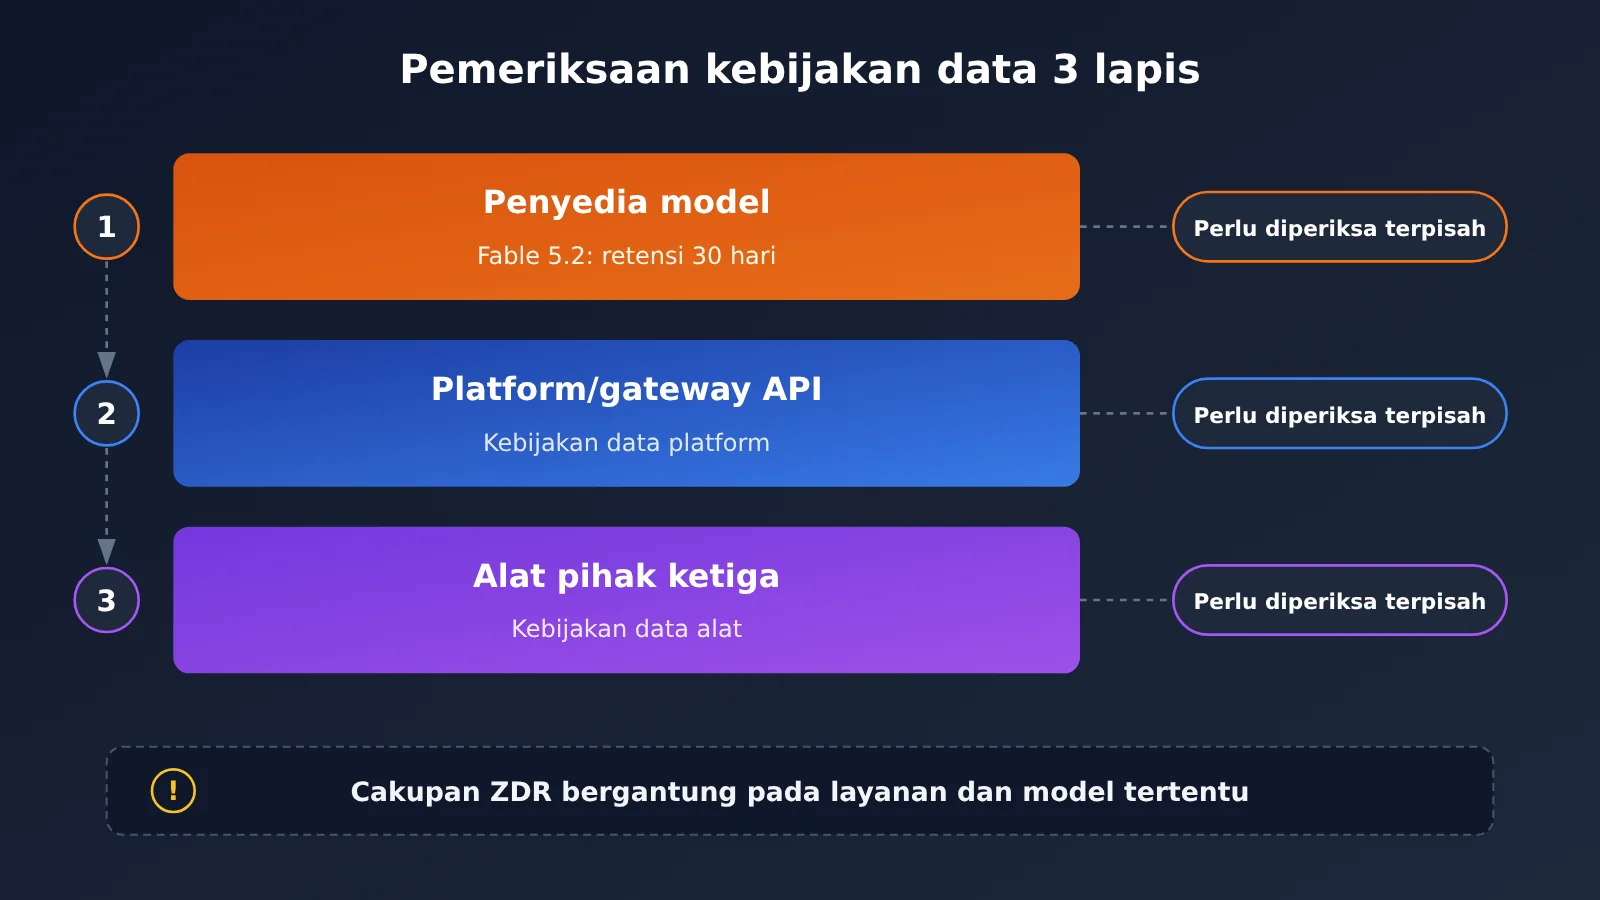
Selain biaya, developer perusahaan juga harus memperhatikan kepatuhan data. Menurut dokumentasi resmi retensi data Anthropic, Fable 5.2 termasuk Covered Model yang mengharuskan retensi data selama 30 hari, bukan model yang secara default mendukung zero data retention (ZDR).
Aturannya secara spesifik adalah sebagai berikut: secara default, organisasi tidak dapat memanggil model ini dengan pengaturan ZDR kecuali telah mendapat otorisasi tegas dari Anthropic; petunjuk dan output model disimpan selama 30 hari sesuai kebijakan yang berlaku; data yang disimpan tidak akan digunakan untuk melatih model tanpa izin tegas; organisasi ZDR yang memenuhi syarat dapat menggunakan model ini dengan mengaktifkan retensi data 30 hari di Workspace tertentu. Pengumuman integrasi Vercel juga secara tegas mengingatkan tentang persyaratan ini.
Ada satu hal yang mudah tertukar: kebijakan data penyedia model berbeda dengan kebijakan data gerbang API pihak ketiga. Meskipun suatu platform API menyediakan fitur ZDR, bukan berarti semua model yang terhubung dengannya memenuhi persyaratan ZDR. Saat menangani data bisnis yang sensitif, perusahaan perlu memeriksa kebijakan pemrosesan data dari penyedia model, platform API, dan alat pihak ketiga secara terpisah, bukan hanya membandingkan harga model.
Pertanyaan Umum (FAQ)
T1: Berapa biaya eksperimen sistem operasi 1000 Agent Claude Fable 5.2?
Anthropic tidak mengungkapkannya. Total penggunaan token, biaya komputasi, dan biaya keseluruhan eksperimen tersebut tidak dipublikasikan secara resmi. Angka-angka spesifik yang beredar di internet bukan data resmi.
T2: Apakah biaya multi-Agent selalu 3–10 kali lebih mahal daripada single-Agent?
Tidak selalu. Rentang tersebut merupakan perbandingan tipikal yang diberikan Anthropic untuk tugas yang sama, bukan pengali tetap. Pengali sebenarnya bergantung pada tingkat pengulangan konteks, jumlah serah terima tugas, pilihan model, dan tingkat keberhasilan cache.
T3: Apakah Session Runtime ditagih per Agent?
Tidak. Managed Agents ditagih berdasarkan durasi setiap Session dalam status running, sebesar $0,08 per jam per Session. Waktu dalam status idle, menunggu konfirmasi, atau sudah dihentikan tidak dikenai biaya. Jika ada beberapa Session, hitung durasi aktual masing-masing, lalu jumlahkan.
T4: Apakah diskon 50% Batch API bisa digunakan untuk Managed Agents?
Tidak. Diskon Batch berlaku untuk permintaan batch asinkron di Messages API. Managed Agents adalah Session interaktif yang menyimpan status, sehingga tidak mendapatkan diskon tersebut. Selain itu, Fast Mode tidak dapat digunakan bersamaan dengan Batch API.
T5: Bagaimana cara cepat menguji biaya pembagian tugas ke beberapa model?
Berikut tiga langkah yang disarankan:
1. Daftar di APIYI, apiyi.com, lalu dapatkan kunci API dan kuota uji coba gratis.
2. Atur `base_url` dalam kode artikel ini ke `https://api.apiyi.com/v1`, lalu ganti dengan ID model yang tersedia di platform.
3. Jalankan skrip pelacakan anggaran untuk tugas berskala kecil dan catat distribusi token aktual dari model di setiap tingkatan.
T6: Apa saja batasan Claude Fable 5.2 yang perlu diperhatikan?
Pertama, harganya cukup tinggi: output sebesar $40/MTok, sehingga model ini tidak cocok untuk menangani semua subtugas. Kedua, Fast Mode menggandakan harga. Ketiga, model ini mensyaratkan retensi data selama 30 hari dan secara default tidak dapat dipanggil dengan pengaturan ZDR. Pastikan untuk memeriksa persyaratan kepatuhan sebelum memproses data sensitif.
Claude Fable 5.2: Poin Penting Biaya Multi-Agent
- Tagihan belum diungkapkan: Anthropic tidak mengungkap biaya sebenarnya dari eksperimen sistem 1.000 Agent.
- Harga turun 20%: Harga standar Fable 5.2 adalah $8 untuk input dan $40 untuk output per satu juta Token.
- Biaya bisa berlipat: Untuk tugas yang sama, konsumsi Token multi-Agent biasanya 3–10 kali lebih besar daripada satu Agent.
- Runtime dihitung per Session: Biayanya $0,08 per jam Session. Yang dihitung hanya durasi berjalan, bukan jumlah Agent.
- Diskon punya batasan: Diskon 50% untuk Batch tidak berlaku bagi Managed Agents. Penghematan dari cache bergantung pada tingkat kecocokan.
- Jangan abaikan kepatuhan: Fable 5.2 mewajibkan retensi data selama 30 hari. ZDR memerlukan otorisasi tambahan.
- Uji dahulu, baru tingkatkan skala: Gunakan APIYI apiyi.com dengan antarmuka terpadu untuk menguji distribusi Token sebenarnya saat membagi tugas ke beberapa model.
Ringkasan
Eksperimen Claude Fable 5.2 dengan 1.000 Agent mengubah cara developer memandang biaya: dari “berapa biaya satu kali pemanggilan” menjadi “berapa total biaya seluruh alur kerja”. Poin utamanya:
- Biaya terdiri dari banyak komponen: Agent utama, Agent anak, konteks berulang, verifikasi, percobaan ulang, Runtime Session, dan pemanggilan alat semuanya berkontribusi pada tagihan.
- Pembagian tugas antar-model menentukan sebagian besar biaya: Gunakan model terkuat hanya untuk perencanaan dan penalaran penting, lalu serahkan tugas eksekusi kepada model yang lebih murah.
- Pahami aturan penagihan dengan tepat: Runtime dihitung berdasarkan durasi Session berjalan, Batch tidak mencakup Managed Agents, dan cache baru menghemat biaya jika jumlah kecocokannya memadai.
- Kepatuhan sama pentingnya dengan harga: Ketentuan retensi data 30 hari dan batasan ZDR perlu dipertimbangkan sejak tahap pemilihan model.
Semakin kompleks aplikasi multi-Agent, semakin penting akses model yang stabil, statistik penggunaan yang jelas, dan mekanisme pengalihan saat terjadi gangguan yang andal. Sebaiknya gunakan APIYI apiyi.com dengan antarmuka terpadu untuk menguji skema pembagian tugas antar-model dengan cepat. Rencanakan anggaran berdasarkan data Token nyata, lalu tingkatkan skala Agent secara bertahap.
📚 Referensi
- Pengumuman Anthropic: Claude Fable 5.2 and Mythos 5.2
- Tautan:
anthropic.com/claude-fable-and-mythos-5-2 -
Keterangan: Pengungkapan resmi tentang eksperimen sistem operasi dengan 1.000 agen
-
Spesifikasi model dan harga Claude Platform: Fable 5.2 Overview
- Tautan:
platform.claude.com/docs/en/models/fable-5-2/overview -
Keterangan: Informasi harga, jendela konteks, Effort, dan spesifikasi lainnya
-
Harga Claude Managed Agents: Aturan penagihan Session Runtime
- Tautan:
platform.claude.com/docs/en/about-claude/pricing -
Keterangan: Informasi Runtime, Web Search, dan harga API lengkap
-
Dokumentasi Prompt Caching: Penjelasan penulisan dan pembacaan cache
- Tautan:
platform.claude.com/docs/en/build-with-claude/prompt-caching -
Keterangan: Cache otomatis dan titik jeda cache eksplisit
-
Kebijakan retensi data API: Covered Model dan ZDR
- Tautan:
platform.claude.com/docs/en/manage-claude/api-and-data-retention -
Keterangan: Dasar resmi persyaratan retensi data selama 30 hari
-
Pengumuman integrasi Vercel AI Gateway: Informasi peluncuran Fable 5.2
- Tautan:
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway - Keterangan: Contoh perutean multi-penyedia, fallback, dan pengelolaan biaya
Penulis: Tim Teknologi APIYI
Diskusi teknis: Hubungi kami melalui halaman beranda situs resmi APIYI. Untuk informasi integrasi lainnya, kunjungi pusat dokumentasi di docs.apiyi.com.