Catatan penulis: Kelompok model open source asal Tiongkok yang sama menempati urutan berbeda dalam daftar pengeluaran Menlo Ventures dan daftar permintaan OpenRouter. Artikel ini menguraikan cakupan pengukuran kedua daftar dan menyajikan metode pemilihan model dalam 5 langkah yang bisa langsung diterapkan.
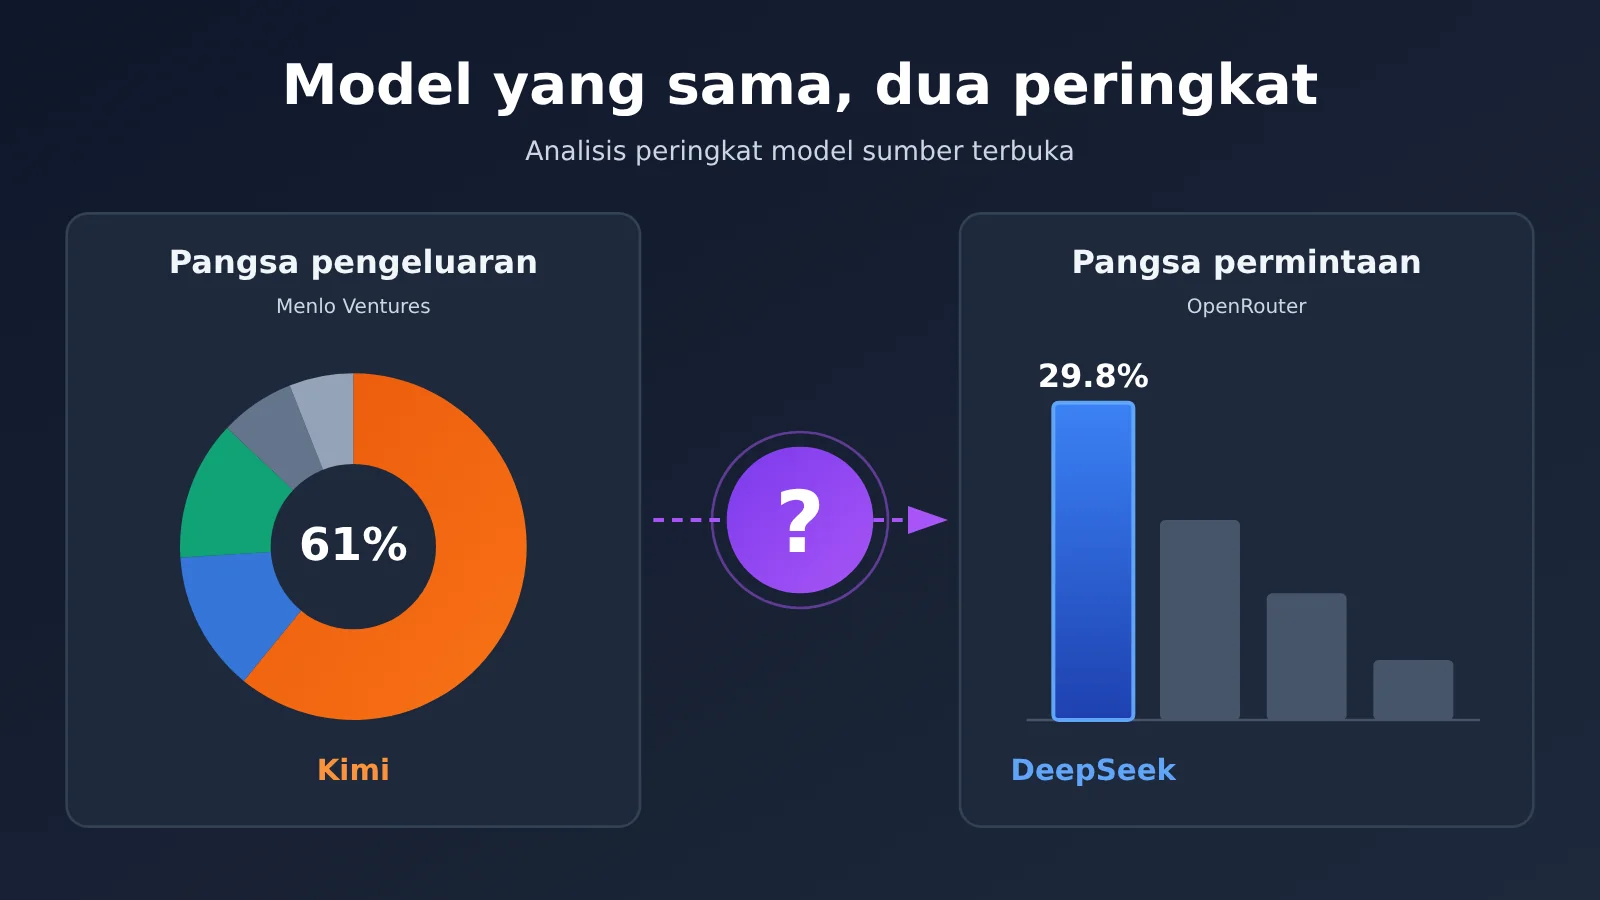
Pada awal November, dua laporan data dirilis. Laporan Menlo Ventures menunjukkan bahwa Kimi meraih 61% pengeluaran perusahaan AS untuk model open source. Daftar mingguan OpenRouter menunjukkan bahwa DeepSeek meraih 29,8% permintaan teks di platform tersebut. Pemuncak kedua daftar berbeda, bahkan urutannya hampir terbalik. Banyak pemimpin teknis mungkin langsung bertanya: daftar mana yang harus dipercaya?
Kesimpulannya, kedua daftar itu tidak bertentangan karena mengukur dua hal yang berbeda. Daftar pengeluaran menunjukkan “kepada siapa perusahaan membayar”, sedangkan daftar permintaan menunjukkan “model siapa yang dipanggil pengembang di suatu platform”. Saat memilih model, jangan langsung menyalin salah satu daftar. Nilailah berdasarkan jenis tugas dan cara Anda menghitung biaya. Daftar peringkat hanya membantu mempersempit pilihan, bukan menggantikan proses pemilihan model.
Ini bukan sekadar rangkuman peringkat. Artikel ini akan menjelaskan sampel, rentang waktu, dan batas penggunaan masing-masing daftar, lalu membahas pengaruh “harga satuan turun, penggunaan naik” terhadap struktur biaya. Terakhir, ada daftar 5 langkah untuk memilih model.
Ringkasan peringkat model open source: mengapa Kimi dan DeepSeek sama-sama nomor satu
Intinya: Menlo Ventures mengukur pengeluaran perusahaan, sedangkan OpenRouter mengukur jumlah permintaan di platformnya. Sampel, periode, dan objek yang dihitung pun berbeda.
Kedua data ini sering dibahas bersama, padahal “penyebut” yang digunakan sama sekali berbeda. Data Menlo Ventures berasal dari survei terhadap pengambil keputusan AI di perusahaan Amerika Serikat. Angkanya adalah estimasi survei, bukan hasil audit tagihan. Sementara itu, data OpenRouter berasal dari statistik permintaan di platformnya sendiri. Data tersebut hanya mencerminkan perilaku pengguna platform itu, bukan keseluruhan pasar.
| Peringkat | Yang diukur | Sampel/periode | Peringkat utama | Cocok untuk menilai |
|---|---|---|---|---|
| Laporan kondisi AI perusahaan 2026 dari Menlo Ventures | Pangsa pengeluaran perusahaan AS untuk model open source | Hampir 400 pengambil keputusan AI di perusahaan AS, disurvei pada 8–26 September 2026, laporan diterbitkan 3 November | Kimi 61%, DeepSeek 15%, GLM 11%, Meta Llama 7%, Qwen 3% | Preferensi pembelian perusahaan, alokasi anggaran, dan model yang masuk dalam kontrak resmi |
| Peringkat mingguan OpenRouter | Pangsa permintaan teks di platform | Platform OpenRouter, 26 Oktober–1 November | DeepSeek 29.8%, OpenAI 18.8%, Z.ai 11.9%, Qwen 5.6% (peringkat keenam) | Aktivitas pengembang, pemanggilan yang sensitif terhadap harga, dan popularitas di komunitas |
Dari tabel ini terlihat bahwa “peserta” kedua peringkat pun berbeda. Menlo hanya menghitung model open source, sedangkan OpenRouter juga memasukkan penyedia model tertutup seperti OpenAI dan Google. Membandingkan langsung persentase dari kedua daftar berarti mencampur ukuran yang berbeda.
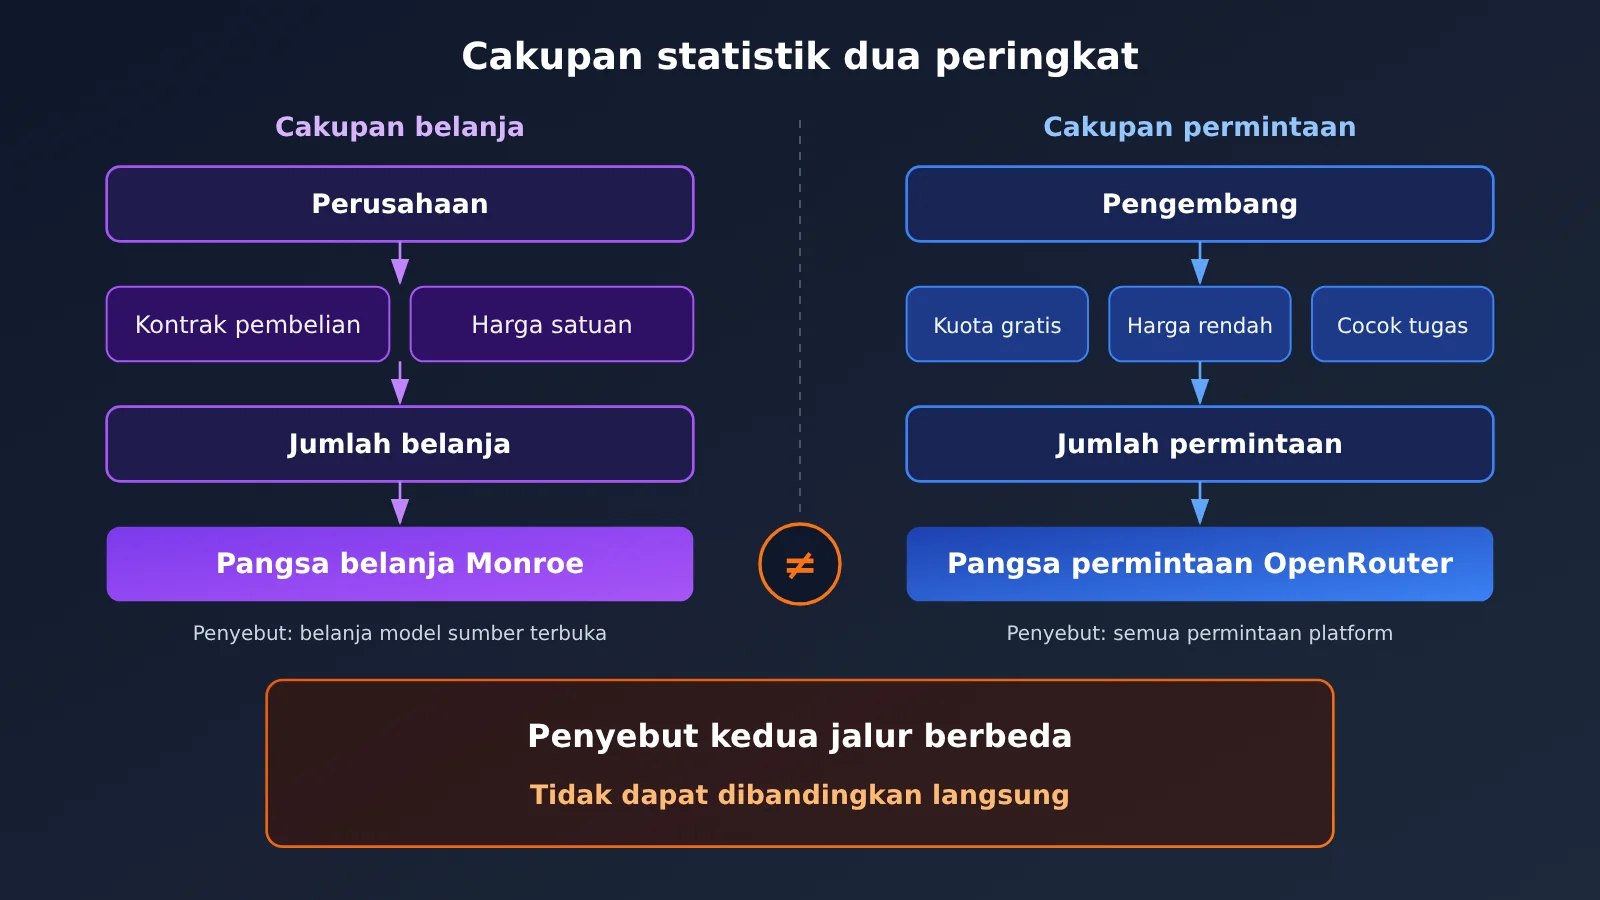
Cara membaca data belanja Menlo Ventures: Kimi menguasai 61% belanja model sumber terbuka
Kesimpulannya: data Menlo Ventures menunjukkan bahwa model sumber terbuka dari China sudah masuk dalam anggaran perusahaan AS, tetapi angkanya merupakan estimasi survei, bukan peringkat kemampuan.
Angka yang paling banyak menarik perhatian dalam laporan ini adalah: model China menyumbang 89% belanja model sumber terbuka perusahaan AS. Kimi sendiri menguasai 61%, disusul DeepSeek 15%, GLM 11%, dan Qwen 3%. Di antara model non-China, Meta Llama memperoleh 7%.
| Model | Pangsa belanja model sumber terbuka perusahaan AS | Hal yang perlu diperhatikan |
|---|---|---|
| Kimi | 61% | Pangsa tertinggi, mungkin terkait dengan saluran pembelian perusahaan dan harga per unit |
| DeepSeek | 15% | Peringkat kedua dalam belanja, tetapi lebih aktif dari sisi pemanggilan |
| GLM | 11% | Konsisten masuk dalam anggaran perusahaan |
| Meta Llama | 7% | Pangsa tertinggi di antara model sumber terbuka non-China |
| Qwen | 3% | Pangsa belanja lebih kecil, tetapi cukup terlihat dari sisi pemanggilan |
Gambaran besarnya akan membantu kita memahami angka-angka ini. Laporan tersebut memperkirakan belanja penerapan AI perusahaan secara global mencapai sekitar 176,8 miliar dolar AS per tahun, naik lebih dari 100 kali lipat dalam tiga tahun. Laboratorium AI terdepan menyumbang 69% belanja penerapan, sementara model sumber terbuka hanya mencakup 4% dari total belanja model. Jadi, “Kimi menguasai 61%” berarti 61% dari porsi kecil model sumber terbuka itu, bukan 61% dari seluruh pasar AI perusahaan.
Selain itu, data kuesioner bergantung pada perkiraan responden terhadap anggaran perusahaan masing-masing, dan hampir 400 sampelnya hanya mencakup perusahaan AS. Cara yang masuk akal untuk membacanya: data ini menunjukkan arah tren pembelian perusahaan, sedangkan persentase pastinya masih berupa estimasi survei yang perlu diverifikasi dengan lebih banyak data.
Cara membaca peringkat permintaan OpenRouter: DeepSeek meraih 29,8% permintaan
Kesimpulannya: peringkat mingguan OpenRouter menunjukkan popularitas pemanggilan model di kalangan developer platform tersebut. Datanya berguna untuk melihat tren, tetapi tidak mewakili pangsa pasar secara keseluruhan.
Pada pekan 26 Oktober hingga 1 November, DeepSeek menempati posisi pertama dengan pangsa 29,8% dari permintaan teks, naik 7% dibandingkan pekan sebelumnya. OpenAI berada di posisi kedua dengan 18,8%, pangsa Google turun dari 14,4%, Z.ai berada di posisi keempat dengan 11,9%, dan Qwen di posisi keenam dengan 5,6%.
| Informasi peringkat | Penyedia | Pangsa permintaan | Perubahan |
|---|---|---|---|
| Ke-1 | DeepSeek | 29,8% | Naik 7% dari pekan sebelumnya |
| Ke-2 | OpenAI | 18,8% | — |
| Turun | Turun dari 14,4% | Pangsa menurun | |
| Ke-4 | Z.ai | 11,9% | — |
| Ke-6 | Qwen | 5,6% | — |
Ada dua tren lain yang patut diperhatikan. Volume pemanggilan token model Tiongkok sudah melampaui model Amerika Serikat selama 27 pekan berturut-turut. Dari lima model dengan volume pemanggilan mingguan tertinggi, empat di antaranya berasal dari Tiongkok. Pada periode yang sama, DeepSeek meningkatkan modelnya ke DeepSeek V4.1-Flash-1017 tanpa mengubah cara pemanggilan API maupun harganya. Ini membuat biaya migrasi bagi developer yang sudah mengintegrasikannya tetap rendah.
Stabilitas juga perlu diperhatikan. Pada 3 November, layanan web dan API DeepSeek mengalami gangguan sebagian selama sekitar 1 jam. Volume pemanggilan yang tinggi tidak berarti layanan selalu tersedia. Inilah alasan perlunya “menyiapkan model cadangan” yang akan dibahas nanti. Setelah versi baru dirilis, periksa daftar model di konsol APIYI apiyi.com untuk memastikan ID model dan tarif yang berlaku.
Mengapa Peringkat Pengeluaran dan Permintaan Model Open Source Berlawanan
Kesimpulannya: perbedaan peringkat terutama disebabkan oleh lima faktor, yaitu harga satuan, cara pembelian, kuota gratis, kesesuaian tugas, dan cakupan platform. Ini tidak berarti salah satu daftar “salah”.
Porsi pengeluaran kira-kira setara dengan “volume pemanggilan × harga satuan”, ditambah pengaruh kontrak dan pembelian. Sementara itu, porsi permintaan hanya menghitung jumlah pemanggilan, tanpa melihat biayanya. Jika harga satuan sebuah model lebih tinggi dan perusahaan bersedia menandatangani kontrak pembelian, model tersebut akan berada lebih tinggi di daftar pengeluaran. Jika harganya rendah dan banyak digunakan pengembang, model tersebut akan lebih tinggi di daftar permintaan.
| Faktor | Pengaruh terhadap porsi pengeluaran | Pengaruh terhadap porsi permintaan |
|---|---|---|
| Harga satuan | Harga lebih tinggi membuat biaya lebih besar untuk penggunaan yang sama, sehingga porsi pengeluaran meningkat | Harga rendah menarik lebih banyak pengguna untuk mencoba, sehingga jumlah permintaan naik |
| Pembelian perusahaan | Kontrak, deployment privat, dan perjanjian layanan masuk ke pengeluaran | Tidak selalu melalui OpenRouter, sehingga tidak terlihat di platform |
| Kuota gratis | Pemanggilan gratis tidak menghasilkan pengeluaran | Pemanggilan gratis tetap dihitung sebagai permintaan |
| Kesesuaian tugas | Tugas dengan penggunaan token tinggi, seperti dokumen panjang dan Agent, meningkatkan biaya | Percakapan singkat dan tugas kecil secara massal meningkatkan jumlah permintaan |
| Cakupan platform | Hanya mencakup perusahaan AS yang disurvei | Hanya mencakup pengguna OpenRouter |
Dengan kerangka ini, Kimi mungkin lebih unggul dalam saluran pembelian perusahaan dan harga satuan, sehingga porsi pengeluarannya tinggi. DeepSeek memiliki harga satuan lebih rendah dan komunitas pengembang yang aktif, sehingga jumlah permintaannya besar. Ini adalah dugaan yang masuk akal berdasarkan cakupan data; kedua laporan itu sendiri tidak memberikan rincian untuk setiap faktor.
Ada satu detail lain yang sering terlewat: versi model, saluran akses, dan tingkat cache hit yang berbeda dapat menyebabkan perbedaan antara angka pengeluaran dan pemanggilan. Jika sebuah tim sering mendapatkan cache hit, jumlah permintaannya tetap dihitung, tetapi pengeluaran aktualnya bisa jauh lebih rendah.
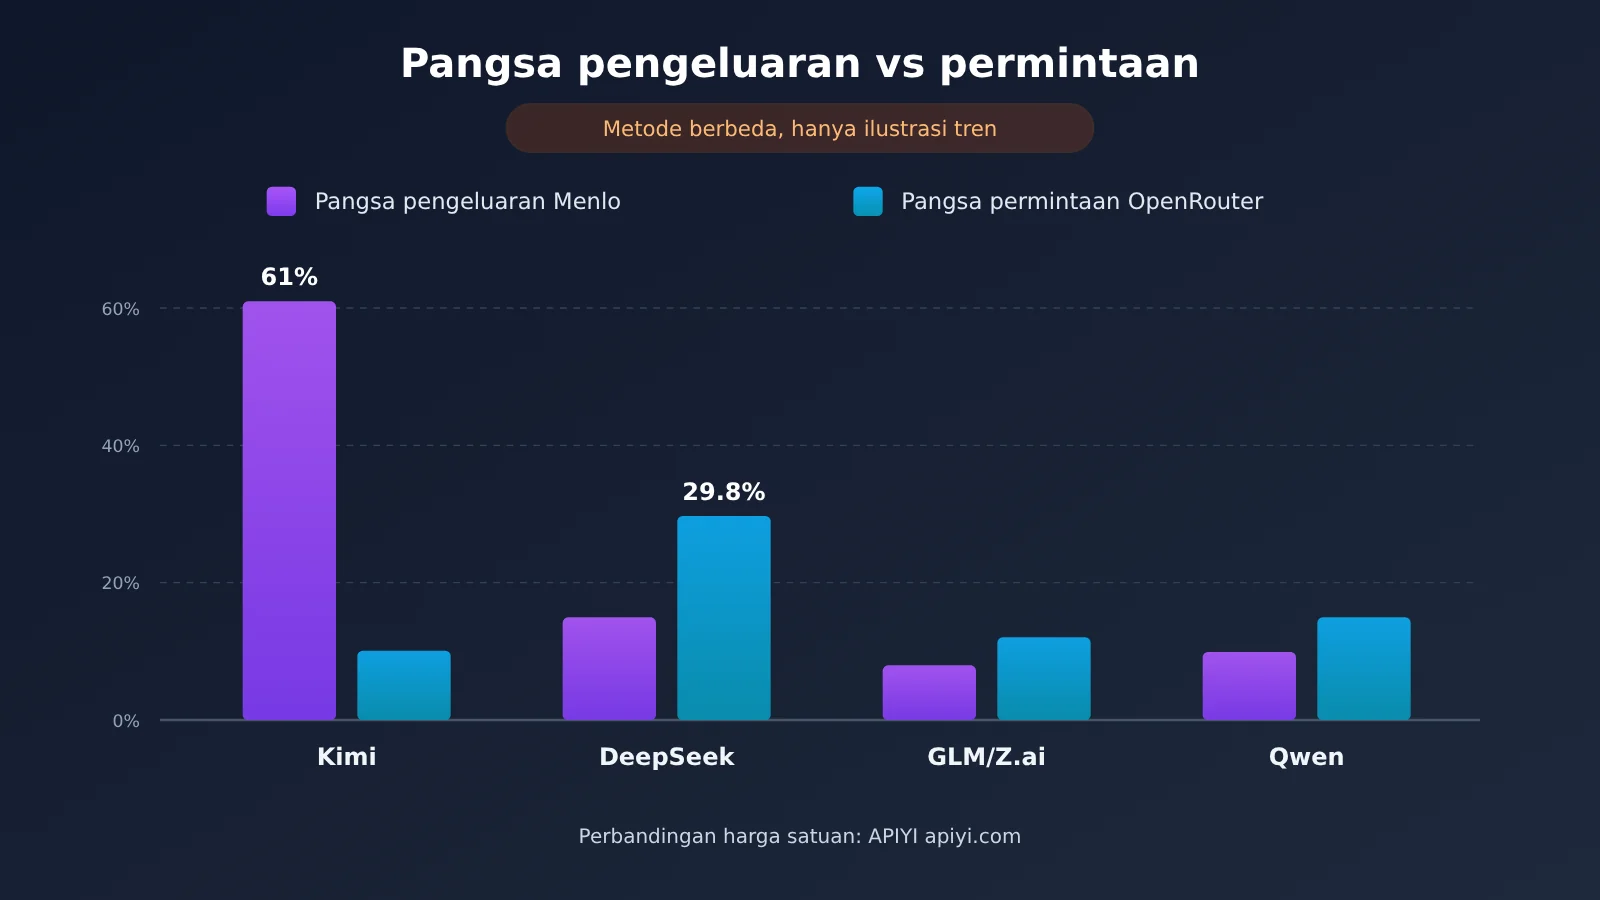
Harga dan penggunaan model open-source: apa arti penurunan harga sekitar 70% dan kenaikan penggunaan 22,5 kali lipat?
Kesimpulannya: turunnya harga per token tidak berarti total biaya ikut turun. Membandingkan “biaya untuk menyelesaikan satu tugas” lebih andal daripada membandingkan harga per juta token.
Laporan Menlo memuat sejumlah angka penting: harga rata-rata token turun dari 0.45 dolar AS/juta token menjadi 0.13 dolar AS/juta token, atau sekitar 70%. Pada periode yang sama, penggunaannya meningkat 22,5 kali lipat. Jika dihitung secara kasar berdasarkan kedua angka tersebut, total pengeluaran justru naik menjadi sekitar 6,5 kali lipat. Ini hanya perhitungan ilustratif berdasarkan rata-rata dalam laporan; situasi setiap tim bisa berbeda.
Gambaran pada model open-source lebih mencolok. Model open-source mencakup 19% penggunaan token perusahaan, tetapi hanya menyumbang 4% dari pengeluaran untuk model. Artinya, banyak token diproses oleh model open-source yang murah, tetapi sebagian besar uang tetap dibayarkan untuk model closed-source terdepan.
Bagi pengembang, turunnya harga per token akan mendorong lebih banyak pemanggilan model, terutama untuk Agent dan tugas batch. Biaya sebenarnya juga perlu memperhitungkan beberapa variabel berikut:
- Cache hit: Apakah petunjuk sistem yang berulang dan konteks panjang bisa dilayani dari cache, karena ini langsung menentukan harga sebenarnya.
- Panjang konteks: Tugas dengan dokumen panjang sering kali membutuhkan jauh lebih banyak token input daripada output.
- Jumlah percobaan ulang: Output yang tidak konsisten atau kesalahan format dapat memicu percobaan ulang dan membuat biaya berlipat.
- Jumlah putaran pemanggilan alat: Satu tugas Agent bisa melibatkan belasan putaran bolak-balik. Harga per token mungkin rendah, tetapi jumlah putarannya banyak.
Saat membandingkan harga, sebaiknya periksa dulu daftar harga dan metode penagihan model kandidat di konsol APIYI apiyi.com. Pastikan Anda memahami cara biaya input, output, dan cache dihitung secara terpisah. Lalu jalankan beberapa sampel menggunakan tugas Anda sendiri dan hitung “berapa biaya untuk menyelesaikan satu tugas”. Angka ini lebih berguna sebagai acuan daripada harga satuan dalam daftar.
Cara memilih model open source: gunakan papan peringkat untuk menyaring, lalu tentukan berdasarkan tugas
Intinya: papan peringkat membantu menyusun daftar kandidat. Keputusan akhir harus didasarkan pada kesesuaian tugas, biaya, stabilitas, dan pengujian dengan sampel kecil.
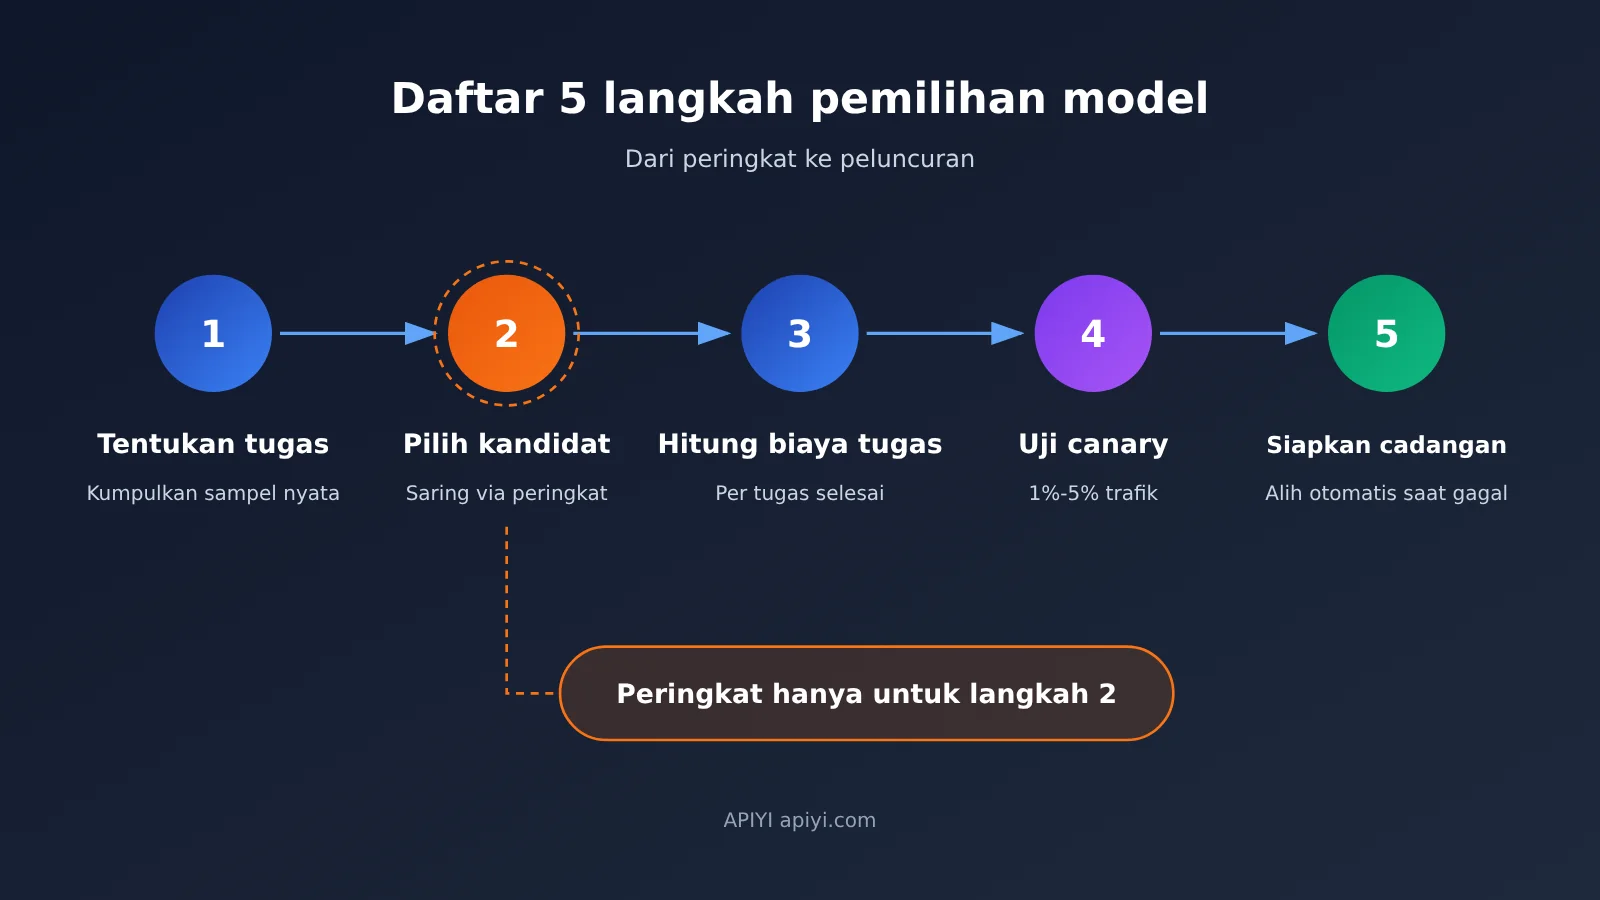
Proses pemilihan bisa dilakukan dengan urutan “tugas → biaya → stabilitas → validasi → cadangan”. Tabel berikut merangkum pertanyaan dan cara memeriksa setiap aspek.
| Aspek | Pertanyaan yang perlu diajukan | Cara memeriksa | Dampak pada biaya |
|---|---|---|---|
| Kesesuaian tugas | Apakah tugas utamanya pemrograman, dokumen panjang, multimodal, atau pemanggilan alat oleh Agent? | Siapkan 30–100 sampel tugas nyata, lalu evaluasi hasilnya secara manual | Kesesuaian yang rendah meningkatkan percobaan ulang dan perbaikan manual |
| Harga satuan dan cache | Berapa biaya input, output, dan cache hit masing-masing? | Periksa daftar model dan ketentuan penagihan di konsol, lalu hitung tingkat cache hit | Menentukan harga aktual per juta token |
| Konteks | Berapa panjang input terpanjang? Apakah hasilnya menurun ketika input sangat panjang? | Gunakan dokumen nyata terpanjang untuk menguji pemotongan dan kemampuan menemukan kembali informasi | Konteks yang panjang langsung meningkatkan jumlah token input |
| Batas laju | Apakah batas konkurensi dan permintaan per menit sudah mencukupi? | Lakukan uji beban berdasarkan lalu lintas puncak | Saat terkena batas laju, permintaan harus diantrekan atau dialihkan, sehingga memengaruhi latensi |
| Ketersediaan wilayah | Apakah model dapat diakses secara stabil dari wilayah deployment? | Lakukan pemanggilan langsung dari wilayah produksi | Jika tidak tersedia, perlu mencari jalur lain |
| Stabilitas | Apakah ada gangguan baru-baru ini? Berapa lama pemulihannya? | Periksa riwayat gangguan dan amati log tingkat kesalahan | Gangguan menimbulkan biaya percobaan ulang dan kerugian bisnis |
Membandingkan beberapa model adalah bagian yang paling menyita waktu. Jika setiap kandidat harus didaftarkan dan diintegrasikan dengan SDK secara terpisah, proses integrasinya saja bisa memakan waktu beberapa hari. Melalui APIYI apiyi.com, satu kunci API dapat digunakan untuk memanggil model dari berbagai penyedia, seperti OpenAI, Claude, Gemini, DeepSeek, dan Kimi. Antarmukanya kompatibel dengan format OpenAI: atur base_url ke https://api.apiyi.com/v1, lalu ubah parameter model dalam permintaan untuk beralih model. Dengan begitu, sampel yang sama bisa cepat dijalankan untuk perbandingan.
Untuk stabilitas, jangan hanya mengandalkan pengumuman penyedia. Gangguan DeepSeek pada 3 November mengingatkan kita bahwa model apa pun bisa sewaktu-waktu tidak tersedia. Di konsol APIYI apiyi.com, penggunaan dan log pemanggilan dapat dilihat per model. Tingkat kesalahan, latensi, dan konsumsi token semuanya tercatat, sehingga berguna untuk mengamati kinerja nyata kandidat model pada tahap canary. Platform ini menggunakan deployment multi-node dan perutean cerdas, serta menyediakan fallback otomatis. Di sisi aplikasi, siapkan juga model cadangan agar sistem bisa beralih saat model utama mengalami kesalahan. Dengan begitu, dampak kegagalan satu titik bisa ditekan.
Sebaiknya mulai perilisan canary dengan 1%–5% lalu lintas nyata, lalu pantau tingkat kesalahan, latensi, dan biaya per tugas selama beberapa hari. Setelah datanya stabil, tingkatkan lalu lintas secara bertahap. Jangan langsung beralih sepenuhnya hanya berdasarkan papan peringkat.
FAQ Seputar Peringkat Model Open Source
Intinya: lima pertanyaan berikut membahas kesalahpahaman yang paling sering muncul saat membaca peringkat model open source.
Q1: Apakah pangsa pengeluaran Kimi sebesar 61% berarti model Kimi lebih baik?
Tidak. Pangsa pengeluaran menunjukkan ke mana uang dibelanjakan. Angka ini dipengaruhi oleh harga satuan, kontrak pembelian perusahaan, dan saluran distribusi, sehingga tidak berkaitan langsung dengan kemampuan model. Selain itu, data Menlo merupakan estimasi survei yang hanya mencakup pengeluaran model open source oleh perusahaan di Amerika Serikat. “Pengeluaran tertinggi” tidak berarti “kemampuan terbaik”; kemampuan perlu dinilai berdasarkan tugas Anda sendiri.
Q2: Apakah peringkat permintaan OpenRouter bisa mewakili pembelian perusahaan?
Tidak. OpenRouter mencatat pangsa permintaan di platformnya sendiri, dengan pengguna yang sebagian besar merupakan pengembang dan tim kecil hingga menengah. Kontrak langsung perusahaan, deployment privat, dan saluran lain tidak termasuk dalam statistiknya. Data ini cocok untuk mengamati popularitas di kalangan pengembang dan tren pemanggilan yang sensitif terhadap harga, tetapi tidak cocok untuk menyimpulkan distribusi anggaran perusahaan.
Q3: Apakah model dengan harga satuan rendah pasti memiliki biaya total yang lebih rendah?
Belum tentu. Jika model yang lebih murah membutuhkan lebih banyak percobaan ulang, petunjuk yang lebih panjang, atau lebih banyak putaran pemanggilan alat, total penggunaan token justru bisa lebih tinggi. Sebaiknya hitung biaya berdasarkan “penyelesaian satu tugas”: lihat penggunaan token dan log biaya setiap pemanggilan di konsol APIYI apiyi.com, lalu bandingkan total biaya berbagai model untuk menyelesaikan kumpulan tugas yang sama.
Q4: Bisakah model open source sepenuhnya menggantikan model closed source?
Tergantung tugasnya. Data Menlo menunjukkan bahwa model open source menangani 19% token perusahaan, tetapi hanya mencakup 4% pengeluaran. Ini menunjukkan bahwa banyak tim menyerahkan tugas massal dan rutin kepada model open source, sementara tugas kompleks tetap ditangani model closed source terdepan. Pendekatan yang lebih aman adalah menggunakan keduanya: melalui APIYI apiyi.com, akses model open source dan closed source dengan satu kunci API, lalu arahkan tugas sesuai tingkat kesulitannya.
Q5: Seberapa sering sebaiknya memeriksa peringkat model open source?
Peringkat mingguan bisa ditinjau sebulan sekali untuk melihat tren, bukan mengejar perubahan dalam satu minggu. Saat laporan survei tahunan atau kuartalan terbit, baca dengan saksama dan perhatikan apakah cakupan pengukuran atau sampelnya berubah. Yang benar-benar memengaruhi keputusan Anda adalah pemantauan berkelanjutan terhadap metrik bisnis sendiri, seperti tingkat kesalahan, biaya per tugas, dan umpan balik pengguna. Sebaiknya tinjau metrik ini setiap minggu.
Memahami Peringkat Model Open-Source: Daftar Pilihan dalam 5 Langkah
Kesimpulannya: kedua peringkat mengukur hal yang berbeda. Mulailah dengan memahami metriknya, periksa sampelnya, lalu uji dengan tugas Anda sendiri.
Ringkasan poin utama:
- Pengeluaran ≠ pemanggilan: Menlo mengukur pengeluaran perusahaan, sedangkan OpenRouter mengukur permintaan di platformnya. Basis pengukurannya berbeda, jadi tidak bisa langsung dibandingkan.
- Survei ≠ audit: Data Menlo merupakan estimasi dari survei terhadap hampir 400 pengambil keputusan perusahaan di AS. Data OpenRouter hanya mewakili platformnya sendiri.
- Murah ≠ hemat: Harga satuan turun sekitar 70%, tetapi penggunaan naik 22,5 kali lipat sehingga total biaya justru meningkat. Hitung biaya berdasarkan tugas.
- Populer ≠ stabil: Model dengan jumlah pemanggilan tertinggi pun bisa mengalami gangguan. Siapkan alternatif sejak awal.
- Peringkat hanya membantu mempersempit kandidat, bukan memilihkan model untuk Anda.
Daftar berikut bisa langsung digunakan saat memilih model berikutnya:
- Tentukan tugas: Jelaskan jenis tugas utama (pemrograman, dokumen panjang, multimodal, Agent), lalu siapkan 30-100 sampel nyata beserta kriteria evaluasinya.
- Susun kandidat: Ambil masing-masing 2-3 model dari peringkat pengeluaran dan permintaan, lalu tambahkan 1 model closed-source sebagai pembanding. Batasi total kandidat menjadi 3-5 model.
- Hitung biaya per tugas: Jalankan semua kandidat dengan kumpulan sampel yang sama. Catat penggunaan token, cache hit, dan jumlah percobaan ulang, lalu hitung biaya per tugas dan skor kualitasnya.
- Jalankan canary: Arahkan 1%-5% lalu lintas nyata ke model terpilih, lalu amati tingkat kesalahan, latensi, dan biaya selama beberapa hari. Tingkatkan lalu lintas setelah memenuhi kriteria.
- Siapkan cadangan: Konfigurasikan setidaknya satu model cadangan dari penyedia berbeda, tetapkan aturan peralihan, dan lakukan simulasi secara berkala.
Jika ingin menyelesaikan langkah 3 hingga 5 melalui satu tempat, Anda bisa menggunakan satu kunci untuk mengakses model kandidat melalui APIYI apiyi.com. Bandingkan harga, penggunaan, dan log di konsol, lalu gunakan fitur fallback otomatis platform untuk mengatur peralihan ke model cadangan. Pengguna baru mendapat kuota uji coba gratis, cocok untuk validasi awal dengan sampel kecil.
Sumber data artikel
- Laporan Menlo Ventures tentang Kondisi AI Perusahaan 2026: diterbitkan pada 3 November 2026
- Tautan:
menlovc.com -
Keterangan: Pengeluaran AI perusahaan, pangsa pengeluaran model open-source, dan perubahan harga token merupakan estimasi berdasarkan survei
-
Peringkat Model OpenRouter: peringkat mingguan 26 Oktober-1 November 2026
- Tautan:
openrouter.ai/rankings - Keterangan: Pangsa permintaan teks dan tren pemanggilan token hanya mewakili platform tersebut
Penulis: Tim Teknis APIYI
Diskusi teknis: Jika menemui masalah terkait harga, pembatasan laju, atau peralihan saat memilih model, hubungi kami melalui halaman utama APIYI apiyi.com. Materi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com