Catatan penulis: Berangkat dari analogi Lai Jie dari Stardust Intelligence, “jangan tagih saya biaya token setiap kali mengencangkan satu sekrup”, artikel ini mengulas tahap mana dalam alur kerja AI yang sebaiknya ditangani program tetap dan mana yang benar-benar membutuhkan penilaian Model Bahasa Besar.
Pada 5 November 2026, rubrik “Perusahaan Keberagaman” Aifaner menerbitkan wawancara eksklusif dengan Lai Jie, pendiri sekaligus CEO Stardust Intelligence. Salah satu pernyataannya sering dikutip oleh para pengembang aplikasi AI: “Saya ingin pekerjaan mengencangkan sekrup ditangani program tetap yang terus berjalan 24 jam sehari, bukan menagih saya biaya token setiap kali mengencangkan satu sekrup.”
Ini bukan sekadar kelakar. Dalam wawancara itu, Lai Jie membahas pembagian tugas pada robot: model AI yang terintegrasi dengan tubuh robot menangani gerakan fisik, lalu menggunakan bahasa alami untuk bertanya kepada Model Bahasa Besar dasar ketika menemui masalah. Jika diterapkan pada alur kerja perangkat lunak, pemikiran ini menjawab pertanyaan praktis: tahap mana saja dalam aplikasi AI yang sebenarnya tidak perlu memanggil Model Bahasa Besar?
Nilai utama: Artikel ini menerjemahkan pandangan tentang robot dalam wawancara tersebut menjadi panduan untuk menentukan batas pemanggilan model dalam alur kerja perangkat lunak. Ada 5 jenis tahapan yang tidak perlu memanggil Model Bahasa Besar, seperangkat kriteria penilaian berlapis, serta contoh kode perutean yang bisa langsung diadaptasi. Perlu dicatat, robot dan perangkat lunak adalah dua jenis sistem yang berbeda. Penerapan di bawah ini merupakan penalaran berdasarkan analogi, sehingga hasilnya perlu diuji dengan penggunaan aktual Anda sendiri.
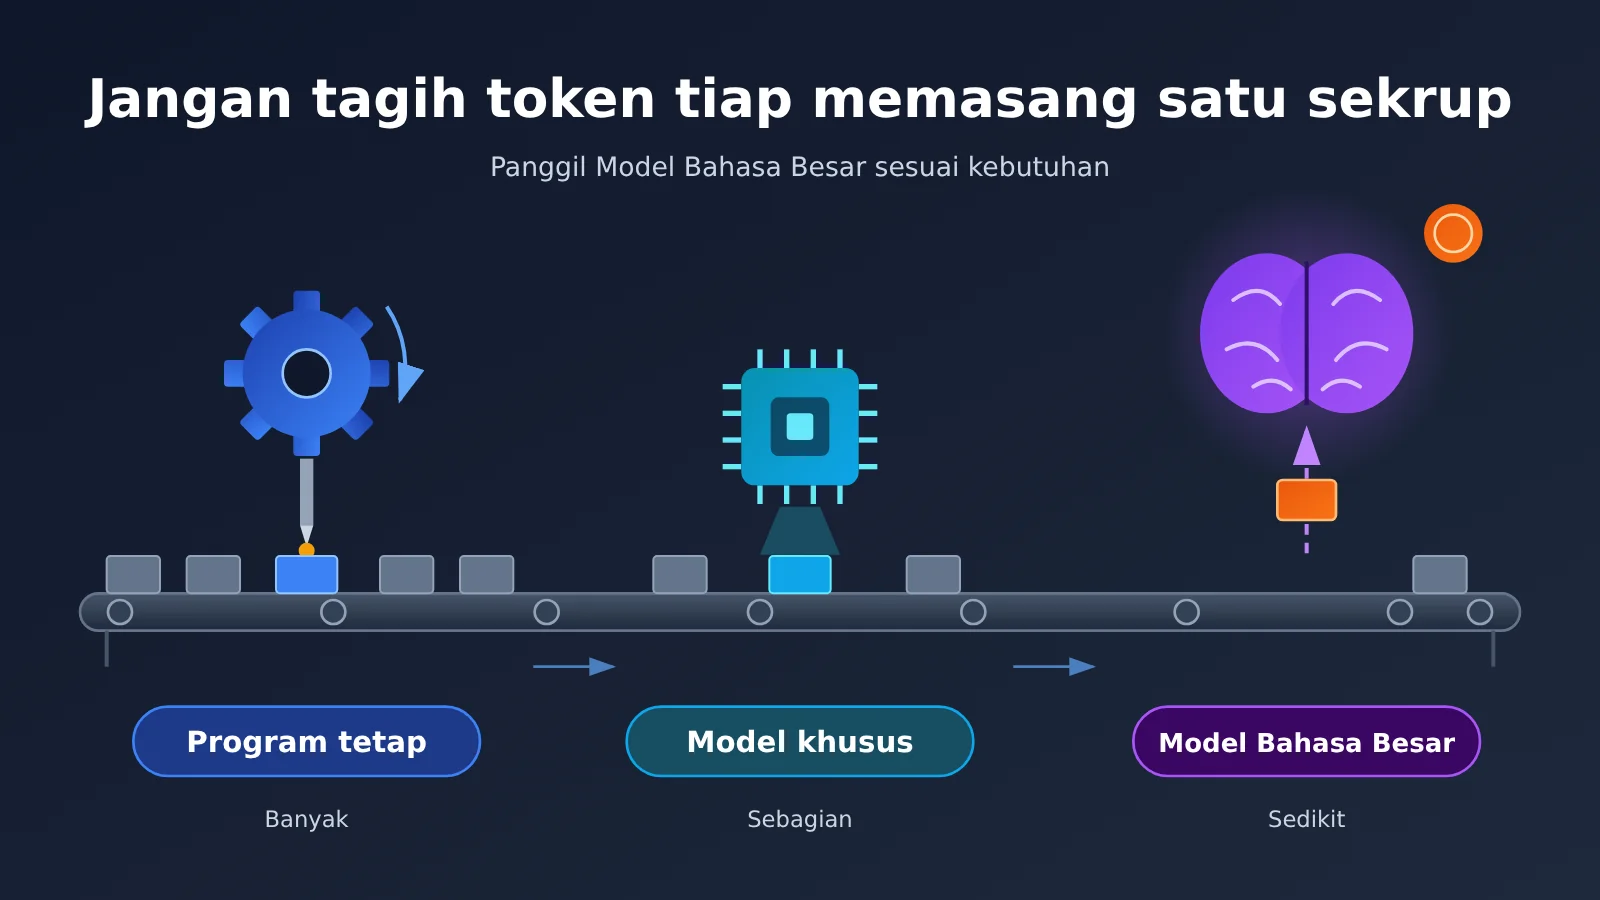
Sekilas: “Jangan kenakan biaya token setiap kali memasang sekrup”
Pernyataan ini muncul pada pertanyaan terakhir dalam wawancara. Saat ditanya pekerjaan apa yang ia harap bisa diambil alih robot dari manusia, Lai Jie dengan tegas mengatakan bahwa ia tidak ingin robot “masuk pabrik untuk memasang sekrup”. Menurutnya, nilai robot terletak pada kemampuan yang luas. Dari sisi biaya, pekerjaan berulang juga tidak sepadan jika setiap gerakan dikenai biaya token.
| Informasi | Detail |
|---|---|
| Sumber | Wawancara ke-15 dalam rubrik “Perusahaan Keberagaman” di ifanr |
| Tanggal terbit | 5 November 2026 |
| Narasumber | Lai Jie, pendiri dan CEO Stardust Intelligence, yang sebelumnya merupakan karyawan pertama di laboratorium robotika Tencent Robotics X |
| Pandangan utama | Gerakan berulang sebaiknya ditangani program tetap, tanpa biaya token untuk setiap gerakan |
| Pembagian tugas | Model embodied menjalankan tugas fisik dan bertanya kepada Model Bahasa Besar dasar dalam bahasa alami saat menemui masalah |
| Pelajaran untuk perangkat lunak | Alur kerja AI perlu menetapkan batas pemanggilan antara program tetap, model khusus, dan Model Bahasa Besar dasar |
Perlu ditekankan bahwa isi wawancara tersebut merupakan pandangan sang pendiri. Artikel itu tidak menyertakan data pengukuran biaya maupun verifikasi dari pihak ketiga. Yang kita ambil adalah logika pembagian tugasnya, bukan kesimpulan spesifik apa pun.
Analogi Lai Jie tentang “menelepon ibu lewat video”: Model Bahasa Besar hanya melengkapi konteks
Dalam wawancara, ada analogi yang lebih menjelaskan pembagian tugas daripada “memasang sekrup”. Lai Jie bercerita bahwa ia tidak bisa memasak, tetapi ingin mencobanya. Ia pun menelepon ibunya lewat video. Ibunya bisa berkata, “Pertama, tuang sedikit minyak ke wajan panas,” tanpa perlu menjelaskan botol mana yang berisi minyak. Kalau ada pertanyaan, ia bisa bertanya lagi. Intinya, ibu membantu melengkapi pengetahuan kontekstual, tetapi ia sendiri harus bisa menuangkan minyak karena ibunya tidak bisa melakukannya dari seberang telepon.
Dalam robotika, model yang terintegrasi dengan tubuh robot harus mampu merasakan sendiri parameter fisik seperti berat, kekuatan jepitan, dan apakah cengkeramannya sudah stabil. Model itu baru bertanya kepada Model Bahasa Besar dasar untuk masalah seperti “Bagaimana jika jepitannya kurang kuat dan agak tidak stabil?” Menurut Lai Jie, melatih Model Bahasa Besar dasar dengan informasi sentuhan “bukan tidak mungkin, tetapi biayanya tidak sepadan dan bandwidth komunikasi juga bisa menjadi masalah”. Ia menambahkan bahwa ini bukan sekadar pembagian lapisan, melainkan lebih seperti sistem agen ala koloni semut: kemampuan setiap agen mungkin tidak terlalu kuat, tetapi ketika digabungkan, hasilnya sangat tangguh.
| Peran dalam sistem robot | Tanggung jawab dalam wawancara | Peran analog dalam alur kerja perangkat lunak |
|---|---|---|
| Program tetap | Memasang sekrup berulang selama 24 jam | Mesin aturan, regex, skrip, kueri basis data |
| Model yang terintegrasi dengan tubuh robot | Melakukan tindakan fisik, merasakan parameter, menerjemahkan kondisi ke bahasa alami | Model kecil khusus untuk klasifikasi, ekstraksi, pencarian vektor, dan sebagainya |
| Model Bahasa Besar dasar | Melengkapi pengetahuan kontekstual, memberikan solusi untuk masalah sulit | Penalaran kompleks, generasi terbuka, pengambilan keputusan untuk kondisi tidak biasa |
| Sistem operasi AOS | Mengemas kemampuan menjadi modul keterampilan, lalu menyesuaikannya dengan Model Bahasa Besar dan Agent | Lapisan orkestrasi alur kerja, lapisan pemanggilan alat, router |
Tabel pemetaan ini adalah interpretasi dalam artikel, bukan kutipan langsung dari wawancara. Robotika berkaitan dengan kontrol waktu nyata di dunia fisik dan keterbatasan bandwidth komunikasi, sedangkan alur kerja perangkat lunak lebih banyak dipengaruhi oleh biaya token, latensi, dan stabilitas. Jadi, hambatan keduanya tidak sepenuhnya sama.
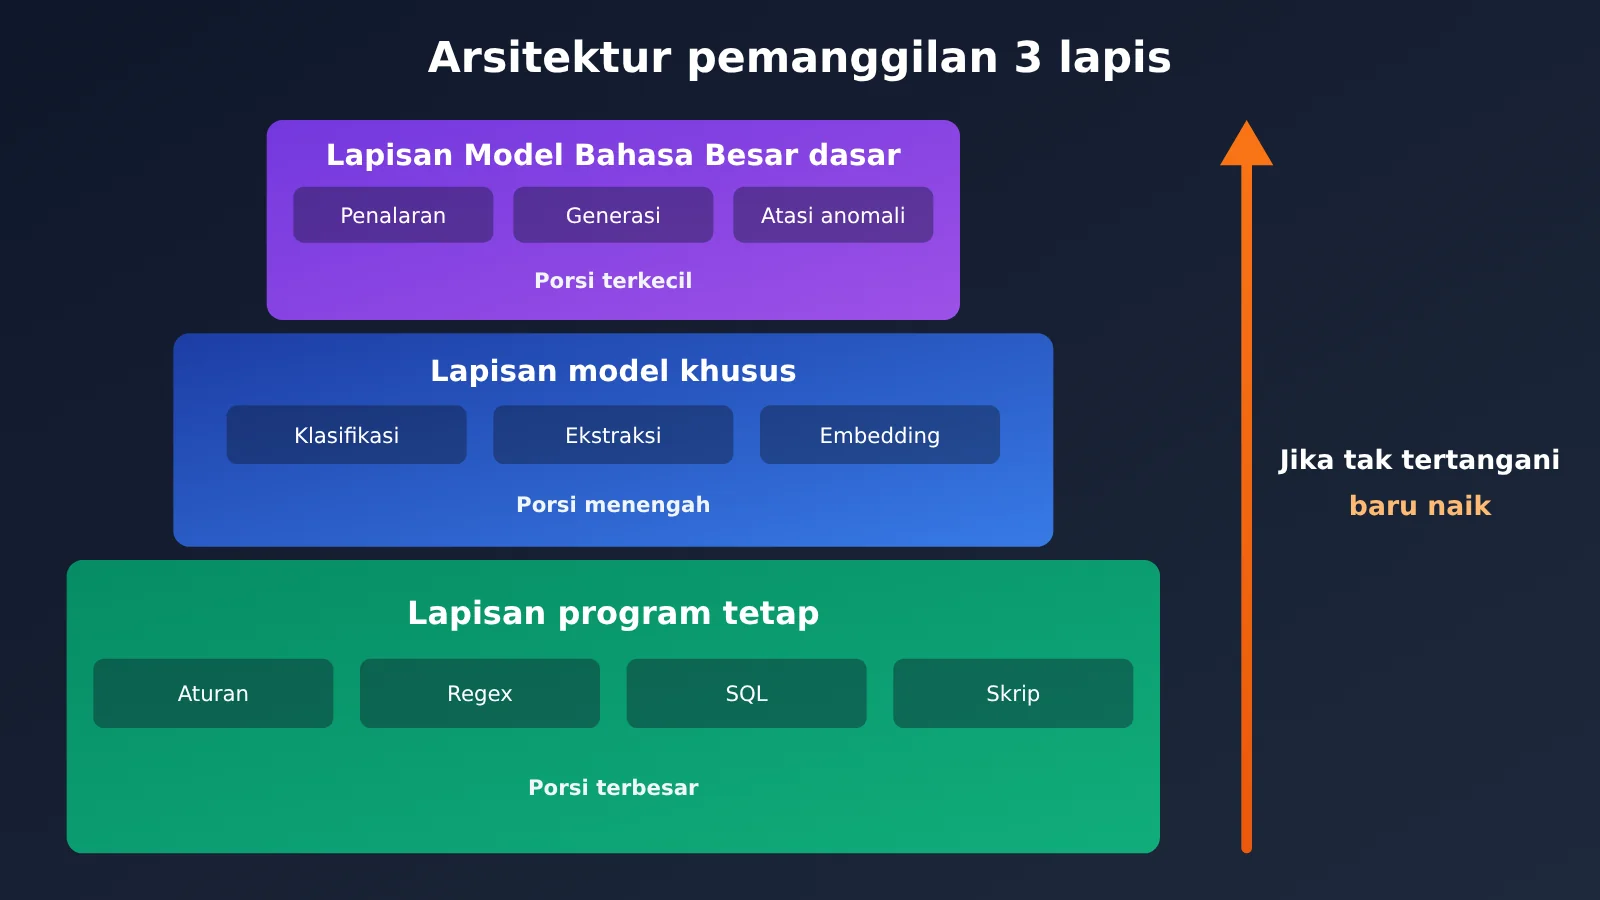
Bagian aplikasi AI mana yang tidak perlu memanggil Model Bahasa Besar: 5 kriteria penilaian
Banyak tim yang membuat Agent versi pertama terbiasa menyerahkan semua langkah kepada Model Bahasa Besar: validasi format, konversi tanggal, bahkan “memeriksa apakah sebuah field kosong” pun dibuat menjadi petunjuk. Cara ini memang cepat untuk membuat prototipe. Namun, setelah aplikasi diluncurkan, setiap permintaan membuat kita membayar untuk pekerjaan yang hasilnya sudah pasti, sekaligus menambah variasi yang tidak perlu.
Dengan memakai analogi “memasang sekrup”, kita bisa menggunakan 5 kriteria berikut untuk menentukan apakah suatu langkah layak memanggil Model Bahasa Besar.
| Kriteria | Cenderung menggunakan program tetap | Cenderung menggunakan model khusus | Cenderung menggunakan Model Bahasa Besar dasar |
|---|---|---|---|
| Apakah input terstruktur? | Field tetap, format jelas | Teks semi-terstruktur | Bahasa alami yang terbuka |
| Apakah output hanya punya satu jawaban? | Ada satu jawaban yang benar | Kategori terbatas | Ada beberapa jawaban yang masuk akal |
| Bisakah semua aturan dijabarkan? | Bisa ditulis sebagai if/else | Banyak aturan, tetapi polanya stabil | Aturan tidak bisa dijabarkan seluruhnya |
| Dampak kesalahan | Harus tanpa kesalahan | Sedikit kesalahan dapat diterima dan ditinjau ulang | Perlu pertimbangan menyeluruh |
| Frekuensi pemanggilan | Sangat tinggi, dijalankan setiap kali | Tinggi | Rendah, dipicu sesuai kebutuhan |
Langkah “memasang sekrup” yang cocok diserahkan ke program tetap
Beberapa jenis langkah berikut biasanya tergolong “memasang sekrup”: hasilnya pasti dan pekerjaannya berulang. Menggunakan Model Bahasa Besar justru bisa mengurangi stabilitas:
- Validasi dan pembersihan format: pemeriksaan email, nomor ponsel, struktur JSON, dan field wajib cukup dilakukan dengan regex dan validasi Schema.
- Kueri dan perhitungan data: status pesanan, jumlah stok, dan total nilai sebaiknya diambil langsung dari database atau antarmuka bisnis, bukan “diperkirakan” oleh Model Bahasa Besar.
- Output dengan template tetap: SMS pemberitahuan, tanda terima standar, dan header laporan cukup dibuat dengan mengisi variabel melalui template engine.
- Kontrol alur dan percobaan ulang: percabangan, percobaan ulang saat timeout, serta pembatasan laju dan antrean merupakan logika pada lapisan orkestrasi yang tidak memerlukan model.
- Pencarian cache yang sering berulang: ketika pertanyaan yang sama terus muncul, periksa cache atau basis FAQ terlebih dahulu dan langsung kembalikan hasilnya jika tersedia.
Langkah yang benar-benar membutuhkan penilaian Model Bahasa Besar
Sebaliknya, tugas yang benar-benar layak diserahkan kepada Model Bahasa Besar dasar adalah “pertanyaan yang hanya bisa dijawab oleh ibu di ujung telepon”: maksud pengguna yang belum jelas dan perlu diklarifikasi, penarikan kesimpulan dari beberapa sumber, penanganan kondisi tak terduga yang belum tercakup aturan, atau pembuatan konten kreatif. Kesamaan tugas-tugas ini adalah jawabannya tidak tunggal, aturannya tidak bisa dijabarkan seluruhnya, dan frekuensi kemunculannya relatif rendah.
Model khusus berada di antara keduanya. Tugas seperti klasifikasi maksud, ekstraksi entitas, analisis sentimen, dan vektorisasi teks sering kali bisa ditangani oleh model yang lebih kecil. Model ini bisa dipahami sebagai “model embodied” versi perangkat lunak: menyelesaikan tugas yang mampu ditanganinya sendiri, lalu merangkum kasus yang tidak bisa ditangani menjadi pertanyaan yang jelas untuk diteruskan ke lapisan di atasnya.
Contoh desain alur kerja AI berlapis: cegah pemanggilan Model Bahasa Besar yang tidak perlu
Berikut contoh alur kerja umum untuk “pemrosesan tiket layanan pelanggan otomatis”, yang menunjukkan cara menetapkan batas pemanggilan model di setiap langkah. Ini adalah contoh desain, bukan data pengujian dari proyek nyata.
| Langkah alur kerja | Lapisan yang bertanggung jawab | Cara penanganan | Mengonsumsi token |
|---|---|---|---|
| Validasi kolom tiket | Program tetap | Validasi skema, langsung kembalikan tiket jika ada kolom yang kurang | Tidak |
| Memeriksa status pesanan dan pengiriman | Program tetap | Memanggil antarmuka basis data bisnis | Tidak |
| Pencocokan pertanyaan umum | Program tetap / model khusus | Utamakan aturan kata kunci, gunakan pencarian vektor sebagai cadangan | Sedikit |
| Klasifikasi maksud | Model khusus | Model kecil menghasilkan kategori dari pilihan yang terbatas | Sedikit |
| Penanganan keluhan kompleks dan kasus tidak biasa | Model Bahasa Besar dasar | Menghasilkan saran penanganan berdasarkan konteks pesanan | Ya |
| Pengisian templat balasan | Program tetap | Mesin templat menghasilkan teks akhir | Tidak |
Seperti terlihat, hanya satu dari 6 langkah yang wajib memanggil Model Bahasa Besar dasar. Besarnya penghematan token, perubahan tingkat keberhasilan, dan perubahan latensi bergantung pada pola trafik serta cakupan aturan. Semua itu perlu dievaluasi menggunakan log aktual.
Contoh minimalis: aturan diutamakan, model sebagai cadangan
Kode berikut menunjukkan konsep dasar perutean berlapis: permintaan rutin ditangani dengan aturan terlebih dahulu, lalu sisanya diklasifikasikan oleh model kecil. Hanya kasus yang kompleks yang diteruskan ke Model Bahasa Besar. Nama model hanya contoh; gunakan daftar model yang tersedia di platform sebagai acuan.
import re
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka APIYI yang kompatibel dengan OpenAI
)

def handle(query: str) -> str:
    # Lapisan pertama: program tetap; jangan panggil model jika aturan sudah cukup
    if re.search(r"(订单号|单号)\s*[::]?\s*\d{8,}", query):
        return "已为您查询订单状态(走业务接口,不消耗 token)"
    # Lapisan kedua: model kecil mengklasifikasikan maksud
    intent = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": f"只输出类别(咨询/投诉/其他):{query}"}],
        max_tokens=5,
    ).choices[0].message.content.strip()
    if intent != "投诉":
        return f"已归类为:{intent},转入标准流程"
    # Lapisan ketiga: panggil Model Bahasa Besar dasar hanya untuk keluhan kompleks
    return client.chat.completions.create(
        model="claude-sonnet-4",
        messages=[{"role": "user", "content": f"请给出投诉处理建议:{query}"}],
    ).choices[0].message.content
Lihat kode implementasi lengkap dengan pencatatan penggunaan
import re
import time
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SMALL_MODEL = "gpt-4o-mini"       # Contoh: model kecil untuk klasifikasi/ekstraksi
LARGE_MODEL = "claude-sonnet-4"   # Contoh: Model Bahasa Besar untuk penalaran kompleks

@dataclass
class UsageLog:
    records: list = field(default_factory=list)

    def add(self, layer: str, tokens: int, latency: float):
        self.records.append({"layer": layer, "tokens": tokens, "latency": latency})

    def summary(self):
        result = {}
        for r in self.records:
            s = result.setdefault(r["layer"], {"count": 0, "tokens": 0, "latency": 0.0})
            s["count"] += 1
            s["tokens"] += r["tokens"]
            s["latency"] += r["latency"]
        return result

log = UsageLog()

RULES = [
    (re.compile(r"(订单号|单号)\s*[::]?\s*\d{8,}"), "order_lookup"),
    (re.compile(r"(营业时间|几点开门)"), "faq_hours"),
]

def rule_layer(query: str):
    for pattern, action in RULES:
        if pattern.search(query):
            return action
    return None

def call_model(model: str, prompt: str, layer: str, max_tokens: int = 512) -> str:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    tokens = resp.usage.total_tokens if resp.usage else 0
    log.add(layer, tokens, time.time() - start)
    return resp.choices[0].message.content.strip()

def handle(query: str) -> str:
    start = time.time()
    action = rule_layer(query)
    if action:
        log.add("rule", 0, time.time() - start)
        return f"[规则层] 执行动作:{action}"

    intent = call_model(
        SMALL_MODEL,
        f"只输出一个类别(咨询/投诉/其他),不要解释:{query}",
        layer="small",
        max_tokens=5,
    )
    if "投诉" not in intent:
        return f"[专用模型层] 归类为:{intent}"

    return call_model(
        LARGE_MODEL,
        f"你是资深客服主管,请针对以下投诉给出处理建议:{query}",
        layer="large",
    )

if __name__ == "__main__":
    for q in ["订单号:2026110612345 到哪了", "你们营业时间是?", "收到的商品破损,客服一直不回复"]:
        print(handle(q))
    print(log.summary())
🚀 Saran untuk mulai cepat: Agar kesimpulan dari perutean berlapis dapat dipercaya, gunakan antarmuka yang sama untuk beralih model di tiap lapisan dan catat pemakaiannya. Melalui APIYI apiyi.com, Anda bisa menggunakan satu kunci API untuk memanggil model kecil maupun Model Bahasa Besar, lalu membandingkan konsumsi token tiap lapisan dengan statistik penggunaan platform. Pengguna baru dapat memanfaatkan kuota uji coba gratis untuk memvalidasi prototipe.
Analisis dampak: 「Jangan tagih saya token untuk setiap sekrup yang dipasang」
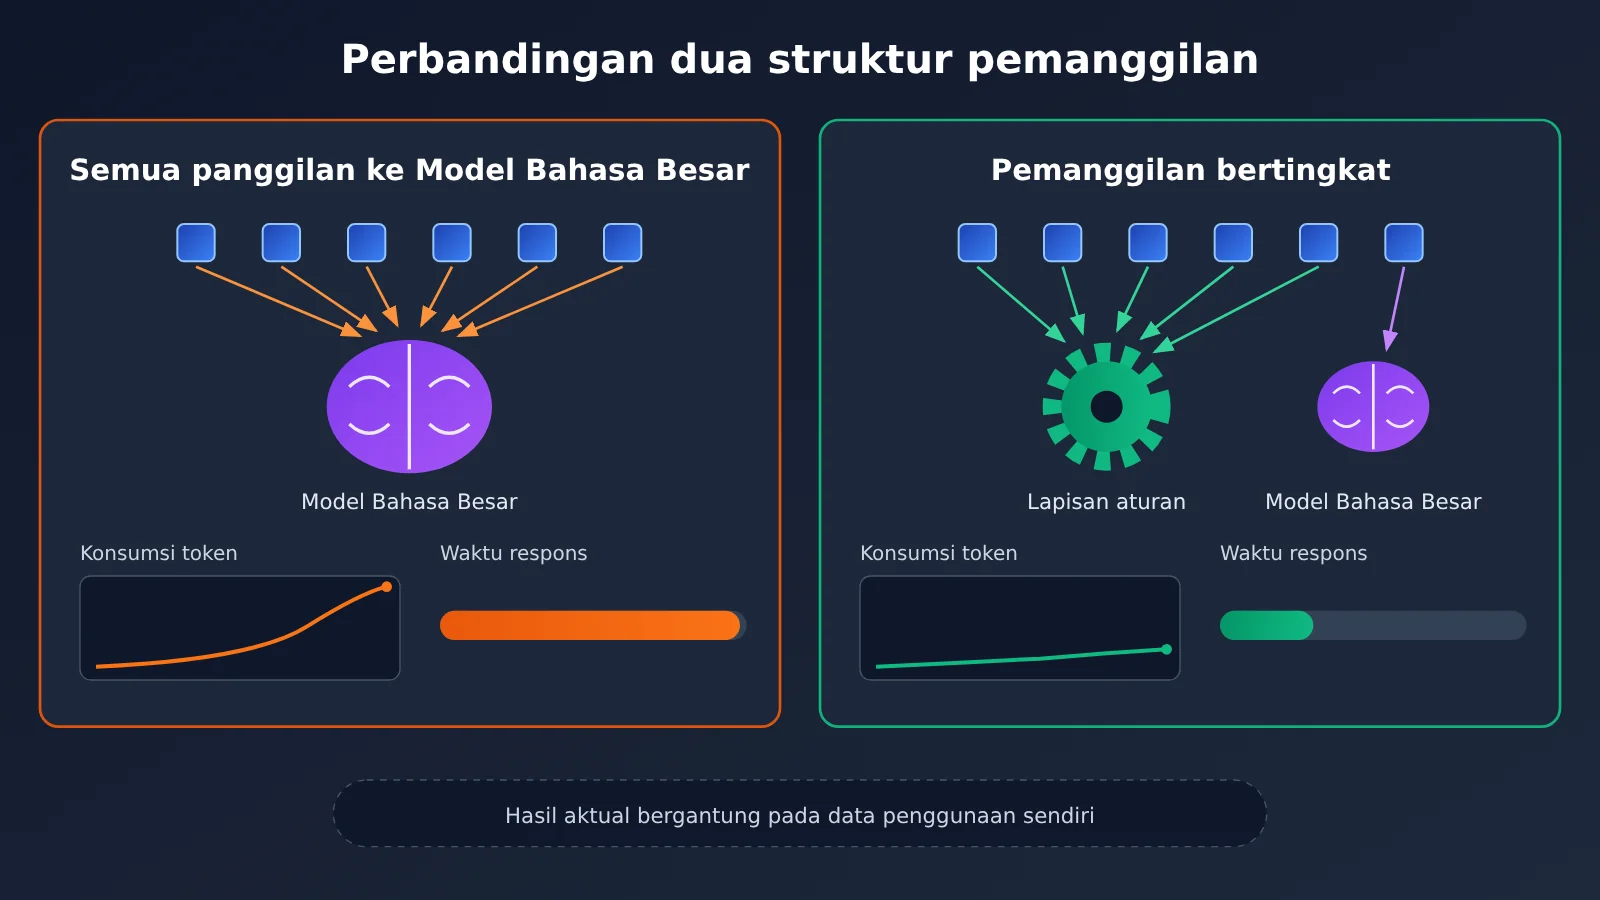
Gambar di atas menunjukkan perbedaan struktur antara dua desain, bukan hasil pengukuran aktual. Untuk mendapatkan data perbandingan, jalankan kedua skema dengan kumpulan permintaan yang sama di APIYI apiyi.com, lalu tarik kesimpulan berdasarkan catatan penggunaan.
| Aspek perbandingan | Semua panggilan menggunakan Model Bahasa Besar | Pemanggilan berlapis | Platform yang tersedia |
|---|---|---|---|
| Kecepatan pengembangan | Prototipe paling cepat, cukup tulis petunjuk | Perlu menyusun aturan dan perutean tambahan | APIYI apiyi.com, API resmi masing-masing penyedia |
| Konsumsi token | Setiap tahap dikenai biaya | Biaya terutama muncul pada tahap yang sulit | Sama seperti di atas |
| Kepastian hasil | Tugas deterministik pun bisa menghasilkan penyimpangan acak | Hasil lapisan aturan dapat diprediksi | Sama seperti di atas |
| Latensi respons | Setiap langkah harus menunggu model menghasilkan respons | Lapisan aturan merespons hampir seketika | Sama seperti di atas |
| Biaya pemeliharaan | Petunjuk makin lama makin panjang | Aturan perlu diperbarui mengikuti kebutuhan bisnis | Sama seperti di atas |
Dampak bagi pembuat alur kerja dan pengembang
- Urutan desainnya jadi terbalik: Bukan lagi “hubungkan Model Bahasa Besar dulu, lalu cari cara berhemat”, melainkan daftarkan semua langkah, tandai mana yang merupakan “sekrup”, lalu tentukan di mana model diperlukan.
- Penempatan model khusus makin penting: Seperti model embodied yang menerjemahkan kondisi fisik menjadi bahasa alami, nilai lapisan perantara adalah mengubah input yang ambigu menjadi masalah terstruktur, sehingga setiap pemanggilan Model Bahasa Besar lebih terarah.
- Observabilitas menjadi kebutuhan utama: Setelah sistem dibagi menjadi beberapa lapisan, jumlah panggilan, token, dan latensi harus dicatat per lapisan. Tanpa itu, sulit menentukan apakah suatu tugas perlu dialihkan ke lapisan yang lebih tinggi atau lebih rendah.
Dampak bagi penanggung jawab produk
- Model biaya lebih mudah diprediksi: Tahap deterministik tidak mengonsumsi token, sehingga biaya terutama terkonsentrasi pada permintaan sulit yang volumenya bisa diperkirakan.
- Perlu menerima bahwa “lebih pintar tidak selalu lebih baik”: Menyerahkan pencarian pesanan kepada Model Bahasa Besar mungkin terlihat lebih pintar, tetapi yang benar-benar dibutuhkan pengguna adalah hasil yang akurat dan cepat.
- Metrik validasi perlu ditetapkan sejak awal: Konsumsi token, tingkat keberhasilan tugas, dan latensi end-to-end sebelum dan sesudah penerapan lapisan perlu menjadi tolok ukur perbandingan sebelum peluncuran.
Dampak bagi industri
Pandangan Laijie mewakili satu pendekatan: Model Bahasa Besar dasar yang makin kuat tidak berarti semua kemampuan harus dimasukkan ke dalam satu model. Sebaliknya, “agen” dengan kemampuan berbeda dapat menjalankan tugas masing-masing. Di bidang perangkat lunak, pendekatan ini sejalan dengan perkembangan pemanggilan alat dan orkestrasi Agent. Namun, wawancara tersebut membahas skenario robotika. Masih belum tersedia cukup data kasus publik tentang seberapa besar manfaat pendekatan ini dalam alur kerja perangkat lunak, sehingga perlu diuji melalui praktik lebih banyak tim.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa maksudnya “jangan kenakan biaya token setiap kali memasang satu sekrup”?
Itulah yang dikatakan Lai Jie, pendiri Stardust Intelligence, dalam wawancara khusus dengan ifanr pada November 2026. Menurutnya, pekerjaan berulang seperti robot memasang sekrup di pabrik sebaiknya ditangani oleh program tetap yang berjalan 24 jam, bukan dengan memanggil model dan membayar biaya token untuk setiap gerakan. Dalam aplikasi AI, artinya tahapan yang deterministik dan sering dilakukan tidak perlu memanggil Model Bahasa Besar.
Q2: Apakah pendekatan berlapis pada robot bisa langsung diterapkan ke alur kerja perangkat lunak?
Tidak bisa disamakan begitu saja. Robot melibatkan kendali waktu nyata, persepsi sentuhan, dan bandwidth komunikasi, sedangkan alur kerja perangkat lunak terutama dibatasi oleh biaya token, latensi, dan stabilitas. Yang bisa diadaptasi adalah pembagian tugasnya: “lapisan eksekusi menyelesaikan tugas sendiri, sementara masalah sulit diteruskan ke lapisan yang lebih tinggi”. Manfaatnya tetap perlu dibuktikan melalui kasus nyata.
Q3: Bagaimana menentukan apakah suatu tahapan perlu menggunakan model kecil atau Model Bahasa Besar?
Perhatikan apakah pilihan hasilnya terbatas dan aturannya stabil. Untuk tugas dengan kategori hasil terbatas dan pola stabil, seperti klasifikasi niat dan ekstraksi bidang, coba model kecil terlebih dahulu. Serahkan tugas yang membutuhkan penalaran menyeluruh, generasi terbuka, atau penanganan pengecualian kepada Model Bahasa Besar. Sebaiknya uji berbagai model dengan kumpulan sampel yang sama di APIYI apiyi.com, lalu bandingkan akurasi dan konsumsinya sebelum menentukan pilihan.
Q4: Apakah pendekatan berlapis pasti mengurangi biaya?
Tidak selalu. Jika sebagian besar permintaan bisnis memang berupa masalah kompleks, lapisan aturan tidak akan banyak menyaring permintaan sehingga manfaat pendekatan berlapis terbatas. Jika aturannya terlalu luas dan keliru menyaring permintaan, tingkat keberhasilan juga bisa menurun. Cara yang tepat adalah mencatat kondisi saat ini terlebih dahulu, lalu membandingkan konsumsi token, tingkat keberhasilan, dan latensi sebelum dan sesudah penerapan lapisan.
Q5: Bagaimana cara cepat membuat prototipe pemanggilan berlapis?
Ikuti langkah-langkah berikut:
1. Daftarkan seluruh langkah dalam alur kerja, tandai tahapan “seperti memasang sekrup”, lalu terapkan menggunakan aturan
2. Kunjungi APIYI apiyi.com untuk mendaftar dan mendapatkan kunci API, lalu hubungkan model kecil dan Model Bahasa Besar melalui antarmuka yang kompatibel dengan OpenAI
3. Gunakan kode dalam artikel ini sebagai acuan untuk menerapkan perutean, lalu catat token dan latensi pada setiap lapisan
Keuntungan antarmuka terpadu adalah Anda cukup mengubah parameter `model` untuk beralih model, sehingga mudah melakukan perbandingan berulang.
Q6: Apa saja kendala umum dalam desain berlapis?
– **Aturan membengkak**: Aturan terus bertambah hingga lebih sulit dipelihara daripada petunjuk. Bersihkan secara berkala.
– **Informasi hilang antarlapisan**: Setelah melakukan klasifikasi, model kecil tidak meneruskan konteks ke Model Bahasa Besar sehingga model harus memahami ulang permintaan.
– **Tidak ada jalur cadangan**: Jika aturan dan model kecil sama-sama gagal mengambil keputusan, harus ada jalur untuk meneruskan tugas ke Model Bahasa Besar atau manusia.
Poin Utama: “Jangan Tagih Biaya Token untuk Setiap Sekrup yang Dipasang”
- Sumber pandangan: Berasal dari wawancara khusus 爱范儿 dengan 来杰 dari 星尘智能 pada November 2026; ini merupakan pandangan sang pendiri.
- Pembagian tugas: Lapisan eksekusi menyelesaikan tindakan sendiri dan hanya meminta tambahan konteks dari Model Bahasa Besar fondasi saat menghadapi masalah sulit.
- 5 jenis tugas sekrup: Validasi format, kueri data, keluaran templat, kontrol alur, dan cache hit tidak seharusnya memanggil Model Bahasa Besar.
- Struktur tiga lapis: Program tetap sebagai dasar, model khusus di lapisan tengah, dan Model Bahasa Besar fondasi hanya menangani masalah terbuka serta pengecualian.
- Batas analogi: Kesimpulan di bidang robotika tidak bisa langsung diterapkan pada perangkat lunak; manfaatnya perlu diuji dengan data sendiri.
- Tiga metrik untuk pengujian: Bandingkan konsumsi token, tingkat keberhasilan tugas, dan latensi dari awal hingga akhir sebelum dan sesudah penerapan lapisan.
- Cara memulai: Gunakan antarmuka terpadu APIYI apiyi.com untuk beralih antar-model di setiap lapisan dan memantau pemakaiannya.
Kesimpulan
Kalimat “Jangan tagih biaya token untuk setiap sekrup yang dipasang” pada dasarnya mengajak kita meninjau ulang kapan pemanggilan AI benar-benar diperlukan dalam alur kerja:
- Kenali dulu tugas sekrup: Serahkan tugas yang sangat deterministik, sering terjadi, dan hanya punya satu jawaban kepada program tetap.
- Lalu gunakan model khusus: Untuk tugas dengan kategori terbatas dan pola yang stabil, gunakan model kecil untuk menyelesaikan tugas dan merumuskan masalah.
- Model Bahasa Besar sebagai pilihan terakhir: Penalaran terbuka, pengambilan keputusan dalam situasi pengecualian, dan pembuatan konten kreatif barulah layak dikenai biaya token.
Metode ini tidak bergantung pada model atau peluncuran tertentu dan bisa menjadi daftar periksa jangka panjang untuk merancang Agent. Saat menerapkannya, pastikan untuk memverifikasi perbedaan sebelum dan sesudah penerapan lapisan menggunakan log bisnis sendiri, alih-alih langsung menganggap biayanya pasti turun.
Jika sedang merancang alur kerja berlapis, Anda bisa menggunakan satu kunci API melalui APIYI apiyi.com untuk mengakses model dengan berbagai ukuran, beralih secara fleksibel di setiap lapisan, dan membandingkan statistik pemakaian. Dengan begitu, Anda bisa memakai data untuk menentukan siapa yang sebaiknya memasang setiap “sekrup”.
📚 Referensi
- 爱范儿 – Wawancara dengan 来杰 dari 星尘智能: Wawancara ke-15 dalam rubrik「多样性公司」
- Tautan:
ifanr.com/1687805 -
Keterangan: Sumber asli analogi “memasang sekrup dan biaya token” serta gagasan pembagian tugas antara model embodied dan Model Bahasa Besar dasar dalam artikel ini
-
Dokumentasi API OpenAI Chat Completions: Penjelasan parameter untuk API yang kompatibel dengan OpenAI
- Tautan:
platform.openai.com/docs/api-reference/chat - Keterangan: Membantu memahami field seperti
model,max_tokens, danusageuntuk mencatat penggunaan pada setiap lapisan
Penulis: Tim teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama situs APIYI. Informasi lebih lanjut tentang integrasi model dan statistik penggunaan tersedia di pusat dokumentasi APIYI