Catatan penulis: Artikel ini membedah struktur tagihan Token untuk tugas Agent yang panjang, menjelaskan mengapa Token input mendominasi, serta cara menata konteks agar cache prefiks lebih sering digunakan kembali.
Banyak tim baru menyadari masalahnya setelah mengintegrasikan Agent multilangkah ke produk dan melihat tagihan di akhir bulan: satu permintaan pengguna ternyata menghabiskan Token puluhan kali lebih banyak daripada percakapan biasa. Reaksi pertama biasanya, “Output model terlalu bertele-tele,” lalu mereka membatasi panjang output. Padahal, sebagian besar penggunaan ada di sisi input, terutama dari riwayat konteks yang harus disertakan kembali pada setiap putaran.
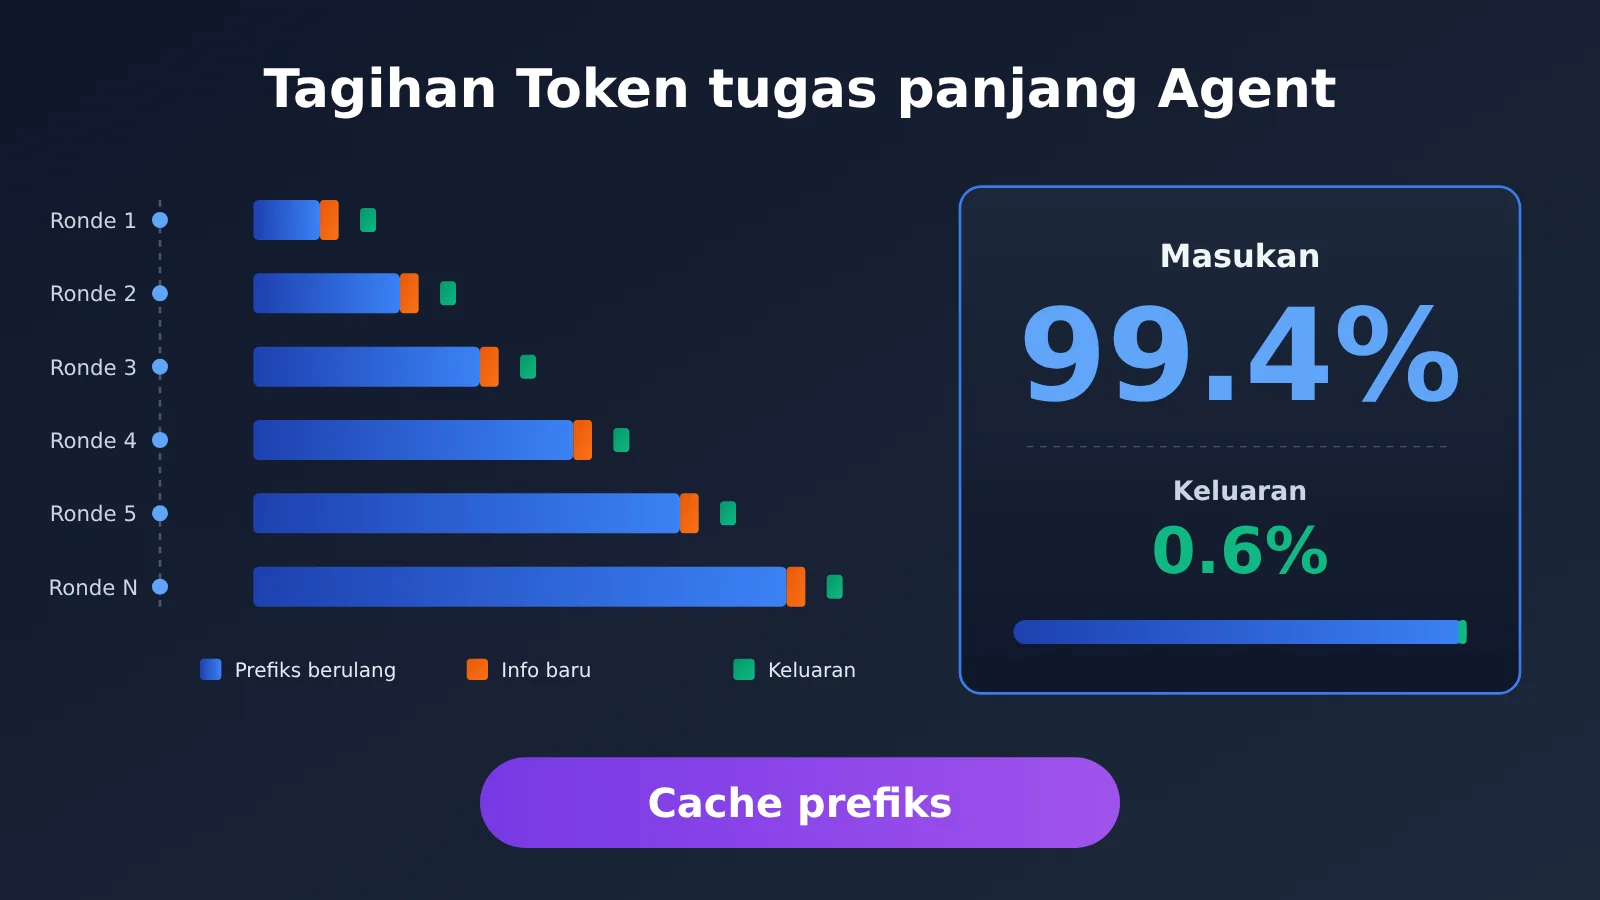
Ini bukan sekadar dugaan berdasarkan pengalaman. Presentasi teknis yang baru-baru ini dipublikasikan memberikan data yang cukup spesifik: dalam skenario produksi di Tiongkok, satu permintaan pengguna rata-rata memicu sekitar 7,2 pemanggilan model. Dalam rantai pemanggilan sepanjang 50 langkah, Token input mencapai sekitar 99,4%, sedangkan output hanya sekitar 0,6%. Tim pengembang mesin inferensi juga menggambarkan beban kerja Agent dengan pola serupa: prefiks panjang, output pendek, dan siklus berulang.
Manfaat utama: Setelah membaca artikel ini, Anda akan memahami struktur tagihan Token untuk tugas Agent yang panjang, mengapa cache prefiks dapat menekan biaya, serta lima cara menata konteks yang bisa langsung diterapkan di sisi aplikasi.
Poin Utama Tagihan Token untuk Tugas Agent yang Panjang
Tabel berikut merangkum kesimpulan artikel ini. Setiap poin akan dibahas lebih lanjut di bagian berikutnya.
| Poin utama | Penjelasan | Manfaat untuk Anda |
|---|---|---|
| Jumlah pemanggilan meningkat | Satu permintaan pengguna menghasilkan rata-rata sekitar 7,2 pemanggilan model; tugas kompleks dengan lebih dari 50 langkah bukan hal yang langka | Perkirakan biaya berdasarkan “tugas”, bukan “permintaan” |
| Input mendominasi biaya | Dalam rangkaian 50 langkah, input mencakup sekitar 99,4% dan output sekitar 0,6% | Prioritaskan pengurangan input; memangkas output hanya memberi dampak terbatas |
| Konteks berulang adalah penyebab utama | Setiap langkah kembali membawa konteks sebelumnya, sehingga konten yang sama dikenai biaya berulang kali | Ketahui sumber biaya yang sebenarnya |
| Cache prefiks dapat digunakan ulang | Jika bagian prefiks yang sama ditemukan di cache, perhitungan prefill yang berulang dapat dihindari | Konteks dengan struktur yang stabil lebih murah |
| Struktur menentukan tingkat hit cache | Pertahankan struktur petunjuk dan alat, letakkan informasi yang berubah di bagian akhir, dan ringkas riwayat pada waktu yang tepat | Turunkan biaya tanpa mengganti model |
Penjelasan Biaya Token untuk Tugas Agent yang Panjang
Perbedaan terbesar antara agent dan percakapan biasa adalah adanya “siklus”. Misalnya, untuk membuat PPT, sistem perlu membaca materi, merencanakan isi, membuat setiap slide, menggunakan alat untuk menyusun presentasi, dan memeriksa hasilnya. Bagi pengguna, ini adalah satu tugas. Namun, di dalam sistem, tugas tersebut melibatkan beberapa putaran penalaran dan pemanggilan alat. Setiap langkah juga mungkin membaca ulang konteks, dan jika hasilnya belum sesuai, sistem perlu kembali melakukan revisi.
Pada setiap pemanggilan, model menerima “petunjuk sistem + definisi alat + seluruh riwayat hingga saat itu + informasi baru pada putaran ini”. Riwayat terus bertambah panjang, sementara konten baru di setiap putaran hanya sedikit. Setelah puluhan putaran, prefiks yang sama dikenai biaya berulang kali. Begitulah proporsi input bisa mencapai 99,4%.
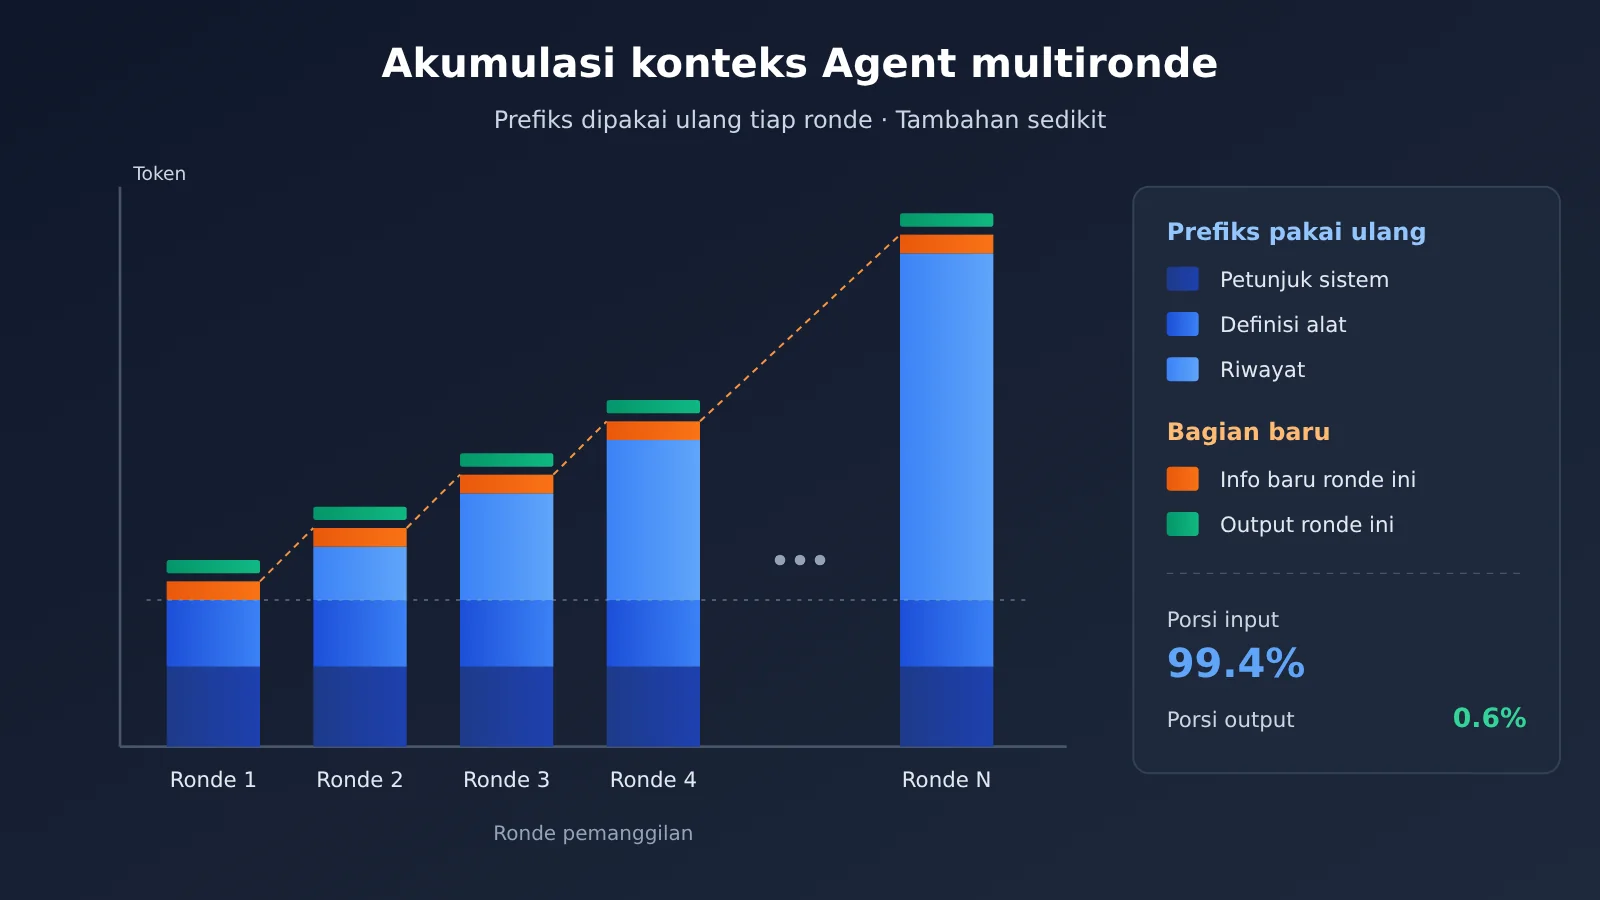
Mengapa jumlah token input jauh lebih besar daripada output dalam tugas Agent yang panjang
Dari sisi mesin inferensi, polanya terlihat lebih jelas. Dalam penjelasannya, TokenSpeed menggunakan coding agent sebagai contoh: model terus berpikir, memanggil alat, menerima hasil, lalu kembali berpikir. Seluruh proses ini terdiri dari siklus permintaan pendek yang berlangsung berkali-kali. Permintaan pertama bisa membawa konteks awalan sepanjang puluhan ribu token, sedangkan output pada setiap siklus berikutnya sering kali hanya beberapa ratus token.
Tabel berikut membandingkan beban kerja chat dan Agent untuk membantu Anda menentukan kategori aplikasi Anda.
| Aspek | Beban kerja Chat tradisional | Beban kerja tugas Agent yang panjang |
|---|---|---|
| Bentuk permintaan | Satu pertanyaan dan satu jawaban, dengan respons lengkap dihasilkan sekaligus | Siklus permintaan pendek berulang, diselingi pemanggilan alat |
| Panjang awalan | Biasanya lebih pendek | Bisa mencapai puluhan ribu token sejak awal dan bertambah pada setiap siklus |
| Output per siklus | Relatif panjang | Sering kali hanya beberapa ratus token |
| Penggunaan ulang konteks | Dilepas setelah satu kali dimuat | Awalan yang sama dibawa berulang kali sepanjang tugas |
| Komponen biaya terbesar | Input dan output sama-sama berpengaruh | Input, terutama awalan yang berulang, mencakup sebagian besar biaya |
Cara kerja cache awalan dalam tugas Agent yang panjang
Mesin inferensi memproses permintaan dalam dua tahap: tahap prefill menghitung seluruh input untuk menghasilkan KV Cache, lalu tahap decode menghasilkan token output satu per satu. Dalam skenario Agent, awalan sepanjang puluhan ribu token harus melalui prefill pada setiap siklus, dan komputasi inilah yang menjadi sumber biaya. Jika awalan yang sama sudah pernah dihitung dan hasilnya masih tersimpan di cache, hasil tersebut bisa langsung digunakan kembali sehingga prefill tidak perlu diulang.
Tim mesin inferensi menganggap tingkat penggunaan ulang KV Cache sebagai variabel penting yang menentukan biaya inferensi. Dalam penjelasannya disebutkan bahwa tingkat penggunaan ulang cache DeepSeek diklaim melebihi 99%, sementara sebagian besar sistem di industri saat ini berada di kisaran 70% hingga 80%. Pada beban kerja Agent, tingkat kecocokan cache awalan pada tahap prefill biasanya melebihi 90%. Ketika cache cocok, sistem hanya perlu menghitung tambahan beberapa ratus token.
Ada satu detail yang mudah terlewat: cache awalan dicocokkan bagian demi bagian mulai dari awal. Pada awalnya, TokenSpeed mengadopsi pendekatan SGLang dan menggunakan Radix Tree untuk mengelola cache awalan. Setiap node pada pohon mewakili satu urutan token, dan permintaan dicocokkan mulai dari akar pohon. Meskipun kemudian beralih ke desain Flat KV, penggunaan ulang tetap dilakukan dalam blok logis berukuran tetap, yaitu 128 token. Bagi pengembang aplikasi, kesimpulannya sederhana: jika ada satu saja token yang berbeda di bagian awal, konten setelahnya tidak dapat digunakan kembali.
Cara menyusun konteks untuk meningkatkan tingkat hit cache prefix pada tugas panjang Agent
Setelah memahami cara kerja pencocokan cache, arah optimasinya menjadi jelas: buat bagian awal setiap permintaan sepanjang mungkin dan sebisa mungkin tetap sama. Tim WorkBuddy melakukannya dengan menjaga petunjuk dan struktur alat tetap konsisten, menaruh informasi yang berubah di akhir konteks, lalu memadatkan riwayat ketika konteks mulai panjang. Berikut 5 langkah yang bisa langsung diterapkan.
| Cara | Tindakan | Contoh yang perlu dihindari |
|---|---|---|
| 1. Pertahankan petunjuk sistem | Pastikan petunjuk sistem tetap sama kata demi kata dan rilis perubahan versi secara terpusat | Menyisipkan waktu saat ini, nama pengguna, atau contoh acak di awal |
| 2. Pertahankan struktur alat | Jaga urutan daftar alat dan deskripsi parameter tetap sama | Menambah atau menghapus alat sesuai kebutuhan setiap putaran, atau menggunakan urutan serialisasi yang tidak konsisten |
| 3. Letakkan informasi yang berubah di akhir | Tambahkan cap waktu, hasil pengamatan putaran saat ini, dan status dinamis di bagian akhir | Menulis “progres saat ini” di bagian atas petunjuk sistem |
| 4. Hanya tambahkan riwayat, jangan tulis ulang | Biarkan riwayat yang sudah dikirim tetap seperti semula dan tambahkan konten baru di belakangnya | Memformat ulang atau mengurutkan ulang pesan sebelumnya pada setiap putaran |
| 5. Padatkan riwayat secara berkala | Saat konteks terlalu panjang, padatkan sekali di titik pemeriksaan, lalu lanjutkan dengan hanya menambahkan konten | Membuat ulang ringkasan pada setiap putaran sehingga prefix terus berubah |
Praktik menjaga petunjuk dan struktur alat untuk tugas panjang Agent
Langkah 1 dan 2 paling mudah terlewat. Banyak framework menyisipkan tanggal saat ini ke dalam petunjuk sistem atau memilih alat secara dinamis sesuai langkah yang sedang dijalankan. Keduanya membuat bagian awal berbeda pada setiap putaran, sehingga cache prefix gagal digunakan sejak token pertama. Cara yang lebih aman adalah memasukkan hanya aturan dan peran ke dalam petunjuk sistem, lalu meletakkan informasi seperti tanggal sebagai pesan biasa di bagian akhir. Cantumkan juga semua alat sekaligus, kemudian gunakan petunjuk untuk membatasi alat yang boleh digunakan pada tahap tertentu, alih-alih mengubah daftar alat itu sendiri.
Perhatikan juga cara serialisasinya. Jika urutan field JSON dalam definisi alat yang sama berbeda antarproses, pada tingkat byte hasilnya adalah dua prefix yang berbeda. Sebaiknya urutkan definisi alat secara konsisten sebelum dikirim dan catat nilai hash prefix dalam log. Dengan begitu, lebih mudah mencari penyebab ketika cache tidak terpakai padahal tidak ada perubahan yang disengaja.
Menyeimbangkan pemadatan riwayat dan penggunaan ulang cache pada tugas panjang Agent
Langkah 5 memiliki konsekuensi yang perlu dipertimbangkan. Memadatkan riwayat dapat mengurangi panjang input, tetapi prefix berubah setelah pemadatan sehingga cache pasti tidak terpakai pada putaran tersebut. Jika dilakukan setiap putaran, artinya Anda mengorbankan penggunaan ulang cache setiap kali. Karena itu, lebih masuk akal untuk menetapkan ambang batas, misalnya memadatkan riwayat saat konteks mencapai panjang tertentu atau saat satu subtugas selesai. Setelah itu, gunakan versi yang sudah dipadatkan sebagai prefix stabil yang baru, lalu lanjutkan dengan hanya menambahkan konten tanpa menulis ulang.
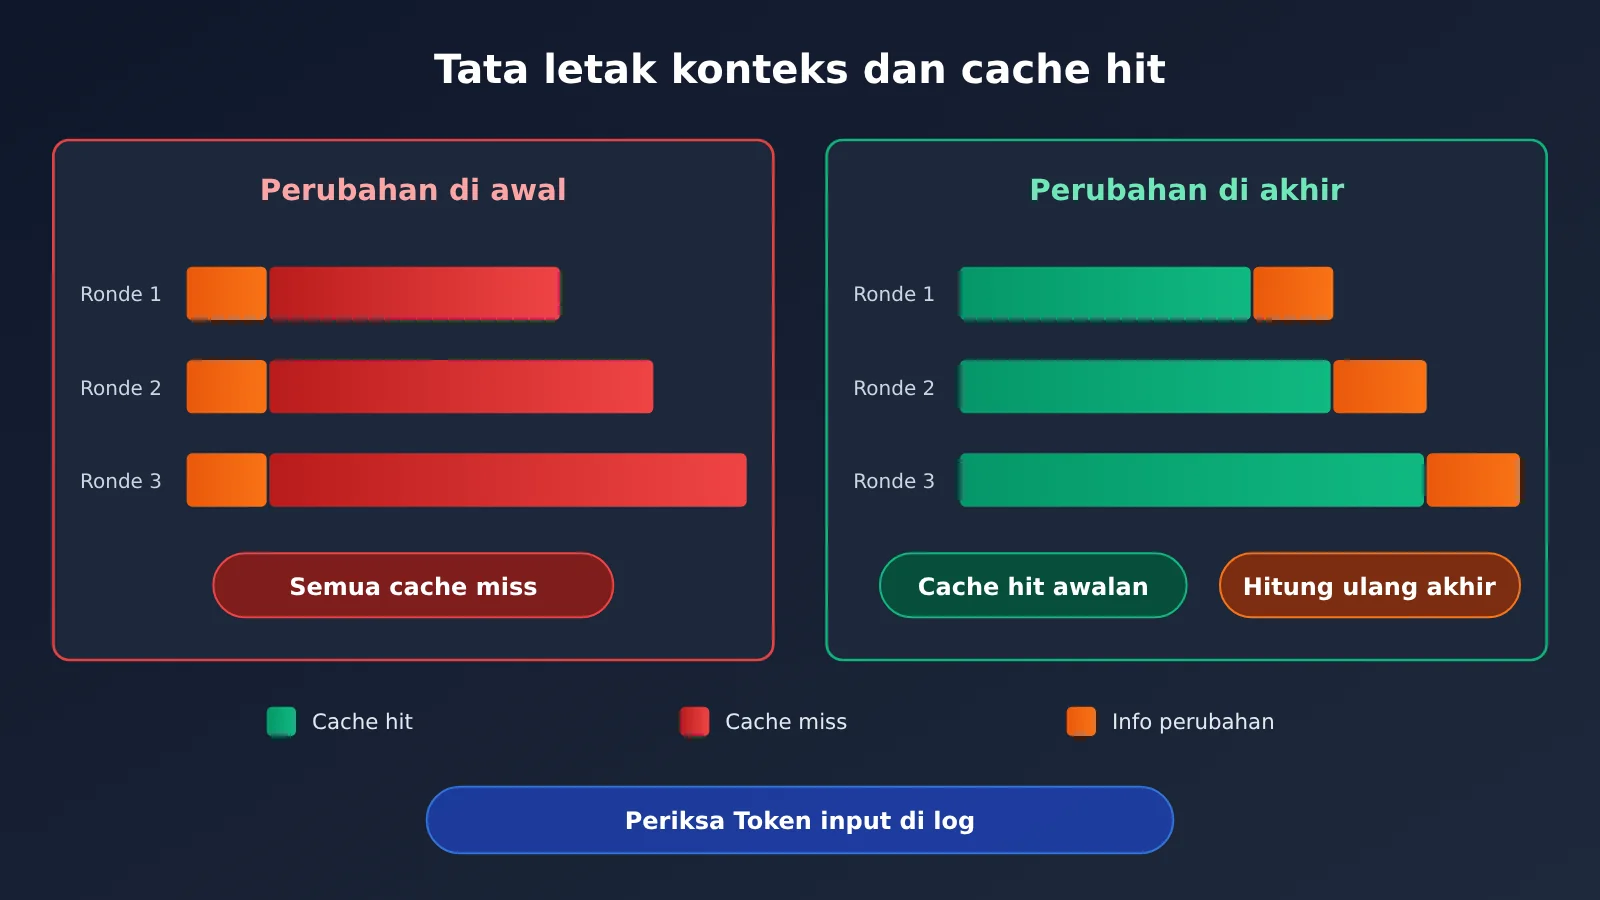
Kedua tata letak di atas nyaris tidak terlihat berbeda jika hanya dilihat dari satu putaran permintaan. Namun, dalam tugas panjang yang berlangsung puluhan putaran, selisih tagihannya akan terasa. Untuk mengetahui tata letak mana yang digunakan aplikasi Anda, cara paling langsung adalah memeriksa perubahan Token input pada setiap putaran di log pemanggilan. APIYI apiyi.com menyediakan penagihan terpadu, statistik penggunaan, dan log pemanggilan. Data dari berbagai model bisa dibandingkan di satu tempat, sehingga cocok untuk menganalisis struktur tagihan seperti ini.
Panduan Cepat Mengoptimalkan Tagihan Token untuk Tugas Agent Berdurasi Panjang
Bagian ini tidak membahas kode. Ikuti saja langkah-langkah pemeriksaan berikut secara berurutan.
Langkah pertama: Pisahkan tagihan Token berdasarkan tugas
- Buat ID tugas untuk setiap tugas pengguna, lalu sertakan ID tersebut dalam log setiap pemanggilan model di dalam tugas itu.
- Catat jumlah Token input dan output dari informasi
usagepada setiap respons. Beberapa penyedia juga mengembalikan jumlah Token yang terkena cache hit secara terpisah; periksa dokumentasi resmi untuk nama field-nya. - Rangkum tiga metrik per tugas: jumlah pemanggilan, rasio input/output, dan proporsi cache hit.
Jika menggunakan model dari beberapa penyedia sekaligus, format log-nya sering kali tidak seragam. Dengan akses terpadu melalui APIYI, kamu bisa melihat rincian penggunaan dan riwayat pemanggilan semua model dalam satu konsol. Padukan informasi ini dengan ID tugas yang kamu catat untuk mendapatkan gambaran lengkap tentang biaya setiap tugas dan tahap yang menghabiskan biaya tersebut.
Langkah kedua: Temukan bagian yang merusak prefix
- Ambil dua permintaan berurutan dalam tugas yang sama, lalu bandingkan setiap bagian petunjuk sistem, definisi alat, dan riwayat pesan untuk memastikan semuanya identik karakter demi karakter.
- Periksa secara khusus posisi field dinamis seperti timestamp, angka acak, dan status pengguna.
- Pastikan urutan serialisasi definisi alat dan pesan tetap stabil di antara permintaan.
Langkah ketiga: Sesuaikan berdasarkan 5 praktik dan uji ulang
- Pindahkan konten dinamis ke bagian akhir, lalu tetapkan petunjuk sistem dan daftar alat agar tidak berubah.
- Tetapkan ambang kompresi riwayat, lalu lakukan kompresi di checkpoint, bukan pada setiap putaran.
- Jalankan versi sebelum dan sesudah perubahan dengan kumpulan tugas pengujian yang sama, lalu bandingkan jumlah Token input dan proporsi cache hit per tugas.
🚀 Saran untuk memulai: Gunakan kumpulan tugas dan model yang sama saat membandingkan hasil sebelum dan sesudah perubahan. Jika tidak, datanya tidak bisa dijadikan acuan. Dengan antarmuka terpadu APIYI, kamu tidak perlu menyesuaikan setiap antarmuka saat berganti model untuk pengujian ulang. Statistik penggunaan juga terkumpul di satu tempat, sehingga perbedaan akibat “optimasi struktur” dan “perbedaan model” lebih mudah diamati secara terpisah.
Batasan estimasi biaya
WorkBuddy pernah memberikan sebuah estimasi berdasarkan skala tugasnya dan harga resmi paket flagship TokenHub: ketika tingkat cache hit mencapai 90%, estimasi biaya per tugas bisa turun dari sekitar 21,06 yuan menjadi sekitar 3,36 yuan. Perlu diingat, angka ini berlaku untuk panjang konteks dan kondisi harga tertentu. Syarat lengkapnya tidak dipublikasikan, sehingga perhitungannya tidak dapat diverifikasi ulang dan tidak bisa langsung diterapkan pada aplikasimu.
| Faktor | Mengapa memengaruhi hasil | Yang perlu kamu periksa |
|---|---|---|
| Panjang konteks | Semakin panjang prefix, semakin besar penghematan dari penggunaan ulang cache | Rata-rata panjang prefix pada tugasmu |
| Cara penagihan cache | Diskon untuk bagian yang terkena cache hit berbeda antarpenyedia | Harga cache dalam dokumentasi resmi model yang dituju |
| Syarat aktivasi cache | Aturan seperti panjang minimum dan masa berlaku berbeda-beda | Aturan aktivasi dan kedaluwarsa dalam dokumentasi resmi |
| Jeda pemanggilan | Jika jeda antara dua putaran terlalu lama, cache mungkin sudah kedaluwarsa | Apakah waktu eksekusi alat sesuai dengan masa berlaku cache |
| Jumlah langkah tugas | Semakin banyak langkah, semakin besar akumulasi prefix yang berulang | Distribusi jumlah langkah pada tugas nyata |
Praktik Pendukung untuk Mengurangi Biaya Token pada Tugas Agent yang Panjang
Selain struktur konteks, pemaparan yang sama juga menyebutkan dua strategi di sisi aplikasi yang bisa digunakan bersama cache prefiks.
- Pilih model berdasarkan langkah: Tim WorkBuddy menyampaikan bahwa sekitar 80% langkah sederhana bisa diserahkan ke model ringan, sehingga biaya per tugas turun sekitar 57%. Langkah seperti mengumpulkan materi dan mengonversi format tidak selalu membutuhkan model unggulan.
- Tangani kegagalan berdasarkan penyebabnya: Saat terjadi timeout, permintaan ditolak, atau gangguan penyedia, batasi jumlah percobaan ulang, sesuaikan konteks, atau ganti model sesuai penyebabnya. Percobaan ulang tanpa batas bisa membuat prefiks panjang yang sama ditagihkan berulang kali.
Perlu diingat, mengganti model berarti menggunakan cache yang berbeda, sehingga penggunaan ulang prefiks harus dimulai dari awal. Karena itu, dalam desain perutean, sebisa mungkin pertahankan langkah-langkah berurutan dalam satu subtugas pada model yang sama, lalu lakukan pergantian model di batas antar-subtugas.
Pertanyaan Umum (FAQ)
Q1: Apa itu cache prefiks dalam tugas Agent yang panjang?
Cache prefiks adalah mekanisme ketika layanan inferensi menyimpan prefiks input yang sudah dihitung (KV Cache), lalu langsung menggunakannya kembali jika awal permintaan berikutnya sama. Dengan begitu, perhitungan prefill untuk bagian tersebut bisa dilewati. Agent membawa riwayat panjang yang sebagian besar sama pada setiap putaran, sehingga sangat cocok untuk mekanisme ini.
Q2: Apa perbedaan cache prefiks dan kompresi riwayat konteks?
Cache prefiks tidak mengurangi isi input, tetapi membuat perhitungan bagian yang berulang lebih murah. Sebaliknya, kompresi riwayat langsung memperpendek input, tetapi mengubah prefiks sehingga cache pada putaran tersebut tidak berlaku. Keduanya perlu digunakan bersama: selama proses berjalan, cukup tambahkan konten agar cache tetap bisa digunakan, lalu lakukan kompresi pada titik pemeriksaan.
Q3: Apakah proporsi input 99,4% berlaku untuk semua Agent?
Belum tentu. Angka ini berasal dari pemaparan tentang rangkaian pemanggilan dengan 50 langkah. Pada tugas dengan langkah lebih sedikit atau output per putaran lebih panjang, proporsi input akan lebih rendah. Namun, selama strukturnya berupa “prefiks panjang, output pendek, dan putaran berulang”, input biasanya tetap mendominasi. Sebaiknya ukur langsung menggunakan log aplikasi Anda.
Q4: Skenario Agent apa yang paling layak dioptimalkan dengan cache prefiks?
– **Agent pemrograman**: Konteks repositori panjang, dengan siklus membaca file, mengubah kode, dan menjalankan tes yang sering berulang
– **Pembuatan dokumen atau PPT**: Setelah materi dibaca, konten dibuat halaman demi halaman dengan prefiks yang sangat berulang
– **Agent analisis data**: Struktur tabel dan penjelasan metrik tetap, sementara setiap putaran hanya menambahkan hasil kueri
Q5: Bagaimana cara cepat melihat komposisi Token input/output aplikasi?
Cara paling sederhana adalah merekap data usage setiap putaran berdasarkan ID tugas. Jika aplikasi menggunakan beberapa model, Anda bisa melakukan pemanggilan secara terpusat melalui APIYI apiyi.com. Platform ini menyediakan statistik penggunaan dan log pemanggilan, sehingga komposisi input dan output mudah dilihat berdasarkan model atau rentang waktu. Untuk dukungan cache petunjuk dan cara penagihan setiap model, lihat penjelasan terbaru dalam dokumentasi platform.
Q6: Apa saja keterbatasan cache prefiks yang sudah diketahui?
– Syarat aktivasi tiap penyedia berbeda, misalnya panjang minimum dan masa berlaku, sehingga perlu diperiksa dalam dokumentasi resmi masing-masing
– Jika eksekusi alat terlalu lama, cache bisa kedaluwarsa sebelum putaran berikutnya
– Mengganti model atau mengubah petunjuk sistem akan membuat seluruh cache tidak berlaku
– Besaran diskon untuk bagian yang menggunakan cache berbeda-beda menurut model, sehingga penghematannya perlu diuji langsung
Poin Utama Tagihan Token untuk Tugas Agent yang Panjang
- Hitung biaya per tugas: Satu permintaan menghasilkan sekitar 7,2 kali pemanggilan, sementara tugas panjang bisa melampaui 50 langkah.
- Input adalah sumber biaya utama: Dalam alur 50 langkah, input menyumbang sekitar 99,4% token, sehingga mengurangi output saja tidak banyak membantu.
- Cache dicocokkan dari awal: Jika satu token di awal berbeda, seluruh konten setelahnya tidak dapat digunakan kembali dari cache.
- Struktur lebih penting daripada model: Jaga struktur petunjuk dan tool tetap konsisten, lalu letakkan informasi yang berubah di bagian akhir.
- Atur waktu kompresi: Lakukan kompresi pada checkpoint, bukan dengan menulis ulang prefix pada setiap putaran.
- Jangan generalisasikan perhitungan: Angka biaya yang dipublikasikan bergantung pada panjang konteks dan harga tertentu, jadi perlu diuji ulang sendiri.
- Amati sebelum mengoptimalkan: Manfaatkan statistik penggunaan dan log pemanggilan APIYI untuk menguraikan struktur tagihan.
Kesimpulan
Kesimpulan utama tentang tagihan token untuk tugas Agent yang panjang:
- Struktur tagihan: Sebagian besar biaya berasal dari riwayat konteks yang disertakan kembali pada setiap putaran. Token input menyumbang porsi terbesar.
- Prinsip penghematan: Cache prefix menghindari perhitungan prefill untuk prefix yang berulang. Tingkat keberhasilannya ditentukan oleh struktur konteks.
- Cara menerapkannya: Jaga petunjuk dan tool tetap konsisten, letakkan informasi yang berubah di akhir, hanya tambahkan riwayat tanpa mengubahnya, lakukan kompresi secara berkala, lalu pilih model sesuai kebutuhan tiap langkah.
Mulailah dengan mengelompokkan log berdasarkan tugas selama satu minggu untuk memastikan proporsi input dan tingkat keberhasilan cache. Setelah itu, terapkan 5 cara dalam artikel ini satu per satu. Jika menggunakan beberapa model, Anda bisa mengakses semuanya melalui APIYI apiyi.com, melihat penggunaan dan riwayat pemanggilan secara terpusat, serta memakai data yang sama untuk menilai hasil setiap langkah optimasi.
📚 Referensi
- Membangun mesin inferensi LLM generasi berikutnya untuk penalaran agentic: rangkuman presentasi TokenSpeed di AICon 2026 Shenzhen
- Tautan:
infoq.cn/article/YwAayF1ylWb7oN4P0lyC -
Keterangan: Membahas karakteristik beban kerja Agent dengan “prefiks panjang, output pendek”, tingkat penggunaan ulang KV Cache, dan desain struktur cache prefiks.
-
Dari pemanggilan model hingga penyelesaian tugas: bagaimana MaaS diterapkan dalam produksi Agent: rangkuman sesi khusus Tencent Cloud MaaS
- Tautan:
infoq.cn/article/zZutPTX8bsr6NWQYNC3A - Keterangan: Mencakup data yang dibagikan WorkBuddy tentang jumlah pemanggilan, proporsi input, cache prefiks, dan perutean model.
Penulis: Tim Teknis APIYI
Diskusi teknis: Untuk pertanyaan tentang pemanggilan beberapa model dan analisis penggunaan, hubungi kami melalui APIYI di apiyi.com. Informasi selengkapnya tersedia di pusat dokumentasi docs.apiyi.com.