Catatan penulis: Artikel ini menggunakan metode lingkungan perusahaan sintetis yang dipublikasikan Microsoft Copilot sebagai contoh untuk menguraikan tiga lapisan: lingkungan sintetis, pembuatan kueri otomatis, dan pemeriksaan kualitas. Artikel ini juga merangkum langkah serta daftar periksa yang dapat digunakan tim kecil dan menengah untuk menyusun set evaluasi.
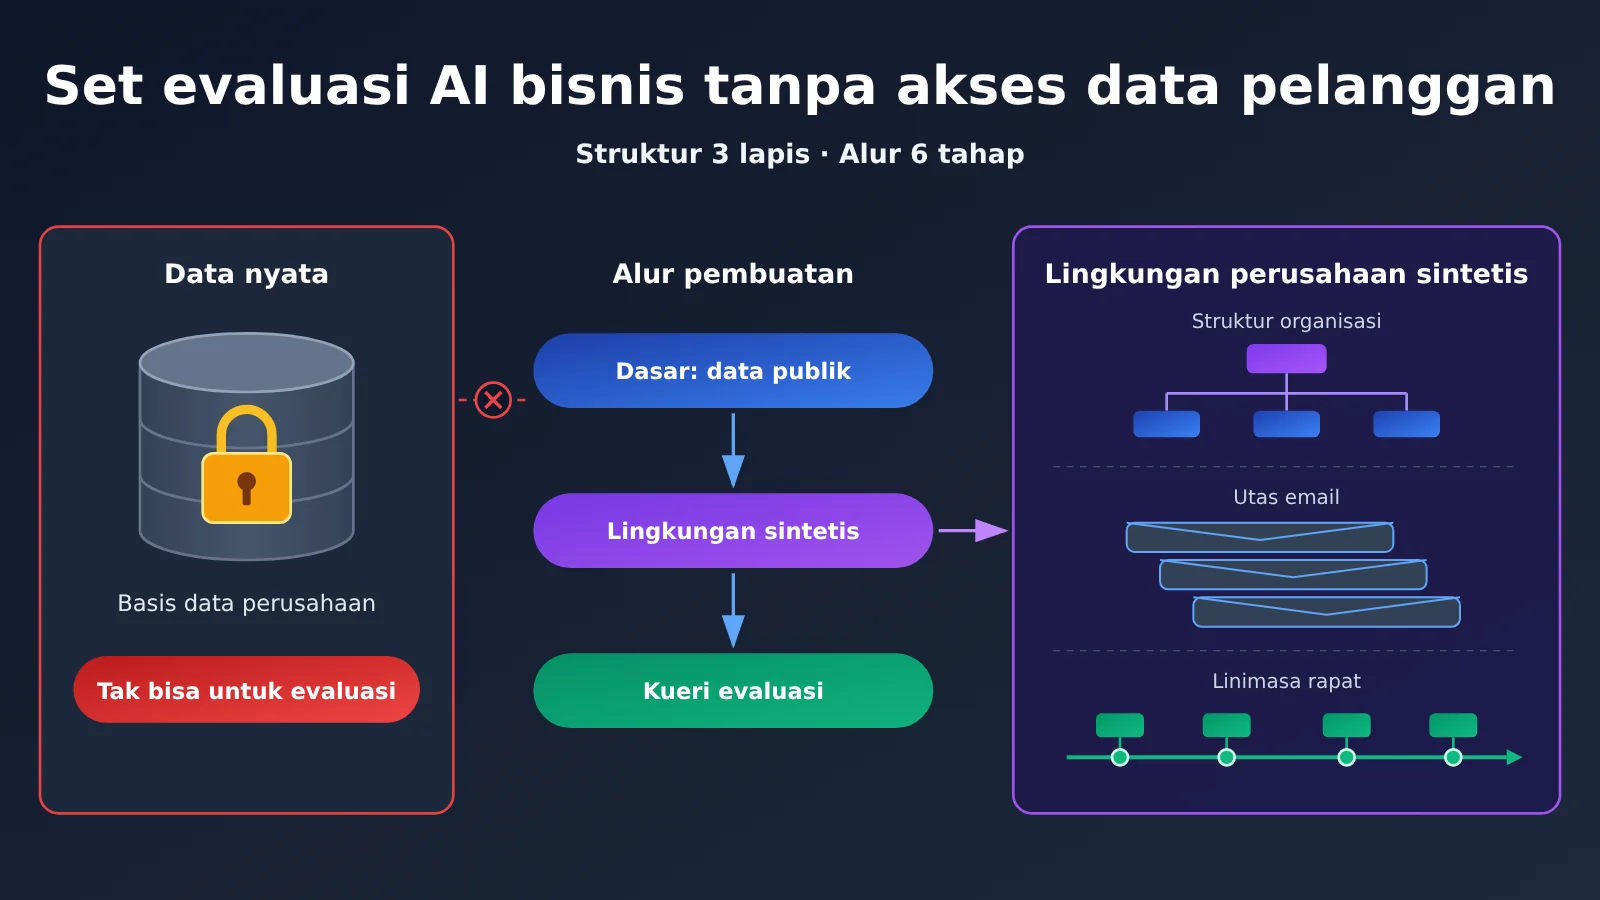
Saat asisten AI atau aplikasi pengetahuan perusahaan siap diluncurkan, tim evaluasi biasanya menghadapi masalah: email, notula rapat, dan dokumen proyek perusahaan adalah sumber yang paling mencerminkan hasil nyata, tetapi mengandung informasi sensitif sehingga tidak bisa digunakan untuk pengujian. Sementara itu, skor benchmark umum tidak cukup untuk mengungkap masalah dalam skenario bisnis. Artikel ini menggunakan blog Microsoft Research yang terbit pada 30 Oktober 2026 sebagai contoh untuk menguraikan metode penyusunan set evaluasi dengan tiga lapisan: lingkungan perusahaan sintetis + pembuatan kueri otomatis + pemeriksaan kualitas.
Ini bukan sekadar mengulang materi promosi resmi. Informasi yang dipublikasikan Microsoft berfokus pada kerangka metode, tanpa menyertakan petunjuk, kode alat, atau metrik spesifik Copilot pada set data tersebut. Artikel ini membedakan apa yang dinyatakan secara eksplisit dalam sumber asli dan apa yang merupakan analisis kami, lalu merangkum metode tersebut menjadi langkah-langkah yang bisa dijadikan acuan oleh tim kecil dan menengah.
Manfaat utama: Setelah membaca artikel ini, Anda akan memahami masalah yang ditangani oleh setiap lapisan set evaluasi perusahaan sintetis, mengapa dimensi waktu dan penyesuaian dengan industri tidak bisa diabaikan, serta cara menemukan celah dalam proses evaluasi Anda menggunakan daftar periksa.
Poin utamaชุด evaluasi lingkungan perusahaan sintetis
Microsoft menyebut sistem ini Industry Evaluation Data Generation Platform (platform pembuatan data evaluasi industri). Menurut artikel aslinya, sistem ini dibangun di atas tiga pilar yang dihubungkan oleh lapisan otomatisasi menyeluruh.
| Komponen | Deskripsi dalam artikel asli | Masalah yang diselesaikan |
|---|---|---|
| Lingkungan perusahaan sintetis | Ruang kerja Copilot simulasi yang mencakup pengguna, rapat, email, dokumen, dan struktur organisasi, tanpa menggunakan data pelanggan | Menyediakan “fondasi” yang bisa diuji tanpa mengorbankan privasi |
| Pipeline pembuatan kueri otomatis | Mengubah gagasan kueri umum menjadi pertanyaan khusus industri yang sesuai dengan data lingkungan | Menulis ribuan kueri yang sesuai dengan data secara manual memakan terlalu banyak biaya |
| Kerangka kualitas terstruktur | Mengukur kelayakan data sintetis dari berbagai dimensi | Mencegah kesimpulan yang salah akibat penggunaan data yang “terlalu tidak realistis” |
| Otomatisasi menyeluruh | Konfigurasi yang sama dapat menghasilkan ulang dataset yang persis sama | Mendukung perbandingan regresi antarversi dan konsistensi antartim |
Mengapa benchmark umum tidak dapat mengungkap masalah aplikasi AI perusahaan
Tantangan di lingkungan perusahaan bukan sekadar tanya jawab satu putaran, melainkan konteks organisasi. Ketika pengguna meminta, “Susun daftar tindak lanjut dari rapat tinjauan keamanan ini untuk setiap tim”, model harus tahu siapa yang hadir, siapa yang bertanggung jawab atas setiap modul, dan hal-hal spesifik apa yang dibahas. Model juga harus mengutip isi asli notulen rapat dalam jawabannya. Artikel aslinya mencontohkan institusi kesehatan yang meminta Copilot merangkum rapat dan mengekstrak tindak lanjut. Yang diuji adalah apakah jawabannya akurat, lengkap, dan punya dasar yang jelas.
Benchmark umum tidak mencakup hubungan pelaporan, riwayat proyek, kebiasaan komunikasi, dan alur kerja bidang tertentu. Karena itu, benchmark tersebut tidak bisa mengungkap kegagalan khas perusahaan, seperti “mengaitkan keputusan departemen A ke departemen B” atau “melewatkan kesimpulan penting dalam rapat lintas fungsi”. Pendekatan Microsoft adalah: jika data nyata tidak bisa digunakan, buatlah lingkungan dengan struktur dan perilaku yang menyerupai perusahaan nyata.
Menggunakan data publik sebagai fondasi lingkungan perusahaan sintetis
Jika struktur organisasi sepenuhnya dibuat dari imajinasi Model Bahasa Besar, hasilnya sering kali berisi peran yang monoton, hierarki pelaporan yang datar, dan pekerjaan yang seragam. Microsoft menggunakan tiga jenis data publik untuk mengalibrasi lingkungan sintetis. Semua sumber data ini telah ditinjau dan disetujui oleh tim hukum dan kebijakan Microsoft.
| Sumber data publik | Penggunaan dalam artikel asli | Alternatif untuk tim kecil dan menengah |
|---|---|---|
| Basis data pekerjaan O*NET (Departemen Tenaga Kerja AS) | Membuat peran dan tanggung jawab karyawan lebih realistis, mengalibrasi kombinasi dan frekuensi aktivitas kerja setiap peran, serta menyesuaikan proses industri | Susun daftar peran dari deskripsi pekerjaan publik dan standar klasifikasi pekerjaan di industri terkait |
| Lowongan kerja online | Menyediakan nama jabatan, hierarki pelaporan, dan susunan departemen yang nyata | Kumpulkan deskripsi pekerjaan (JD) publik di industri sasaran, lalu ambil informasi jenjang jabatan dan struktur departemennya |
| Dokumen publik SEC | Menentukan skala organisasi, struktur unit bisnis, dan latar belakang keuangan | Rujuk uraian segmen bisnis dan jumlah karyawan dalam laporan tahunan perusahaan publik |
Dalam istilah Microsoft, setiap ruang kerja simulasi disebut “tenant” (penyewa), yaitu lingkungan organisasi yang terisolasi dengan pengguna, data, dan konfigurasi tersendiri. Artikel asli menekankan bahwa lingkungan ini merupakan fondasi yang dapat diperluas, sehingga setiap tim bisa terus mengembangkannya.
Dimensi waktu: mengapa “apa yang diputuskan Kamis lalu” membutuhkan struktur waktu yang nyata
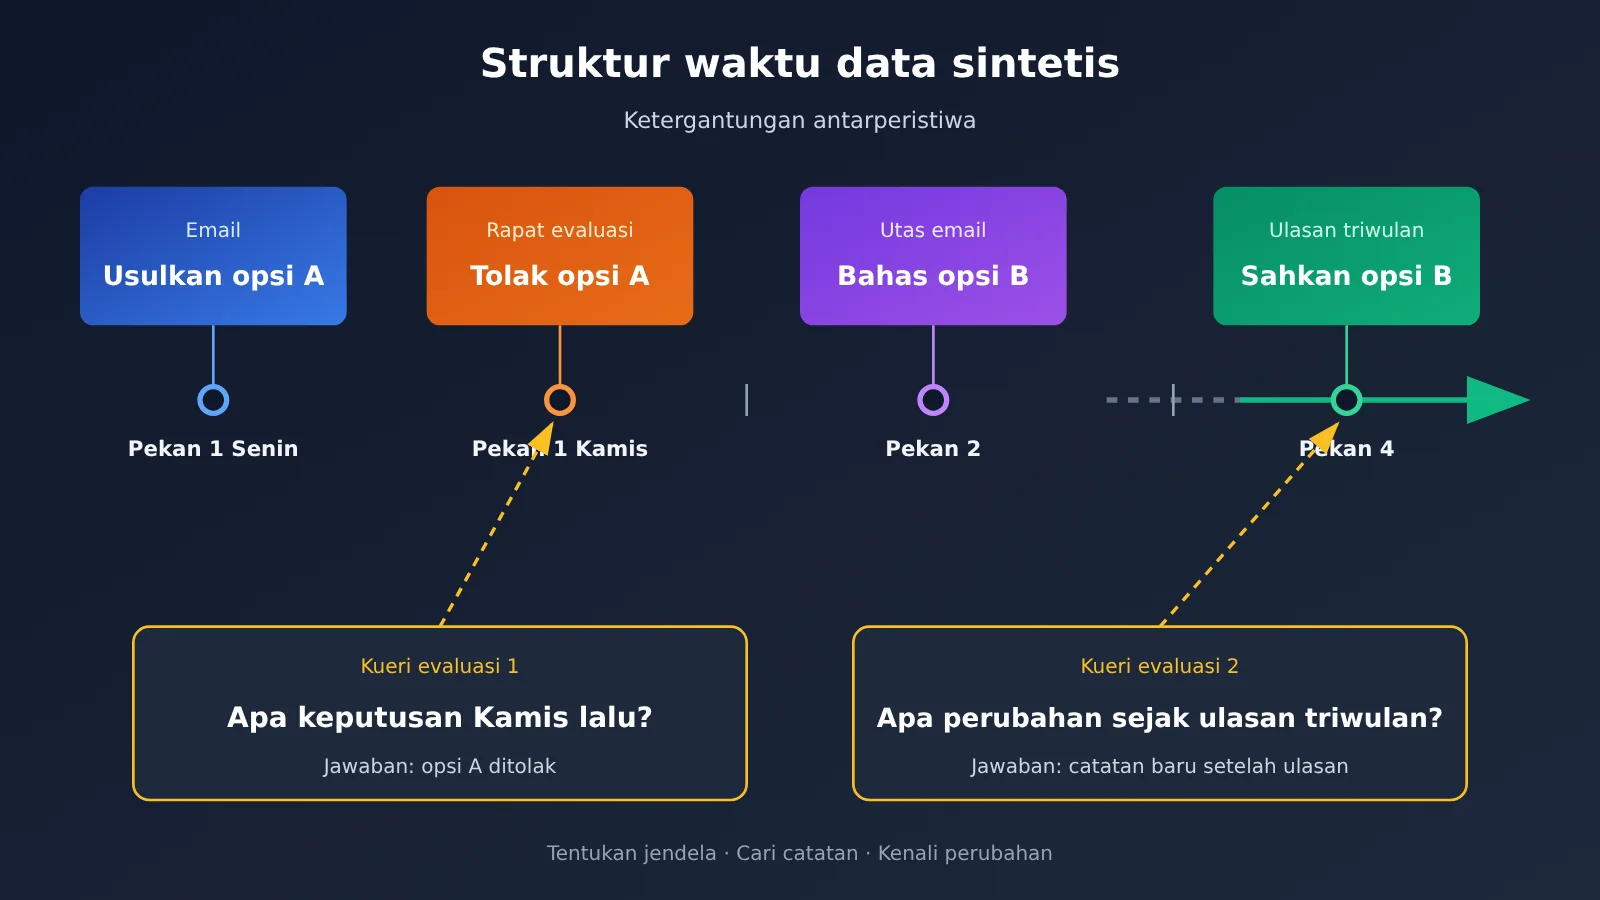
Inilah salah satu poin dari artikel asli yang paling perlu diperhatikan tim kecil dan menengah. Lingkungan sintetis Microsoft bukanlah snapshot statis, melainkan organisasi yang berkembang seiring waktu: ada riwayat rapat, linimasa proyek, rangkaian email yang berlangsung selama berminggu-minggu, serta perubahan organisasi yang terjadi secara alami. Artikel asli menunjukkan bahwa banyak kueri Copilot berkaitan dengan waktu, seperti “apa yang diputuskan tim Kamis lalu” dan “apa yang berubah sejak tinjauan kuartalan terakhir”.
Pertanyaan tentang waktu menuntut model melakukan tiga hal: menentukan rentang waktu, menemukan catatan yang relevan dalam rentang tersebut, dan mengenali perubahan yang terjadi. Jika data sintetis hanya berupa kumpulan dokumen tanpa hubungan tanggal, atau semua rapat ditumpuk pada hari yang sama, pertanyaan seperti ini tidak akan memiliki jawaban baku atau jawabannya terlalu mudah. Hasil evaluasinya pun tidak bermakna. Data sintetis harus memiliki keterkaitan antarperistiwa, misalnya usulan diajukan pada hari Senin, ditolak dalam rapat hari Kamis, lalu alternatifnya muncul dalam email minggu berikutnya. Dengan begitu, pertanyaan “apa yang diputuskan Kamis lalu” benar-benar bisa menguji model.
Penyesuaian industri: model yang sama bisa menunjukkan masalah berbeda di setiap industri
Microsoft membangun lingkungan sintetis untuk tiga industri, masing-masing berdasarkan alur kerja bisnis nyata:
- Farmasi: proses pengajuan ke regulator, diskusi uji klinis, dan rapat tinjauan keselamatan lintas fungsi
- Pasar modal: pipeline transaksi, komunikasi kepatuhan, dan tinjauan portofolio klien
- Perusahaan IT/perangkat lunak: perencanaan iterasi, diskusi tinjauan kode, dan koordinasi peluncuran produk
Menurut artikel aslinya, penyesuaian industri membuat kueri evaluasi lebih dekat dengan pertanyaan yang benar-benar diajukan pengguna di bidang tersebut. Dengan begitu, pola kegagalan spesifik domain yang tidak terdeteksi oleh kasus uji umum bisa terungkap. Bagi tim internal perusahaan, yang biasanya hanya melayani satu atau dua industri, pendekatan ini justru lebih mudah didalami.
Pembuatan kueri otomatis: membedah pipeline enam tahap
Setelah memiliki lingkungan sintetis, kita masih membutuhkan kueri evaluasi. Menurut artikel aslinya, menulis ribuan kueri yang sesuai dengan data dan memiliki karakteristik industri secara manual terlalu mahal dan lambat. Karena itu, dibuatlah pipeline otomatis. Artikel asli hanya memberikan ringkasan untuk setiap tahap. Tabel berikut merangkum enam tahap berdasarkan urutan deskripsinya; pembagian tahap secara detail mengikuti diagram pada artikel asli.
| Tahap | Pokok penjelasan artikel asli | Pendekatan sederhana untuk tim kecil dan menengah |
|---|---|---|
| 1. Kumpulan tugas | Berangkat dari beragam tugas umum di tempat kerja | Daftar 50~100 tugas yang umum dilakukan karyawan, seperti merangkum rapat, mencari keputusan, dan membandingkan versi |
| 2. Penyaringan industri | Pilih tugas yang relevan dengan industri tertentu | Minta tim bisnis memilih tugas yang relevan dengan industrinya |
| 3. Penulisan ulang sesuai domain | Tulis ulang menggunakan bahasa dan konteks domain | Tambahkan istilah industri dan jenis dokumen yang umum digunakan |
| 4. Pembuatan berdasarkan lingkungan | Gunakan AI untuk membuat kueri yang mengacu pada data di lingkungan sintetis | Minta model membaca dokumen atau utas tertentu sebelum membuat pertanyaan, sekaligus menghasilkan jawaban referensi dan sumbernya |
| 5. Penulisan ulang agar alami | Tulis ulang agar lebih mirip pertanyaan orang sungguhan | Tambahkan bahasa percakapan, penghilangan kata, dan rujukan tidak langsung, seperti “Rencana itu akhirnya bagaimana?” |
| 6. Validasi | Periksa keakuratan dan keunikan setiap kueri | Hapus duplikasi dan periksa sampel untuk memastikan setiap jawaban memiliki satu dasar yang jelas dalam data |
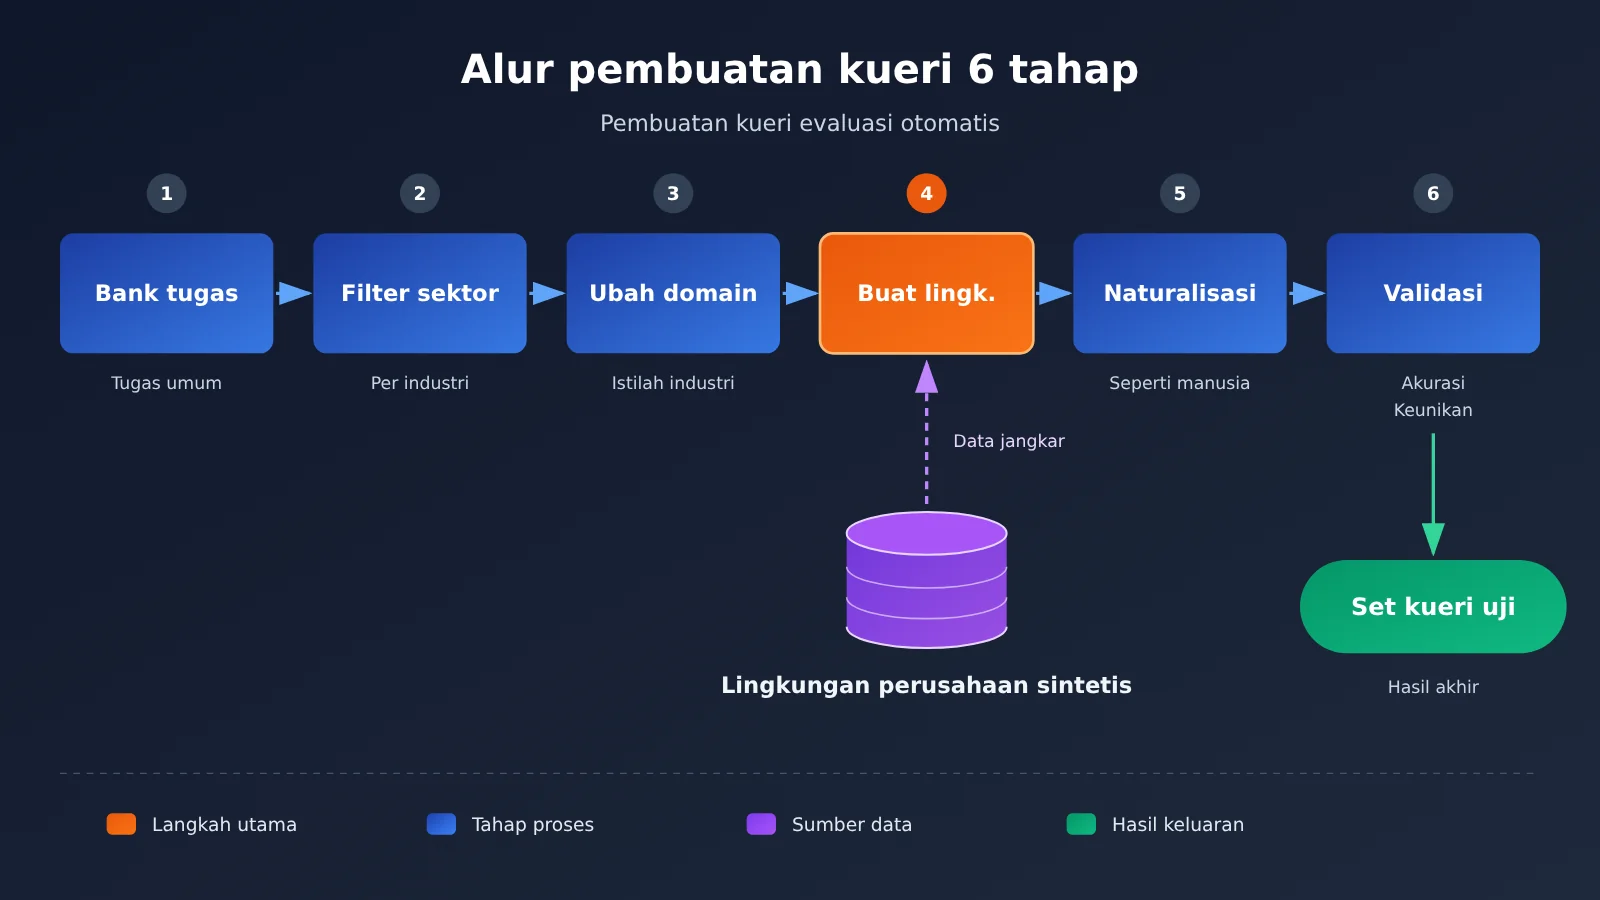
Tahap 4 adalah kunci seluruh pipeline: kueri harus mengacu pada data spesifik di lingkungan tersebut. Jika tidak, kita tidak bisa menilai apakah jawabannya benar. “Keunikan” pada tahap 6 juga mudah terlewat. Jika satu pertanyaan memiliki beberapa jawaban yang masuk akal berdasarkan data, penilaiannya bisa diperdebatkan.
Pada tahap 4 dan 5, satu model bisa digunakan untuk membuat pertanyaan, sementara model lain melakukan penulisan ulang agar lebih alami atau melakukan validasi. Ini membantu mengurangi bias akibat model yang sama membuat dan menjawab pertanyaannya sendiri. Saat memanggil beberapa model melalui antarmuka kompatibel OpenAI dari APIYI apiyi.com, Anda hanya perlu mengganti nama model; skrip pembuatan pada dasarnya tidak perlu diubah.
🎯 Saran teknis: Pada tahap pembuatan kueri, tetapkan templat petunjuk, nama model, dan parameter seperti seed acak, lalu simpan semuanya dalam file konfigurasi. Dengan begitu, saat mengganti model untuk eksperimen perbandingan, satu-satunya variabel yang berubah adalah modelnya. Melalui antarmuka terpadu APIYI, Anda bisa beralih antara model dari berbagai penyedia dalam alur kerja yang sama untuk membuat dan memvalidasi kueri.
Validasi kualitas data sintetis: uji data dulu, baru model
Data sintetis juga perlu dievaluasi. Kalau tidak, skor model yang tinggi mungkin hanya karena datanya terlalu mudah. Artikel asli menyebutkan bahwa kualitas diukur dengan kerangka evaluasi semantik internal berdasarkan “tiga dimensi”, tetapi sebenarnya mencantumkan empat aspek. Tabel berikut memuat keempat aspek tersebut; perhatikan perbedaan ini saat mengutipnya.
| Dimensi kualitas | Pertanyaan pemeriksaan dalam artikel asli | Cara pemeriksaan yang bisa diterapkan |
|---|---|---|
| Keakuratan struktur | Apakah struktur organisasi mencerminkan hierarki pelaporan, ukuran tim, dan hubungan lintas fungsi yang nyata? | Hitung kedalaman hierarki dan distribusi jumlah anggota tim, lalu bandingkan dengan data publik |
| Relevansi konteks | Apakah kueri dan alur kerja mewakili pola penggunaan di perusahaan nyata? | Minta staf bisnis menilai sampel kueri secara buta dan memberi skor berdasarkan kemiripannya dengan masalah nyata |
| Keaslian perilaku | Apakah pengguna simulasi memiliki pola komunikasi dan dinamika kolaborasi yang menyerupai manusia? | Periksa apakah email memiliki rangkaian balasan, serta apakah rapat memuat perbedaan pendapat dan tindak lanjut |
| Keamanan konten | Apakah konten bebas dari materi berbahaya, menyinggung, atau informasi pengenal pribadi, serta tidak menyamar sebagai orang nyata? | Pindai format nama, nomor telepon, dan nomor identitas secara otomatis, lalu tinjau secara manual |
Menurut artikel asli, dibandingkan dengan metode pembuatan awal, metrik kualitas keseluruhan meningkat sebesar 39%. Skor kualitas pada beberapa lingkungan industri juga melampaui 0.9 dari skor maksimum 1.0. Artikel tersebut mengaitkan peningkatan ini dengan dua hal: penggunaan sinyal dari industri nyata dan pemanfaatan metrik kualitas keseluruhan untuk mendorong perbaikan kualitas secara otomatis. Perlu dicatat bahwa skor ini mengukur seberapa mirip data sintetis dengan kondisi perusahaan nyata, bukan kinerja Copilot itu sendiri. Artikel asli tidak mengungkapkan metrik Copilot pada kumpulan data tersebut.
Reproduksibilitas: syarat penggunaan set evaluasi sintetis untuk regresi lintas versi
Artikel asli menyebutkan empat masalah yang muncul tanpa otomatisasi:
- Reproduksibilitas: hasil proses manual sedikit berbeda setiap kali dijalankan sehingga sulit dibandingkan antarversi
- Skala: jumlah variasi industri dan konfigurasi melampaui kemampuan pengerjaan manual
- Kecepatan iterasi: pembuatan manual memakan waktu berhari-hari dan memperlambat umpan balik
- Konsistensi antartim: tanpa alat standar, format dan kualitas dataset dari berbagai tim tidak kompatibel
Setelah otomatisasi, pembuatan dataset yang tadinya memakan waktu berhari-hari secara manual bisa berjalan otomatis. Microsoft memperkirakan penghematan sekitar 100.000 dolar AS untuk setiap dataset evaluasi, atau sekitar 300.000 dolar AS untuk seluruh proyek. Perkiraan ini didasarkan pada skala mereka sendiri dan tidak bisa langsung diterapkan pada tim lain. Menurut artikel asli, hasil yang lebih penting adalah: tim mana pun yang membuat ulang dataset dengan konfigurasi yang sama akan mendapatkan dataset yang persis sama.
Hal ini penting untuk pengujian regresi. Saat Anda mengubah strategi pencarian atau mengganti model dan skornya turun, Anda harus memastikan bahwa perubahan itu berasal dari sistem, bukan dari data. Jika set pengujian yang dibuat ulang selalu sedikit berbeda, perbandingan antarversi menjadi tidak bermakna.
Saat membandingkan beberapa kandidat model di APIYI, prinsip yang sama juga perlu diterapkan: tetapkan set evaluasi sintetis dengan nomor versi yang sama, lalu jalankan pengujian untuk setiap model. Dengan begitu, hasil perbandingan hanya mencerminkan perbedaan antarmodel.
Panduan cepat membangun dataset evaluasi perusahaan sintetis untuk tim kecil dan menengah
Sistem Microsoft melibatkan riwayat komunikasi lengkap dari ratusan pengguna, tiga lingkungan industri, peninjauan hukum, dan direktori bersama internal. Tim kecil dan menengah tidak perlu menirunya secara persis. Berikut langkah-langkah yang disederhanakan dari metode dalam artikel asli.
Langkah-langkah
- Tentukan cakupan: Pilih satu skenario bisnis, misalnya “tanya jawab notulen rapat” atau “pencarian dokumen proyek”, dan fokus pada satu industri.
- Rancang organisasi: Gunakan informasi lowongan kerja publik dan sumber industri sebagai referensi. Buat organisasi virtual beranggotakan 20~50 orang, lalu jelaskan departemen, jenjang jabatan, dan hubungan pelaporannya.
- Susun linimasa: Buat linimasa proyek selama 4~8 minggu terlebih dahulu. Daftarkan peristiwa penting, titik pengambilan keputusan, dan perubahan. Kemudian, gunakan linimasa itu untuk membuat notulen rapat, email, dan dokumen yang saling terkait secara konsisten.
- Buat konten: Gunakan Model Bahasa Besar untuk membuat dokumen satu per satu berdasarkan linimasa. Sertakan metadata seperti tanggal, penulis, dan peserta pada setiap dokumen.
- Buat kueri: Susun pertanyaan mengikuti alur enam tahap di atas. Sertakan jawaban referensi dan nomor dokumen sumber untuk setiap pertanyaan, serta tandai kueri terkait waktu secara terpisah.
- Validasi data: Periksa sampel berdasarkan empat dimensi kualitas. Pemindaian PII wajib dilakukan pada seluruh data.
- Terapkan pengelolaan versi: Masukkan rancangan organisasi, linimasa, petunjuk, nama model, dan parameternya ke dalam konfigurasi, lalu beri nomor versi.
- Jalankan evaluasi: Jalankan sistem yang diuji pada versi dataset yang tetap, lalu catat skor untuk setiap jenis kueri.
🚀 Mulai cepat: Langkah 4 dan 5 membutuhkan pemanggilan Model Bahasa Besar berulang kali. Melalui antarmuka kompatibel OpenAI dari APIYI apiyi.com, Anda dapat mengakses beberapa model dengan cara pemanggilan yang sama. Gunakan satu model untuk membuat data dan model lain untuk memvalidasinya—cukup ubah nama model.
Daftar periksa mandiri
- [ ] Data evaluasi sama sekali tidak memuat data pelanggan atau karyawan nyata
- [ ] Struktur organisasi memiliki hierarki dan kolaborasi lintas departemen, bukan sekadar daftar tanpa jenjang
- [ ] Data memiliki struktur waktu yang realistis, mencakup setidaknya beberapa minggu, dan peristiwanya saling terkait secara sebab-akibat
- [ ] Sebagian kueri berkaitan dengan waktu, seperti “minggu lalu” atau “sejak evaluasi terakhir”
- [ ] Kueri menggunakan istilah dan jenis dokumen yang lazim di industri Anda
- [ ] Setiap kueri memiliki satu jawaban acuan yang dapat diverifikasi beserta sumbernya
- [ ] Data sintetis telah melalui pemeriksaan kualitas, bukan langsung digunakan
- [ ] Konfigurasi yang sama dapat menghasilkan ulang dataset yang sama
Tahapan mana yang membutuhkan investasi besar, dan mana yang bisa disederhanakan
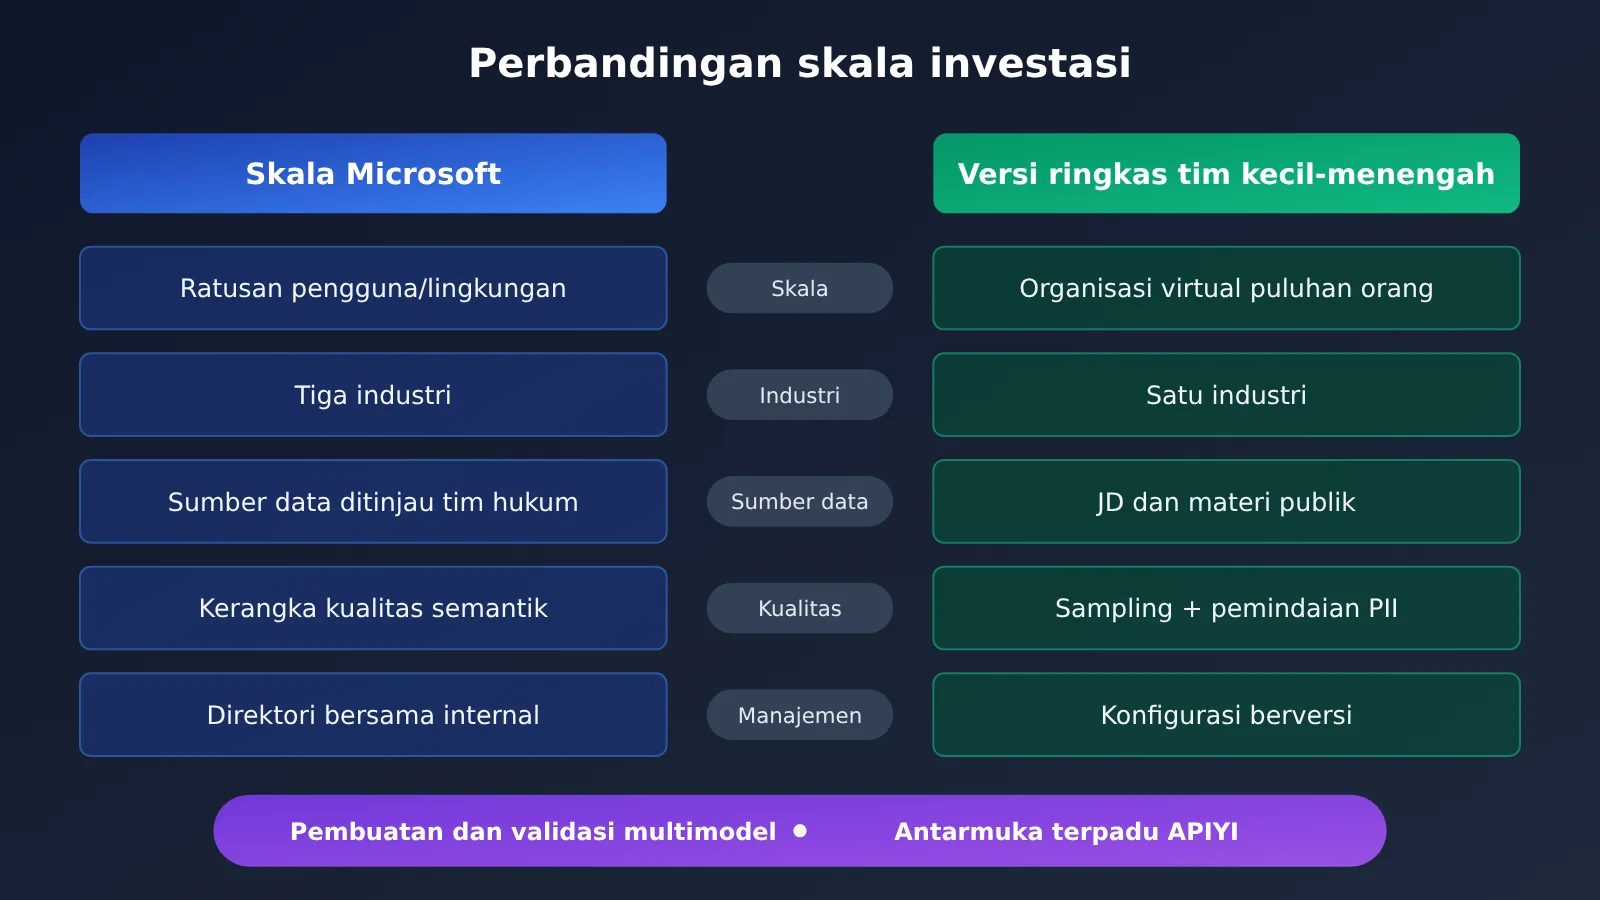
| Tahapan | Pendekatan Microsoft | Tingkat investasi | Saran untuk tim kecil dan menengah |
|---|---|---|---|
| Penggunaan data publik | O*NET, informasi lowongan kerja, dokumen SEC, ditinjau tim hukum | Tinggi | Cukup kumpulkan materi industri secara manual, tetapi tetap pastikan sumbernya boleh digunakan |
| Skala lingkungan | Ratusan pengguna per lingkungan, dengan riwayat komunikasi lengkap | Tinggi | Puluhan orang cukup untuk mencakup peran utama |
| Cakupan industri | Tiga industri | Sedang | Fokus pada satu industri yang Anda layani |
| Kerangka kualitas | Kerangka evaluasi semantik internal dan metrik menyeluruh | Tinggi | Pengambilan sampel manual + statistik sederhana + pemindaian PII otomatis |
| Struktur waktu | Organisasi yang berkembang seiring waktu | Tidak bisa dihilangkan | Susun linimasa sebelum membuat konten |
| Reproduktibilitas | Konfigurasi yang sama menghasilkan hasil yang sama | Tidak bisa dihilangkan | Gunakan konfigurasi berversi dan simpan hasil pembuatan dalam cache |
Skala dan tingkat otomatisasi bisa dikurangi, tetapi struktur waktu, pengaitan kueri dengan data, dan reproduktibilitas tidak bisa dihilangkan. Ketiganya menentukan apakah hasil evaluasi dapat digunakan untuk mengambil keputusan peluncuran. Perlu dicatat, saat ini belum ada materi publik yang bisa dijadikan acuan mengenai biaya dan hasil nyata penerapan metode ini oleh tim kecil dan menengah. Saran di atas merupakan perkiraan berdasarkan metode dalam artikel asli.
Pertanyaan Umum (FAQ)
Q1: Apa itu kumpulan evaluasi lingkungan perusahaan sintetis?
Ini adalah ruang kerja perusahaan simulasi yang seluruhnya dibuat secara terprogram. Isinya mencakup karyawan, struktur organisasi, rapat, email, dan dokumen, beserta serangkaian kueri evaluasi berdasarkan data tersebut. Tujuannya adalah menguji apakah aplikasi AI perusahaan dapat menemukan, menggabungkan, dan menyajikan informasi yang tepat tanpa mengakses data pelanggan asli.
Q2: Apa perbedaan kumpulan evaluasi sintetis dan benchmark umum?
Benchmark umum berguna untuk membandingkan kemampuan umum, tetapi tidak mencakup hubungan pelaporan, riwayat proyek, dan proses bidang tertentu. Lingkungan perusahaan sintetis mempertahankan struktur tersebut sehingga dapat mengungkap kegagalan spesifik bidang yang tidak terdeteksi oleh kasus uji umum, seperti salah mengidentifikasi departemen atau melewatkan keputusan dalam rapat lintas fungsi.
Q3: Kapan metode Microsoft ini dipublikasikan?
Microsoft Research menerbitkan blog terkait pada 30 Oktober 2026. Artikel aslinya menyebutkan bahwa platform ini telah dirilis ke direktori bersama internal dan menjadi baseline evaluasi standar pertama untuk Microsoft Copilot.
Q4: Untuk skenario apa metode ini paling cocok?
– **Tanya jawab tentang notulen rapat**: Menguji keakuratan ringkasan, ekstraksi item tindakan, dan kutipan
– **Pencarian pengetahuan perusahaan**: Menguji kemampuan menemukan satu-satunya sumber yang tepat di antara banyak dokumen
– **Kueri terkait waktu**: Menguji pertanyaan seperti “Apa yang diputuskan minggu lalu?” dan “Apa yang baru saja berubah?”
– **Regresi model atau versi**: Membandingkan solusi lama dan baru pada kumpulan data yang sama
Q5: Bagaimana cara membandingkan berbagai model dengan kumpulan evaluasi sintetis yang sama?
Kuncinya adalah mempertahankan versi kumpulan data dan hanya mengganti model yang diuji. APIYI apiyi.com menyediakan antarmuka terpadu yang kompatibel dengan OpenAI dan mendukung berbagai model populer. Untuk beralih, cukup ubah nama model, sehingga skrip evaluasi yang sama bisa digunakan untuk menjalankan setiap kandidat secara bergantian. Perlu dicatat, Anda tetap harus membuat logika penilaian dan kerangka evaluasinya sendiri.
Q6: Apakah data sintetis bisa membuat hasil evaluasi tidak akurat?
Bisa. Karena itu, artikel aslinya menetapkan kerangka kualitas untuk mengevaluasi data terlebih dahulu sebelum mengevaluasi model. Jika data sintetis terlalu rapi dan tidak memiliki perbedaan pendapat serta noise seperti di dunia nyata, skor model bisa tampak lebih tinggi daripada kemampuan sebenarnya. Sebaiknya minta tim bisnis menilai sampel data secara buta, lalu kalibrasikan data sintetis secara berkala menggunakan umpan balik nyata yang telah dianonimkan.
Q7: Apa saja keterbatasan metode ini yang sudah diketahui?
Artikel aslinya tidak mengungkap petunjuk, alat, atau detail implementasi setiap tahap pipeline, dan juga tidak menyebutkan metrik evaluasi Copilot. Kerangka kualitas menyebutkan “tiga dimensi”, tetapi mencantumkan empat poin. Jumlah penghematan merupakan estimasi Microsoft sendiri. Artikel itu juga menyebutkan bahwa interaksi agen multi-putaran, perubahan organisasi selama berbulan-bulan atau bahkan bertahun-tahun, serta sistem AI yang melakukan tindakan merupakan masalah evaluasi yang akan mereka tangani selanjutnya.
Poin Utama Dataset Evaluasi Lingkungan Perusahaan Sintetis
- Struktur tiga lapisan: lingkungan sintetis sebagai fondasi, pembuatan kueri otomatis, dan validasi kualitas data. Tanpa salah satunya, evaluasi tidak dapat diandalkan.
- Kalibrasi dengan data publik: gunakan basis data profesi, lowongan kerja, dan laporan keuangan publik agar struktur organisasi mendekati kondisi nyata.
- Struktur waktu tidak boleh dilewatkan: kueri terkait waktu membutuhkan data dengan urutan kejadian dan hubungan sebab-akibat yang realistis.
- Penyesuaian industri meningkatkan temuan: kueri yang sesuai dengan bidangnya lebih mudah mengungkap kegagalan yang khas di bidang tersebut.
- Uji data sebelum model: periksa data sintetis dari empat aspek: struktur, konteks, perilaku, dan keamanan.
- Reproduksibilitas adalah syarat uji regresi: konfigurasi yang sama harus menghasilkan data yang sama agar perbandingan antarversi bermakna.
- Perbandingan beberapa model: setelah dataset ditetapkan, gunakan antarmuka terpadu APIYI untuk mengganti nama model dan membandingkan hasilnya.
Kesimpulan
Metode lingkungan perusahaan sintetis Microsoft Copilot dapat dirangkum dalam tiga poin:
- Gunakan data sintetis untuk menjaga privasi: tanpa menggunakan data pelanggan sejak awal, dataset dapat dibagikan dan digunakan kembali secara bebas antar tim.
- Gunakan struktur untuk meningkatkan realisme: hierarki organisasi, linimasa, dan alur kerja industri menentukan apakah evaluasi dapat menemukan masalah nyata.
- Gunakan otomatisasi agar hasil dapat direproduksi: konfigurasi yang sama harus menghasilkan dataset yang sama agar hasil evaluasi dapat mendukung keputusan peluncuran.
Tim kecil dan menengah tidak perlu meniru skala Microsoft, tetapi struktur waktu, pengaitan kueri dengan data, dan pengelolaan versi konfigurasi layak diterapkan. Mulailah dengan satu skenario, satu industri, dan organisasi virtual beranggotakan puluhan orang. Jalankan satu proses lengkap, lalu perluas secara bertahap.
Setelah dataset ditetapkan, APIYI apiyi.com dapat digunakan untuk mengakses beberapa model melalui metode pemanggilan yang kompatibel dengan OpenAI. Dengan begitu, performa model dapat langsung dibandingkan pada dataset evaluasi sintetis yang sama.
📚 Referensi
- Microsoft Research Blog – From synthetic enterprise data evaluations to real Microsoft Copilot AI confidence: Sumber utama untuk pembahasan metode dalam artikel ini
- Tautan:
microsoft.com/en-us/research/blog/from-synthetic-enterprise-data-evaluations-to-real-microsoft-copilot-ai-confidence -
Keterangan: Memuat penjelasan asli tentang lingkungan sintetis, pipeline enam tahap, kerangka kualitas, desain privasi, dan data hasil
-
Basis data pekerjaan O*NET: Basis data informasi pekerjaan milik Departemen Tenaga Kerja AS
- Tautan:
onetonline.org -
Keterangan: Digunakan dalam artikel asli untuk menyesuaikan peran, tanggung jawab, dan distribusi aktivitas kerja karyawan sintetis
-
Pencarian dokumen publik SEC EDGAR: Dokumen keterbukaan publik dari Komisi Sekuritas dan Bursa AS
- Tautan:
sec.gov/edgar - Keterangan: Digunakan dalam artikel asli untuk menentukan skala, struktur unit bisnis, dan latar belakang keuangan organisasi sintetis
Penulis: Tim Teknis APIYI
Diskusi teknis: Untuk pertanyaan tentang akses terpadu ke berbagai model, silakan berdiskusi dengan kami melalui situs APIYI apiyi.com