Artikel ini menggunakan kasus migrasi, layanan pelanggan, dan kode dari GPT-6.1 Sol serta GPT-6.2 Sol untuk menjelaskan cara menetapkan kriteria penerimaan bisnis terlebih dahulu, lalu memilih tingkat penalaran yang mampu memenuhi kriteria secara stabil, sekaligus menghitung biaya setiap tugas yang memenuhi kriteria.
Intinya: saat menyesuaikan tingkat, yang seharusnya dibandingkan adalah “berapa biaya dan waktu untuk setiap tugas yang memenuhi kriteria”; harga per pemanggilan hanyalah salah satu komponen. Dalam uji skala kecil yang sudah dipublikasikan, low milik GPT-6.2 Sol mencapai jumlah kelulusan yang sama dengan medium pada soal kebijakan layanan pelanggan dan satu set soal kode, dengan waktu yang lebih singkat. Pada soal kode, biaya ekuivalen dari harga tercantum untuk low sekitar tujuh puluh persen dari medium. Kesimpulan ini berlaku dengan dua syarat: tugas Anda cukup mirip dengan tugas pengujian, dan ambang penerimaan tidak hanya melihat tingkat kelulusan, tetapi juga memeriksa tautan fiktif, field nominal, dan pekerjaan ulang. Untuk tugas dengan konflik antar-sumber, ketergantungan alat yang rumit, atau yang mudah melewatkan batasan, tingkat medium dan di atasnya tetap perlu diverifikasi secara terpisah.
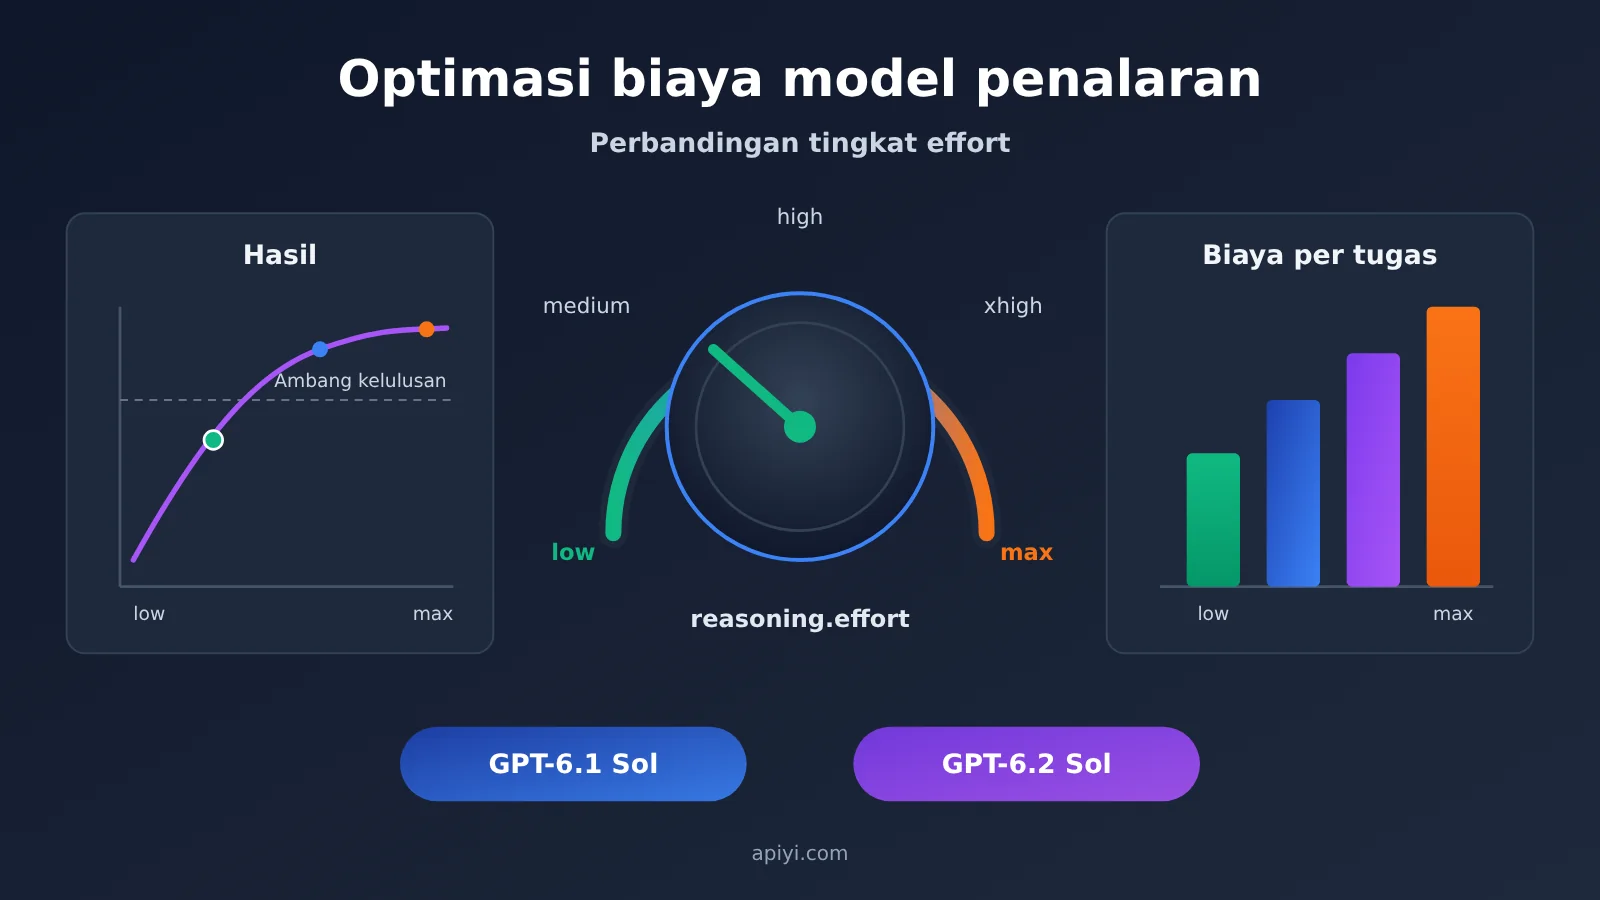
Ringkasan perbandingan tingkat effort model penalaran
Tabel berikut merangkum beberapa kumpulan bukti yang akan digunakan dalam artikel ini; setiap baris mencantumkan sumber dan cakupannya. Angka dari sumber berbeda tidak dapat langsung dijumlahkan atau dicampur.
| Dimensi perbandingan | GPT-6.1 Sol | GPT-6.2 Sol | Apa arti perbedaannya |
|---|---|---|---|
| Tingkat yang tersedia (dokumentasi OpenAI) | low, medium, high, xhigh, max | Lima tingkat yang sama; menolak none |
Saat bermigrasi dari model yang mengizinkan none/minimal, tingkat awal perlu diubah |
| Harga tercantum APIYI untuk konteks pendek (tabel umum 2026-11-20, USD/juta Token) | Input $2, baca cache $0.10, output $10 | Sama seperti kiri | Pada konteks pendek, harga kedua generasi sama; perbedaan biaya terutama berasal dari penggunaan |
| Harga input saat Token input melebihi 272,000 | APIYI dan OpenAI Standard sama-sama mencantumkan $4 | APIYI mencantumkan $3, OpenAI Standard mencantumkan $4 | Pada skenario input panjang, muncul selisih harga antarkanal |
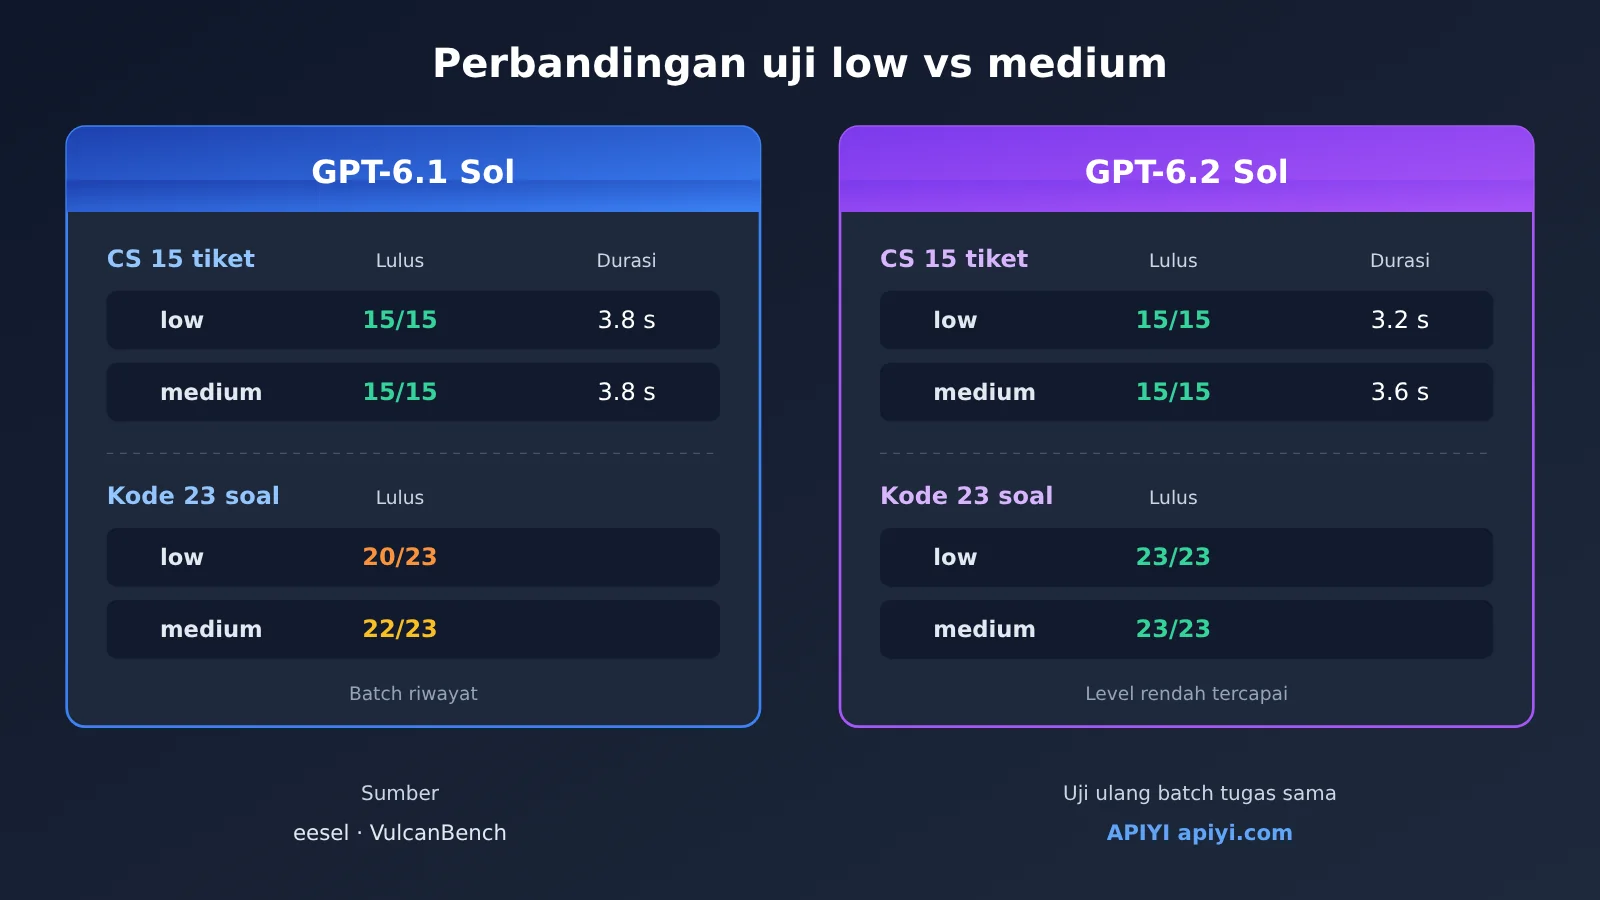
| eesel layanan pelanggan 15 tiket (low / medium) | 15/15, 3.8 detik; 15/15, 3.8 detik | 15/15, 3.2 detik; 15/15, 3.6 detik | Tingkat kelulusan sama; perbedaan biaya antar-tingkat sangat kecil |
| VulcanBench 23 soal kode (low / medium) | 20/23; 22/23 (batch historis) | 23/23; 23/23 | Tingkat rendah 6.2 Sol sudah memenuhi kriteria; angka lintas versi berasal dari batch berbeda |
| Artificial Analysis Index (dikutip ulang oleh OrcaRouter, low / medium) | 35; 46 | 41; 53 | Indeks komposit pihak ketiga; label tingkat dipetakan sendiri oleh evaluasi tersebut |
Isi artikel disusun dengan urutan berikut: Bagian 1 memastikan apakah model dapat diintegrasikan dan bagaimana penghitungan harganya, Bagian 2 membahas hasil uji pada tugas yang sama, Bagian 3 memberikan langkah migrasi dan penerimaan, Bagian 4 membahas persoalan menyesuaikan tingkat di tengah sesi multi-giliran. Jika Anda sudah memastikan routing model dan harga, Anda bisa langsung membaca dari Bagian 2.
Terminologi Terkait Tingkat Effort Penalaran yang Perlu Diketahui
| Istilah | Penjelasan |
|---|---|
reasoning.effort |
Field dalam Responses API yang digunakan untuk mengatur intensitas penalaran model |
| Token penalaran | Pemakaian penalaran yang dikonsumsi model untuk menghasilkan jawaban. Termasuk dalam output_tokens yang ditagih, dan perlu dibedakan dari output yang terlihat oleh pengguna |
low / medium |
Dua tingkat penalaran. Setelah beralih ke versi baru pada tingkat yang sama, tetap perlu validasi ulang |
| Harga satuan pembacaan cache | Hanya berlaku untuk bagian input yang cocok dengan prefiks yang dapat digunakan kembali; tidak bisa dihitung langsung dari jumlah Token total |
| Prefiks permintaan | Konteks yang sudah ada sebelum pesan saat ini. Mengubah riwayat awal akan memengaruhi penggunaan ulang cache dan item penalaran |
configuration_update |
Item input dalam sesi Responses yang mendukung fitur ini, dipakai untuk menyesuaikan konfigurasi berikutnya |
| Ambang validasi | Standar minimum yang dapat diterima untuk kebenaran kebijakan, kelulusan fungsi, atau tingkat pengerjaan ulang |
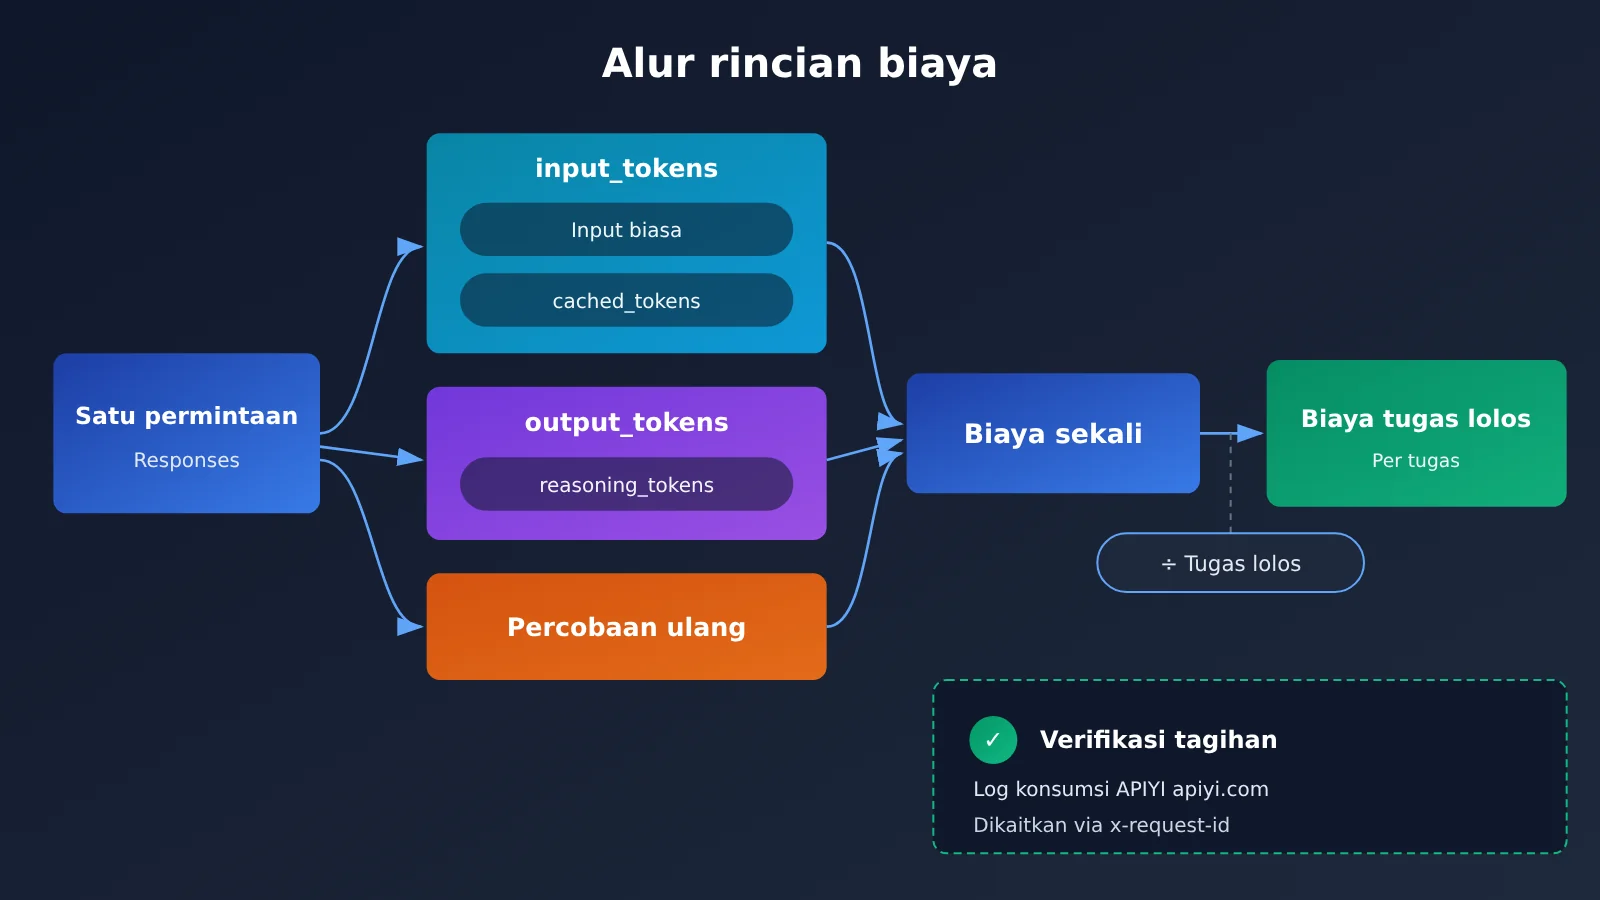
| Biaya per tugas yang memenuhi standar | Biaya pemanggilan, retry, tool, dan pengerjaan ulang manual dari seluruh uji coba, dibagi dengan jumlah tugas yang memenuhi standar |
1. Sebelum Optimasi Biaya Model Penalaran: Kapan Layak Menyesuaikan Tingkat Effort
1.1 Status integrasi dua generasi Sol di APIYI
Berdasarkan pembaruan platform APIYI, GPT-6.1 Sol diluncurkan pada 2026-09-30, sedangkan GPT-6.2 Astra dan Sol diumumkan diluncurkan pada 2026-11-18. Tabel harga lengkap per 2026-11-20 menunjukkan bahwa kedua varian Sol menyediakan dua rute sekaligus, yaitu responses dan chat, dengan grup terkait CodexResponses, Codex_Reverse, Default, dan SVIP. Kemampuan apa saja yang benar-benar dapat dipanggil oleh akun bergantung pada grup tempat token berada.
Menurut dokumentasi OpenAI, kedua generasi Sol mendukung Chat Completions dan Responses, tetapi tool calling harus melalui Responses, dan tingkat effort diatur melalui reasoning.effort. Jadi, selama alur bisnis mencakup bagian berbasis tool seperti kueri pesanan dan eksekusi kode, evaluasi dan peluncuran sebaiknya menggunakan rute Responses secara konsisten, agar perbedaan perilaku kedua rute tidak ikut masuk ke hasil perbandingan.
1.2 Dua basis harga: harga tertera APIYI vs harga standar upstream
| ID Model (tabel lengkap APIYI, 2026-11-20) | Input biasa | Baca cache | Output | Platform tersedia |
|---|---|---|---|---|
gpt-6.2-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, OpenAI resmi |
gpt-6.1-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, OpenAI resmi |
gpt-6-sol |
$2 | $0.20 | $10 | APIYI |
gpt-6.2-astra |
$8 | $0.40 | $40 | APIYI |
Tabel di atas adalah harga default untuk konteks pendek, dengan satuan dolar per juta token. Kartu harga upstream yang disusun OrcaRouter mencantumkan harga input, baca cache, dan output yang sama untuk kedua generasi Sol, serta mencantumkan biaya tulis cache sebesar $2.50 secara terpisah. Konteks panjang perlu diperiksa secara terpisah: untuk gpt-6.2-sol, ketika input melebihi 272.000 token, APIYI saat ini mencantumkan $3, sedangkan OpenAI resmi Standard mencantumkan $4; untuk gpt-6.1-sol, keduanya sama-sama $4. Untuk harga cache dan output pada tier panjang, silakan mengacu pada aturan penagihan real-time masing-masing kanal.
1.3 Biaya harus dibaca dari respons nyata dan tagihan
Harga katalog hanya bisa dipakai untuk estimasi. Berikut contoh perhitungan dengan serangkaian asumsi untuk menjelaskan bagaimana biaya dipecah. Asumsikan setiap putaran input 12,000 Token, tanpa penulisan cache dan biaya alat:
- Prefiks dipertahankan: pembacaan cache 9,000, total output 1,000, estimasi sekitar $0.0169.
- Prefiks diubah: pembacaan cache turun ke 3,000, total output naik ke 1,600, estimasi sekitar $0.0343.
Dari selisih keduanya, sekitar $0.0114 berasal dari 6,000 Token input yang berubah dari harga cache kembali ke harga normal, dan sekitar $0.0060 berasal dari tambahan 600 Token output. Ini data asumsi; selisih sebenarnya mengacu pada usage. Jika ada penulisan cache yang dicatat terpisah, hitung input normal, pembacaan cache, dan penulisan cache sebagai tiga kategori yang saling eksklusif.
Cara memverifikasi pemotongan biaya sebenarnya: gunakan x-request-id di header respons untuk mengaitkannya dengan catatan type=2 di log konsumsi APIYI, konversi nilai dolar pemotongan biaya sebenarnya dengan quota ÷ 500,000, sekaligus catat model, grup token, jendela waktu pemanggilan, penggunaan input/output, dan jumlah percobaan ulang.
Berikut contoh pemanggilan paling sederhana, sekaligus membaca field penggunaan yang dibutuhkan untuk diagnostik:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "low"},
    input=[{"role": "user", "content": "根据退款政策判断工单 #1024 是否可退"}],
)

u = resp.usage
print(resp.output_text)
print("输入:", u.input_tokens, "缓存命中:", u.input_tokens_details.cached_tokens)
print("总输出:", u.output_tokens, "其中推理:", u.output_tokens_details.reasoning_tokens)
🚀 Mulai cepat: sebaiknya jalankan dulu contoh di atas di APIYI apiyi.com menggunakan kuota gratis pengguna baru, pastikan grup tujuan dapat mengembalikan
cached_tokensdanreasoning_tokensdengan normal, lalu mulai evaluasi batch.
2. Perbandingan tugas yang sama: hasil pengujian nyata tingkat low dan medium
2.1 Tiket layanan pelanggan: manfaat tingkat rendah sangat kecil
Penguji eesel pada 2026-11-18 menguji masing-masing dua generasi Sol pada tingkat low dan medium melalui Responses API, dengan total 60 pemanggilan. Setiap konfigurasi mencakup 15 tiket yang sama, berisi permintaan pengembalian dana, pelacakan logistik, dan kegagalan alat pesanan, yang dinilai secara manual berdasarkan kebijakan SaaS fiktif.
| Konfigurasi (eesel, 15 tiket) | Lulus | Rata-rata waktu | Konversi harga/ribu item |
|---|---|---|---|
| GPT-6.1 Sol low | 15/15 | 3,8 detik | $1,32 |
| GPT-6.1 Sol medium | 15/15 | 3,8 detik | $1,35 |
| GPT-6.2 Sol low | 15/15 | 3,2 detik | $1,41 |
| GPT-6.2 Sol medium | 15/15 | 3,6 detik | $1,42 |
Dalam data ini, low dan medium hanya berbeda beberapa sen per seribu item, sehingga dasar pemilihan tingkat lebih pada latensi daripada biaya. Selain itu, berdasarkan konversi penggunaan aktual, GPT-6.2 Sol justru sedikit lebih mahal daripada 6.1 Sol pada soal layanan pelanggan ini. Yang lebih penting, meskipun tingkat kelulusan keempat konfigurasi sempurna, penulis tetap menemukan bahwa 6.2 Sol mengeluarkan tautan logistik yang tidak ada dalam respons alat. Ini menunjukkan bahwa jika penerimaan layanan pelanggan hanya melihat “jawaban benar terhadap kebijakan”, masalah seperti ini akan terlewat, dan sumber tautan serta field harus diperiksa secara terpisah. Bukti ini hanya berlaku untuk kumpulan tiket ini, standar penilaian ini, dan lingkungan pengujian OpenAI.
2.2 Tugas kode: biaya per soal tingkat rendah layak diukur secara langsung
Pada 2026-11-19, VulcanBench menjalankan Codex untuk GPT-6.2 Sol pada set tes 23 soal yang sama, tingkat demi tingkat, total 115 kali. Nilai dalam tabel di bawah dihitung dari kuitansi eksekusi berdasarkan harga resmi API, bukan tagihan aktual akun APIYI.
| Konfigurasi (VulcanBench, 23 soal) | Lulus | Rata-rata waktu | Biaya per soal (harga resmi) | Skor gabungan |
|---|---|---|---|---|
| GPT-6.2 Sol low | 23/23 | 2,8 menit | $0,23 | 88,44 |
| GPT-6.2 Sol medium | 23/23 | 4,4 menit | $0,33 | 88,94 |
| GPT-6.2 Sol max | — | 11,3 menit | $0,55 | 88,74 |
| GPT-6.1 Sol low (batch historis) | 20/23 | 6,9 menit | $0,31 | — |
| GPT-6.1 Sol medium (batch historis) | 22/23 | 10,6 menit | $0,40 | — |
Jika hanya melihat kelompok GPT-6.2 Sol: jumlah soal yang lulus pada low dan medium sama, biaya per soal sekitar 30% lebih rendah, dan waktunya juga lebih singkat; skor gabungan max tidak melebihi medium. Perbandingan antarversi perlu dilakukan dengan hati-hati: data 6.1 Sol berasal dari evaluasi historis pada set soal yang sama, tetapi termasuk batch pengujian yang berbeda. Skor gabungan adalah penilaian kualitas kode, sedangkan tingkat kelulusan tes adalah dua metrik berbeda yang tidak dapat saling menggantikan.
Artificial Analysis Index v5.0.1 yang dikutip ulang oleh OrcaRouter (dibaca pada 2026-11-20) memberikan sudut pandang lain: pada tingkat low, 6.2 Sol mendapat 41 poin dengan $0,18 per tugas, sedangkan 6.1 Sol mendapat 35 poin dengan $0,16; pada tingkat medium, masing-masing 53 poin dengan $0,41 dan 46 poin dengan $0,36. Label tingkat dalam daftar peringkat gabungan ini adalah cara pemetaan dari pihak evaluator sendiri; framework yang Anda gunakan belum tentu memakai pemetaan yang sama.
💡 Saran pemilihan: Dua pengukuran di atas menunjukkan bahwa ambang kelulusan, tingkat percobaan ulang, dan pengerjaan ulang manual dapat mengubah “tingkat paling hemat”, tetapi semuanya bukan tagihan aktual untuk bisnis Anda sendiri. Disarankan untuk menguji ulang di APIYI apiyi.com dengan grup yang sama dan kumpulan sampel yang sama sebelum mengambil keputusan.
3. Urutan migrasi dan ambang penerimaan untuk optimasi biaya model penalaran
3.1 Pertahankan baseline dulu, baru sesuaikan tingkat
Sesuai saran OpenAI dalam 《Using GPT-6.2》, saat migrasi ubah hanya satu variabel dalam satu waktu:
- Sedang memakai 6.1 Sol
low: ganti dulu ke 6.2 Sollowsebagai pembanding, lalu ujimediumsecara terpisah. - Sedang memakai 6.1 Sol
medium: ganti modelnya dulu tetapi tetap pakaimedium, setelah lolos penerimaan, bandingkan denganlowmemakai batch tugas yang sama. - Integrasi baru: mulai dari
medium. - Migrasi dari model yang bisa disetel
noneatauminimal: GPT-6.2 Sol mulai diuji darilow.
Untuk tugas sederhana dengan batasan yang jelas, validasi bisa dimulai dari low; untuk tugas majemuk, naikkan tingkat secara bertahap sesuai hasil. Selama evaluasi, petunjuk, definisi tool, pengelompokan, dan sampel uji harus dijaga tetap sama. Sekaligus bersihkan parameter yang tidak lagi berlaku sesuai panduan resmi, misalnya menghapus temperature, top_p, top_logprobs pada permintaan Responses.
3.2 Definisikan ambang penerimaan per skenario
| Skenario | Ambang penerimaan | Kapan mempertimbangkan naik tingkat |
|---|---|---|
| Layanan pelanggan rutin | Konsistensi kebijakan, kolom nominal benar, kondisi pemicu eskalasi ke manusia; tautan dan nomor pesanan harus berasal dari hasil tool | Saat melibatkan konflik antar-kebijakan atau rangkaian beberapa tool |
| Modifikasi kode | Tes lulus, fungsi kunci utuh, volume rework saat review kode | Saat tingkat kelulusan di tingkat rendah menurun atau rework meningkat jelas |
| Konten pendek | Kepatuhan pada batasan, kolom fakta, durasi penyuntingan manual | Saat muncul batasan yang terlewat atau kesalahan fakta |
Cara menghitung biaya per tugas yang memenuhi standar: jumlahkan biaya pemanggilan, retry, tool, dan rework manual, lalu bagi dengan jumlah tugas yang memenuhi standar. Selama low memenuhi ambang yang disepakati, low boleh dipilih; jika low butuh banyak retry atau perbaikan manual, harga yang terlihat murah di atas kertas bisa saja tertutup oleh biaya tambahan itu.
💰 Optimasi biaya: saat melakukan perbandingan tingkat, Anda bisa membuat token khusus untuk evaluasi di APIYI apiyi.com, sehingga log bisa langsung difilter berdasarkan token dan model, memudahkan penghitungan biaya sebenarnya untuk seluruh batch percobaan.
4. Menyesuaikan tingkat effort di tengah percakapan multi-giliran
4.1 Mengatur tingkat dengan configuration_update dan mempertahankan prefix
Dalam sesi agen tunggal OpenAI HTTP Responses yang mendukung fitur ini, reasoning.effort tingkat permintaan tetap pada nilai awal, dan letakkan item berikut sebelum pesan pengguna berikutnya:
{"type": "configuration_update", "reasoning": {"effort": "medium"}}
Pengaturan ini akan terus berlaku hingga pembaruan berikutnya. Keuntungannya adalah tidak perlu menulis ulang riwayat awal, sehingga prefix permintaan tetap sama. Menurut dokumentasi OpenAI, mulai dari GPT-6.2, mengedit riwayat awal dapat memicu prefix_mismatch, yang menyebabkan item reasoning yang ada dihapus; beralih keluarga model atau turun ke model dengan kemampuan lebih rendah juga dapat menghapus item reasoning. Biaya menulis ulang prefix terdiri dari dua bagian: pembacaan cache mungkin berkurang, dan setelah item reasoning yang tersedia hilang, output reasoning baru mungkin dihasilkan. Menurut penjelasan resmi, menghapus item lengkap dan membiarkan item lainnya tidak berubah, atau menambahkan item baru setelah item reasoning, tidak akan memicu penghapusan ini, tetapi jumlah cache hit masih dapat berubah. Selain itu, instructions tingkat atas GPT-6.2 ditambahkan setelah input, dan ditagih sebagai input yang tidak di-cache.
4.2 Catatan tentang kompresi konteks dan routing APIYI
Saat menggunakan context_management sisi server, konfigurasi yang diperbarui dapat dilanjutkan. Jika riwayat yang berisi configuration_update lama langsung diberikan ke endpoint /responses/compact yang independen, permintaan akan ditolak; cara yang benar adalah memisahkan item konfigurasi terlebih dahulu sesuai penjelasan resmi, lalu menambahkan konfigurasi terbaru setelah kompresi selesai.
Di APIYI, cara yang aman saat ini adalah mengelola riwayat input sendiri, tanpa bergantung pada previous_response_id. Alasannya, panduan pemanggilan native APIYI tidak konsisten mencatat hal ini: teks utama menyatakan bahwa penyambungan berantai tidak berlaku, sementara FAQ mencatat bahwa pada 2026-09-02 pernah teruji berfungsi. Dokumentasi APIYI saat ini juga belum mencantumkan hasil verifikasi configuration_update di setiap grup. Oleh karena itu, konfigurasi khusus seperti ini, pengembalian item reasoning terenkripsi, dan bidang diagnostik cache sebaiknya diverifikasi terlebih dahulu secara terpisah menggunakan sesi pendek pada saluran target, dan setelah dipastikan berfungsi, baru diintegrasikan ke alur kerja resmi.
🎯 Saran teknis: Anda dapat menjalankan serangkaian sesi pendek dua giliran di routing Responses APIYI apiyi.com terlebih dahulu, membandingkan
cached_tokens,reasoning_tokens, dan waktu proses antara dua sampel “hanya menambahkan” dan “menulis ulang prefix”, lalu memutuskan cara implementasi penyesuaian tingkat di tengah percakapan setelah memastikan perilakunya.
Kalimat terakhir: Dasar untuk memilih tingkat seharusnya adalah biaya setiap tugas yang memenuhi ambang penerimaan yang ditetapkan. Menjalankan satu putaran perbandingan di APIYI apiyi.com dengan sampel dan tagihan Anda sendiri akan lebih menjelaskan masalahnya daripada daftar peringkat mana pun.
Referensi
- OpenAI《Using GPT-6.2》: Saran migrasi dan tingkat awal
- Tautan:
developers.openai.com/api/docs/guides/latest-model
- Tautan:
- OpenAI《Reasoning models》:
configuration_updatedan penggunaan ulang item penalaran- Tautan:
developers.openai.com/api/docs/guides/reasoning
- Tautan:
- OpenAI《Compaction》: Aturan kompresi konteks
- Tautan:
developers.openai.com/api/docs/guides/compaction
- Tautan:
- OpenAI《Keep the prefix unchanged》: Diagnosis prefix dan cache
- Tautan:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- Tautan:
- eesel AI《GPT-6.2 Sol: what’s new, pricing, benchmarks》: Uji coba langsung pada tiket layanan pelanggan, 2026-11-18
- Tautan:
eesel.ai/blog/gpt-6-2-sol
- Tautan:
- VulcanBench《GPT-6.2 Sol across effort levels》: Evaluasi soal pemrograman per tingkat effort, 2026-11-19
- Tautan:
vulcanbench.com/benchmarks/swe-v4-gpt62-sol-v331.html
- Tautan:
- OrcaRouter《GPT-6.2 vs GPT-6.1 Sol》: Kutipan tabel harga dan indeks komprehensif, 2026-11-20
- Tautan:
orcarouter.ai/blog/gpt-6-2-vs-gpt-6-1-sol
- Tautan:
- APIYI《Tabel Harga Model Lengkap》: Data diperbarui pada 2026-11-20
- Tautan:
docs.apiyi.com/models
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami lewat halaman utama APIYI apiyi.com. Keterangan integrasi yang lebih lengkap bisa dilihat di pusat dokumentasi docs.apiyi.com