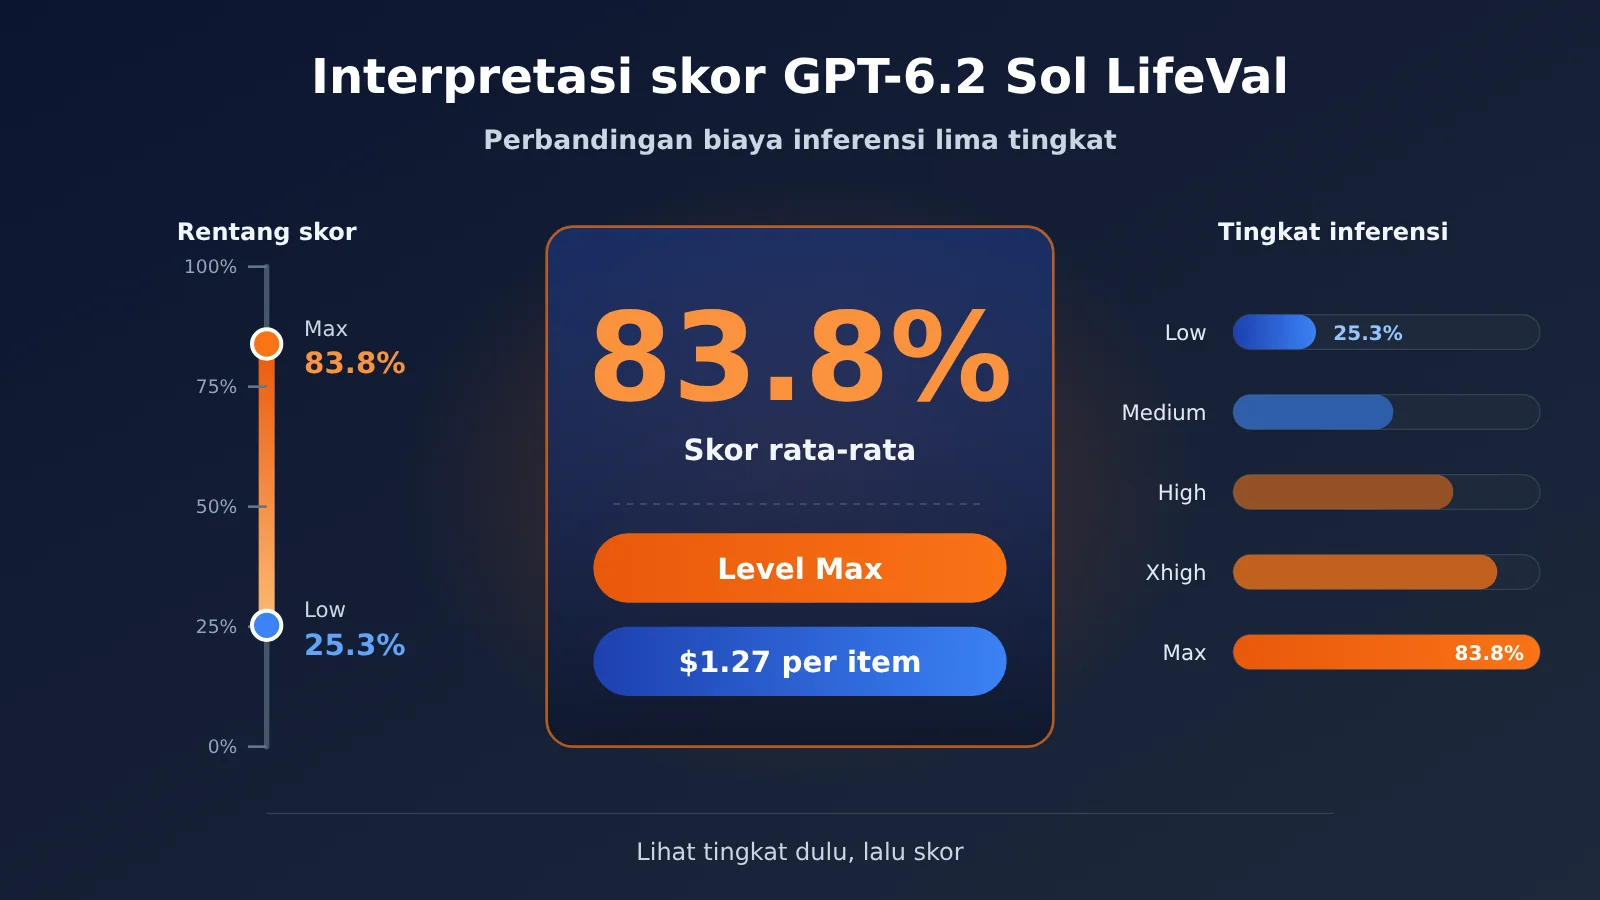
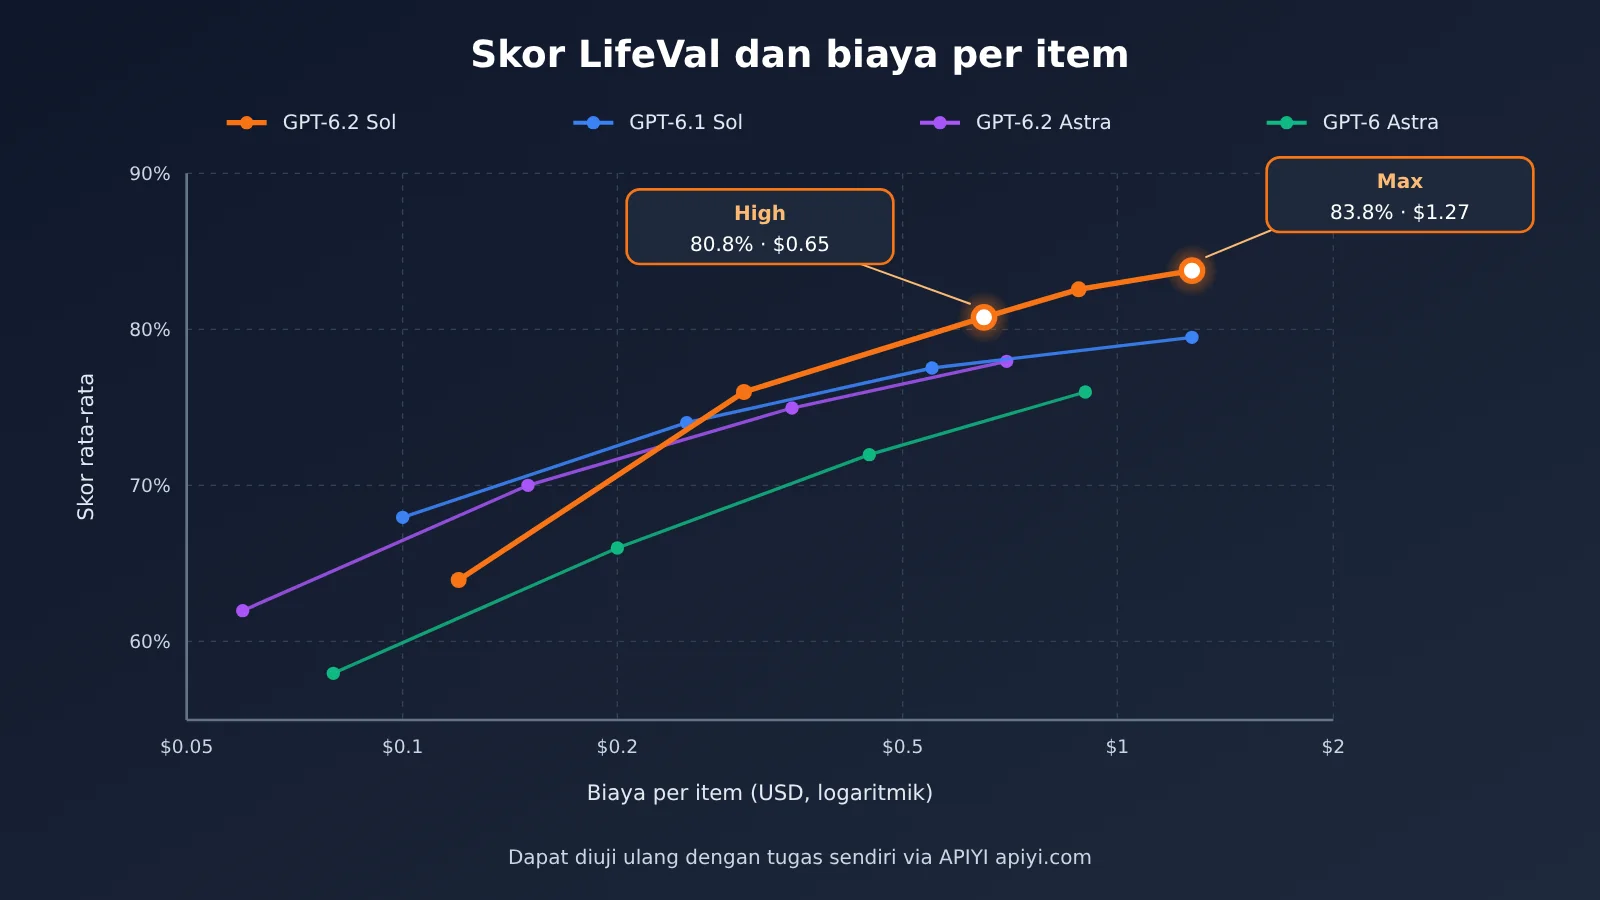
83.8% bukan “83.8% tugas selesai seluruhnya”, melainkan skor rata-rata LifeVal GPT-6.2 Sol pada tingkat penalaran Max. Skor ini dihitung dengan memberi nilai pada tiap item berdasarkan rubrik tiap tugas lalu menjumlahkannya, dan biaya rata-rata per item yang sesuai adalah $1.27. Jika model yang sama dipindah ke tingkat Low, skor rata-ratanya hanya 25.3%; ke tingkat High, skor rata-ratanya 80.8% dengan biaya per item $0.65. Jadi saat membahas performa LifeVal GPT-6.2 Sol, kita harus menjelaskan dulu tingkat mana yang dimaksud.
Kesimpulannya: papan peringkat resmi memberikan “kombinasi skor dan biaya pada tugas serta lingkungan tertentu”, bukan peringkat keseluruhan yang bisa langsung dipindahkan ke produk Anda. Dalam kumpulan data LifeVal ini, tingkat High adalah titik awal yang layak diuji lebih dulu. Tingkat mana yang akhirnya dipakai tetap harus divalidasi dengan tugas Anda sendiri, berdasarkan output dan kondisi nyata.
Apa yang bisa Anda pahami setelah membaca artikel ini?
- Tugas apa yang diukur LifeVal, dan bagaimana 83.8% seharusnya diungkapkan dengan benar.
- Skor dan biaya lima tingkat penalaran GPT-6.2 Sol, serta perbandingan pada tingkat yang sama dengan GPT-6.1 Sol, GPT-6 Astra, dan GPT-6.2 Astra.
- Mengapa “biaya sekitar sepertujuh” dan “penurunan drastis tingkat Low” yang disebut resmi bisa sama-sama berlaku.
- Bagaimana meniru metode validasi LifeVal untuk merancang tugas evaluasi yang dapat diuji ulang bagi asisten harian Anda.
Indeks: Tabel To Know menjelaskan lebih dulu istilah evaluasi yang akan dipakai nanti, sedangkan Ikhtisar Dampak menjelaskan apa yang masing-masing perlu diperhatikan oleh pengguna umum dan pengembang. Bagian fakta objektif secara berurutan menjelaskan sumber tugas LifeVal dan cara penilaiannya, serta data per tingkat dalam grafik rilis 17 November. Bagian analisis dan penilaian membongkar dulu penyebut dari beberapa perbandingan, lalu memberikan contoh validasi asisten rute dan jadwal yang bisa langsung diadaptasi, dan menjelaskan batas penerapannya.
Perlu Diketahui: Konsep Kunci untuk Memahami Skor GPT-6.2 Sol LifeVal
| Konsep | Penjelasan Singkat |
|---|---|
| LifeVal | Tolok ukur yang digunakan OpenAI untuk mengukur performa asisten AI dalam menyelesaikan tugas digital harian yang dipersonalisasi |
| Konteks personalisasi | Preferensi pengguna, riwayat data, kondisi spesifik tugas, dan informasi lain yang dapat mengubah “jawaban yang memenuhi syarat” |
| Rubrik penilaian | Memecah penyelesaian suatu tugas menjadi beberapa persyaratan yang dapat diverifikasi satu per satu |
| Lingkungan terkontrol | Lingkungan evaluasi yang aplikasi, data, dan kondisi awalnya telah diatur sebelumnya, sehingga memudahkan verifikasi hasil tindakan |
| Perbedaan status backend | Perubahan status aplikasi yang dicatat sebelum dan sesudah pengujian, digunakan untuk memastikan apakah operasi alat benar-benar berlaku |
| Nilai reward rata-rata | Metrik agregat setelah setiap tugas diberi skor sesuai rubrik penilaian; persentase dalam grafik rilis adalah jenis “skor rata-rata” ini |
| Intensitas penalaran | Tingkat yang mengontrol investasi penalaran model; artikel ini membandingkan Low, Medium, High, Xhigh, Max |
| Biaya per item | Biaya rata-rata per tugas dalam grafik evaluasi, yang berubah sesuai penggunaan model dan tarif |
Sekilas Dampak GPT-6.2 Sol LifeVal
- Pengguna umum: Saat melihat “83.8%”, pahami itu sebagai “skor rata-rata pada serangkaian tugas harian pengguna berbahasa Inggris Amerika”, bukan tingkat keberhasilan. Perhatikan juga bahwa model yang sama memiliki selisih besar di tingkat penalaran yang berbeda; pengalaman produk bergantung pada tingkat mana yang dipilih oleh pihak aplikasi.
- Manajer produk: Tingkat Low memiliki harga terendah, tetapi kali ini skornya di LifeVal tertinggal jauh dari tingkat Low Sol generasi sebelumnya. Menggunakan konfigurasi tingkat dari versi lama saat melakukan upgrade dapat menyebabkan situasi “mengganti ke model baru malah menjadi lebih buruk”.
- Pengembang API: Yang patut ditiru adalah desain verifikasi LifeVal, yaitu penilaian terpisah untuk deliverables, status lingkungan, dan jawaban. Membandingkan tingkat Low, Medium, High secara horizontal menggunakan kumpulan tugas milik sendiri lebih andal daripada langsung mengutip angka dari papan peringkat.
Fakta objektif: tugas apa yang dipakai GPT-6.2 Sol LifeVal untuk menguji model
Asal-usul dan lini masa publikasi LifeVal
LifeVal adalah evaluasi dari OpenAI untuk mengukur tugas agen sehari-hari yang dipersonalisasi. Tanggal halaman riset OpenAI adalah 2 November 2026, sedangkan tanggal makalah pendampingnya 3 November. Pada 17 November, OpenAI merilis GPT-6.2 Astra dan GPT-6.2 Sol, serta menyertakan grafik LifeVal berisi skor per tingkat untuk model baru di halaman rilis (identitas grafik lifeval-v2).
Distribusi tugas dalam makalah berasal dari studi penggunaan waktu di Amerika Serikat dan sejumlah negara, serta mengacu pada survei kesediaan membayar yang menyasar populasi Amerika Serikat; akhirnya aktivitas sehari-hari disusun menjadi 148 kategori. Eksperimen dalam makalah menggunakan 169 tugas. Perlu dicatat, model yang dievaluasi dalam makalah itu sendiri hanya sampai GPT-6 Astra; angka per tingkat untuk seri GPT-6.2 hanya muncul di grafik rilis resmi yang belakangan.
Menurut positioning resmi, Sol ditujukan untuk pekerjaan harian berfrekuensi tinggi, pemrograman rutin, dan Agent multi-langkah yang dapat diskalakan, sedangkan Astra ditujukan untuk penalaran yang lebih sulit dan hasil profesional. Positioning ini sejalan dengan “tugas asisten sehari-hari” yang diukur LifeVal.
Desain tugas LifeVal: kebutuhan yang sama, jawaban yang memenuhi syarat bisa berbeda
Ciri khas LifeVal adalah “personalisasi”. Ambil contoh membandingkan sekolah setelah pindah rumah: pengguna dengan usia anak, rute perjalanan, dan preferensi distrik sekolah yang berbeda akan punya jawaban yang memenuhi syarat berbeda pula. Contoh lain, saat mencari rumah dengan menimbang anggaran dan waktu perjalanan, batas atas anggaran dan durasi perjalanan yang dapat diterima akan langsung menentukan properti mana yang masuk sebagai hasil yang memenuhi syarat.
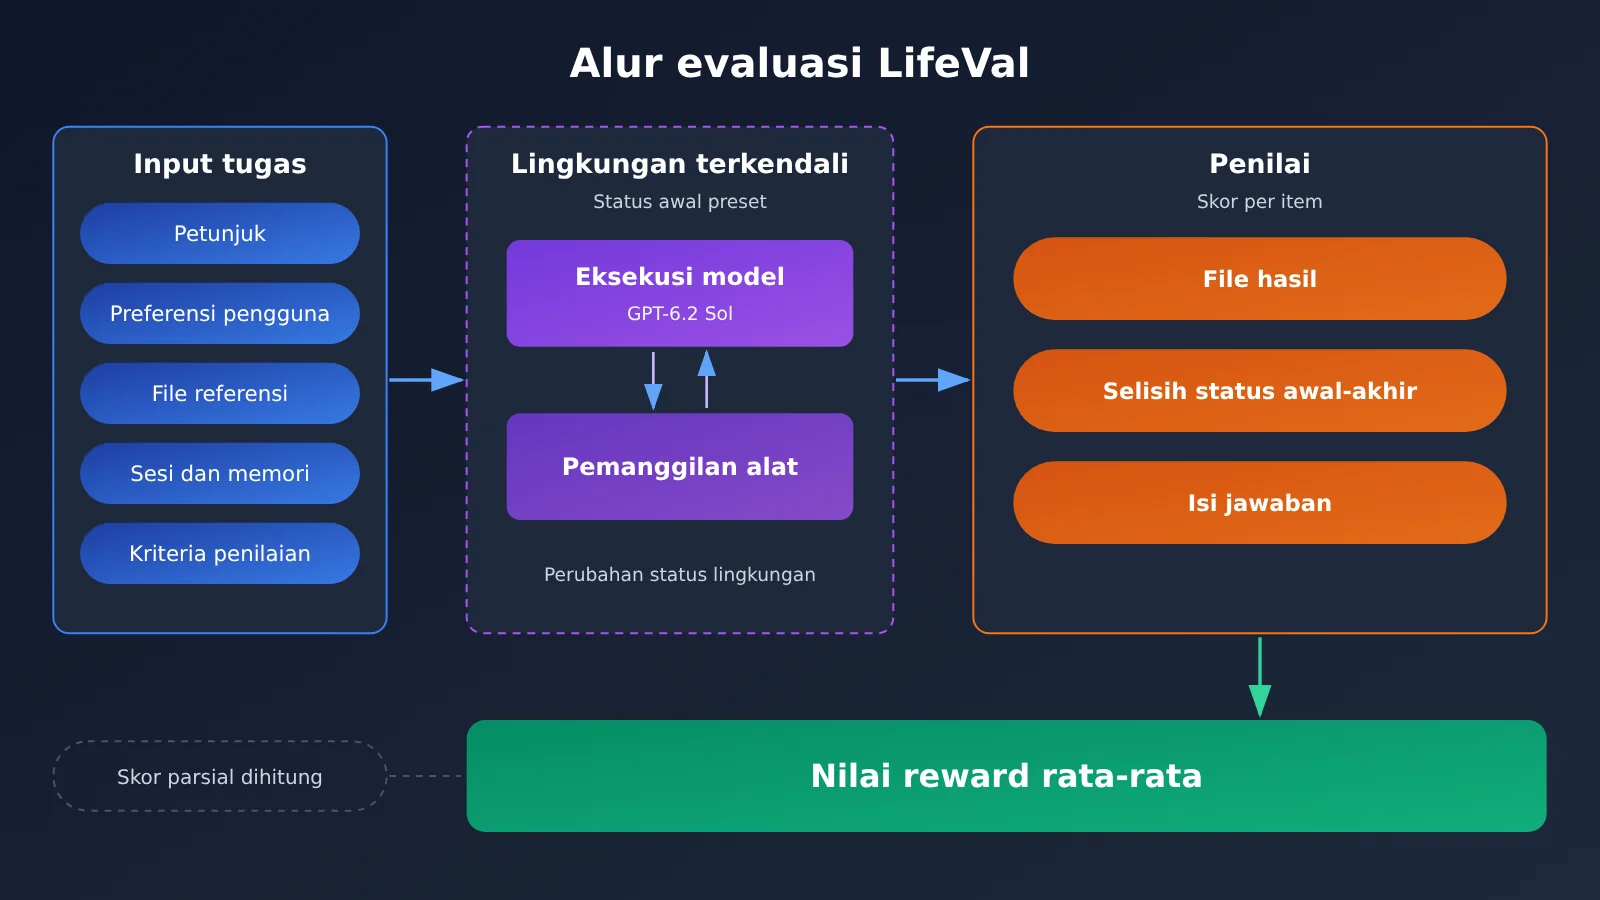
Menurut definisi dalam makalah, setiap tugas dilengkapi petunjuk, preferensi pengguna, file referensi, sesi dan memori yang relevan, rubrik penilaian, serta lingkungan terkendali dengan status yang sudah disiapkan. Setelah eksekusi selesai, penilai dapat memeriksa tiga hal: file yang diserahkan model, status lingkungan sebelum dan sesudah dioperasikan oleh alat, serta jawaban model; lalu memberi skor untuk masing-masing persyaratan tugas.
Mengapa 83.8% hanya bisa disebut “skor rata-rata”
Sumbu vertikal pada grafik hasil makalah adalah nilai reward rata-rata. Karena itu, 83.8% sebaiknya dinyatakan sebagai “skor rata-rata”, bukan “83.8% tugas berhasil dieksekusi sepenuhnya”. Sebuah tugas tetap menyumbang sebagian skor meski hanya memenuhi sebagian item penilaian.
Makalah juga menyebutkan beberapa keterbatasan: lingkungan offline dan halaman web cache masih memuat sebagian informasi yang berubah seiring waktu, dan populasi sampel didominasi pengguna berbahasa Inggris yang menyasar Amerika Serikat. Artinya, skor tersebut tidak bisa langsung digeneralisasikan ke wilayah lain, bahasa lain, atau ekosistem aplikasi lain.
Grafik Rilis LifeVal GPT-6.2 Sol: Skor Lima Tingkat dan Biaya per Tugas
Tabel di bawah ini dibaca dari data publik grafik interaktif LifeVal pada halaman rilis OpenAI tanggal 17 November 2026. Setiap sel berisi “skor rata-rata / biaya rata-rata per tugas (USD)”, yang merupakan data evaluasi publik yang dilaporkan sendiri oleh OpenAI, bukan hasil pengukuran independen.
| Model | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| GPT-6.2 Sol | 25,3% / $0,089 | 70,3% / $0,38 | 80,8% / $0,65 | 82,6% / $0,88 | 83,8% / $1,27 |
| GPT-6.1 Sol | 66,8% / $0,52 | 75,5% / $0,73 | 77,1% / $0,88 | 77,8% / $0,96 | 79,5% / $1,27 |
| GPT-6.2 Astra | 46,3% / $0,59 | 78,9% / $1,56 | 83,1% / $2,41 | 83,7% / $2,94 | 86,1% / $4,23 |
| GPT-6 Astra | 67,5% / $3,51 | 74,3% / $5,30 | 76,0% / $6,52 | 77,5% / $6,94 | 79,8% / $9,04 |
Isi teks pengumuman resminya menyatakan: dalam LifeVal, skor Sol lebih tinggi daripada GPT-6 Astra, dengan biaya sekitar sepertujuh dari biaya model tersebut. Objek perbandingan di sini adalah flaghip generasi sebelumnya, GPT-6 Astra, bukan GPT-6.2 Astra pada periode yang sama. Perbandingan FrontierCode 2.0 lainnya dalam pengumuman barulah yang menggunakan GPT-6.2 Astra, jadi jangan mencampur kedua kesimpulan itu saat membaca.
📌 Catatan dasar data: “Biaya per tugas” dalam tabel adalah nilai rata-rata dari grafik evaluasi resmi, yang dipengaruhi oleh panjang input, panjang output, dan penggunaan alat pada evaluasi tersebut. Biaya tugas Anda sendiri perlu diuji ulang dengan permintaan nyata; Anda bisa menjalankan Sol pada berbagai tingkat secara berurutan dengan Key yang sama melalui APIYI apiyi.com dan langsung membandingkan tagihannya.
Informasi akses API GPT-6.2 Sol
ID model API adalah gpt-6.2-sol, dapat dipanggil melalui Responses dan Chat Completions; pemanggilan fungsi dan alat bawaan menggunakan jalur Responses, dan kedua endpoint tidak menerima tingkat penalaran none. Harga resmi Standard untuk konteks pendek adalah input $2,00 dan output $10,00 (USD / juta token, output sudah mencakup token penalaran), sama dengan GPT-6.1 Sol.
Hingga 20 November 2026, tabel umum model publik dan antarmuka penetapan harga APIYI telah mencantumkan gpt-6.2-sol, dengan penanda entry responses dan chat. Penetapan harga tier pendek konsisten dengan yang resmi; grup yang benar-benar tersedia, rentang parameter, dan penagihan mengacu pada konfigurasi serta tagihan APIYI apiyi.com saat ini.
Analisis: bagaimana “biaya sepertujuh” dan penurunan Low pada GPT-6.2 Sol LifeVal bisa berlaku bersamaan
Selaraskan dulu objek perbandingan dan penyebutnya
Grafik yang sama bisa memunculkan dua kesan sekaligus, “kemajuan besar” dan “kemunduran signifikan”. Akar penyebabnya adalah objek perbandingan dan tingkatannya berbeda. Selisih serta rasio pada tabel berikut dihitung berdasarkan nilai yang diumumkan resmi.
| Kelompok perbandingan | Nilai kedua pihak | Selisih skor | Hubungan biaya |
|---|---|---|---|
| 6.2 Sol Max vs unggulan generasi sebelumnya GPT-6 Astra Max | 83.8%/$1.27 vs 79.8%/$9.04 | +4.0 poin persentase | sekitar 14.0%, yakni “sekitar sepertujuh” |
| 6.2 Sol Max vs 6.1 Sol Max | 83.8%/$1.27 vs 79.5%/$1.27 | +4.3 poin persentase | biaya sama |
| 6.2 Sol Low vs 6.1 Sol Low | 25.3%/$0.089 vs 66.8%/$0.52 | −41.5 poin persentase | biaya lebih rendah, tetapi skor turun drastis |
| 6.2 Sol Medium vs 6.1 Sol Medium | 70.3%/$0.38 vs 75.5%/$0.73 | −5.2 poin persentase | biaya sekitar setengahnya |
| 6.2 Sol High vs 6.1 Sol Max | 80.8%/$0.65 vs 79.5%/$1.27 | +1.3 poin persentase | sekitar setengahnya |
| 6.2 Sol Max vs 6.2 Astra Max | 83.8%/$1.27 vs 86.1%/$4.23 | −2.3 poin persentase | sekitar 30% |
Di antara angka-angka ini, “poin persentase” menggambarkan selisih skor rata-rata, sedangkan “rasio biaya” menggambarkan rasio biaya rata-rata per item; keduanya tidak bisa saling dikonversi. “Sepertujuh” hanya berlaku pada kelompok “6.2 Sol Max vs GPT-6 Astra Max”. Jika diganti dengan GPT-6.2 Astra dari periode yang sama, Sol justru lebih rendah 2.3 poin persentase pada tingkat Max.
💡 Tips pemilihan: Jarak antar tingkatan pada model yang sama bisa lebih besar daripada jarak antar model yang berbeda. Sebaiknya jalankan dulu satu putaran perbandingan antar tingkatan di APIYI apiyi.com dengan kumpulan tugas tetap, lalu tentukan tingkatan default; jangan langsung memakai konfigurasi tingkatan model lama.
Sinyal dari tingkat Low: upgrade tidak bisa sekadar “ganti tanpa pikir”
6.2 Sol hanya mencapai 25.3% di LifeVal, lebih rendah 41.5 poin persentase daripada 6.1 Sol Low. Materi rilis resmi menyebutkan bahwa Sol mengonsumsi token output lebih sedikit pada sejumlah tugas, dan biaya rata-rata per item untuk tingkat Low juga hanya $0.089. Satu spekulasi yang masuk akal: pada tugas multi-langkah yang dipersonalisasi, tingkat penalaran yang rendah tidak cukup untuk menangani batasan preferensi dan operasi tool. Ini hanya spekulasi; pihak resmi tidak memberikan penjelasan atas penurunan tingkat Low.
Bagi tim produk, dampaknya sangat langsung. Jika aplikasi Anda sebelumnya memakai tingkat Low pada 6.1 Sol untuk menghemat biaya, lalu beralih ke ID model baru tanpa menyesuaikan tingkatnya, kualitas tugas harian yang kompleks bisa turun secara signifikan. Sebaliknya, tingkat Max dengan biaya per item yang sama berada 4.3 poin persentase lebih tinggi daripada Sol generasi sebelumnya, yang menunjukkan bahwa batas atas model baru memang meningkat.
Mengapa High adalah tingkat yang perlu diprioritaskan untuk diuji dalam evaluasi ini
Pada 6.2 Sol, dari High ke Xhigh lalu ke Max, peningkatan antar tingkat yang berdekatan hanya 1.8 dan 1.2 poin persentase, sementara biaya rata-rata per item justru naik berturut-turut sebesar $0.23 dan $0.39. Tingkat High mencatat 80.8% dengan biaya $0.65, sudah lebih tinggi daripada tingkat Max pada 6.1 Sol dan tingkat Max pada GPT-6 Astra. Jika hanya melihat LifeVal, High adalah titik awal untuk “keseimbangan antara kualitas dan biaya”.
Namun, penilaian ini punya tiga syarat: distribusi tugas mendekati LifeVal, bahasa dan lingkungan aplikasi mendekati skenario pengguna berbahasa Inggris Amerika, serta struktur biaya mendekati rasio input/output dalam evaluasi ini. Jika salah satunya tidak terpenuhi, kesimpulannya bisa berubah. Dalam praktik, pendekatan yang lebih aman adalah mulai dari High, lalu berdasarkan tingkat keberhasilan tugas Anda sendiri, putuskan apakah perlu turun ke Medium atau naik ke Xhigh maupun Max.
Analisis dan Penilaian: Menguji Asisten GPT-6.2 Sol Anda Sendiri dengan Pendekatan LifeVal
Membangun Tugas Itinerary Keluarga Berisiko Rendah
Yang paling layak diteladani dari LifeVal bukanlah skornya, melainkan metode “verifikasi berdasarkan hasil dan status”. Berikut contoh itinerary keluarga: sebelumnya berikan tiga batasan ketat kepada asisten, yaitu titik keberangkatan dan tujuan, kondisi perjalanan yang ramah aksesibilitas, serta batas anggaran. Minta asisten menyerahkan kandidat rencana dengan rute yang dapat diverifikasi, plus draf jadwal yang bisa diedit.
| Item penilaian | Cara pemeriksaan | Bisa diotomatiskan? |
|---|---|---|
| Apakah batasan lokasi terpenuhi | Titik awal dan akhir pada rencana sesuai dengan input | Bisa diperiksa otomatis |
| Apakah kondisi aksesibilitas terpenuhi | Penjelasan rute secara eksplisit mencakup kebutuhan aksesibilitas | Sebagian otomatis, perlu cek manual |
| Apakah anggaran tidak melebihi batas | Parse nominal pada rencana lalu bandingkan dengan batas atas | Bisa diperiksa otomatis |
| Apakah tautan mendukung informasi | Tautan bisa diakses dan isinya sesuai dengan rencana | Perlu ditinjau manual |
| Apakah berkas draf jadwal ada | Periksa status sebelum dan sesudah pada berkas output atau entri kalender | Bisa diperiksa otomatis |
| Apakah asisten bertanya saat info penting hilang | Sengaja hilangkan tanggal dan info lain, lihat apakah ia proaktif bertanya | Perlu penilaian manual |
Rangkaian item penilaian ini sejalan dengan tiga jalur verifikasi LifeVal: hasil kerja (draf jadwal), perubahan status (apakah berkas atau entri benar-benar tertulis), dan kualitas jawaban (pemenuhan batasan serta pertanyaan proaktif). Jalankan kumpulan tugas yang sama dengan level Low, Medium, dan High secara terpisah, lalu tentukan tingkat awal berdasarkan tingkat keberhasilan dan biayanya.
Contoh minimal: memanggil GPT-6.2 Sol dan mencatat penggunaan penalaran
Contoh berikut memanggil gpt-6.2-sol melalui antarmuka Responses, sekaligus membaca token output dan token penalaran di dalamnya, agar memudahkan perhitungan biaya per item nantinya.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI dari APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "high"},
    input="请为我规划周六的家庭出行:从家到市立博物馆,需全程无障碍,交通预算不超过 200 元,并给出日程草稿。"
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
Lihat skrip perbandingan tingkat (Low / Medium / High)
import re
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Satu kunci saja dapat membandingkan beberapa tingkat
)

# Harga Standard konteks pendek, USD / juta token (output sudah termasuk token penalaran)
PRICE_IN, PRICE_OUT = 2.00, 10.00

TASKS = [
    {
        "prompt": "从家到市立博物馆,周六上午出发,全程无障碍,交通预算不超过 200 元。"
                  "请给出带路线说明的候选方案,并输出一份日程草稿。",
        "budget": 200,
        "must_include": ["无障碍", "博物馆"],
    },
    {
        # Sengaja tidak menyertakan tanggal, untuk menguji apakah model bertanya balik secara proaktif
        "prompt": "帮我安排一次带老人去公园的出行,预算 100 元以内,需要无障碍路线。",
        "budget": 100,
        "must_include": ["无障碍"],
        "expect_question": True,
    },
]

def check(task, text):
    """Menilai tiap item sesuai rubrik penilaian, mengembalikan skor 0~1"""
    items = []
    items += [kw in text for kw in task["must_include"]]
    amounts = [float(x) for x in re.findall(r"(\d+(?:\.\d+)?)\s*元", text)]
    items.append(bool(amounts) and max(amounts) <= task["budget"])
    if task.get("expect_question"):
        items.append("?" in text or "?" in text)
    return sum(items) / len(items)

for effort in ["low", "medium", "high"]:
    scores, cost = [], 0.0
    for task in TASKS:
        resp = client.responses.create(
            model="gpt-6.2-sol",
            reasoning={"effort": effort},
            input=task["prompt"],
        )
        u = resp.usage
        cost += u.input_tokens / 1e6 * PRICE_IN + u.output_tokens / 1e6 * PRICE_OUT
        scores.append(check(task, resp.output_text))
    print(f"{effort:>6}: 平均得分 {sum(scores)/len(scores):.1%}, "
          f"平均单项费用 ${cost/len(TASKS):.4f}")
Pemeriksaan otomatis dalam skrip hanya mencakup item penilaian yang “dapat diverifikasi mesin”; keaslian tautan dan kualitas pertanyaan balik masih perlu diperiksa manual. Nilai parameter untuk tingkat penalaran (terutama string yang sesuai dengan Xhigh dan Max) harap mengacu pada dokumentasi resmi terkini dan penjelasan parameter dari kanal yang digunakan.
🚀 Mulai cepat: Daftar melalui APIYI apiyi.com untuk mendapatkan kuota uji gratis. Platform ini menyediakan antarmuka yang kompatibel dengan OpenAI; skrip di atas cukup mengganti kunci agar bisa dijalankan, cocok untuk melakukan verifikasi sampel kecil sebelum memilih tingkat secara final.
Batas Penerapan Kesimpulan LifeVal GPT-6.2 Sol
Saat membawa kesimpulan LifeVal ke produk Anda sendiri, setidaknya ada tiga perbedaan yang perlu dipertimbangkan. Pertama, bahasa dan wilayah: sampel dalam makalah sebagian besar adalah pengguna bahasa Inggris Amerika, sedangkan ekosistem aplikasi peta, pembayaran, dan kalender dalam skenario bahasa Mandarin sangat berbeda. Kedua, lingkungan: LifeVal berjalan di lingkungan terkendali dan halaman web cache, sementara produk nyata akan menghadapi fluktuasi jaringan, kegagalan otorisasi alat, dan perbedaan status akun. Ketiga, struktur biaya: biaya per item resmi didasarkan pada rasio input/output evaluasi tersebut, dan permintaan konteks panjang yang melebihi 272K input akan dialihkan seluruhnya ke tarif yang lebih tinggi, sehingga biaya per item bisa sangat berbeda dari yang terlihat di grafik.
Karena itu, cara penggunaan yang lebih masuk akal adalah: jadikan grafik resmi sebagai dasar untuk “mempersempit kandidat”, dan jadikan kumpulan tugas Anda sendiri sebagai dasar untuk “keputusan akhir”. Untuk asisten harian yang kompleks, Anda bisa lebih dulu membangun baseline dengan tingkat High, lalu menguji apakah Medium mampu mempertahankan batasan keras utama, serta apakah Xhigh atau Max dapat secara signifikan mengurangi pekerjaan ulang manual—gunakan tingkat kepatuhan aktual dan tagihan sebagai acuan.
Setelah kumpulan tugas, rubrik penilaian, dan pemeriksaan lingkungan Anda siap, peningkatan model tidak lagi sekadar “melihat papan peringkat lalu mengganti model”, melainkan proses rekayasa yang dapat diuji ulang setiap kali. Saat perlu membandingkan beberapa model dan tingkat secara berulang, Anda dapat memanfaatkan antarmuka terpadu APIYI apiyi.com untuk menjalankan GPT-6.2 Sol, GPT-6.2 Astra, dan lainnya dalam satu set skrip penerimaan yang sama.
Referensi
-
Pengumuman peluncuran OpenAI GPT-6.2 Astra dan Sol (termasuk grafik klasifikasi LifeVal)
- Tautan:
openai.com/zh-Hans-CN/index/introducing-gpt-6-2-astra-sol - Keterangan: Dirilis pada 2026-11-17, sumber data klasifikasi dalam artikel ini
- Tautan:
-
Halaman riset dan makalah LifeVal
- Tautan:
openai.com/index/lifeval,cdn.openai.com/pdf/lifeval.pdf - Keterangan: Sumber tugas, metode penilaian, dan penjelasan batasan (makalah §3–§5)
- Tautan:
-
Kartu model dan harga resmi GPT-6.2 Sol
- Tautan:
developers.openai.com/api/docs/models/gpt-6.2-sol - Keterangan: Spesifikasi jendela konteks, aturan penagihan konteks panjang/pendek, dan batas kuota
- Tautan:
-
Tabel lengkap model APIYI
- Tautan:
docs.apiyi.com/models.md - Keterangan: Model yang terdaftar publik, entri akses, dan informasi harga
- Tautan:
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami di situs resmi APIYI apiyi.com, materi integrasi lebih lanjut dapat diakses di pusat dokumentasi docs.apiyi.com