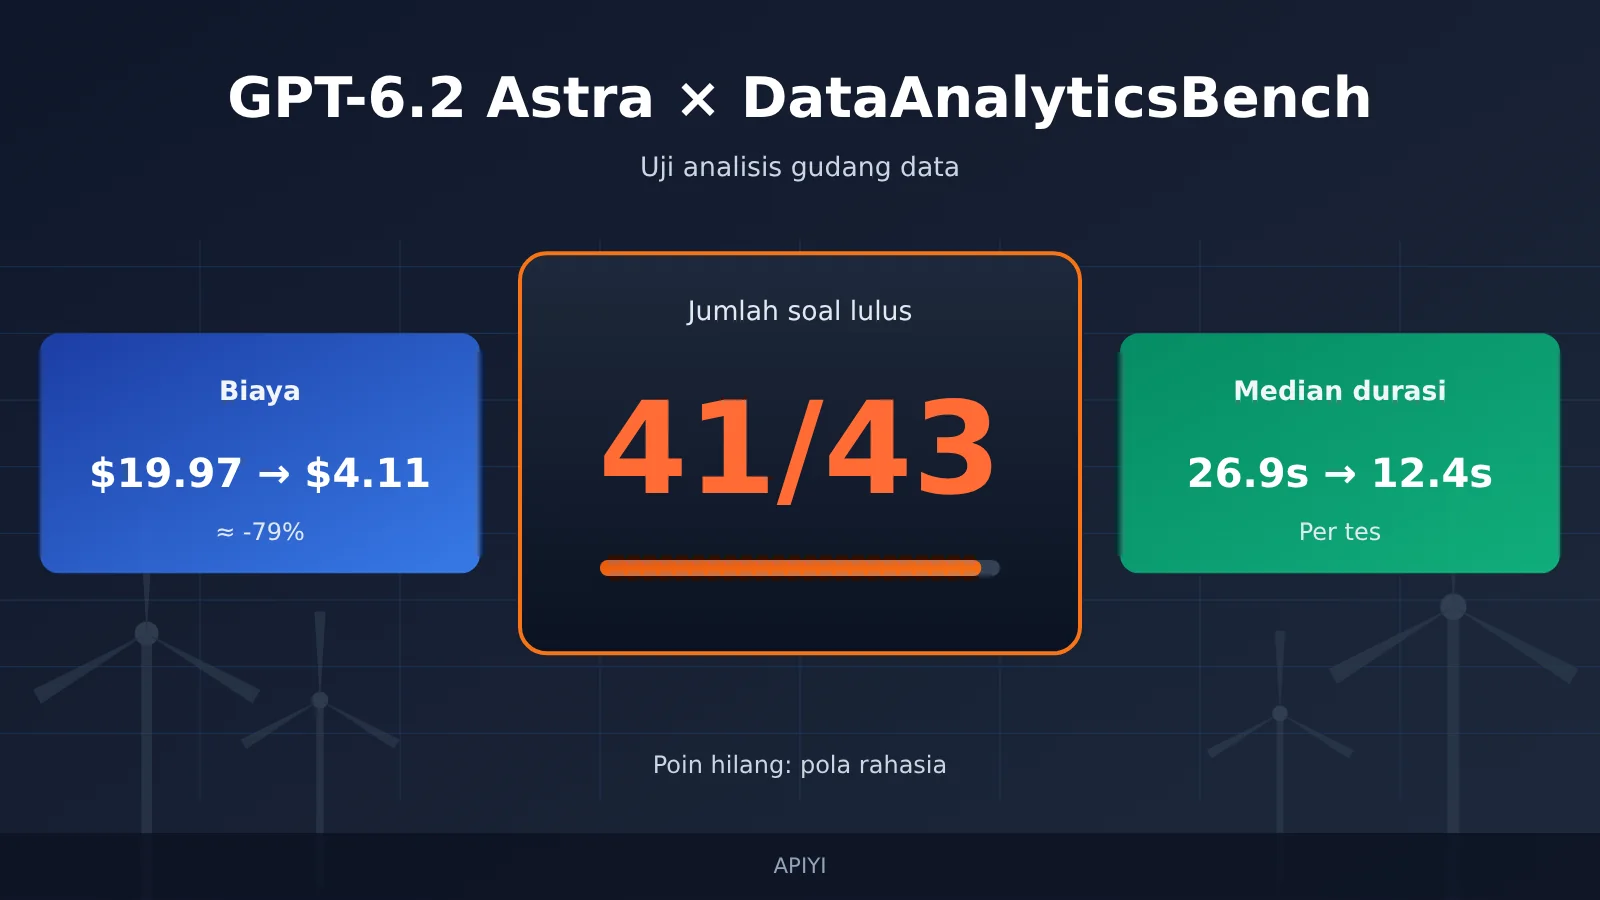
Kesimpulan utama: Dalam uji nyata DataAnalyticsBench milik Plotly, GPT-6.2 Astra lulus 41 dari 43 soal analisis data. Model generasi sebelumnya, GPT-6 Astra, mencetak 43/43. Dua soal yang gagal keduanya berasal dari kategori “pola tersembunyi”, sementara lima kategori lainnya lulus semua. Pada saat yang sama, biaya satu putaran penuh turun dari $19.97 menjadi $4.11, dan median waktu per soal memendek dari 26.9 detik menjadi 12.4 detik. Astra generasi baru menukar dua soal dengan biaya kurang dari seperempat generasi sebelumnya dan waktu tunggu kurang dari separuhnya — tetapi apakah ia benar-benar mundur dalam hal aktif memburu anomali, baru ada satu putaran data, jadi masih perlu diuji ulang dengan data Anda sendiri.
Apa yang bisa Anda dapatkan setelah membaca artikel ini?
- Apa yang diukur DataAnalyticsBench, bagaimana penilaiannya, dan di mana batas dari skor 41/43.
- Skor per kategori dari enam jenis soal, serta bagaimana masing-masing dari dua soal yang gagal itu tumbang.
- Dua sumber penurunan biaya sekitar 79%: pemangkasan tarif dan pengurangan beban kerja, masing-masing menyumbang berapa banyak.
- Trade-off GPT-6.2 Astra dibanding GPT-6 Astra, GPT-6.1 Sol, dan GPT-6.2 Sol dalam hal skor, biaya, dan latensi.
- Satu set metode pengujian ulang yang bisa langsung dimodifikasi beserta kode Python, untuk memverifikasi kesimpulan di gudang data Anda sendiri.
Indeks: Tabel To Know menjelaskan konsep-konsep khusus dalam evaluasi, sedangkan Ringkasan Dampak merangkum makna berita ini menurut kelompok pembaca. Bagian “Fakta objektif” menguraikan secara berurutan lingkungan pengujian dan aturan penilaian, skor enam kategori soal, data biaya dan waktu, serta identitas model dan acuan harga resmi OpenAI. Bagian “Analisis dan penilaian” menafsirkan makna 41/43, mengajukan hipotesis penjelasan atas kegagalan soal pola tersembunyi, membedah sumber penurunan biaya, serta memberikan saran pemilihan model dan kode pengujian ulang.
Konsep yang perlu diketahui terlebih dahulu tentang GPT-6.2 Astra DataAnalyticsBench
| Konsep | Penjelasan singkat |
|---|---|
| DataAnalyticsBench | 43 soal analisis gudang data yang dirancang oleh peneliti Plotly dan Mila, menguji kemampuan analisis model pada data operasi pembangkit listrik tenaga angin yang disimulasikan |
| Lingkungan uji | Sistem evaluasi yang menyediakan gudang data yang sama untuk setiap model, serta alat hanya-baca seperti kueri, menggambar, dan menampilkan tabel |
| Aturan penilaian | Aturan per soal yang menentukan jawaban seperti apa yang dianggap cukup memenuhi maksud soal; hanya menilai lulus atau tidak lulus, tanpa nilai sebagian |
| Masalah kualitas data | Masalah input yang memengaruhi kesimpulan analisis, seperti data hilang, duplikat, dan catatan anomali, yang sengaja ditanamkan dalam soal |
| Jebakan statistik | Soal di mana algoritma intuitif atau cara agregasi dapat menggiring orang ke kesimpulan yang salah |
| Pola tersembunyi | Pola atau penyebab anomali yang tidak disebutkan dalam soal dan perlu diselidiki secara aktif oleh model |
| Median waktu per soal | Nilai tengah setelah waktu aktual 43 soal diurutkan; peringkat ini mencakup waktu kueri alat |
| Biaya satu putaran penuh | Biaya kumulatif pemanggilan model yang sama untuk menyelesaikan seluruh 43 soal |
| Cache hit | Bagian token input yang dikenai tarif lebih rendah setelah prefiks input berulang di-cache oleh server |
Sekilas dampak skor GPT-6.2 Astra DataAnalyticsBench terhadap berbagai kelompok
- Tim yang memilih API: GPT-6.2 Astra menunjukkan perbaikan yang jelas pada biaya per unit dan kecepatan respons, sehingga tugas seperti laporan rutin dan klarifikasi definisi metrik bisa diprioritaskan. Untuk tugas investigasi anomali, sebaiknya belum perlu langsung meniru kesimpulan dari daftar peringkat.
- Pengembang produk data: Saat membangun produk seperti “tanya data dengan bahasa alami” dan asisten BI, median latensi yang berkurang setengah sangat berpengaruh pada pengalaman interaktif. Namun perlu evaluasi tersendiri terhadap “kesabaran” model dalam eksplorasi multi-putaran; bila perlu, paksa langkah pemeriksaan tambahan di dalam petunjuk atau alur kerja.
- Tim analisis: Model bisa dianggap sebagai analis draf awal yang lebih cepat, tetapi kesimpulan dari investigasi akar masalah tetap memerlukan tinjauan manusia. Dengan menggunakan layanan agregasi yang kompatibel dengan OpenAI seperti APIYI apiyi.com, Anda dapat berganti di antara empat model dalam satu set kode yang sama untuk melakukan pengujian pembanding.
Fakta objektif GPT-6.2 Astra DataAnalyticsBench
Skenario Pengujian dan Aturan Penilaian GPT-6.2 Astra
DataAnalyticsBench dirancang oleh peneliti Plotly dan Mila menggunakan gudang data operasi tenaga angin simulasi. Gudang data ini berisi 44 tabel, sekitar 19,9 juta baris, dan 554 kolom, mencakup data telemetri perangkat, alarm, perintah kerja, inspeksi, dan cuaca. Setiap soal dijalankan di Plotly Studio Embedded, dengan pemanggilan model melalui OpenRouter. Model hanya dapat menggunakan empat alat hanya-baca: daftar dataset, jalankan SQL, buat grafik, dan tampilkan tabel.
Model menentukan sendiri jalur kueri dan kapan harus menjawab; pihak penguji tidak merencanakan langkah untuknya. Artinya, evaluasi tidak hanya menguji kemampuan menulis SQL, tetapi juga penilaian “sampai titik mana pencarian dianggap cukup”.
Dalam hal penilaian, setiap soal dinilai lulus atau tidak berdasarkan kunci jawaban dan aturan penilaian; tidak ada nilai parsial. Model penilai adalah Claude Sonnet 5 dengan temperature 0. Penyelenggara menghasilkan jawaban secara independen dengan tiga cara—SQL, pandas, dan Polars—lalu melakukan validasi silang; mereka juga meninjau secara manual jejak kegagalan dan hasil nilai penuh. Dua jenis soal khusus memiliki syarat lulus yang jelas:
- Soal ambigu: Model lulus jika mengklarifikasi, atau menyatakan asumsi dan memberikan solusi alternatif.
- Soal yang tidak dapat dijawab dengan data: Model lulus cukup dengan menunjukkan secara tepat keterbatasan data yang tersedia.
Bank soal juga memiliki batas yang jelas: satu domain bisnis (operasi tenaga angin), bahasa Inggris, lingkungan pengujian yang sama, dan setiap model hanya dijalankan satu putaran. Soal, data, dan kunci jawaban disimpan oleh penyelenggara dan tidak dipublikasikan.
Sumber: Plotly, Introducing DataAnalyticsBench, diterbitkan 2026-10-14, diperbarui 2026-11-19, plotly.com/blog/introducing-dataanalyticsbench/
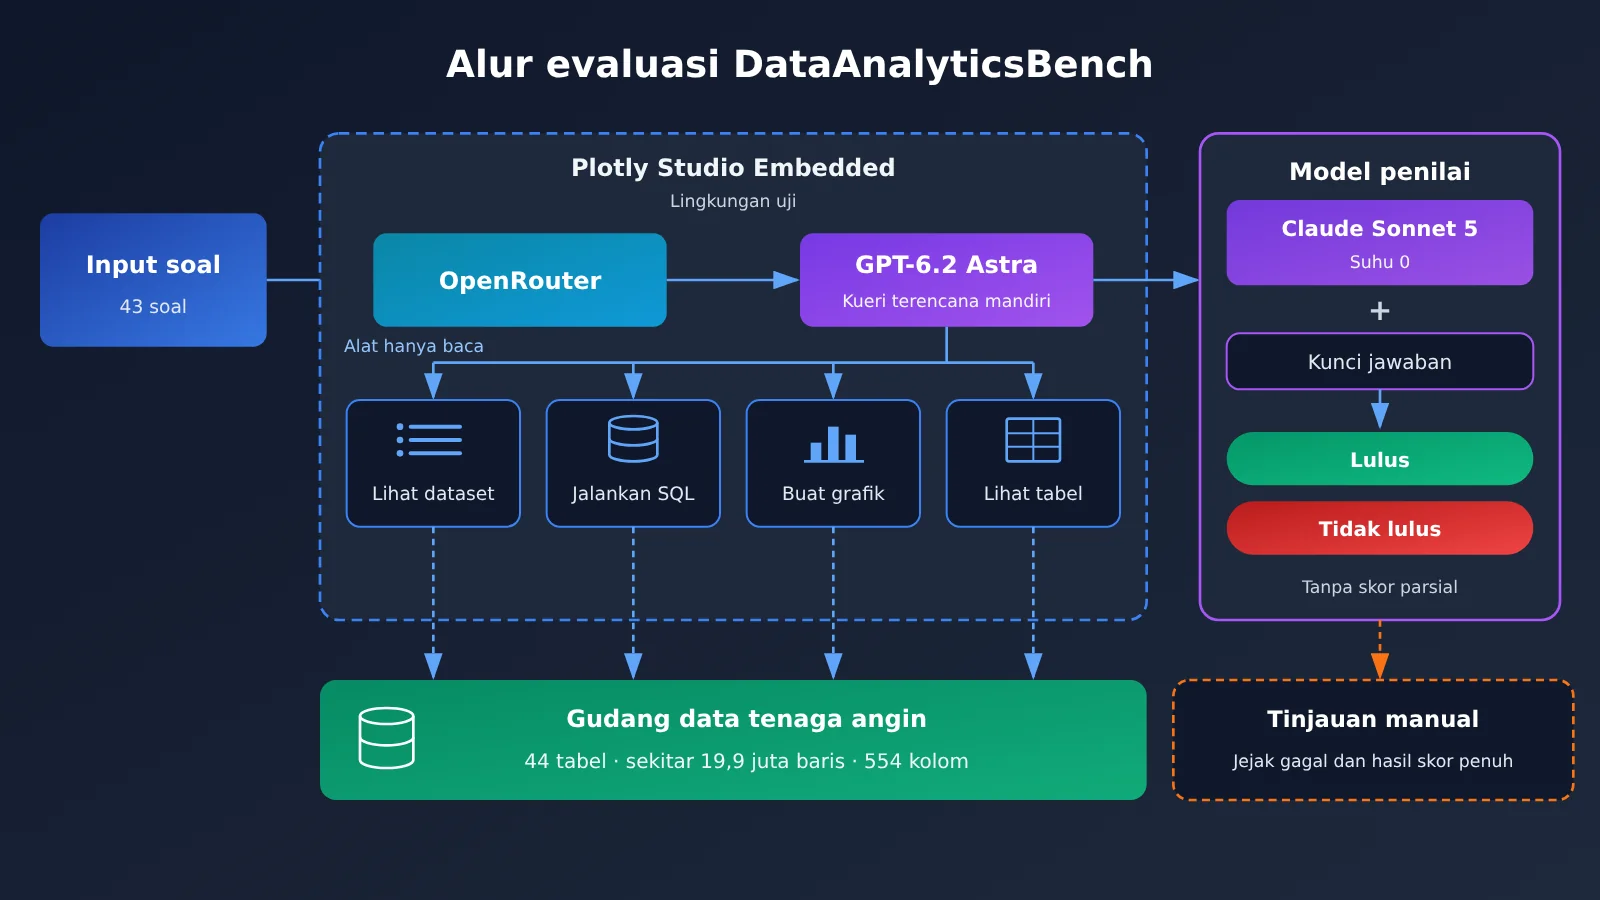
Keterangan gambar: Struktur “model merencanakan kueri secara mandiri + alat hanya-baca + penilaian lulus/tidak lulus per soal” ini dapat direproduksi secara mendekati di lingkungan Anda sendiri menggunakan antarmuka kompatibel OpenAI dari APIYI apiyi.com untuk melakukan pengujian pembanding internal.
Skor GPT-6.2 Astra pada Enam Kategori Soal: Kehilangan Poin Terpusat pada Pola Tersembunyi
Laporan khusus Astra yang diterbitkan Plotly pada 17 November 2026 memberikan skor per kategori:
| Jenis soal | GPT-6.2 Astra | GPT-6 Astra | Aspek yang diuji |
|---|---|---|---|
| Analisis rutin | 20/20 | 20/20 | SQL multi-langkah, join tabel, dan rentang waktu |
| Penanganan ambiguitas | 5/5 | 5/5 | Mengklarifikasi definisi atau menjelaskan asumsi yang wajar |
| Data tidak dapat dijawab | 5/5 | 5/5 | Mengidentifikasi pertanyaan yang tidak dapat dijawab berdasarkan data yang ada |
| Kualitas data | 3/3 | 3/3 | Mengidentifikasi masalah kualitas yang disisipkan |
| Jebakan statistik | 5/5 | 5/5 | Mengidentifikasi potensi menyesatkan dari algoritma intuitif |
| Pola tersembunyi | 3/5 | 5/5 | Secara proaktif menyelidiki pola anomali yang tidak disebutkan |
| Total | 41/43 | 43/43 | Setiap soal berbobot sama, dinilai lulus per soal |
Lima kategori pertama berjumlah 38/38, dengan performa kedua generasi sepenuhnya identik. Seluruh selisih berasal dari soal pola tersembunyi: generasi baru 3/5, generasi sebelumnya 5/5.
Kedua soal yang kehilangan poin telah ditinjau secara manual oleh Plotly, dan cara kegagalannya berbeda:
- Pada satu soal, model tidak pernah berhasil menemukan pola yang disisipkan.
- Pada soal lainnya, model menemukan lokasi yang seharusnya diselidiki, tetapi justru menyingkirkan penyebab sebenarnya.
Laporan tersebut juga memberikan satu data proses: pada soal pola tersembunyi, GPT-6.2 Astra rata-rata menjalankan sekitar 9 kueri basis data per soal, sedangkan GPT-6 Astra sekitar 15 kueri.
Sumber: Plotly, GPT-6.2 Astra Benchmark Results for Data Analysis, 2026-11-17, plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/
Biaya dan Durasi GPT-6.2 Astra: Perbandingan Lintas Generasi dan Sesama Penyedia
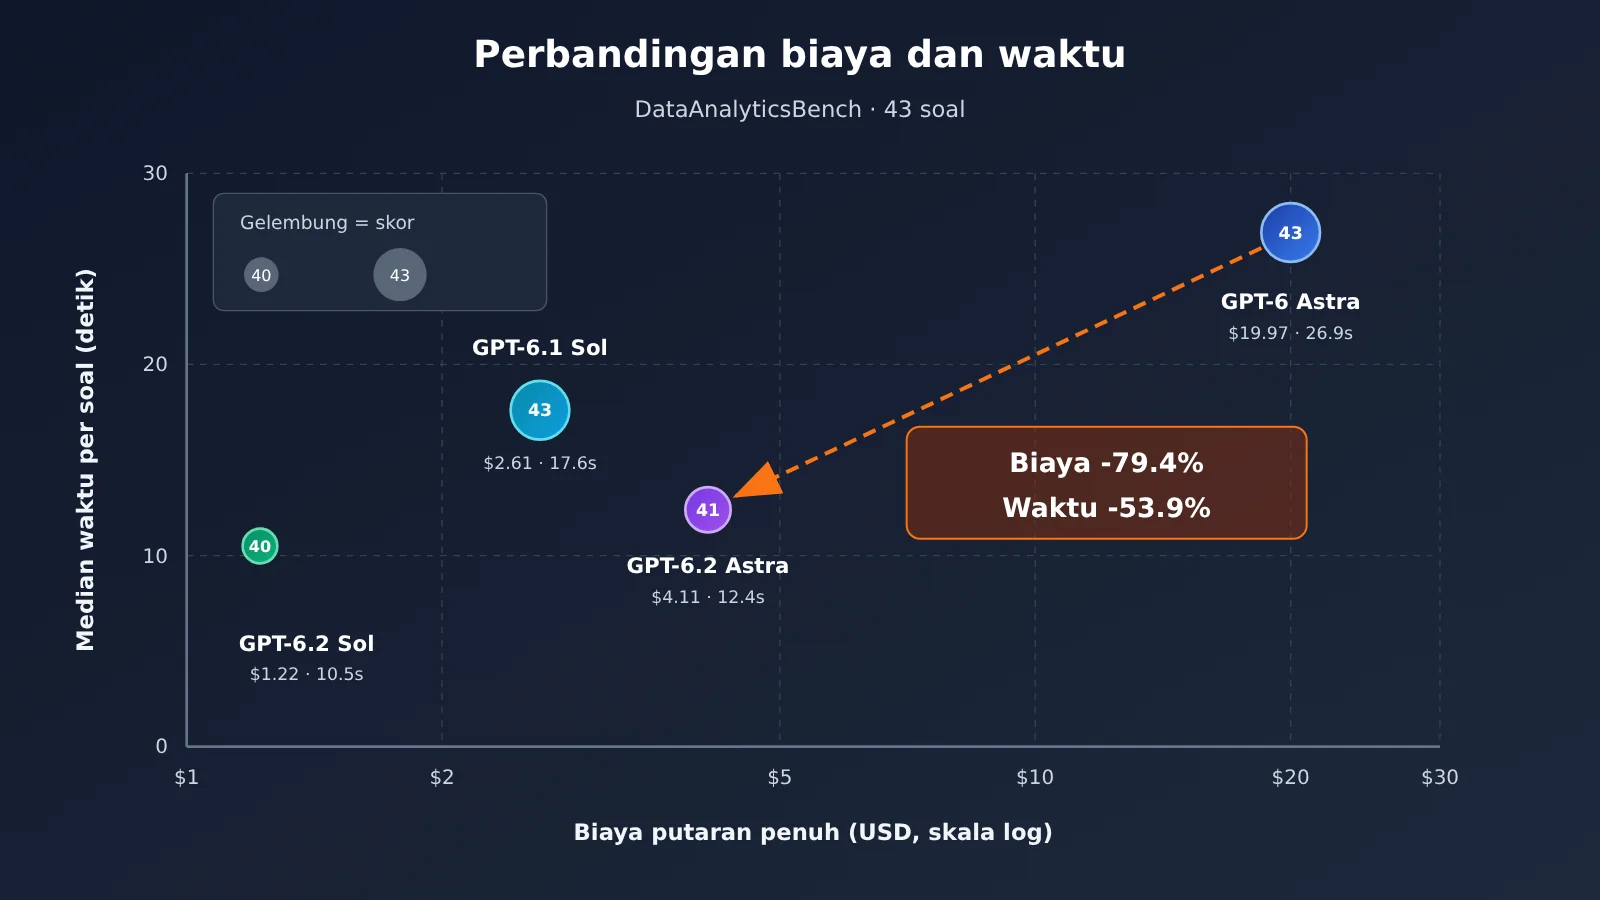
| Model | Skor | Biaya satu putaran penuh | Median waktu per soal |
|---|---|---|---|
| GPT-6.2 Astra | 41/43 | $4.11 | 12.4 detik |
| GPT-6 Astra | 43/43 | $19.97 | 26.9 detik |
| GPT-6.1 Sol | 43/43 | $2.61 | 17.6 detik |
| GPT-6.2 Sol | 40/43 | $1.22 | 10.5 detik |
Berdasarkan perhitungan pada tabel asli, biaya satu putaran penuh GPT-6.2 Astra turun sekitar 79.4% dibandingkan generasi sebelumnya, dan median waktu per soal memendek sekitar 53.9%. Dalam pengujian penulis, satu putaran penuh 6.2 Astra memakan waktu sekitar 13 menit, sedangkan generasi sebelumnya sekitar 32 menit. Waktu di sini adalah waktu berlalu yang sebenarnya, termasuk kueri alat, bukan waktu inferensi model murni.
Ada dua basis perhitungan biaya per soal yang perlu dibedakan: $4.11 ÷ 43 menghasilkan biaya rata-rata sekitar $0.096 per soal; sedangkan papan peringkat keseluruhan yang diperbarui mencatat $0.066 sebagai median biaya per soal pada putaran ini. Nilai rata-rata lebih tinggi daripada median, yang menunjukkan bahwa sedikit soal berbiaya jauh lebih tinggi dan menaikkan rata-rata.
Plotly juga menyediakan rincian beban kerja untuk putaran asli kedua generasi:
| Metrik beban kerja | GPT-6 Astra (generasi sebelumnya) | GPT-6.2 Astra |
|---|---|---|
| Jumlah pemanggilan alat | 266 kali | 148 kali |
| Jumlah pemanggilan model | 249 kali | 171 kali |
| Token input | sekitar 9.1 juta | sekitar 4.4 juta |
| Token output | sekitar 78 ribu | sekitar 34 ribu |
| Proporsi cache hit input | 93% | 98% |
Plotly menghitung ulang penggunaan yang sama persis dari generasi sebelumnya dengan tarif baru, dan memperkirakan biayanya sekitar $11. Perlu dicatat bahwa biaya ini berasal dari harga OpenRouter pada saat pengujian Plotly, bukan konversi langsung dari daftar harga resmi OpenAI.
Sumber: laporan khusus Plotly Astra plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/; papan peringkat keseluruhan Plotly plotly.com/blog/introducing-dataanalyticsbench/#full-results
Identitas Model GPT-6.2 Astra dan Acuan Harga Resminya
OpenAI merilis GPT-6.2 Astra dan GPT-6.2 Sol pada 17 November 2026. Astra ditujukan untuk penalaran kompleks, pemrograman, dan pekerjaan profesional, dengan ID model API gpt-6.2-astra. Evaluasi yang tercantum dalam pengumuman rilis OpenAI adalah versi vendor, sedangkan DataAnalyticsBench milik Plotly adalah benchmark pihak ketiga yang terpisah — keduanya tidak boleh dibandingkan secara langsung.
Menurut model card, Astra menerima input teks dan gambar serta menghasilkan output teks, dengan jendela konteks 1,050,000 token, input maksimum 922,000 token, dan output maksimum 128,000 token. Model ini mendukung Responses API sekaligus Chat Completions API; kemampuan seperti tool bawaan, Multi-agent, dan background completion window mengikuti Responses API. Model card juga menyebutkan bahwa permintaan dengan reasoning.effort disetel ke none akan ditolak.
Harga teks murni konteks pendek standar OpenAI (per juta token) adalah: input biasa $8, input dengan cache hit $0.40, output $40. Pihak resmi menyatakan bahwa dibandingkan generasi sebelumnya, harga satuan input biasa dan output turun 20%, sementara harga satuan input dengan cache hit turun 60%.
Sumber: pengumuman rilis OpenAI openai.com/index/introducing-gpt-6-2-astra-sol/; model card developers.openai.com/api/docs/models/gpt-6.2-astra; changelog API developers.openai.com/api/docs/changelog; tabel harga developers.openai.com/api/docs/pricing
Analisis dan Penilaian GPT-6.2 Astra DataAnalyticsBench
Cara membaca 41/43: bukan berarti “melemah secara keseluruhan”
Jika 41/43 diuraikan, GPT-6.2 Astra tidak kehilangan poin pada lima kategori soal: analisis rutin, ambiguitas, pertanyaan yang tidak dapat dijawab, kualitas data, dan jebakan statistik. Kelima kategori ini mencakup sebagian besar skenario laporan harian dan pemeriksaan definisi metrik. Jika bisnis Anda terutama berhadapan dengan jenis pertanyaan seperti ini, dari data putaran ini kualitas Astra generasi baru setara dengan generasi sebelumnya, tetapi biaya dan kecepatannya jelas lebih baik.
Selisih dua soal juga perlu dilihat dalam rentang fluktuasi. Plotly melaporkan bahwa saat menjalankan ulang model lain, pernah terjadi fluktuasi hingga tiga soal. Jadi, 41 versus 43 lebih tepat dianggap sebagai “nilai pengamatan putaran ini”, bukan perbedaan kemampuan yang stabil. Ungkapan yang lebih akurat: pada kategori pola tersembunyi muncul sinyal yang layak dilacak, tetapi data satu putaran belum cukup untuk memastikan adanya degradasi.
Mengapa soal pola tersembunyi layak diuji ulang: hipotesis penjelasan tentang kedalaman eksplorasi
Berikut adalah hipotesis penjelasan berdasarkan data laporan, bukan kesimpulan Plotly. Pada soal pola tersembunyi, generasi baru rata-rata melakukan sekitar 9 kueri per soal, generasi sebelumnya sekitar 15 kueri; dari dua soal yang kehilangan poin, satu berperilaku “tidak menemukan”, yang lain “menemukan lokasi tetapi menyingkirkan penyebab sebenarnya”. Keduanya tampak seperti “berhenti setelah tidak menggali cukup dalam”: yang pertama cakupan eksplorasi kurang, yang kedua terlalu cepat mengambil kesimpulan negatif pada tahap verifikasi.
Hal ini dan penurunan biaya serta latensi mungkin berasal dari satu perubahan perilaku yang sama, yaitu model lebih cenderung menjawab setelah beberapa kali kueri saja. Pada soal biasa, kecenderungan ini langsung berubah menjadi efisiensi; pada soal akar masalah yang butuh hipotesis dan verifikasi berulang, kecenderungan ini bisa berubah menjadi risiko. Untuk memverifikasi hipotesis ini, perlu membandingkan hubungan antara jumlah kueri dan tingkat kelulusan pada data Anda sendiri, bukan sekadar melihat skor total.
Mengapa biaya dan kecepatan GPT-6.2 Astra turun secara bersamaan
Penurunan dari $19.97 ke $4.11 dapat dipecah menjadi dua bagian, berdasarkan data perhitungan ulang Plotly:
- Faktor tarif: penggunaan generasi sebelumnya apa adanya dihitung ulang dengan tarif baru menjadi sekitar $11, yaitu hanya dengan penurunan harga saja, biaya turun dari sekitar $19.97 ke $11, penurunan sekitar 45%. Harga satuan input cache resmi turun 60%, dan pada skenario dengan tingkat cache hit setinggi 93% hingga 98%, efek bagian ini sangat terasa.
- Faktor beban kerja: dari sekitar $11 menjadi $4.11, bergantung pada pengurangan beban kerja. Pemanggilan alat turun dari 266 menjadi 148 kali, token input berkurang dari sekitar 9,1 juta menjadi sekitar 4,4 juta, token output berkurang lebih dari setengah, proporsi cache hit naik dari 93% menjadi 98%.
Menghitung kasar penggunaan generasi baru dengan harga satuan resmi juga menghasilkan besaran yang sama dengan $4.11: dari sekitar 4,4 juta input, 98% memakai harga cache, sisanya memakai harga input biasa, ditambah sekitar 34 ribu token output. Ini menunjukkan bahwa dalam skenario seperti analisis data dengan konteks panjang dan banyak putaran pemanggilan alat, tingkat cache hit dan jumlah putaran pemanggilan mungkin lebih berpengaruh terhadap biaya daripada harga satuan itu sendiri. Peningkatan kecepatan pun sama logikanya: kueri lebih sedikit, pemanggilan model lebih sedikit, waktu yang berlalu otomatis lebih singkat.
💰 Saran biaya: Saat mengevaluasi biaya tugas bertipe Agent seperti ini, catat token cache hit dan jumlah putaran pemanggilan alat, jangan hanya melihat tabel harga satuan. Saat memanggil sesuai pemakaian melalui APIYI apiyi.com, Anda dapat mencocokkan tagihan dengan field usage di log untuk memverifikasi apakah cache benar-benar efektif.
Pilihan antara GPT-6.2 Astra, GPT-6.1 Sol, dan GPT-6.2 Sol
Posisi keempat model ini berbeda-beda:
- GPT-6.1 Sol: Dalam pengaturan ini meraih 43/43 dengan biaya $2.61, menjadikannya opsi “paling murah di antara yang skornya sempurna” pada putaran ini; konsekuensinya adalah waktu median 17.6 detik, lebih lambat daripada 6.2 Astra.
- GPT-6.2 Astra: 41/43, $4.11, 12.4 detik, keunggulannya muncul saat skor dan kecepatan dibandingkan bersama. Jika hanya melihat biaya dan skor, ia tidak unggul.
- GPT-6.2 Sol: $1.22, 10.5 detik, paling murah sekaligus paling cepat, tetapi skornya 40/43 adalah yang terendah.
- GPT-6 Astra: Skor sempurna, tetapi biaya dan latensinya jelas lebih tinggi, sehingga dalam kelompok pembanding ini sudah sulit menemukan alasan untuk memilihnya sebagai opsi utama.
Selisih skor di antara model-model tersebut semuanya berada dalam rentang fluktuasi maksimal tiga soal yang disebutkan Plotly. Ini berarti hanya dengan melihat skor total sulit menentukan urutan prioritas yang andal; dimensi pembeda yang benar-benar reliabel adalah biaya dan latensi. Dalam pemilihan praktis, produk tanya-jawab data interaktif sensitif terhadap latensi, sehingga bisa memprioritaskan perbandingan 6.2 Astra dan 6.2 Sol; analisis batch offline tidak sensitif terhadap latensi, dan rasio harga-kinerja 6.1 Sol lebih layak diperhatikan.
Cara menguji ulang GPT-6.2 Astra dengan data Anda sendiri
Metode pengujian ulang berikut merupakan saran editorial. DataAnalyticsBench hanya mencakup operasi ladang angin, berbahasa Inggris, dan lingkungan tunggal, sehingga sangat berbeda dengan gudang data nyata sebagian besar tim. Langkah yang lebih aman adalah membuat kumpulan soal kecil dengan data milik sendiri, memakai data, tool, dan petunjuk yang tetap sama, menjalankannya beberapa putaran, lalu mencatat performa untuk tiap jenis tugas secara terpisah.
| Subset | Jumlah soal disarankan | Fokus pencatatan | Kegunaan penilaian |
|---|---|---|---|
| Laporan rutin | 15-20 soal | Tingkat kelulusan, latensi median | Apakah pertanyaan data harian aman diserahkan ke model |
| Definisi ambigu | Sekitar 5 soal | Apakah model aktif meminta klarifikasi atau menjelaskan asumsi | Mencegah “diam-diam memilih satu definisi” |
| Bias statistik | Sekitar 5 soal | Apakah model mengenali jebakan seperti paradoks Simpson | Kredibilitas kesimpulan |
| Akar penyebab anomali | 5-8 soal | Tingkat kelulusan, jumlah kueri, latensi P90 | Memvalidasi sinyal kehilangan poin pada soal pola tersembunyi |
| Seluruh soal | — | Total biaya per putaran, rasio cache hit | Anggaran biaya |
Untuk setiap model, disarankan menjalankan minimal 3 putaran, lalu catat rata-rata dan variasinya. Latensi ekor (P90) harus dicatat terpisah: median yang terlihat bagus bukan berarti beberapa soal paling lambat bisa diterima.
Berikut contoh pemanggilan paling sederhana, ID model memakai gpt-6.2-astra yang diumumkan OpenAI, sedangkan model yang tersedia mengacu pada daftar platform:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.2-astra",
    reasoning_effort="medium",  # Kartu model menyatakan bahwa permintaan dengan effort none akan ditolak
    messages=[{"role": "user", "content": "上月各风场故障工单数环比变化最大的是哪个?请说明计算口径。"}],
)
print(resp.choices[0].message.content)
Lihat skrip pengujian ulang lengkap: statistik tingkat kelulusan, biaya, dan latensi P50/P90 per subset
import time
import statistics
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODELS = ["gpt-6.2-astra", "gpt-6-astra", "gpt-6.1-sol", "gpt-6.2-sol"]

# Kumpulan soal buatan sendiri: category memetakan ke subset di tabel pengujian ulang, checker Anda implementasikan berdasarkan kunci jawaban
TASKS = [
    {"id": "r01", "category": "常规报表", "prompt": "...", "checker": lambda a: "..." in a},
    {"id": "h01", "category": "异常根因", "prompt": "...", "checker": lambda a: "..." in a},
]

# Harga koneksi langsung resmi (USD/juta token), hanya untuk estimasi kasar; tagihan platform tetap jadi acuan
PRICE = {"input": 8.0, "cached": 0.40, "output": 40.0}

def estimate_cost(usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * PRICE["input"] + cached * PRICE["cached"]
            + usage.completion_tokens * PRICE["output"]) / 1_000_000

def p90(values):
    values = sorted(values)
    return values[max(0, int(len(values) * 0.9) - 1)]

def run(model, rounds=3):
    stats = {}
    for _ in range(rounds):
        for t in TASKS:
            start = time.perf_counter()
            resp = client.chat.completions.create(
                model=model,
                reasoning_effort="medium",
                messages=[{"role": "user", "content": t["prompt"]}],
            )
            elapsed = time.perf_counter() - start
            answer = resp.choices[0].message.content or ""
            s = stats.setdefault(t["category"], {"pass": 0, "n": 0, "lat": [], "cost": 0.0})
            s["n"] += 1
            s["pass"] += int(t["checker"](answer))
            s["lat"].append(elapsed)
            s["cost"] += estimate_cost(resp.usage)
    for cat, s in stats.items():
        print(f"{model} | {cat} | 通过率 {s['pass']}/{s['n']} | "
              f"P50 {statistics.median(s['lat']):.1f}s | P90 {p90(s['lat']):.1f}s | "
              f"估算费用 ${s['cost']:.3f}")

for m in MODELS:
    run(m)
Skrip ini hanya melakukan tanya jawab satu putaran. Kalau ingin lebih mendekati pengaturan DataAnalyticsBench, Anda juga perlu menyambungkan alat SQL read-only, membiarkan model melakukan kueri multi-putaran secara mandiri, dan mencatat tambahan jumlah pemanggilan alat untuk tiap soal — itu dipakai untuk menguji hipotesis “jumlah kueri dan kehilangan poin” yang dibahas sebelumnya.
🎯 Saran pengujian ulang: keempat model semuanya memakai protokol yang kompatibel dengan OpenAI, jadi cukup beralih dengan satu kunci API yang sama lewat APIYI apiyi.com. Kuota uji coba gratis untuk pengguna baru sudah cukup untuk menjalankan satu putaran kumpulan soal kecil terlebih dahulu, baru kemudian memutuskan apakah mau memperbesar skala.
Peringkat hanya memberi arah. Untuk gudang data Anda sendiri dan jenis anomali Anda sendiri, jawabannya hanya bisa didapat dengan menjalankannya sendiri. Lu You dalam puisi “Membaca Buku di Malam Musim Dingin untuk Anakku, Ziyu” menulis: “Ilmu dari kertas selalu terasa dangkal; hal ini baru benar-benar dipahami setelah dipraktikkan sendiri.”
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami lewat halaman utama APIYI apiyi.com; materi integrasi lebih lanjut bisa diakses di pusat dokumentasi docs.apiyi.com