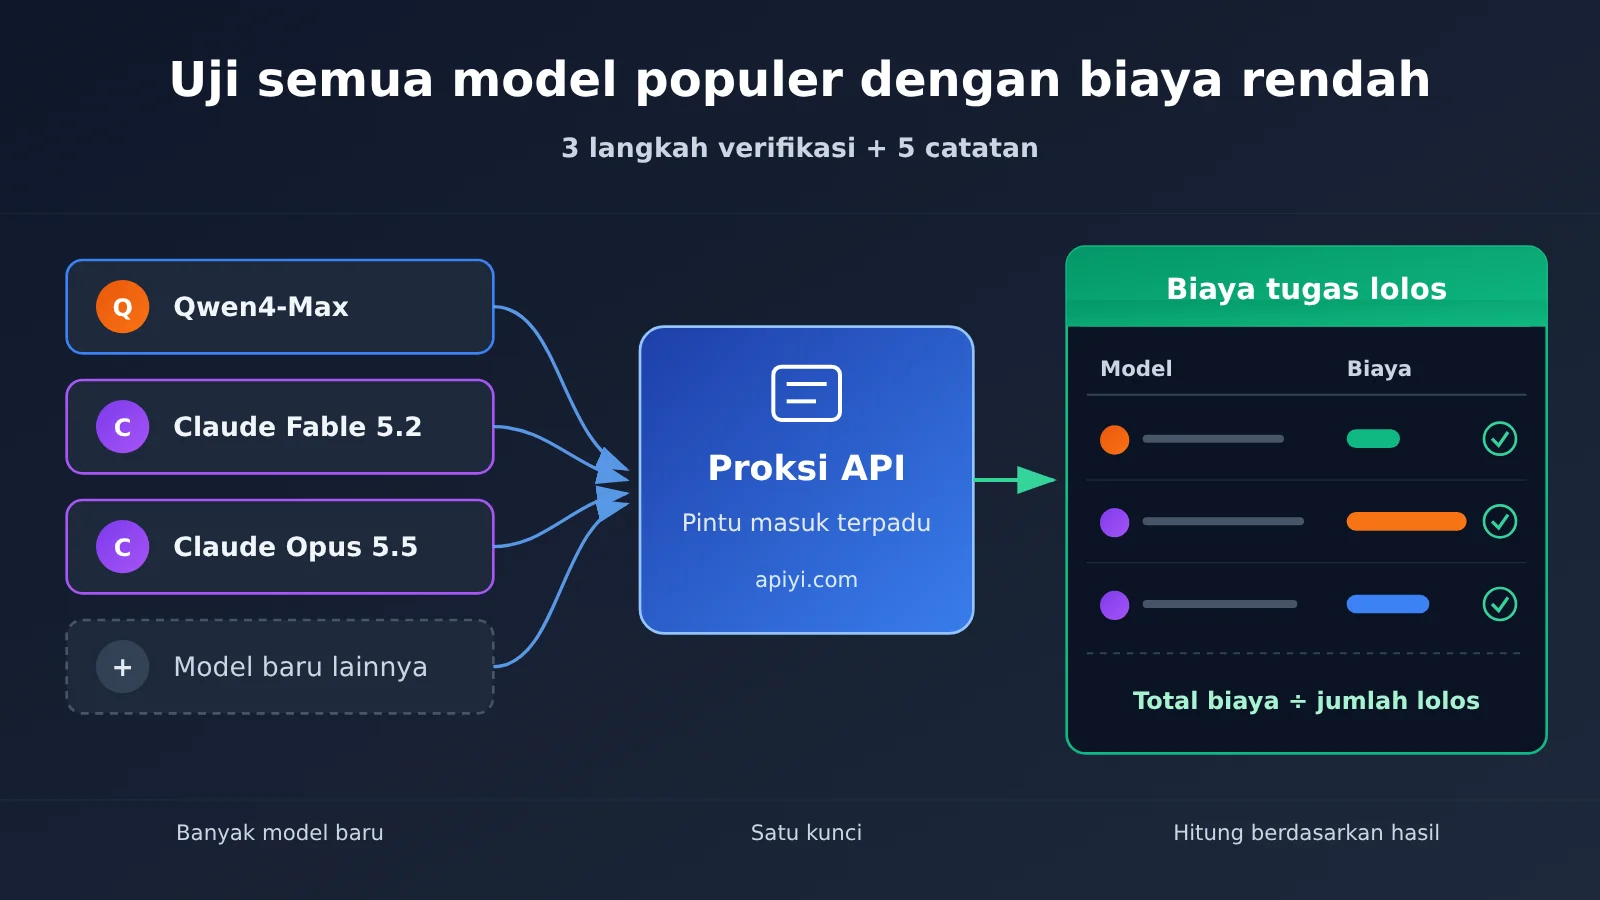
Ketika banyak model baru dirilis secara beruntun, untuk menguji semua model populer dengan biaya rendah, cara paling praktis adalah menyelesaikan integrasi melalui satu pintu masuk layanan proksi API yang terpadu. Ini menghemat pekerjaan berulang untuk mendaftar ke tiap penyedia dan mengonfigurasi tiap set SDK. Namun, pintu masuk terpadu hanya menyelesaikan “cara terhubung”, bukan “siapa yang harus dipilih”. Urutan yang benar adalah memeriksa dulu katalog model, izin kunci API, dan endpoint, lalu membandingkan output yang memenuhi syarat dan total biaya menggunakan kumpulan tugas nyata yang sama. Artikel ini menggunakan APIYI apiyi.com sebagai contoh untuk mendemonstrasikan alur uji coba beranggaran kecil dengan standar penerimaan ini.
Apa yang bisa Anda pahami setelah membaca artikel ini?
- ID model persis, endpoint, dan grup yang tersedia untuk Qwen4-Max dan Claude Fable 5.2 dalam katalog saat ini.
- Satu set kode integrasi dasar yang dapat digunakan ulang, serta cara memeriksa terlebih dahulu “model apa saja yang dapat dilihat oleh kunci ini”.
- Cara mengontrol biaya uji coba dengan tugas sampel kecil, catatan usage, dan tagihan, lalu memilih berdasarkan “biaya tugas yang memenuhi syarat”.
Indeks: Bagian “Fakta Objektif” terlebih dahulu mencantumkan entri katalog, syarat integrasi, dan kebijakan uji coba per 2026-11-17, serta menjelaskan kepada siapa harga penawaran dan skor peringkat dalam materi pihak ketiga masing-masing merujuk. Bagian “Analisis dan Penilaian” membahas tiga hal: cara merancang sampel kecil dengan soal yang sama, cara mencatat biaya, dan kesenjangan antara katalog yang terlihat, pemanggilan yang berhasil, dan output yang memenuhi syarat. Di akhir disertakan tabel catatan yang dapat diisi sendiri oleh pembaca.
Yang perlu diketahui: konsep yang perlu dipahami sebelum menguji model populer lewat layanan proksi API
| Konsep | Penjelasan singkat |
|---|---|
| Layanan proksi API | Gateway yang menyatukan permintaan ke model dari beberapa penyedia dalam satu pintu layanan |
| ID model | String yang dipakai dalam permintaan untuk menentukan model secara tepat, misalnya qwen4-max |
| Endpoint | Jalur permintaan spesifik yang disediakan layanan untuk suatu kemampuan, seperti chat, responses, messages |
| Grup token | Konfigurasi yang membatasi kanal model mana yang bisa diakses sebuah kunci, dan dengan koefisien penagihan berapa |
| usage | Catatan pemakaian dalam respons, dipakai untuk memeriksa Token yang benar-benar terpakai pada permintaan ini |
| Pembacaan cache | Memakai ulang prefiks input yang sudah diproses; harganya bisa berbeda dari input baru |
| Biaya per tugas yang memenuhi syarat | Total biaya semua percobaan ÷ jumlah tugas yang akhirnya memenuhi kriteria penerimaan |
Ringkasan dampak: apa arti pengujian model lewat layanan proksi API bagi tiap kelompok
- Developer yang baru pertama kali mengakses: satu Base URL plus satu kunci sudah cukup untuk berganti model, tidak perlu mengonfigurasi akun dan SDK berulang kali di banyak platform.
- Tim yang sudah punya bisnis berjalan: bisa menguji model baru dengan standar kelayakan milik sendiri, tanpa bergantung pada kesimpulan daftar peringkat orang lain; tetapi parameter seperti pemanggilan tool, visi, dan penalaran tetap harus disesuaikan satu per satu.
- Pengguna perorangan yang sensitif terhadap anggaran: batasi dulu jumlah tugas dan panjang input, lalu hitung berdasarkan “output yang benar-benar bisa dipakai”. Jangan hanya melihat harga satuan per juta Token.
Fakta objektif: katalog model populer dan syarat akses di layanan proksi API saat ini
Apa isi katalognya: entri qwen4-max dan claude-fable-5-2
Registry model yang dapat dibaca mesin dan dipublikasikan APIYI (docs.apiyi.com/model-registry.json) menyatakan sumber datanya adalah antarmuka penetapan harga platform, dengan waktu pembuatan 2026-11-17T07:54:33Z. Tabel tersebut memuat 285 catatan model. Perlu dicatat, ini adalah jumlah catatan katalog, bukan jumlah model yang benar-benar tersedia untuk suatu akun. Tiga entri yang relevan dengan artikel ini adalah sebagai berikut:
| ID model persis | Endpoint katalog | Grup (ID mesin) | Harga katalog: input / output / baca cache (USD per juta token) |
|---|---|---|---|
claude-fable-5-2 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 8 / 40 / 0.2 |
claude-opus-5-5 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 4 / 20 / 0.2 |
qwen4-max |
chat / responses / messages | ClaudeCode / CodexResponses / default / svip | 1.5 / 4.5 / 0.075 |
Semua harga di atas adalah harga katalog per 2026-11-17, bukan jumlah yang benar-benar dibayar akun; penyelesaian transaksi sebenarnya juga dipengaruhi faktor seperti grup token. Selebihnya, sebelumnya ada blog dan pengumuman lama yang menyebut kedua model ini “belum tersedia di katalog”. Pernyataan semacam itu hanya mencerminkan kondisi saat model tersebut dirilis dan tidak bisa dijadikan kesimpulan apakah model itu bisa dipanggil hari ini.
Registry mencantumkan grup reverse (ClaudeCodeReverse) untuk Fable, tetapi pengumuman awal dan FAQ tidak membuka grup tersebut. Karena itu, artikel ini menggunakan grup default atau ClaudeCode sebagai contoh dan tidak menjamin grup reverse dapat digunakan. Jika Anda memerlukan jalur penerusan resmi, perhatikan grup ClaudeOfficial pada entri Fable.
Cara menghubungkan: Base URL dan verifikasi visibilitas
Dokumen quick start (docs.apiyi.com/getting-started, diakses pada 2026-11-17) memberikan konfigurasi dasar sebagai berikut:
- Base URL untuk SDK yang kompatibel dengan OpenAI:
https://api.apiyi.com/v1 - Base URL untuk SDK Anthropic:
https://api.apiyi.com - Langkah pertama adalah meminta
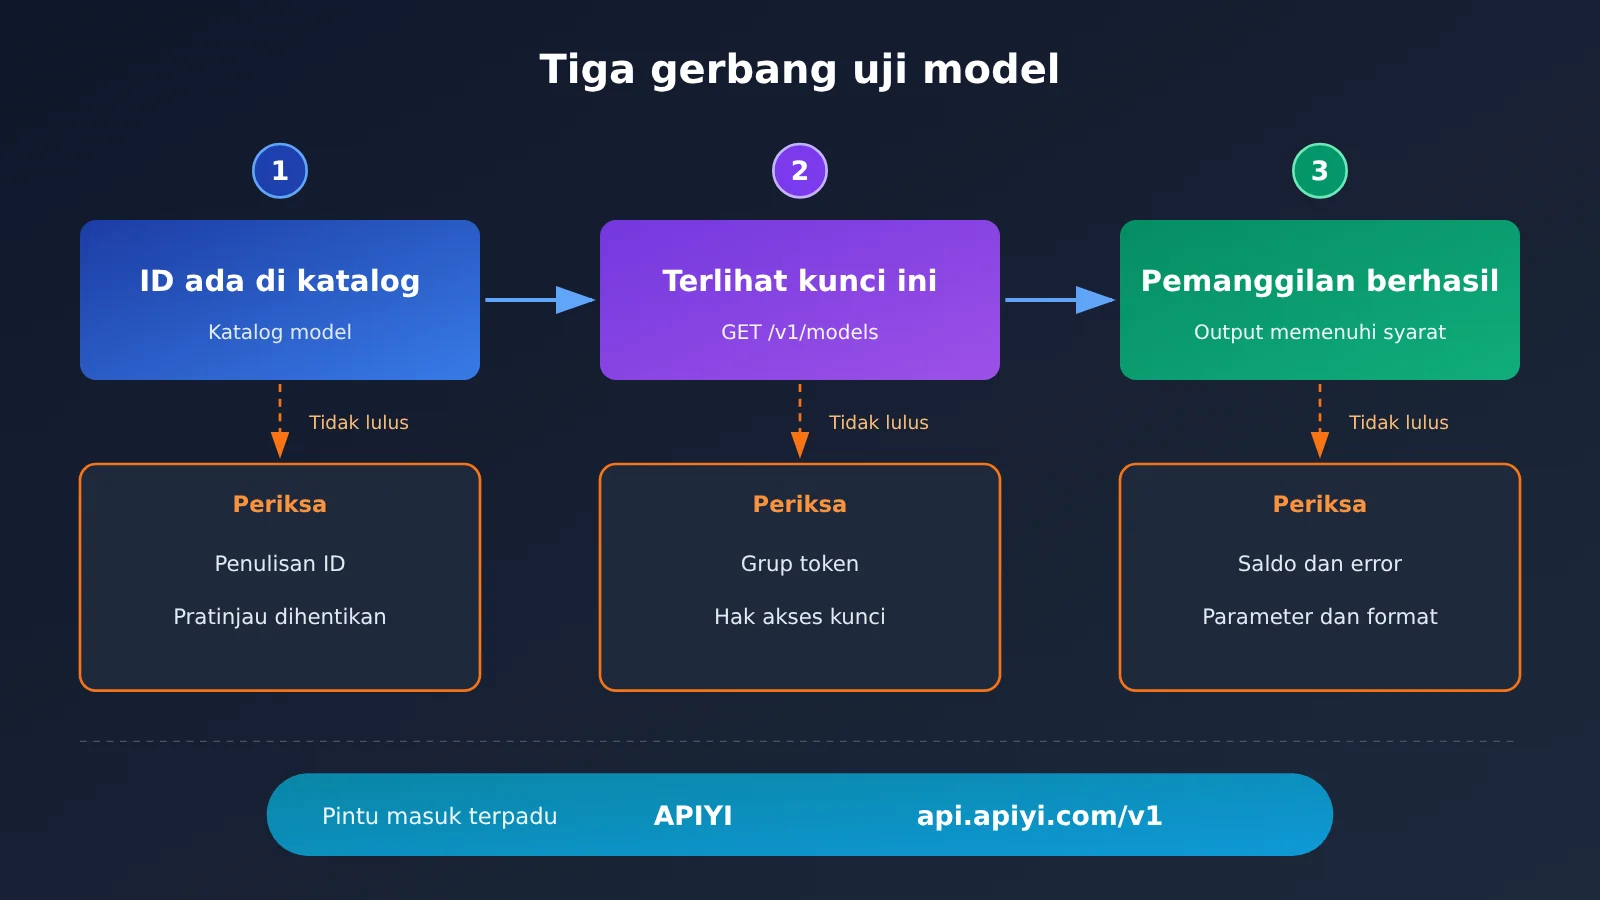
GET /v1/modelsuntuk memeriksa model mana saja yang terlihat oleh kunci saat ini, lalu pilih endpoint yang kompatibel.
Kedua model mendukung endpoint chat, jadi contoh di bawah ini seragam menggunakan Chat Completions yang kompatibel dengan OpenAI. Pastikan dulu model terlihat, lalu kirim permintaan terpendek, dan cetak usage-nya:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Endpoint kompatibel OpenAI APIYI
)

visible = {m.id for m in client.models.list().data}
for model in ["qwen4-max", "claude-fable-5-2"]:
    if model not in visible:
        print(f"{model}: tidak terlihat oleh kunci ini, periksa grup token")
        continue
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Jelaskan dalam satu kalimat apa itu layanan proksi API."}],
        max_tokens=100,
    )
    print(model, r.usage, r.choices[0].message.content)
Kuota Uji Coba: Mengacu pada Halaman Quick Start Saat Ini
Halaman Quick Start saat ini menyatakan bahwa akun yang mendaftar mendapat kuota uji coba senilai 0.05 dolar AS; tanpa mengisi saldo pun Anda sudah bisa memverifikasi pemanggilan pertama. Klaim pada kartu promosi awal seperti “daftar langsung dapat 3 juta Token” sudah tidak berlaku lagi—aturan yang ditampilkan di halaman akunlah yang menjadi acuan. Perlu dicatat juga, selama penulisan artikel ini tidak ada pemanggilan model berbayar yang dilakukan; semua “biaya” di artikel adalah estimasi berdasarkan harga katalog, bukan tagihan hasil pengukuran.
Apa yang Dibagikan dan Tidak Dibagikan oleh Antarmuka Terpadu
Menurut dokumentasi kemampuan pembuatan teks APIYI, antarmuka chat terpadu cocok untuk membandingkan bagian input dan output teks yang sama. Riwayat percakapan multi-giliran diatur sendiri oleh pihak pemanggil. Kemampuan, pengaturan penalaran, dan parameter opsional tiap model tetap berbeda; kebutuhan seperti pemanggilan alat, input visual, dan intensitas penalaran perlu diadaptasi secara terpisah. Hanya mengganti field model tidak serta-merta menghilangkan pekerjaan tersebut.
Cara membaca materi pihak ketiga: harga dan skor peringkat OrcaRouter
Diskusi terkini dalam materi berbahasa Inggris tentang kedua model ini sebagian besar berasal dari blog penyedia layanan routing lain, OrcaRouter (dipublikasikan pada 2026-11-16). Informasi pentingnya adalah sebagai berikut:
- Waktu rilis: Qwen4-Max tersedia secara resmi pada 2026-11-16; Claude Fable 5.2 dirilis pada 2026-11-09; apa yang disebut “Claude Fable 5.5” tidak ada dalam daftar model resmi Anthropic.
- Skor peringkat dan biaya per tugas: Data Artificial Analysis yang dikutip artikel (dibaca pada 2026-11-17) menunjukkan indeks komprehensif Qwen4-Max sekitar 42.9, dengan biaya terukur per tugas indeks sebesar 3.27 dolar; Fable 5.2 pada tingkat medium default memiliki indeks 56.4, dengan biaya per tugas 3.80 dolar. Artikel tersebut juga menyebutkan bahwa Qwen4-Max cenderung menghasilkan jumlah Token output yang besar dalam evaluasi.
- Penghentian versi pratinjau: ID pratinjau seperti
qwen4-max-previewakan berhenti melayani pada 2026-11-25 24:00 (UTC+8), setelah itu ID resmi yang dipertahankan adalahqwen4-max.
Angka-angka di atas semuanya berasal dari penyedia layanan tersebut dan evaluasi pihak ketiga terkait. Angka-angka itu bukan harga APIYI dan juga bukan kesimpulan pengujian aktual dalam artikel ini. Nilai referensinya terletak pada satu pemikiran: harga satuan yang rendah tidak berarti biaya per tugas juga rendah.
Analisis dan penilaian: Cara menguji model populer secara hemat biaya menggunakan layanan proksi API
Tetapkan tugas dan kriteria penerimaan dulu, baru buat sampel kecil dengan tugas yang sama
Pintu masuk terpadu menurunkan biaya integrasi hingga mendekati nol, sehingga biaya sebenarnya beralih ke “apa yang harus diuji”. Kami menyarankan untuk memilih 3–5 tugas kecil dari kebutuhan nyata, lalu untuk setiap tugas menetapkan versi input, standar kelayakan, dan dasar penilaian. Misalnya, “output harus berupa JSON yang dapat diurai dan berisi 5 field”, atau “ringkasan tidak boleh menghilangkan 3 angka dari teks asli”. Jika standar tidak ditulis sejak awal, pada akhirnya pengujian sering hanya menyisakan “merasa model mana yang lebih baik”.
Selanjutnya, kirim input yang sama ke masing-masing model kandidat dengan aturan penilaian yang konsisten: respons kosong, kesalahan format, dan pemotongan tidak dianggap lolos. Untuk parameter, gunakan dulu set minimal umum, yaitu hanya setel model, messages, dan max_tokens. Kebutuhan seperti pemanggilan alat, visi, dan intensitas penalaran diuji pada babak terpisah, agar tidak salah menilai “parameter belum disetel dengan benar” sebagai “modelnya tidak bagus”.
🚀 Saran memulai: Sampel kecil pada babak pertama bisa langsung diselesaikan menggunakan kuota uji coba yang disertakan saat mendaftar di APIYI apiyi.com. Pastikan dulu dua atau tiga model kandidat terlihat dan dapat dipanggil dengan kunci API Anda, lalu putuskan apakah akan mengisi ulang saldo untuk memperluas cakupan pengujian.
Menghitung semua percobaan: biaya tugas yang lolos
Setiap permintaan harus mencatat input, output, dan pembacaan cache dari usage (jika respons mengembalikan field tersebut); permintaan yang di-retry maupun gagal juga harus dicatat. Metrik intinya adalah biaya tugas yang lolos = total biaya seluruh percobaan ÷ jumlah tugas yang lolos. Jika hanya menghitung biaya percobaan yang berhasil, kita akan secara sistematis meremehkan model yang “murah tetapi butuh banyak retry”.
Berikut estimasi aritmetika murni berdasarkan harga katalog (bukan tagihan sebenarnya; koefisien grup akan mengubah hasil). Asumsikan satu permintaan memakai input 2.000 token dan output 500 token:
| Model | Biaya input | Biaya output | Estimasi per permintaan | Sekitar cukup untuk berapa kali dengan USD 0,05 |
|---|---|---|---|---|
qwen4-max (1,5 / 4,5) |
USD 0,003 | USD 0,00225 | sekitar USD 0,0053 | sekitar 9 kali |
claude-fable-5-2 (8 / 40) |
USD 0,016 | USD 0,02 | sekitar USD 0,036 | sekitar 1 kali |
Dari tabel ini ada dua kesimpulan. Pertama, kredit uji cukup untuk memverifikasi “apakah bisa jalan”, tetapi perbandingan kualitas yang serius membutuhkan anggaran lebih besar. Kedua, jika output aktual suatu model lebih panjang, atau butuh dua kali retry agar lolos, keunggulan harga satuan akan tergerus—persis seperti fenomena yang disebutkan dalam materi pihak ketiga sebelumnya. Karena itu anggaran perlu dikendalikan dalam dua lapis: batasi dulu dengan saldo akun dan max_tokens per permintaan, jalankan teks pendek, lalu naikkan ke konteks panjang setelah tingkat kelulusan terkonfirmasi.
Berikut skrip pencatatan yang bisa langsung dipakai ulang; skrip ini menulis setiap percobaan ke CSV agar biaya tugas yang lolos mudah dihitung nanti:
Lihat skrip pencatatan sampel untuk soal yang sama
import csv, time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

MODELS = ["qwen4-max", "claude-fable-5-2"]
TASKS = [
    {"id": "t1", "prompt": "把下面的会议记录整理为 JSON:...", "check": lambda s: s.strip().startswith("{")},
    # Tambahkan 2–4 tugas nyata lagi, masing-masing dengan fungsi penilaian yang baik
]

with open("trial_log.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.writer(f)
    w.writerow(["model", "task", "attempt", "prompt_tokens", "completion_tokens",
                "cached_tokens", "passed", "latency_s", "error"])
    for model in MODELS:
        for t in TASKS:
            for attempt in range(1, 3):  # Maksimal satu kali retry; kegagalan juga dicatat
                start = time.time()
                try:
                    r = client.chat.completions.create(
                        model=model,
                        messages=[{"role": "user", "content": t["prompt"]}],
                        max_tokens=800,
                    )
                    text = r.choices[0].message.content or ""
                    u = r.usage
                    details = getattr(u, "prompt_tokens_details", None)
                    cached = getattr(details, "cached_tokens", 0) if details else 0
                    ok = bool(text) and t["check"](text)
                    w.writerow([model, t["id"], attempt, u.prompt_tokens,
                                u.completion_tokens, cached, ok,
                                round(time.time() - start, 2), ""])
                    if ok:
                        break
                except Exception as e:
                    w.writerow([model, t["id"], attempt, 0, 0, 0, False,
                                round(time.time() - start, 2), str(e)[:120]])
Apa yang dihemat oleh pintu masuk terpadu, dan apa yang tidak bisa dihemat
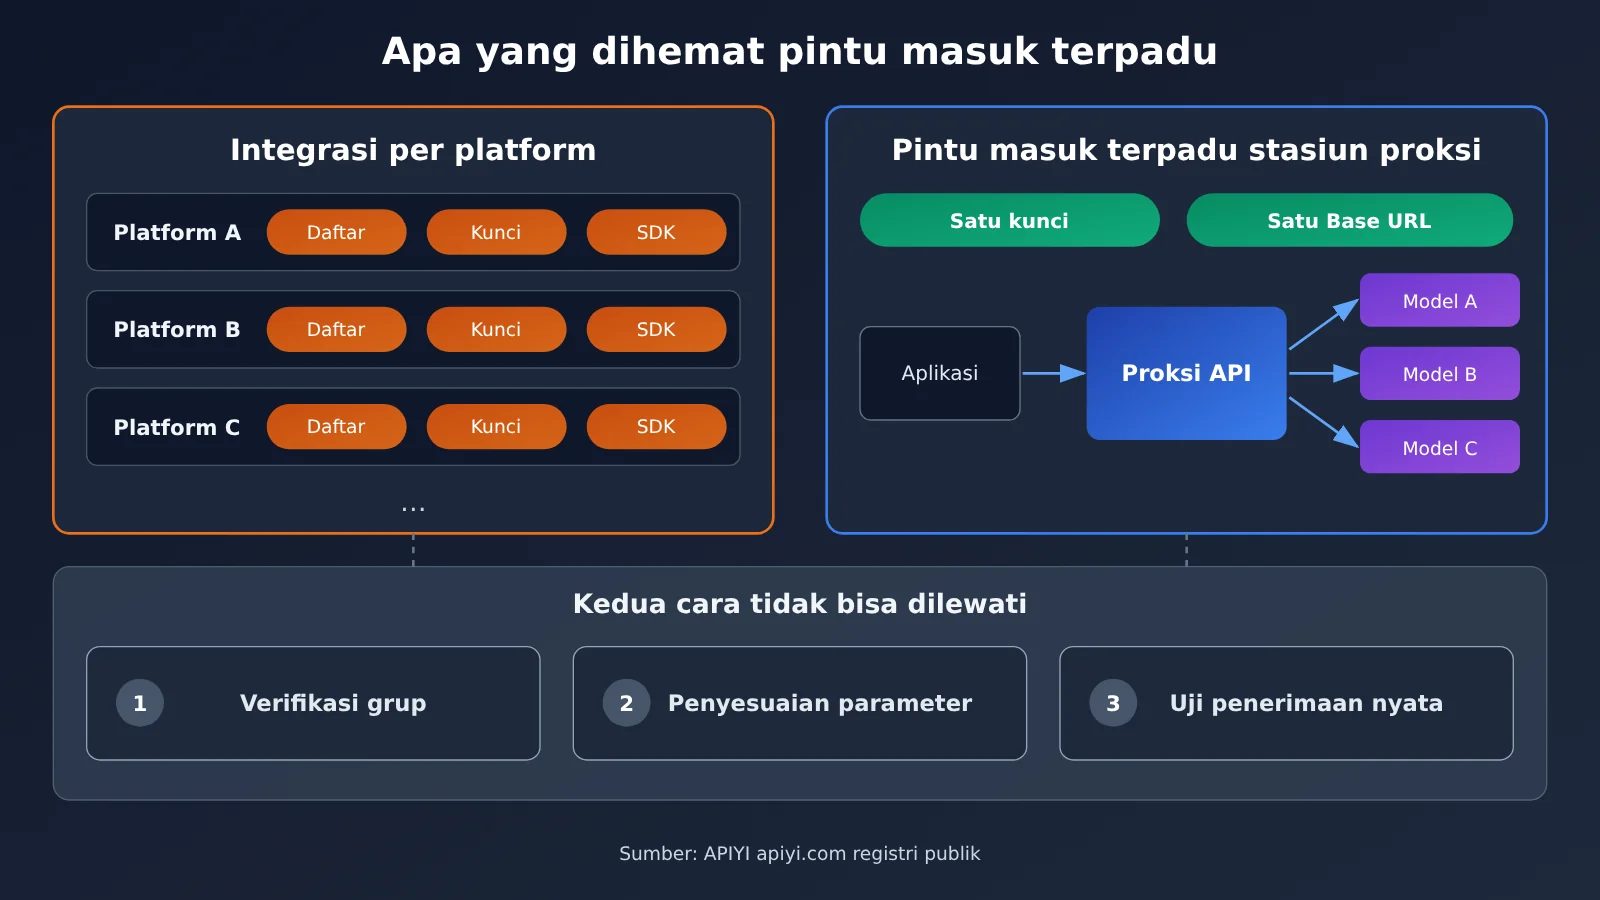
Yang dihemat oleh pintu masuk terpadu adalah akun, kunci, dan konfigurasi SDK yang berulang. Ada tiga hal yang tetap tidak bisa dihemat:
- Grup dan visibilitas: ada di katalog bukan berarti kunci Anda bisa melihatnya;
- Penyesuaian parameter: parameter non-publik perlu ditangani secara terpisah untuk tiap model;
- Verifikasi hasil: bisa melihat model bukan berarti pemanggilan berhasil dan output memenuhi syarat.
Katalog terlihat, kunci terlihat, pemanggilan berhasil, output memenuhi syarat—itu empat gerbang yang berurutan, dan masing-masing perlu diverifikasi sendiri-sendiri. Tabel berikut bisa dicentang satu per satu saat pengujian:
| Item pemeriksaan | Cara verifikasi | Penyebab umum saat tidak lulus |
|---|---|---|
| Model ID ada di katalog | Cek registri publik, pastikan penulisan ID tepat | Memakai ID preview atau alias |
| Terlihat oleh kunci ini | Panggil GET /v1/models |
Grup token tidak mencakup kanal tersebut |
| Kompatibilitas endpoint | Cocokkan dengan kolom endpoint di katalog | Memakai chat untuk kemampuan yang hanya mendukung responses |
| Pemanggilan berhasil | Benar-benar kirim permintaan terpendek | Saldo kurang, parameter tidak didukung |
| Output memenuhi syarat | Periksa dengan aturan penilaian yang sudah ditetapkan | Format salah, terpotong, kembalian kosong |
💡 Saran pemilihan: Buat satu token khusus untuk pengujian di konsol APIYI apiyi.com, lalu centang hanya grup yang dibutuhkan pengujian. Dengan begitu tagihan dan usage bisa dipisahkan dari trafik produksi, dan menghitung biaya tugas yang memenuhi syarat di kemudian hari juga lebih jelas.
Tabel kesimpulan yang perlu Anda isi sendiri
Artikel ini tidak memberikan peringkat kualitas antara qwen4-max dan claude-fable-5-2, karena kami belum pernah melakukan eksperimen pada tugas Anda, dan peringkat pihak ketiga pun tidak bisa mewakili bisnis Anda. Cara yang lebih andal adalah menjalankan sampel kecil terlebih dahulu, lalu mengisi tabel di bawah ini sendiri sebelum mengambil keputusan:
| Model | Jumlah percobaan | Jumlah yang lolos | Total biaya (sesuai tagihan) | Biaya tugas yang lolos | Parameter yang perlu disesuaikan tambahan |
|---|---|---|---|---|---|
| qwen4-max | |||||
| claude-fable-5-2 | |||||
| Model yang Anda gunakan saat ini |
Dua saran sebagai bahan pertimbangan, keduanya merupakan penilaian dan bukan kesimpulan yang sudah terverifikasi. Pertama, masukkan juga model yang Anda gunakan saat ini ke dalam tabel yang sama; model baru hanya layak untuk dimigrasi jika secara jelas unggul dalam “biaya tugas yang lolos” atau “tingkat kelulusan”. Kedua, pada masa awal peluncuran model baru, ID, harga, dan batas maksimal parameter bisa berubah — contohnya adalah ID pratinjau yang disebutkan sebelumnya yang akan dihentikan pada 25 November. Sebaiknya tulis ID model ke dalam file konfigurasi, bukan di-hardcode, sekaligus menyimpan satu jalur cadangan. Jika perlu memperluas cakupan kandidat, Anda bisa terus menambahkan model baru melalui pintu masuk terpadu APIYI apiyi.com, lalu menjalankannya ulang dengan set tugas dan aturan penilaian yang sama.
Peringkat dan katalog hanya bisa memberi tahu Anda model mana yang layak dicoba; model mana yang benar-benar cocok untuk bisnis Anda harus dijawab oleh tabel yang Anda buat dan jalankan sendiri. Sebagaimana ditulis Lu You dalam puisi “Membaca Buku di Malam Musim Dingin untuk Anakku Ziyu”: “Yang didapat dari kertas selalu terasa dangkal; untuk benar-benar memahami hal ini, harus dengan tindakan sendiri.”