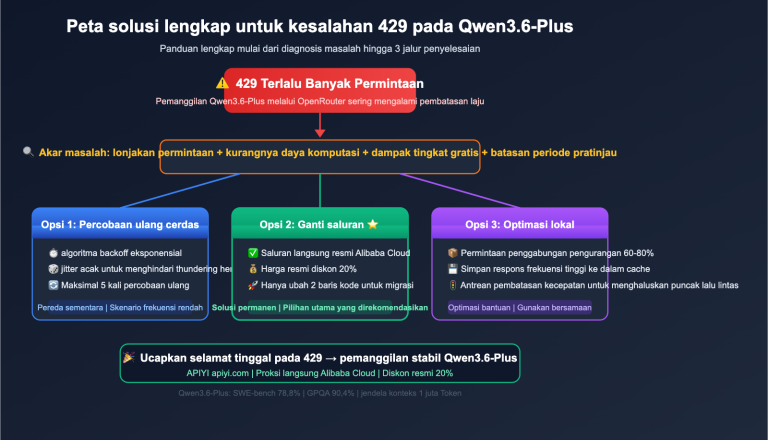
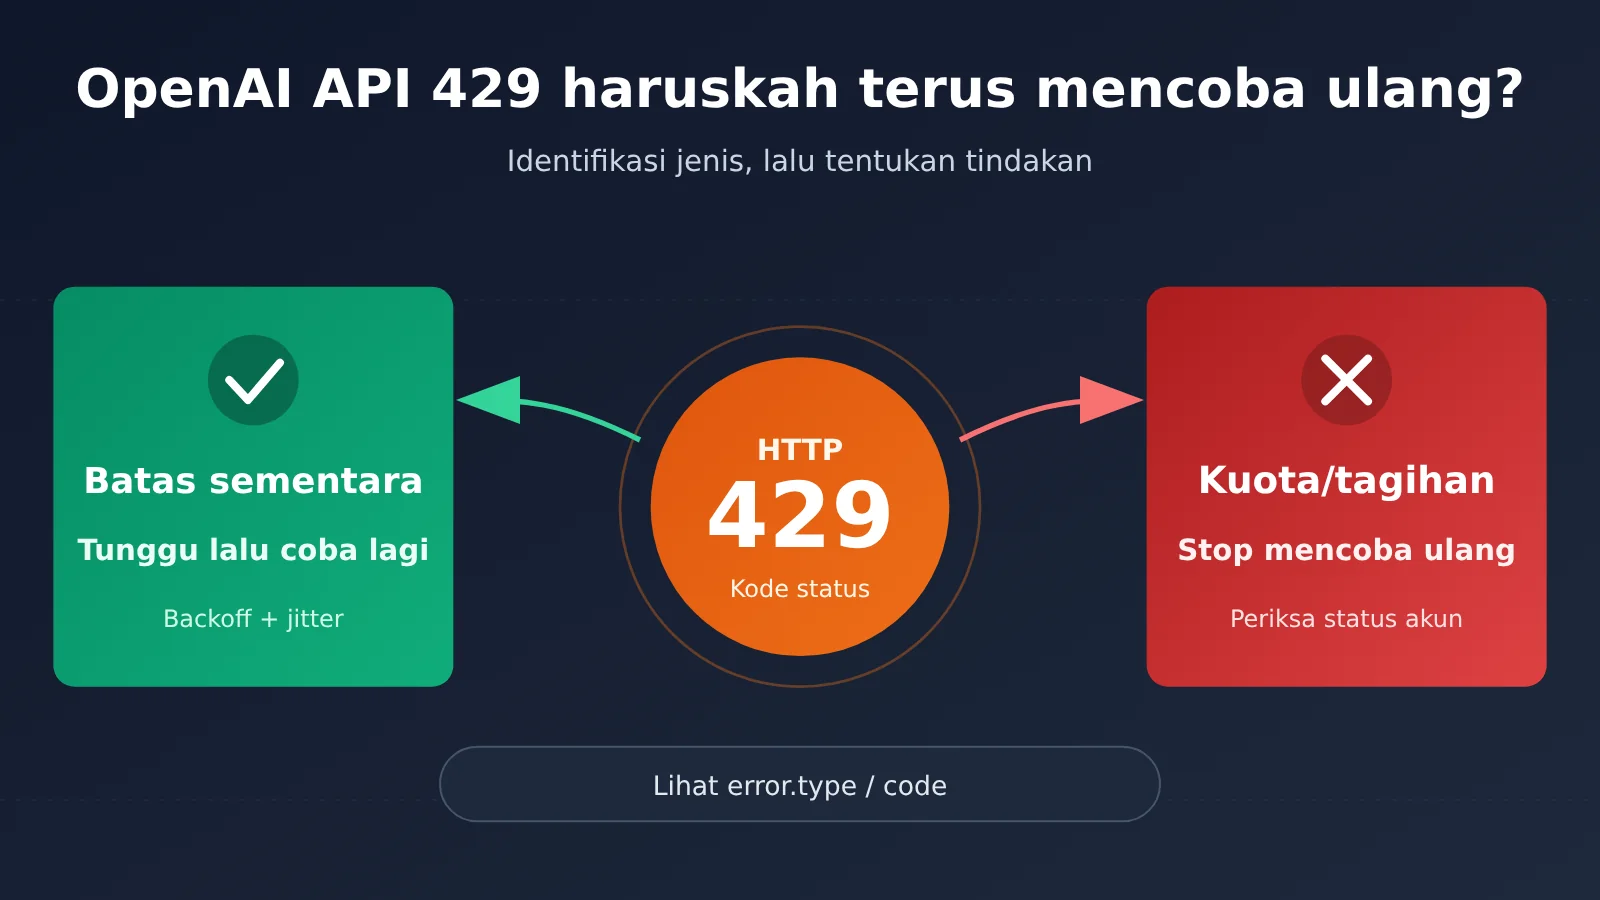
Jangan terus mencoba ulang. OpenAI API mengembalikan 429 bukan berarti “tunggu sebentar saja sudah beres”. Hanya pembatasan laju sementara yang layak ditunggu lalu dicoba ulang. Kuota habis, masalah penagihan, atau batasan penggunaan di tingkat organisasi tidak akan pulih hanya dengan mencoba ulang; sebaliknya, antrean bisa macet.
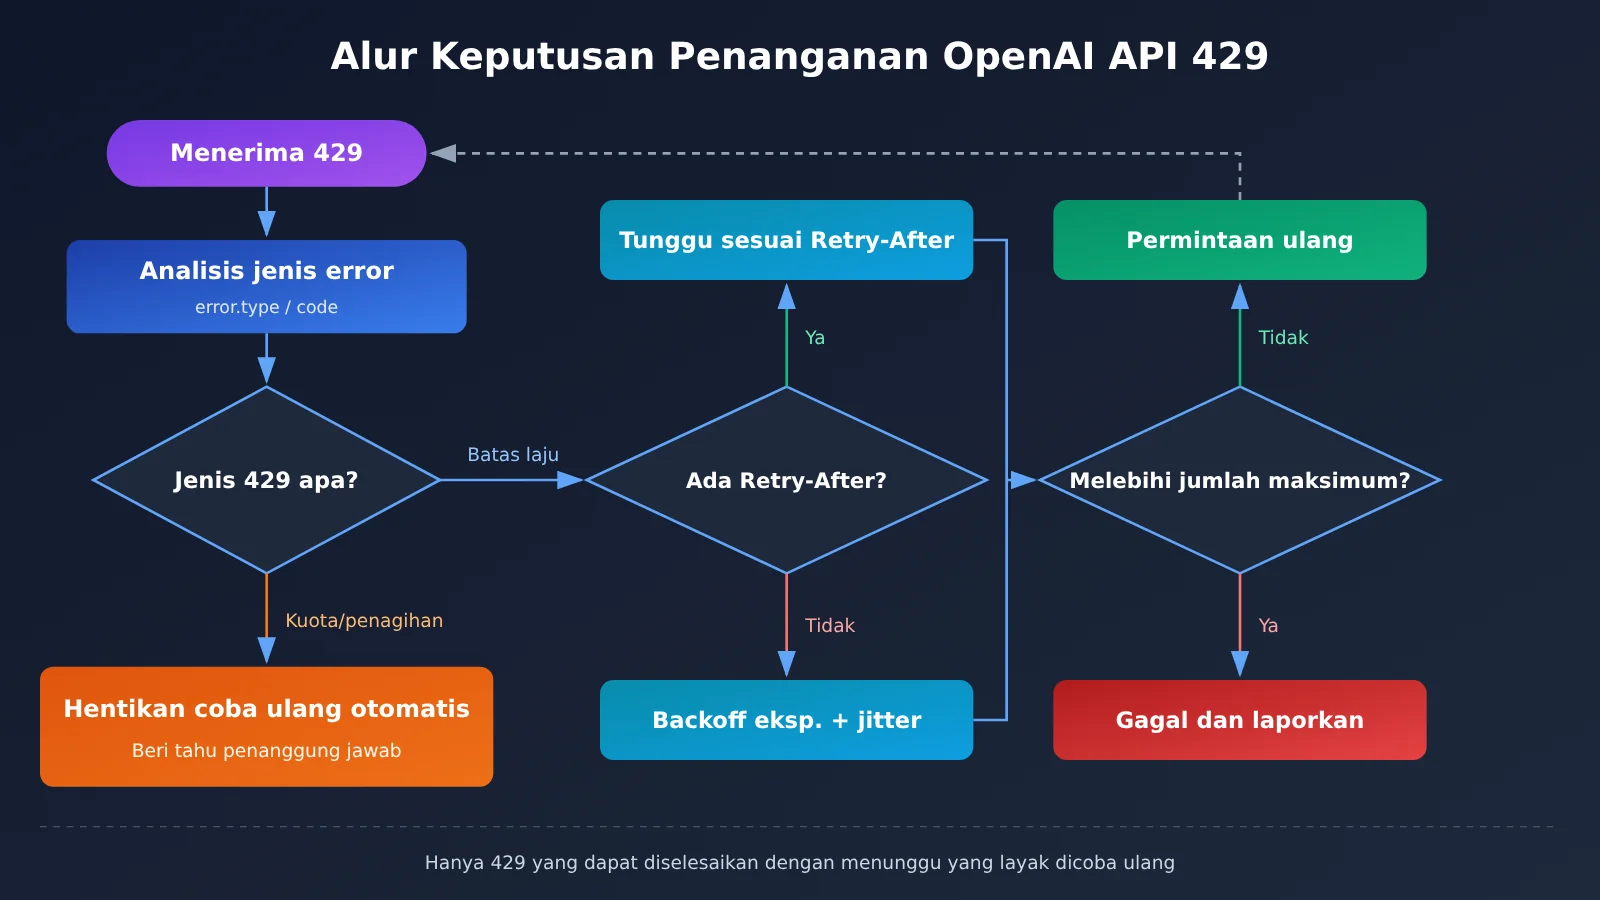
Cara yang tepat adalah melihat pesan error, error.type, dan error.code yang tersedia lebih dulu, lalu menentukan 429 ini termasuk kategori yang mana. Jika itu pembatasan laju sementara, dan ada Retry-After yang valid, tunggu sesuai nilainya; jika tidak ada, gunakan backoff eksponensial dengan jitter acak, dan tetapkan batas jumlah percobaan.
Apa yang akan Anda pelajari dari artikel ini?
- 429 dari OpenAI API setidaknya terbagi menjadi kategori apa saja, dan bagaimana masing-masing harus ditangani.
- Apa hubungan antara
Retry-After, backoff eksponensial, dan jitter acak, serta kapan menggunakan yang mana. - Mengapa percobaan ulang otomatis dari SDK resmi, antrean tugas, dan tombol “coba ulang” manual yang bertumpuk bisa memperparah 429.
- Solusi berbeda untuk bottleneck jumlah permintaan dan bottleneck token, serta hal yang perlu diperhatikan saat permintaan streaming gagal di tengah jalan.
Indeks: Sebelum isi utama, kami sajikan satu tabel konsep dan satu ringkasan dampak untuk membantu Anda menyamakan istilah dan menemukan bagian yang relevan. Bagian “Fakta objektif” merangkum deskripsi dokumentasi resmi OpenAI tentang 429, termasuk klasifikasi error, aturan percobaan ulang, dan perilaku SDK. Bagian “Analisis dan pertimbangan” membahas penerapan di rekayasa, termasuk menyesuaikan strategi berdasarkan jenis bottleneck, merancang status antrean, menelusuri percobaan ulang yang bertumpuk, dan perbedaan semantik yang perlu diperhatikan saat bermigrasi ke gateway lain.
To Know: Konsep yang perlu dipahami tentang OpenAI API 429
| Konsep | Penjelasan singkat |
|---|---|
| HTTP 429 | Kode status “Too Many Requests”. OpenAI API memakainya untuk menandakan pembatasan laju, sekaligus untuk menandakan batas kuota atau penggunaan |
| Pembatasan laju (Rate Limit) | Batas atas jumlah permintaan yang bisa dikirim dalam periode tertentu. OpenAI menghitung jumlah permintaan dan jumlah token secara terpisah |
| RPM / TPM | Jumlah permintaan per menit dan jumlah token per menit. Salah satu dari keduanya mencapai batas bisa memicu 429 |
error.type / error.code |
Field terstruktur di dalam body respons error, dipakai untuk membedakan penyebab spesifik 429, lebih andal daripada hanya melihat kode status |
| Retry-After | Field header respons yang menunjukkan berapa lama server menyarankan untuk menunggu sebelum mencoba lagi. Jika nilainya valid, sebaiknya diikuti |
| Exponential Backoff (mundur eksponensial) | Setelah setiap kegagalan, waktu tunggu bertambah secara berlipat, misalnya 1 detik, 2 detik, 4 detik, dan diberi batas maksimum |
| Jitter (getaran acak) | Menambahkan jumlah acak pada waktu backoff agar banyak klien tidak menumpuk retry di saat yang sama |
| Output streaming (Streaming) | Model mengembalikan konten sambil menghasilkannya. Begitu output dimulai, error di tengah jalan tidak bisa begitu saja diputar ulang secara keseluruhan |
| Penumpukan retry | Fenomena ketika SDK, antrean bisnis, dan tindakan manual pengguna masing-masing melakukan retry sehingga volume permintaan aktual berlipat ganda |
Ringkasan Dampak: Apa Arti OpenAI API 429 bagi Berbagai Peran
| Peran | Dampak Utama | Hal yang Perlu Diperhatikan |
|---|---|---|
| Pengembang backend | Logika percobaan ulang yang salah dapat mengubah pembatasan laju sementara menjadi gangguan berkepanjangan | Bedakan jenis 429, dan serahkan percobaan ulang pada satu lapisan yang menanganinya secara terpusat |
| Penanggung jawab tugas batch dan data | Tugas bervolume besar mudah menabrak dua batas sekaligus: jumlah permintaan dan token | Ritme pengiriman, ukuran konteks, dan desain status antrean |
| Produk dan frontend | Pengguna yang berulang kali menekan “coba lagi” justru terus memicu 429 baru | Beri tahu pengguna kapan sebaiknya mencoba lagi, atau jelaskan bahwa penyebabnya ada pada akun |
| Operasi dan pengelola akun | 429 terkait kuota dan penagihan tidak bisa pulih sendiri lewat kode | Deteksi dan tangani status akun dengan cepat, jangan biarkan percobaan ulang otomatis berjalan tanpa kendali |
Fakta Objektif: Bagaimana Dokumentasi Resmi OpenAI Menjelaskan 429
Bagian ini mengacu pada panduan kode error, panduan pembatasan laju, dan artikel penelusuran masalah 429 di pusat bantuan yang dipelihara secara publik oleh OpenAI, dengan tanggal verifikasi 2026-11-17. Dokumen-dokumen ini adalah dokumentasi pemeliharaan yang terus diperbarui, dan artikel ini tidak dapat memverifikasi kapan konten terkait pertama kali diterbitkan, sehingga tidak diperlakukan sebagai berita hari itu, melainkan hanya sebagai penjelasan aturan yang berlaku saat ini.
Berbagai Sumber Error 429 pada OpenAI API
Prinsip utama dalam dokumentasi resmi adalah: 429 yang sama bisa memiliki makna berbeda; tentukan berdasarkan pesan error, error.type, dan error.code yang tersedia. Pembatasan laju sementara dan batas kuota, penagihan, serta penggunaan organisasi ditangani dengan cara yang berbeda.
Yang pertama berarti “terlalu cepat atau terlalu banyak permintaan dalam jendela saat ini”; setelah jendela diperbarui, kondisinya biasanya pulih. Yang kedua berkaitan dengan status akun itu sendiri, misalnya kuota habis, masalah pembayaran, atau batas penggunaan di tingkat organisasi. Masalah seperti ini tidak akan hilang sendiri seiring waktu.
| Jenis 429 | Sinyal tipikal | Apakah menunggu dapat mengatasi | Tindakan yang disarankan |
|---|---|---|---|
| Pembatasan laju jumlah permintaan | Pesan error mengarah pada batas jumlah permintaan; code yang umum adalah rate_limit_exceeded |
Biasanya bisa | Ikuti Retry-After, atau gunakan backoff eksponensial dengan jitter |
| Pembatasan laju jumlah token | Pesan error mengarah pada batas token | Biasanya bisa, tetapi mudah terpicu berulang kali | Kurangi jumlah token per permintaan sambil melakukan backoff |
| Batas kuota/penagihan/organisasi | Pesan error mengarah pada kuota atau tagihan; code yang umum adalah insufficient_quota |
Tidak bisa | Hentikan percobaan ulang otomatis, beri tahu penanggung jawab untuk menangani akun |
Perlu ditekankan bahwa nilai spesifik error.code harus mengacu pada isi respons aktual dan dokumentasi resmi. code pada tabel di atas hanyalah contoh umum; dalam kode, jangan membuat keputusan hanya berdasarkan string yang di-hardcode, dan tetap simpan pesan error asli untuk penelusuran log.
Batas jumlah permintaan dan jumlah token bisa berlaku terpisah
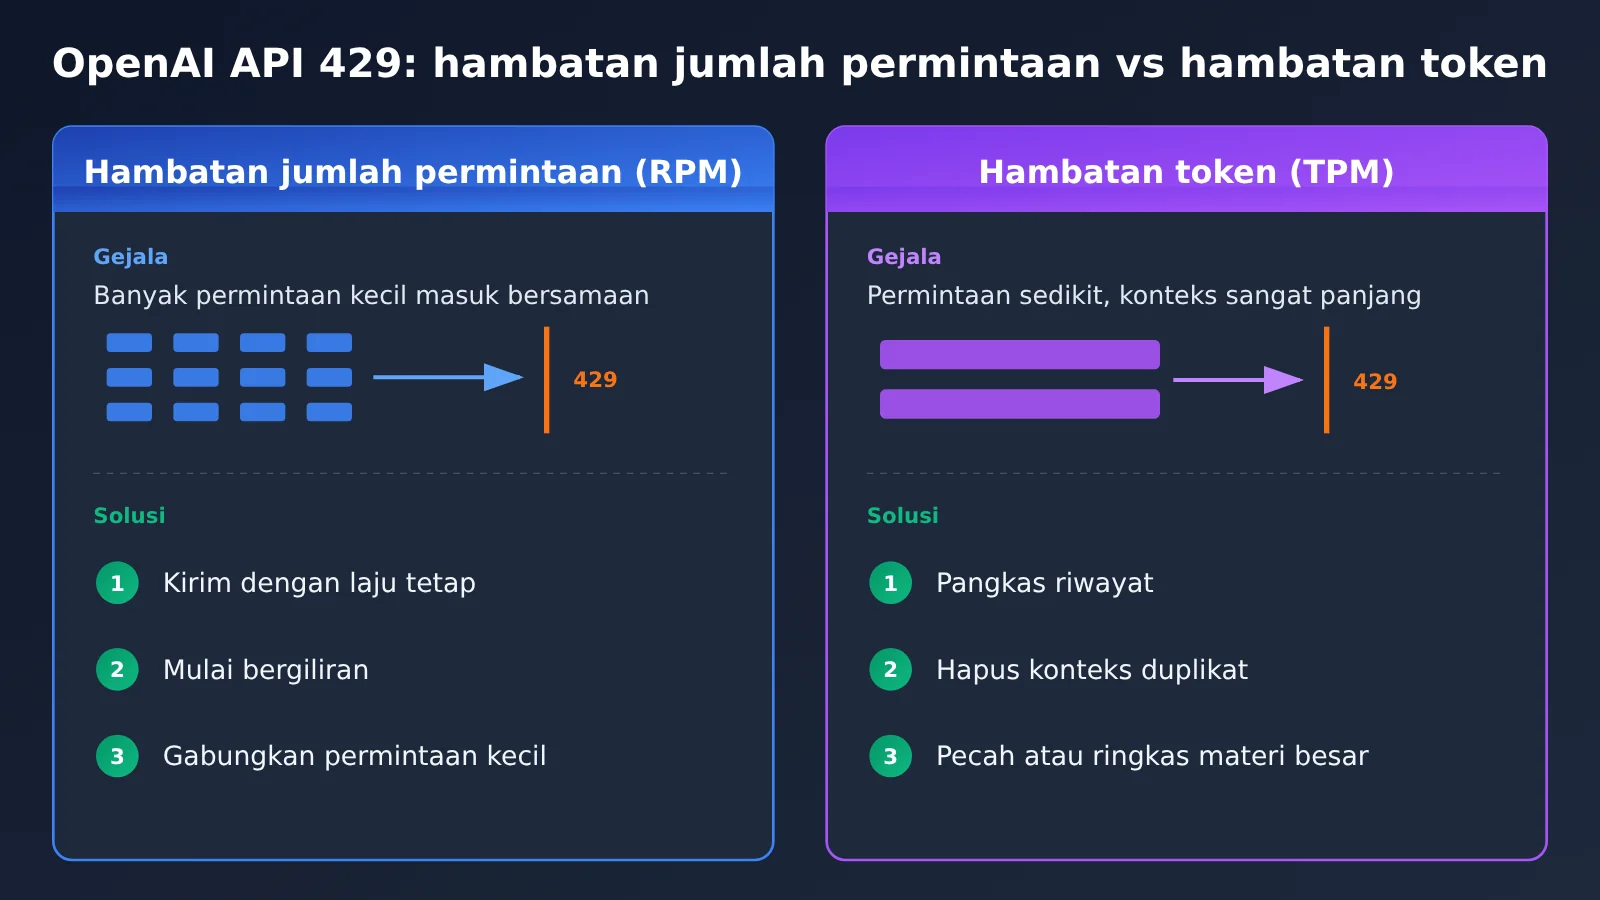
Panduan rate limit menjelaskan bahwa batas diukur dari beberapa dimensi, dan yang paling sering ditemui adalah jumlah permintaan dan jumlah token, yang keduanya berlaku secara independen. Artinya, saat jumlah permintaan masih jauh dari batas, kamu bisa lebih dulu menabrak batas token karena setiap permintaan membawa konteks yang sangat panjang. Sebaliknya, banyak permintaan yang sangat kecil pun bisa lebih dulu menghabiskan kuota jumlah permintaan.
OpenAI menyediakan informasi terkait rate limit di header respons, misalnya sisa jumlah permintaan, sisa jumlah token, dan waktu reset masing-masing. Field header ini membantu kamu menentukan batas mana yang lebih dekat sebelum benar-benar memicu 429.
Cara retry OpenAI API 429 yang direkomendasikan secara resmi
Untuk pembatasan sementara yang layak dicoba ulang, rekomendasi resmi bisa diringkas menjadi dua poin:
- Saat ada Retry-After yang valid, ikuti nilainya. Ini adalah sinyal paling langsung dari server, lebih akurat daripada tebakan klien sendiri.
- Saat tidak ada Retry-After, gunakan exponential backoff dengan jitter acak. Waktu tunggu meningkat seiring jumlah kegagalan, lalu ditambah besaran acak, agar semua klien tidak mencoba ulang pada saat yang sama.
Kedua aturan ini berasumsi bahwa “429 kali ini termasuk jenis yang bisa diselesaikan dengan menunggu”. Jika masalahnya adalah kuota atau penagihan, algoritma backoff seakurat apa pun hanya akan berputar tanpa hasil.
Perilaku percobaan ulang otomatis pada SDK resmi
SDK resmi OpenAI akan secara otomatis mencoba ulang kesalahan pembatasan laju (rate limit) yang memenuhi syarat, dan perilaku spesifiknya dipengaruhi oleh konfigurasi klien. Pada SDK Python misalnya, Anda bisa menyesuaikannya lewat parameter max_retries, atau menyetelnya ke 0 untuk mematikan percobaan ulang otomatis.
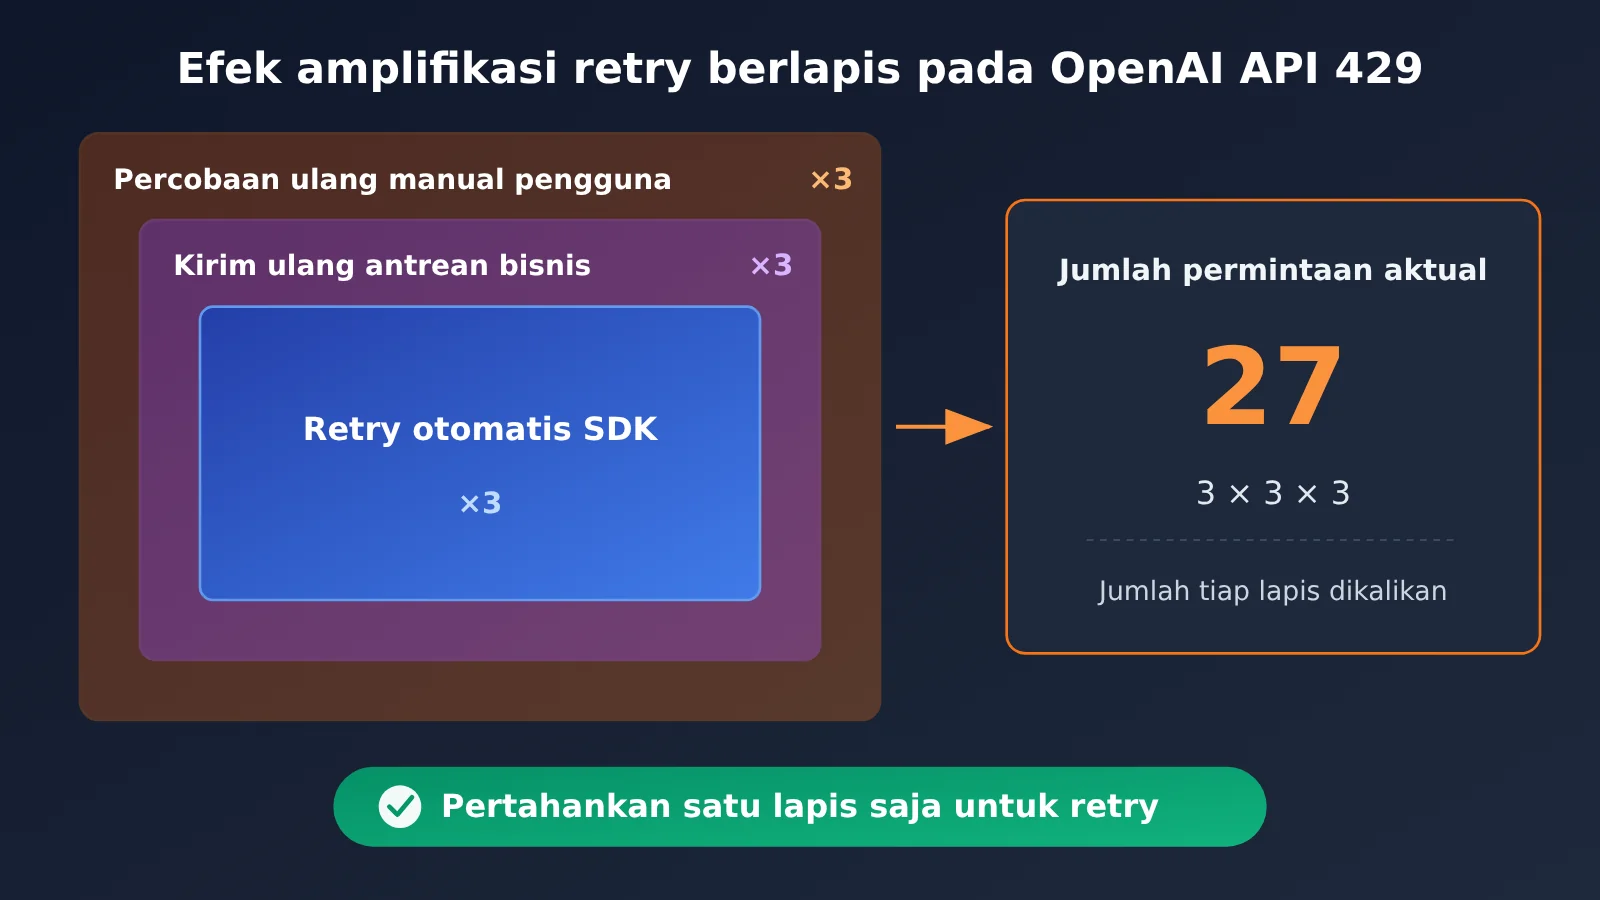
Artinya, meskipun kode bisnis Anda tidak menulis satu baris pun logika percobaan ulang, permintaan tersebut mungkin sudah dicoba ulang beberapa kali. Jika lapisan bisnis menambahkan lapisan percobaan ulang lagi di atasnya, jumlah permintaan sebenarnya adalah hasil kali keduanya.
Kesalahan di tengah permintaan streaming tidak bisa selalu diputar ulang begitu saja
Dokumentasi resmi juga menyebutkan batasan yang mudah terlewat: begitu output streaming sudah dimulai, kesalahan yang terjadi setelahnya tidak bisa selalu ditangani dengan memutar ulang seluruh permintaan. Pengguna mungkin sudah melihat sebagian konten, dan sistem hilir juga mungkin sudah mengonsumsi sebagian data. Memutar ulang secara langsung akan menyebabkan konten duplikat, tidak konsisten antara sebelum dan sesudah, serta menghabiskan token dua kali.
Analisis dan penilaian: bagaimana menerapkan OpenAI API 429 di praktik engineering
Konten berikut adalah penilaian engineering berdasarkan fakta di atas, bukan pernyataan resmi OpenAI.
Contoh backoff OpenAI API 429 yang bisa langsung dimodifikasi
Contoh di bawah ini memperlihatkan beberapa prinsip: matikan retry otomatis SDK dan serahkan penanganan seragam ke lapisan bisnis; error terkait kuota langsung dilempar; utamakan mengikuti Retry-After; jika tidak ada, gunakan exponential backoff dengan jitter penuh; batasi jumlah percobaan maksimum.
import random
import time
from openai import OpenAI, RateLimitError

# Matikan retry otomatis SDK untuk menghindari penumpukan dengan retry kustom di bawah
client = OpenAI(max_retries=0)

# Jenis 429 yang tidak dapat diselesaikan hanya dengan menunggu (mengacu pada respons aktual dan dokumentasi resmi)
NON_RETRYABLE_CODES = {"insufficient_quota"}


def parse_retry_after(response):
    """Mengurai jumlah detik Retry-After; kembalikan None jika tidak valid. Format tanggal HTTP dapat ditambahkan penguraiannya sesuai kebutuhan."""
    if response is None:
        return None
    value = response.headers.get("retry-after")
    try:
        seconds = float(value)
        return seconds if seconds >= 0 else None
    except (TypeError, ValueError):
        return None


def call_with_backoff(messages, model, max_attempts=5, base=1.0, cap=60.0):
    for attempt in range(max_attempts):
        try:
            return client.chat.completions.create(model=model, messages=messages)
        except RateLimitError as e:
            if e.code in NON_RETRYABLE_CODES:
                raise  # Masalah kuota/penagihan, serahkan ke proses penanganan akun
            if attempt == max_attempts - 1:
                raise  # Melebihi batas maksimum, serahkan ke antrean atau alarm
            wait = parse_retry_after(e.response)
            if wait is None:
                # Jitter penuh: ambil nilai acak dalam [0, batas atas eksponensial]
                wait = random.uniform(0, min(cap, base * 2 ** attempt))
            time.sleep(wait)
max_attempts, base, dan cap dalam contoh hanyalah titik awal, bukan nilai yang direkomendasikan. Tingkat limit tiap akun berbeda, begitu pula bentuk tugasnya, sehingga tidak ada satu angka konkurensi atau jumlah retry yang cocok untuk semua akun, dan semuanya harus disesuaikan berdasarkan data monitoring Anda sendiri.
Menyesuaikan berdasarkan jenis bottleneck: solusi bottleneck jumlah permintaan dan bottleneck token berbeda
Backoff hanya bisa menjawab “bagaimana menunggu kali ini”, tetapi tidak bisa menjawab “kenapa selalu menabrak batas”. Untuk mengurangi 429, pertama-tama harus jelas batas mana yang ditabrak.
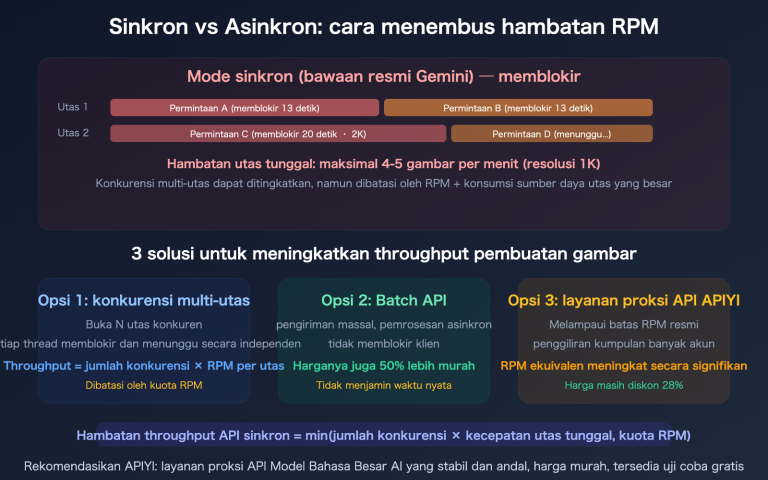
Kunci bottleneck jumlah permintaan adalah merenggangkan ritme pengiriman. Di pintu masuk antrean, lakukan pelepasan dengan laju tetap, misalnya token bucket atau pelepasan dengan interval tetap, jangan biarkan banyak tugas membanjir pada detik yang sama. Saat memulai tugas batch juga harus menyebar waktu, jangan dipicu serentak pada jam bulat.
Kunci bottleneck token adalah mengurangi ukuran satu permintaan. Pemborosan yang umum meliputi: setiap putaran percakapan membawa petunjuk sistem dan riwayat yang sangat panjang secara lengkap; dokumen besar yang sama dikirim berulang kali di banyak permintaan; seluruh materi dimasukkan ke model padahal sebenarnya hanya perlu satu bagian saja. Melakukan pemotongan, peringkasan, atau retrieval terlebih dahulu sebelum mengirim sering jauh lebih efektif daripada menaikkan jumlah percobaan ulang.
Status antrean harus membedakan “menunggu percobaan ulang” dan “akun terblokir”
Banyak sistem hanya punya dua status: “dalam antrean” dan “gagal”. Saat kena 429, ini memicu dua kesalahan penilaian: pembatasan sementara dianggap gagal sehingga tugas dibuang, sementara masalah kuota dianggap masih mengantre sehingga menunggu tanpa batas.
Pendekatan yang lebih masuk akal adalah memecah kedua jenis 429 menjadi dua status dengan tampilan berbeda:
| Status antrean | Pemicu | Informasi yang perlu ditampilkan | Penanganan lanjutan |
|---|---|---|---|
| Menunggu percobaan ulang | Pembatasan laju sementara | Perkiraan waktu percobaan berikutnya, jumlah percobaan yang sudah dilakukan | Coba ulang otomatis saat waktunya tiba; jika mencapai batas, ubah ke gagal |
| Akun terblokir | Kuota, penagihan, batas penggunaan organisasi | Alasan blokir (mis. kuota tidak mencukupi) | Jeda tugas-tugas berikutnya di akun yang sama, beri tahu penanggung jawab |
| Gagal | Melebihi batas percobaan ulang atau error lain yang tidak dapat dipulihkan | Jenis error dan pesan asli | Intervensi manual atau degradasi layanan |
Status “akun terblokir” juga punya efek berantai. Tugas lain di akun yang sama kemungkinan besar akan kena 429 yang sama, jadi sebaiknya dijeda secara keseluruhan, bukan dibiarkan setiap tugas menabraknya sendiri-sendiri.
Menelusuri penumpukan retry: SDK, antrean, tombol manual
Kalau kamu menemukan 429 makin banyak justru saat di-retry, hal pertama yang perlu dicek adalah apakah ada beberapa lapisan retry yang aktif bersamaan. Rantai tipikalnya: SDK otomatis retry beberapa kali, antrean bisnis mengirim ulang tugas setelah gagal beberapa kali, lalu pengguna di frontend melihat error dan menekan “Retry” manual. Setelah tiga lapisan dikalikan, satu permintaan awal bisa berubah jadi belasan permintaan nyata, dan permintaan itu sering terkumpul tepat di jendela pembatasan laju, yang justru memperparah limit.
Saat menelusuri, sebaiknya cek lapisan demi lapisan:
- Lapisan SDK: Pastikan nilai aktual
max_retries, jangan mengandalkan default yang kamu ingat. - Lapisan antrean: Pastikan apakah tugas otomatis dikirim ulang setelah gagal, dan apakah pengiriman ulang punya backoff.
- Lapisan interaksi: Pastikan tombol “coba ulang” dinonaktifkan selama masa tunggu, dan menampilkan waktu percobaan berikutnya.
- Lapisan log: Beri setiap tugas asli ID unik, lalu hitung berapa permintaan yang benar-benar dikirim.
Prinsipnya sederhana: di satu jalur hanya pertahankan satu lapisan yang bertanggung jawab atas retry, lapisan lain hanya meneruskan status.
Skenario streaming perlu merancang strategi pemulihan 429 OpenAI API secara terpisah
Saat permintaan streaming menemui 429 ketika koneksi sedang dibangun dan belum ada konten apa pun yang dikeluarkan, ini bisa ditangani seperti permintaan biasa. Begitu sudah mulai mengeluarkan output, keputusan “apakah akan memutar ulang” sebaiknya diserahkan kepada logika bisnis. Misalnya, beri tahu pengguna secara eksplisit bahwa generasi terputus, lalu biarkan pengguna memilih untuk membuat ulang; atau buang bagian yang sudah dikeluarkan dan ganti seluruhnya. Jangan memutar ulang secara diam-diam di belakang layar, karena itu membuat antarmuka menampilkan dua bagian konten yang duplikat.
Saat bermigrasi ke platform lain, jangan meniru mentah-mentah semantik 429 OpenAI
Klasifikasi error, nilai error.code, perilaku Retry-After, dan header respons yang dijelaskan dalam artikel ini semuanya merupakan semantik API resmi OpenAI. Jika Anda memanggil model melalui gateway pihak ketiga, proxy, atau platform agregasi (misalnya APIYI), maka kode error, dimensi pembatasan laju, dan saran percobaan ulang dari pihak tersebut harus mengacu pada dokumentasi platform itu sendiri, verifikasi secara terpisah, jangan langsung meniru perilaku OpenAI. Praktik yang lebih aman adalah melakukan normalisasi error di lapisan integrasi, memetakan 429 dari berbagai sumber ke dalam tiga kategori status yang disebutkan dalam artikel ini—”tunggu dan coba lagi / akun terblokir / gagal”—lalu menyerahkannya ke modul percobaan ulang terpadu untuk diproses.
Perubahan yang perlu terus diperhatikan
Dokumentasi kode kesalahan dan dokumentasi batas laju OpenAI terus dipelihara. Tingkat kuota, dimensi pengukuran, dan field header respons semuanya mungkin disesuaikan. Sebaiknya pertahankan log teks asli kesalahan di dalam kode, dan secara berkala memeriksa ulang logika penilaian dengan mengacu pada dokumentasi resmi. Selain itu, jangan menuliskan “semua 429 bisa diselesaikan dengan menunggu” ke dalam konfigurasi default mana pun. Begitu asumsi ini berlaku saat kuota habis, harganya adalah antrean tugas yang sia-sia berputar sepanjang malam.
429 pada dasarnya adalah server yang mengatakan “pelan-pelan”, dan kadang juga mengatakan “jalur ini untuk sementara tidak bisa dilalui”. Membedakan yang mana di antara keduanya, lalu memutuskan apakah harus menunggu, mengubah, atau berhenti, lebih penting daripada algoritma retry mana pun yang canggih. Sebagaimana yang dikatakan dalam 《Analek Konfusius·Zilu》:
“Jangan tergesa-gesa, jangan mengejar keuntungan kecil. Ingin cepat maka tidak akan tercapai, mengejar keuntungan kecil maka hal besar tidak akan terwujud.”