Catatan penulis: Membandingkan Qwen4-Max dan Claude Opus 5.5 berdasarkan empat kategori tugas—terminal dan repositori kode, tugas kantor jangka panjang, dokumen panjang multimodal, serta biaya—dengan mencakup skor benchmark, spesifikasi, harga cache, dan biaya migrasi, sekaligus memberikan saran pemilihan yang bisa langsung diterapkan.
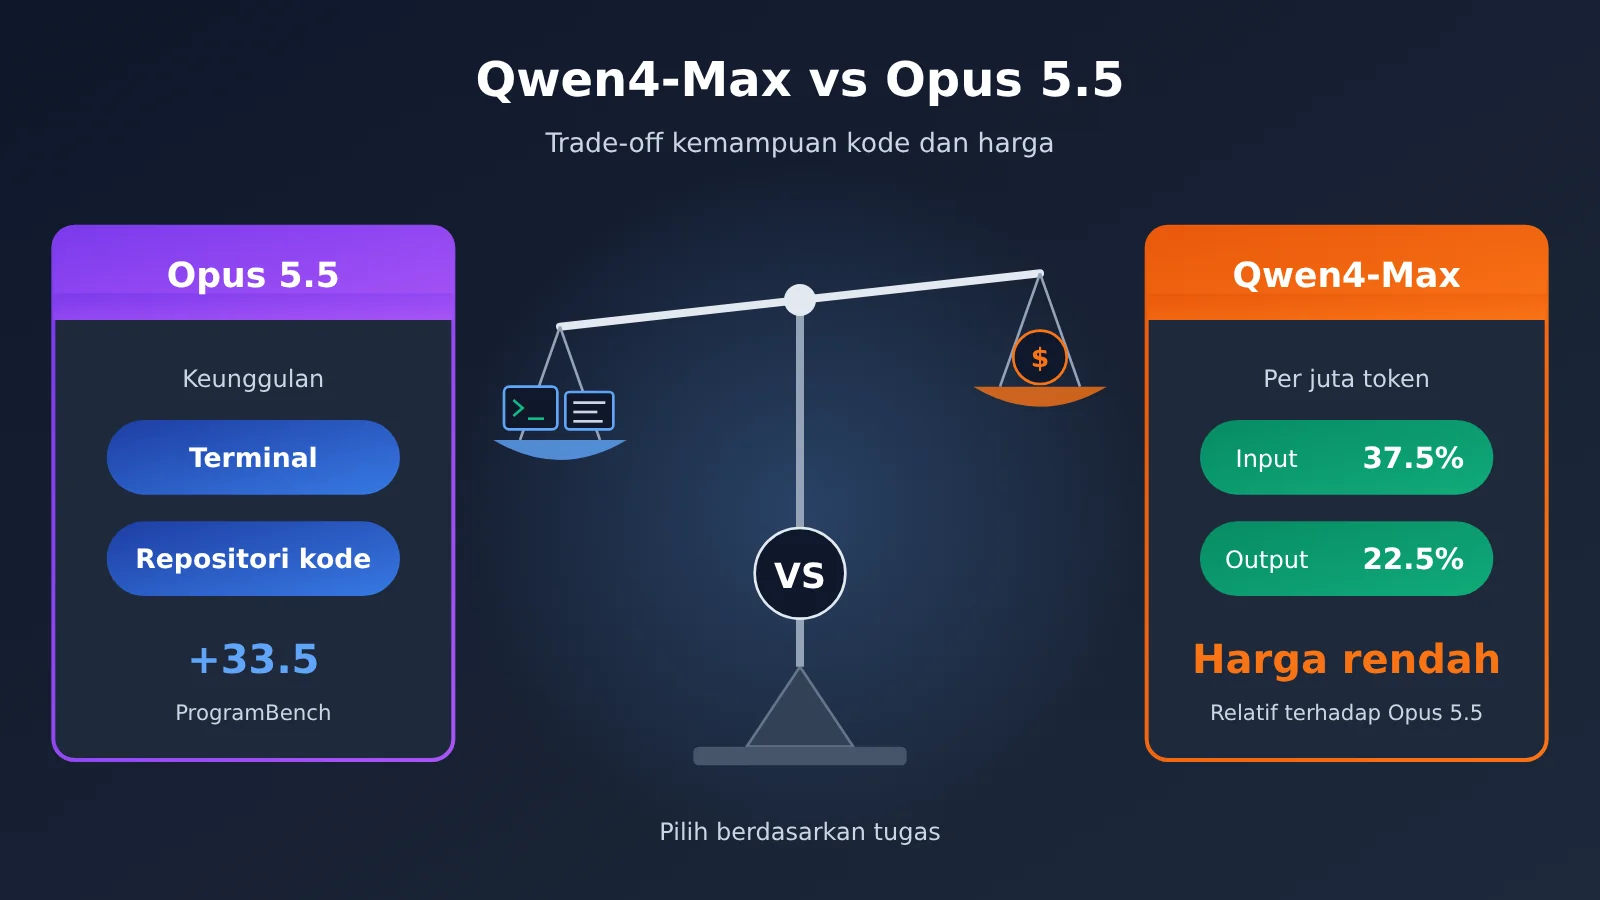
Jika tim kamu sudah menjadikan Claude Opus 5.5 sebagai model utama dan menjalankannya di produksi lewat Claude Code atau agent yang dibangun sendiri, maka Qwen4-Max yang dirilis pada 2026-11-16 akan membuat kamu menghitung ulang anggaran: harga inputnya hanya 37.5% dari Opus 5.5, dan harga outputnya hanya 22.5%.
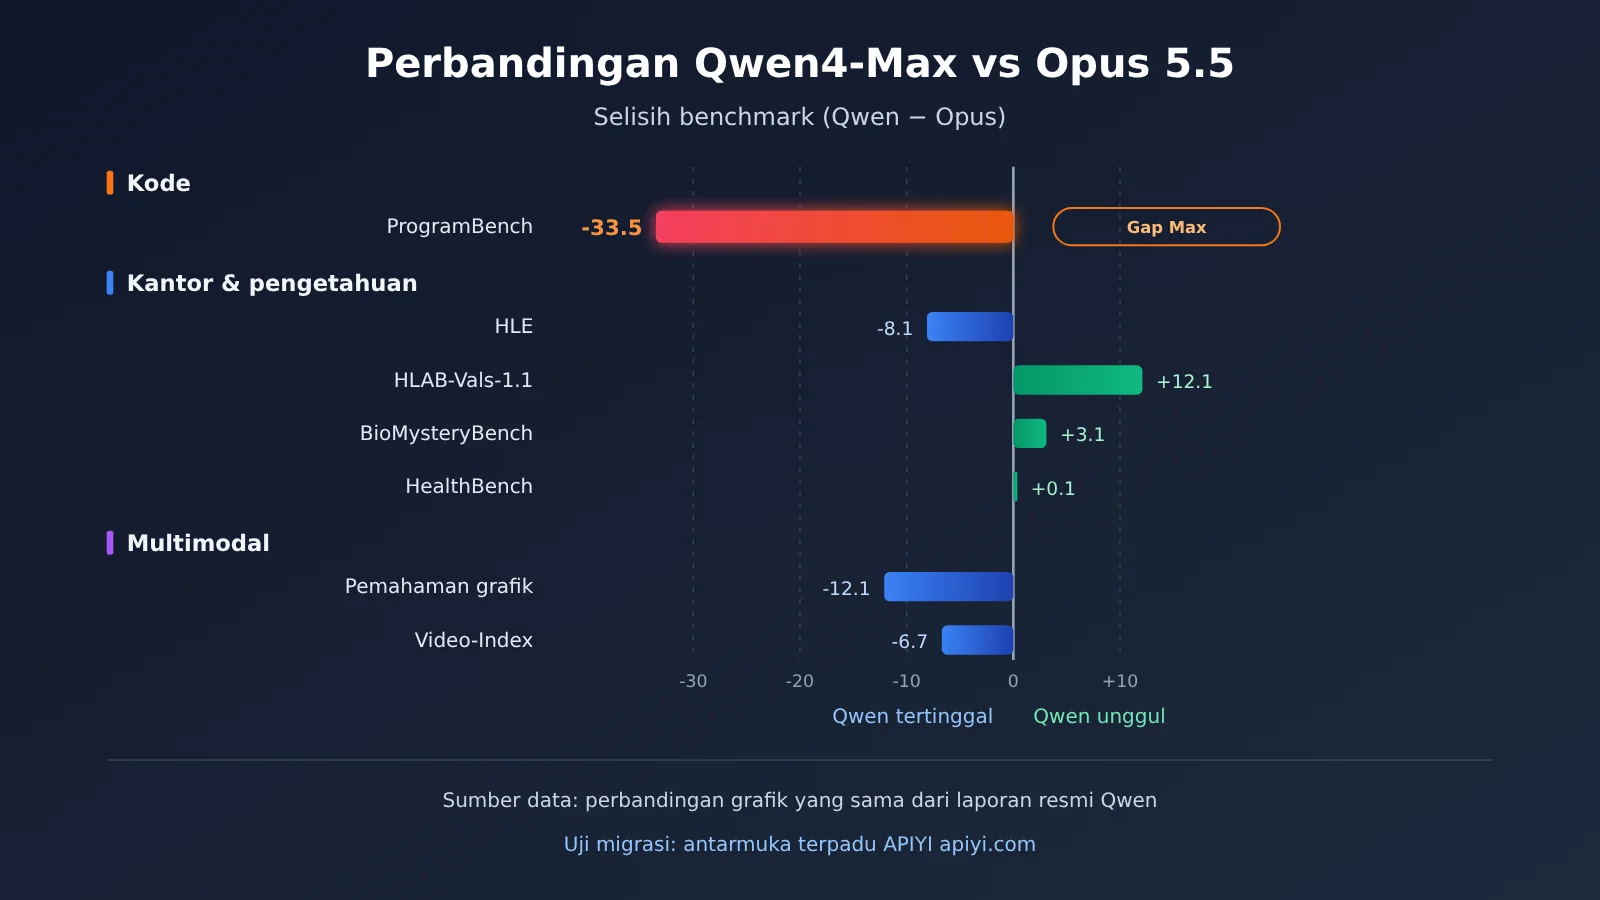
Langsung ke kesimpulan, tanpa kompromi: operasi terminal dan refaktor tingkat repositori tetap di Opus 5.5—Qwen4-Max tertinggal 33.5 poin di ProgramBench, dan ini adalah kelemahan terbesar dalam perbandingan kali ini; otomatisasi alur kerja, agent konkurensi tinggi yang sensitif biaya, serta tugas dokumen dengan output sangat panjang bisa dicoba lebih dulu dengan Qwen4-Max; untuk deliverable kantor serta tugas pemahaman grafik dan video, Opus 5.5 masih punya keunggulan yang jelas.
Nilai inti: setelah membaca artikel ini, kamu akan mendapatkan tabel trade-off berdasarkan jenis tugas, serta memahami perbedaan harga cache, mode penalaran default, dan langkah migrasi aktual di kedua sisi.
Qwen4-Max vs Opus 5.5: Ringkasan Cepat Perbedaan Inti
Mari perjelas dulu dasar datanya. Angka-angka dalam artikel ini berasal dari tiga sumber yang berbeda dan tidak bisa dicampur begitu saja:
- Perbandingan pada grafik yang sama menurut klaim resmi Qwen: Alibaba dalam blog rilisnya memakai grafik yang sama untuk mencantumkan skor Qwen4-Max dan Opus 5.5; ini hasil uji yang dijalankan sendiri oleh vendor, bukan reproduksi pihak ketiga.
- Snapshot papan peringkat publik, 2026-11-14: Papan Code Arena WebDev dari arena.ai, berdasarkan pemungutan suara publik.
- Dokumen asli Anthropic: Spesifikasi dan harga Opus 5.5 diambil dari halaman model resmi dan halaman daftar harga Anthropic.
Tabel berikut merangkum kesimpulan seluruh artikel; bab-bab selanjutnya menguraikan dasar untuk tiap poin.
| Jenis tugas | Rekomendasi | Dasar utama | Alasan singkat |
|---|---|---|---|
| Operasi terminal dan refaktor tingkat repositori | Opus 5.5 | Terminal-Bench lebih rendah 11.1, ProgramBench lebih rendah 33.5 | Rantai perintah bertahap dan perubahan seluruh repositori adalah titik terlemah Qwen4-Max |
| Pengodean untuk perbaikan satu issue | Qwen4-Max patut dicoba | DeepSWE lebih tinggi 1.5 | Kemampuan perbaikan lokal sudah setara, keunggulan harga jelas |
| Hasil kerja kantor dan tugas panjang | Opus 5.5 | AA-Briefcase lebih rendah 115 Elo, JobBench lebih rendah 6.9 | Selisih kualitas keluaran dokumen dan laporan terasa nyata |
| Otomasi alur kerja | Qwen4-Max | AutomationBench lebih tinggi 3.0 | Tugas proses dengan aturan jelas tidak kalah, dan biayanya lebih rendah |
| Pemahaman diagram dan video | Opus 5.5 | Chartography lebih rendah 12.1, Video-Index lebih rendah 6.7 | Kemampuan membaca gambar multimodal masih tertinggal |
| Agent konkurensi tinggi yang sensitif biaya | Qwen4-Max | Input 37.5%, output 22.5% | Saat volume besar, selisih tagihan akan berlipat ganda |
Perbedaan Spesifikasi Qwen4-Max dan Opus 5.5
Dari sisi spesifikasi, keduanya memiliki jendela konteks 1M, tetapi nilai default untuk keluaran dan penalaran sangat berbeda:
- Qwen4-Max: backbone 2.4T, 71B aktif, ditambah 328B N-gram Embedding; visi native; output maksimum 393K, rantai pemikiran maksimum 262K;
reasoning_effortdefault bernilai high. - Opus 5.5 (dokumen asli Anthropic): diposisikan untuk pengodean agentic jangka panjang dan pekerjaan pengetahuan; output maksimum 128K; effort default bernilai medium; batas pengetahuan Juni 2026.
Poin tentang tingkat default ini mudah terlewat. Qwen4-Max secara default sudah diatur ke high, dan proses berpikirnya akan ditagih sebagai output, jadi selisih tagihan sebenarnya biasanya lebih kecil daripada 22.5% pada harga tertera. Bagian harga nanti akan memberikan bukti pendukung dari papan peringkat publik.
Qwen4-Max vs Opus 5.5: Tugas Terminal dan Repositori Kode
Ini adalah bagian yang paling diperhatikan oleh pengguna Opus saat ini, sekaligus bagian yang paling perlu ditangani dengan hati-hati oleh Qwen4-Max.
| Benchmark (perbandingan pada grafik yang sama, dilaporkan sendiri oleh Qwen secara resmi) | Qwen4-Max | Opus 5.5 | Selisih |
|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 74.2 | Qwen lebih tinggi 1.5 |
| CodeArena WebDev Elo | 1750 | 1816 | Qwen lebih rendah 66 |
| Terminal-Bench 4.0 | 48.5 | 59.6 | Qwen lebih rendah 11.1 |
| ProgramBench | 31.5 | 65.0 | Qwen lebih rendah 33.5 |
Mari kita lihat satu per satu apa artinya bagi pekerjaan nyata:
- DeepSWE lebih tinggi 1.5: Pada tugas seperti melakukan perbaikan titik tertentu berdasarkan issue yang diberikan, Qwen4-Max sudah berada di level yang sama dengan Opus 5.5. Selisih 1.5 poin pada dasarnya bisa dianggap imbang, cocok dipakai untuk menjalankan antrean perbaikan bug berisiko rendah.
- WebDev lebih rendah 66 Elo: Untuk kesan keseluruhan dari pembuatan halaman frontend, suara pengguna lebih condong ke Opus. Saat membuat landing page atau prototipe komponen, selisihnya bisa terlihat dengan mata telanjang.
- Terminal-Bench lebih rendah 11.1: Kemampuan untuk terus-menerus menjalankan perintah di terminal, membaca output, lalu memutuskan langkah berikutnya tertinggal cukup jelas. Ini justru keseharian alur kerja bergaya Claude Code, jadi beralih ke model ini berarti lebih sering macet di tengah jalan atau butuh campur tangan manusia.
- ProgramBench lebih rendah 33.5: Ini adalah kelemahan terbesar dalam perbandingan kali ini, skornya hampir berkurang separuh. Untuk tugas membangun program dari nol atau menulis ulang secara besar-besaran, Qwen4-Max saat ini belum cocok menjadi pengganti Opus 5.5.
Papan peringkat publik juga memberikan informasi posisi yang serupa. Menurut snapshot papan publik, 2026-11-14, arena.ai Code Arena WebDev memiliki total 1,007,405 suara dan 159 model: Opus 5.5 (Max) dengan 1816 poin berada di peringkat 2, Qwen4-Max (xHigh) dengan 1750 poin berada di peringkat 6. Namun yang terakhir hanya memiliki 1,814 suara dan masih ditandai sebagai Preliminary, sehingga peringkatnya masih akan berfluktuasi.
Saran Penggunaan Qwen4-Max untuk Skenario Repositori Kode
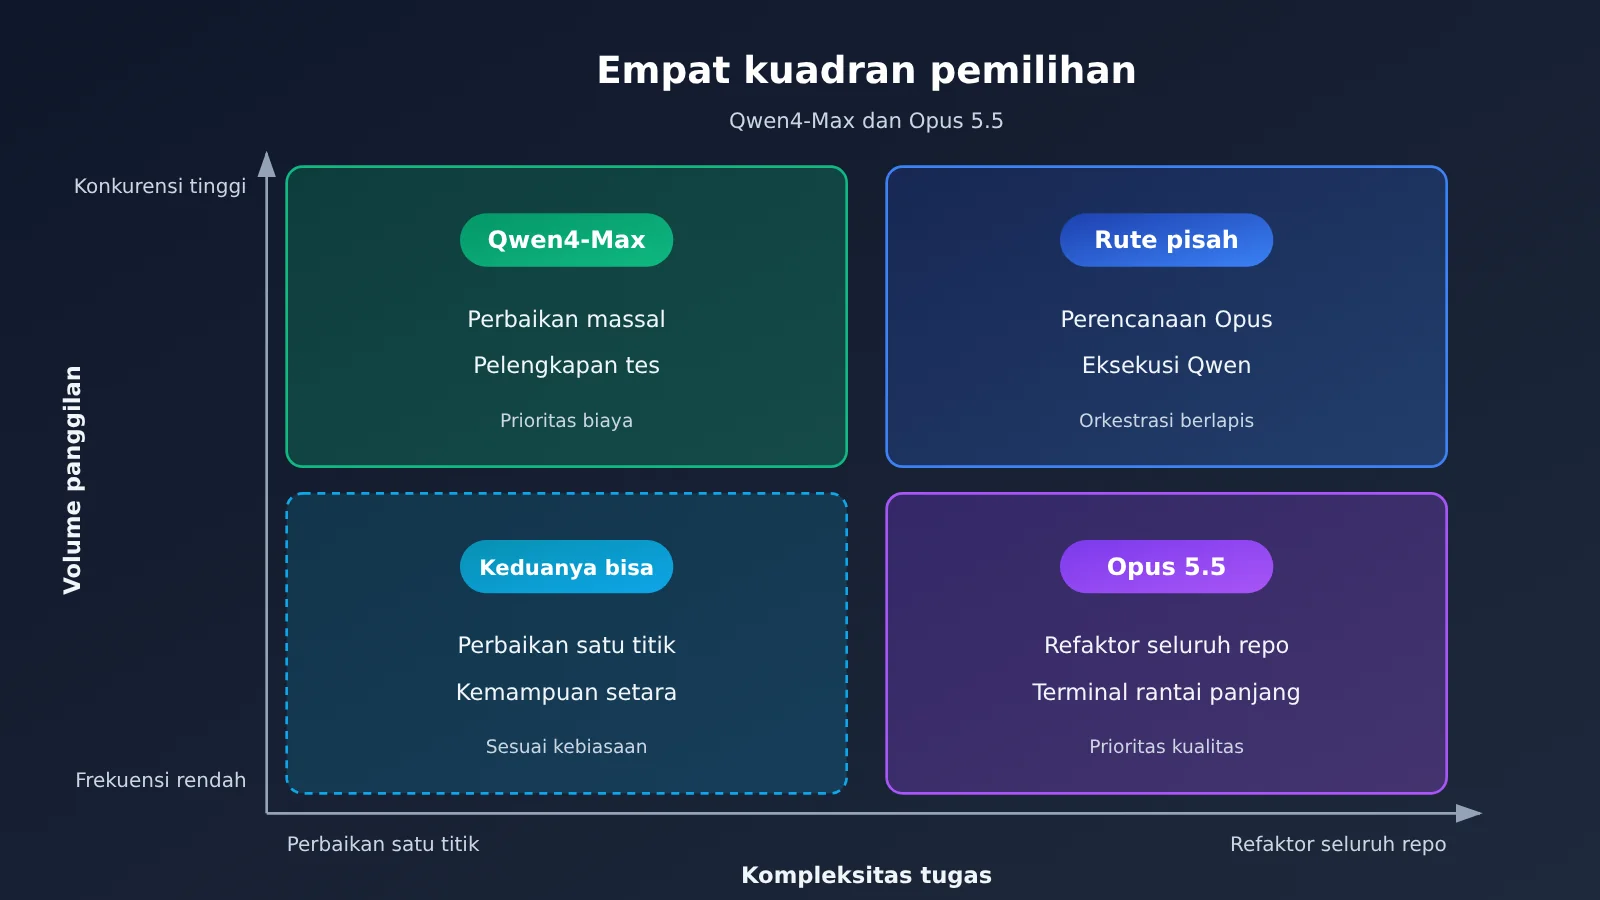
Jika agent Anda terutama melakukan refactor seluruh repositori, migrasi lintas modul, atau operasi terminal dengan rantai panjang, sebaiknya tetap gunakan Opus 5.5. Jika Anda memecah tugas menjadi dua lapisan “perencanaan + eksekusi”, Anda bisa mempertimbangkan Opus 5.5 untuk menangani perencanaan dan perubahan kunci, lalu mengalihkan tugas lokal seperti perbaikan satu file atau melengkapi tes ke Qwen4-Max.
Qwen4-Max vs Opus 5.5: Tugas Kantor dan Tugas Panjang
Hasil untuk tugas perkantoran dan tugas agent berdurasi panjang lebih beragam dibandingkan coding — ada yang kalah, ada yang menang.
| Benchmark (perbandingan gambar yang sama, dilaporkan sendiri oleh Qwen resmi) | Qwen4-Max | Opus 5.5 | Selisih |
|---|---|---|---|
| AA-Briefcase v1.1 Elo | 1686 | 1801 | Qwen lebih rendah 115 |
| JobBench | 68.5 | 75.4 | Qwen lebih rendah 6.9 |
| APEX-Agents v1.1 | 72.1 | 73.5 | Qwen lebih rendah 1.4 |
| AutomationBench-AA | 72.5 | 69.5 | Qwen lebih tinggi 3.0 |
| AgentArena Net Improvement | 7.5 | 18.2 | Qwen lebih rendah 10.7 |
Kalau dipetakan ke pekerjaan nyata:
- AA-Briefcase lebih rendah 115 Elo: untuk deliverable kantor seperti laporan, proposal, dan tabel, hasil jadi Opus 5.5 lebih mudah langsung dipakai — ini kesenjangan terbesar di skenario perkantoran.
- JobBench lebih rendah 6.9: tingkat penyelesaian menyeluruh yang mendekati tugas jabatan sungguhan masih unggul Opus, artinya saat penyerahan end-to-end kemungkinan rework bisa lebih tinggi.
- APEX-Agents lebih rendah 1.4: tugas agent umum pada dasarnya imbang, ganti model tidak akan memberi perbedaan pengalaman yang mencolok.
- AutomationBench lebih tinggi 3.0: otomasi proses dengan aturan yang jelas justru jadi kekuatan Qwen4-Max; pemrosesan formulir, pemindahan data, dan orkestrasi tugas terjadwal cocok diprioritaskan untuk migrasi.
- AgentArena Net Improvement lebih rendah 10.7: kemampuan untuk terus membaik lewat iterasi multi-putaran lebih lemah; semakin panjang tugas dan semakin bergantung pada koreksi diri model, Opus lebih stabil.
Selain itu, output maksimum 393K dan batas chain-of-thought 262K milik Qwen4-Max adalah keunggulan nyata untuk tugas panjang yang perlu menghasilkan konten sangat panjang dalam sekali jalan; output maksimum Opus 5.5 adalah 128K.
Qwen4-Max vs Opus 5.5: Bahasa Mandarin dan Dokumen Panjang Multimodal
Perlu ditegaskan di awal: grafik perbandingan dalam materi referensi tidak memiliki benchmark khusus bahasa Mandarin, jadi artikel ini tidak bisa menjawab dengan angka “siapa yang lebih baik dalam bahasa Mandarin”. Jika kualitas bahasa Mandarin adalah indikator inti Anda, lakukan A/B dengan kumpulan sampel Anda sendiri, jangan mengandalkan kesimpulan orang lain.
Yang bisa dibicarakan dengan angka adalah tugas multimodal dan pengetahuan:
| Benchmark (perbandingan pada grafik yang sama, dilaporkan sendiri oleh Qwen) | Qwen4-Max | Opus 5.5 | Selisih |
|---|---|---|---|
| Chartography | 54.2 | 66.3 | Qwen lebih rendah 12.1 |
| Video-Index | 68.1 | 74.8 | Qwen lebih rendah 6.7 |
| Humanity’s Last Exam | 51.7 | 59.8 | Qwen lebih rendah 8.1 |
| HLAB-Vals-1.1 | 21.3 | 9.2 | Qwen lebih tinggi 12.1 |
| BioMysteryBench | 85.0 | 81.9 | Qwen lebih tinggi 3.1 |
| HealthBench Professional | 60.0 | 59.9 | Praktis imbang |
Makna praktis dari angka-angka ini: dalam membaca grafik serta mengekstrak data visual dari laporan keuangan dan laporan riset, Qwen4-Max tertinggal 12.1 poin dan cenderung melewatkan atau salah membaca koordinat; pemahaman video juga tertinggal 6.7 poin; soal pengetahuan komprehensif tingkat sulit (HLE) tertinggal 8.1 poin. Sebaliknya, pada penalaran biologi dan tanya jawab medis profesional, Qwen4-Max setara bahkan sedikit lebih unggul, dengan HLAB-Vals memimpin 12.1 poin.
Jadi tugas dokumen panjang perlu dipecah lagi: untuk dokumen yang didominasi teks dan menuntut keluaran sangat panjang, Qwen4-Max bisa menjadi kandidat utama; untuk PDF yang padat grafik atau materi yang berisi video, tetap disarankan memakai Opus 5.5.
Harga per juta token dan perhitungan cache Qwen4-Max vs Opus 5.5
Harga adalah argumen terkuat Qwen4-Max. Satuan pada tabel berikut adalah per 1M tokens; harga resmi diambil dari teks asli dokumentasi QwenCloud dan Anthropic, sedangkan harga APIYI saat ini diambil dari docs.apiyi.com/models, dengan tanggal pengambilan data 2026-11-16.
| Item penagihan ($/1M tokens) | Qwen4-Max resmi | Opus 5.5 resmi | Qwen/Opus | APIYI qwen3.8-max |
APIYI claude-opus-5-5 |
|---|---|---|---|---|---|
| Input | 1.5 | 4 | 37.5% | 1.65 | 4 |
| Output | 4.5 | 20 | 22.5% | 4.95 | 20 |
| Baca cache | 0.075 | 0.20 | 37.5% | 0.20625 | 0.2 |
| Tulis cache 5 menit | 1.875 | 5 | 37.5% | sesuai daftar platform | sesuai daftar platform |
| Tulis cache 1 jam | 3 | 8 | 37.5% | sesuai daftar platform | sesuai daftar platform |
Struktur cache kedua penyedia sebenarnya sepenuhnya isomorfik: baca cache adalah 5% dari harga input, tulis cache 5 menit adalah 1.25 kali harga input, dan tulis cache 1 jam adalah 2 kali. Artinya, strategi cache yang Anda rancang untuk Opus dapat dipindahkan apa adanya ke Qwen4-Max, dengan tagihan menyusut secara proporsional menjadi 37.5%. Perlu diperhatikan bahwa di APIYI, baca cache qwen3.8-max adalah 12.5% dari harga input, rasionya berbeda dari Qwen4-Max resmi, jadi saat migrasi harap hitung secara terpisah sesuai model aktual.
Satu perhitungan konkret
Ambil contoh 100 juta input + 10 juta output: Qwen4-Max sekitar $195 (150 + 45), Opus 5.5 sekitar $600 (400 + 200). Selisihnya sekitar $405, setara dua pertiga tagihan Opus.
Tetapi harga tertera tidak sama dengan yang dibayar. Snapshot papan peringkat publik, 2026-11-14 memberikan biaya per tugas P50: Opus 5.5 (Max) $8.99, Qwen4-Max (xHigh) $4.18, rasio sekitar 46%, bukan 22.5% dari harga tertera. Penyebabnya adalah tingkat penalaran keduanya berbeda; Qwen4-Max default-nya high, rantai pemikiran ditagih sebagai output, sehingga konsumsi token lebih banyak. Berapa banyak yang benar-benar dihemat bergantung pada panjang tugas dan tingkat penalaran Anda; sebaiknya uji dengan replay trafik Anda sendiri.
💰 Saran biaya: Saat membandingkan tagihan, catat sekaligus jumlah token untuk empat komponen input, output, baca cache, dan tulis cache, bukan hanya harga satuan. Dengan memanggil kedua model secara paralel di akun yang sama melalui APIYI apiyi.com, rincian penggunaan dapat diselaraskan di satu tempat.
Rekomendasi Keputusan dan Tiga Langkah Migrasi: Qwen4-Max vs Opus 5.5
Memindahkan satu agen dari Opus ke Qwen tidak lepas dari tiga langkah: cek model, bandingkan harga, dan samakan protokol.
Langkah pertama: cek model. Per 2026-11-16, Qwen4-Max belum tersedia di APIYI; kami akan segera menghadirkan model ini. Saat ini model terkuat di sisi Qwen adalah qwen3.8-max. Di sisi Opus tersedia claude-opus-5-5, juga ada claude-opus-5-5-thinking dengan harga yang sama. Model dan harga mengacu pada daftar model di pusat dokumentasi apiyi.com. Sebelum model tersedia, Anda bisa menyiapkan jalur uji bertahap menggunakan qwen3.8-max.
Langkah kedua: bandingkan harga. Dengan metode di bagian sebelumnya, estimasikan biaya kedua sisi menggunakan trafik nyata selama satu minggu, lalu bandingkan setelah tingkat penalaran disamakan. Daftar model APIYI di apiyi.com mencantumkan input, output, dan pembacaan cache dalam satu tabel ringkasan, sehingga cocok dijadikan sumber data langsung untuk tabel perhitungan biaya.
Langkah ketiga: samakan protokol. APIYI menyediakan antarmuka kompatibel OpenAI dengan endpoint https://api.apiyi.com/v1. Saat mengganti model, cukup ubah field model, misalnya dari claude-opus-5-5 ke qwen3.8-max; api_key dan base_url tetap sama. Ada dua hal tambahan yang perlu diperiksa: parameter kekuatan penalaran di sisi Qwen disebut reasoning_effort dengan default high; jika ingin selaras dengan medium di Opus, set secara eksplisit. Durasi penulisan cache dan aturan cache hit juga perlu diverifikasi ulang untuk model target.
🎯 Saran uji bertahap: Jangan migrasikan seluruh agen sekaligus. Sebaiknya alirkan trafik di bawah
base_urlyang sama (https://api.apiyi.com/v1) berdasarkan jenis tugas. Migrasikan dulu tugas otomasi dan perbaikan lokal, sementara tugas terminal dan seluruh repositori tetap di Opus 5.5. Pantau tingkat pekerjaan ulang selama dua minggu sebelum memutuskan langkah berikutnya.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Qwen4-Max atau Opus 5.5, mana yang lebih cocok untuk coding agent?
Tergantung granularitas tugas. Untuk perbaikan satu issue (DeepSWE), keduanya setara, jadi Qwen4-Max bisa lebih hemat biaya; untuk operasi multi-langkah di terminal dan pembangunan seluruh repositori (Terminal-Bench, ProgramBench), Opus 5.5 jelas unggul, terutama ProgramBench dengan selisih 33,5 poin, sehingga tugas seperti ini sebaiknya tetap memakai Opus.
Q2: Apakah skor pada grafik Alibaba dan papan peringkat arena bisa dibandingkan secara langsung?
Tidak bisa dianggap setara. Yang pertama adalah perbandingan pada gambar yang sama yang dilaporkan sendiri oleh pihak resmi Qwen, sedangkan yang kedua adalah snapshot papan peringkat publik (2026-11-14), dan Qwen4-Max di papan tersebut hanya mengantongi 1.814 suara serta masih berstatus Preliminary. Keduanya bisa saling dijadikan rujukan tren, tetapi tidak boleh digabung menjadi satu kesimpulan “unggul berapa poin”.
Q3: Berapa banyak biaya yang sebenarnya bisa dihemat dengan beralih ke Qwen4-Max?
Pada harga resmi, input menghemat 62,5% dan output 77,5%. Namun rasio biaya per tugas P50 di papan peringkat publik sekitar 46%, karena Qwen4-Max secara default memakai tingkat penalaran yang lebih tinggi dan token berpikir yang lebih banyak. Penghematan aktual perlu diukur melalui pemutaran ulang lalu lintas Anda.
Q4: Apakah Qwen4-Max sudah bisa dipanggil di APIYI sekarang?
Untuk sementara belum; Qwen4-Max belum tersedia di katalog dan kami akan segera menambahkannya. Saat ini `qwen3.8-max` dapat dipakai untuk membangun jalur migrasi, dan setelah tersedia cukup mengubah field `model`. Status model harap mengacu pada daftar model di APIYI apiyi.com.
Q5: Berapa banyak kode yang perlu diubah saat beralih dari Opus ke Qwen?
Jika sudah memakai antarmuka yang kompatibel dengan OpenAI, cukup arahkan `base_url` ke `https://api.apiyi.com/v1`, lalu ubah nama model dan atur `reasoning_effort` sesuai kebutuhan. Setelah mendaftar di APIYI apiyi.com, Anda bisa memakai kuota uji gratis pengguna baru untuk menjalankan satu putaran perbandingan terlebih dahulu.
Q6: Apa saja keterbatasan Qwen4-Max yang diketahui?
Terminal dan pengodean seluruh repositori adalah kelemahan terbesarnya, pemahaman grafik tertinggal 12,1 poin, Elo untuk deliverable perkantoran lebih rendah 115, dan kemampuan penyempurnaan diri multi-putaran juga relatif lemah. Selain itu, semua skor perbandingan dilaporkan sendiri oleh vendor dan belum ada reproduksi pihak ketiga, sementara kemampuan bahasa Mandarin juga belum memiliki data benchmark khusus.
Qwen4-Max vs Opus 5.5: Poin-Poin Utama (Key Takeaways)
- Kelemahan terbesar: ProgramBench lebih rendah 33,5 poin; untuk build dan refactor seluruh repositori, tetap gunakan Opus 5.5.
- Area yang seimbang: DeepSWE, APEX-Agents, dan HealthBench pada dasarnya imbang, sehingga bisa didahulukan untuk dialihkan ke Qwen.
- Keunggulan Qwen: otomasi alur kerja, penalaran biomedis, dan output super panjang hingga 393K.
- Struktur harga: input 37,5%, output 22,5%, dengan keempat proporsi cache sepenuhnya identik dengan Opus.
- Selisih biaya aktual: tingkat penalaran default adalah
high, biaya tugas pada leaderboard publik sekitar 46%. - Jalur migrasi: di APIYI apiyi.com, jalankan dulu
qwen3.8-maxdengan endpoint yang sama, lalu ganti langsung begitu Qwen4-Max tersedia.
Kesimpulan
Pilihan antara Qwen4-Max dan Opus 5.5 dapat diringkas menjadi tiga poin:
- Terminal dan repositori kode tetap diserahkan ke Opus 5.5: selisih pada Terminal-Bench dan ProgramBench tidak bisa ditutupi oleh perbedaan harga, karena biaya pengerjaan ulang lebih besar.
- Otomasi dan konkurensi tinggi diserahkan ke Qwen4-Max: pada tugas yang kemampuannya setara atau bahkan lebih unggul, tagihan yang 30–50% lebih murah adalah keuntungan murni.
- Bagi tugas berdasarkan jenisnya, bukan mengganti secara keseluruhan: antarmuka yang sama dengan routing berdasarkan jenis tugas adalah cara migrasi dengan risiko terendah.
Disarankan untuk lebih dulu menjalankan replay tugas Anda sendiri di APIYI apiyi.com menggunakan qwen3.8-max dan claude-opus-5-5, lalu ambil keputusan peralihan final setelah Qwen4-Max tersedia.
📚 Referensi
-
Blog rilis Qwen4-Max: spesifikasi model dan perbandingan dengan benchmark resmi
- Tautan:
qwen.ai/blog?id=qwen4-max - Keterangan: berisi parameter arsitektur, batas jendela konteks dan output, serta skor perbandingan pada grafik yang sama
- Tautan:
-
Ikhtisar model Anthropic: spesifikasi Opus 5.5
- Tautan:
platform.claude.com/docs/en/about-claude/models/overview.md - Keterangan: jendela konteks, output maksimum, effort default, dan batas pengetahuan
- Tautan:
-
Halaman harga Anthropic: harga input, output, dan cache Opus 5.5
- Tautan:
platform.claude.com/docs/en/about-claude/pricing.md - Keterangan: termasuk harga penulisan cache 5 menit dan 1 jam
- Tautan:
-
Daftar model APIYI: harga terkini dan model yang tersedia di platform
- Tautan:
docs.apiyi.com/models - Keterangan: cek status ketersediaan model dan harga sebelum migrasi
- Tautan:
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami melalui halaman utama situs APIYI apiyi.com. Materi integrasi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com